不调库、不套壳:OCR、推理运行时、GPU 层全自研的爬虫引擎,1.0 了
原创
不调库、不套壳:OCR、推理运行时、GPU 层全自研的爬虫引擎,1.0 了
原创
用户12863179
修改于 2026-11-04 12:00:26
修改于 2026-11-04 12:00:26
先说结论
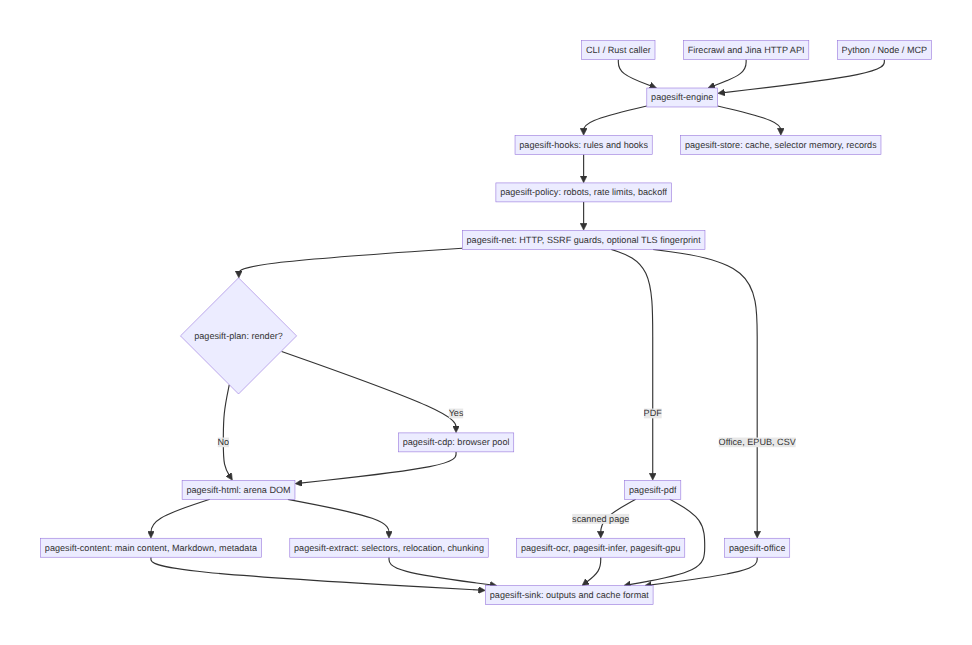
PageSift 1.0 正式版今天发布。它是一个用 Rust 写的 Web 内容引擎:把 URL、PDF、Office 文件变成干净的 Markdown 和结构化数据,喂给 AI Agent 和 LLM 流水线。单个自托管二进制,提供 CLI、Firecrawl 兼容的 HTTP API、Jina Reader 兼容端点、MCP 服务器,以及 Python / Node.js / Rust 三套 SDK。
从 10 月 20 日开源 0.20,到今天 1.0,中间隔了 15 天、二十多个版本。1.0 的定位不是又一次提速(性能在 0.9 的架构重构里已经到位),而是功能的最终完善:竞品有的表面,这次基本收齐了。
GitHub:https://github.com/YOLOW92/pagesift (AGPL-3.0,另有商业许可)
1.0 补齐了什么
OCR,而且是全自研的。 扫描版 PDF 以前是 PageSift 公认的短板(不做 OCR 是 0.9 时代写进设计文档的非目标)。1.0 自己写了完整的 OCR 管线:文本检测、识别、公式识别(输出 LaTeX)、版面分析;连底层的推理运行时都没用 ONNX Runtime,而是自研了一个 safetensors 执行器;GPU 层同样是自写的 CUDA 绑定。模型是开放权重、按需下载,默认关闭,需要时开 [ocr] enabled = true 或 --ocr。在 olmOCR 口径的扫描集上,1.0 得分 0.543,高于 Docling(GPU)的 0.410。
带记忆的选择器抽取。 你给一个 JSON schema,PageSift 按选择器抽字段;站点改版、选择器失效时,它会根据之前记住的元素指纹,按统计后验概率在新页面里重新定位元素,并明确报告「重定位成功 / 歧义 / 缺失」,而不是悄悄返回错数据。
变更监控。 /v2/monitor 一组端点:盯住一批页面或整站,定时检查,内容变了产生变更事件——配合内置的块级 diff,能把「价格、日期变了」这类噪声变化和实质变化分开。
浏览器动作、会话与 Agent。 HTTP / MCP / Jina 三个表面都支持 actions(点击、输入等);/v2/scrape/{id}/interact 可以保持浏览器会话连续操作;POST /v2/agent 是给定目标、由模型驱动浏览的 Agent 端点。
其余收尾:Jina Reader 全兼容(包括 /s/ 搜索端点);WARC 档案可以直接当输入;hooks 与 [[rules]] 规则系统、[secrets] 按主机注入的密钥管理;PDF / Office / EPUB / CSV 全格式统一管线。
架构:为什么它快,而且行为可预测
1.0 的底子是 0.9 的架构重构,核心思想有三条:
- 固定值改成估计值。 以前版本里几百个手调的超时、阈值、并发数,0.9 起由一个统计内核从运行时观测里推导:超时用生存分析(Kaplan–Meier)、全局并发用 USL 拟合、渲染与否用「后验期望价值 − 影子价格 × 成本」决策。全局只剩一个元参数 δ = 0.05。没有观测时,行为与旧版一致;估计值只有在统计显著时才接管。
- 调度顺应硬件。 每核一个常驻 CPU 工人(取代阻塞线程池),绑 NUMA 节点集合而非逐核硬绑(这是 0.70 时代的实测结论:硬绑 −33.9%,绑节点集 +8.63%),节点内优先偷任务。工人的注释里写着每个决定的实测出处。
- 失败不许报成功。 这是 0.91 的主题,也是 1.0 的全线纪律:作业页存不下、记录复制不到备机、webhook 没送达,以前这类失败会被记个日志然后报 completed——现在全部报错终止并给出查询端点。1.0 更进一步:API 里兑现不了的参数直接拒绝(MCP 未知参数报错、Jina 无法兑现的 header 返回 UNSUPPORTED_OPTION),不再静默忽略。发布说明里专门有一节 Known limits,把没测到的、做不到的逐条写清,包括安全注意事项。
性能(1.0 于 2026-11-04 复测)
工作负载 | PageSift 1.0 | 最快对手 | 差距 |
|---|---|---|---|
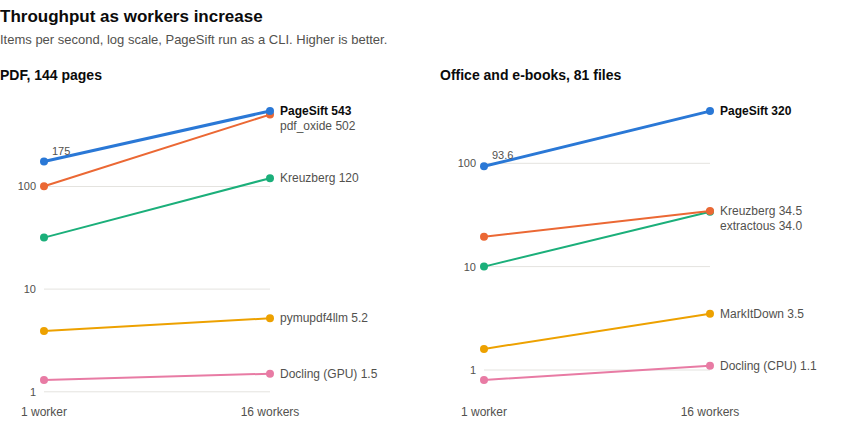
PDF → Markdown(olmOCR-bench 1,269 页,单线程) | 2.4 ms/页 | pypdf 50.0 ms/页 | ×20.8 |
HTML → Markdown(600 文档) | 0.24 ms/页 | Turndown 1.9 ms/页 | ×8.1 |
正文抽取(Firecrawl 597 页,单线程 p50) | 1.0 ms/页 | crw 7.4 ms/页 | ×7.3 |
Office / 电子书(81 文件) | 93.6 文件/秒 | Kreuzberg 19.5 | ×4.8 |
宽爬(200 站 × 100 页,无限速) | 3,500–4,400 页/秒,峰值内存 280–316 MB | Spider 2,000–2,700 页/秒,5.5 GB | — |
口径照实说:对照组数字是 10 月下旬的实测记录、本次未重跑;PageSift 输给对手的格子也完整列在官方基准文档的「Largest gaps」一节里(例如单机回放的礼貌间隔会让它看起来慢——那是默认对每个站点 1 秒间隔的策略,不是引擎速度)。完整数据与复现脚本都在仓库的 docs/benchmarks.md 与 benchmarks/ 目录。
已经被生产环境验证过
1.0 不是实验室项目。10 月底,一个海外团队把 PageSift 接进了他们的生产系统,第一时间撞上了一个真问题:官方 Node 绑定要求的 glibc 版本太高,他们的服务器(glibc 2.32)加载不了。这个问题在 0.81.5 修复:构建基线降到 glibc 2.28,并加了发布门禁脚本,任何产物超出基线就发不出去。发现问题的是用户,修掉并防住它再犯,是这个项目的做事方式。
适合谁,不适合谁
适合:给 RAG / Agent 喂数据的团队,想自托管一个 Firecrawl / Jina 替代品、不按页付费的人,需要 PDF 和 Office 与网页走同一条管线的人。
不适合:需要云托管服务的人(PageSift 是自托管的,托管版不在 1.0 范围里);需要绕过强反爬站点的场景(PageSift 遵守 robots.txt 与站点礼貌策略,验证码不破解、挑战页如实报告;1.0 新增的浏览器指纹是默认关闭的单一画像,定位是让自有浏览器流量保持一致,不是伪装大军)。
最后
PageSift 是我一个人在业余时间写的个人项目。它起源于我另一个项目 AiSeek 的真实需求:现成的抓取工具太慢、抽得也不够干净,那就自己写一个。15 天走到 1.0,功能到此收官;接下来的重点是让更多生产环境把它跑出问题来——然后逐个修掉、写进发布说明。
欢迎试用、提 issue,也欢迎拿它去和你现在的方案对跑,结果好坏都可以发出来。
- 仓库:https://github.com/YOLOW92/pagesift
- 安装:
cargo install pagesift --locked,或 Dockerghcr.io/yolow92/pagesift,Pythonpip install pagesift,Nodenpm i @pagesift/node
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号