DataGrip 中查看 ES 文档、Kafka 消息与 Nacos 配置的操作记录
原创
DataGrip 中查看 ES 文档、Kafka 消息与 Nacos 配置的操作记录
原创
用户10976269
修改于 2026-11-05 11:15:18
修改于 2026-11-05 11:15:18
DataBridge 是我维护的 DataGrip 插件。它支持 Elasticsearch、Kafka、ZooKeeper、RabbitMQ、Nacos、MinIO/S3,入口放在 DataGrip 的数据源和资源树里。这篇记录按安装、连接、查询的顺序写,截图来自本机演示环境。
JetBrains Marketplace(插件商店):https://plugins.jetbrains.com/plugin/35783
这里先说清用途:查一批 Kafka 消息、看 ES 文档、核对 Nacos 配置,适合在 IDE 里顺手完成。各适配器的操作范围不同,不能把它们都当作关系数据库使用。下面会把这些限制放在对应步骤旁边。
先装插件,再创建连接
准备好 DataBridge 插件 ZIP,不要解压。打开 DataGrip 的 Settings → Plugins,点齿轮,选择 Install Plugin from Disk,选中 ZIP,重启 IDE。
接着打开 Settings → Tools → DataBridge,勾选需要的适配器。界面可以选中文或英文;切换后需要重新打开已有的插件页面。
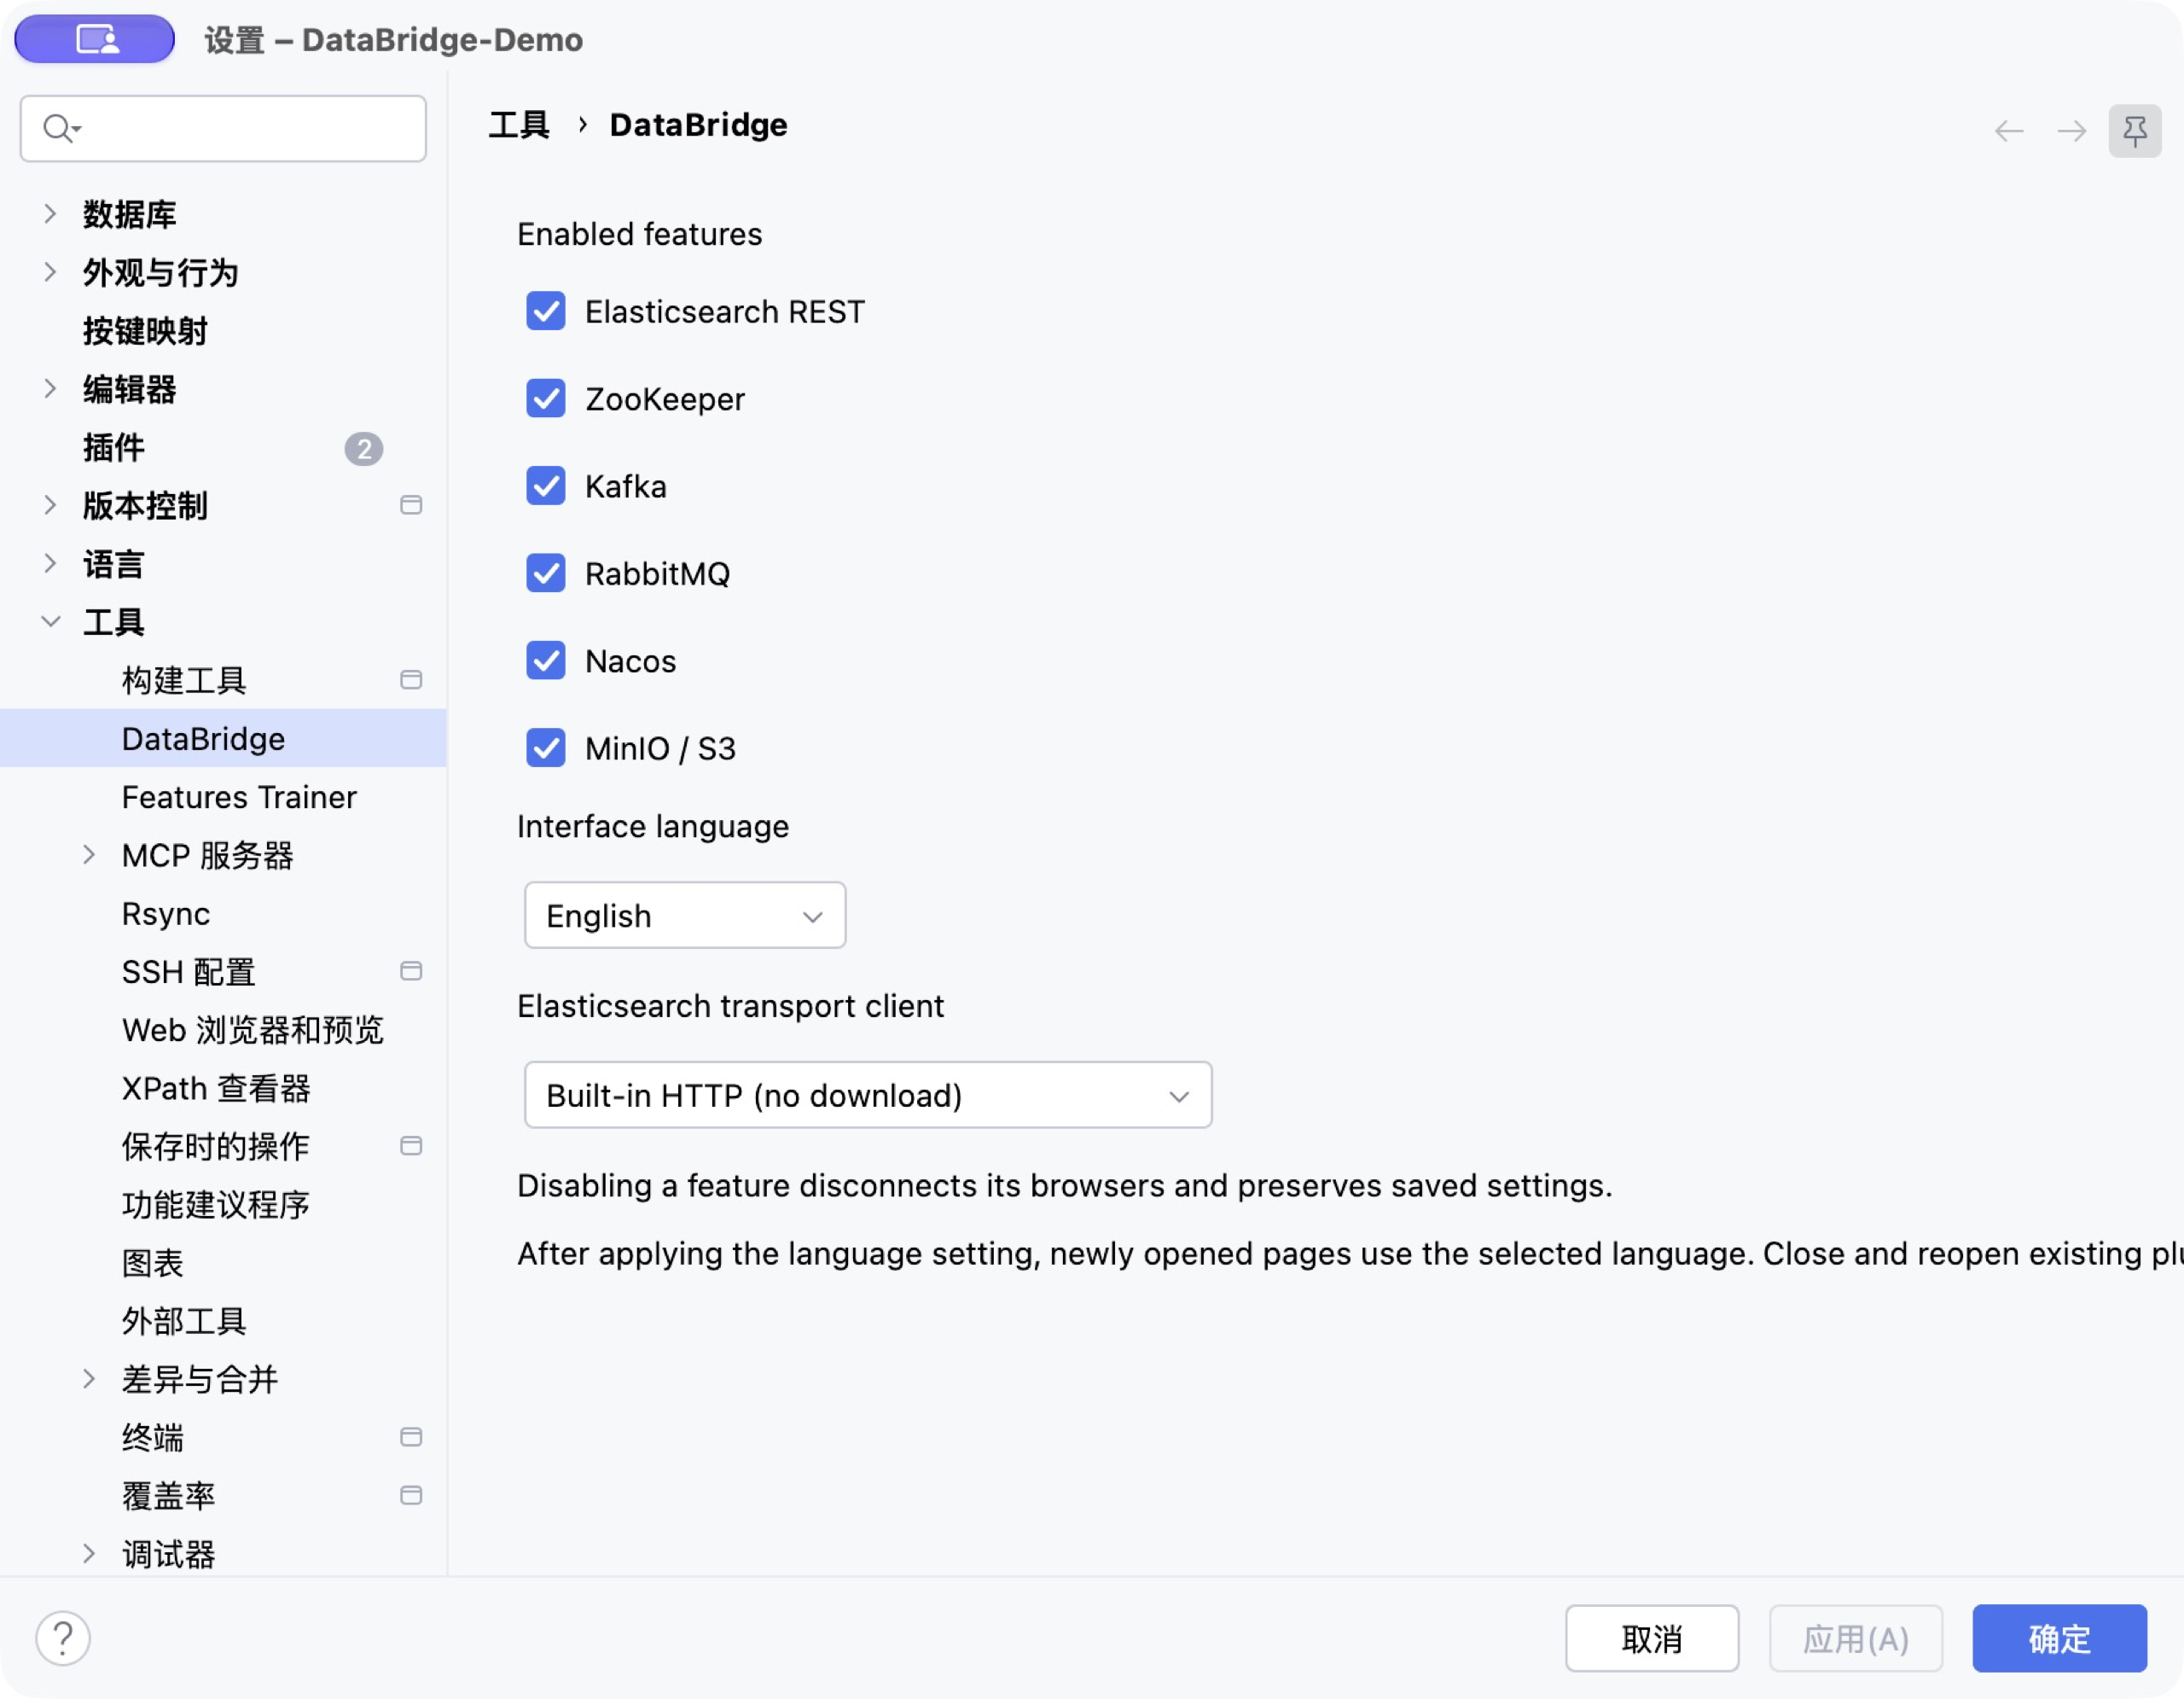
设置页:适配器开关与界面语言
在 Database Explorer 中点“+”,从 Data Source → Other 中找带有“(DataBridge)”后缀的类型。下表是本机连接示例,服务器地址和认证信息需要换成自己的。
类型 | URL 示例 |
|---|---|
Elasticsearch |
|
Kafka |
|
ZooKeeper |
|
RabbitMQ |
|
Nacos 2 |
|
Nacos 3 Console |
|
MinIO |
|
User/Password 填在连接配置中。Kafka 和 ZooKeeper 如果提示缺少驱动依赖,按驱动页提示下载,再测试连接。
查 ES:先限定索引和条数
连上 Elasticsearch 后,先选一个已存在的索引。比如索引叫 logs,可以运行:
SELECT * FROM "logs" LIMIT 100;插件把支持的 SQL 转成 DSL。结果表格旁边能看到生成的 DSL,遇到返回结果和预期不一致时,可以先核对这一部分。
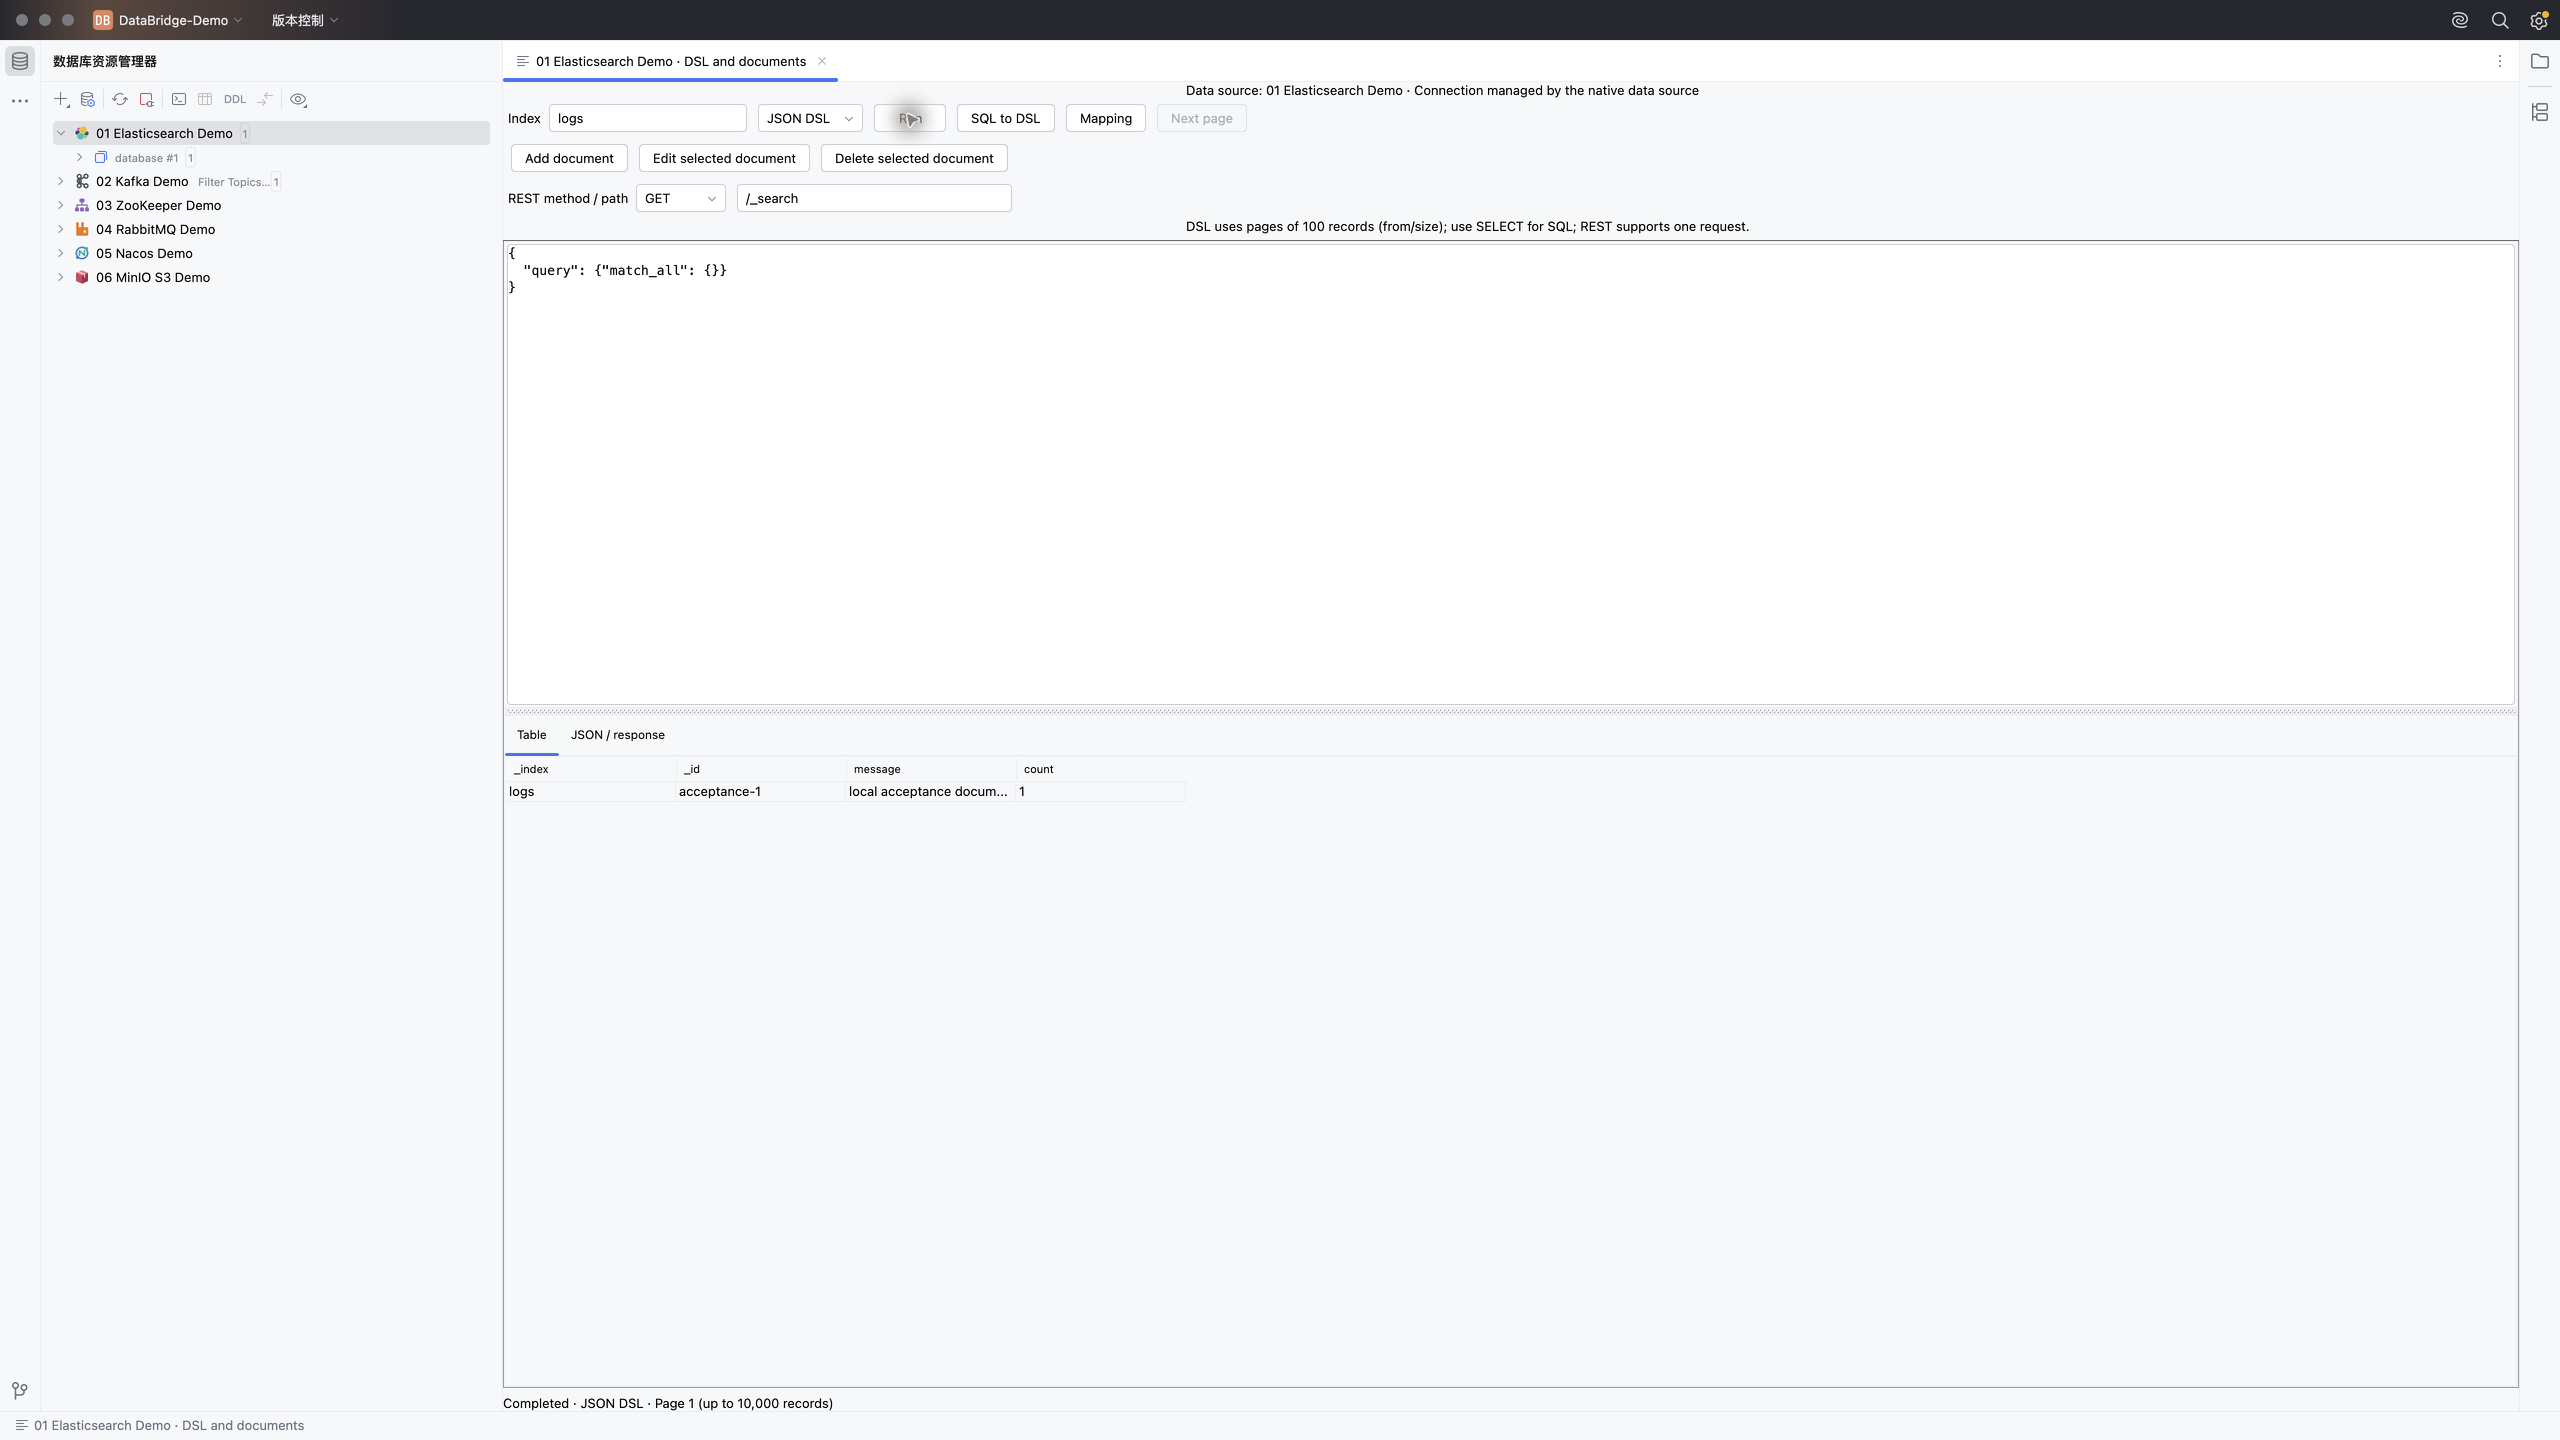
ES 查询结果及生成的 DSL
文档编辑有版本检查,索引设置、Mapping、别名等有对应入口。普通浏览最多 10000 条,统计最多 10000 个分组;SQL 只支持项目文档列出的子集,也没有跨文档事务。
查 Kafka:指定分区和起点
打开 Topic 的消息表格,选择分区,然后选择 earliest、offset 或时间起点。下面这个例子读取分区 0 的前一批消息:
SELECT * FROM "demo-topic"
WHERE partition = 0 AND offset >= 'earliest' LIMIT 100;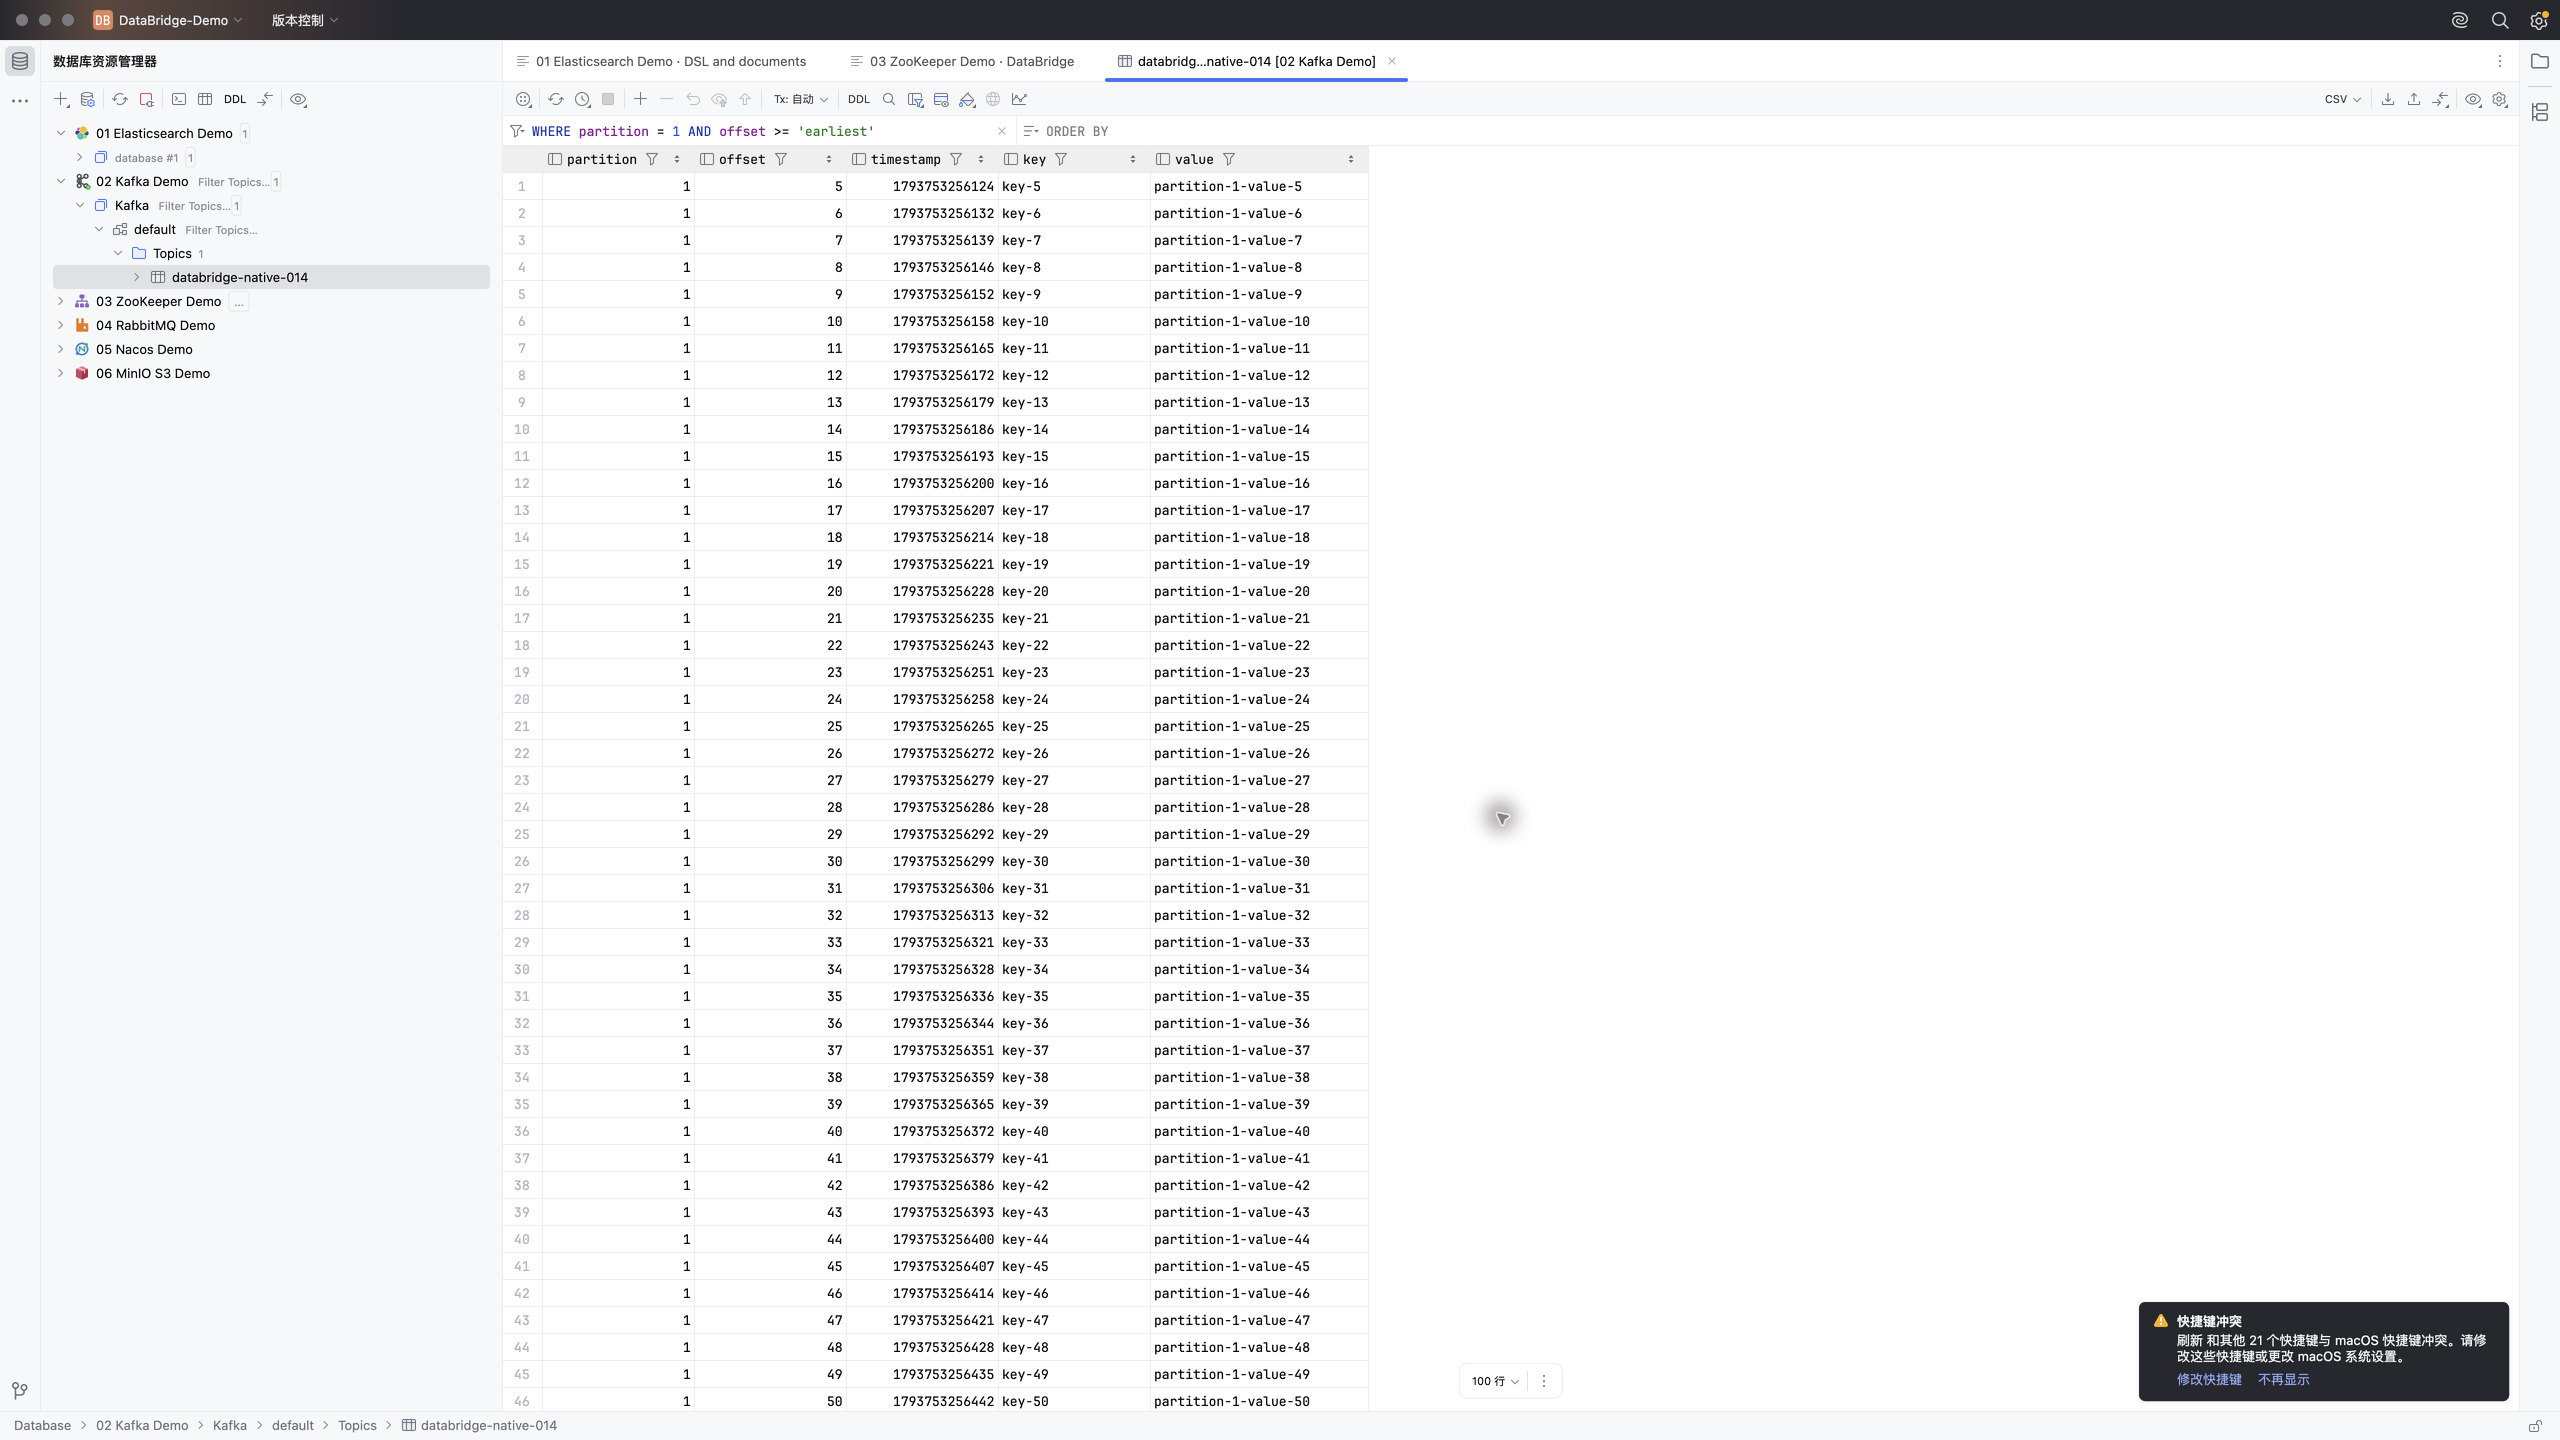
Kafka 消息表格:分区、位点与消息内容
每批最多 100 条,可以继续读下一批,JSON 内容可以格式化查看。这里不加入业务消费组,也不提交消费组位点。它是只读检查入口,业务消费还是交给应用里的 Kafka 客户端。
ZooKeeper:路径范围要先确认
连接示例中的 /app 是 chroot。如果只想看某个子树,可以在连接中限定路径。展开节点后,详情页显示数据、Stat 和 ACL;使用 digest 认证时,在连接配置里填写认证信息。
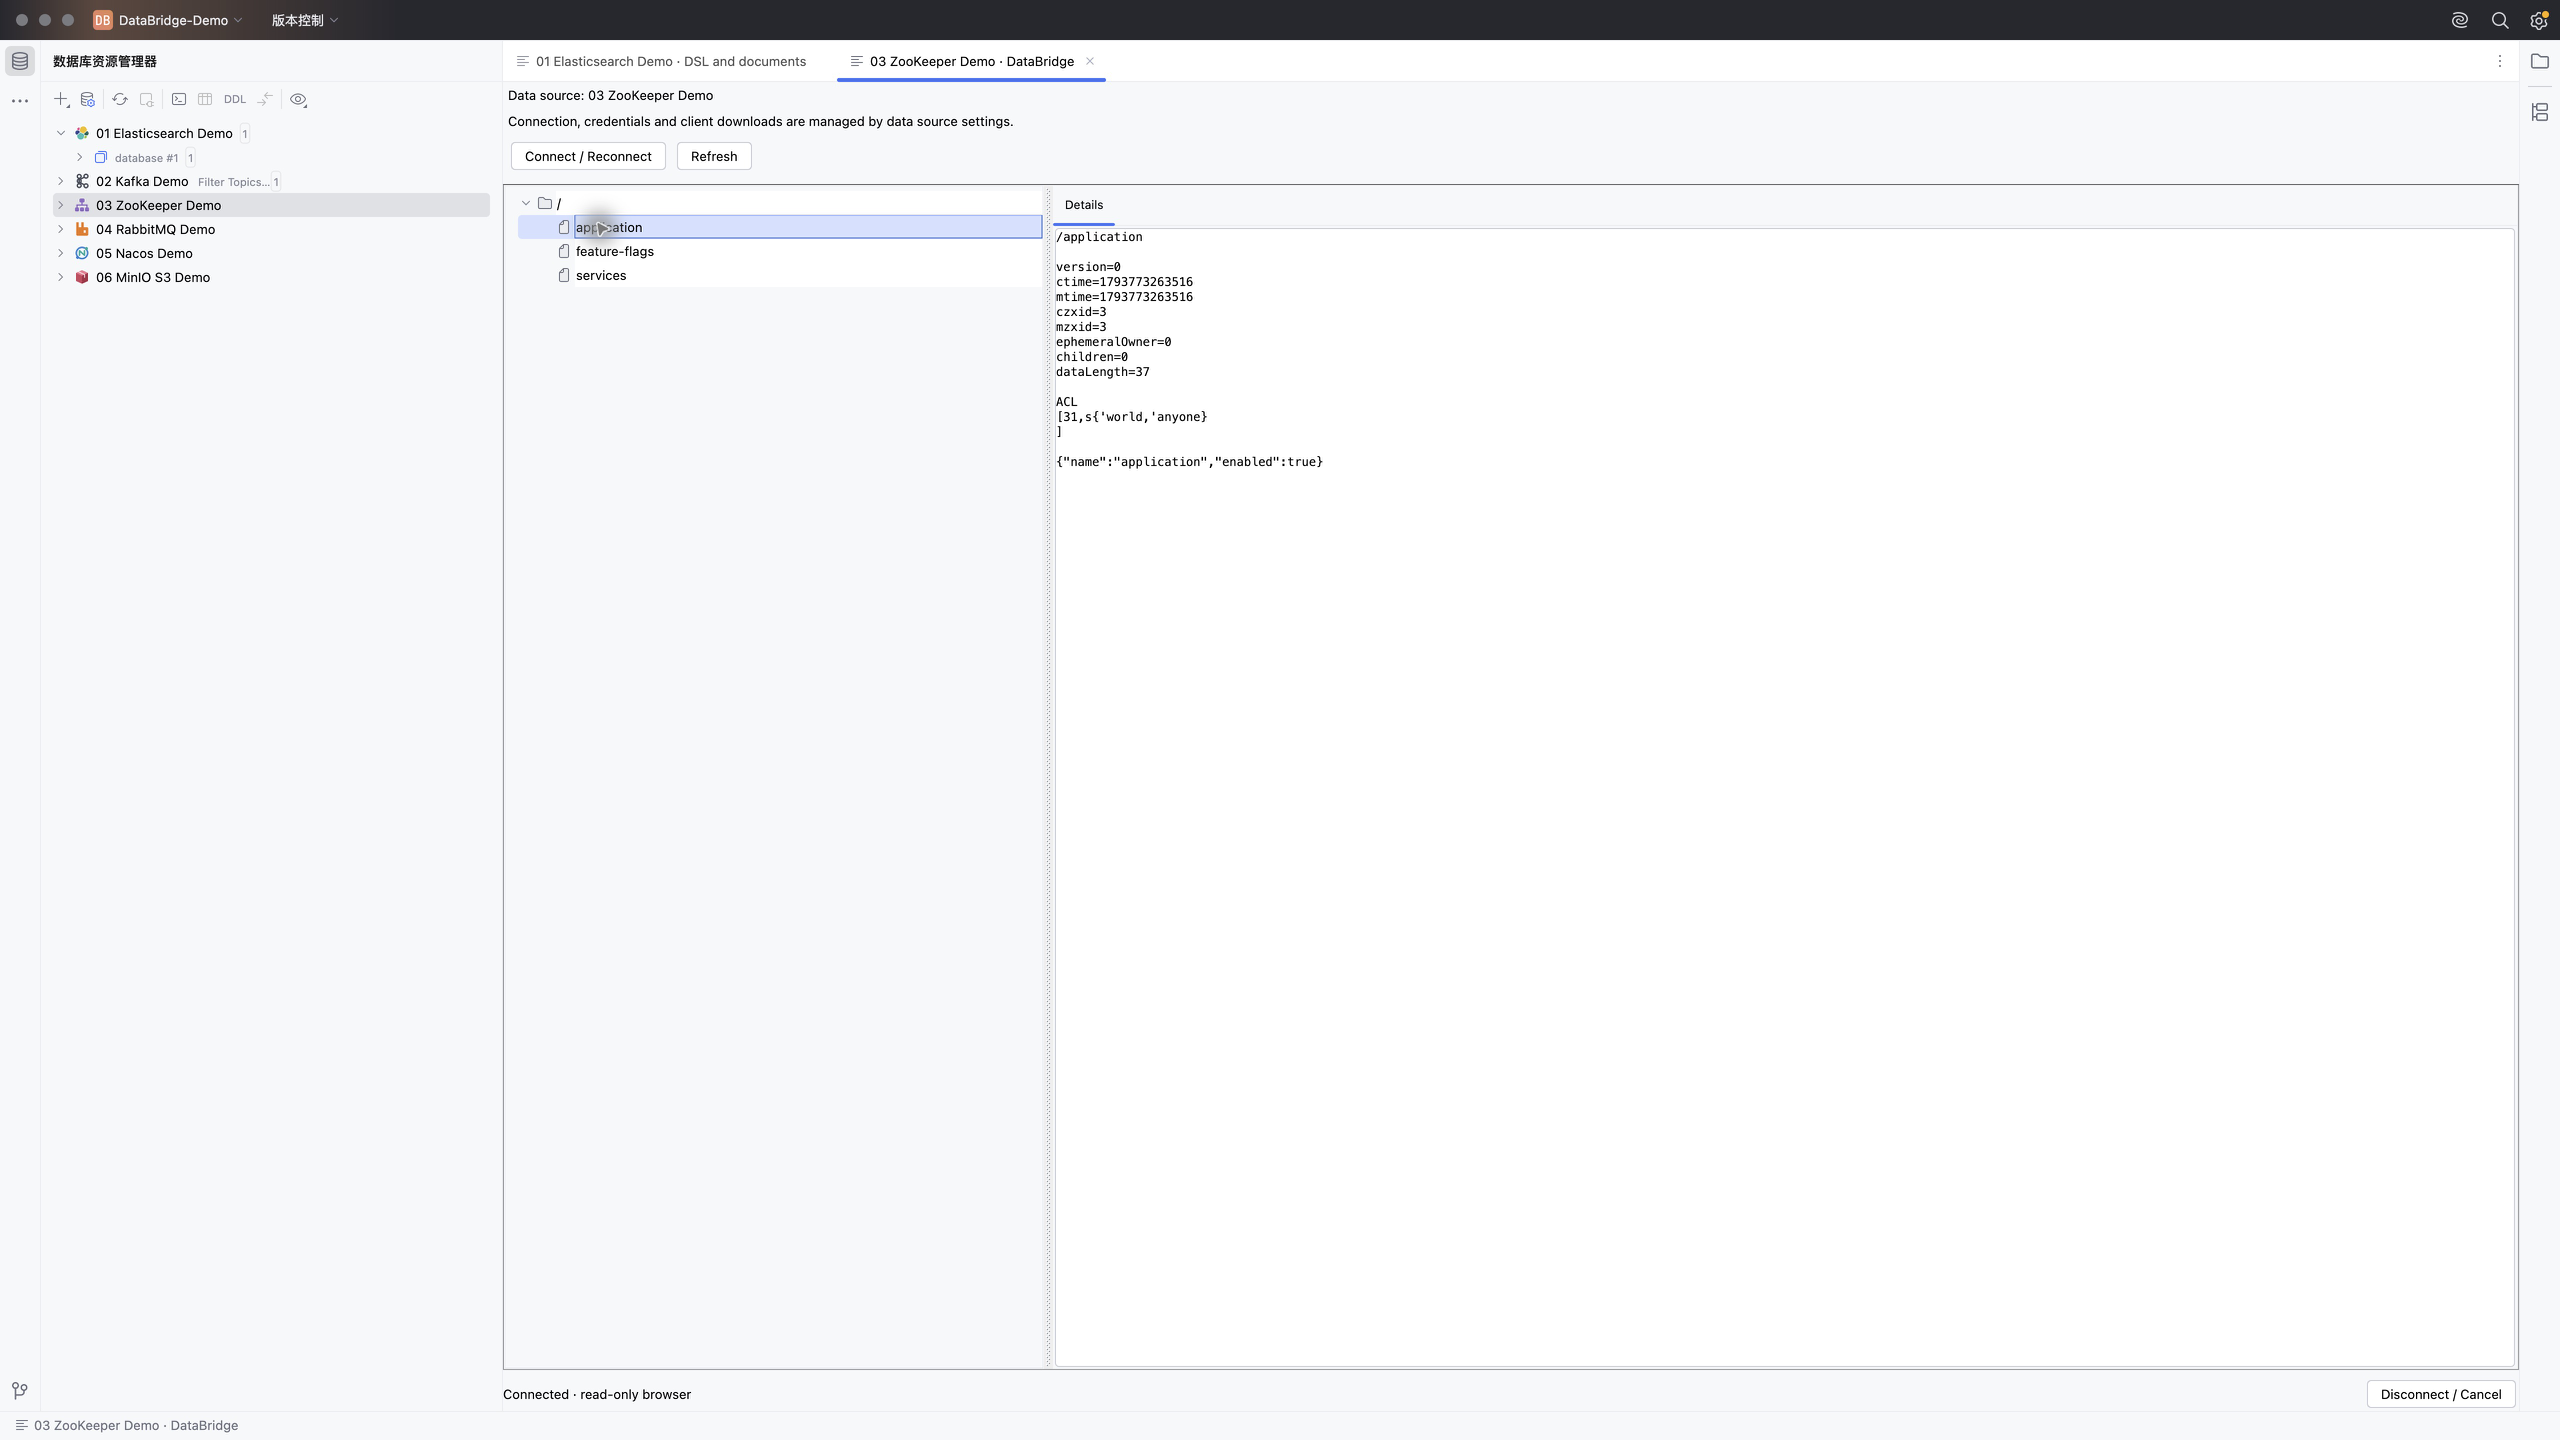
ZooKeeper 节点数据、Stat 与 ACL
这个适配器只读。查询使用根节点和直接子节点的有限快照,不会无限递归扫描整棵树。
RabbitMQ:注意连接的是管理接口
RabbitMQ 连接使用 Management HTTP API,示例端口是 15672,不是 AMQP 的 5672。连接后可以查看队列、交换机和绑定等资源。
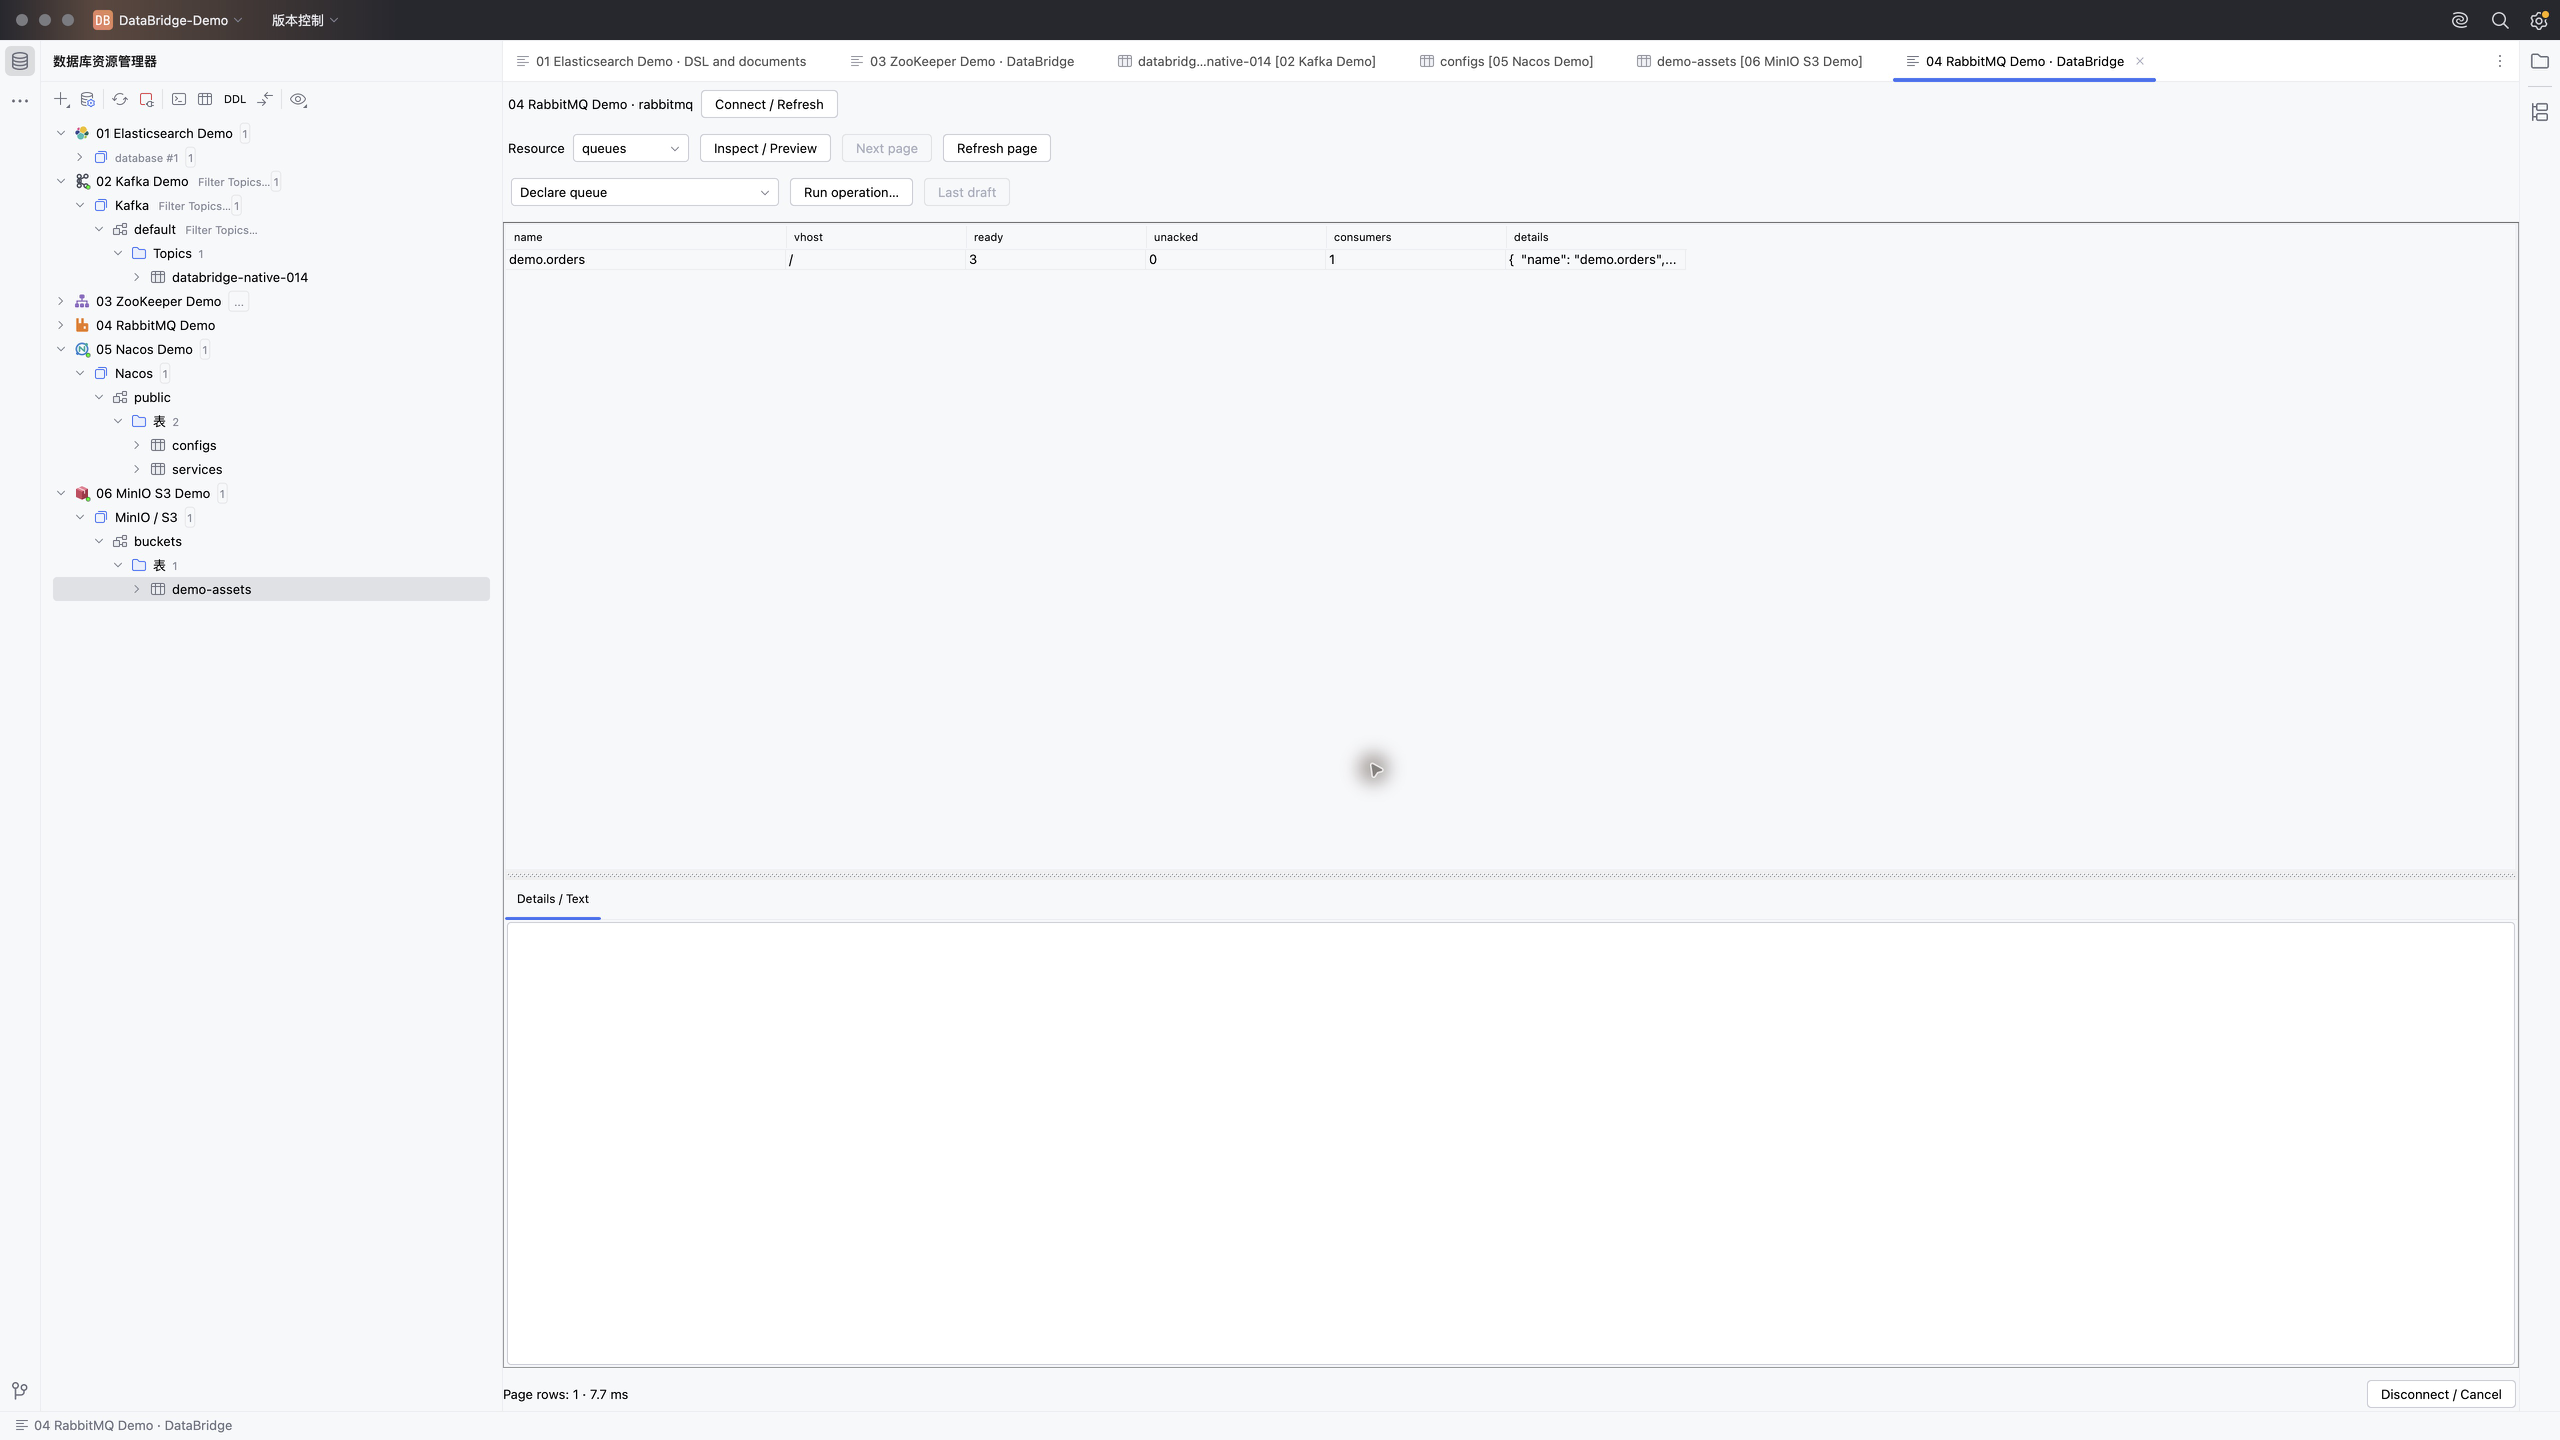
RabbitMQ 资源列表
取消息、重新入队和发送调试消息都有单独入口。重新入队也可能改变消息顺序和 redelivered 标志,操作前需要确认服务端权限及数据源的只读设置。
Nacos 和对象存储:从资源树进入表格
Nacos 按命名空间组织配置和服务。打开配置表格,可以核对配置内容;打开服务表格,可以查看注册信息。
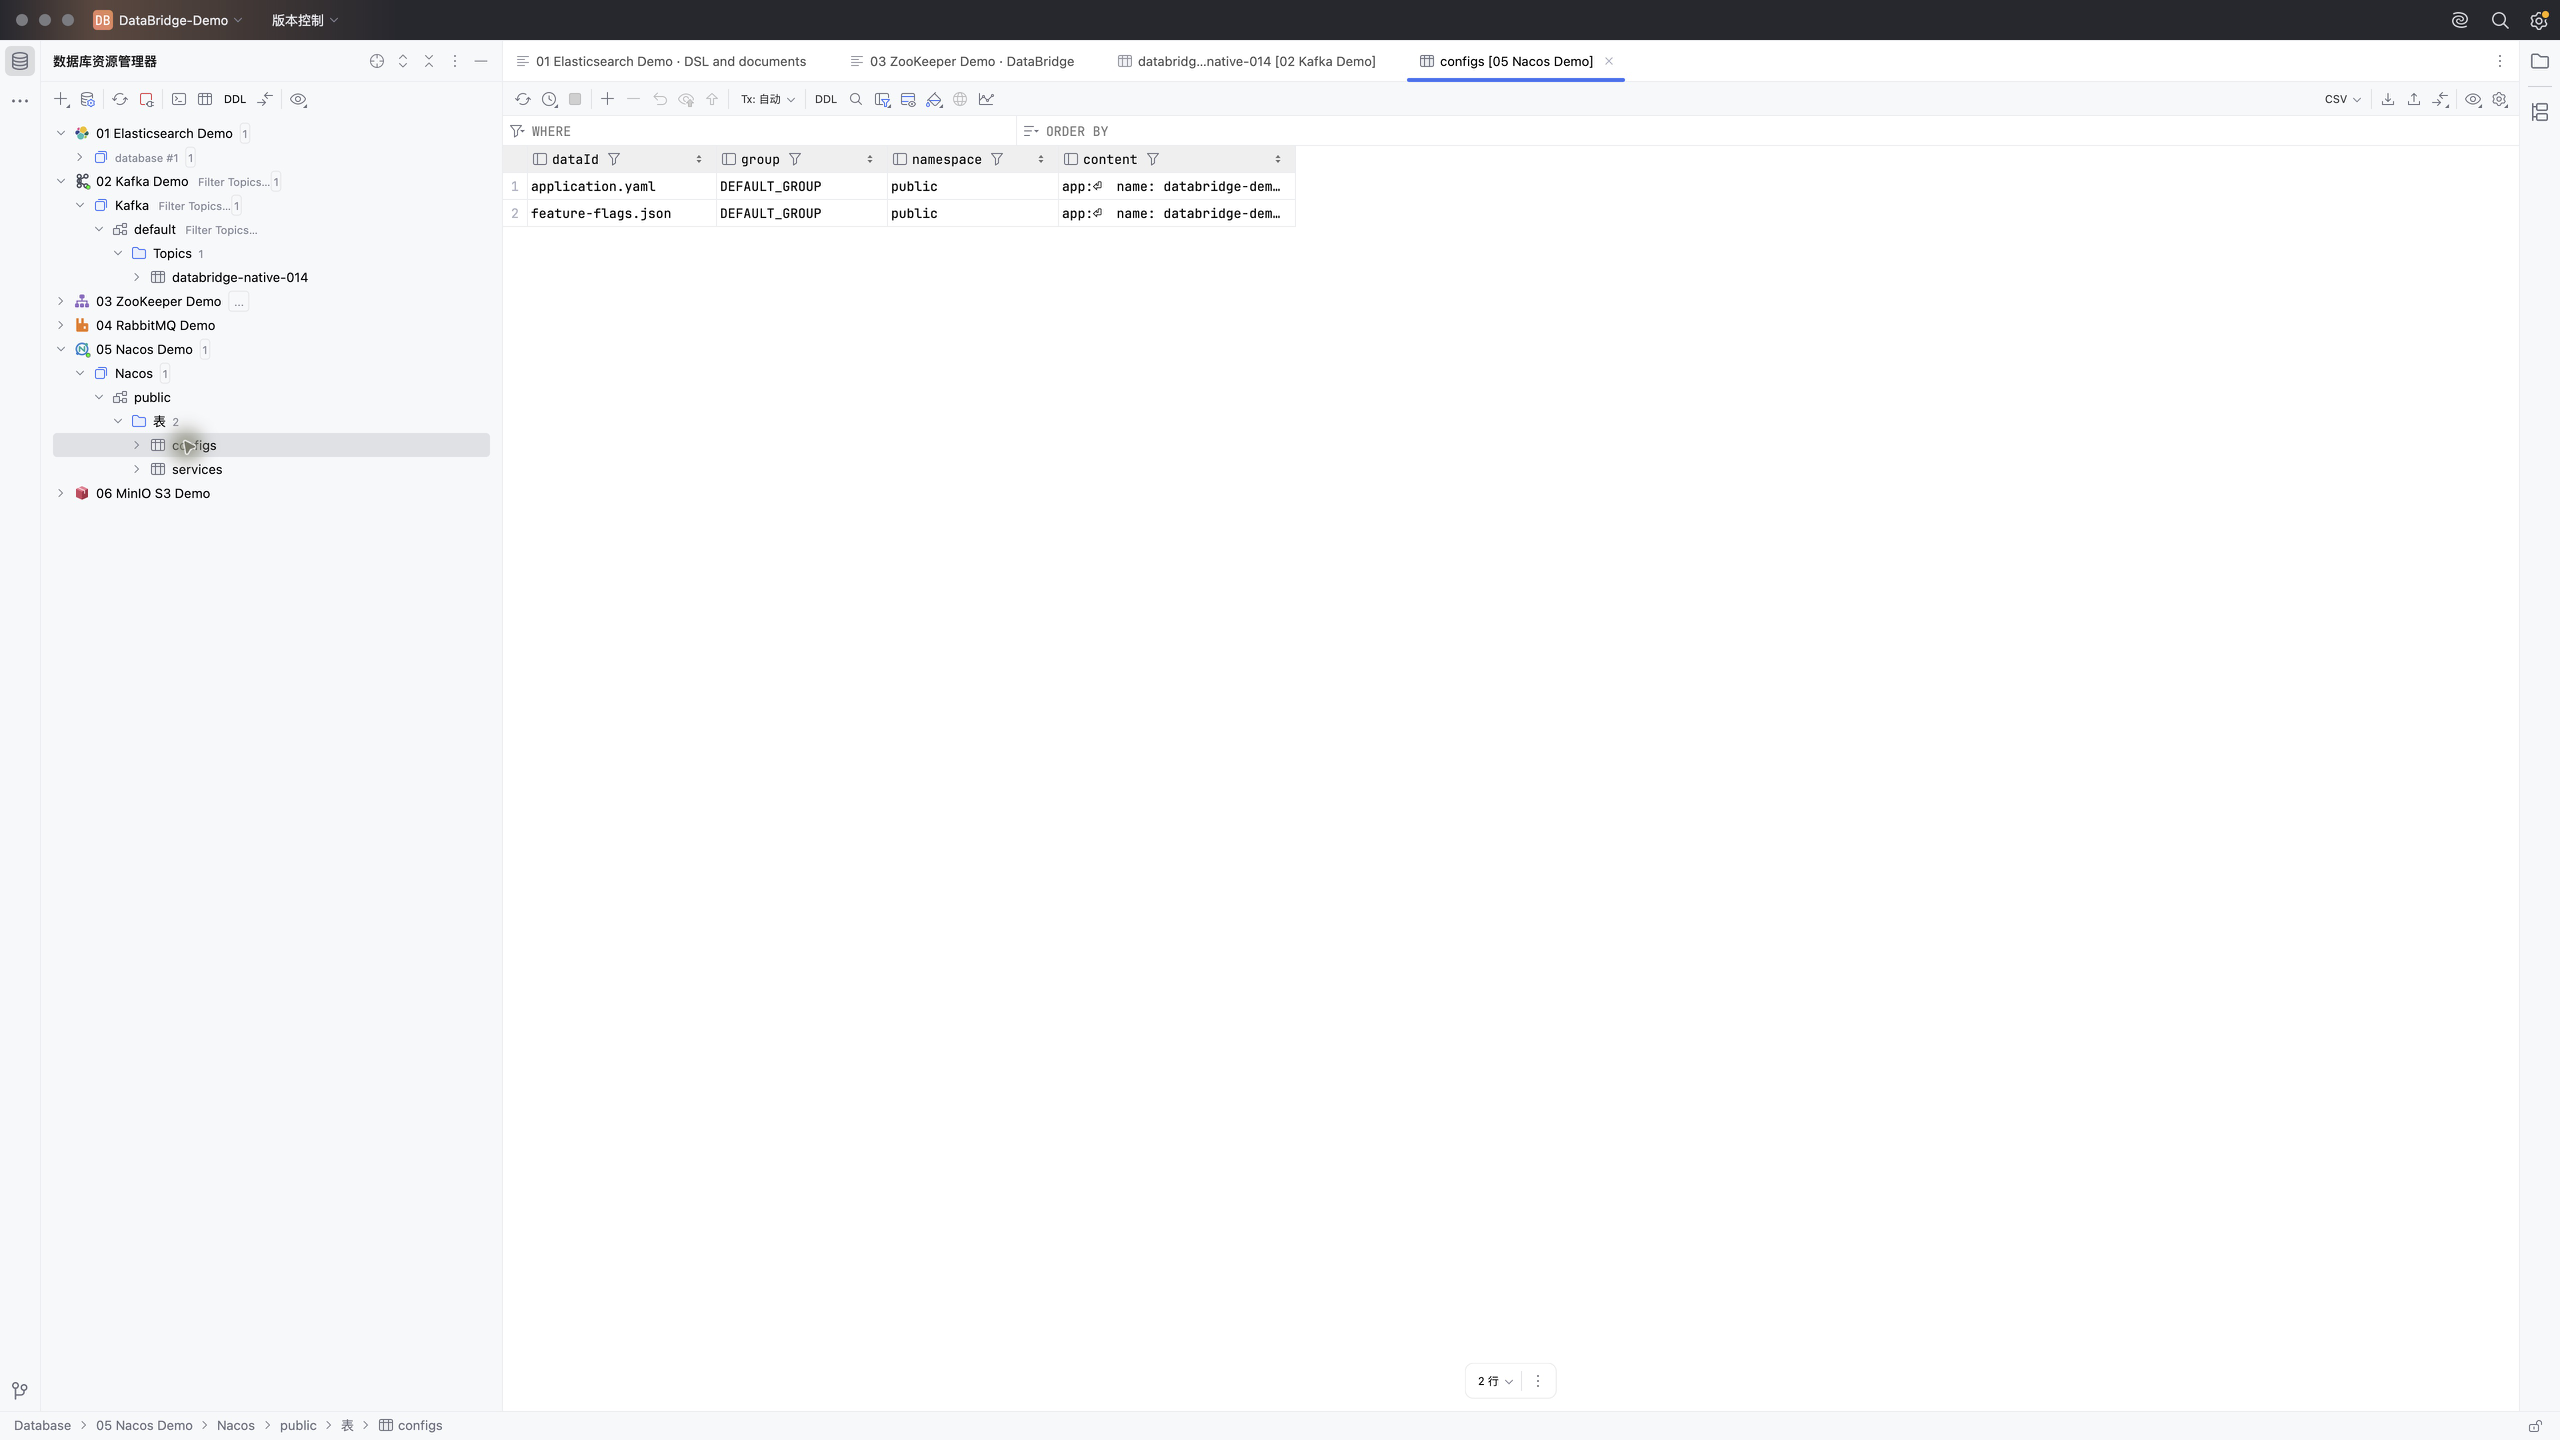
Nacos 配置表格
MinIO/S3 先选 Bucket,再看对象列表。对象较多时用 Prefix 缩小范围。macOS 上可以预览图片和系统支持的 PDF、Office、媒体文件。
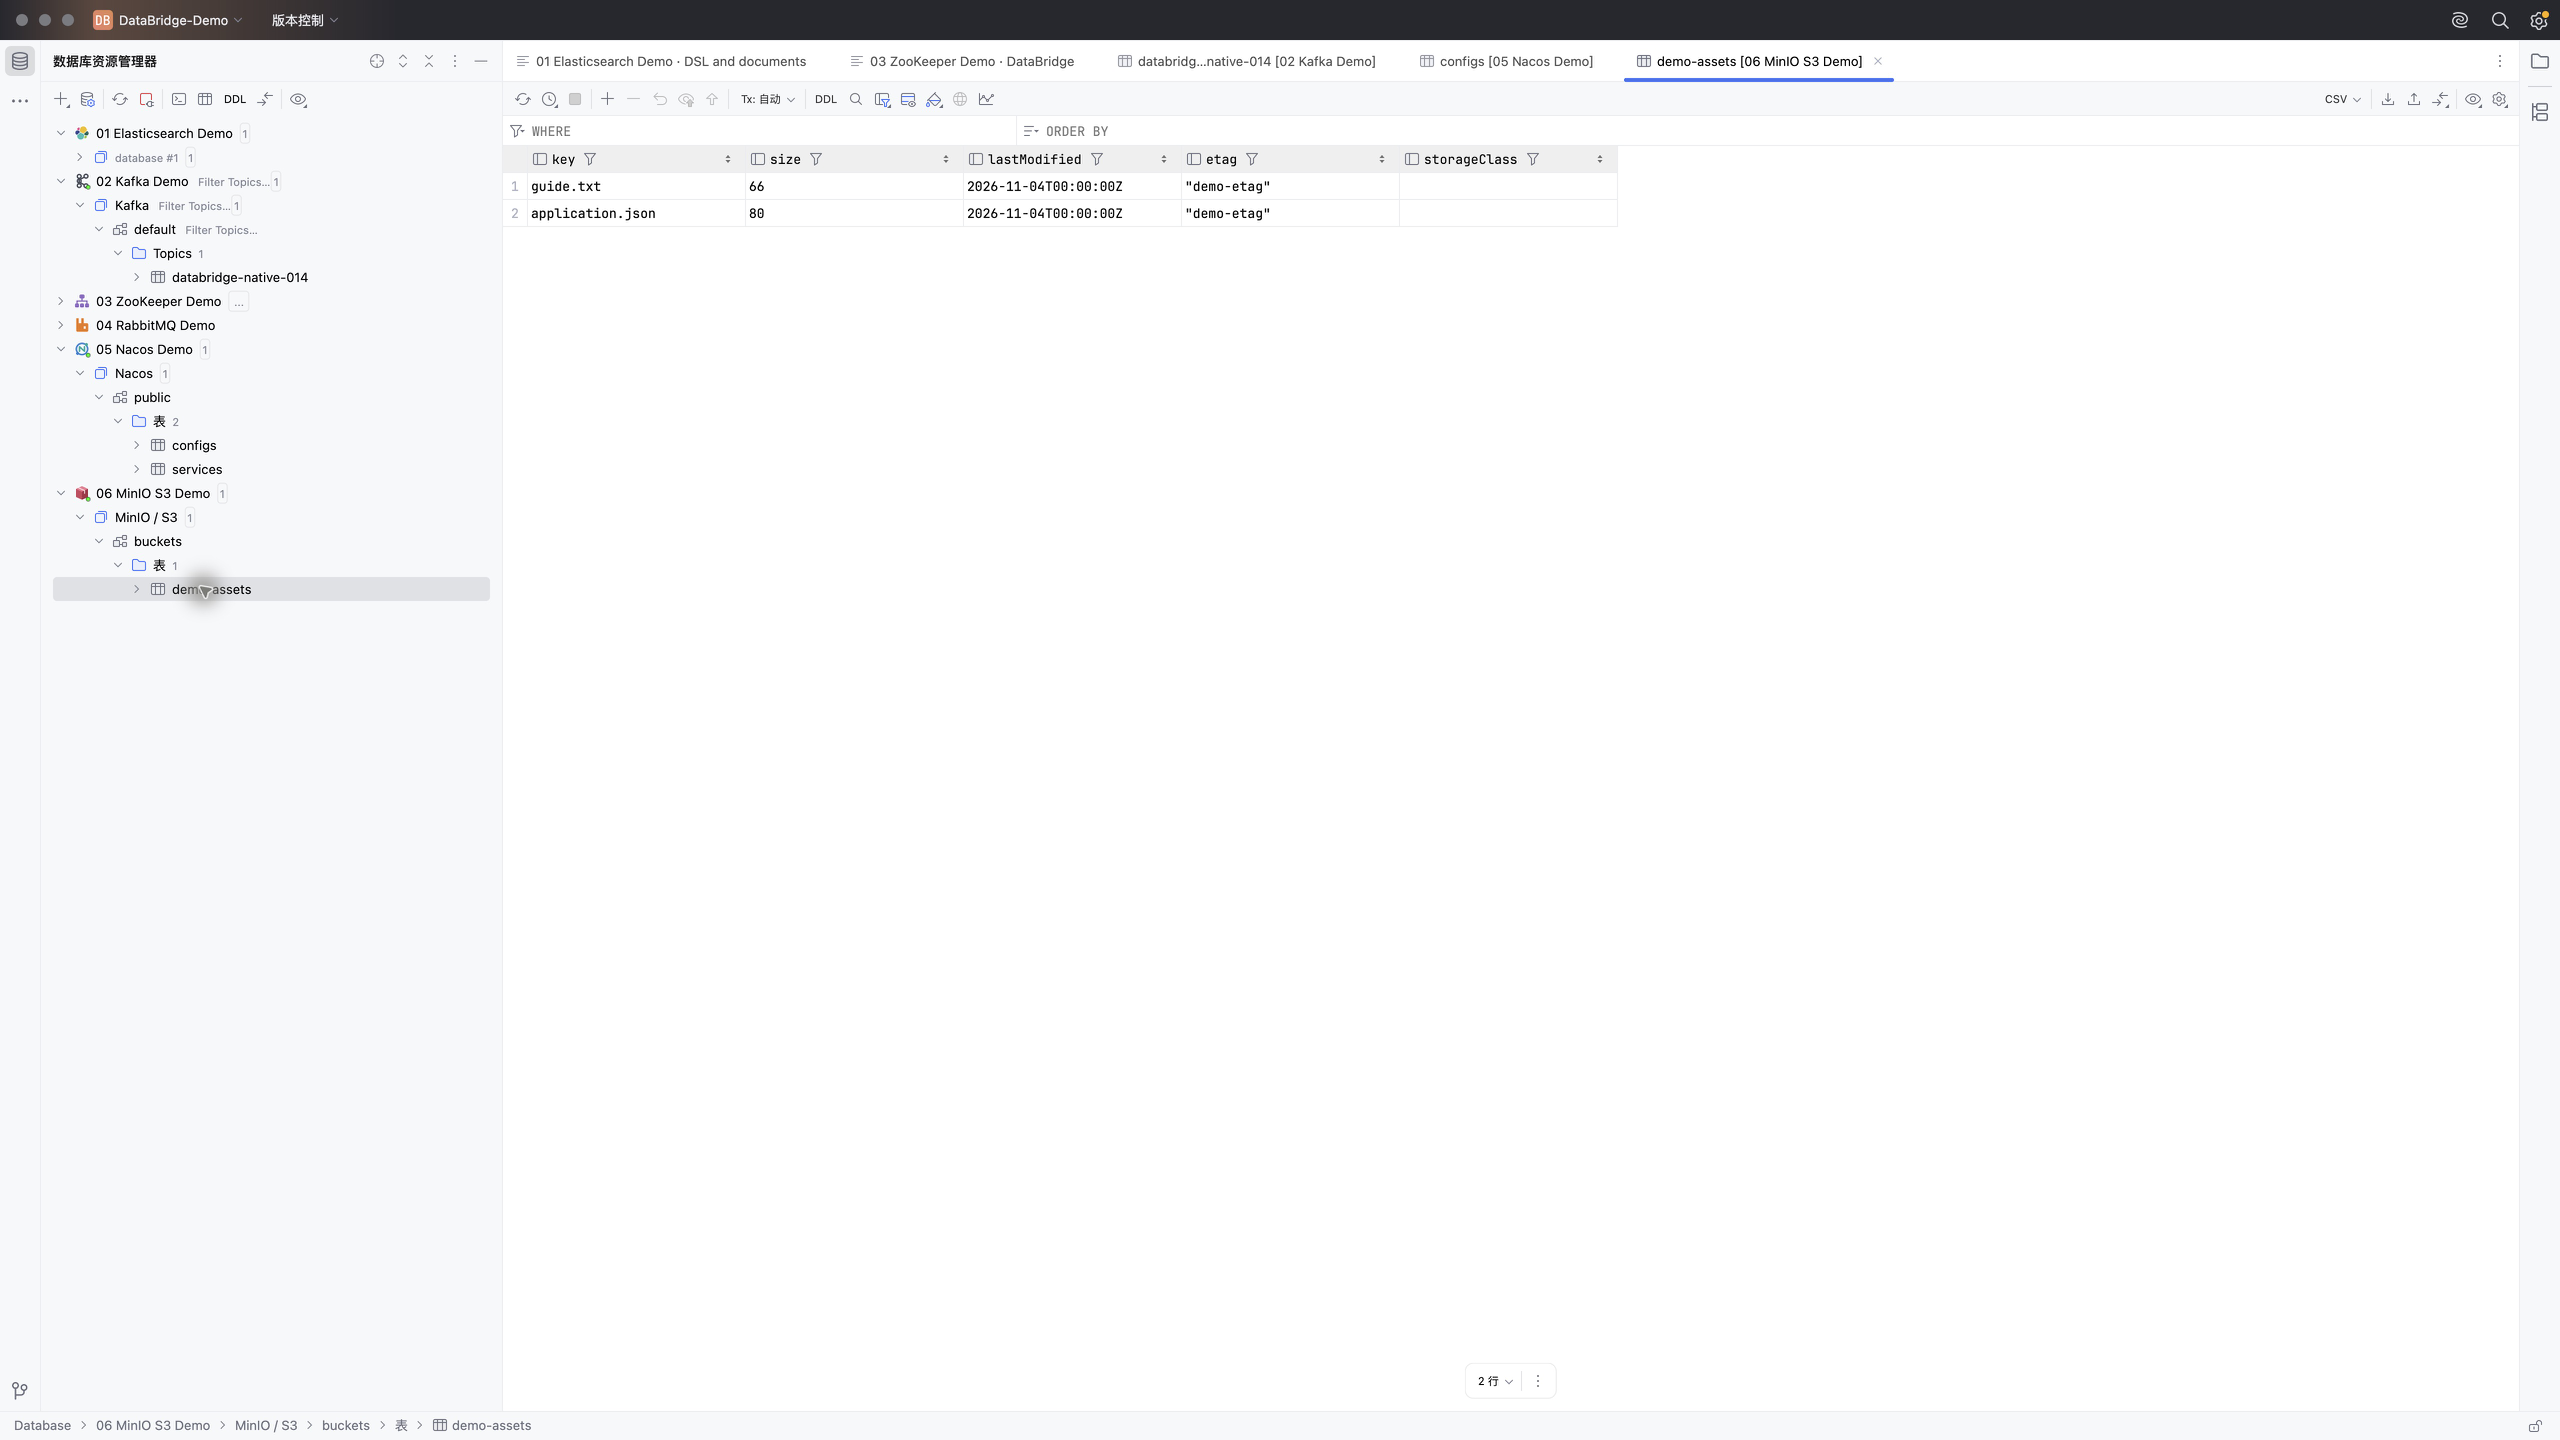
MinIO/S3 对象表格
这两个适配器的原生表格目前只读。本文不包含上传对象、删除对象或修改 Nacos 配置的操作说明。
操作视频与演示范围
下面的视频按安装、连接、查询的顺序展示界面。视频是截图配音教程,使用美式英语合成女声,保留中英文字幕。
截图中的 IDE 是 DataGrip 2026.2.6,数据来自本机合成数据,部分演示使用协议夹具。截图用于说明界面位置,不代表所有服务端版本都已验证。Kafka、ZooKeeper、Nacos 和 S3 表格的只读限制已在对应步骤说明。
本文文字整理使用 AI 辅助,操作说明依据项目实现与已有验证记录。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号