#WorkBuddy# 300 个页面抽正文:正则剥标签只对了 32%,62% 的输出是导航和评论
原创
#WorkBuddy# 300 个页面抽正文:正则剥标签只对了 32%,62% 的输出是导航和评论
原创
用户12784192
发布于 2026-11-05 10:36:00
发布于 2026-11-05 10:36:00
#WorkBuddy# 300 个页面抽正文:正则剥标签只对了 32%,62% 的输出是导航和评论
抓网页正文这件事,看起来像是"把标签去掉"这么简单。我一开始也这么想:re.sub(r"<[^>]+>", "", html),一行代码,跑 300 个页面不到一秒。结果精确率 32.20%——输出的 95.8 万个字符里,只有 30.8 万是正文,剩下 65 万全是导航条、侧栏推荐、十二条评论、页脚备案号和广告位。
这篇文章把同一份 300 页语料喂给三档方案,把"到底错在哪"拆成可复现的数字,再给出八步流水线。所有数字都是本机真实跑出来的,脚本在文末。
一、痛点:能跑通,但结果没法用
批量抓取最常见的需求是"把 N 个页面存成干净文本,再喂给检索或模型"。朴素的写法有两个典型版本:
版本一,正则剥标签。优点是一行、快;缺点是它不知道 <script> 里也有字。
版本二,取"文本最长的那个 div"。这个思路已经比版本一聪明,但它仍然假设"字多的地方就是正文",而真实页面里评论区的字数经常超过正文。
我按这两版各写了一档(A、B),再加一档治理式(C),语料是 300 个合成页面:
300 页 / 3.45 MiB / 真值 399,554 字 / 5,567 行 4 类模板:语义化
<article>、class="post-content"、五层嵌套 div、表格布局 4 种编码:utf-8 220 页、gbk 有声明 38 页、gbk 无声明 28 页、utf-8-sig 14 页 4 类畸形:未闭合<p>、属性不带引号、多删</div>、完好对照 每页噪声:24 条导航、18 条侧栏推荐、12 条评论、4 个广告位、标签云、作者卡、分页器、Cookie 提示
@@FIG1@@
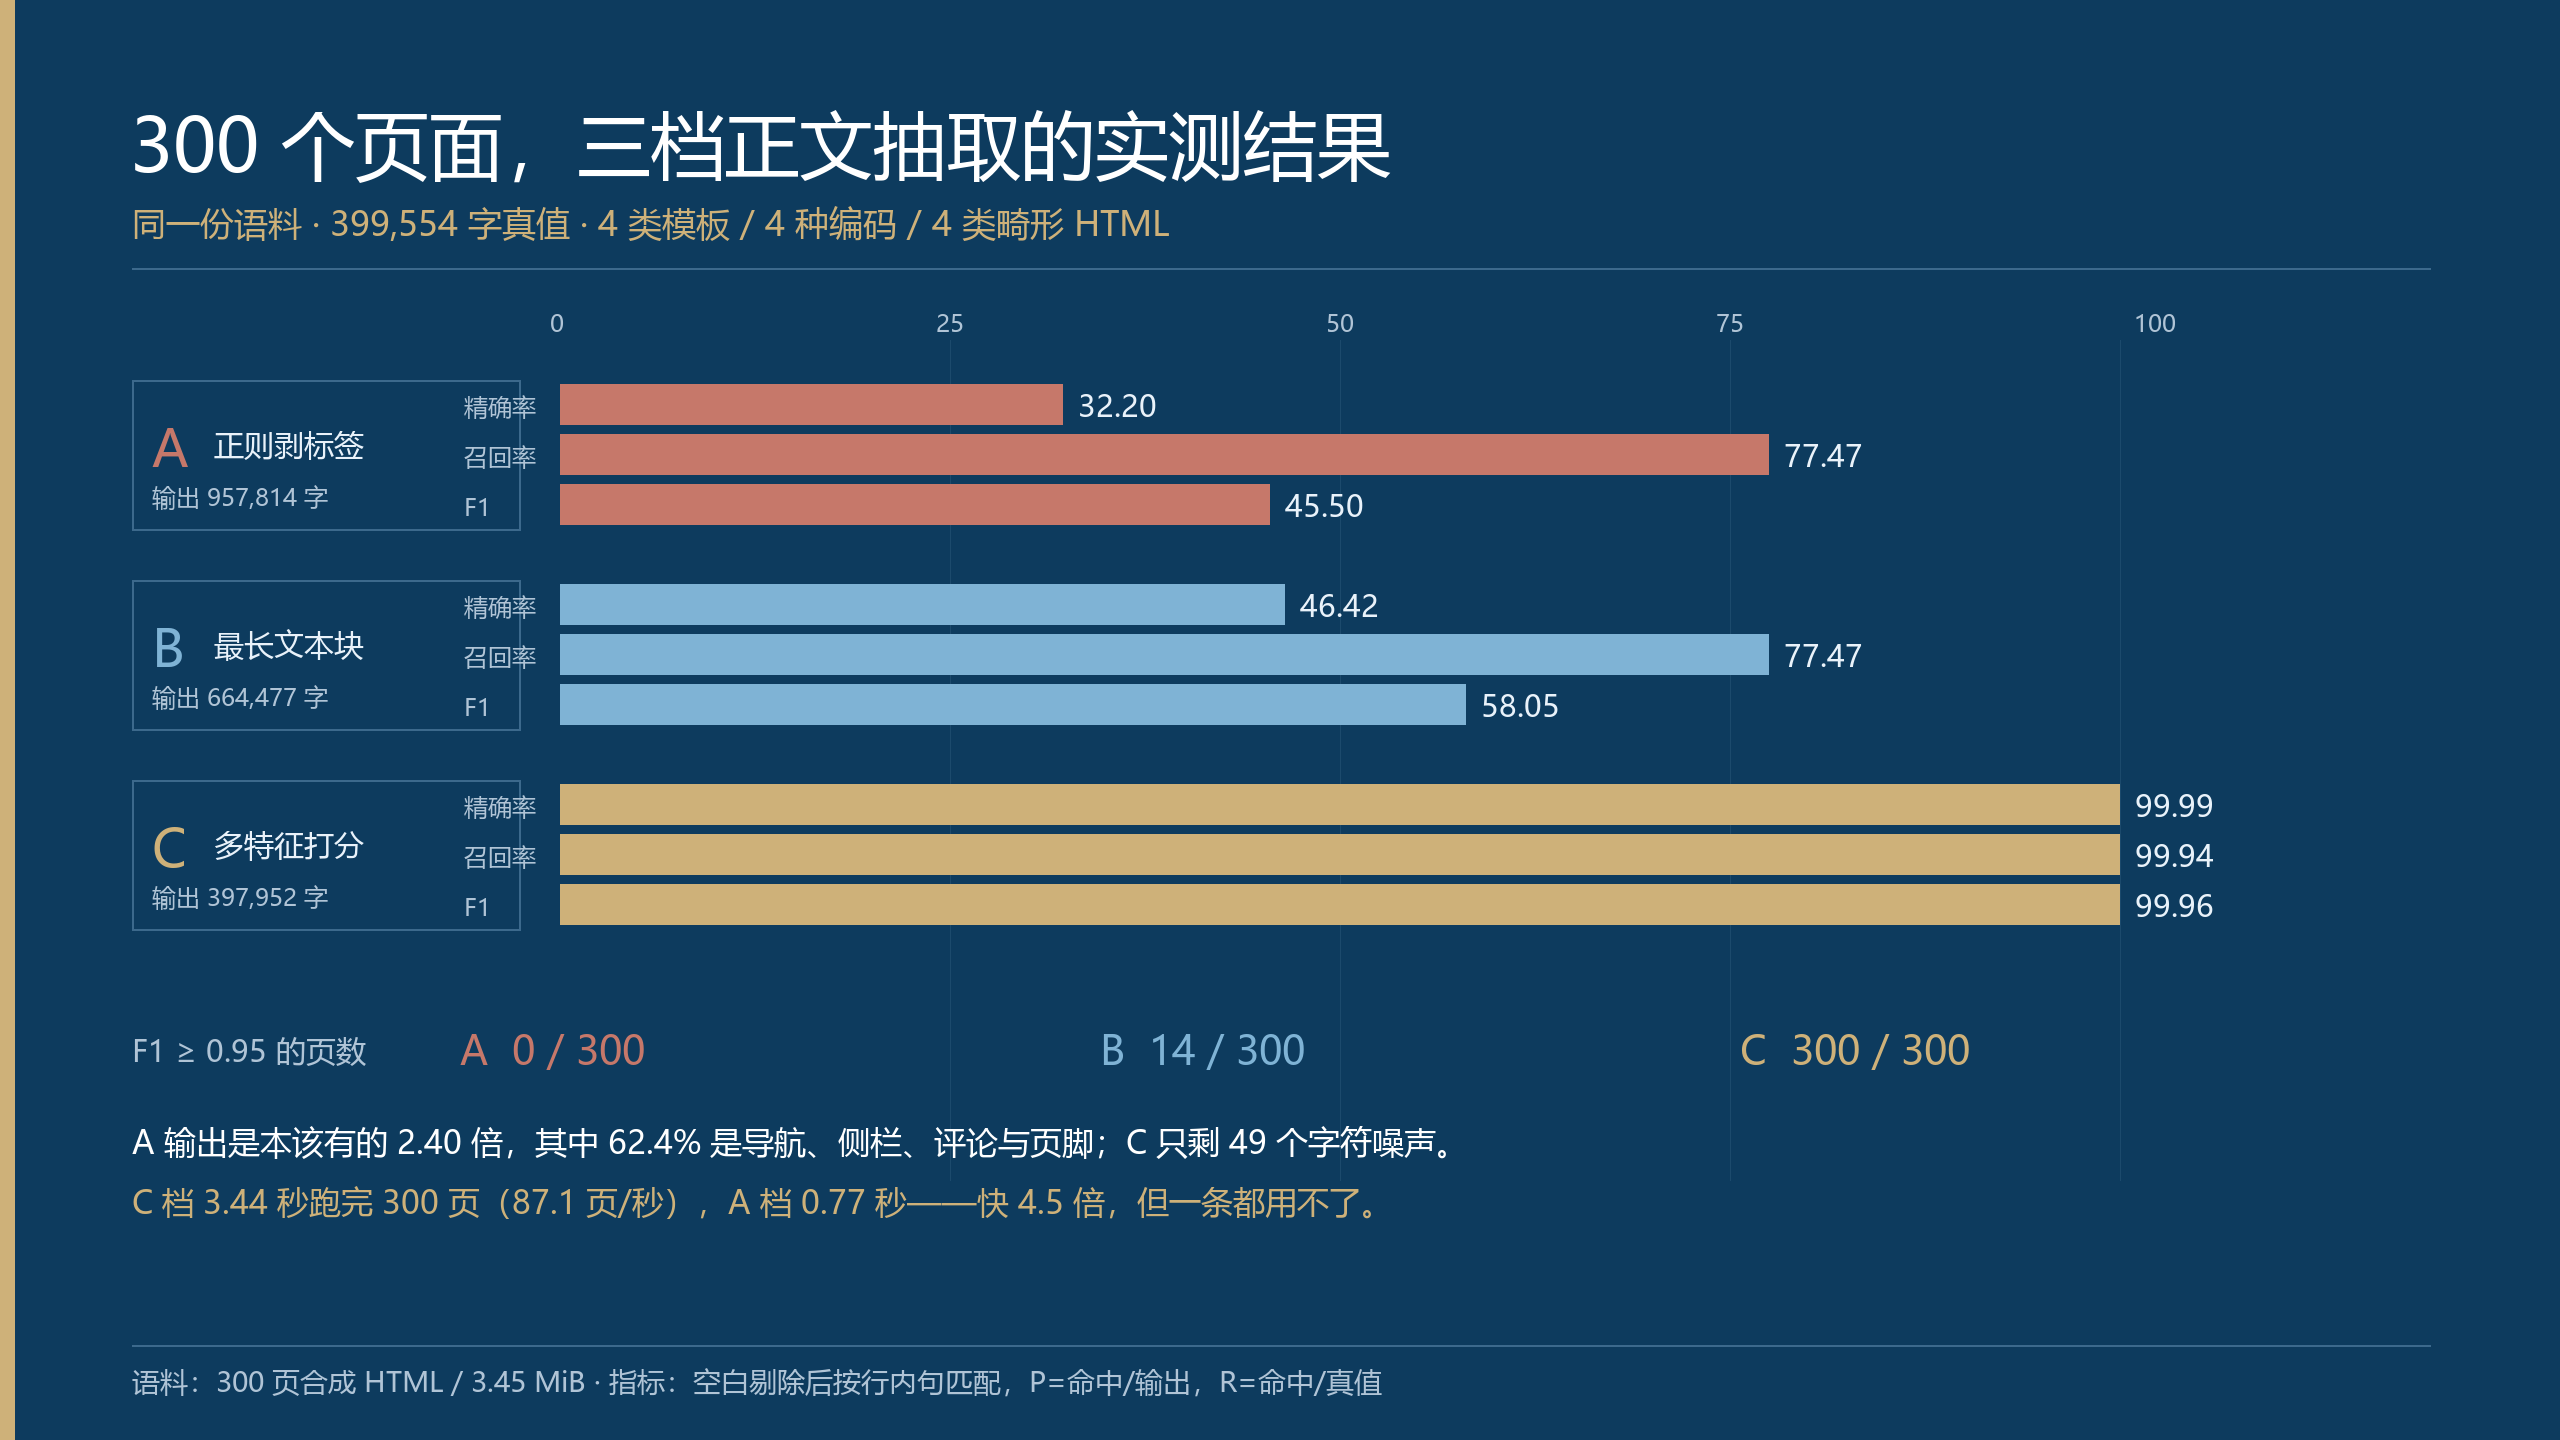
三档的差距不是"好一点"和"差一点",而是"能用"和"不能用":
档位 | 做法 | 精确率 | 召回率 | F1 | 输出字符 | 噪声字符 | F1≥0.95 页数 | 耗时 |
|---|---|---|---|---|---|---|---|---|
A | 正则剥标签 | 32.20% | 77.47% | 45.50 | 957,814 | 649,365 | 0 / 300 | 0.77 s |
B | 最长文本块 | 46.42% | 77.47% | 58.05 | 664,477 | 356,028 | 14 / 300 | 2.91 s |
C | 多特征打分 | 99.99% | 99.94% | 99.96 | 397,952 | 49 | 300 / 300 | 3.44 s |
A 档输出是应该有的 2.40 倍,B 档是 1.66 倍。注意 A 和 B 的召回率完全一样(77.47%)——因为两者的失败点根本不在"多抓",而在于都对编码和畸形结构无能为力,那 22.53% 的正文压根没进输出。
二、根因:五个通道,让噪声混进正文
把 A 档的输出按"去掉某类节点前后的字符差"拆开,构成是这样的:
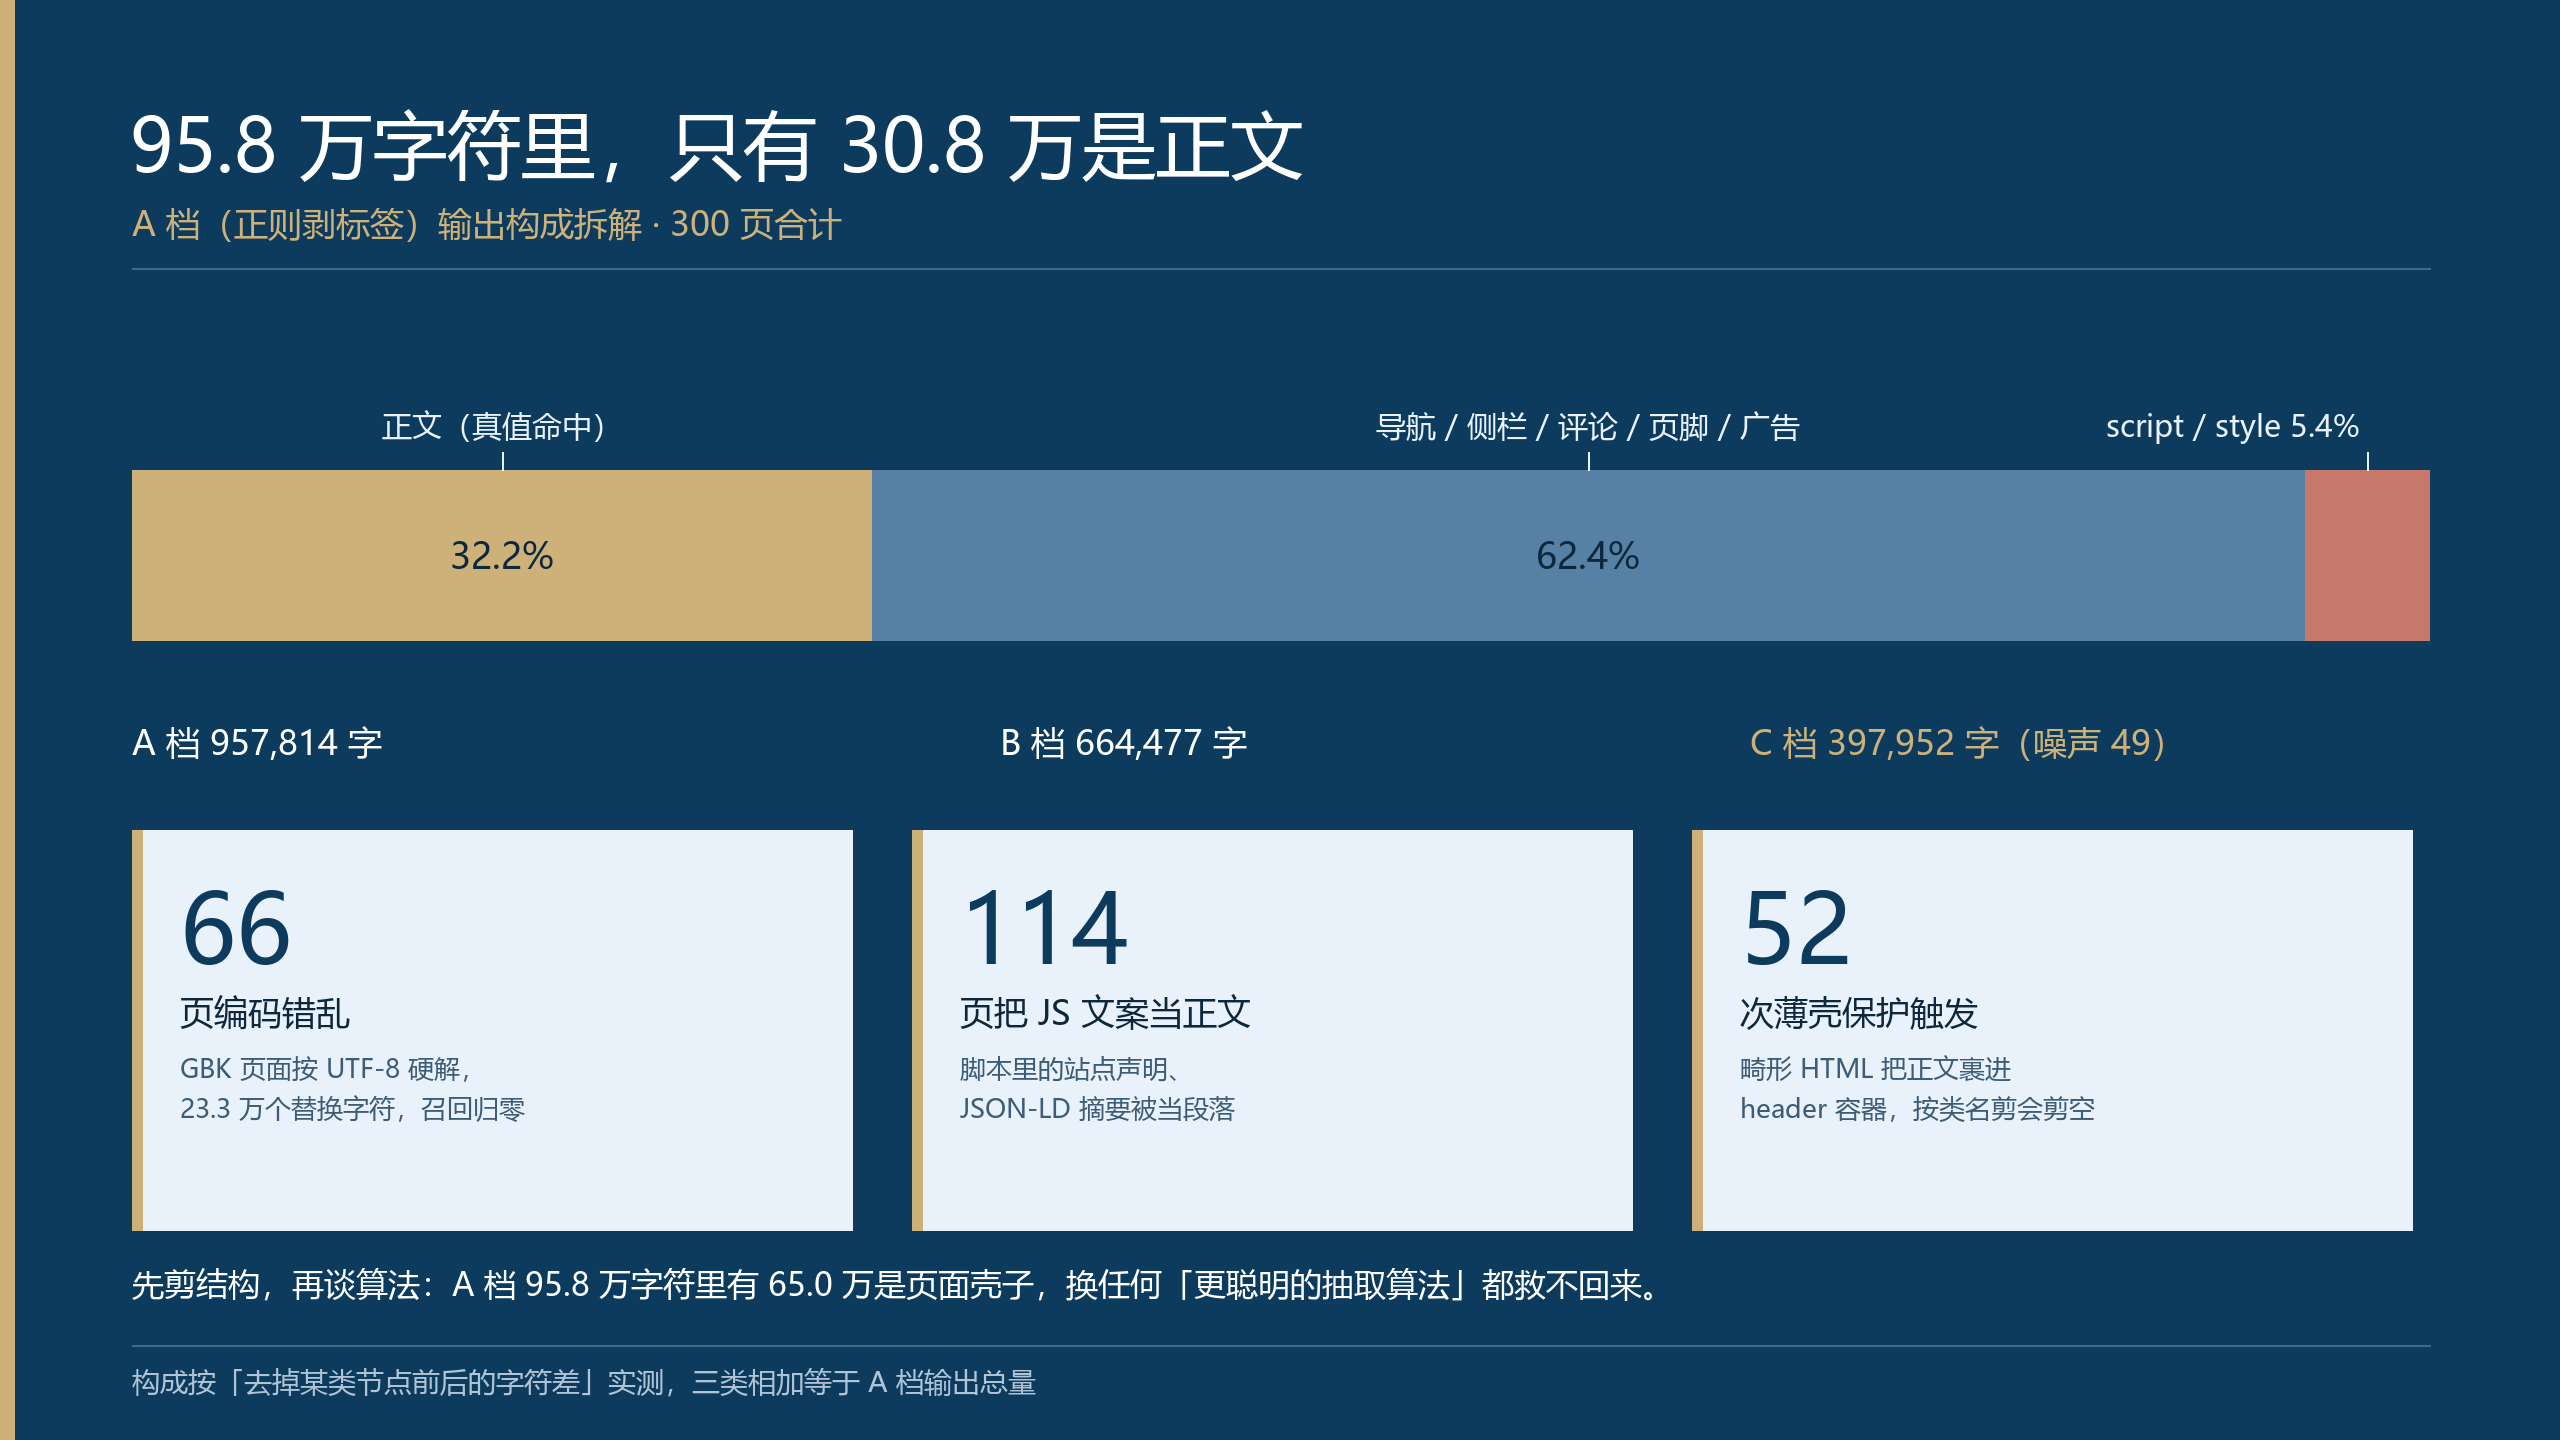
- 正文 308,449 字(32.2%)
- 版式噪声 597,627 字(62.4%):导航、侧栏、评论、页脚、广告、标签云、作者卡、分页器
- script / style 51,738 字(5.4%):114 个页面里,脚本中的站点声明"本文由示例社区原创发布,转载请注明出处"被当成了正文段落
五个混入通道,各自的机制不同:
1. 脚本与样式的内容不是"标签属性",而是文本节点。 剥标签只去掉 <...>,<script>window.__INITIAL_STATE__={"tip":"…"}</script> 里的 JSON 字符串会原样留下。114/300 页中招。
2. 编码错,召回直接归零。 66 个页面出现 233,445 个 U+FFFD 替换字符。GBK 页面按 UTF-8 硬解,每个汉字变成 1~2 个"�",正文一个字都匹配不上。
3. 版式容器的文本量和正文同一量级。 我的语料里 24 条导航 + 18 条侧栏 + 12 条评论 + 页脚 + 广告,合计约 2,000 字,而正文平均 1,332 字。也就是说,任何"取最长文本块"的策略在这个语料上必然选错——B 档 14/300 的合格率就是这么来的。
4. 畸形 HTML 会把正文吞进噪声容器。 这是最阴的一条。少写两个 </div>,浏览器和 lxml 都会把后面的正文当成 class="header" 的子节点。此时"按类名剪枝"会把整页正文一起剪掉。实测这种结构在 300 页里出现 52 次。
5. 标题没有独立通道。 <h1> 如果落在被剪掉的容器里,标题就空了;而下游检索、切分、摘要全都依赖标题。
三、八个步骤,一步管一类失败
@@FIG3@@
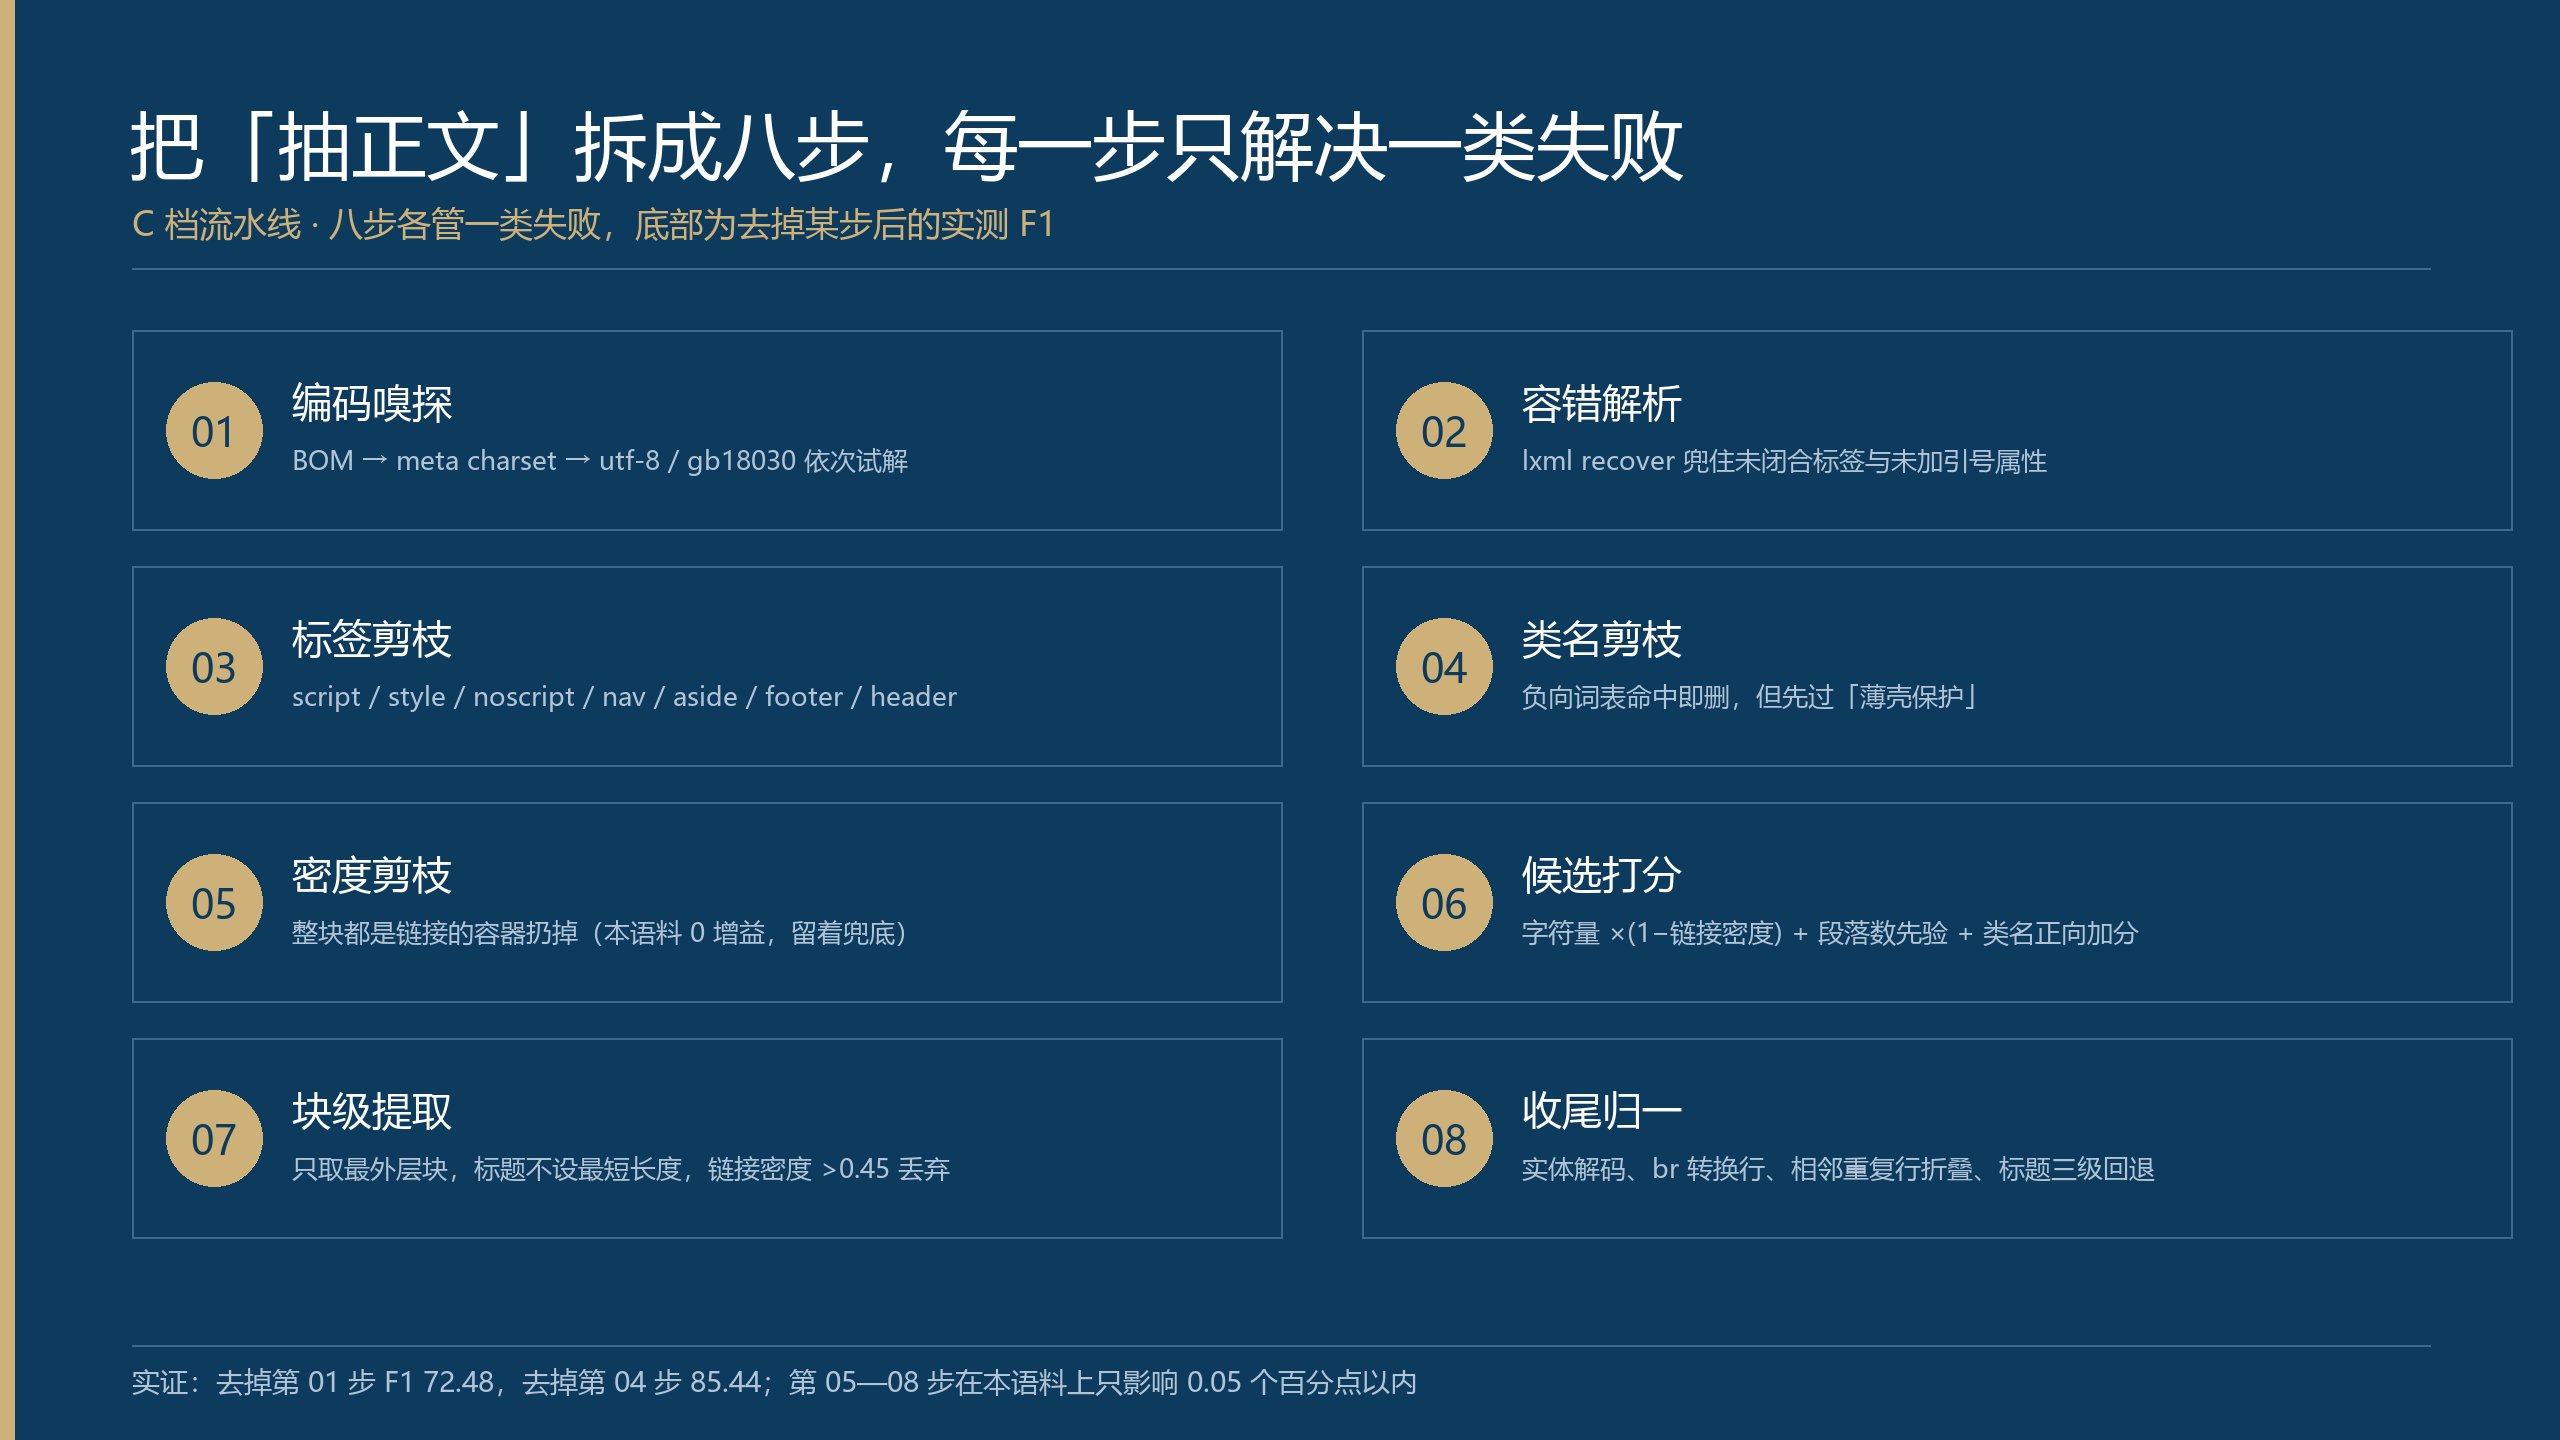
流水线的顺序不是随便排的,它对应上面的五个通道:先修编码(不然什么都匹配不上),再保结构(不然剪枝会剪空),然后才谈打分。
第一段代码是编码嗅探与容错解析,这是整条链路的地基:
import re
from lxml import html as LH

def decode_smart(raw: bytes):
    if raw.startswith(b"\xef\xbb\xbf"):                 # BOM 优先
        return raw[3:].decode("utf-8", "replace"), "utf-8-sig"
    head = raw[:4096].decode("latin-1", "ignore").lower()
    m = re.search(r'charset\s*=\s*["\']?\s*([a-z0-9_\-]+)', head)
    cands = ([m.group(1)] if m else []) + ["utf-8", "gb18030"]
    for c in cands:
        try:
            return raw.decode("gb18030" if c in ("gbk", "gb2312") else c), c
        except (UnicodeDecodeError, LookupError):
            continue
    return raw.decode("utf-8", "replace"), "utf-8/replace"

def parse(raw: bytes):
    txt, enc = decode_smart(raw)
    return LH.fromstring(txt), enc          # lxml 自带 recover,畸形标签不抛异常
第二段是剪枝与提取的核心。注意 doc_len 和那个 npg >= 3 的判断——它就是"薄壳保护",没有它,畸形页面会把正文剪光:
NEG = re.compile(r"(^|[-_ 0-9])(nav|menu|header|footer|side|comment|cmt|ad|ads|"
                 r"share|related|recommend|crumb|pager|tag|author|cookie)([-_ 0-9]|$)", re.I)

def prune_and_pick(doc):
    for bad in doc.xpath("//script|//style|//noscript|//iframe|//svg|//form|"
                         "//nav|//aside|//footer|//header|//comment()"):
        bad.getparent().remove(bad)

    doc_len = max(1, len(doc.text_content()))
    for el in list(doc.iter()):
        if not isinstance(el.tag, str) or el.getparent() is None:
            continue
        sig = f"{el.get('class','')} {el.get('id','')}"
        if not sig.strip() or not NEG.search(sig.replace(" ", "-")):
            continue
        L, _, npg = text_stats(el)
        # 薄壳保护:含 3 个以上段落、且占全页 35% 以上的容器不能按类名剪
        if npg >= 3 and L > 0.35 * doc_len:
            continue
        el.getparent().remove(el)

    cands = [e for e in doc.iter() if isinstance(e.tag, str)
             and e.tag in ("article", "main", "div", "section", "td", "body")]
    return max(cands, key=lambda e: score(e))
score() 的公式是:字符量 × (1 − 1.6 × 链接密度) + 55 × min(段落数, 12) + 类名正向加分。链接密度乘 1.6 再截断,是为了让"整块都是链接"的容器直接出局;段落数封顶 12,是防止 body 靠"段落多"取巧。
块级提取还有一个容易被忽略的细节:标题不能设最短长度。我第一版给所有块设了 len >= 10,结果 4 个字的 <h2>("处理流程""性能观察""常见误区")被全部丢掉,行保真率卡在 91.07%。改成标题阈值 2、正文阈值 10 之后,行保真率到 99.69%。
四、消融:哪一步真的在起作用
把八步逐个关掉,其余不动,看 F1 掉多少:
关掉的步骤 | F1 | 精确率 | 召回率 | 合格页数 | 结论 |
|---|---|---|---|---|---|
无(完整 C) | 99.96 | 99.99 | 99.94 | 300 | — |
编码嗅探 | 72.48 | 68.12 | 77.45 | 234 | 致命,等于退回 A/B 的召回水平 |
负向类名剪枝 | 85.44 | 74.59 | 99.99 | 0 | 致命,召回不掉但每页都夹带噪声 |
链接密度过滤 | 99.96 | 99.99 | 99.94 | 300 | 本语料 0 增益 |
候选打分 | 99.99 | 99.99 | 99.99 | 300 | ±0.03,仅噪声水平 |
祖先提升 | 99.95 | 99.99 | 99.92 | 300 | 可忽略 |
实体解码 | 99.94 | 99.96 | 99.92 | 300 | 只影响 151 个字符 |
这张表比"总分 99.96"有用得多。它说明:编码和类名剪枝是两个真正的开关,其余六步是保险丝。 保险丝平时不响,但换一份语料(比如整站没有语义标签、class 全叫 a1/b2)就会响。
要诚实说一句:链接密度过滤在这份语料上是冗余的,因为负向类名已经先把侧栏剪掉了。我保留它,是因为真实站点里大量容器的 class 是哈希值,类名剪枝会完全失效。同理,候选打分和祖先提升在本语料上只差 0.03 个百分点——这 0.03 不是"没用",而是"没有它也能过",两者要分清。
五、踩坑清单(都是实测撞出来的)
re.sub("<[^>]+>", "", html)会把<script>里的 JS 当正文。 114/300 页命中。必须先按标签剪枝,再剥标签,顺序反了就等于没做。- GBK 页面按 UTF-8 解码不会抛异常(
errors="replace"时),只会静默产出 23.3 万个�。必须显式strict试解 + 回退,别信"没报错就是对的"。 - 畸形 HTML 会让正文落进
class="header"**。** 52/300 页出现。任何"按类名剪"的动作都要先看它是不是裹着正文,否则一剪全空。 - 块过滤的阈值对标题是毒药。 4 字标题被
len >= 10全灭,行保真率从 99.69% 掉到 91.07%,而字符召回只掉 0.5%——只看总分根本发现不了。 <br>不能直接删。 删掉会把上下两段粘成一段,段落切分全乱。先转\n再归一空白。- 真值口径要按"浏览器显示文本"建。 我第一版拿源段落当真值,但正文里埋了
—、的这类实体,解码后多出字符,导致正确实现被判错——召回率虚低 20 个百分点。 - 评估要按行做,不能整页拼一句。 标题、小标题、首段在没有分隔符时会粘成一句,任何一处字符差异都会让整句判错,F1 被系统性压低(本次虚低约 4 个点)。
lxml的fromstring对纯空白页返回None,取.text_content()会AttributeError,批量跑要兜住。
六、给 WorkBuddy 的提示词模板
我后来把这条流水线固定成一句话交给 WorkBuddy 执行,比每次手写脚本省事:
# 提示词模板:网页正文批量抽取
# 1) 目标:把 <源目录> 下所有 .html 抽成纯文本,输出到 <输出目录>,一页一个 .txt
# 2) 硬约束:不联网、不改源文件、不删任何文件;只读源目录
# 3) 必须处理:BOM/meta charset/GBK 回退;script/style/noscript 先剪;
#    负向类名剪枝前做「薄壳保护」(段落≥3 且占全页 35% 不剪)
# 4) 输出一份 report.json:每页 编码 / 输出字符数 / 标题 / 被剪容器数
# 5) 最后按 10% 抽样,把 原文-抽取 对照贴出来,我要人工核一遍
四个约束里最有用的是第 5 条。批量脚本最大的风险不是跑不通,而是"跑通了但静默出错"——抽样对照能把这个风险压到最低。
七、收尾
这套东西的价值不在 99.96 这个数字,而在那张消融表:它告诉你哪一步是开关、哪一步是保险丝。抓到 300 页还是 3 万页,瓶颈永远在"编码"和"结构"这两件事上,而不是在"用哪个更聪明的算法"。
完整跑批数据:300 页 / 3.45 MiB / 真值 399,554 字;A 档 F1 45.50、B 档 58.05、C 档 99.96;C 档 3.44 秒,约 87 页/秒。按每页 2 分钟人工核对估算,300 页是 10 小时——这个估算只是量级参考,不是实测。
如果你的页面里 class 全是哈希值,把第 4 步的负向词表换成"链接密度 + 标点密度"双阈值,其余七步可以直接复用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号