企业销售 AI 助手落地:知识库、混合检索与口径约束的工程实践
原创
企业销售 AI 助手落地:知识库、混合检索与口径约束的工程实践
原创
用户12808664
发布于 2026-11-05 16:49:40
发布于 2026-11-05 16:49:40
给一家通讯运营商的地市分公司做全员 AI 落地时,我们很快发现:通用的 AI 助手在真实业务里几乎不可用。原因不是模型不行,而是它"不知道这个单位的规定",输出的每一句都要人工核对,一线自然不敢用。
于是我们把问题重新定义成一个工程问题:如何构建一个答案可溯源、口径可控、能按岗位隔离的企业问答助手。下面是这次落地的技术拆解。
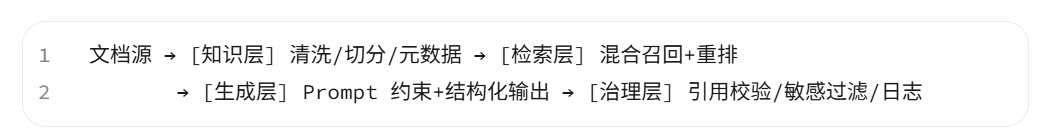
一、整体架构
系统分四层,职责清晰、可独立迭代:
二、知识层:切分与元数据是效果上限
2.1 切分策略
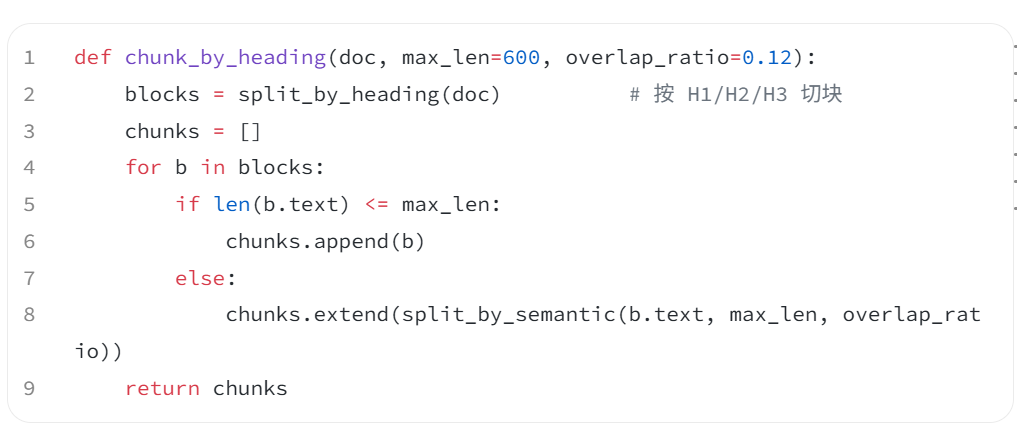
直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法:
- 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk;
- chunk 长度控制在 300–600 字,超长再按语义段落二次切分;
- 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失;
- 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。
2 元数据 Schema关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法:
- 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk;
- chunk 长度控制在 300–600 字,超长再按语义段落二次切分;
- 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失;
- 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法:
- 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk;
- chunk 长度控制在 300–600 字,超长再按语义段落二次切分;
- 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失;
- 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法:
- 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk;
- chunk 长度控制在 300–600 字,超长再按语义段落二次切分;
- 相邻 chunk 保留 10%–15% 重叠,避免边界信息丢失;
- 表格单独处理:转成"表头+行"的键值对文本,不要把表格拍平成乱序字符。关键设计原则:生成层不负责"记事实",事实只从检索结果来。模型只做归纳与表达,所有事实性内容必须带引用,否则不输出。 二、知识层:切分与元数据是效果上限 2.1 切分策略 直接按固定字数切是最常见的错误——会把一条制度切成两半,检索出来语义残缺。我们的做法:
- 优先按标题层级切分,一个三级标题下的完整段落为一个 chunk;
- chunk 长度控制在 300–600 字,超长再
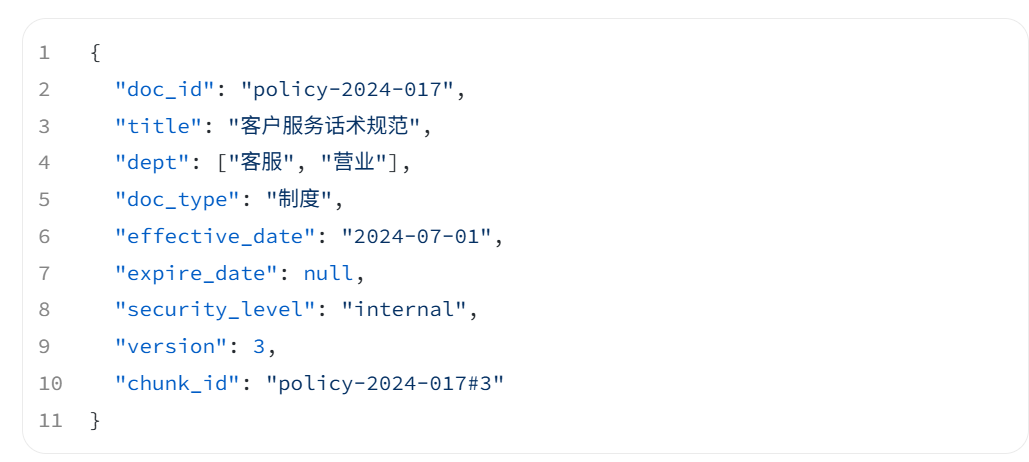
元数据决定了"能不能按岗位隔离、能不能按生效时间取最新版"。我们给每个 chunk 挂这套字段:
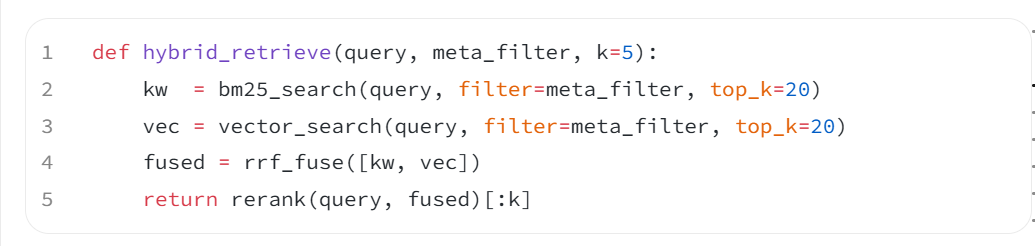
索时先按 dept + security_level + 有效期 过滤,再做语义匹配——这一步比换更大的模型更能提升准确率。 三、检索层:混合召回 + 重排 纯向量检索对"制度编号、专有名词、缩写"不敏感,纯关键词又不懂同义表达。我们用混合检索:
- BM25 召回 Top 20;
- 向量召回 Top 20;
- RRF(Reciprocal Rank Fusion)融合去重;
- 用轻量重排模型取 Top 5 喂给生成层。
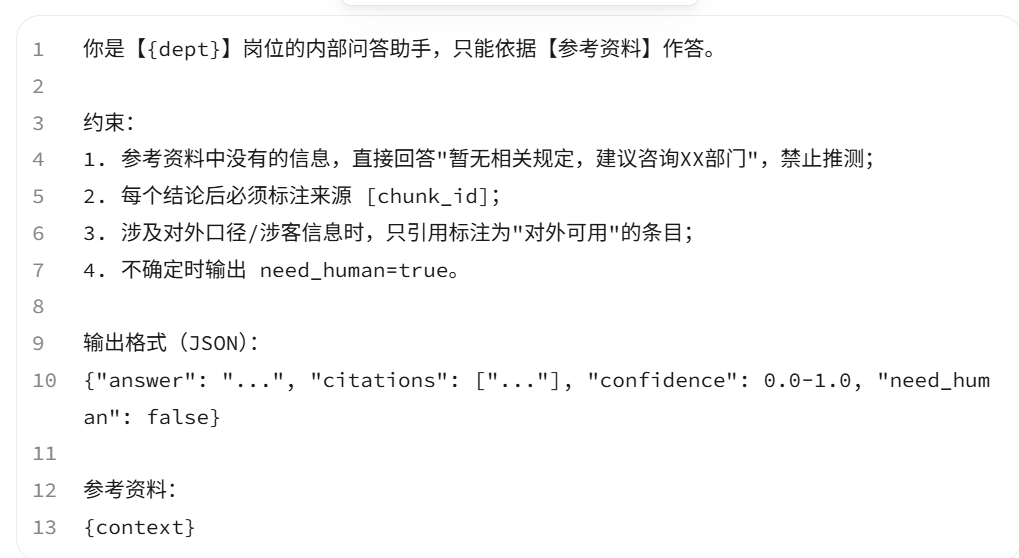
中,混合检索把"答非所问"的比例从约 3 成降到 1 成以内,收益远大于单纯调 Prompt。 四、生成层:Prompt 约束与结构化输出 Prompt 的核心不是"让它聪明",而是"让它守规矩"。模板固定四段:角色、约束、输出格式、兜底。
 化输出的好处:下游可以自动校验引用是否真实存在于检索结果,引用对不上就直接拦截重答——这就是"可审、可回溯"的工程实现。 五、治理层:三道闸
- 引用校验:citations 必须命中本次检索返回的 chunk_id,否则判为幻觉,打回。
- 敏感过滤:涉客信息、对外口径按 security_level 与白名单过滤。
- 低置信转人工:confidence < 0.6 或 need_human=true 时,直接转人工,不硬答。
六、效果评估:先建测试集,再上线
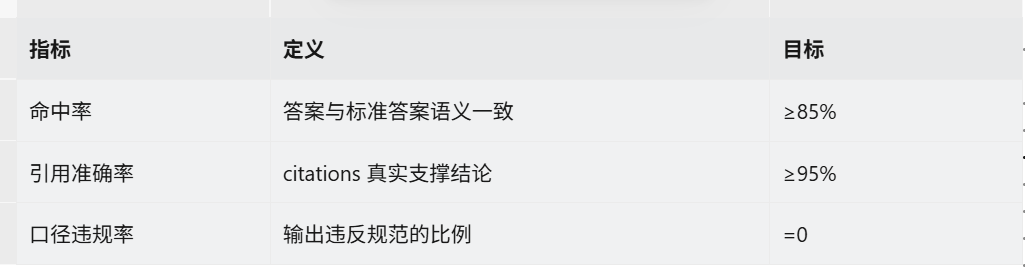
上线前我们人工构造了 80 条测试问答,覆盖高频问题、边界问题、诱导性问题,按三个指标验收:
!
、几个踩过的坑
- 知识库质量 > 模型能力。文档乱、过期、互相矛盾,换再强的模型也没用。先做文档治理。
- 权限必须前置到检索层,不能靠 Prompt 说"不要回答"——那是拦不住的。
- 版本与会话隔离。制度更新要能增量重建索引,旧答案要能标记失效。
- 不要追求全自动。低置信转人工不是缺陷,是设计。 结语 企业问答助手的难点,从来不是"接一个大模型",而是把组织的规章制度变成可检索、可引用、可审计的结构化知识。这一层做扎实了,模型只是最后一公里的表达。 以上是这次落地的技术骨架,欢迎在评论区交流你们在 RAG 切分和权限隔离上的做法。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号