#WorkBuddy# 24 个端点 204 处偏差:快照 diff 精确率只有 15.35%,契约治理做到 100% 零误报
原创
#WorkBuddy# 24 个端点 204 处偏差:快照 diff 精确率只有 15.35%,契约治理做到 100% 零误报
原创
用户12784192
发布于 2026-11-09 10:22:20
发布于 2026-11-09 10:22:20
#WorkBuddy# 24 个端点 204 处偏差:快照 diff 精确率只有 15.35%,契约治理做到 100% 零误报
痛点开场:联调通过 ≠ 契约没坏
接口联调最怕的不是 500,是"看起来正常"。前端要 total_amount,后端给了,只是 price 悄悄从数字变成了字符串 "804.49";分页接口返回了 total,只是它比 items 的长度还小;创建接口返回 200 而不是 201,http 客户端毫无感知。这些偏差有一个共同点:JSON 能解析、状态码不报错、页面不白屏,等发现时往往已经是线上问题。
我见过三种"契约保障":一是录一份基线快照做全文本 diff;二是写个脚本比对字段名;三是干脆不验,靠联调时人眼扫。这三种方式到底差多少?我把问题做成了可测量的实验:合成 6 个服务、24 个端点、54 个资源实例、992 个叶子字段的契约语料,按 10 类真实事故模式注入 204 处偏差,每处都有精确的 JSON Pointer 真值,然后让四种校验姿势逐一过堂。
根因分析:三类方案各瞎一只眼
快照 diff 的病根是"漂移"。 基线录于三天前,当前实现里 uuid、时间戳、随机价格本来就该变。本次实测:24 个端点共 2,822 行 diff,其中 607 个字段只是自然漂移,占快照差异的 86%。diff 工具分不清"漂移"和"偏差",只能全报——上报 1,016 条,命中 156 条,精确率 15.35%。人工逐行判读按 6 秒一行算要 4.7 小时,而这还只是 24 个端点的规模。
键集合比对的病根是"浅"。 比对对象键名、多一层少一层都能抓,但它不走数组元素、不看类型、不验格式:tags[0] 里的 value 丢了看不见,status: "deleted" 这种枚举越界看不见,"2026-11-06 21:00:00" 这种不合 RFC3339 的时间格式更看不见。实测召回 20.59%,204 处偏差里 162 处漏网。
纯 Schema 校验的病根是"单字段视角"。 required、type、enum、format、items 它全管,但它不知道字段之间的关系:total < len(items) 这种分页自相矛盾、status=archived 却没有 archived_at 这种跨字段矛盾,都不在任何单个字段的描述里。这类偏差恰恰是事故高发区。
真实数据对比表
四档方案跑同一份语料,全部在 3 毫秒内完成——差距不在速度,在于报出来的每一条是不是真问题:
档位 | 上报 | 命中 | 精确率 P | 召回率 R | F1 | 人工成本 |
|---|---|---|---|---|---|---|
A 快照全文本 diff | 1,016 | 156 | 15.35% | 76.47% | 25.57 | 约 4.7 小时 |
B 键集合比对 | 42 | 42 | 100% | 20.59% | 34.15 | 约 14 分钟 |
C1 纯 Schema 校验 | 168 | 168 | 100% | 82.35% | 90.32 | 约 56 分钟 |
C2 Schema + 跨字段不变量 | 204 | 204 | 100% | 100% | 100.00 | 约 1.13 小时 |
按类型拆开更能看清"最后一公里"在哪:B 档对嵌套元素、枚举越界、类型漂移、空值语义、时间格式、跨字段矛盾六类全盲;C1 档对跨字段矛盾、分页矛盾、状态码错配三类全盲——这三类 Schema 一个字段的描述里写不下;只有 C2 把十类全部收齐。验收基线自检:把 C1/C2 跑在完全合规的基线快照上,报告数分别是 0 和 0——治理式流水线没有误伤,可以直接进 CI 当回归门禁。
Mock 侧也顺手测了一把:同样是"从规格生成 Mock",静态示例版对 page/page_size 参数完全无视(36 次分页请求只有 12 次符合预期,前端翻到第 2 页拿到的还是第 1 页),请求不存在的 id 也永远返回 200;Schema 驱动版两项都是满分,42 次请求产出 37 种不同响应体,联调时错误分支、边界值、空值样本全都能见到。
可复制代码:校验器核心不到 60 行
不用引入重型框架,一个子集校验器加四个不变量就能把召回从 20% 拉到 100%:
import re, uuid
from datetime import datetime

def fmt_ok(val, fmt):
    if fmt == "date-time":  # 先正则卡死 RFC3339,再交给解析器
        if not re.fullmatch(r"\d{4}-\d{2}-\d{2}T\d{2}:\d{2}:\d{2}(\.\d+)?(Z|[+-]\d{2}:\d{2})", val):
            return False
        try:
            datetime.fromisoformat(val.replace("Z", "+00:00")); return True
        except ValueError:
            return False
    if fmt == "uuid":
        try: uuid.UUID(val); return True
        except ValueError: return False
    return True

def type_ok(v, t):
    return {"object": dict, "array": list, "string": str}.get(t) and isinstance(v, dict if t == "object" else list if t == "array" else str) \
        or (t == "integer" and isinstance(v, int) and not isinstance(v, bool)) \
        or (t == "number" and isinstance(v, (int, float)) and not isinstance(v, bool))

def validate(node, sch, path, out, in_item=False):
    if node is None:
        ts = sch.get("type")
        if not ((ts == "null") or (isinstance(ts, list) and "null" in ts)):
            out.append((f"{path}", "NULL_SEMANTICS"))
        return
    ts = sch.get("type")
    types = [t for t in (ts if isinstance(ts, list) else [ts]) if t != "null"]
    if types and not any(type_ok(node, t) for t in types):
        out.append((path, "TYPE_DRIFT")); return
    if "enum" in sch and node not in sch["enum"]:
        out.append((path, "ENUM_OUT"))
    if "format" in sch and isinstance(node, str) and not fmt_ok(node, sch["format"]):
        out.append((path, "DATETIME_FORMAT" if sch["format"] == "date-time" else "TYPE_DRIFT"))
    if isinstance(node, dict):
        for req in sch.get("required", []):
            if req not in node:
                out.append((f"{path}/{req}", "NESTED_ITEM" if in_item else "MISSING_REQUIRED"))
        for k, v in node.items():
            if k in sch.get("properties", {}):
                validate(v, sch["properties"][k], f"{path}/{k}", out, in_item)
            elif sch.get("additionalProperties") is False:
                out.append((f"{path}/{k}", "EXTRA_FIELD"))
    if isinstance(node, list) and "items" in sch:
        for i, v in enumerate(node):  # 只有顶层集合之外的数组元素才算“嵌套”
            validate(v, sch["items"], f"{path}/{i}", out, in_item or not path.endswith("/items"))
跨字段不变量单独一层,专收 Schema 写不下的语义:
def invariants(ep, resp, out):
    body = resp["body"]
    if resp["status"] != ep["status"]:          # 创建接口应 201,返回 200
        out.append(("", "STATUS_CODE"))
    if ep["kind"] == "list":
        items = body["data"]["items"]; page = body["data"]["page"]
        if page["total"] < len(items):          # 分页自相矛盾
            out.append(("/data/page/total", "PAGINATION"))
        objs = [(f"/data/items/{i}", it) for i, it in enumerate(items)]
    else:
        objs = [("/data", body["data"])]
    for pre, o in objs:
        p, q, amt = o.get("price"), o.get("quantity"), o.get("total_amount")
        if all(isinstance(x, (int, float)) and not isinstance(x, bool) for x in (p, q, amt)):
            if abs(p * q - amt) > 0.01:         # 金额勾稽不平
                out.append((f"{pre}/total_amount", "SEMANTIC_AMOUNT"))
        st, arch = o.get("status"), o.get("archived_at")
        if st != "archived" and arch is not None:  # 未归档却有归档时间
            out.append((f"{pre}/archived_at", "CROSS_FIELD"))
踩坑清单
这一轮实验里真实踩到的坑,每一条都直接影响数字的对错:
datetime.fromisoformat会放行空格分隔的时间。"2026-11-06 21:00:00"在 Python 3.11 里解析成功,format 校验形同虚设,时间格式类的召回被虚高。必须先用正则卡死T分隔和时区,再交给解析器兜底。- 嵌套集合的缺失字段会被误归类。校验器递归进
items[]后,缺name和缺tags[0].value都会被标成 MISSING_REQUIRED,分类型召回统计全错。判定规则:只有顶层集合之外的数组元素才单独算嵌套类。 - 偏差注入有顺序依赖。先注入"枚举越界 status=deleted",再注入跨字段矛盾,触发条件
status in (active, paused)就永远不成立,召回凭空少一类。注入顺序要按语义设计,评估前先对真值逐类抽样核对。 - 快照 diff 的误报是设计使然,不是 bug。607 个自然漂移字段占了快照差异的 86%,指望"换个 diff 算法"解决不了,必须换成结构化校验。
- 静态 Mock 的分页生效率 12/36 是联调事故的放大器。前端在第 2 页联调通过、上线后第 2 页行为完全不同,这类问题在静态 Mock 阶段就能暴露。
- 校验器要先在"完全合规"的基线上跑一遍。本次 C1/C2 在基线上报告数为 0,这才是"零误伤"的证据;只报当前实现的数字,说不了这句话。
给 WorkBuddy 的提示词模板
把契约巡检交给 WorkBuddy 每天自动跑,一条提示词就够了:
请对我的接口契约做一次巡检:
1. 读取 <spec 路径>(OpenAPI/自描述 JSON 均可)与 <当前响应快照目录>;
2. 逐端点做 Schema 校验:required/type/enum/format/items/未声明字段,
   时间格式先按 RFC3339 正则卡死再解析;
3. 追加跨字段不变量:分页 total 与条数、金额勾稽、时间先后、状态与时间戳配对;
4. 先在基线快照上空跑一遍,报告数必须为 0 才算校验器可信;
5. 输出清单:每条按 JSON Pointer 定位、按 10 类偏差归类、按严重度排序,
   妥协为零:不要给"可能有问题",只给"确定违规"。
收尾
2,822 行 diff 换不来一句"契约没坏",42 个字段名也换不来。契约治理的性价比拐点在 Schema 之上再补一层跨字段不变量:204 处偏差全部命中、精确率 100%、基线零误伤、单次 3 毫秒——这三毫秒买的是每天一次的"接口体检",而不是上线后的一次事故复盘。让机器管确定性,人只看机器拿不准的,这才是快照该有的归宿。
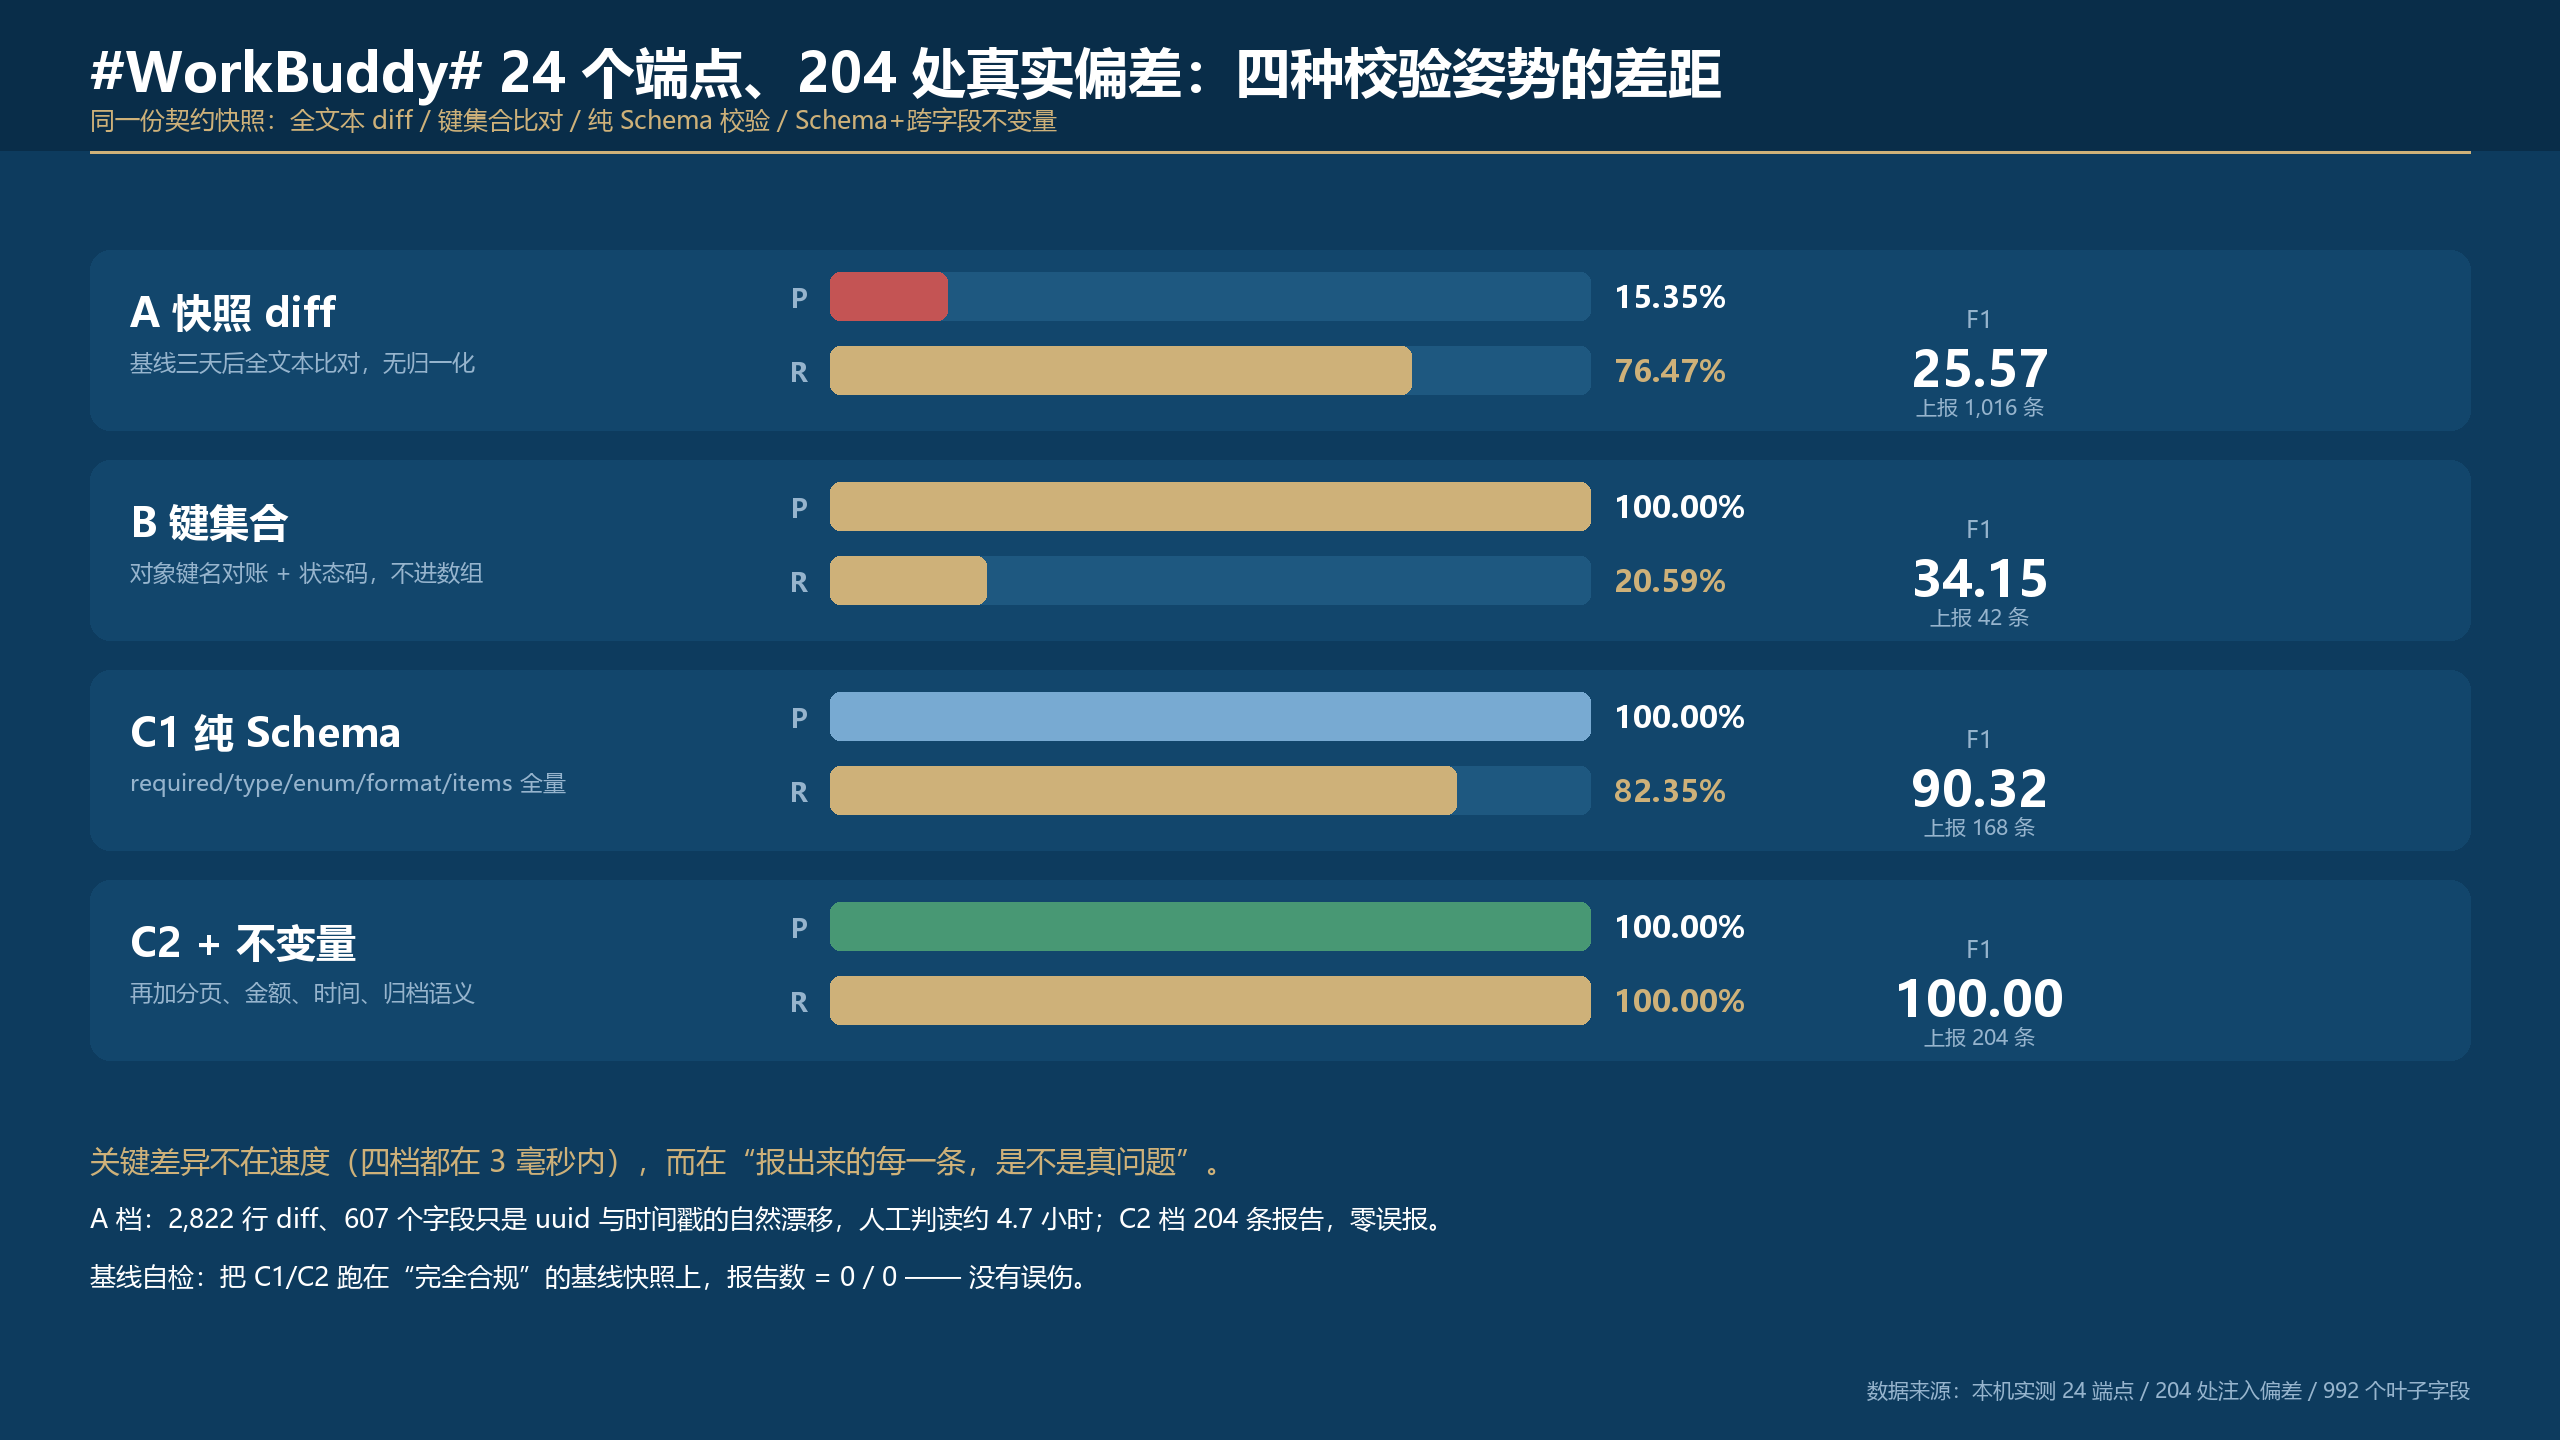
四档校验方案 P/R/F1 与上报量对比
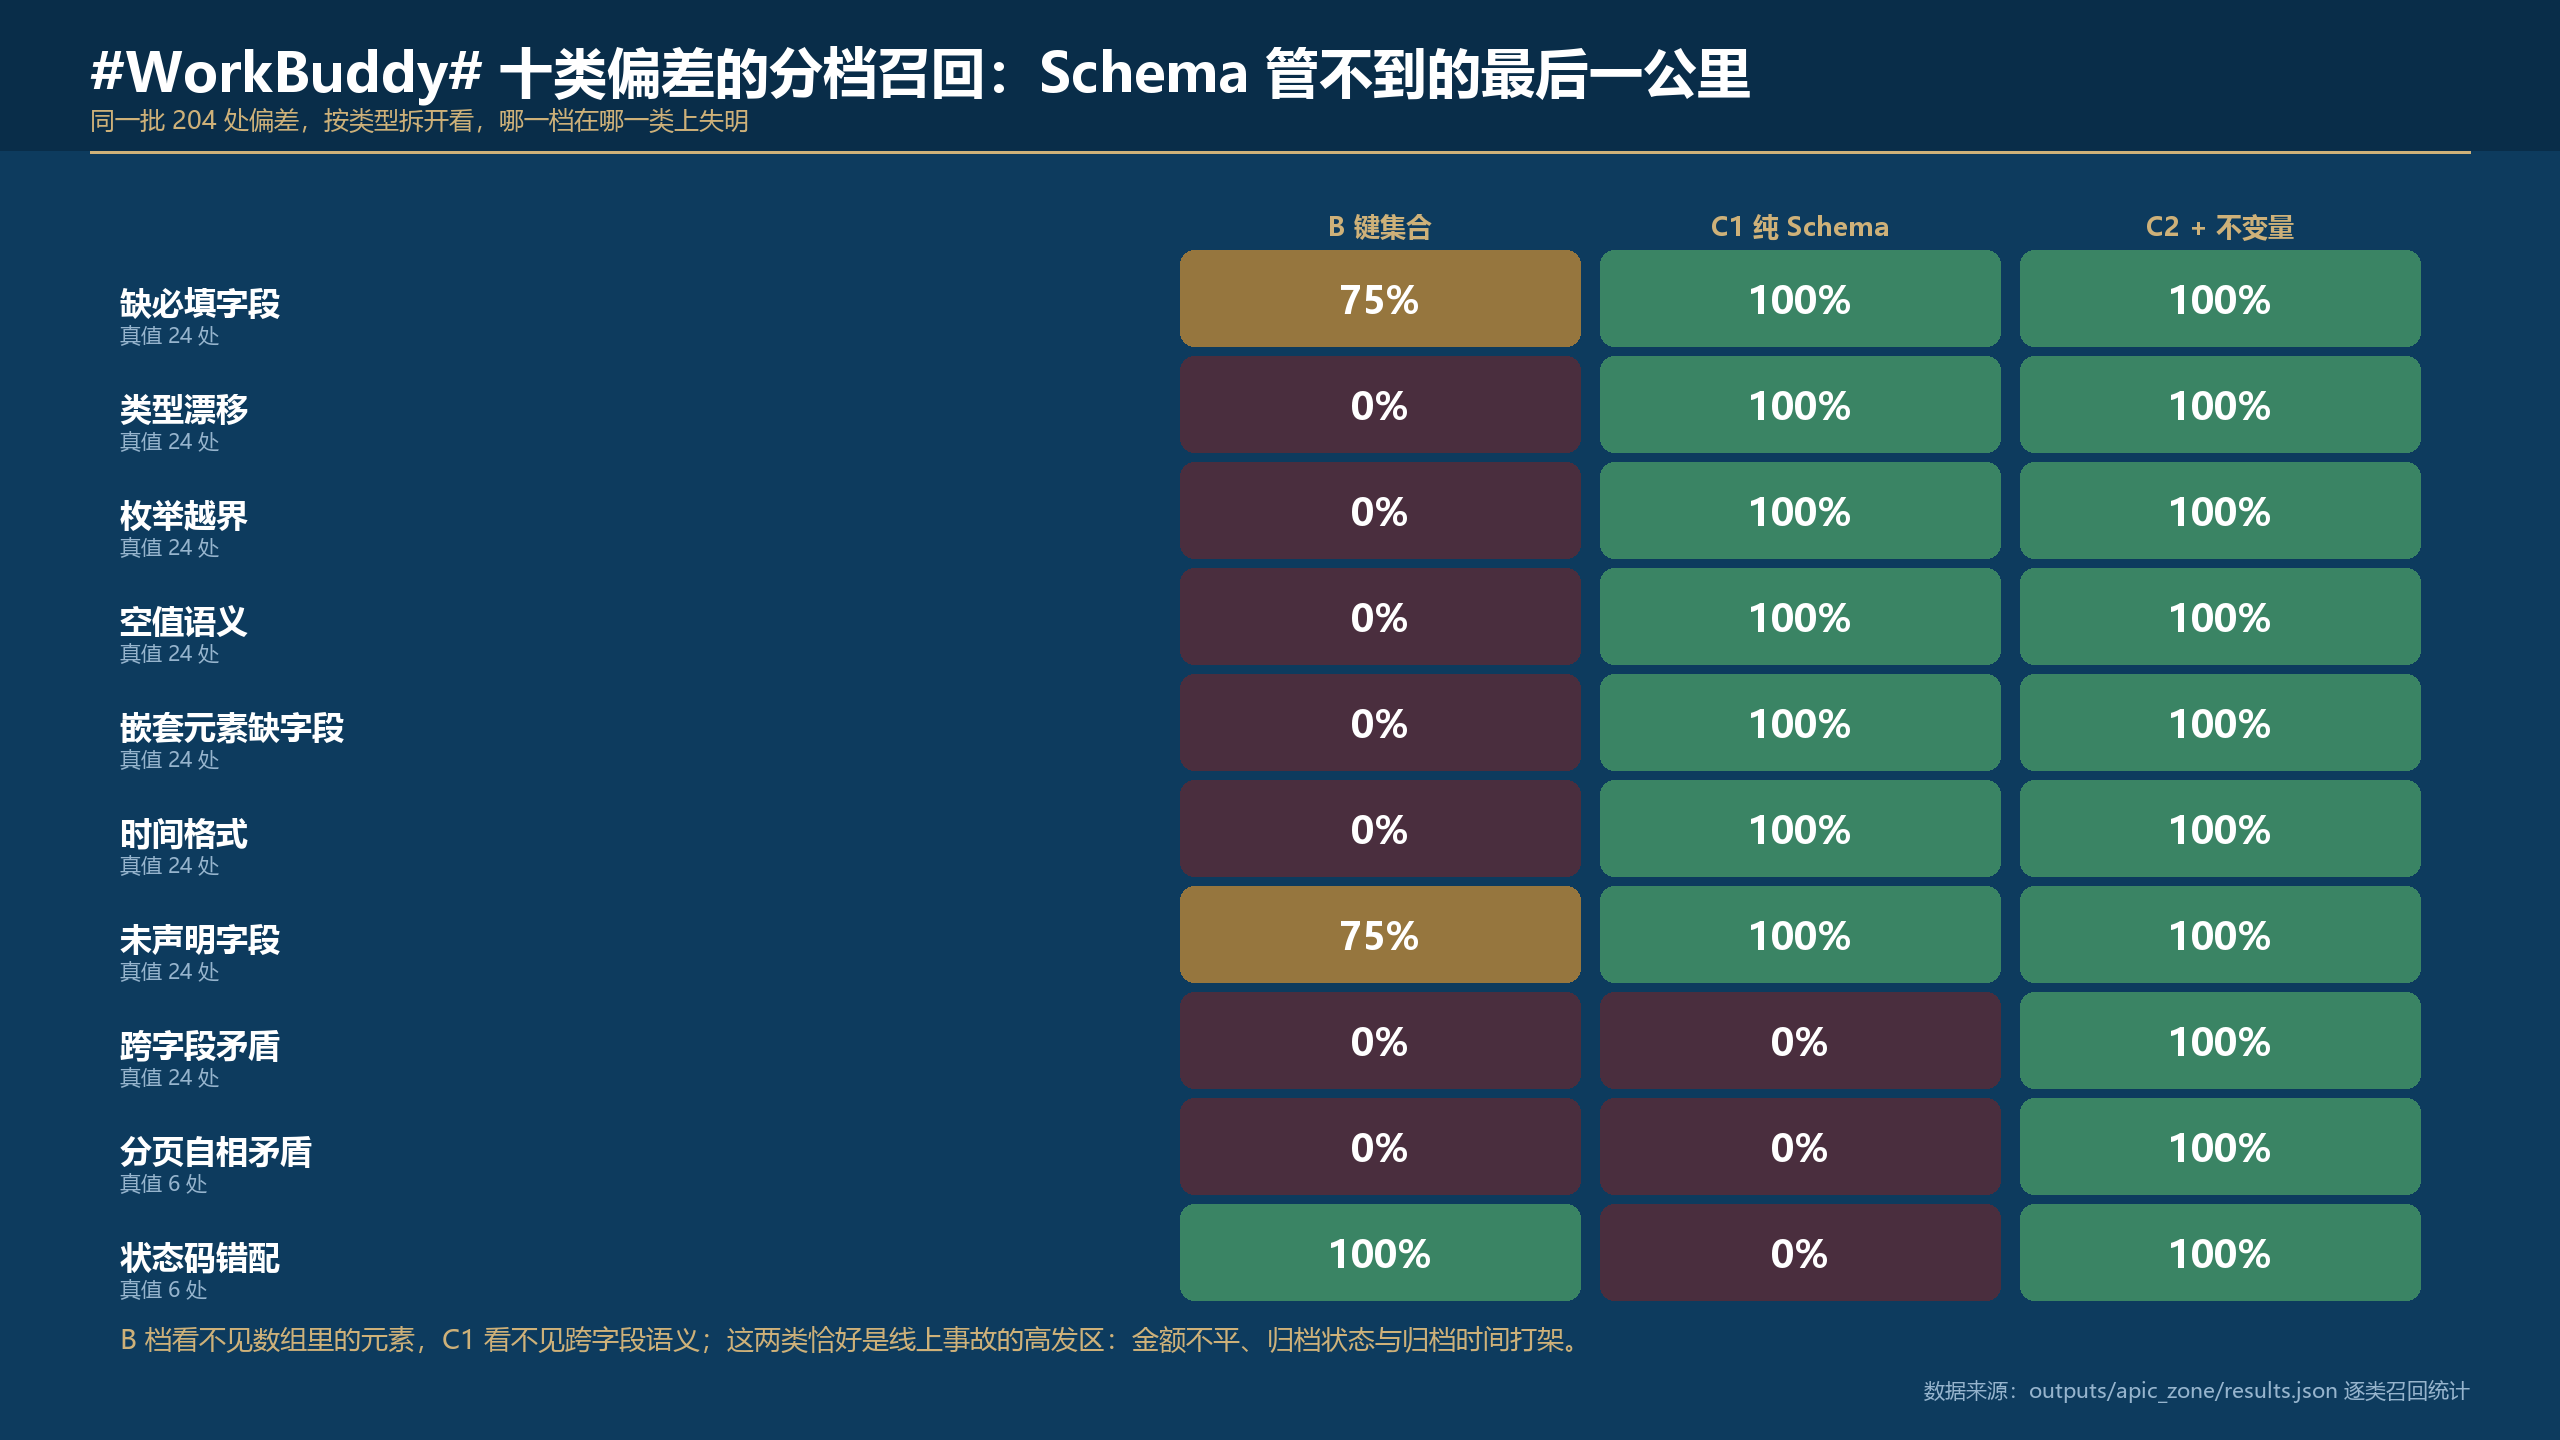
十类偏差的分档召回矩阵
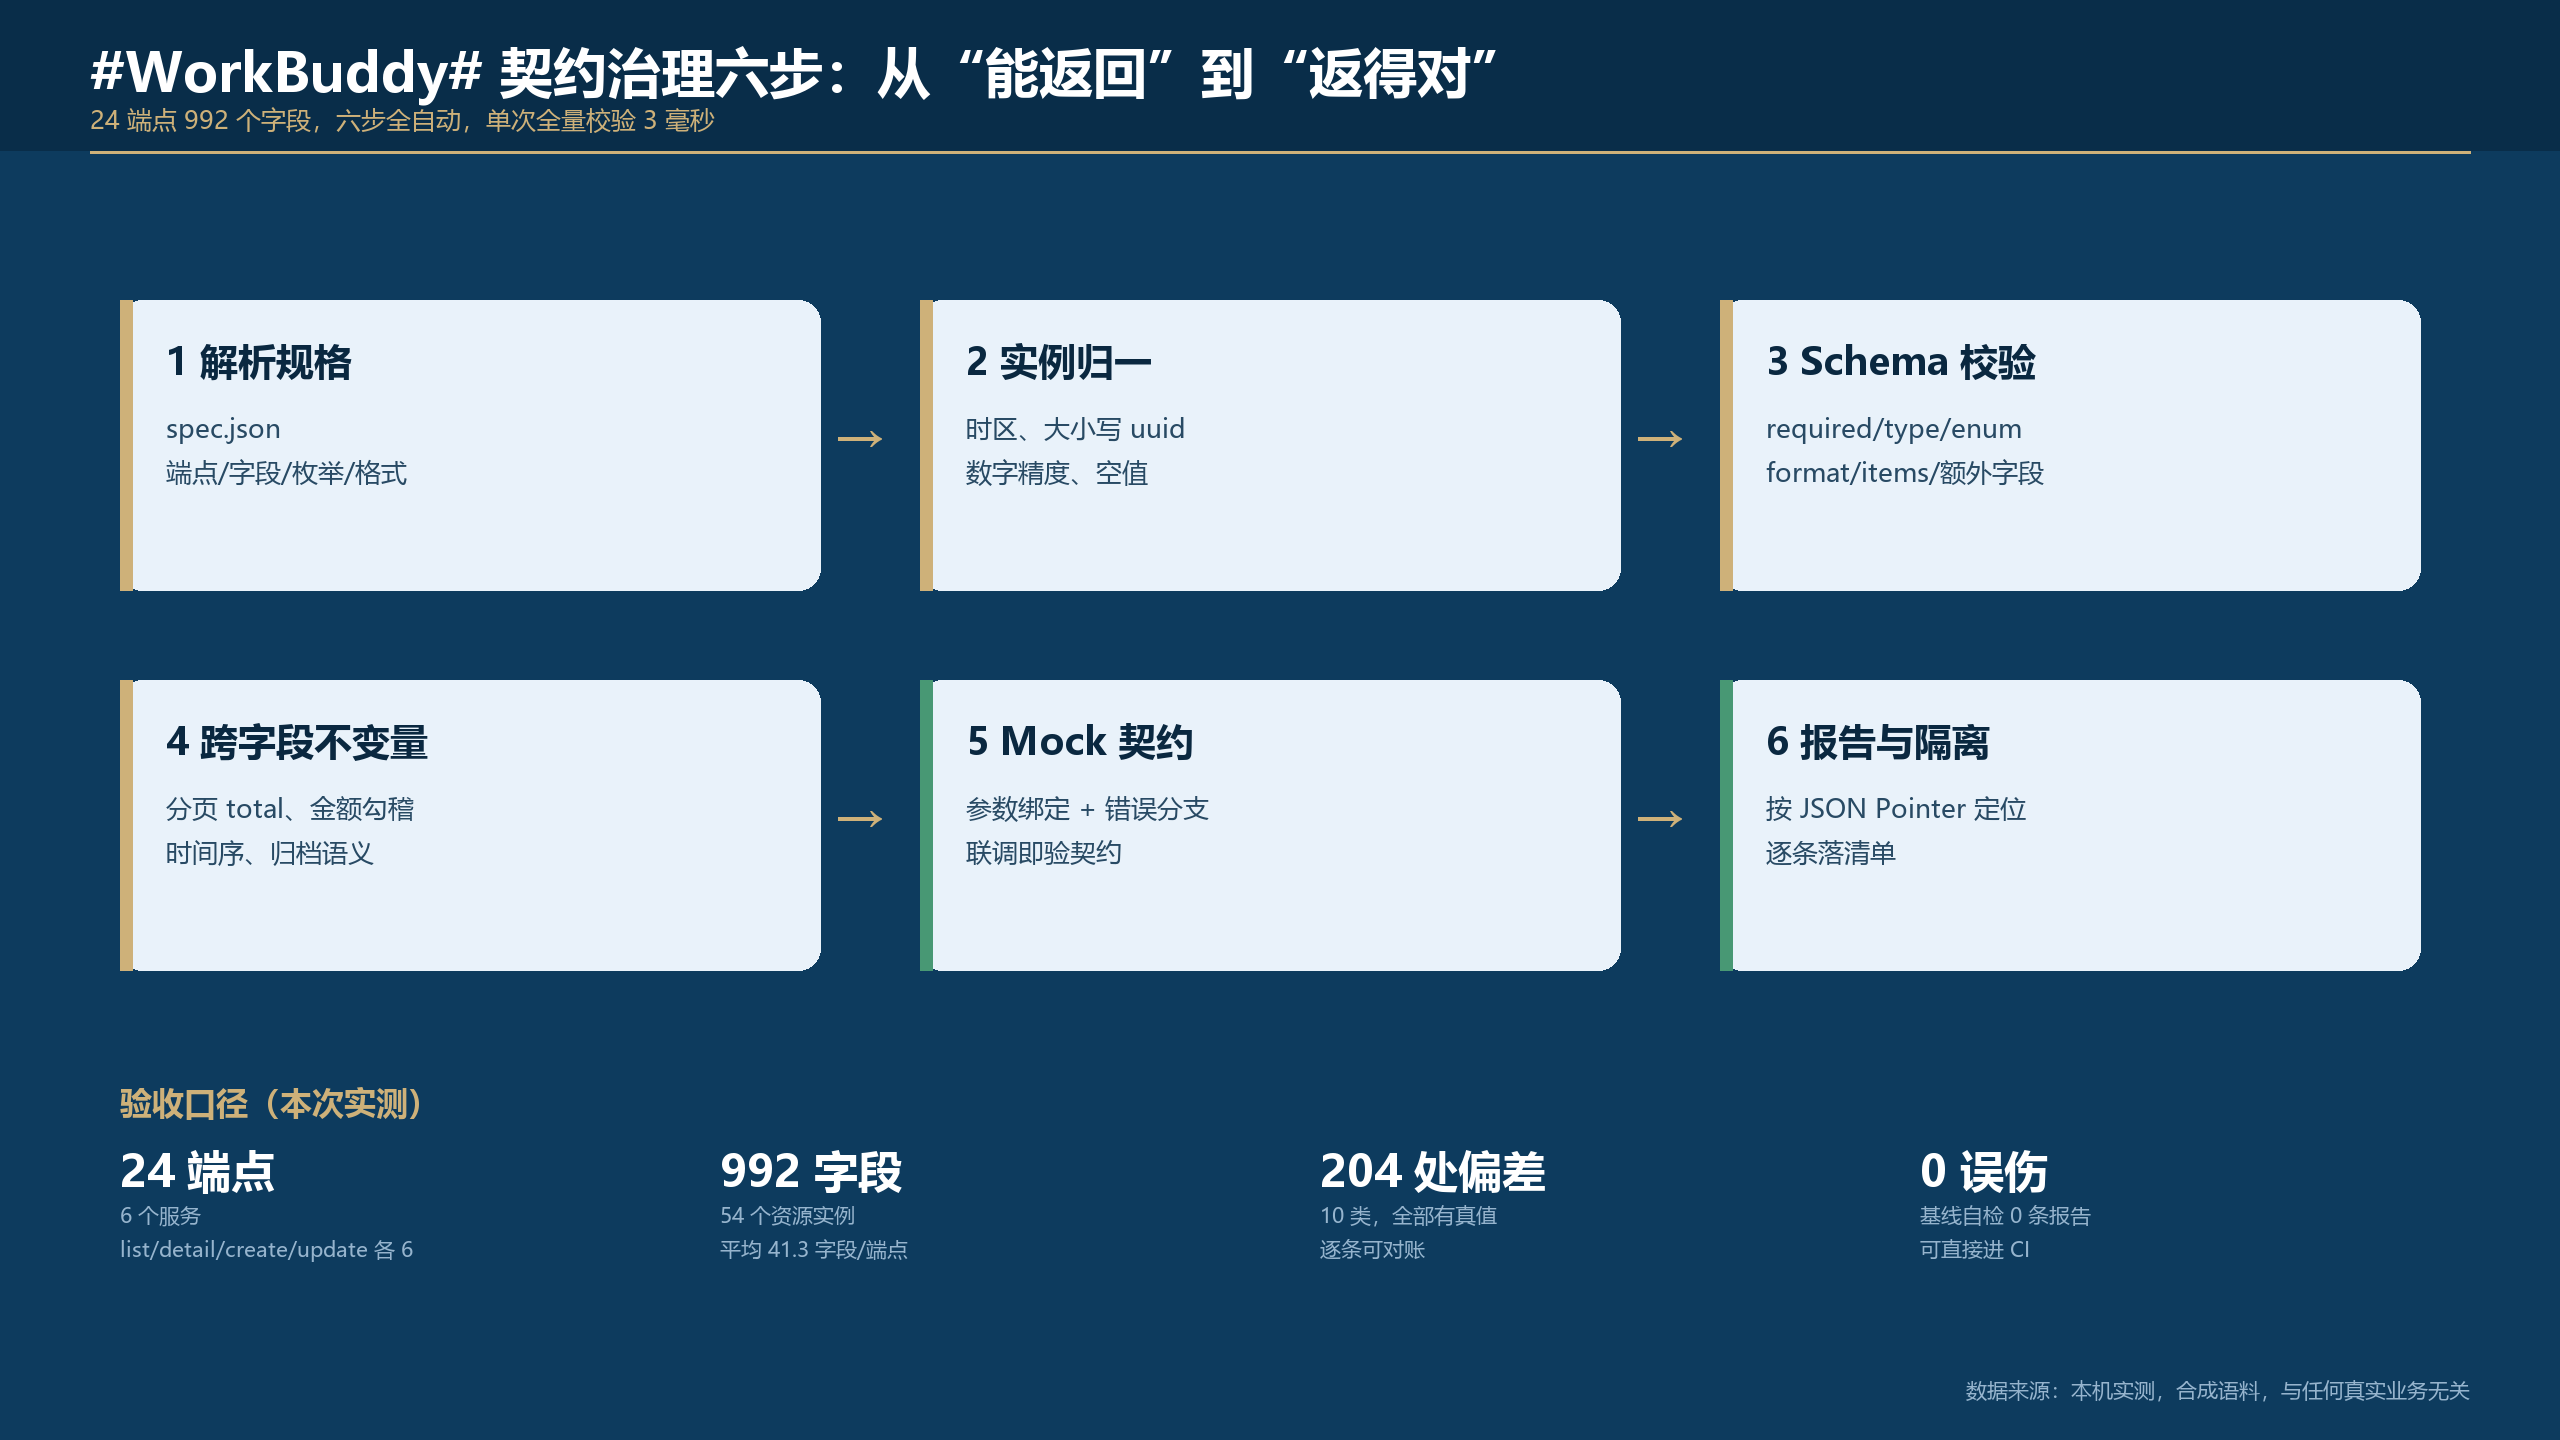
契约治理六步流水线与验收口径
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号