工作量估算的可复核性:功能点计数、生产率基线与偏差校准
原创
工作量估算的可复核性:功能点计数、生产率基线与偏差校准
原创
newlati
发布于 2026-11-10 09:41:42
发布于 2026-11-10 09:41:42
同一份需求说明,两个团队给出的工作量估算能差三倍。工程上的问题不是谁的数更小,而是估算过程不可复核——中间量全在脑子里,事后无法复现,也没法归因。这篇文章从工程视角拆一遍软件工作量估算的做法:规模怎么数、调整因子怎么取、基线怎么用、偏差怎么回填。
一、规模计量:功能点计数与三档精度
规模计量的对象不是代码行数,也不是页面数量,而是系统向用户提供的功能数量。功能点分析(FPA)把功能分成五类:
- 数据功能:内部逻辑文件(ILF,系统自己维护的业务数据)、外部接口文件(EIF,引用但由外部系统维护的数据);
- 事务功能:外部输入(EI,处理外部进入的数据)、外部输出(EO,经复杂处理输出的数据)、外部查询(EQ,简单检索输出)。
复杂度由三个参数判定:数据元素类型(DET)、记录元素类型(RET)、引用文件类型(FTR)。复杂度(低/中/高)决定权重,权重求和得到未调整功能点(UFP)。
国内工程实践常用 NESMA 的三档精度:
| 精度 | 计数对象 | 适用阶段 | 计算方式 |
|---|---|---|---|
| 指示法 | 只数逻辑文件(ILF / EIF) | 需求尚未成形 | FP ≈ 35 × ILF + 15 × EIF |
| 估算法 | 逻辑文件 + 事务功能(EI / EO / EQ) | 需求基本成形 | 按标准权重表逐项赋值 |
| 详细法 | 全部功能元素及复杂度 | 事中评估 / 事后复算 | 逐项判定复杂度后加权 |
早期阶段还常用快速功能点赋值:跳过复杂度判定,按固定权重直接赋值。常见两套体系是 10/7/4/5/4(ILF/EIF/EI/EO/EQ,数据功能按平均复杂度)与 7/5/4/5/4(数据功能按低复杂度)。两套体系的差别在数据功能权重上,同一个系统用不同体系数出来的规模能差两成——所以计数体系必须在项目启动时写定,中途不许换。
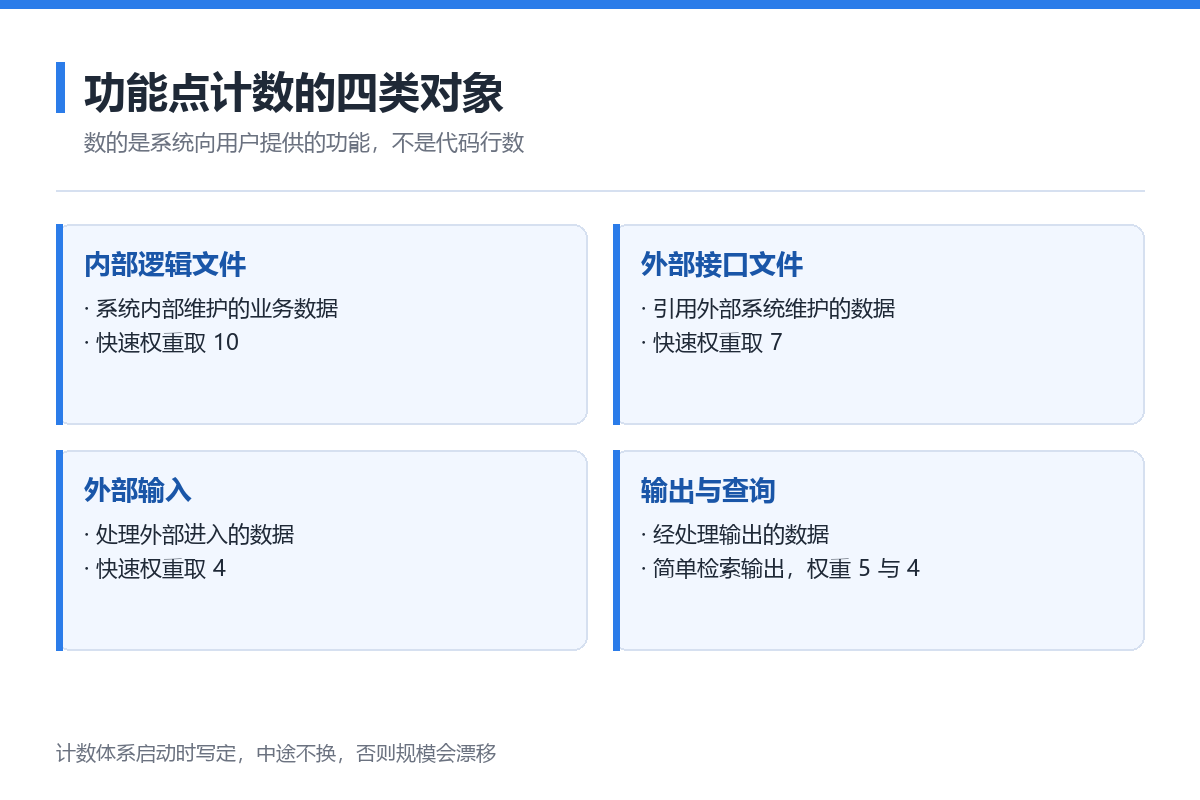
图 5:功能点计数的四类对象与计数边界(示意)
二、规模调整因子:需求完整度如何进模型
未调整规模不能直接进工作量模型,因为需求完整度不同,同样一句需求背后的真实工作量不同。GB/T 36964-2018 引入了规模变更因子(CF):
- 预算阶段,需求极不明确,CF 常取 2.0;
- 招投标阶段,需求基本明确,CF 取 1.26;
- 计划阶段,需求明确,CF 取 1.0。
调整后规模 S = US × CF。
工程上要注意两点。其一,CF 不是打折工具——它的作用是补偿"需求还没写完"这件事,同一份需求在预算阶段和计划阶段数出来的规模本来就该不同。其二,CF 取值要有书面依据,写清当时需求文档的完整度(哪些模块有原型、哪些只有一句话),否则事后无法解释为什么同一个系统两次估出不同的规模。
三、生产率基线:用分位数而不是单点
规模折工作量靠生产率(人时/功能点)。行业基准数据给出的不是一个点,而是一组分位数:全行业开发生产率中值 6.72 人时/功能点。工程上取分位的规则是:
- 团队首次做该类系统、技术栈不熟 → 取 P75;
- 有同类项目沉淀、团队稳定 → 取 P50;
- 高度复用、模块几乎照搬 → 可参考 P25。
单点估算的问题是它掩盖了分布。真实项目的工期分布通常右偏——延期容易、提前难,所以对外承诺的工期应当取分布的 P80 附近,而不是中位数。
工作量还要过四类调整因子:
| 因子 | 含义 | 取值范围 |
|---|---|---|
| A | 应用领域(业务复杂度差异) | 0.8 – 1.2 |
| IL | 软件完整性级别(可靠性/安全性要求) | 1.0 – 1.8 |
| L | 开发语言与工具链 | 0.8 – 1.2 |
| T | 团队规模(沟通成本随人数上升) | 0.8 – 1.2 |
调整后工作量 AE = UE × A × IL × L × T,单位人时;折算人月时按 1 人月 = 21.75 人天、1 人天 = 8 人时。
一个完整的算例(指标法 + 中位基线):
| 步骤 | 计算 | 结果 |
|---|---|---|
| 计数 | 12 个 ILF、3 个 EIF,指示法:12 × 35 + 3 × 15 | 465 FP |
| 规模调整 | 需求基本成形,CF 取 1.26:465 × 1.26 | 585.9 FP |
| 转工作量 | 585.9 × 6.72 ÷ 8 | 约 492 人天 |
| 折人月 | 492 ÷ 21.75 | 约 22.6 人月 |
| 因子调整 | 团队首次做该类系统,L 取 1.1:22.6 × 1.1 | 约 24.9 人月 |
这个算例的每一步都能被别人重算,也能在结项后被回填的实际值逐项校验——可复核性正是从这里来的。
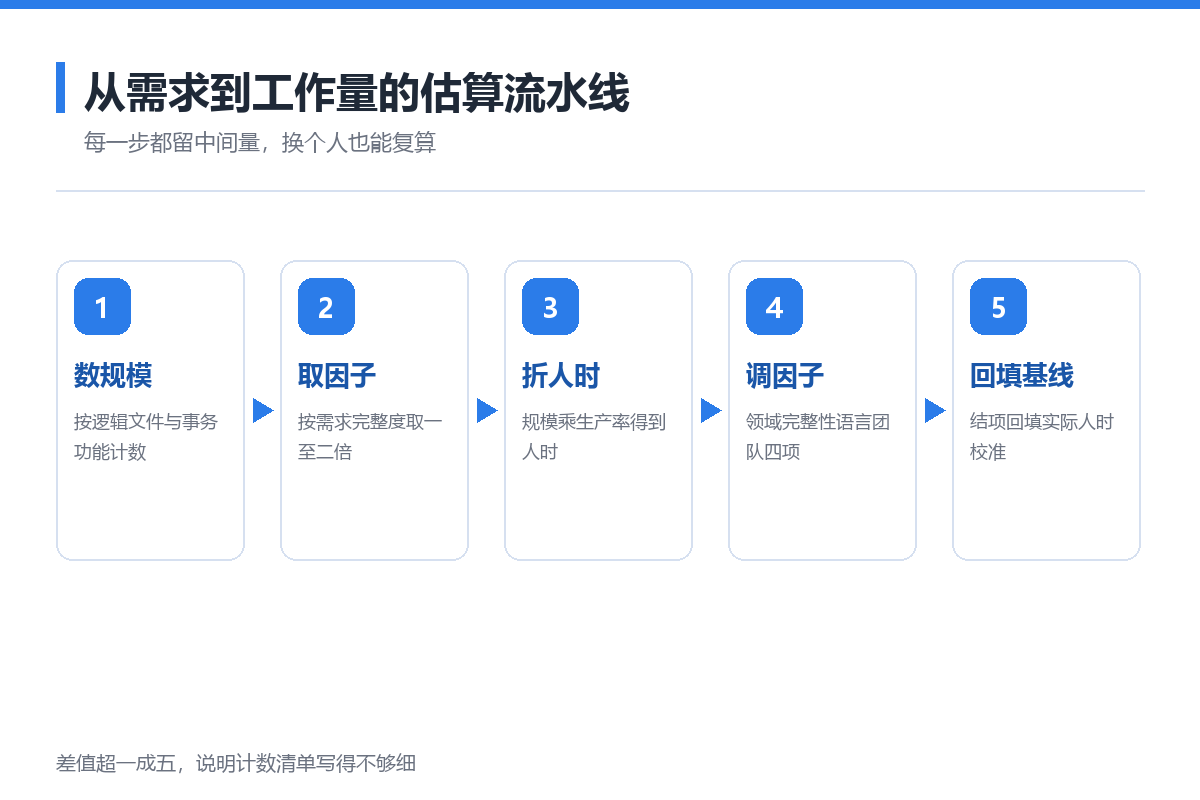
图 6:从需求到工作量的估算流水线(示意)
四、可复核性:四个必须留档的中间量
估算之所以不可复核,是因为只留了结果。要让另一个工程师拿着同一份需求复算出 ±10% 以内的规模,以下四份材料必须留档:
- 计数清单:每个 ILF / EIF / EI / EO / EQ 的编号、名称、判定理由(为什么这是 ILF 而不是 EIF);
- CF 取值依据:需求文档完整度说明 + 取值理由;
- 分位选择理由:团队历史数据支撑,或明确标注"无历史数据,取保守分位";
- 调整因子表:四个因子逐个给值与理由,禁止"综合取 1.0"这种写法。
复核的动作本身也要设计:让没参与估算的人用同一份材料重算一遍,两次结果偏差超过 15% 就说明计数清单写得不够细,而不是"估算能力不行"。
五、偏差校准:把误差变成基线资产
估算的价值不在头一次准,而在每做一次就更准一点。做法是建立回填机制:
- 项目结项时回填实际人时、实际功能点、缺陷数量;
- 计算三个偏差:规模偏差(实际 FP / 估算 FP)、生产率偏差(实际人时/FP ÷ 基线值)、进度偏差;
- 偏差归因四类:规模漏数(常见的漏项是批量导入、审批流分支、报表导出)、CF 取错、生产率选错分位、范围蔓延(需求没变但做的事变多了)。
归因比数值重要。规模漏数的修正办法是补计数规则(把"数据导入"这类通用功能做成固定计分项);范围蔓延的修正办法是变更单,而不是下次估算多加 20% 的"安全垫"——安全垫会把基线整体推高,越垫越不准。
质量侧可以对照行业基准:缺陷密度中值 0.23/功能点(交付前测试发现的缺陷总和 ÷ 规模),交付质量中值 9.30/千功能点(交付后 6 个月内发现的缺陷数)。这两个数用来判断"工期估得紧不紧":工期压到生产率下限的项目,交付质量通常明显劣于中值。
六、需求变更的增量计数
变更管理的工程要点是把变更变成可以计数的增量,而不是重新谈判:
- 变更单三分类:新增功能(按完整权重计)、修改功能(按增量计,常见做法取 0.5 权重)、删除功能(按删除涉及的接口与数据迁移量计);
- 映射表:每个变更单挂到基准计数清单的具体条目上,标明是哪个 ILF 或 EI 的变更;
- 累计占比:变更增量占基准规模的比例要持续统计——超过 20% 通常说明需求阶段该补的工作没补,此时继续追加变更不如重做一次规模基线。
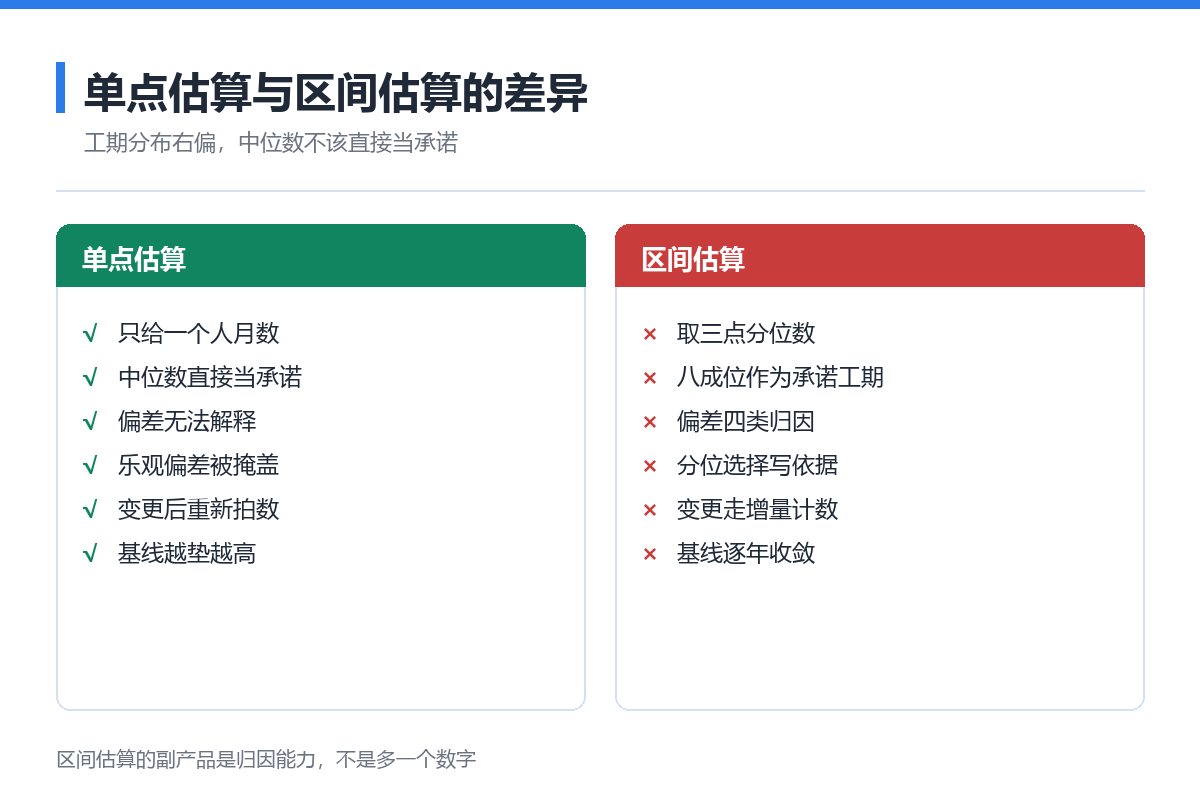
图 7:单点估算与区间估算的差异(示意)
七、技术侧交付物清单
- 功能点计数清单(含判定理由与计数体系说明);
- 规模变更因子取值依据与需求完整度说明;
- 调整因子表(四因子逐项给值与理由);
- 自有生产率基线表(按项目类型与团队分组,含分位数);
- 变更单与基准计数的映射表、累计变更占比报表;
- 结项回填表(实际人时 / 实际规模 / 缺陷数 / 三类偏差)。
这几份东西合起来,估算才从一个"数"变成一个"可复算的模型"。规模能复算,工作量能复算,偏差能归因——三件事做到了,两个团队对同一份需求给出的工作量就不太可能差出三倍。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号