用 WorkBuddy 把 4.5 小时导游录音 + 视频整理成公文级文本:完整实操与踩坑 #WorkBuddy#
原创
用 WorkBuddy 把 4.5 小时导游录音 + 视频整理成公文级文本:完整实操与踩坑 #WorkBuddy#
原创
用户12874686
修改于 2026-11-11 15:06:41
修改于 2026-11-11 15:06:41
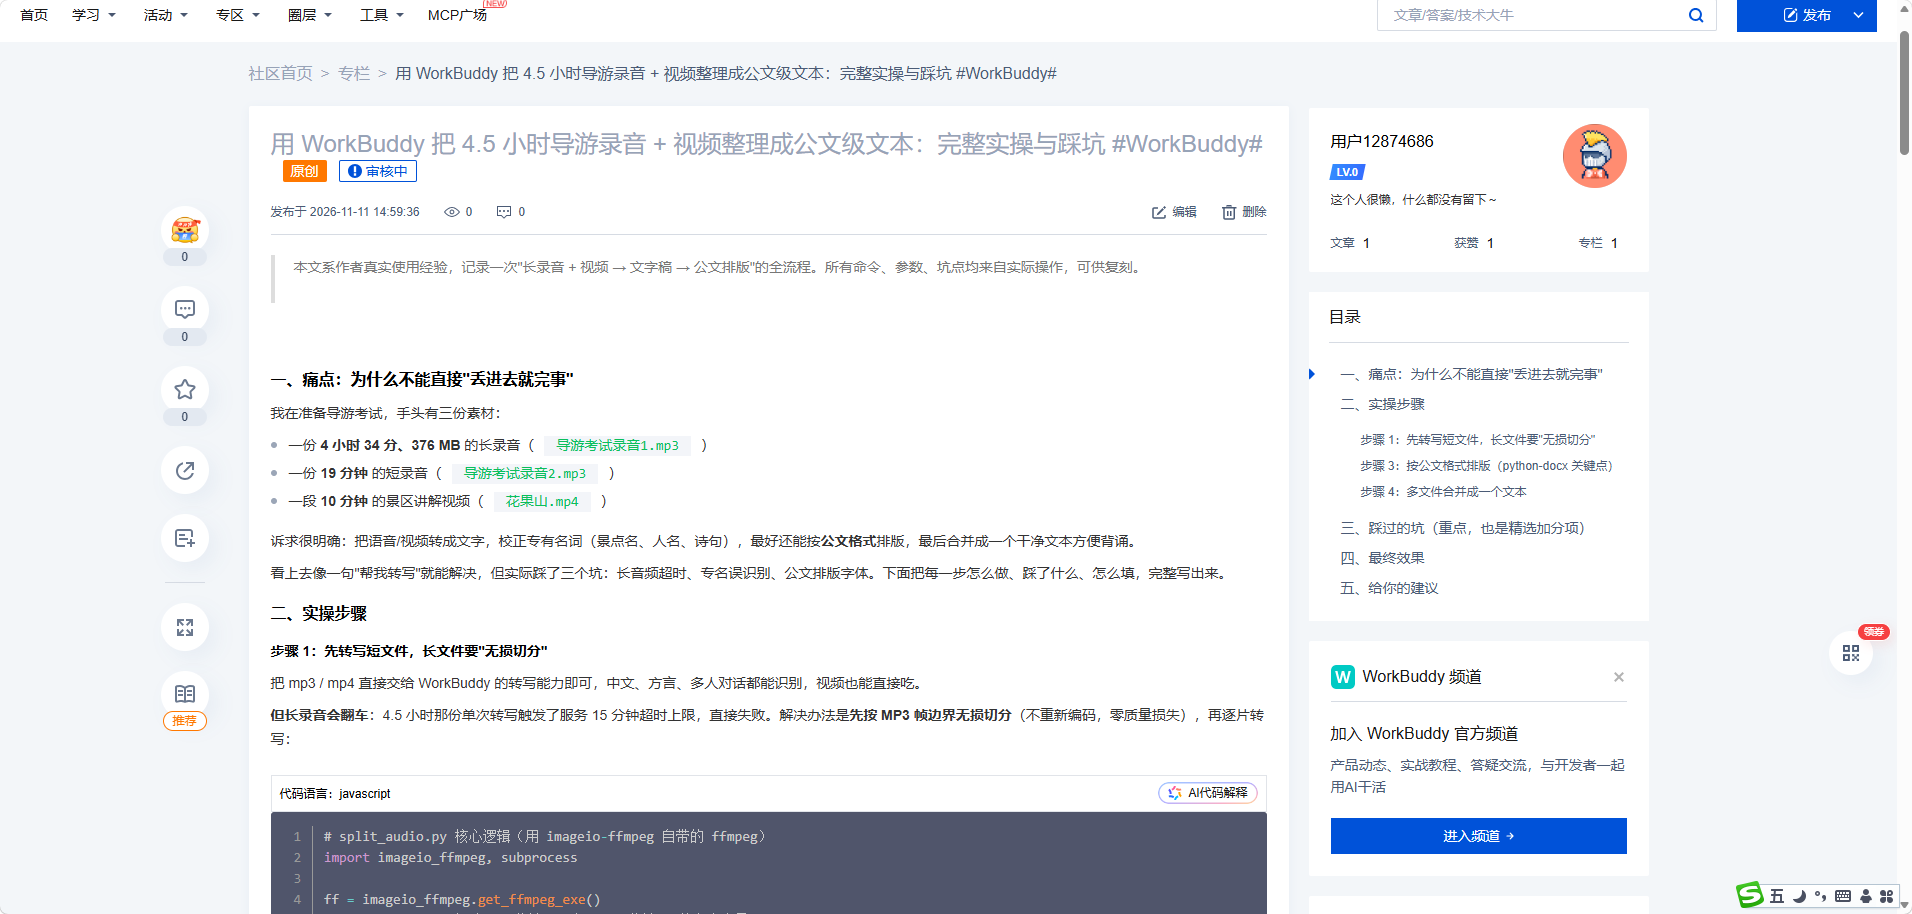
本文系作者真实使用经验,记录一次"长录音 + 视频 → 文字稿 → 公文排版"的全流程。所有命令、参数、坑点均来自实际操作,可供复刻。
一、痛点:为什么不能直接"丢进去就完事"
我在准备导游考试,手头有三份素材:
- 一份 4 小时 34 分、376 MB 的长录音(
导游考试录音1.mp3) - 一份 19 分钟 的短录音(
导游考试录音2.mp3) - 一段 10 分钟 的景区讲解视频(
花果山.mp4)
诉求很明确:把语音/视频转成文字,校正专有名词(景点名、人名、诗句),最好还能按公文格式排版,最后合并成一个干净文本方便背诵。
看上去像一句"帮我转写"就能解决,但实际踩了三个坑:长音频超时、专名误识别、公文排版字体。下面把每一步怎么做、踩了什么、怎么填,完整写出来。
二、实操步骤
步骤 1:先转写短文件,长文件要"无损切分"
把 mp3 / mp4 直接交给 WorkBuddy 的转写能力即可,中文、方言、多人对话都能识别,视频也能直接吃。
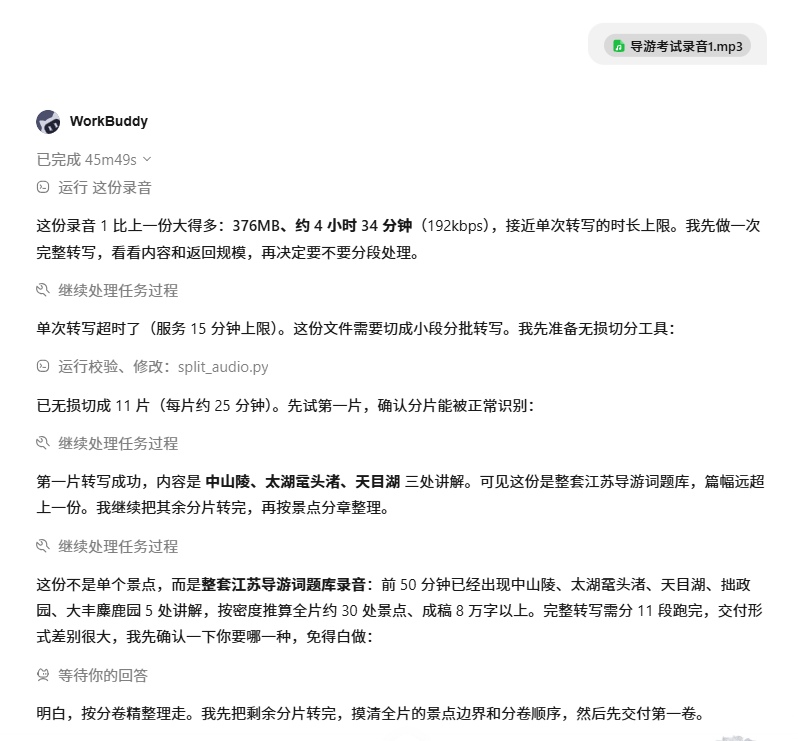
但长录音会翻车:4.5 小时那份单次转写触发了服务 15 分钟超时上限,直接失败。解决办法是先按 MP3 帧边界无损切分(不重新编码,零质量损失),再逐片转写:
# split_audio.py 核心逻辑(用 imageio-ffmpeg 自带的 ffmpeg)
import imageio_ffmpeg, subprocess

ff = imageio_ffmpeg.get_ffmpeg_exe()
seg = 25 * 60  # 每片 25 分钟,远小于 15 分钟×N 的安全余量
for i, start in enumerate(range(0, total_seconds, seg)):
    subprocess.run([ff, "-i", src,
                    "-ss", str(start), "-t", str(seg),
                    "-c", "copy",                 # 关键:流拷贝,不重编码
                    f"part{i+1:02d}.mp3"])
4.5 小时切成了 11 片,逐片转写全部成功。切分后的转写原文记得落盘保存(带时间戳),后面合并时直接读文本,不用再跑一遍语音识别。
步骤 2:专名校正——这一步最值钱,也最不能省
语音识别在"专有名词"上错得离谱。我遇到的真实误识(左边是机器听错的,右边是校正后的):
原转写(误) | 校正后(正) | 类型 |
|---|---|---|
焕公塔 / 智焕 | 幻公塔 / 智幻 | 景点+人名 |
赵会沈秀之楼 | 赵绘沈绣之楼 | 景点 |
包孕五岳 | 包孕吴越 | 摩崖石刻 |
五豪 / 一豪 | 伍豪 / 逸豪 | 周恩来代号 |
昱林观 / 陶树畅 / 尧镇洪流 | 郁林观 / 陶澍 / 遥镇洪流 | 景点+人名 |
毕竟在源头 / 神猿 | 毕竟在鼋头 / 神鼋 | 诗句+动物 |
做法:通读转写文本,对照景区标牌或正式讲解词逐条校正,把"原转写 → 采用"列成对照表。对不上、无法确证的一律标"待核",绝不擅自改成"看起来对"的名字——考试写错一个字就是失分点。
步骤 3:按公文格式排版(python-docx 关键点)
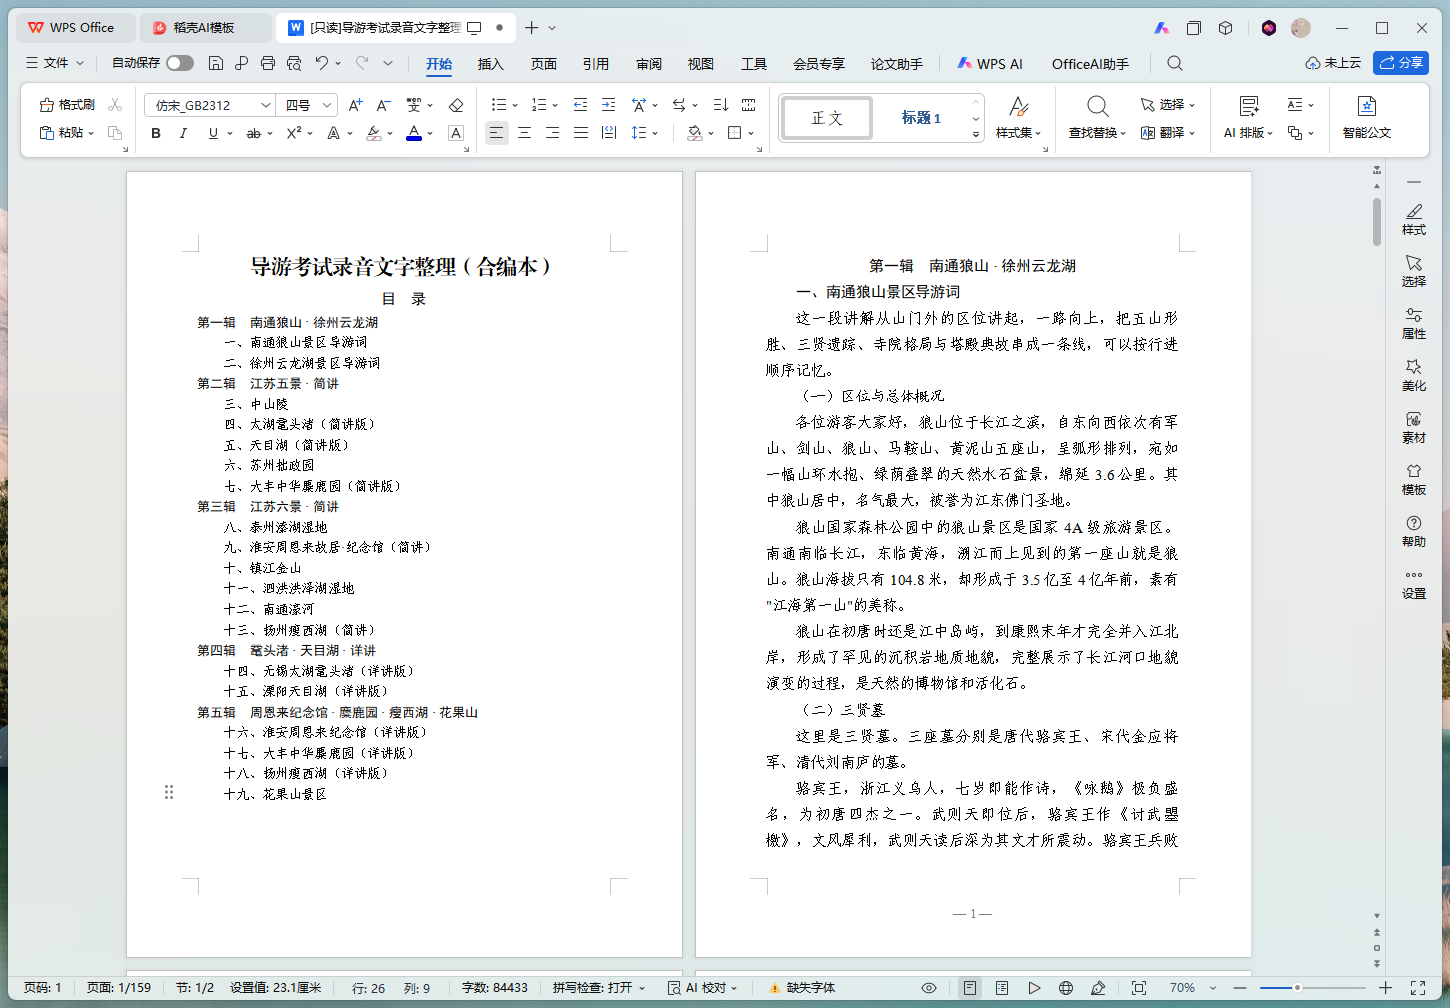
整理好的文字要用公文规格排(A4、上下 3cm 左右 2.7cm、二号小标宋标题、三号仿宋正文、固定行距 28pt、页码「— 1 —」)。几个容易漏的底层设置:
from docx import Document
from docx.shared import Pt, Cm
from docx.enum.text import WD_LINE_SPACING, WD_ALIGN_PARAGRAPH
from docx.oxml.ns import qn

d = Document()
s = d.sections[0]
s.page_height, s.page_width = Cm(29.7), Cm(21)
s.top_margin = s.bottom_margin = Cm(3)
s.left_margin = s.right_margin = Cm(2.7)

# 正文:仿宋 三号 16pt,首行缩进 2 字符(32pt),固定行距 28pt
p.paragraph_format.line_spacing = Pt(28)
p.paragraph_format.line_spacing_rule = WD_LINE_SPACING.EXACTLY  # 固定值,不是倍数
p.paragraph_format.first_line_indent = Pt(32)
p.paragraph_format.widow_control = False  # 关闭孤行控制
run.font.size = Pt(16)
run.font.name = "Times New Roman"
run._element.rPr.rFonts.set(qn("w:eastAsia"), "仿宋_GB2312")  # 中文走仿宋
# 页码「— 1 —」:footer 插入 PAGE 域,四号 14pt,居中
标题用方正小标宋简体(二号)、一级标题黑体、二级小标题楷体_GB2312。全部走 Normal 样式 + 直接格式,不套标题样式,避免 Word 自动改格式。
步骤 4:多文件合并成一个文本
几份稿件(录音2 单卷 + 四卷整理稿 + 视频稿)要合成一册。做法:按 ## 切块,过滤掉"整理说明 / 转写校正说明"两章,章节连续重新编号,统一重排为一份 docx。注意去重自动编号——源 markdown 若自带"一、",脚本又加一遍就会变成"一、一、",要先把源稿的显式编号清掉交给脚本。
步骤 5:视频也走同一套
花果山.mp4 直接转写就是完整版讲解,比之前长录音里那段十几秒的残段完整得多。校正专名(郁林观、陶澍、遥镇洪流等)后,按你的要求用完整视频版替换掉残段,全册最终只保留一个花果山,合并成一份文本。
三、踩过的坑(重点,也是精选加分项)
- 长音频直接转写超时 → 必须先无损切分(按帧边界
-c copy),别用重新编码的切法,否则音质受损。 - 专名误识别率高 → 语音转写绝不能"转完就用",尤其景点、人名、诗句、年份,必须人工校正 + 留"待核"清单。
- 公文字体本机没装会回退 → 方正小标宋、仿宋_GB2312、楷体_GB2312 需本机安装,否则 Word 自动替换,排版走样。交付时务必提醒读者。
- 合并双重编号 → 源稿自带编号 + 脚本再加编号 = "一、一、",要去重。
- 页码域位置要合规 →
w:pgNumType必须放在w:cols之前,否则 Word 不认;首个章节前别再设分页符,否则多一页空白。
四、最终效果
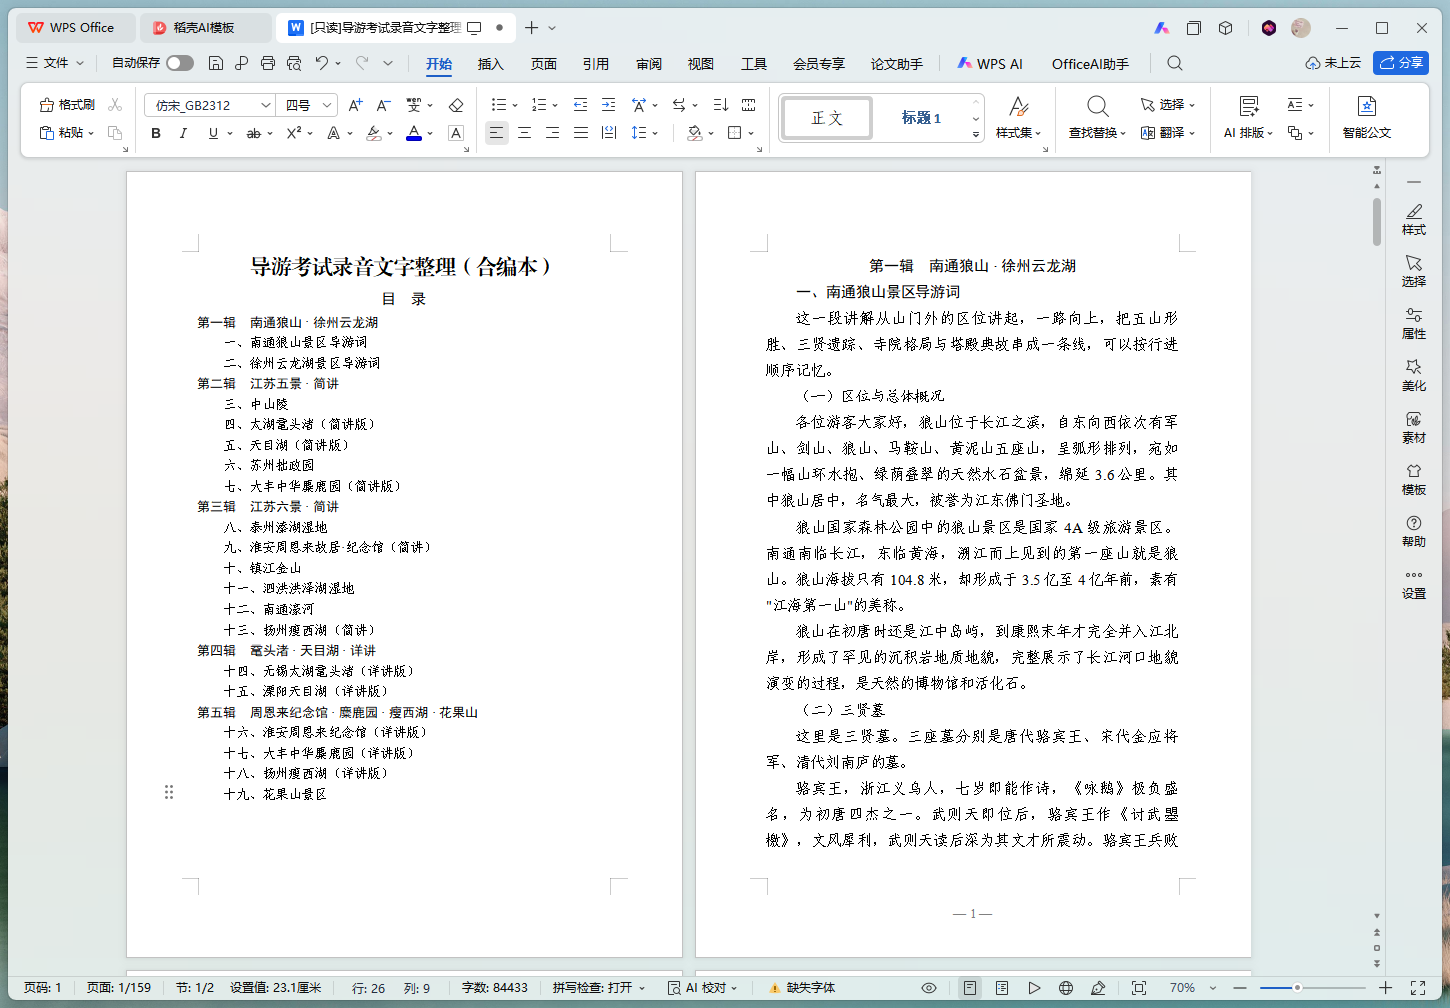
一份 5 辑 / 19 章 / 178 节 的合编本 docx,A4 公文排版、带可跳转目录、页码从 1 起,全部讲解正文完整保留,说明类章节和校正表按约定剔除。从 4.5 小时录音到一份能直接打印背诵的资料,整套流程可复刻。
五、给你的建议
- 长素材先切分再转写,这是最容易卡住的一步;
- 转写结果一定要人工校专名,WorkBuddy 擅长清理结构和排版,但专有名词的"对错"最终要你拍板;
- 想要公文/讲话稿等特定版式,把格式规格直接告诉我,我可以精确到页边距、字号、行距去排;
- 投稿记得审核过后在页面手动领积分,别像很多人一样写完了却忘了点,白丢几千分。
原创声明:本文系作者真实使用 WorkBuddy 的经验总结,未授权不得转载。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号