接手一份没人维护的旧代码,Hy4 帮我理清调用链和重构顺序
原创
接手一份没人维护的旧代码,Hy4 帮我理清调用链和重构顺序
原创
用户12856501
修改于 2026-11-11 15:54:56
修改于 2026-11-11 15:54:56
我提的需求
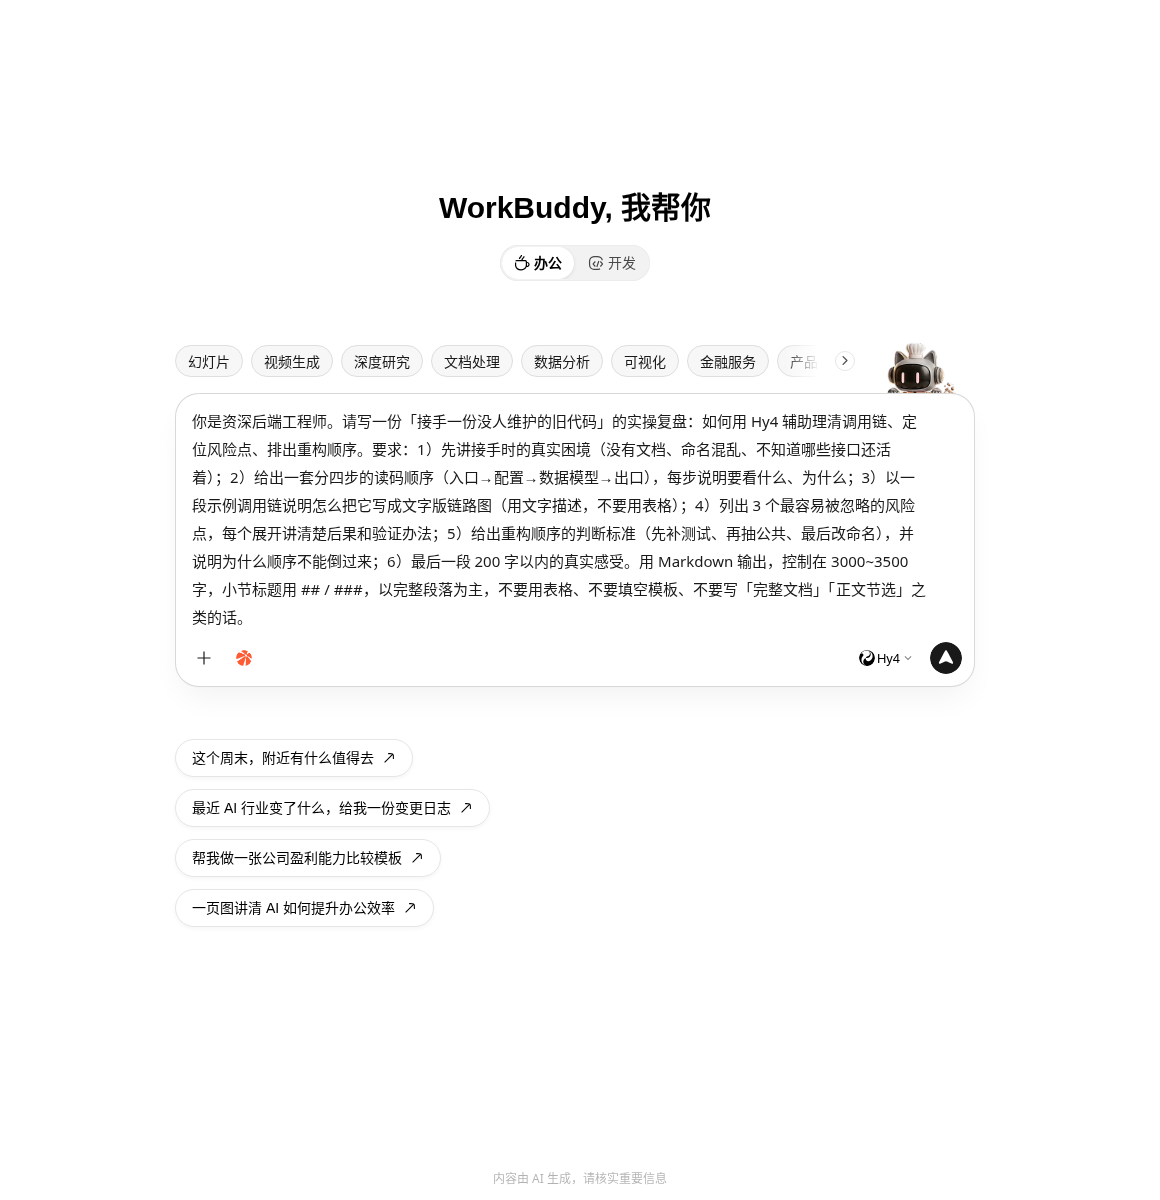
我把一段老服务的接手任务丢给 Hy4:没有文档、命名混乱、不知道哪些接口还活着。要求它给出一套读码顺序、把调用链写成文字版链路图、点出最容易被忽略的风险,并排出重构的先后顺序。
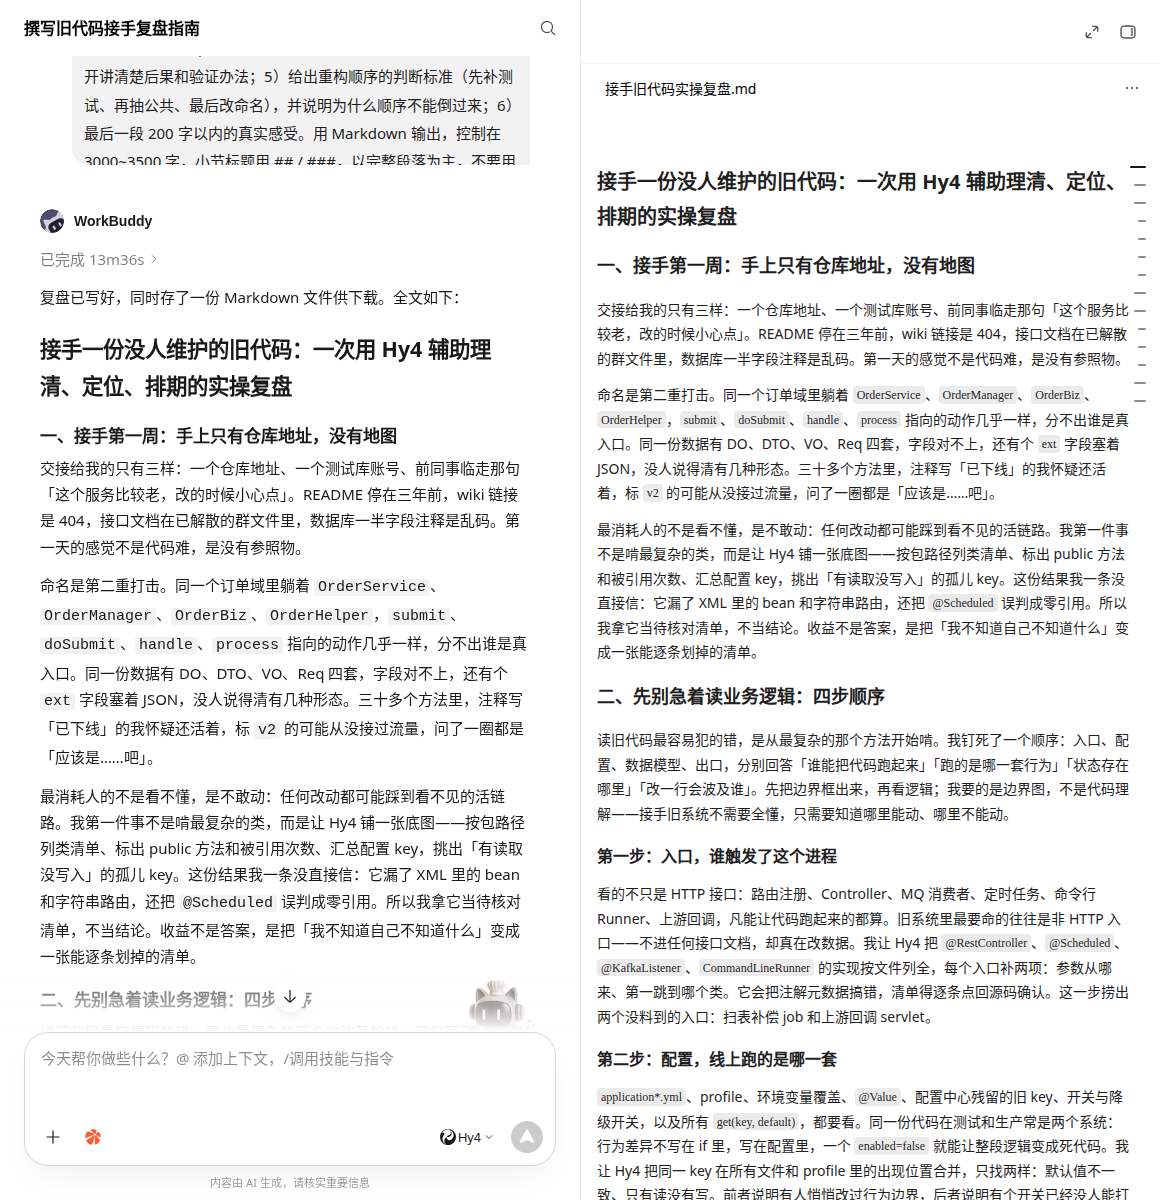
Hy4 的完整产出
接手第一周:手上只有仓库地址,没有地图
交接给我的只有三样:一个仓库地址、一个测试库账号、前同事临走那句「这个服务比较老,改的时候小心点」。README 停在三年前,wiki 链接是 404,接口文档在已解散的群文件里,数据库一半字段注释是乱码。第一天的感觉不是代码难,是没有参照物。
命名是第二重打击。同一个订单域里躺着 OrderService、OrderManager、OrderBiz、OrderHelper,submit、doSubmit、handle、process 指向的动作几乎一样,分不出谁是真入口。同一份数据有 DO、DTO、VO、Req 四套,字段对不上,还有个 ext 字段塞着 JSON,没人说得清有几种形态。三十多个方法里,注释写「已下线」的我怀疑还活着,标 v2 的可能从没接过流量,问了一圈都是「应该是……吧」。
最消耗人的不是看不懂,是不敢动:任何改动都可能踩到看不见的活链路。我第一件事不是啃最复杂的类,而是让 Hy4 铺一张底图——按包路径列类清单、标出 public 方法和被引用次数、汇总配置 key,挑出「有读取没写入」的孤儿 key。这份结果我一条没直接信:它漏了 XML 里的 bean 和字符串路由,还把 @Scheduled 误判成零引用。所以我拿它当待核对清单,不当结论。收益不是答案,是把「我不知道自己不知道什么」变成一张能逐条划掉的清单。
先别急着读业务逻辑:四步顺序
读旧代码最容易犯的错,是从最复杂的那个方法开始啃。我钉死了一个顺序:入口、配置、数据模型、出口,分别回答「谁能把代码跑起来」「跑的是哪一套行为」「状态存在哪里」「改一行会波及谁」。先把边界框出来,再看逻辑;我要的是边界图,不是代码理解——接手旧系统不需要全懂,只需要知道哪里能动、哪里不能动。
第一步:入口,谁触发了这个进程
看的不只是 HTTP 接口:路由注册、Controller、MQ 消费者、定时任务、命令行 Runner、上游回调,凡能让代码跑起来的都算。旧系统里最要命的往往是非 HTTP 入口——不进任何接口文档,却真在改数据。我让 Hy4 把 @RestController、@Scheduled、@KafkaListener、CommandLineRunner 的实现按文件列全,每个入口补两项:参数从哪来、第一跳到哪个类。它会把注解元数据搞错,清单得逐条点回源码确认。这一步捞出两个没料到的入口:扫表补偿 job 和上游回调 servlet。
第二步:配置,线上跑的是哪一套
application*.yml、profile、环境变量覆盖、@Value、配置中心残留的旧 key、开关与降级开关,以及所有 get(key, default),都要看。同一份代码在测试和生产常是两个系统:行为差异不写在 if 里,写在配置里,一个 enabled=false 就能让整段逻辑变成死代码。我让 Hy4 把同一 key 在所有文件和 profile 里的出现位置合并,只找两样:默认值不一致、只有读没有写。前者说明有人悄悄改过行为边界,后者说明有个开关已经没人能打开。
第三步:数据模型,状态存在哪里
表结构、DO 映射、手写 SQL、缓存 key 规则、枚举与魔数、ext 里实际装的东西、状态机流转,都归这步。业务逻辑会骗人,数据不会:命名再乱,最后总要落到某几张表和几个状态字段上。我让 Hy4 把每个 Mapper 方法对应的 SQL 及其读写字段列出来,再推断两类异常——只被读不被更新的字段、代码里出现过却没在枚举里定义的状态值。后者往往意味着只跑过一次的历史逻辑,或已注释掉却仍在处理历史数据的分支。这步也让我确认 ext 里至少有三种互不兼容的 JSON,凡是碰它的重构都得单独排期。
第四步:出口,改一行会炸到哪里
返回值与序列化、异常、发出的消息、外部 RPC、写文件、落库副作用,以及最关键的下游是谁。重构的风险不来自你改的那行,来自它牵动的人。我让 Hy4 对准备动的方法做影响面推演:把实现连同直接调用方贴进去,只问「改了返回结构或异常行为,谁先出错」。名单我从不全信,会再用全局检索和调用日志复核,但比一层层点调用层级快得多。
四步花了两天,后面两周几乎没走回头路。附带好处是每步产物都能交给 Hy4 当下轮上下文,越收越窄,它后面的判断比第一天靠谱。
把一条调用链写成文字版链路图
Hy4 很会画调用关系,但图一复杂就看不清,还容易和代码对不上。我最后用一行一跳、带缩进、写明副作用的纯文字链:能读、能贴进提交说明、能逐行核对源码。以「提交订单」为例:
plaintext POST /api/order/submit → OrderController.submit(OrderReq) // 仍有流量;注解只校验 3 个字段 → BaseReq.checkParam() // catch 里 return false → OrderServiceImpl.submit(req) // @Transactional 起点 → OrderManager.doSubmit(req) // 遗留万能类 → UserAccountMapper.selectById // 读 user_account → CouponDao.lockCoupon(...) // 读写 coupon → OrderMapper.insert(order_main) // 写主单,状态 INIT → RiskFacade.check(...) // 同步 RPC → orderEventProducer.send(...) // 发 MQ,topic=order.created ← 返回 OrderDTO → Result.ok → JSON 旁路:OrderNotifyJob 每 5 分钟扫 INIT 且超 10 分钟的记录,重发 order.created
规矩只有三条:每跳写清「谁调谁、传了什么、留下什么副作用」;一条链控制在十几行,超了就拆;箭头只表示控制流,不表示数据流向。写完把链路连同源码交回 Hy4,只问「哪一跳在源码里不存在」,抓笔误和它的臆造。
逐跳看,坑都藏在平静处。入口其实有两个,OrderController.submit 和 OrderApi.submit 都在,最后靠网关近三十天访问日志确认只有前者有流量——「哪个接口还活着」Hy4 答不了,得靠日志。checkParam() 的 catch 里 return false,调用方根本没接返回值,校验等于没有。事务注解在 Service 层,RPC 和 MQ 却被圈在事务方法内,埋下下一节第一个风险。最关键的是旁路:OrderNotifyJob 不在任何正向调用链上,却会重发同一条消息,只顺主链看会低估消息量;它是让 Hy4 检索「以 INIT 为条件扫 order_main 的位置」才翻出来的。之后我加了条硬规矩:链路图不含旁路就不算画完。
三个最容易被忽略的风险点
三处都不在代码最复杂的地方,恰恰在最像「不用管」的地方。共同点是:本地不复现、测试环境不报警、静态检索够不着。
风险一:事务边界里的外部副作用
@Transactional 管得住数据库,管不住已发出去的消息和已打出去的 RPC。链里 insert 之后紧跟 RiskFacade.check 和 orderEventProducer.send,全在事务方法体内。只要之后任意一步抛异常,主单随事务回滚消失,消息却已进 broker,下游查不到这张单,轻则幽灵记录和告警,重则重试风暴;若 RPC 带扣减语义,还会出现「本地没扣、远端扣了」的对账差,且要等第二天对账才发现。
验证分三层:先让 Hy4 把事务方法体内所有非数据库写操作标出来——发消息、远程调用、写文件、改缓存,再人工确认提交与回滚位置,留意自调用导致注解失效和 REQUIRES_NEW;然后做故障注入,在 insert 后人为抛异常,看 broker 有没有多出消息、下游有没有查单失败;最后翻监控,看有没有「消息量持续大于主单量」的时段,那基本就是它在流血。
风险二:静态搜索够不着的活引用
引用不一定是符号,可能只是一个字符串:XML 里的 bean 名、调度平台的 job 全限定类名、Class.forName、配置表里的 handler 名、MQ topic 常量,甚至数据库记录里的 class_name。IDE 显示 0 references,你放心删掉,本地全绿,上线后定时任务报 ClassNotFound,或某个下游回调突然 404。示例里的 OrderNotifyJob 正是这类:调度中心按字符串触发,代码里没有一处调它。这也是「不知道哪些接口还活着」的根源——活着不等于被代码引用着。
验证要把检索面从符号扩到文本:类名、方法名、path 字符串、配置 key 四类分别做全仓纯文本检索,覆盖 xml、yml、properties、SQL 脚本和调度平台配置,Hy4 擅长这种机械比对;平台上的配置它看不到,必须人登录导出。另一半靠流量反推:从访问日志按 path 统计近三十到九十天调用量,从 broker 控制台看消费组是否还在线。凡是「代码里零引用、日志或配置里有痕迹」的,一律标「存活待定」,没有明确下线证据不许删。
风险三:被吞掉的异常和漂移的默认值
老代码常靠静默降级活着:catch (Exception e) { return null; }、config == null 时赋老默认值、getOrDefault 里写死兜底。重构时把 return null 改成抛异常、把散在四个文件里的默认值统一成「更合理」的值,控制流没变,行为却变了:上游本来靠 null 走降级,现在直接 500;默认值不一致时,统一等于悄悄打开一条没跑过的分支。这类改动不报错,往往隔几天才在报表上显出来。
验证是先把现状当契约记下来,而不是当 bug 改掉。让 Hy4 列出所有空 catch、带默认值的配置读取,以及同一 key 在不同文件里的默认值差异;再补一组边界输入——空值、超时、字段缺失、开关关闭——把返回值和落库结果原样记下,这组记录后来成了特征测试的断言来源。这里必须按住工具:Hy4 会积极把这些兜底判成「该修的坏味道」,而接手阶段是还原,不是纠正;一个被吞掉的异常可能正是上下游多年默契的一部分。
重构顺序:补测试、抽公共、改命名
三步各有一个开工门槛,达不到就不许动生产代码。顺序不是习惯,是成本,不能倒过来。
先补测试,补的不是「期望行为正确」的测试,是特征测试:把现状钉死,包括别扭的、疑似 bug 的行为。门槛很硬——目标模块得有一条本地能稳定跑通的测试,覆盖主链路一次成功路径,加至少两个上一节记录的边界输入;跑不起来就一律不动。为什么第一:后面每步都要回答「行为有没有变」,没这张网只能靠猜,而旧系统猜错的代价是线上告警。我让 Hy4 生成测试骨架,但断言值只取真实输出,绝不让它按合理逻辑推期望值——那测的是它以为的系统。
再抽公共:把校验、DO 与 DTO 转换、拼查询条件、重复兜底分支收敛到一处。门槛两个——同一逻辑出现三次以上,且抽取后全量测试仍全绿、调用链不新增跨层跳转。为什么在补测试之后:抽取是结构性改动,最容易手滑改掉语义,必须有网兜着。为什么在改命名之前:抽取会重划边界,边界一变名字语义跟着变,先改名等于抽完还得再改;OrderManager 这种万能类,只有先把重复的校验和转换搬走,才看得清剩下的部分该叫什么。
最后改命名。门槛最宽松也最严格:行为与结构都已冻结,改动只涉及符号、注释和目录,不碰控制流、不碰配置 key、不碰任何字符串路由——最后这条正是风险二的教训;验收靠 IDE 全局重命名、全量测试和一次全仓检索。它排最后,因为命名最便宜,也最容易制造「今天干了好多事」的错觉,一点都不降低风险。倒过来的代价有三个:没有测试时连改名都不安全,反射和字符串引用会静默断掉;大面积改名会污染链路记忆,也让 Hy4 的符号索引失效,后面定位风险点时它给的位置和我对不上号;名字跟着边界走,边界没定就贴标签,返工是必然的。
三步其实是一条可验证性的依赖链:测试生产可验证性,抽取消耗它,命名几乎不消耗、却依赖前两者的稳定基线。所以标准可以压成一句话——开工前只问「如果这步改错了,我多久能发现」。补测试把答案从「上线后」拉到「几秒内」,抽取依赖这个「几秒内」,命名则要求它已经稳定运行了一阵子。倒过来,等于在没有基线的地方做最需要基线的判断。
最后:一点真实感受
那两周最难受的不是看不懂,是明明看懂了也不敢改。Hy4 帮上最大忙的地方不是给答案,是把我心里那团「不知道自己不知道什么」摊成一张能逐条划掉的清单;它列得很快,也漏得很多,我差不多一半时间花在核对它、否掉它。后来慢慢觉得,老代码不是敌人,是一堆当年有人做过、却没人替它留下解释的决策,所谓重构,多半只是在替那些人把解释补上。技术部分能验证,感受不能;最后签字、半夜接告警的,还是人。所以这段我写得比前面慢。
用下来的真实感受
- 最省时间的是把「我不知道自己不知道什么」摊成一张能逐条划掉的清单,省得自己在包路径里瞎翻。
- 它给的底图不能全信:XML 里的 bean、字符串路由、@Scheduled 这类活引用它都漏过,我一条条核对后才敢用。
- 免费档跑这种结构化复盘完全够用,缺点是任务越大等得越久,赶时间得提前排。
- 技术部分能验证,感受不能;最后签字、半夜接告警的,还是人。
#WorkBuddy #Hy4
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号