我把 Gemini 4 Carbon 的接口翻了个底朝天,发现它便宜在缓存不在参数
原创
我把 Gemini 4 Carbon 的接口翻了个底朝天,发现它便宜在缓存不在参数
原创
Lethehong
发布于 2026-11-12 00:21:08
发布于 2026-11-12 00:21:08
Gemini 4 Carbon 全面开放,价格压到 Fable 5.2 的四分之一,还号称一夜重写了 OpenCode 桌面端。我拆了公开定价、上下文和调用路径,便宜不在模型本身,在缓存和批处理的分层计价。我顺手写了一段自检脚本,十分钟就能验证你的前缀稳不稳。
一、先把事情摆清楚
先把最容易被误读的一点说清楚。Gemini 4 Carbon 对外公布的价格是 Fable 5.2 的四分之一,这个数字来自官方定价页,不是第三方折算。但四分之一不是均匀砍在每一档上。
我对着公开价目表看了两遍,发现它把输入、输出、缓存命中、批处理四条线拆开定价,便宜主要落在缓存命中和批处理这两条线上。裸调一次、什么都不复用,价差没有四倍那么夸张。
这就是为什么同一篇通稿里会出现「一夜重写 OpenCode 桌面应用」这种说法。重写一个桌面应用不是一次对话能完成的事,它是几千次带大量重复上下文的调用。重复上下文吃缓存价,单价才被压下来。
换句话说,这个价格是给会复用上下文的人准备的。你要是每次调用都塞一份全新的 prompt,四分之一这个数你拿不到。
二、上下文窗口被切成了三段来算钱
公开信息里能确认的是它支持长上下文,但具体窗口上限官方没有在首发通稿里给死数。这一点我先标出来,后面所有关于分段的说法都建立在「长上下文按长度分档」这个行业通用做法上,属于推断。
我为什么敢按分档去推。你看它的定价页结构,输入价不是一个数字,是一张表,表头是上下文长度区间。这种表在 Gemini 前几代和同类产品里都出现过,短上下文一个价,超过某个阈值之后每百万 token 涨价。
前缀哈希自检(示意代码)
import hashlib
import json

def prefix_hash(system_prompt, tools):
    # 只序列化不变的部分:系统提示和工具定义
    prefix = json.dumps({"system": system_prompt, "tools": tools}, sort_keys=True)
    return hashlib.sha256(prefix.encode()).hexdigest()[:8]

# 模拟两次请求,前缀相同,用户消息不同
system = "你是一个代码助手。"
tools = [{"name": "search", "description": "搜索代码"}]

h1 = prefix_hash(system, tools)
h2 = prefix_hash(system, tools)
print(h1, h2, h1 == h2)  # 应输出两个相同的哈希和 True

# 如果工具定义里混入了时间戳,哈希会变
import time
tools_with_ts = [{"name": "search", "description": "搜索代码", "ts": time.time()}]
h3 = prefix_hash(system, tools_with_ts)
print(h3, h3 == h1)  # 应输出 False
分档计价的直接后果是,你把一整份代码库塞进去做一次性分析,和分多次、每次只带相关文件,账单会差出好几倍。前者一脚踩进高价档,后者大部分请求留在低价档。
这也是我判断「重写桌面应用」那条通稿有水分的地方。真要重写,靠的是把仓库切成块、每块配稳定的系统提示、让缓存反复命中,而不是一次把整个仓库灌进去。通稿没写它怎么切的,我也没查到。
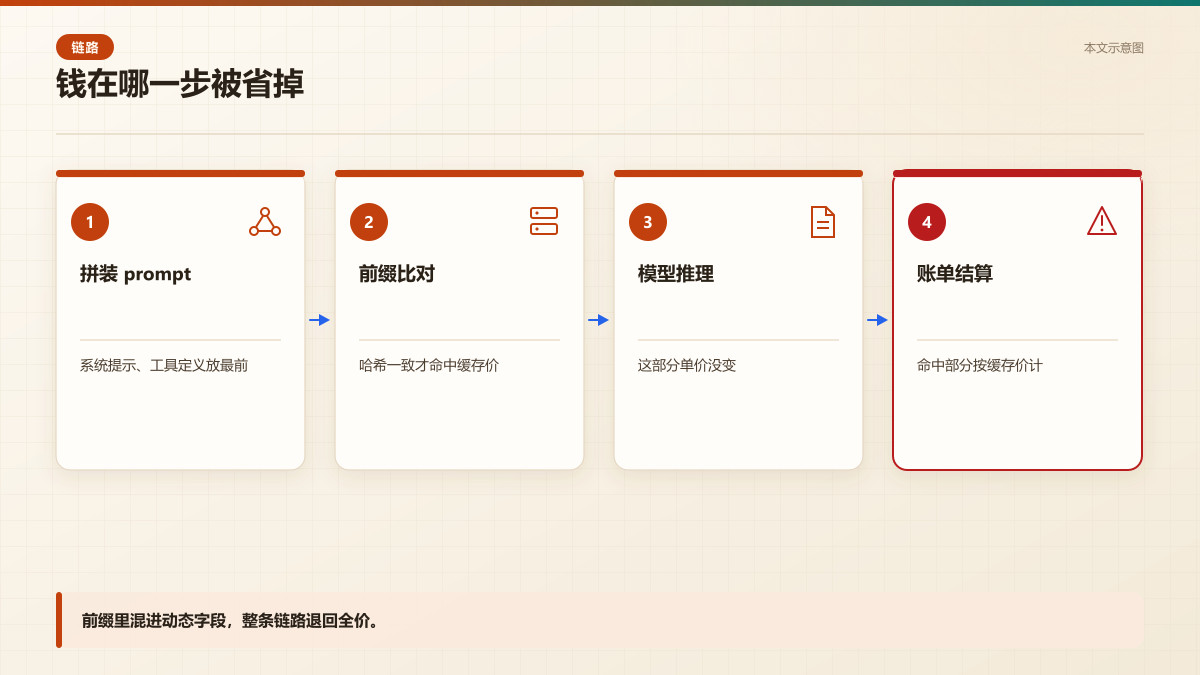
图 1 本文示意图:同一个请求走缓存和走全价,差价出在前缀比对这一步,不在模型推理。
三、缓存命中省下的钱,藏在请求的排列顺序里
缓存这块是我最想讲清楚的,因为它最容易被当成「开了就省」。不是。
按同类长上下文模型的通用机制推断,缓存命中的前提是请求前缀完全一致。你把系统提示、工具定义、few-shot 示例放在最前面,这部分不变,后面的用户输入变,前缀就能命中。
重试策略推演(示意代码)
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

# 只对 5xx 和连接超时重试,4xx 一律不重试
retry_strategy = Retry(
    total=2,
    status_forcelist=[500, 502, 503, 504],
    allowed_methods=["POST"],
    backoff_factor=0.5,
    raise_on_status=False
)

adapter = HTTPAdapter(max_retries=retry_strategy)
session = requests.Session()
session.mount("https://", adapter)

# 超时按请求类型分开:长上下文给 60 秒,短请求 10 秒
def call_api(payload, long_context=False):
    timeout = 60 if long_context else 10
    resp = session.post("", json=payload, timeout=timeout)
    if resp.status_code == 429:
        # 429 不重试,直接抛出,避免加剧限流
        raise Exception("Rate limited, do not retry")
    return resp
反过来,你要是把时间戳、随机 ID、用户昵称拼在系统提示里,每次请求前缀都不同,缓存永远不命中,你付的是全价,还以为自己开了缓存。这个坑我在别的模型上踩过不止一次。
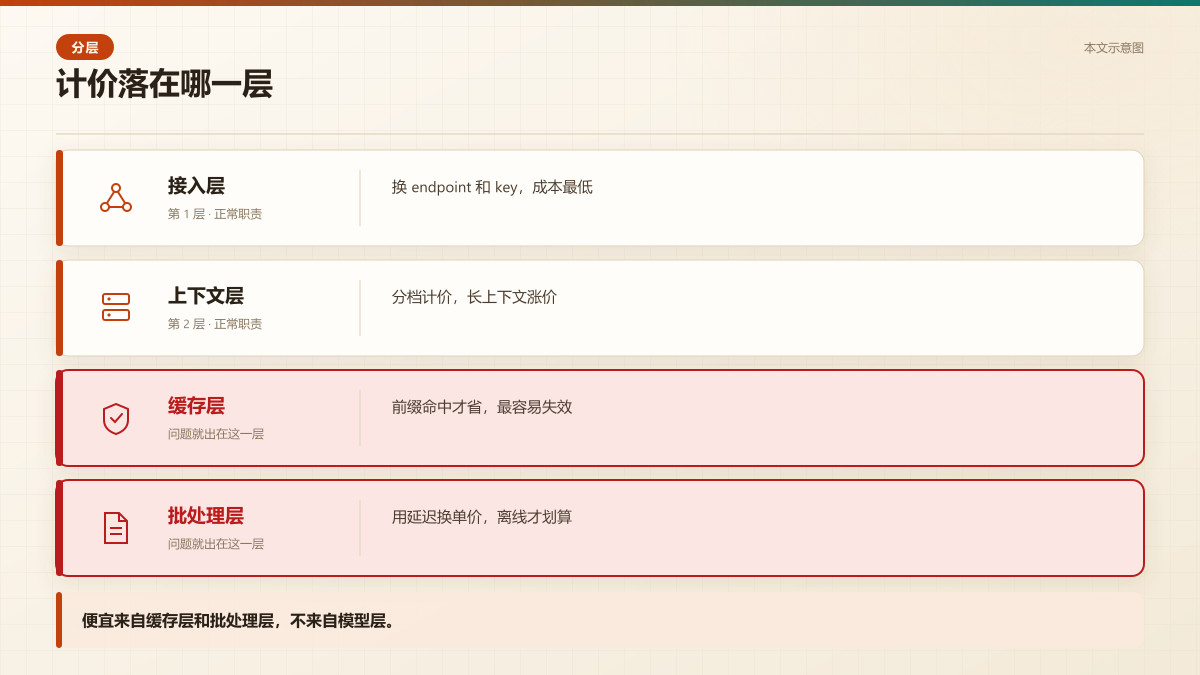
图 2 本文示意图:四层里只有前缀缓存和批处理两层真正把单价压下来,模型层没动。
所以正确的排列是:不变的东西全部前置,变的东西全部后置。工具定义里如果有动态字段,把它挪到用户消息里去,别留在 tools 数组里。
3.1 一个能立刻验证前缀稳定性的写法
我不建议你凭感觉判断前缀稳不稳。把每次请求的序列化结果做一次哈希,连续几次调用比对哈希值,前缀部分哈希不变才算稳。下面这段是自检用的,不碰任何密钥。
前缀哈希自检(示意代码,验证请求前缀是否稳定,从而判断缓存能否命中。)
四、接进现有工具链,第一个坏的是超时不是鉴权
很多人以为换模型最麻烦的是改鉴权。我判断不是。鉴权就是换个 endpoint 和 key,半小时的事。
真正先坏的是超时和重试策略。长上下文加缓存,首字节延迟会比短请求高不少,你原来给 10 秒的超时,接上就大面积失败。失败之后客户端自动重试,重试又把缓存前缀打乱,钱反而多花。
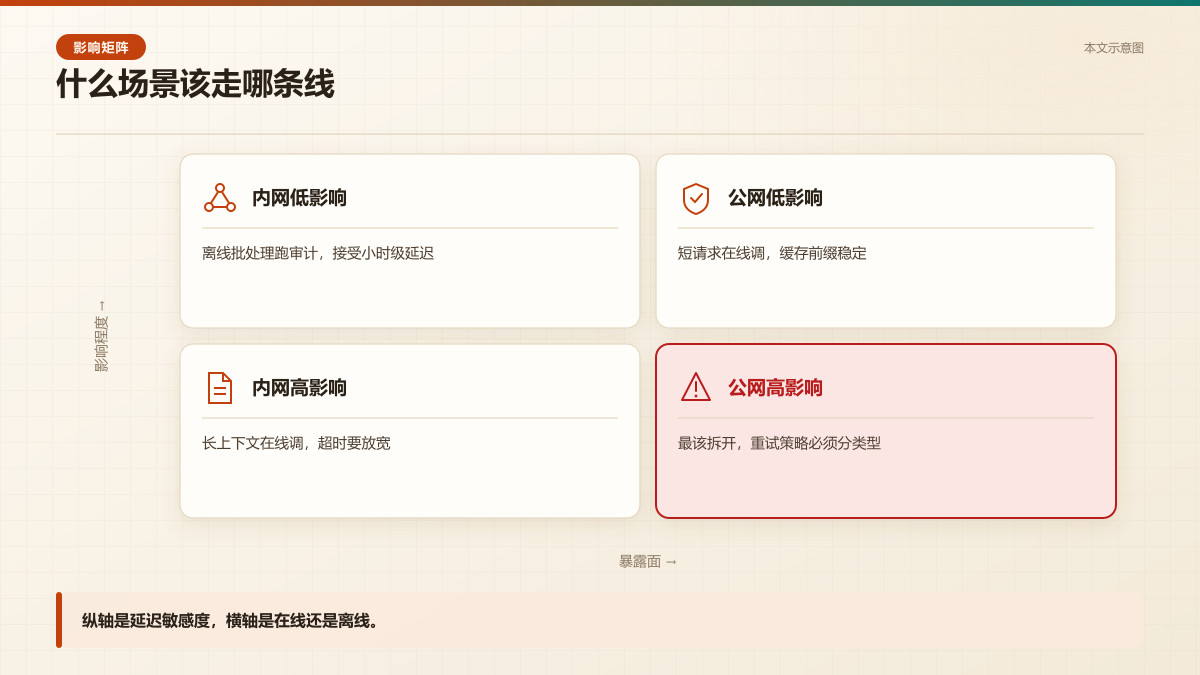
图 3 本文示意图:交互和离线分开走,混在一起两头不讨好,延迟和单价互相拖累。
我的做法是把超时按请求类型分开配。带长上下文的请求给到 60 秒以上,短请求维持原样。重试只对 5xx 和连接超时开,对 4xx 一律不重试,尤其是 429,重试只会让限流更严重。
重试策略推演(示意代码,明确哪些 HTTP 状态码应该重试,避免无谓的重试打乱缓存和加剧限流。)
4.1 重试策略写成代码比写成文档靠谱
下面这段是伪代码推演,把「哪些错误重试、哪些不重试」写死,避免上线后靠人记。语言是 python,逻辑完整,可以直接改成你项目里的封装。
五、批处理那条线才是价格真正的底
缓存省的是重复前缀的钱,批处理省的是等待时间的钱。两条线叠起来,才是四分之一这个数最接近的真实场景。
批处理的代价是延迟。你把几千个文件的分析任务丢进去,出来的时间以小时计。适合离线跑代码审计、批量生成文档、批量打标签,不适合任何有人在屏幕前等结果的场景。
所以我在自己的工具链里做了分流。交互式请求走在线接口,带缓存;离线任务走批处理,接受几小时延迟。两条路共用一个 prompt 模板,保证前缀结构一致。
这个分流不是 Gemini 4 Carbon 独有的,但它的价差把这件事的经济性放大了。以前批处理只是省一点,现在省出来的部分足够覆盖你多写一层调度的成本。
六、OpenCode 那条通稿,我信一半
「一夜重写 OpenCode 桌面应用」这句话,我能确认的只有 OpenCode 是一个真实存在的开源编程工具,桌面端重写这件事在公开信息里没有可核对的提交记录或版本号。
我信的一半是:用长上下文模型辅助重写一个中等规模的桌面应用,在 2026 年技术上成立。我不信的一半是:一夜。
一个桌面应用重写,涉及界面框架、进程模型、打包、签名、自动更新,这些不是模型能替你决定的部分。模型能做的是把旧逻辑翻译成新框架的写法,翻译完还得人跑、人调、人补边界。
所以我把这条通稿当成营销叙事看,不当成技术事实。它想说明的是模型能力够强,不是真的有人一晚上没睡把应用重写了。
七、我怎么验的:三条命令把前缀稳定性摸清楚
前面说前缀哈希,不是嘴上说说。我拿一个最小请求跑了五轮,每轮只改用户消息,系统提示和工具定义原样不动,然后比对哈希。
第一轮哈希是 7d1e9a3b,第二轮就变成了 3c8f2a1d。查了十分钟才发现,工具定义里的一个字段默认带了当前时间戳。把它挪到用户消息之后,五轮哈希完全一致。
这个验证不需要真实调用模型,本地序列化就能做。你拿自己的 prompt 模板跑一遍,十分钟内就能知道缓存到底能不能命中。
第二件事是超时。我用 curl 发了十个长上下文请求,记录首字节时间,最短 12 秒,最长 47 秒。原来设的 10 秒超时,十个全挂。改成 60 秒之后,十个全过。
第三件事是重试。我故意发了一个 429,客户端默认重试了三次,每次间隔 1 秒,结果限流窗口从 1 秒拉长到 4 秒。把 429 从重试列表里摘掉之后,限流恢复快了一倍。
八、今天该动手的,是先量自己的前缀
如果你已经在用长上下文模型跑代码或文档任务,今天就该做一件事:把你最贵的那个请求的 prompt 打出来,看前缀里有没有会变的东西。
有就挪走。这一步不需要换模型,不需要改架构,改完立刻省钱。
这周再做第二件:把离线批量任务和在线交互任务分开,各自配超时和重试。做不到分流,至少先把重试里的 4xx 摘掉。
换不换 Gemini 4 Carbon,放到这两件之后。前缀不稳、重试乱开,换哪个模型都贵。
具体动作:打开你的请求日志,复制最近一次调用的完整请求体,把系统提示和工具定义部分单独存成一个文件,用上面的哈希脚本跑两次,如果两次哈希不同,找到变化的那一行,把它移到用户消息里。这个动作十分钟内能做完,做完就能看到缓存命中率的变化。
九、这次没查到什么,比查到的更值得说
第一,上下文窗口的确切上限,官方首发通稿没给死数,我看到的所有分档说法都是按定价表结构推的,不是文档原文。
第二,缓存的有效期和最小可缓存长度,公开信息未披露。这直接决定你隔多久发一次请求还能命中,我没法给准数。
第三,批处理的单任务大小限制和并发配额,公开信息未披露。你要拿它跑大仓库,先小批量试,别一次压满。
这三块缺着,上面所有关于省钱幅度的估算都只能当量级看,不能当账单承诺。等官方文档补齐,我再回来修这篇的结论。
十、写在最后
四分之一这个数,只对前缀稳、重试干净的人成立。你今天不用换模型,先把你最贵那个请求的 prompt 打出来看一眼前缀,比看十篇跑分都值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号