PDF 结果链接过期后无法下载?先把文件归档和临时地址分开
原创
PDF 结果链接过期后无法下载?先把文件归档和临时地址分开
原创
Youna
修改于 2026-11-13 16:24:25
修改于 2026-11-13 16:24:25
一份转换后的 PDF 当天能打开,几天后再下载却失败。排查时,先确认两件事:结果文件是否已经存到自己的系统;用户手里的地址是否仍然有效。文件存在与链接可访问,是两个不同条件。
如果数据库只保存了上游转换服务返回的地址,业务下载就会依赖那个地址的生命周期。更可靠的做法是及时取得结果文件,验证后归档,用户下载时再根据权限提供访问方式。
服务返回地址,不代表长期交付地址
例如,ComPDF 图片转 PDF 接口返回处理结果后,应用还需要下载 PDF 并保存。接口负责转换;归档位置、文件权限和业务记录由自己的应用决定。可以在 ComPDF 图片转 PDF 接口文档中核对当前版本的结果结构与下载限制。
这里讨论的是“结果已经生成,怎样可靠保存”的后半段,不把转换请求、文件落盘和用户下载混成一个成功状态。
建议至少区分:
状态 | 必须确认的结果 |
|---|---|
converted | 上游业务状态和文件状态成功,取得本次结果 |
downloaded | 下载完成,文件格式及内容可读取 |
stored | 写入自己的持久存储,记录对象键和版本 |
ready | 当前用户有权访问,业务可以提供下载 |
表中的名称由应用定义。HTTP 200 只说明请求层没有返回错误,不能替代后面的检查。
下载时,先写临时文件,再验证并改名
下面是一段 Python 3 的 PDF 结果归档示例。安装 requests 和 pypdf 后,将从受信任转换服务取得的结果 URL 传给函数。不要把它开放成接收任意用户网址的下载接口;部署时应限制目的域名、重定向和网络出口,避免服务端请求伪造风险。
import hashlib
import os
import tempfile
import uuid
from pathlib import Path

import requests
from pypdf import PdfReader


def archive_pdf(download_url, directory, max_bytes=30 * 1024 * 1024):
    directory = Path(directory)
    directory.mkdir(parents=True, exist_ok=True)
    fd, temporary = tempfile.mkstemp(prefix="pdf-", suffix=".part", dir=directory)
    temp_path = Path(temporary)
    digest = hashlib.sha256()
    size = 0
    try:
        with os.fdopen(fd, "wb") as local:
            with requests.get(download_url, stream=True, timeout=(10, 60),
                              allow_redirects=False) as response:
                if response.status_code != 200:
                    raise ValueError("结果地址未返回完整文件")
                for chunk in response.iter_content(64 * 1024):
                    if not chunk:
                        continue
                    size += len(chunk)
                    if size > max_bytes:
                        raise ValueError("结果超过本次允许的文件大小")
                    digest.update(chunk)
                    local.write(chunk)
        with temp_path.open("rb") as check:
            if check.read(5) != b"%PDF-":
                raise ValueError("结果不是预期的 PDF 文件头")
        reader = PdfReader(str(temp_path))
        pages = len(reader.pages)
        if pages == 0:
            raise ValueError("结果没有可读取页面")
        target = directory / (uuid.uuid4().hex + ".pdf")
        temp_path.replace(target)
        return {"path": str(target), "size": size,
                "sha256": digest.hexdigest(), "pages": pages}
    finally:
        temp_path.unlink(missing_ok=True)
调用方式是 record = archive_pdf(download_url, "results")。其中 download_url 必须替换为本次成功任务的真实返回值,不能用原文件地址或文档示例占位值。函数会拒绝重定向,遇到实际服务需要重定向时,应先检查其规则并显式验证目的地址,不能简单取消限制。
这段代码把下载中断、超出大小、错误文件头及无法解析的结果挡在正式文件之外。改名发生在同一目录、下载与解析完成之后;它不是数据库和对象存储的分布式事务。连接和读取超时也不是整个批次的总时限,生产队列仍需设置任务级期限。
文件能被解析,不代表页面内容已符合业务要求。页数、方向、文字和图像仍需要按转换任务核对;SHA-256 用于记录本地收到的字节,未与可信预期值比较时,不能称为完整性已经得到上游证明。
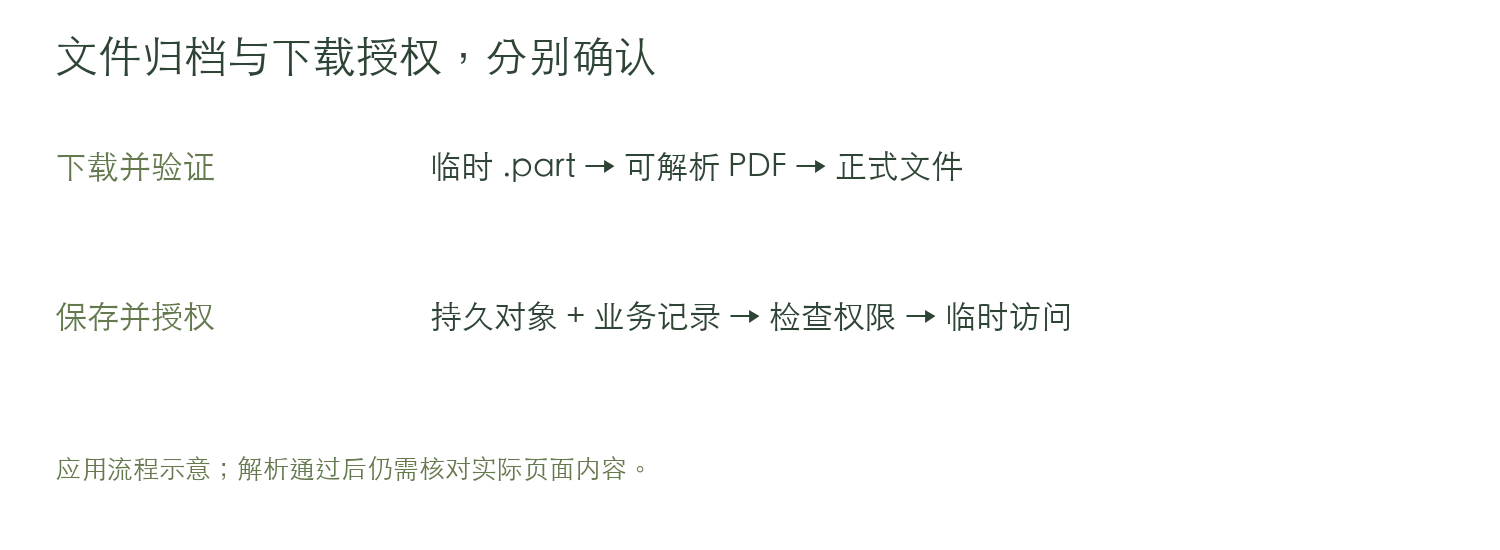
文件归档与下载授权分别确认
图:应用处理流程示意,不是产品运行截图。
从本地文件接到对象存储
本地下载通过后,再上传到 COS 等持久存储。对象键使用业务文件 ID、版本或唯一标识,避免两份同名文件覆盖。上传成功后才把对象键和版本写入业务记录,失败时保留可重试状态。
如果存储成功、数据库提交失败,可能出现孤立对象。可以记录待清理对象,或由定期清理任务回收;数据库回滚不会自动删除对象。反过来,也不能先把数据库标为 ready,再异步上传而不处理上传失败。
文件记录建议保存源文件版本、上游任务 ID、结果序号、对象键、字节数、页数及状态。一次产生多个结果时,每个结果分别记录,不能只保存第一项。
用户下载时,再检查权限
业务接口根据文件 ID 查询对象,不直接接受客户端提供的任意对象键并签名。确认用户有权访问后,可以返回短期签名地址,或通过有权限校验的下载接口发送文件。
签名地址失效时,重新鉴权后生成新的地址;不要把桶改成公有读来解决过期问题。已经签发的地址可能在剩余有效期内继续可用,这个期限也应纳入权限设计。
最后用四个失败场景检查:下载中断不能留下正式文件;上游返回 HTML 错误页不能保存成成功 PDF;存储失败不能提前显示可下载;用户失去权限后不能继续取得新地址。
完成接入的判断,是关闭页面后重新进入,仍能通过业务权限取得自己存储中的文件。临时地址只负责本次传输,持久存储负责保留文件,业务接口负责访问授权。把这三个职责分开,才不会让一条过期链接变成整份材料丢失。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号