DolphinDB 工业IoT故障根因定位实战:告警时间聚类与设备拓扑传播分析
原创
DolphinDB 工业IoT故障根因定位实战:告警时间聚类与设备拓扑传播分析
原创
Xxtaoaooo
发布于 2026-11-14 01:08:32
发布于 2026-11-14 01:08:32
摘要
处理过告警风暴的人都知道,风暴过去之后真正的问题才开始:这 200 条告警里,哪一条是根因,哪 199 条是症状?
三号产线停电,线下 200 台设备依次离线,加上电压跌落、通讯中断、温控失效……半小时内几百条告警涌进来。降噪做得好,风暴压成了一片"安静";但安静的另一面是——如果当时没人盯着,事后面对的还是一长串告警列表,要靠人从里面翻出"先坏的那个"。
告警降噪解决的是"少报"(让每条值得看),根因定位解决的是"找头"(找到该去现场看哪台)——这是两个问题,后者常常没有工具支撑,全凭老师傅的直觉和翻屏的耐心。
好消息是,根因定位需要的东西,时序平台恰好都有两块拼图:时间(谁先告警——告警流的时间结构)和拓扑(谁在上游——设备之间的供电与工艺层级)。把告警按时间聚成"事件簇",把簇内设备沿拓扑往上溯,时间和位置一合成,一份按嫌疑度排序的清单就出来了。
本文把这套方法完整走一遍:风暴窗口检测、告警时间聚类、拓扑表设计与上溯、时间 × 拓扑的根因评分、从嫌疑清单到确认闭环。先说清楚一点:输出的是嫌疑清单,不是判决书——算法给坐标,人给结论。
特别说明:本文基于个人在 IoT 场景下的设计与使用经验,涉及的方法与判断来自有限测试,不代表官方或专业结论。
一、症状与根因:200 条告警里的那 1 条
1.1 症状是怎么淹没根因的
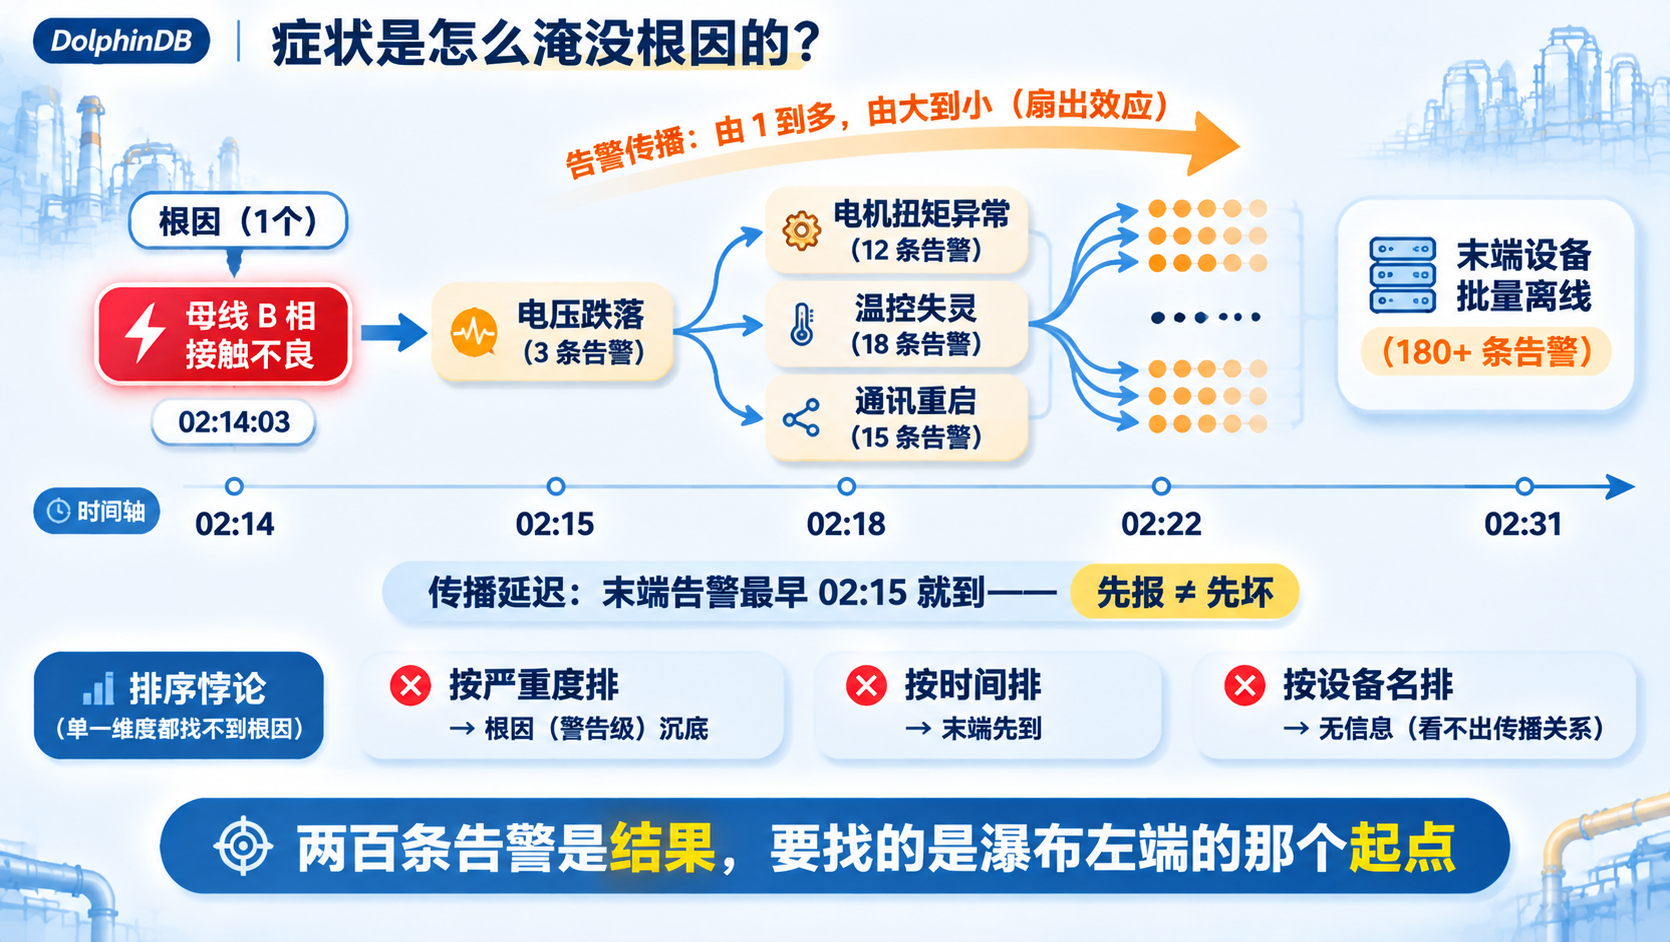
一个真实的传播链:配电柜 B 相接触不良 → 电压跌落 → 产线上电机扭矩异常、温控失灵、通讯模块重启、末端传感器批量离线。一个根因,七八种症状,两百条告警。
麻烦在于,告警列表的呈现方式恰好帮倒忙:
- 按严重度排——温控失效(严重)排在配电柜告警(警告)前面,越排越靠后
- 按时间排——最近的是末端离线(传播末端),不是根因
- 按设备名排——毫无信息量
排序方式回答不了"从哪查起",因为根因既不是最近的,也不一定是最严重的。
1.2 人肉排查的三个盲区
- 只看时间:传播有延迟,末端告警可能先于根因到达(根因设备自己的告警规则可能更迟钝)。谁先报 ≠ 谁先坏
- 不知道拓扑:不看供配电图,就不会想到那 47 台"毫无关系"的设备其实挂在同一段母线下
- 告警名不对应层级:设备级告警名里没有"母线"两个字,根因藏在设备层之上
1.3 两块拼图
根因定位需要的全部原料,就两样:
- 时间结构——告警流里,同一事件的告警在时间上聚簇;簇内的时间顺序是传播顺序的近似
- 拓扑结构——设备不是平铺的,供配电和工艺把它们组织成层级;传播永远从上游往下游走
接下来两节分别处理这两块,第四节把它们合成为评分。
二、第一块拼图:告警的时序结构
2.1 先认出风暴:滑动窗口计数
根因分析的前置问题是"有没有发生事件"。告警量本身就是一个时序信号,用滑动窗口计数检测风暴:
// 告警流按 5 分钟桶计数,突增即风暴起点
stormDetect = select bar(ts, 5m) as window,
       count(*)                as alert_count
from loadTable("dfs://iot", "alertLog")
group by bar(ts, 5m)

// 近 5 分钟告警量超过前 1 小时均值的 5 倍 → 风暴
select * from stormDetect
where alert_count > 5 * mavg(alert_count, 12) // 12 个 5 分钟桶 = 1 小时风暴窗口确定了分析对象:只需要分析告警量异常的这段窗口,不用全量翻查。
2.2 时间聚类:把散告警聚成事件簇
风暴窗口内的告警,用"间隔切分"聚成簇:相邻两条告警间隔小于阈值(如 3 分钟)归入同一簇,间隔超阈值开新簇:
// 按时间排序后,间隔 > 3 分钟的地方"切开",形成簇号
clustered = select ts, deviceId, ruleName,
       cumsum(iif(ts - prev(ts) > 3 * 60 * 1000, 1, 0))   as clusterId
from (
    select * from loadTable("dfs://iot", "alertLog")
    where ts between datetime(2026.03.15 02:00:00) : datetime(2026.03.15 03:00:00)
    order by ts
)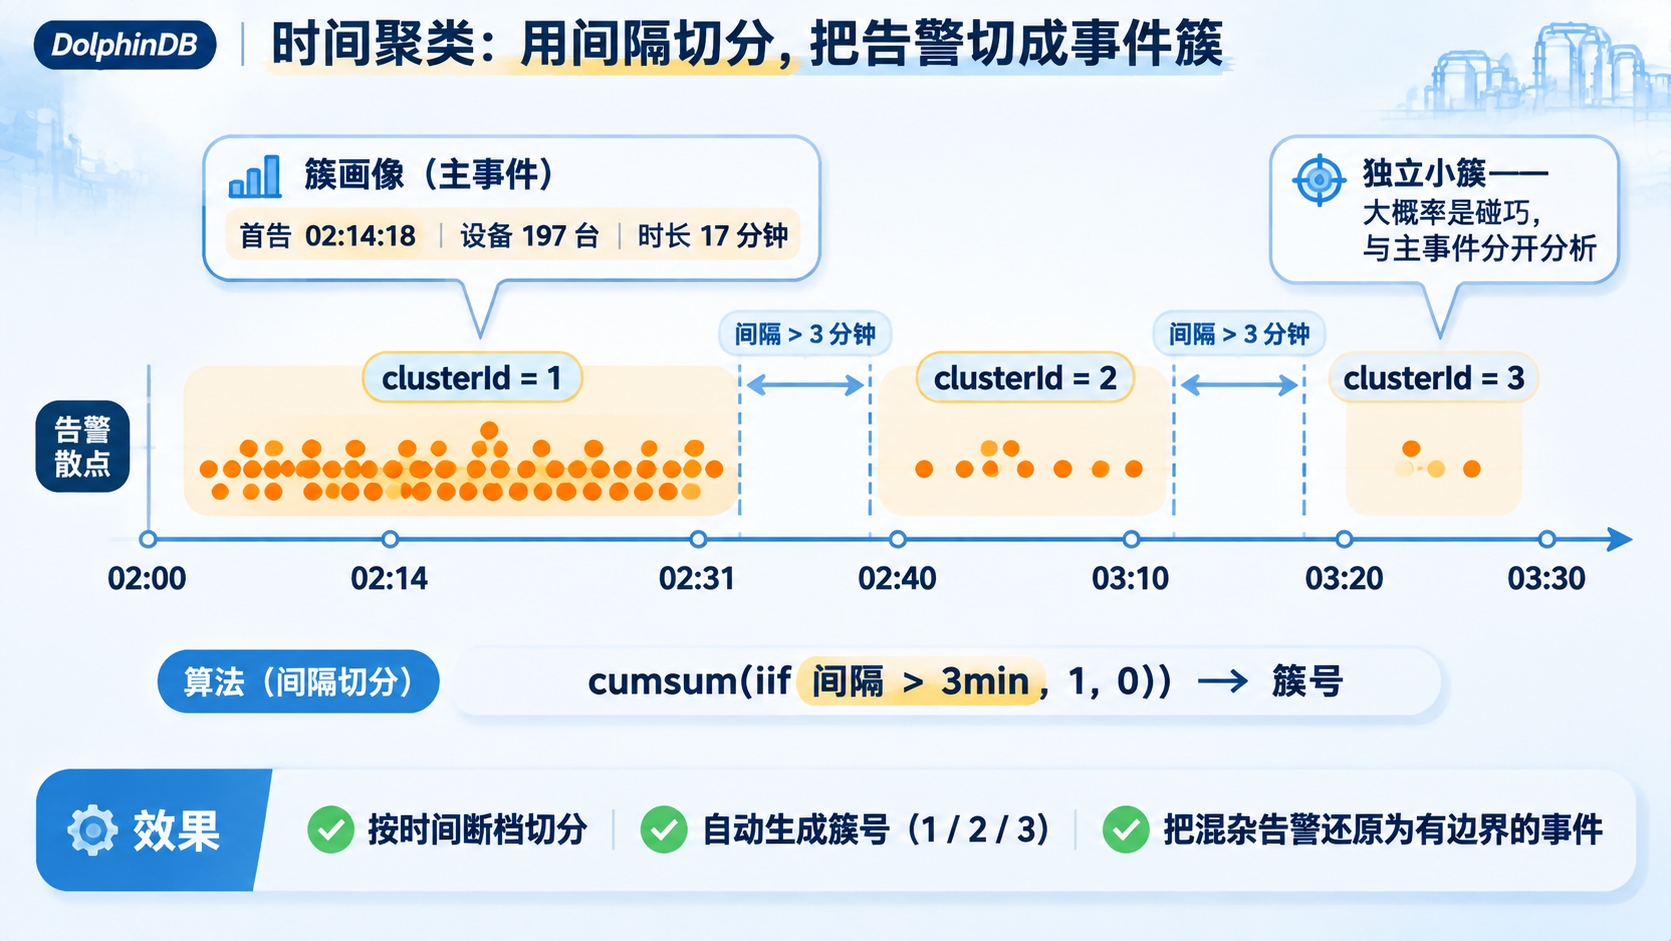
cumsum(iif(间隔超阈值, 1, 0)) 是个常用技巧:每次"断档"计数器加一,断档之间的告警共享同一个 clusterId。一次停电事件触发的几百条告警,就此聚成一个(或少数几个)事件簇。
2.3 簇的画像
每个簇提炼一行画像——这是后面所有分析的工作单元:
// 事件簇画像:首告时刻、首告设备、规模、时长
clusterProfile = select clusterId,
       min(ts)                        as first_ts,
       first(deviceId)                as first_device,   // 按时间排序后的第一个
       count(*)                       as alert_count,
       count(distinct deviceId)       as device_count,
       max(ts) - min(ts)              as duration
from clustered
group by clusterId
首告设备和首告时刻是初步线索——但正如 1.2 节所说,它可能被传播延迟误导。要坐实,得看第二块拼图。
三、第二块拼图:设备拓扑
3.1 拓扑表:边表设计
设备的层级关系(供电段 → 产线 → 设备,或 车间 → 工段 → 设备)存成一张边表——每行一条父子关系:
// 拓扑边表:nodeId 的父节点是 parentNodeId
topo = table(1:0,
    `nodeId`parentNodeId`nodeType`nodeName,
    [SYMBOL, SYMBOL, SYMBOL, SYMBOL])

// 示例数据(三层:母线 → 产线 → 设备):
// (BUS-2,      NULL,      BUS,    2 号母线)
// (LINE-3,     BUS-2,     LINE,   三号产线)
// (PUMP-007,   LINE-3,    DEVICE, 循环水泵 7)
// (MOTOR-114, LINE-3, DEVICE, 主电机 114)拓扑表是这类分析的前提投资:没有它,一切"上游/下游"都无从谈起。它通常可以从电气图或 MES 的资产树导入,一次建表、按改造维护(第六节讲维护纪律)。
3.2 上溯:从设备找到它的祖先
设备级告警要回答"挂在哪",就把拓扑父链 join 上去。层级不深(通常 2~4 层)时,逐跳 join 最直观:
// 簇内告警设备 + 两级上溯(更深层级照此再 join)
upTraced = select c.clusterId, c.ts, c.deviceId,
       t1.parentNodeId  as parent1,
       t2.parentNodeId  as parent2
from clustered as c
inner join topo as t1 on c.deviceId = t1.nodeId
left  join topo as t2 on t1.parentNodeId = t2.nodeId
3.3 最近公共祖先:嫌疑层级的定位
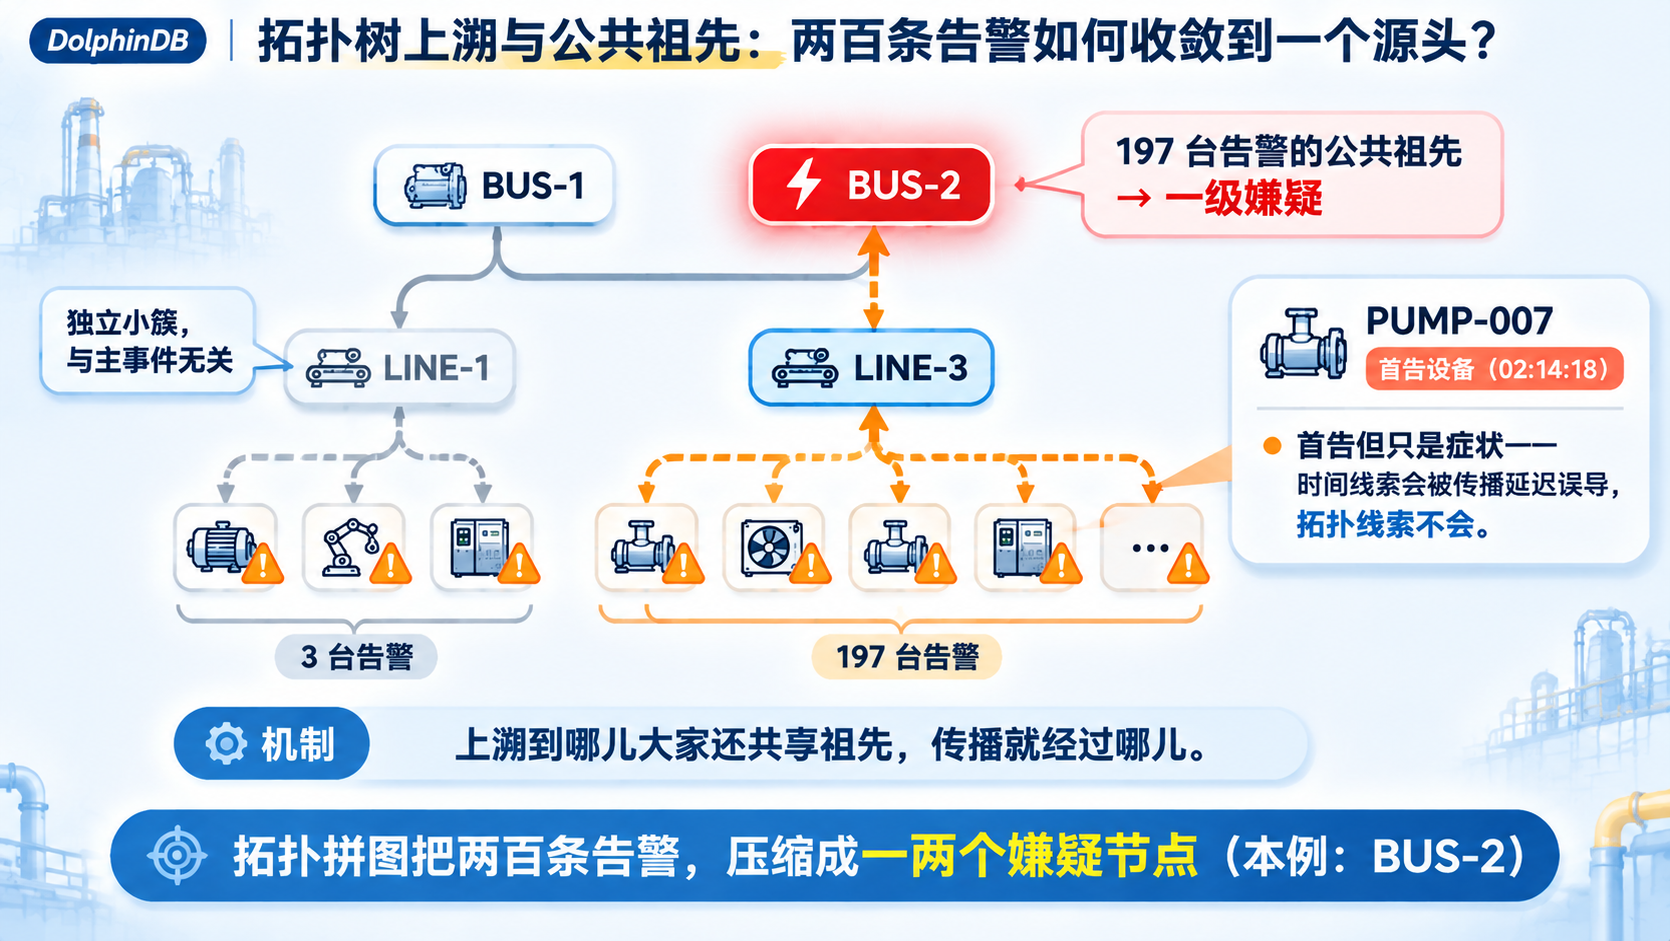
把簇内所有告警设备的祖先列出来做交集——大家共同的最近祖先,就是传播经过的那个节点:
// 簇内设备的一级父节点分布:集中在哪一个?
select clusterId, parent1,
       count(distinct deviceId)   as devices_under
from upTraced
group by clusterId, parent1
order by devices_under desc
直觉的读法:某个簇的告警设备里,47 台都挂在 LINE-3 下、另外 3 台挂在 LINE-1 下——根因嫌疑集中在 LINE-3 这一层或其上游,那 3 台 LINE-1 的告警大概率是碰巧赶上的独立小问题。公共祖先把"两百条告警"压缩成"一两个嫌疑节点"。
四、根因评分:时间与拓扑的合成
4.1 三个评分要素
单看时间或单看拓扑都会误判,合成评分要三个要素:
- 时间分:该节点相关的首条告警出现得越早,越可能是源头(传播还没走远)
- 拓扑分:节点在拓扑上越靠上游,能解释的下游告警越多,越可能是源头
- 解释力:以该节点为根的子树,覆盖了簇内多少比例的告警设备——上游节点天然解释面大,但"解释面大且自身有告警"才可信
4.2 评分实现
// 候选节点评分(示意权重:拓扑 0.5 / 时间 0.3 / 解释力 0.2)
scoring = select
    parent1                                    as suspectNode,
    min(ts)                                    as first_alert_ts,
    count(distinct deviceId)                   as covered_devices,
    // 时间分:簇内越早出现,分越高(首告时刻相对簇起点的提前量)
    1.0 \ (1.0 + (min(ts) - clusterStart) \ 60000.0)        as time_score,
    // 解释力:覆盖设备占簇内设备总数的比例
    count(distinct deviceId) \ totalDevices                   as coverage
from upTraced, clusterProfile
group by suspectNode

// 合成:加权排序,输出嫌疑清单
select suspectNode, first_alert_ts, covered_devices,
       0.5 * topo_depth_score + 0.3 * time_score + 0.2 * coverage as suspect_score
from ...
order by suspect_score desc
limit 5(topo_depth_score 由节点层级折算,母线层高于产线层高于设备层;权重是起点,按本厂告警的历史命中率校准。)
4.3 嫌疑清单长什么样
一次典型输出的样子:
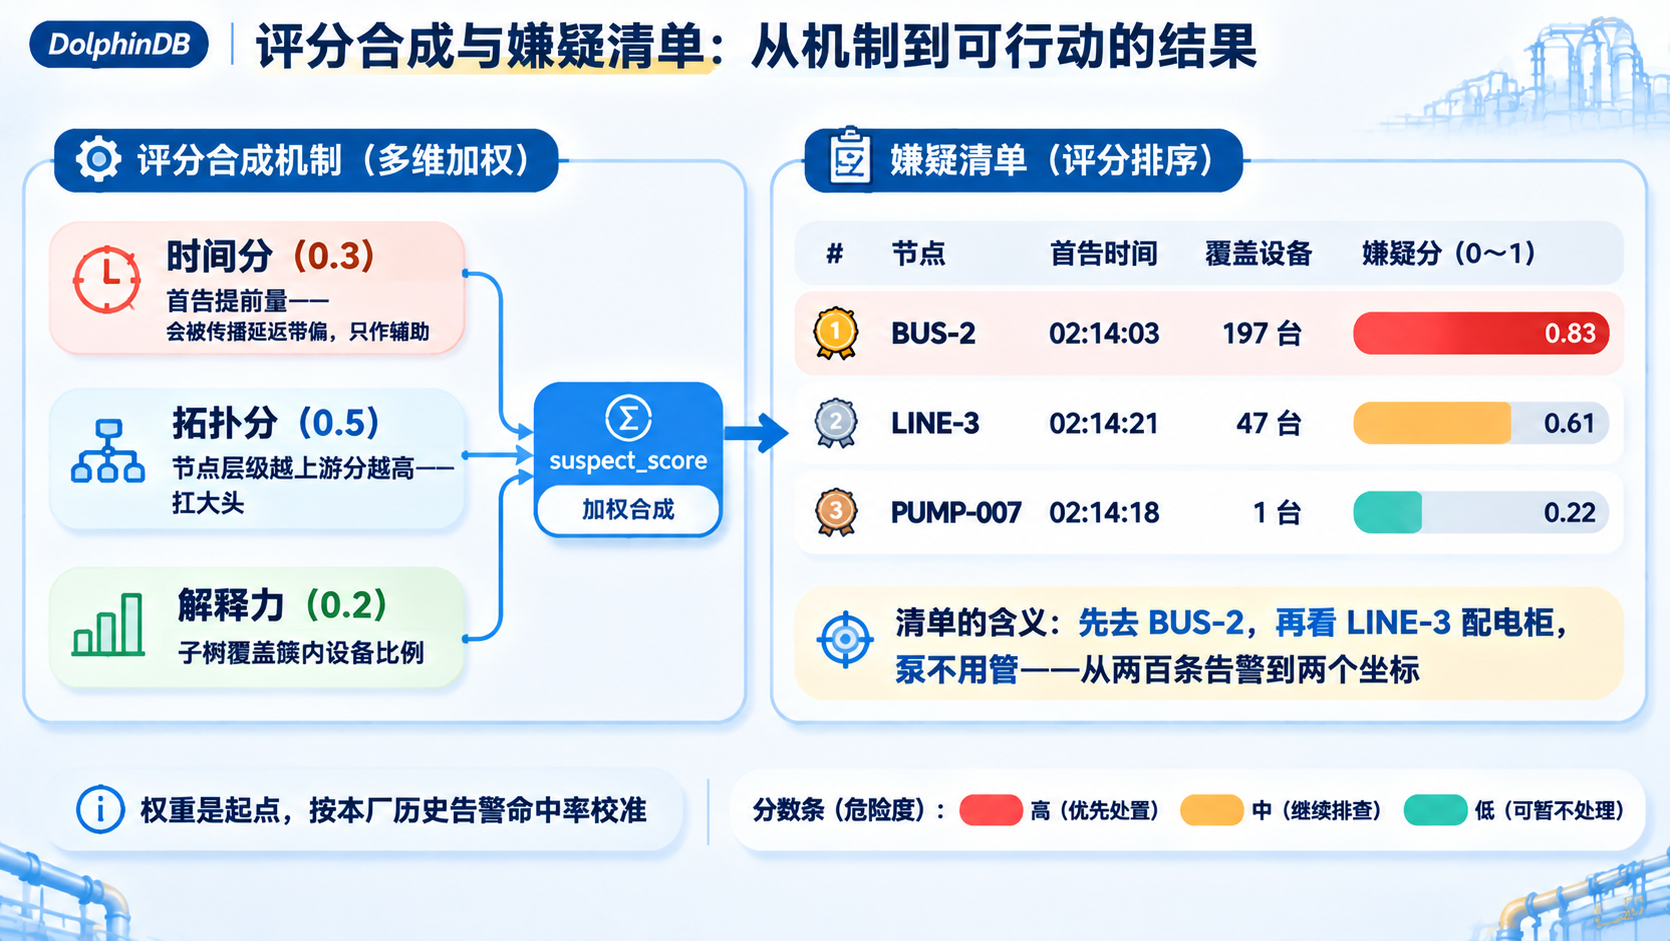
排名 | 嫌疑节点 | 首告时刻 | 覆盖设备数 | 嫌疑分 |
|---|---|---|---|---|
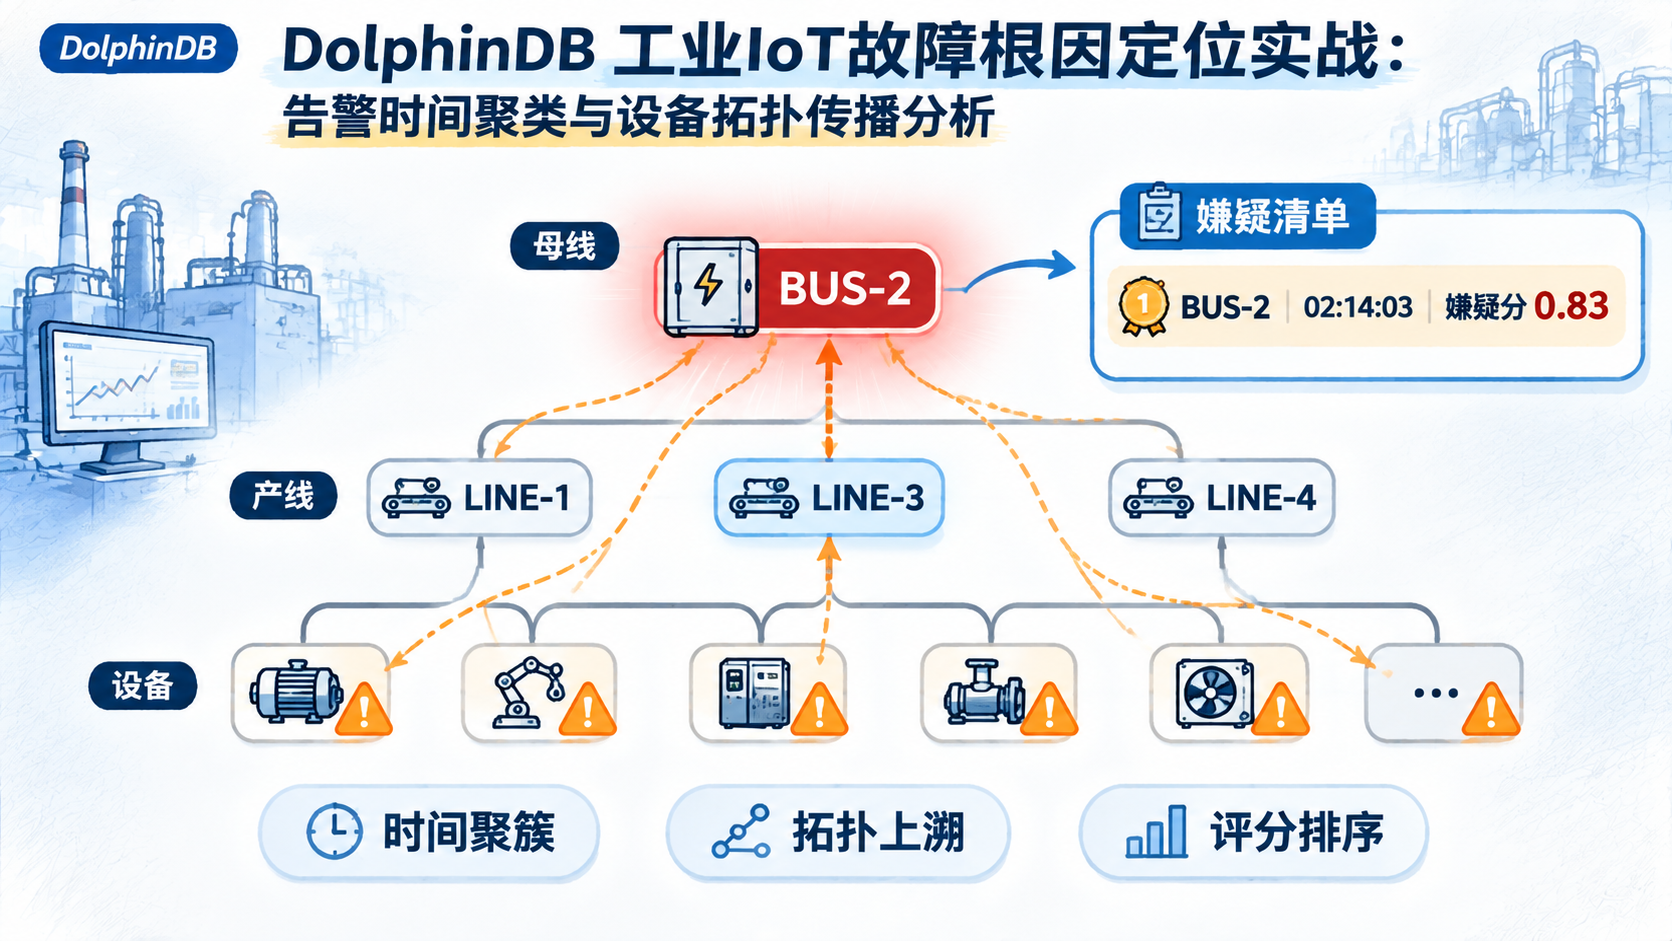
1 | BUS-2(2 号母线) | 02:14:03 | 197 | 0.83 |
2 | LINE-3(三号产线) | 02:14:21 | 47 | 0.61 |
3 | PUMP-007(循环水泵) | 02:14:18 | 1 | 0.22 |
这张表交给值班工程师的含义是:先去 2 号母线看,再看三号产线的配电柜,大概率不用管那台泵——从"面对两百条告警"变成"带着两个坐标去现场"。
五、从嫌疑到确认:闭环
5.1 嫌疑不是结论
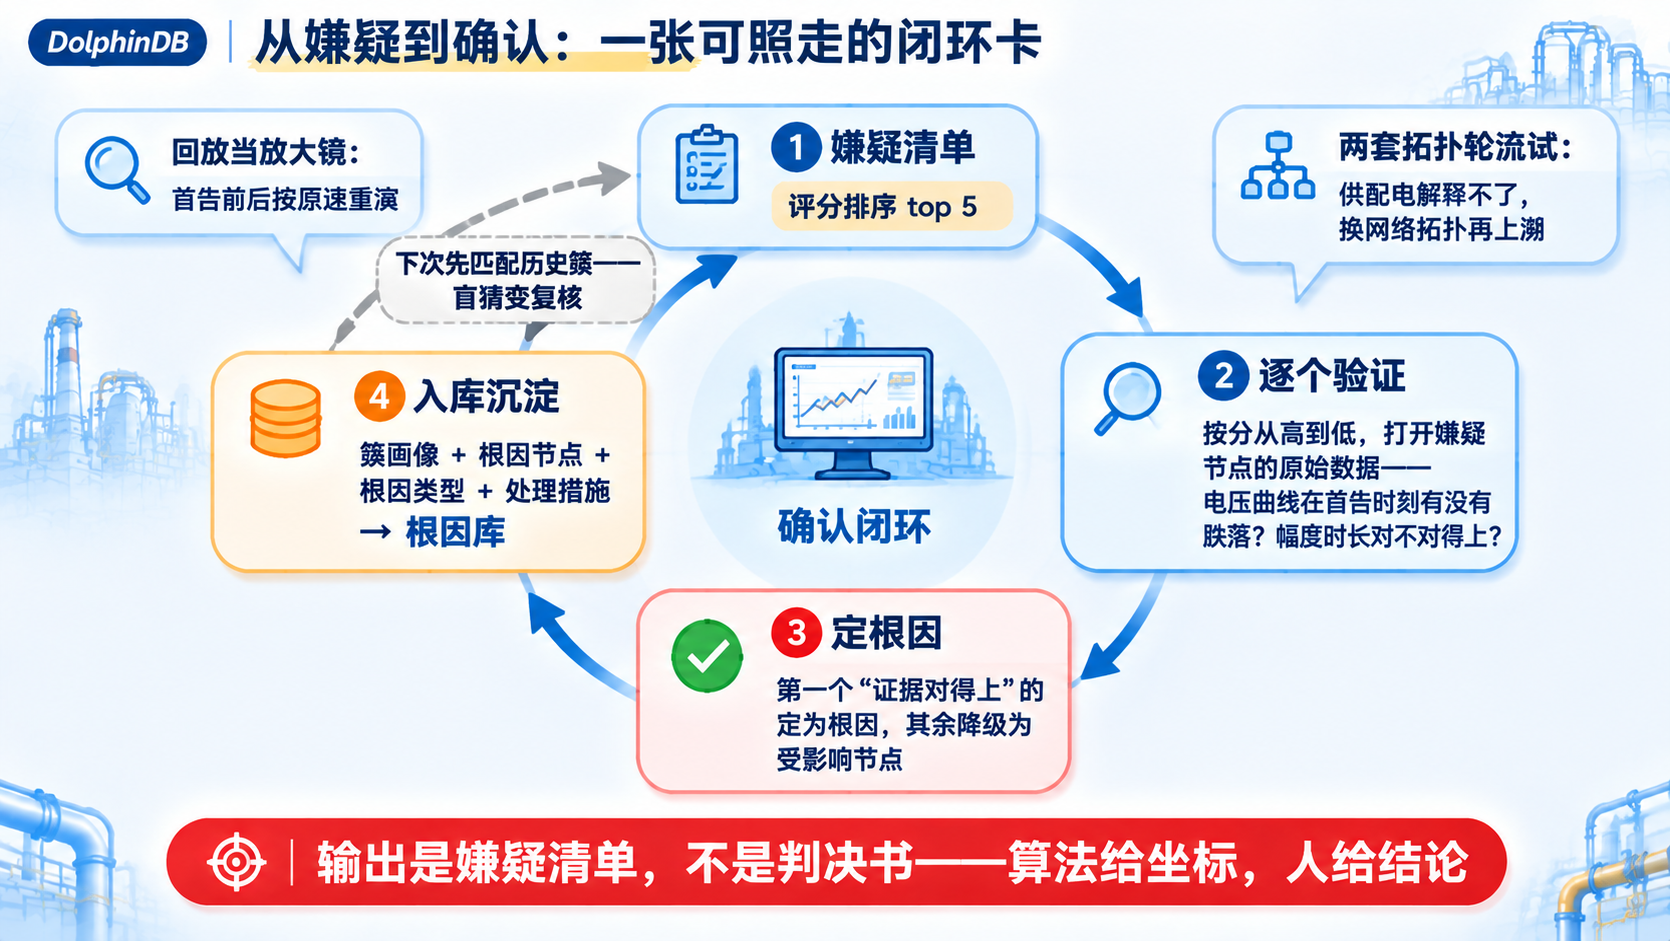
评分模型有两类系统性误差:时钟偏移会让时间分失真(第六节);拓扑之外的传播路径(网络故障沿网段传播,不在供配电拓扑里)会让公共祖先扑空。所以清单只完成了一半工作,另一半是人工确认:打开嫌疑节点的原始数据看证据——母线电压曲线在首告时刻有没有跌落?跌落的幅度和持续时间对不对得上?
确认动作本身也有章法:按嫌疑分从高到低逐个验证,第一个"数据证据对得上"的节点定为根因,其余降级为受影响节点。
5.2 根因库:让下一次更快
每次确认的事件入库沉淀——簇特征(规模、时长、告警规则组合)+ 根因节点 + 根因类型 + 处理措施。下次风暴聚完簇,先拿簇画像去库里匹配:相似簇出现过,直接给出"上次是 BUS-2 接触不良"的先验,评分从一个盲猜变成有据可依的复核。根因库和诊断经验一样,是越用越准的资产。
5.3 用回放做确认的放大镜
确认环节想看得更细,可以把首告时刻前后的数据按原速重演一遍——根因时刻前后几十秒的数据按真实节拍流过诊断逻辑,传播的先后在慢镜头里一目了然。回放让"证据对得上"从翻曲线的肉眼活,变成可复现的验证。
六、坑与纪律
6.1 时钟偏移:上游未必先报
采集链路的延迟差几秒到几十秒,首告时刻的排序天然带噪声。纪律:时间分只占评分的一部分(拓扑分扛大头),并且簇内时间序只用于"排除明显滞后的",不用于判决先后。
6.2 告警时间口径:用数据时刻,不用到达时刻
告警的时间戳应该取数据时刻(异常发生的数据时间戳),而不是告警引擎的处理时刻。后者叠加了引擎排队延迟,风暴期间排队最狠,恰好在最需要准确的时候最失真。
6.3 拓扑表会过期
产线改造、设备移位、配电调整之后拓扑表不更新,公共祖先就会指向错误节点——拓扑表的维护纪律比算法本身更重要。把拓扑表变更纳入改造验收清单:动了现场,就改表。
6.4 聚类窗口:太大并簇,太小碎簇
间隔阈值取多大没有标准答案:太小,一次事件碎成十几簇,公共祖先失去意义;太大,两件独立事件并成一簇,嫌疑清单指向不存在的共同根因。经验起点 3~5 分钟,用本厂历史风暴回标——拿过去几次已知根因的事件回放聚类,调到"已知事件恰好各成一簇"的窗口。
6.5 拓扑不是只有供配电
工艺上下游(前工序停机导致后工序连锁告警)、网络拓扑(同一交换机下的通讯类告警)都是传播路径。成熟的做法是多张拓扑表并存,评分时分别试:供配电拓扑解释不了的簇,换网络拓扑再上溯一次。传播路径不止一条,拼图也可以不止一套。
七、写在最后
告警的价值链有三段:产生(把异常报出来)、降噪(让每条值得看)、定位(找到该去现场看哪)——第三段最缺工具,却最能缩短故障时长。本文补的就是这一段。
方法收拢成三句话:
- 时间聚簇:间隔切分把风暴归拢成事件簇,簇是最小分析单元
- 拓扑上溯:公共祖先把"两百条告警"压缩成"一两个嫌疑节点"
- 评分合成:时间 × 拓扑 × 解释力加权,输出按嫌疑度排序的清单
以及三条压轴纪律:时间口径用数据时刻;拓扑表随改造更新;输出是嫌疑清单不是判决书——算法把两百条告警变成两个坐标,剩下的现场确认,是工程师的经验和数据的证据一起完成的事。
风暴一定会再来。区别在于,下一次你是面对两百条告警从第一条翻起,还是拿到一张写着"BUS-2,02:14:03,嫌疑分 0.83"的纸,直接走向配电室。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号