Agentic Search深入解析:大模型自主决策搜索动作,解决长链路多步骤信息查询难题27.5
原创
Agentic Search深入解析:大模型自主决策搜索动作,解决长链路多步骤信息查询难题27.5
原创
未闻花名
发布于 2026-11-14 09:13:10
发布于 2026-11-14 09:13:10
一、前言
如今我们向大模型问一个复杂问题,如果直接丢给普通大模型,要么它只会调用训练截止前的陈旧知识,要么单次搜索只查一个关键词,得到碎片化信息,最后答案片面、遗漏关键数据,甚至出现幻觉。传统的检索增强生成RAG,本质上是用户提问→提取关键词→一次性检索文档→交给大模型总结,全程是被动的。关键词是谁定的?是模型一次性提取。搜几次?大多只搜一轮。发现信息不够、资料矛盾怎么办?传统RAG没有自主处理能力,只能输出现有内容。
而Agentic Search,也就是智能体式搜索,把大模型变成了一个会思考、会规划、会反复搜资料、自我校验的信息侦探。它不再是收到问题就直接搜索,而是把用户复杂问题拆解成多个子目标,自己判断需要搜什么、用什么关键词、拿到结果后评估信息够不够,信息不足就继续补充检索,发现信息冲突就交叉验证,直到收集到足够可靠素材再整合输出答案。Agentic Search的核心是由智能体(Agent)来掌控整个搜索流程,具备规划、反思、迭代、决策能力。
二、Agentic Search基础介绍
1. 传统检索的短板
我们先看看了解透旧的搜索摸索,才能理解Agentic Search诞生的意义。当前常见的大模型信息获取方式有两类:
- 第一类,纯大模型静态知识库。模型学到的知识冻结在训练数据截止时间,新事件、最新论文、实时数据完全不知道,很容易编造不存在数据,也就是幻觉。
- 第二类,普通联网搜索/基础RAG。用户输入query,模型抽取关键词,调用搜索引擎检索网页,拿到搜索摘要之后,直接把摘要和用户问题一起送入大模型生成回答。整个链路是单次、单向、无反馈闭环。
它有几个很难解决的硬伤:复杂问题无法拆解。面对多步骤问题,只能用原始问题直接搜索,关键词宽泛,返回信息杂乱无关。比如调研行业趋势,一次性搜索返回大量无关新闻,模型分不清主次。没有信息评估能力。拿到搜索结果,不会判断信息是否充足、是否可信、是否存在矛盾。搜到多少就用多少,缺资料也不会主动再次搜索。无法迭代修正。如果第一轮搜索得到的内容互相冲突,模型不能自动换关键词、换数据源二次检索,只能强行整合矛盾信息,直接引发幻觉。无法处理多轮依赖任务。很多任务存在先后顺序,必须先查到A结论,才能去搜索B内容。基础RAG不具备这种“根据上一步结果决定下一步搜索动作”的能力。
举个生活化例子:基础RAG就像你让实习生一次性去网上找资料,只给一句原始需求,实习生搜一次网页,不管资料够不够、有没有冲突,直接复制材料回来交差。 而Agentic Search,相当于一名专业研究员,拿到需求后,先写调研大纲,分步骤查找,看完资料评估还差哪些内容,继续换关键词检索,多方核对来源,确认信息完整可信之后,再撰写最终报告。
简单一句话定义Agentic Search:由大模型智能体自主驱动整个检索流程,自主规划搜索目标、生成检索指令、评估检索结果、迭代多轮搜索,直到满足任务终止条件,最后整合全部信息生成答案的检索范式。
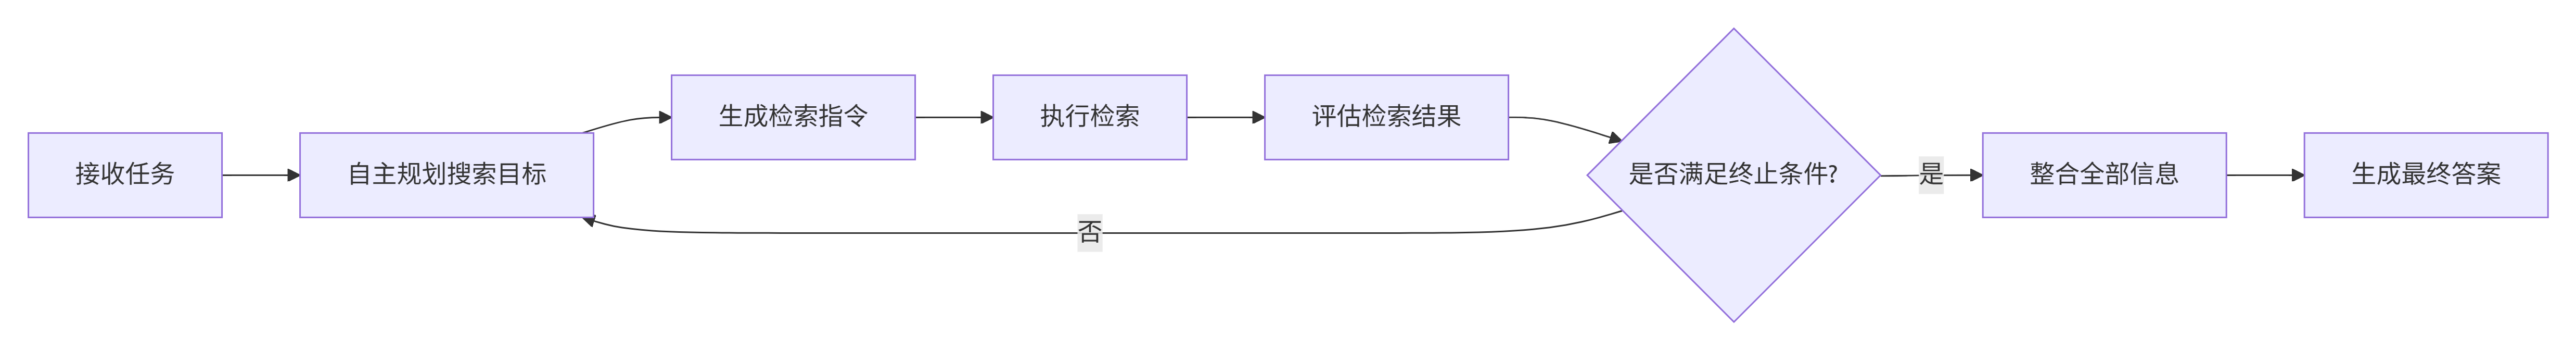
它的核心不是搜索引擎本身,而是智能体的决策闭环。搜索引擎只是智能体可以调用的外部工具,真正的大脑是负责思考、判断、反思的大模型Agent。
2. 和RAG、联网搜索的区别
通常很容易把三者混在一起,这里做清晰的对比区分:
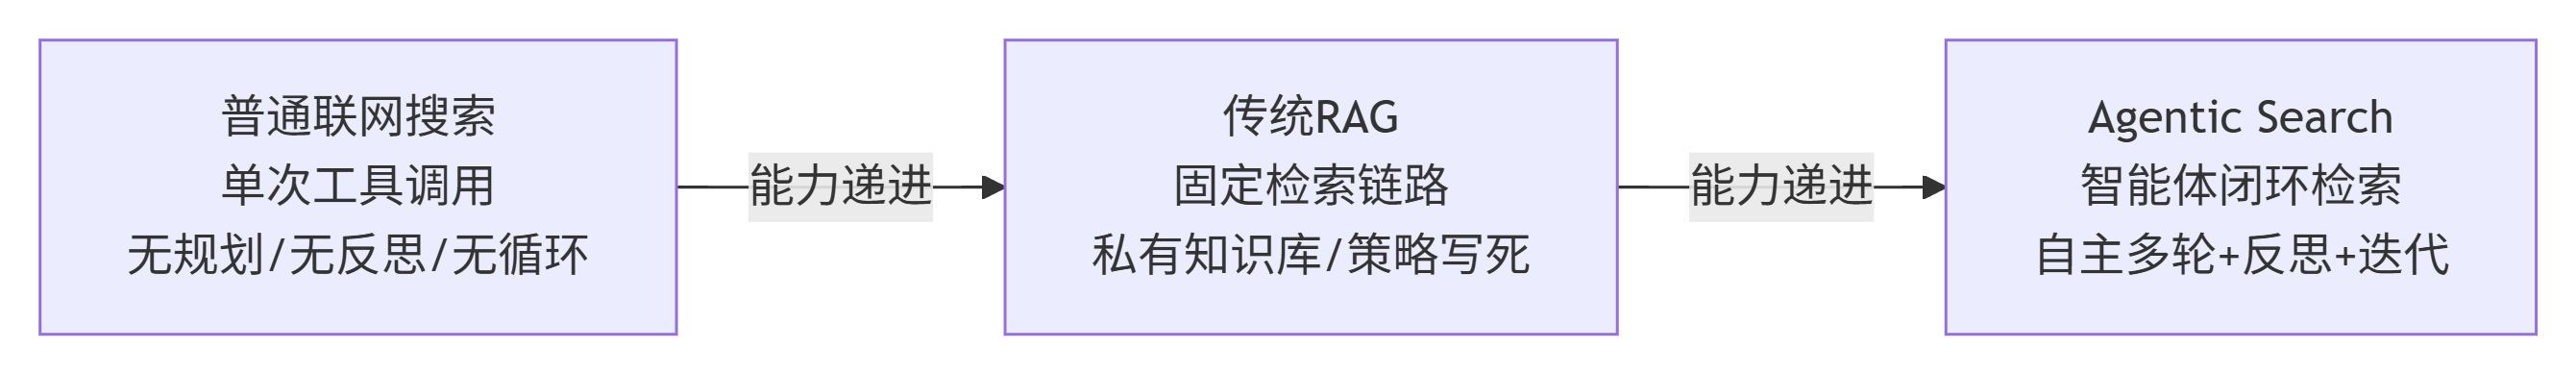
- 普通联网搜索:工具能力。模型调用搜索引擎,一次检索,没有规划、反思、循环迭代。属于“单次工具调用”。
- 传统RAG:固定检索链路,大多面向私有知识库文档,检索策略提前写死,检索词提前抽取,一般不具备自主多轮检索。适合已知文档库内的问答。
- Agentic Search:智能体闭环检索。可以调用公网搜索引擎,也可以对接私有知识库检索接口。检索动作由模型自主动态决定,支持多轮循环搜索+自我反思,面向开放式、复杂、多步骤调研任务。
三者并不是互相替代。Agentic Search内部也可以嵌入RAG模块。智能体在规划之后,既可以调用公网搜索引擎,也可以调用私有向量库做RAG检索,两种工具混合使用。Agentic Search是一种更高层次的任务执行框架,RAG和搜索引擎都是它的底层工具。
三、Agentic Search核心组件
1. 任务规划模块
任务规划模块是Agentic Search的起点,由大模型承担。它接收用户原始问题,做问题拆解,把一个宏大复杂的目标,拆成多个有序、独立、可以通过搜索完成的子任务。
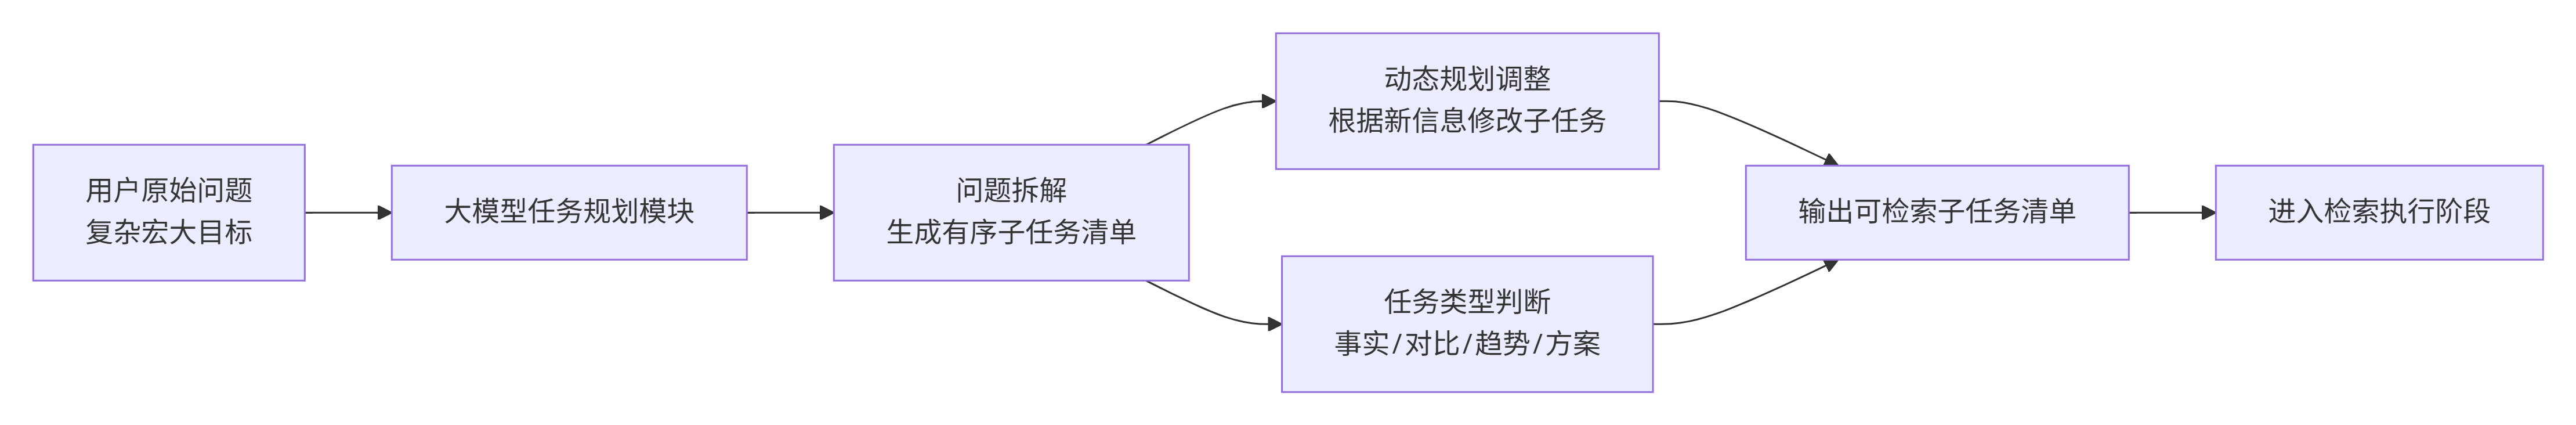
比如用户提问:“总结2025年国内开源多模态模型的进展,对比各自优缺点,并预测落地难点。” 规划模块会拆解出子任务清单:
- 检索2025国内开源多模态大模型完整清单,确认有哪些主流项目;
- 分别检索每个项目的技术报告、发布博客,获取模型架构、参数量、支持模态;
- 查找各模型公开评测数据集上的指标结果;
- 收集业内论文、技术社区对各个模型优缺点的分析;
- 检索行业分析文章,梳理多模态模型产业落地遇到的共性难点;
- 汇总全部信息,交叉核对冲突数据。
规划不是一次性写死。高级Agentic Search支持动态规划,后续检索拿到新信息之后,可以反过来修改子任务清单。比如检索之后发现某个模型发布时间不在2025,智能体就自动把它剔除,调整后续检索目标。
规划阶段,模型还要判断任务类型:是事实查询、对比调研、趋势分析,还是方案查找,不同任务对应不同检索策略。事实类任务更注重权威来源交叉验证;趋势调研任务需要收集多篇行业分析,避免单一来源片面。
2. 检索动作生成模块
规划得到子任务之后,检索动作生成模块负责把子任务转化成可执行的检索指令。这里不只是生成关键词,智能体还要决定用什么检索工具、检索词、检索数量。

同一个子任务,可以生成多条不同角度的query,避免单一关键词带来信息遗漏。比如调研模型评测,模型会生成多条检索词:
- 2025国内开源多模态大模型 官方评测
- 多模态模型 视频理解 benchmark 对比 2025
- 国内开源多模态大模型 局限性分析
同时智能体还会选择检索策略:有时候适合宽泛query,获取综述类文章;有时候需要精准query,定位论文、官方文档这类权威原始资料。基础联网搜索只能从用户原始问题提取query;而Agentic Search是根据子任务,动态、多候选生成检索query,这是很大差异。
3. 检索工具执行层
这一层是底层工具,不具备思考能力,只负责执行检索指令。可以是通用搜索引擎API、私有向量数据库检索接口、论文数据库接口、文档检索服务等。
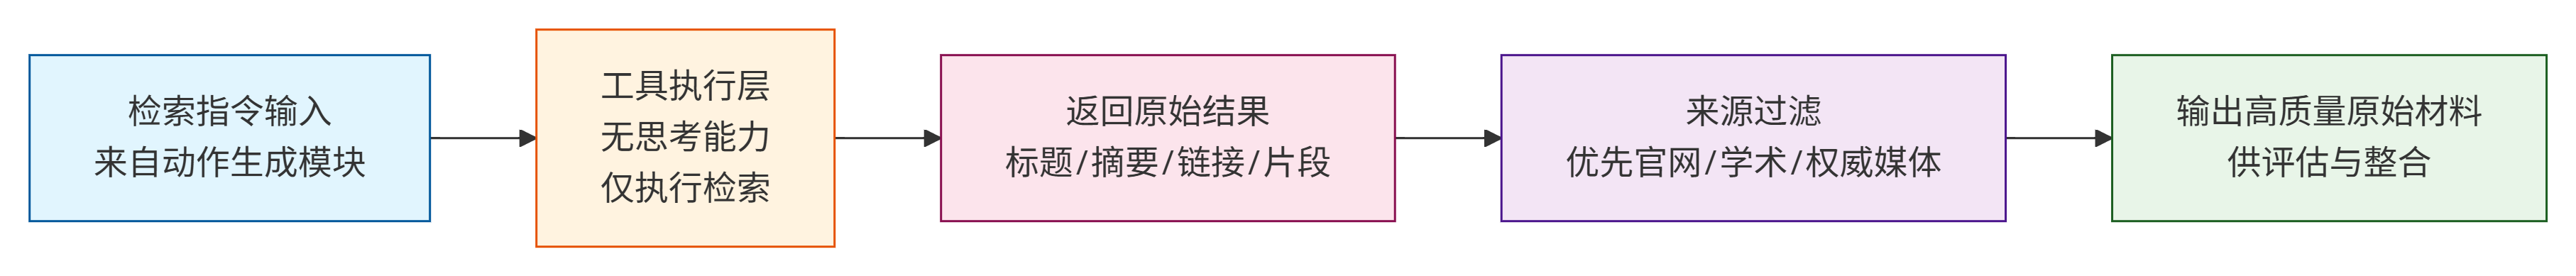
智能体把生成的检索query下发给工具,工具返回检索结果,一般是网页标题、摘要、链接、原文片段。工具层只负责获取原始材料,不会做信息筛选、真伪判断。
实际应用中,我们这里会增加一层来源过滤,预先过滤低质量来源,优先保留官网、学术论文、权威媒体,减少垃圾网页进入后续环节,降低大模型处理压力,减少幻觉风险。
4. 结果评估与反思模块
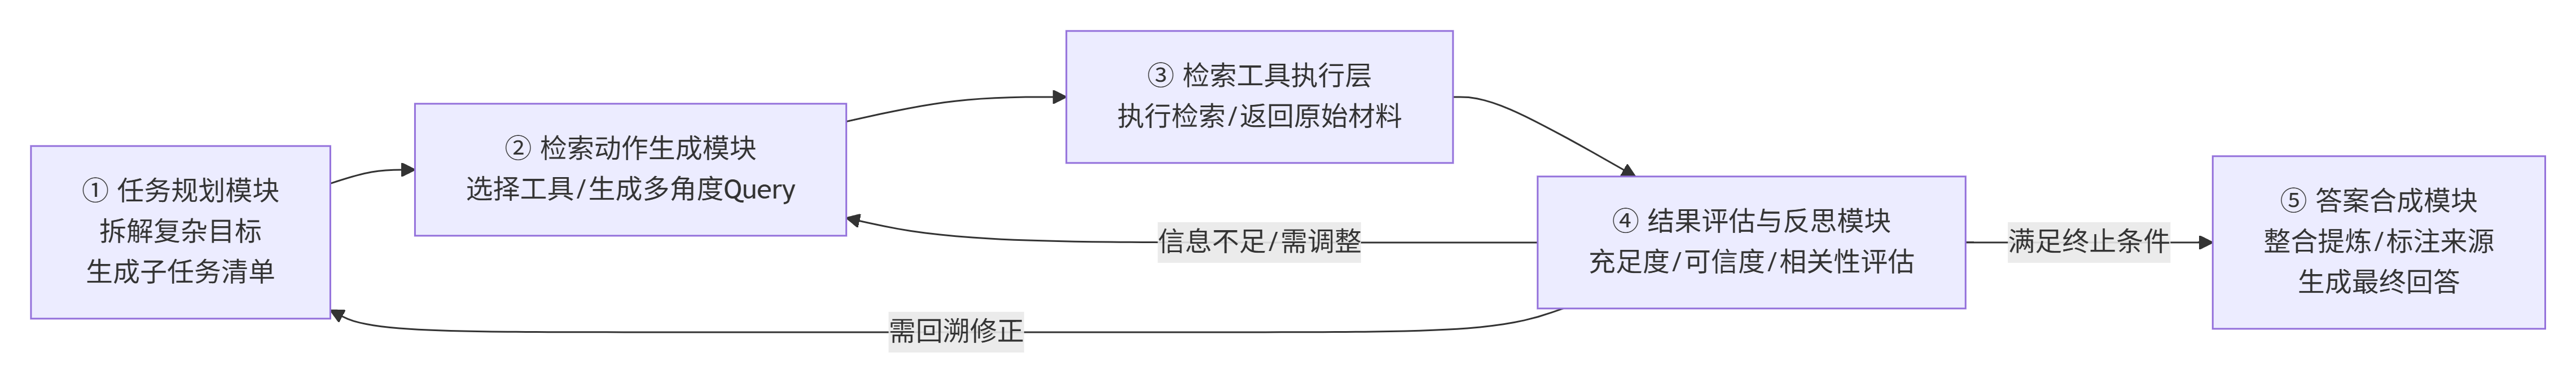
反思模块是Agentic Search最核心、最有特色的一环,也是和普通单次搜索最大分界线。拿到一轮检索返回的内容之后,大模型智能体需要做三件评估:
- 1. 信息充足度评估:当前拿到的资料能不能完成当前子任务?信息是否缺失关键数据?如果不够,判定需要继续搜索,回到检索动作生成环节,重新构造query,开启新一轮检索。
- 2. 信息可信度与冲突校验:多条检索结果之间结论是否矛盾?信息来源是否可靠?比如A文章说模型A在某项指标第一,B论文给出相反结论,智能体识别冲突,会设计新检索词查找原始论文,核验真实数据。
- 3. 信息相关性过滤:剔除无关、冗余检索片段,保留对当前子任务有用内容,压缩上下文,避免过长上下文窗口浪费资源。
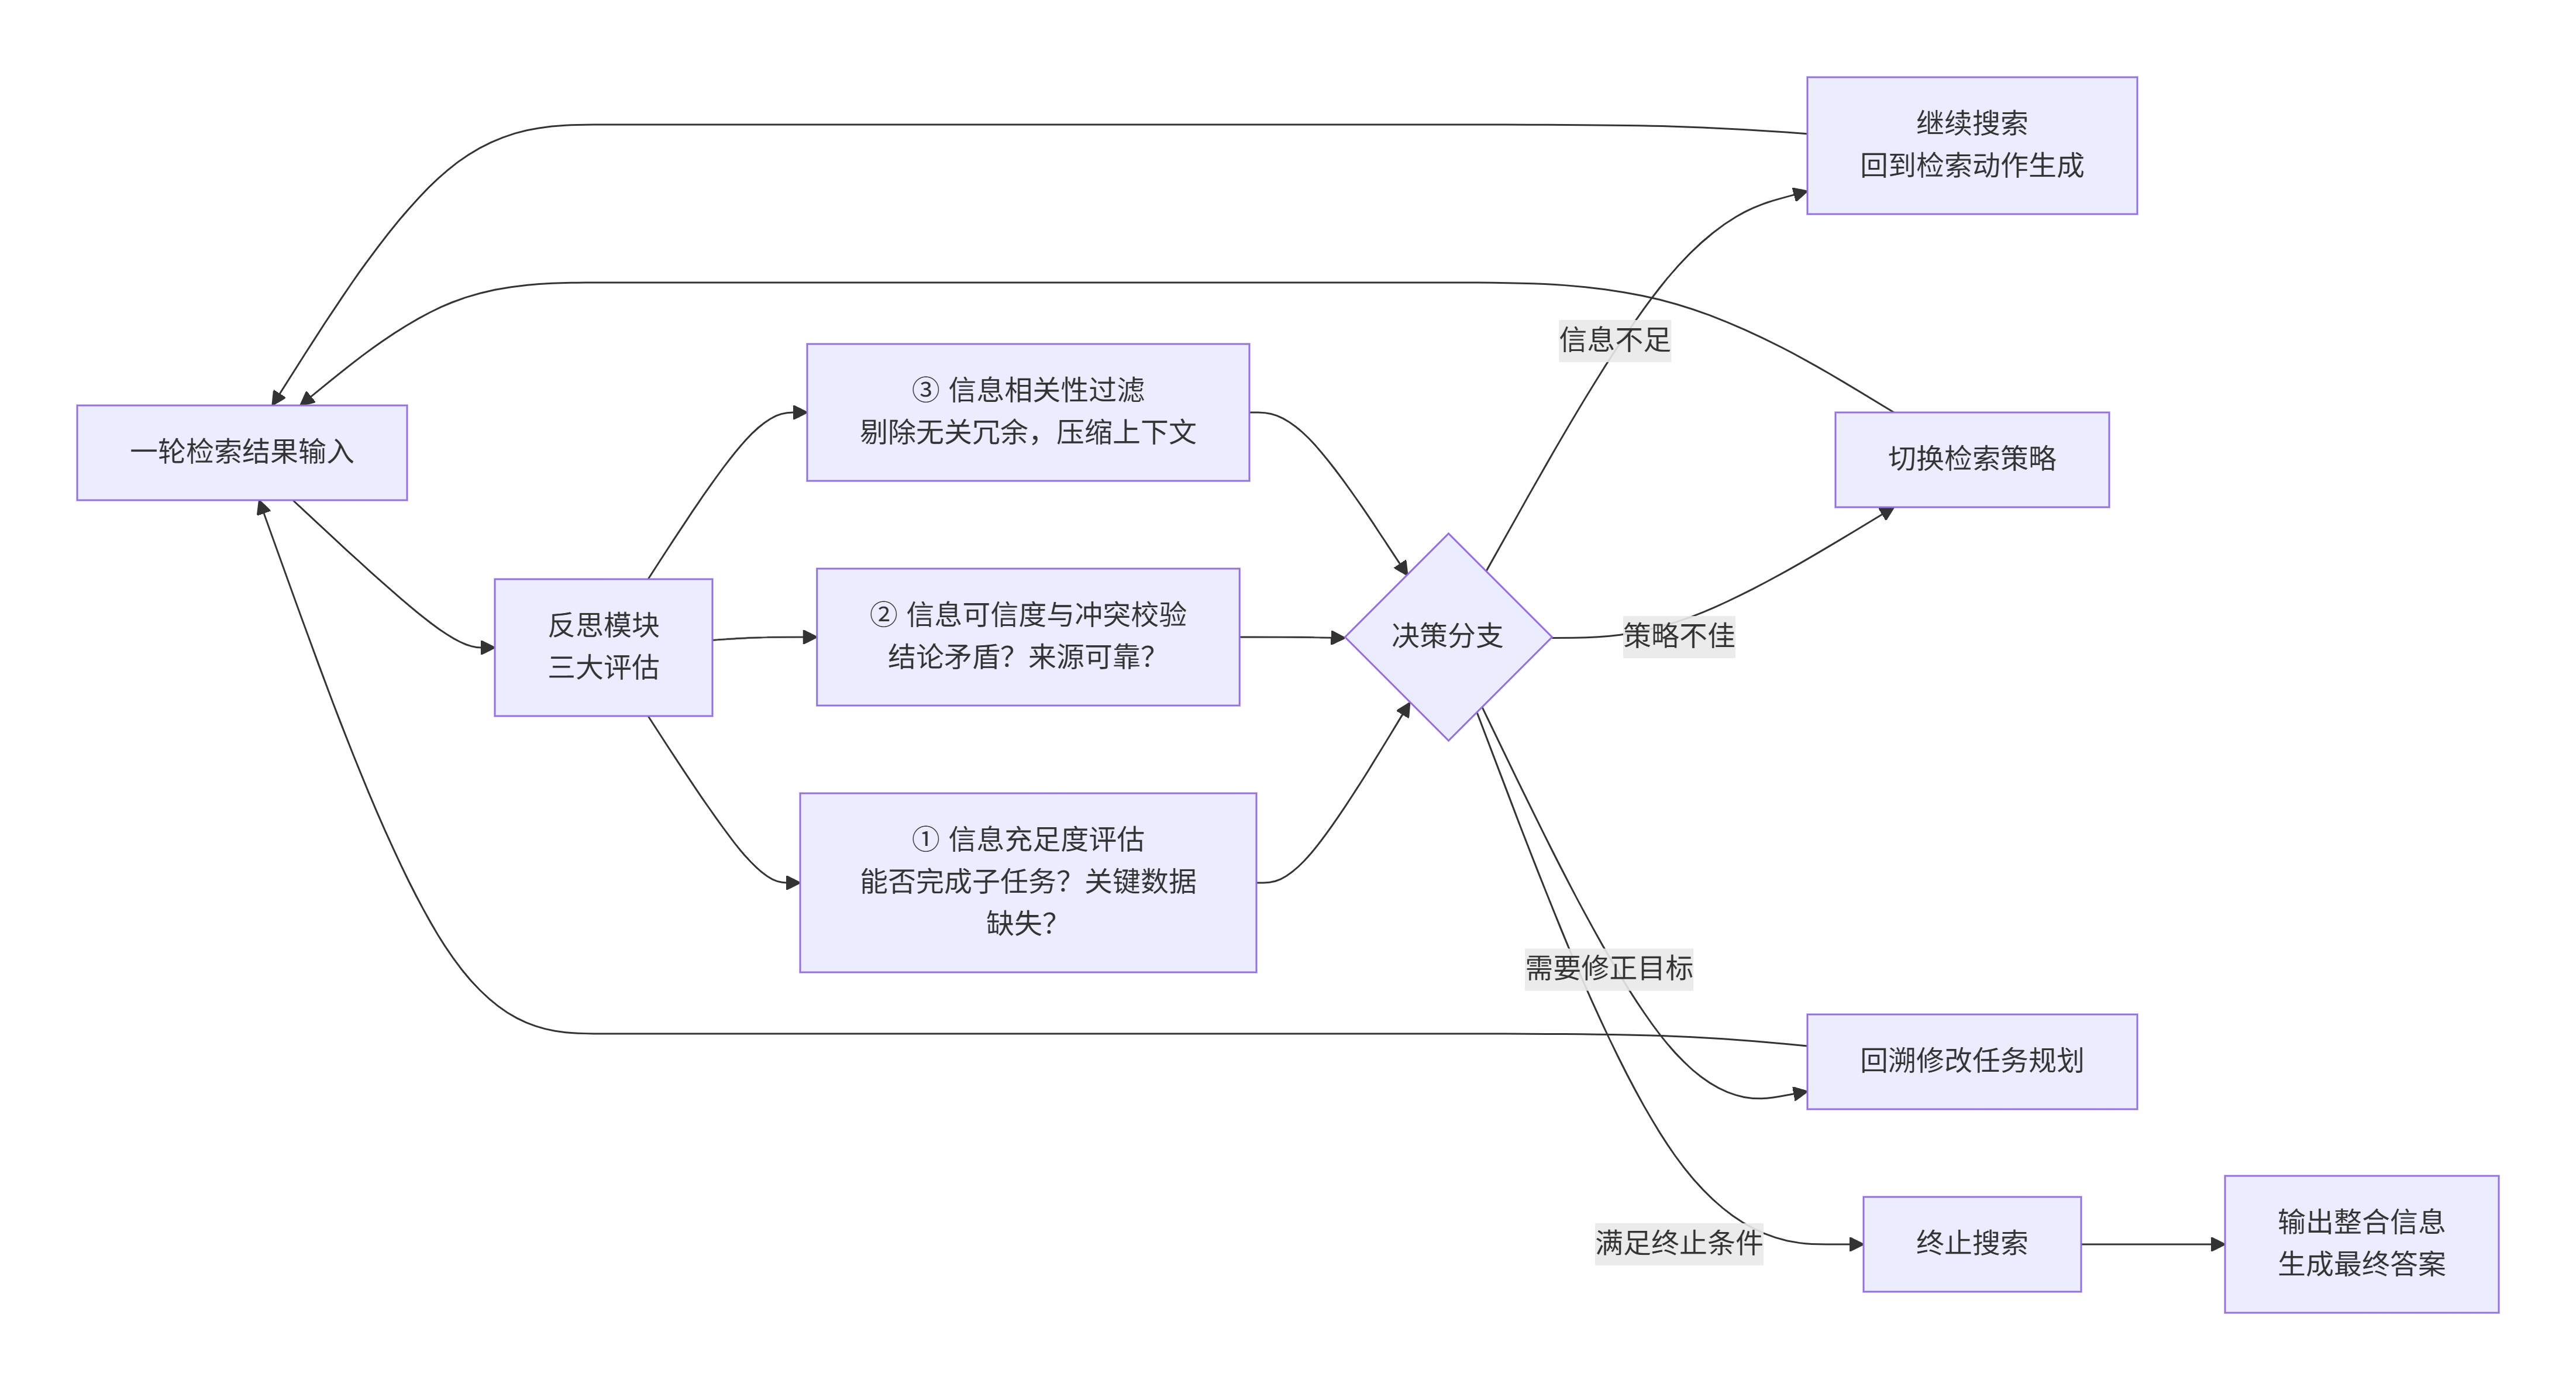
反思判断之后,智能体有几种决策分支:继续搜索、切换检索策略、终止搜索,或者回溯,修改前面的任务规划。这个循环会不断运行,直到满足终止条件。
终止条件可以人工预设,也可以由模型自主判断:子任务全部完成、信息足够回答原始问题、达到最大搜索轮次上限、没有更多有价值检索方向。设置最大轮次上限,是工程上的必要约束,防止智能体无限循环搜索,消耗大量调用成本。
5. 答案合成模块
所有子任务检索、校验全部完成之后,进入答案合成。智能体汇总全部经过校验的检索材料,按照最初规划的结构,整合、提炼,生成最终完整回答。
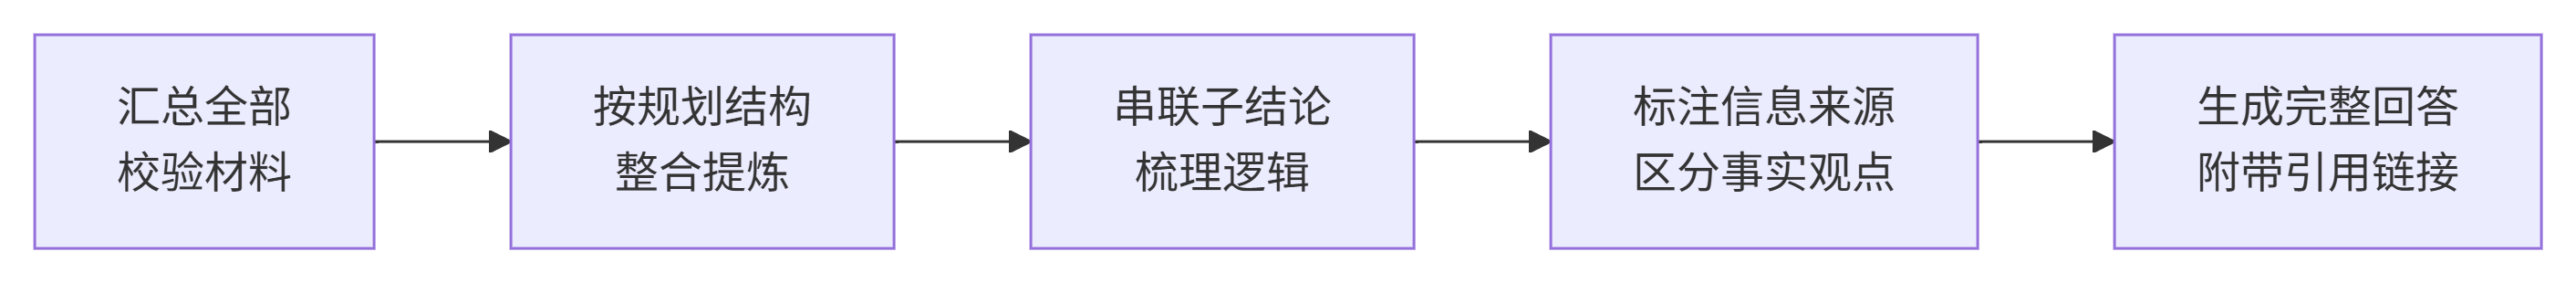
合成阶段不只是简单拼接摘要。模型需要串联所有子结论,梳理逻辑,标注信息来源,区分事实和观点。高质量Agentic Search输出结果还会附带引用链接,方便用户溯源核对。
整个流程形成闭环:规划→生成检索指令→工具检索→评估反思→(循环检索)→汇总输出。
三、Agentic Search完整流程
1. 完整闭环分步演示
我们用一个真实问题,完整走一遍Agentic Search全流程,直观感受智能体如何自主完成搜索。 用户问题:“对比2024-2025开源本地大模型,在8GB显存设备上的推理速度和效果,推荐2个综合最优模型。”
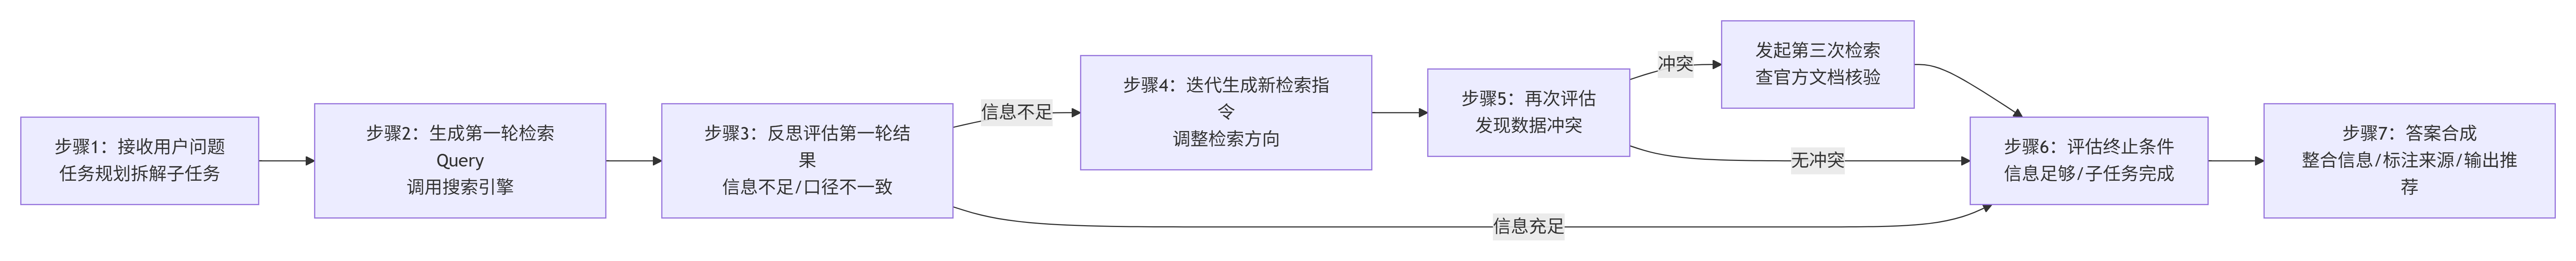
步骤1:接收用户问题,任务规划。
智能体拆解子任务:
- 1. 查找支持8GB显存可部署的开源大模型清单;
- 2. 查找2024至2025发布的候选模型,排除超出显存要求的模型;
- 3. 搜集各个模型公开实测:8G显存下推理速度、上下文能力、中文效果评测;
- 4. 对比不同评测来源数据,校验有没有矛盾实测结果;
- 5. 综合速度与效果筛选,选出2个最优模型,说明取舍理由。
步骤2:生成第一轮检索query,调用搜索引擎。
生成多条检索词:
- 8G显存 本地开源大模型 2024-2025 实测
- 8GB显卡 LLM推理速度 中文评测
- 低显存开源大模型 benchmark 2025
拿到搜索结果,读取网页摘要。
步骤3:反思模块评估第一轮检索结果。
智能体读完资料后判断:
- 找到了候选模型列表,但是很多评测是不同硬件环境,数据口径不一致,缺少统一横向对比,信息不足,需要继续检索。
- 识别问题:不同博主测试环境不一样,数据不能直接拿来对比。
步骤4:迭代生成新一轮检索指令。
智能体调整检索方向,查询标准化横向评测:
- 8G显存 大模型统一横向评测 2025
- 量化LLM 8GB RTX显卡 推理速度对比
再次调用搜索工具,获取新资料。
步骤5:再次评估,交叉校验冲突。
- 获取新评测文章,发现两份评测里同一个模型速度数值存在差异。
- 智能体判断冲突,发起第三次检索,查找模型官方量化文档,确认量化版本差异,厘清数据不一致原因。
步骤6:评估终止条件。
- 子任务全部完成,已经有统一口径实测数据,信息足够支撑对比和推荐,不再继续搜索,退出检索循环。
步骤7:答案合成。
- 整合全部校验后的信息,整理对比维度,分析优劣,给出推荐模型,标注数据来源,生成最终回答。
从这个案例能看到,整个过程不是一次搜索就结束,智能体会根据每一轮拿到的信息动态调整搜索策略,自主判断什么时候该继续查资料,什么时候信息足够可以停止。而普通联网搜索只会执行一轮,拿到什么就直接写答案。
2. 两种主流执行架构
目前Agentic Search工程上主要分为两种架构:串行链式架构和并行多query架构。
2.1 串行链式(ReAct范式)
最常用的方案,基于ReAct(Reasoning and Acting)思想,一步一步串行执行:思考→生成搜索动作→获取结果→再次思考。
- 一次只执行一个检索动作,每一步观察结果,再决定下一步。
- 优点逻辑清晰,适合依赖型任务,上一步结果决定下一步搜索;
- 缺点串行执行,耗时更长,调用次数更多,成本更高。
2.2 并行多query检索架构
一次性生成多条不同角度的检索query,批量并行调用搜索引擎,一次性拿到多份资料,再统一评估全部结果。
- 适合开放式调研、综述类任务,可以一次性覆盖多个信息角度,减少总耗时。
- 缺点,任务存在强依赖关系时不适用,子任务有先后顺序就不能并行。
应用实践时很多方案是两者结合:无关子任务并行检索,存在依赖关系的子任务串行执行,平衡速度和能力。
四、应用实践示例分析
基于混元hy3流式大模型 + Tavily真实搜索构建的 Agentic Search 智能体。核心机制:
- 先把中文query自动翻译成英文关键词再交给Tavily检索以提升命中率;
- 搜索后用tavily.extract拉取最相关页面的完整正文,避免只看snippet;
- 以“≥3 条结果含主流型号”作为硬阈值早停条件,防止无效重复;
- 最终合成阶段加反捏造硬约束,输出压缩为“一句话结论 + 推荐 TOP2 + 风险”三段式,总长度控制在约200字内。
from openai import OpenAI
from tavily import TavilyClient
import json
import os

# 初始化大模型客户端,替换成你的模型API地址/key
# 混元模型(腾讯混元大模型,OpenAI 兼容协议)
client = OpenAI(
    api_key=os.environ.get("TENCENT_API_KEY", "sk-**"),
    base_url="https://tokenhub.tencentmaas.com/v1"
)

# Tavily 搜索客户端(真实搜索引擎)
tavily = TavilyClient(
    api_key=os.environ.get("TAVILY_API_KEY", "tvly-dev-LdaOJ-**")
)

class AgenticSearch:
    def __init__(self, max_search_round=2, min_evidence=3):
        self.max_search_round = max_search_round  # 每个子任务最多搜几轮(精简版默认2)
        self.min_evidence = min_evidence          # 累计带数字证据条数达标即停
        self.collected_info = []  # 存储每一轮收集到的检索信息

    def llm_call(self, prompt: str, max_tokens: int = 1024) -> str:
        """调用大模型(混元 hy3-preview,支持流式输出)
        max_tokens 可在最终合成时调大,避免答案被砍断。
        """
        resp = client.chat.completions.create(
            model="hy3-preview",
            messages=[{"role": "user", "content": prompt}],
            temperature=0.3,
            stream=True,
            max_tokens=max_tokens,
        )
        # 拼装流式返回的增量文本
        content_parts = []
        for chunk in resp:
            try:
                delta = chunk.choices[0].delta.content or ""
            except (IndexError, AttributeError):
                delta = ""
            if delta:
                content_parts.append(delta)
        return "".join(content_parts)

    def _to_en_query(self, query: str) -> str:
        """把中文搜索词翻译成英文关键词(Tavily 英文检索命中率显著更高)"""
        trans = self.llm_call(
            f"Translate this search phrase to concise English keywords for web search. "
            f"Only output the English query, no quotes or explanation.\nQuery: {query}",
            max_tokens=64,
        ).strip().strip('"').strip("'")
        return trans or query

    def mock_search_engine(self, query: str) -> str:
        """模拟搜索引擎,真实项目替换为 Tavily / SerpAPI / Bing Search API"""
        mock_db = {
            "8G显存 本地开源大模型 2024-2025 实测":
                "Qwen2-7B-Instruct、Llama3-8B、GLM4-6B 可以在8GB显卡量化运行。Qwen2-7B中文表现更好,Llama3-8B推理速度更快。",
            "8GB RTX显卡 LLM量化推理速度对比":
                "4-bit量化:Qwen2-7B:28 token/s;Llama3-8B:34 token/s;GLM4-6B:21 token/s。不同评测环境存在浮动。",
            "Qwen2-7B vs Llama3-8B 局限性":
                "Qwen2-7B长文本容易丢失细节;Llama3-8B原生中文弱,需要中文微调版本。"
        }
        return mock_db.get(query, "没有找到相关信息")

    def real_search_engine(self, query: str) -> dict:
        """真实搜索引擎:调用 Tavily 返回结构化结果。
        自动英译 query;对最相关的1条再用 extract 拉完整正文。
        """
        en_q = self._to_en_query(query)
        print(f"\n🔍 Tavily: {query[:30]}… → en: {en_q}")
        resp = tavily.search(
            query=en_q,
            search_depth="advanced",
            max_results=5,
            include_answer=True,
            topic="general",
        )
        results = [
            {"url": i.get("url", ""), "content": i.get("content", "")}
            for i in resp.get("results", [])
        ]
        # 关键:对最相关的1条再 extract 取完整正文(修复合成时丢内容的bug)
        if results:
            try:
                ex = tavily.extract(urls=[results[0]["url"]])
                if ex.get("results"):
                    raw = ex["results"][0].get("raw_content",
                                               ex["results"][0].get("content", ""))
                    if raw:
                        results[0]["content"] = raw[:3000]
            except Exception:
                pass
        return {
            "query": query,
            "en_query": en_q,
            "answer": resp.get("answer", "") or "",
            "results": results,
        }

    def plan_task(self, user_question: str) -> list:
        """步骤1:任务规划,拆解成最多3个子任务"""
        prompt = f"""把用户问题拆解成2~3个有序可搜索子任务,只输出JSON。
用户问题:{user_question}
输出:{{"sub_tasks": ["子任务1","子任务2"]}}"""
        raw = self.llm_call(prompt, max_tokens=256)
        try:
            return json.loads(raw)["sub_tasks"]
        except Exception:
            # 解析失败兜底:直接把原问题当一个子任务
            return [user_question]

    def evaluate_info(self, user_question: str) -> dict:
        """步骤3:反思评估(简单阈值判断,提早停止)。
        满足以下任一硬规则即停:
        1) 累计 ≥3 条结果且包含主流型号 → 直接停(精简模式);
        2) 累计 ≥5 条结果 → 饱和停;
        3) 否则继续。
        """
        total = sum(len(x.get("results", [])) for x in self.collected_info)
        keys = ("qwen", "llama", "deepseek", "mistral", "gemma", "phi")
        has_models = any(
            any(k in (r.get("content", "") + " " + x.get("answer", "")).lower()
                for k in keys)
            for x in self.collected_info
            for r in x.get("results", [])
        )
        if total >= 3 and has_models:
            return {"enough": True, "reason": f"已收{total}条结果并包含主流型号"}
        if total >= 5:
            return {"enough": True, "reason": f"已收{total}条结果(饱和)"}
        return {"enough": False, "reason": f"结果{total}条,含主流型号={has_models}"}

    def run(self, user_question: str):
        print("===== Agentic Search 启动 =====")
        sub_tasks = self.plan_task(user_question)
        print(f"\n📋 子任务:{sub_tasks}")

        # 遍历子任务,命中阈值或达到轮数上限即停
        for subtask in sub_tasks:
            print(f"\n----- 子任务:{subtask} -----")
            for r in range(self.max_search_round):
                hit = self.real_search_engine(subtask)
                self.collected_info.append(hit)
                ev = self.evaluate_info(user_question)
                tag = "✅" if ev["enough"] else "✖"
                print(f"  {tag} 评估:{ev['reason']}")
                if ev["enough"]:
                    break

        # 打印已收集的前几条结果数据,便于排查与回溯
        # print("\n📊 已收集证据(前3条搜索 × 每条前2个结果):")
        # for i, x in enumerate(self.collected_info[:3], 1):
        #     print(f"\n[{i}] query: {x['query']}")
        #     if x.get('en_query'):
        #         print(f"    en:   {x['en_query']}")
        #     if x.get('answer'):
        #         print(f"    ans:  {x['answer'][:300]}")
        #     for r in x.get('results', [])[:2]:
        #         print(f"    • {r['url']}")
        #         print(f"      {r['content'][:200].strip()}")

        # 合成最终答案(紧凑 prompt + 反捏造约束 + 限长输出)
        # 关键:把每条结果的内容也喂给 LLM,避免凭空捏造型号
        all_info = "\n".join(
            f"[{i+1}] q={x['query']}\n"
            f"answer: {x['answer'][:200]}\n" +
            "\n".join(f"  - src={r['url']}\n    content={r['content'][:600]}"
                      for r in x['results'][:3])
            for i, x in enumerate(self.collected_info)
        )
        final_prompt = f"""你是技术调研员,用最紧凑的中文回答用户问题。

【硬约束】
1) 只引用检索里**明确出现**的型号/数字;找不到的写"未在检索中证实"。
2) 不要长篇背景介绍,直接给结论与依据。
3) 输出格式:
   - 一句话结论
   - 推荐TOP2:每个型号一行:型号 | 速度/效果要点 | 主要来源 url
   - 风险/局限(一句话)

用户问题:{user_question}
检索证据:
{all_info}
"""
        final_answer = self.llm_call(final_prompt, max_tokens=800)
        print("\n===== 最终答案 =====")
        print(final_answer)
        return final_answer


if __name__ == "__main__":
    agent = AgenticSearch(max_search_round=1, min_evidence=3)
    question = "对比2024-2025开源本地大模型,在8GB显存设备上的推理速度和效果,推荐2个综合最优模型。"
    agent.run(question)
输出结果:
===== Agentic Search 启动 ===== 📋 子任务:['检索2024-2025年开源本地大模型在8GB显存设备上的推理速度基准测试数据', '检索2024-2025年开源本地大模型在8GB显存设备上的效果评测对比', '基于推理速度与效果对比推荐2个综合最优的开源本地大模型'] ----- 子任务:检索2024-2025年开源本地大模型在8GB显存设备上的推理速度基准测试数据 ----- 🔍 Tavily: 检索2024-2025年开源本地大模型在8GB显存设备上的推… → en: 2024 2025 open source local LLM inference benchmark 8GB VRAM ✅ 评估:已收5条结果并包含主流型号 ----- 子任务:检索2024-2025年开源本地大模型在8GB显存设备上的效果评测对比 ----- 🔍 Tavily: 检索2024-2025年开源本地大模型在8GB显存设备上的效… → en: 2024 2025 open source local LLM benchmark 8GB VRAM comparison ✅ 评估:已收10条结果并包含主流型号 ----- 子任务:基于推理速度与效果对比推荐2个综合最优的开源本地大模型 ----- 🔍 Tavily: 基于推理速度与效果对比推荐2个综合最优的开源本地大模型… → en: best 2 open-source local LLMs speed accuracy comparison recommendation ✅ 评估:已收15条结果并包含主流型号 ===== 最终答案 ===== - 一句话结论:检索中明确提及适合8GB显存且综合较优的为Qwen3.5-9B与Qwen 3 7B(或Mistral Small 3 7B),但部分速度数字未在检索中证实。 - 推荐TOP2: Qwen3.5-9B | 检索称最快推理与好推理/编码,8GB VRAM适用 | r/LocalLLM/comments/1wblnsk/a_final_llm_benchmark_for_8gb_vram_16gb_ram Qwen 3 7B | HumanEval(Q4_K_M) 76.0,~5.5GB,代码/多语优 | /best-local-llm-models-2026 - 风险/局限:Gemma 27B等称适8GB实为16GB,且RTX 3070具体速度数字未在检索中证实。
五、实践经验总结
1. 检索策略优化难题
智能体自主生成检索query,很容易出现query质量差的问题。大模型可能写出过于宽泛或者过于狭窄的检索词,导致返回大量无关内容。
- 举个例子:用户问低显存模型评测,如果智能体错误生成query“大模型发展历史”,检索内容完全偏离任务目标。这个问题叫做检索漂移,是Agentic Search常见bug。
- 解决思路:增加query校验子步骤。生成检索词之后,让模型先评估query和当前子任务是否匹配,过滤无效检索词;同时可以使用query改写、query拓展技术,对原始检索词做变体生成,提升召回丰富度。
还有检索数量平衡问题。搜太少,信息不足;每次大量检索,带来高额API费用,同时大量网页文本塞进上下文,会造成上下文溢出,增加幻觉概率。这里需要做动态召回,根据任务重要程度动态控制每次返回文档条数。
2. 反思与信息校验能力不足
反思模块是整个系统的软肋。大模型本身不是完美的,有时候无法识别信息冲突,或者错误判断“信息已经足够”,提前终止检索,导致答案缺关键内容;也可能错误判断信息不足,无意义反复搜索,浪费资源。这个问题根源在于,模型很难精准评估信息完备度。很多事实隐藏在网页深处,仅依靠摘要,模型很难判断有没有遗漏关键信息。
优化方向:细化反思prompt,拆分评估维度,不要让模型笼统判断够不够,而是逐条检查:是否有数据、是否有多来源佐证、是否存在观点冲突、有没有权威原始文档。同时增加来源权重机制,官方论文、一手文档权重高于自媒体博客。
3. 成本、延迟与上下文压力
Agentic Search需要多轮大模型调用+多次搜索引擎API调用,相比单次联网搜索,token消耗、接口费用、响应延迟都会明显上升。复杂调研任务,可能会触发5~10轮搜索,多次调用大模型做规划、反思,成本成倍增加。
另外,每一轮检索返回网页片段不断累积,上下文窗口快速膨胀。过长上下文会带来几个问题:推理变慢,模型容易丢失早期信息,忽略关键细节。
我们迭代过的优化手段:
- 检索结果摘要压缩,提炼网页核心要点,丢弃冗余文本;
- 做记忆管理,保留已验证关键结论,清理中间过程的无效片段;
- 设置最大搜索轮次上限,防止无限循环;
- 小模型做规划、反思,大模型只负责最终答案生成,降低成本。
4. 幻觉无法彻底根除
Agentic Search可以大幅降低幻觉,但不能完全消灭幻觉。有几种场景依然会出错:
- 搜索结果本身网页内容就是错误信息,智能体无法分辨虚假网页;
- 多个网页都传播同样错误信息,交叉验证失效,模型误以为多方佐证就是事实;
- 网页信息含糊,模型自行脑补缺失数据,生成不存在结论。
应对手段:优先采信一手权威来源;对于关键数值、结论强制多源交叉验证;最终输出时区分“事实”和“网络观点”,并附上引用链接,让用户可以溯源核对。
六、应用场景适配
1. 专业深度调研
这是Agentic Search最适合场景。市场调研、技术文献调研、竞品分析、学术资料整理。
- 这类任务天然多步骤,需要多方资料交叉比对。
- 普通搜索只能拿到零散文章,Agentic Search自主规划调研大纲,逐层收集信息,自动核对矛盾,输出完整调研报告。
- 企业内部知识库检索系统,接入Agentic Search,辅助研究员、产品、研发快速完成资料整理。
2. 复杂技术问答
比如排查开源框架报错、查找API变更、对比不同方案技术选型。
- 很多技术问题,需要分步检索:先查报错含义,再查版本更新日志,再查找github issue案例。
- 传统RAG一次检索很难覆盖完整链路,Agentic Search可以根据查到的报错信息,继续检索对应的解决方案。
3. 实时事实类复杂查询
- 需要整合多个实时信息的复杂问题,比如赛事多维度数据分析、政策多文件解读。
- 简单单次搜索只能返回单条新闻,Agentic Search可以自动检索多份官方文件,对比新旧条款,梳理完整逻辑。
4. 教育辅助与深度科普
面对复杂科普问题,智能体分步查找资料,从基础概念到案例,层层检索,组织通俗易懂内容,还能多方核对保证内容准确,减少错误知识点。
七、总结
Agentic Search本质不是一种新搜索引擎,而是让大模型具备自主开展信息调研的能力。传统RAG和联网搜索,模型只是被动执行检索指令;Agentic Search把思考权交给智能体,形成“规划-检索-评估反思-迭代”闭环,把大模型从信息摘要器,变成自主信息研究员。
它解决了传统检索无法处理多步骤复杂调研、缺少信息校验、不能迭代补充资料的痛点,极大提升开放式复杂问题答案准确性,显著降低幻觉。但我们也要理性看待:它有成本高、延迟大、智能体决策不稳定等短板,不是万能方案。简单问题没必要上Agentic Search,复杂深度调研场景,才能发挥它最大价值。
未来随着智能体规划、反思能力持续优化,加上成本不断下降,Agentic Search会成为大模型应用里的基础能力,深度改变我们获取信息的方式:不再是我们自己想关键词去搜索网页,而是交给AI智能体自主完成整套调研,我们只需要提出最终目标。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号