思维系列-构建个人思维元模型
原创
思维系列-构建个人思维元模型
原创
人月聊IT
发布于 2026-11-14 16:45:23
发布于 2026-11-14 16:45:23
大家好,我是人月聊IT。今天继续分享思维方面的内容,即我在前面输出过的个人思维元模型文档。这份文档想做的事,是把一个人“怎么思考”这件事拆开、摊平、重新装一遍。
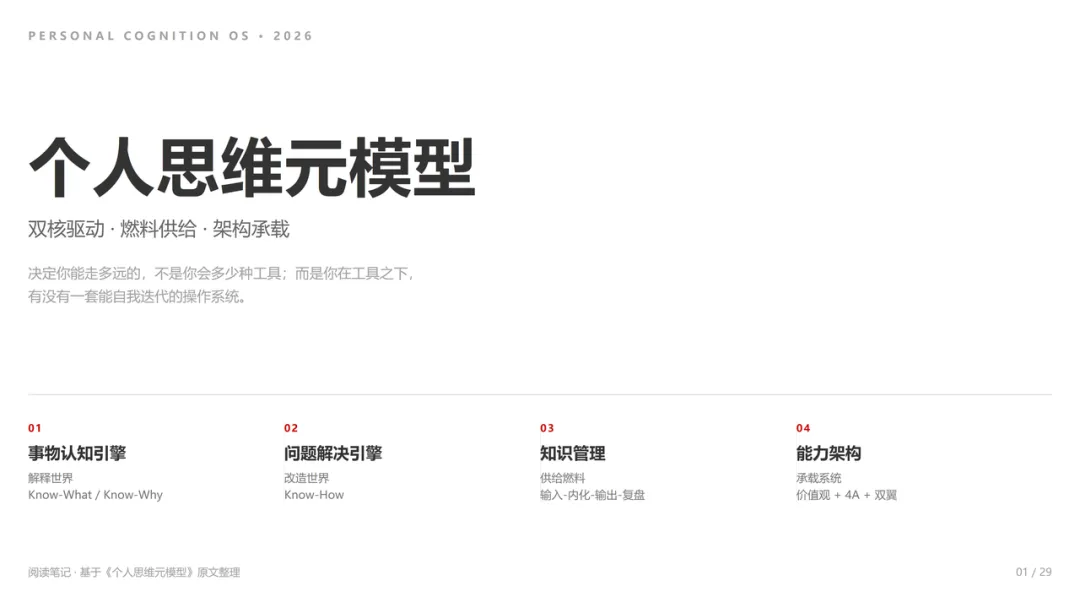
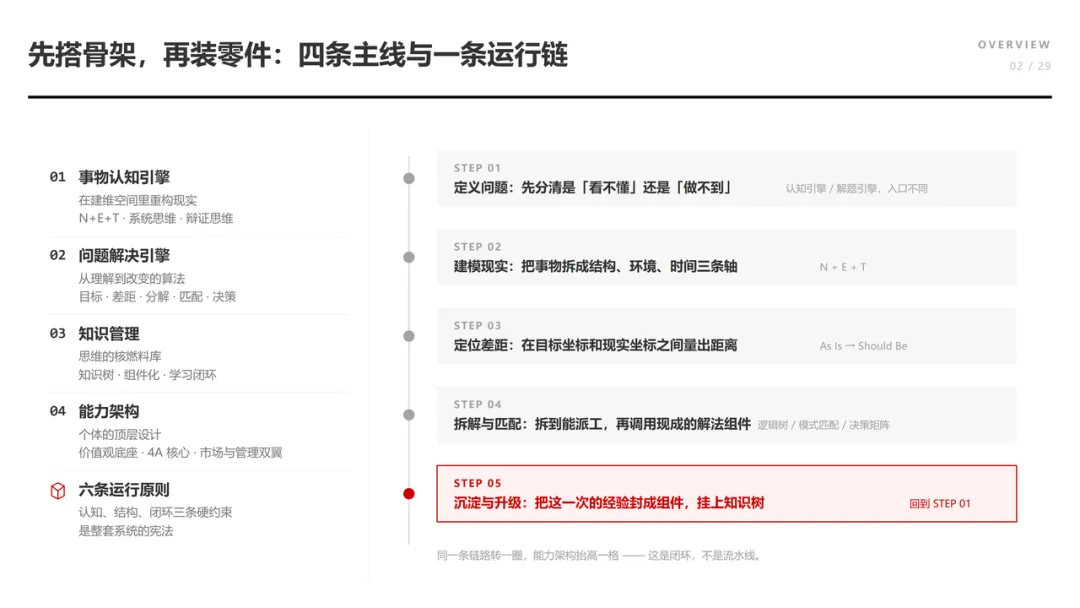
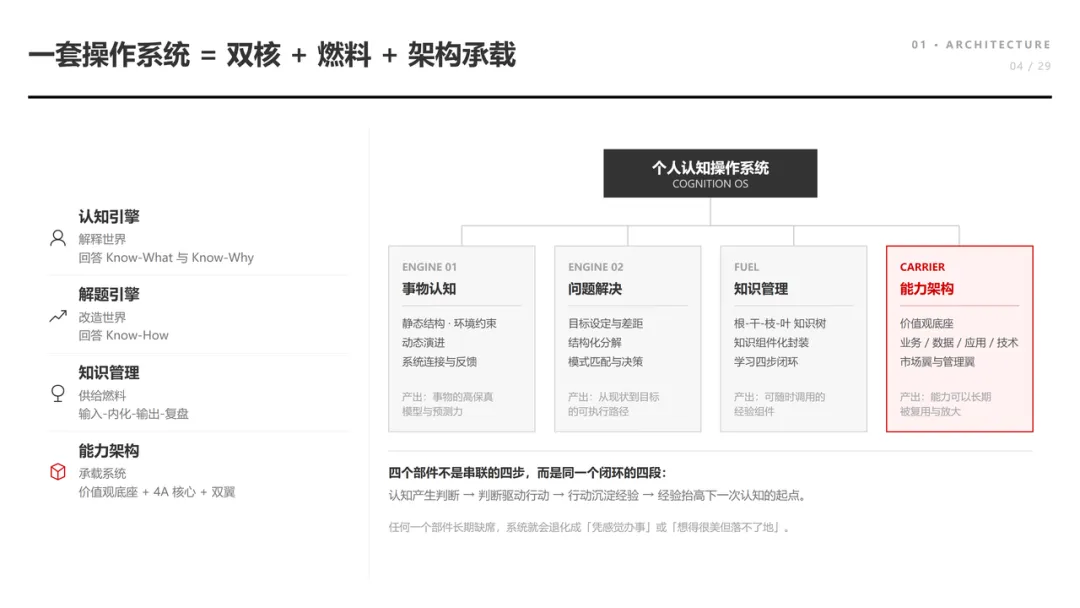
它把个人认知当成一套操作系统来看待,而一套操作系统至少要解决四个问题:靠什么看懂世界,靠什么改变世界,靠什么持续供能,靠什么承载这一切。对应到模型里,就是两个引擎(事物认知、问题解决)、一个燃料系统(知识管理)和一个承载架构(能力架构)。四者不是并列的四块砖,而是一个闭环:认知产出判断,判断驱动行动,行动沉淀经验,经验回头修正认知。
往下六章基本沿着这条线走。第一章把整张地图摊开,说清楚这四块各自管什么;第二章讲怎么把一件事看透;第三章讲怎么把一个难题解决;第四章讲知识该怎么存、怎么长;第五章讲能力本身该怎么搭;第六章是六条运行原则,相当于这套系统的使用守则。最后附三个完整案例,分别对应个人成长、技术排查和团队管理,用来说明这套东西落到真实场景里是什么样子。
如果你时间有限,只读第一章和附录,也能拿到七成的信息。
第一章 元模型总览 —— 个人认知的操作系统
1.1 为什么需要元模型?
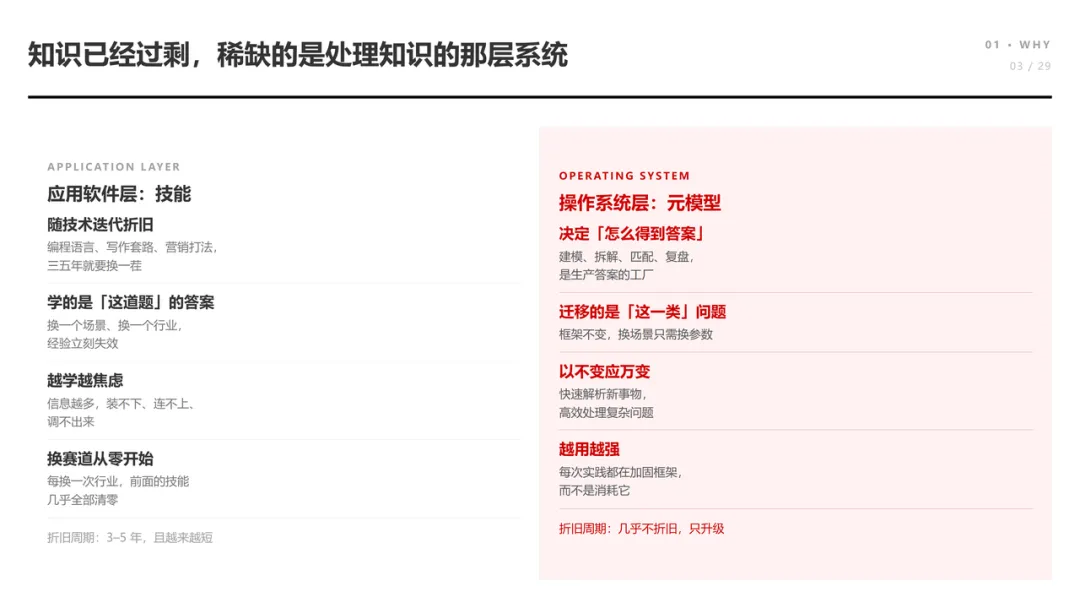
信息早就不是稀缺品了。今天真正稀缺的,不是知识本身,而是处理知识的智慧——同样一份资料摆在面前,有人看到的是一堆事实,有人看到的是结构、是因果、是下一步该做什么。差别不在信息量,在处理信息的那套底层程序。
一个常用的比喻是把大脑比作计算机。大多数人拼命升级的是“应用软件”:学编程、学写作、学营销、学各种工具。这些当然有用,但它们全都跑在一个看不见的东西上面——操作系统。操作系统弱,装再好的软件也会卡死;操作系统强,临时装个什么都能跑起来。
思维体系元模型,就是给大脑装的那套操作系统。它的价值不在于解决某一个具体问题,而在于提供一套通用的底层框架:遇到没见过的东西,你知道从哪几个角度切进去;遇到啃不动的难题,你知道该把它拆成什么样。所谓“以不变应万变”,说的就是这个——变的永远是问题,不变的是你拆解问题的手法。
这里有个容易混淆的地方需要先说清楚:元模型不是知识,是生产知识的那台机器。学一个模型,不会让你多知道一件事实,但会让你再遇到新事实时,知道该把它放在哪、该怎么用。
1.2 元模型的核心架构
整个模型可以概括成一句话:两个引擎负责干活,一个燃料系统负责供能,一个架构负责承载。
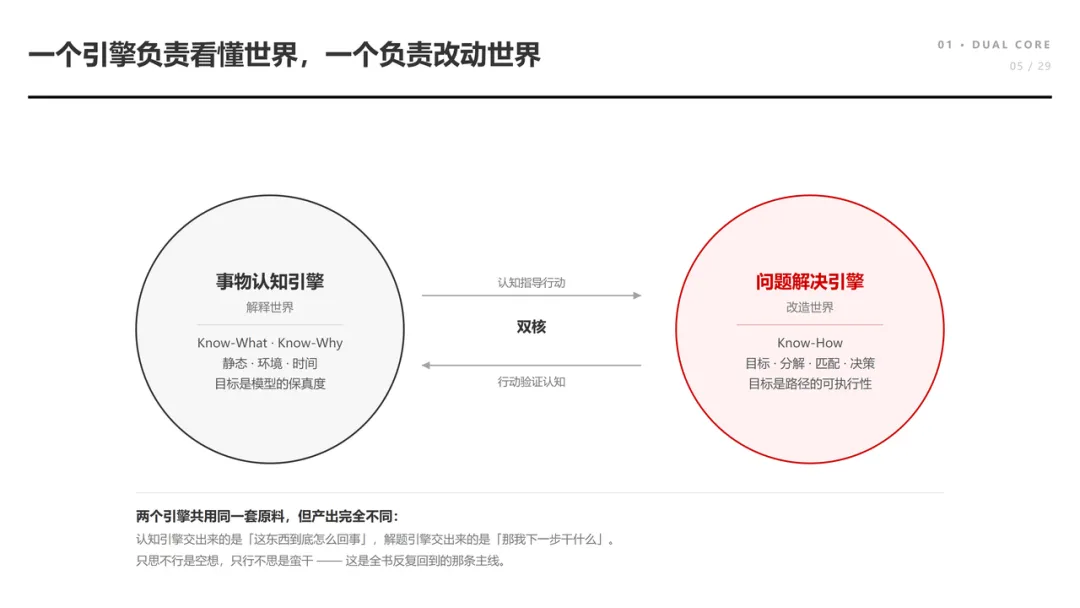
第一块,双核驱动引擎。 所谓“双核”,是因为人面对世界时,说到底只做两件事:先看懂它,再改变它。看懂世界的那一台叫事物认知引擎,改变世界的那一台叫问题解决引擎。两台机器缺一不可——只看不改,是空谈;只改不看,是瞎干。
第二块,燃料供给系统。 引擎要转得动,得有油。这里的油就是知识与经验,由知识管理系统负责持续供给。它做的不是“收藏”,而是把外部信息加工成引擎能直接烧的燃料——可复用的知识组件。
第三块,承载架构。 前面那些都是“能力”,能力得长在一个人身上,而人是有底座、有结构的。能力架构描述的就是这个承载结构:以价值观为地基,以架构能力为核心,以市场洞察和管理能力为两翼。
具体展开:
1. 双核驱动引擎(Dual-Core Engine)
- 事物认知引擎(Cognition Engine):负责“解释世界”,回答的是 Know-What(这是什么)和 Know-Why(为什么会这样)。它的工作方式是三维扫描——看静态结构、看动态演进、看所处环境,最后拼出一个对客观事物的精准模型。
- 问题解决引擎(Problem Solving Engine):负责“改造世界”,回答的是 Know-How(怎么做)。它的工作方式是设定目标、量出差距、结构化分解、做出决策,把“我想要”一步步变成“已经做到”。
一台负责把世界看清楚,一台负责把世界改过来。前者追求的是模型的保真度和预测力,后者追求的是行动路径的可行性和效率。
2. 燃料供给系统(Fuel System)
- 知识管理(Knowledge Management):为两个引擎持续供能。它靠一个闭环运转——输入、内化、实践、复盘,四步转一圈。外部信息经过这一圈,才从“我看过”变成“我会用”,也就是变成内部的知识组件和行为模式。
值得强调的是“转化”这个动作。未经转化的信息只会增加焦虑,转化过的信息才会增加能力。
3. 承载架构(Carrier Architecture)
- 能力架构(Capability Architecture):个体能力的综合载体。以价值观为底座,以架构能力为核心,以市场洞察和管理能力为双翼,支撑整套思维体系的运行。
为什么单独拎出“价值观”当底座?因为底座决定方向。方法再强,方向错了只是更快地跑偏。这一层不产出技能,但它决定你所有技能往哪使。
第二章 事物认知引擎 —— 在多维空间中重构现实
认知的本质是建模。
这句话听起来抽象,但它其实在纠正一个很日常的误解:我们并不是“直接看到”了真实世界。眼睛接收的只是光信号,耳朵接收的只是空气振动,大脑拿这些零碎的输入,拼出了一个“世界”给你看。你看到的从来不是世界本身,而是大脑做出来的那个模型。
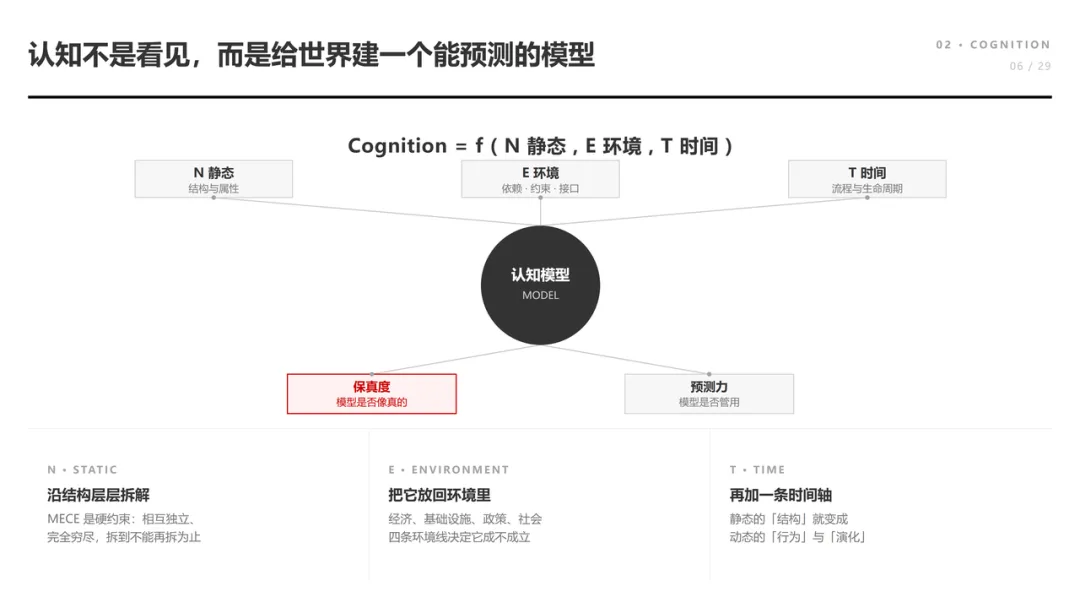
既然是模型,就有好坏之分。好的模型保真度高——它和现实对得上;预测力强——它能告诉你接下来会发生什么。认知引擎的全部任务,就是把手里这个模型做得更准一点、更远一点。
2.1 全维认知模型(The N+E+T Model)
做出片面模型的最典型症状,是“盲人摸象”:每个人摸到的都是真的,但每个人说的都不全。
要避免这一点,就得承认一件事——任何事物都不是单维存在。它同时占据三个维度:它内部有结构(N),它外部有环境(E),它自身有时间(T)。三个维度都扫一遍,模型才立得住。
Cognition = f (N_static, E_environment, T_time)
认知,就是静态结构、环境、时间这三者的函数。
2.1.1 N 维静态分析(Static Analysis)
静态分析,是把事物在某个时间点上“切片”,像解剖一样看清楚它由什么构成。它只关心两件事:结构(Structure)和属性(Attributes)。
结构解剖。 任何复杂事物都由更简单的组件构成,而且往往是层层嵌套。外科医生不会对着一个人整体发愁,他打开胸腔,看到器官,再看到组织,再看到细胞。拆解事物也是这个动作:一层一层往下问“它由什么组成”,直到每一块都简单到能被单独处理。
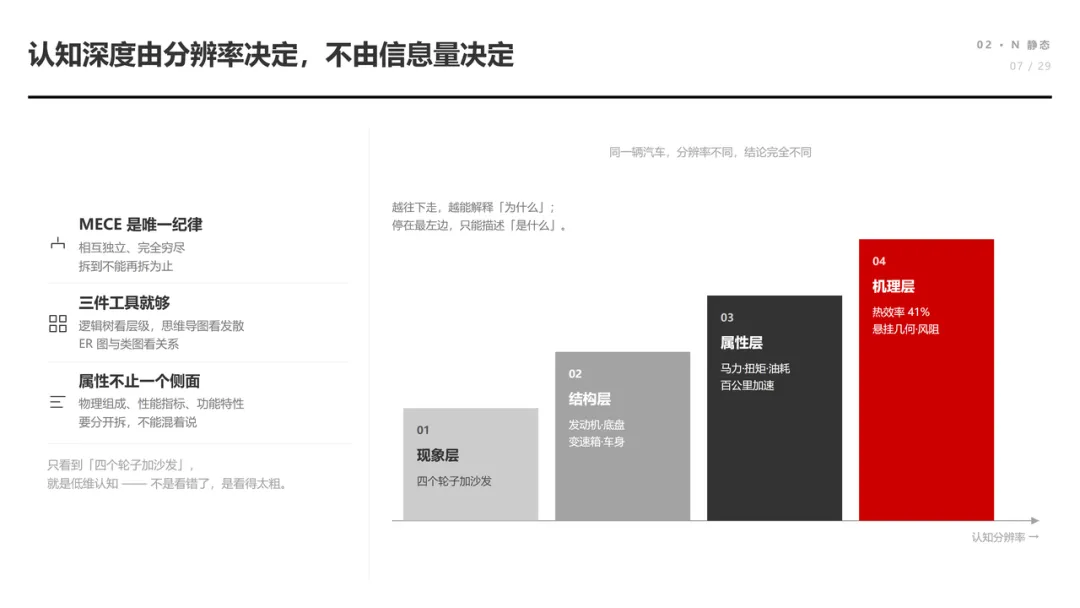
拆解有个硬约束:必须遵循 MECE 法则(Mutually Exclusive, Collectively Exhaustive),即“相互独立,完全穷尽”。翻成大白话是两条:第一,拆出来的几块之间不能互相重叠,否则同一件事会被算两遍;第二,拆出来的几块加起来必须等于原来的整体,不能漏。很多分析做到一半失效,就是违反了这两条——要么漏了关键一块,要么几块之间纠缠不清。
常用的拆解工具有逻辑树、思维导图、ER 图、类图。工具不同,本质相同:把“一团”变成“几块”。
属性维度。 光知道“由什么组成”还不够,还得知道“它有什么性质”。同一个对象,从不同侧面看会得出完全不同的属性清单,所以分析属性时,得先说明白是从哪个侧面看。
案例分析:汽车的静态认知
以一辆车为例,静态分析会问三组问题。
它由什么组成? 发动机、底盘、变速箱、车身。这是结构维度。
它有什么指标? 马力、扭矩、油耗、百公里加速。这是属性维度。
它能干什么? 载人、载物、越野。这是功能维度。
三组答案合起来,才是一个完整的“静态的汽车”。
这里能看出认知的分层:如果我们眼里的车只是“四个轮子加沙发”,那就是低维认知——只看到了外形;如果我们能一路解构到发动机的热效率、底盘的悬挂通过性,那就是高维认知。低维不是错,是不足以支撑判断。你没法用“四个轮子加沙发”这个模型去判断一辆车值不值三十万。
2.1.2 环境分析(Environment Analysis - E)
事物不是孤立存在的。同一个东西放在不同环境里,价值和命运可能完全相反——这也是为什么很多“正确的分析”最后得出“错误的结论”,因为它只分析了事物本身,没分析事物所处的场。
环境分析问三类问题:
- 依赖关系:它靠什么活着?离开了什么它就活不成?
- 约束条件:环境给它划了哪些不能越的线?
- 交互接口:它怎么和外界交换能量与信息?入口在哪,出口在哪?
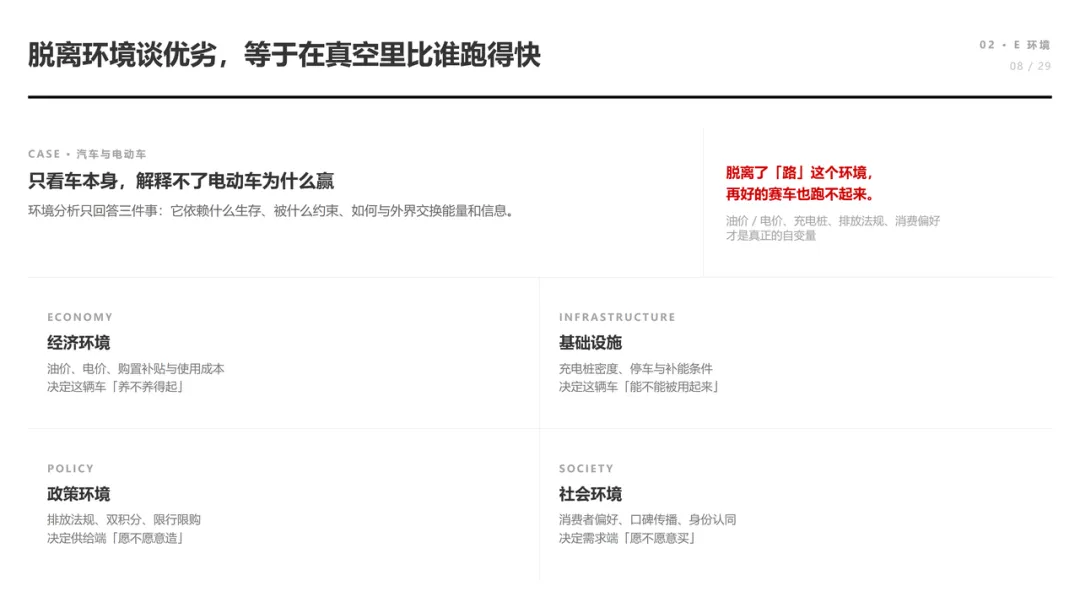
案例继续:汽车的环境
如果你只研究车本身——发动机热效率、变速箱齿比、车身风阻——你会得出一个很合理的困惑:内燃机技术明明一路在进步,为什么现在满街都是电动车?
答案不在车里,在车外。
环境分析至少要扫四条:油价与电价(经济环境)、充电桩的分布密度(基础设施环境)、排放法规的收紧节奏(政策环境)、消费者对续航和牌照的偏好(社会环境)。这四条里任何一条变化,都会重写“什么车值得造”这个结论。
一句话概括:脱离了“路”这个环境,再好的赛车也跑不起来。
2.1.3 动态演进分析(Dynamic Analysis - T)
世界是流动的。静态永远只是相对的——你按下快门的那一刻,事物已经在变了。把时间轴 T 加进来,原来的“结构”就展开成了“行为”和“演化”。
动态分析有两个观察尺度,一个看内部怎么运转,一个看整体怎么变化。
流程分析(Flow):事物内部的运作机制。
追问三个问题就够了:输入是什么?中间经过了哪些步骤?输出是什么?把这三问答清楚,一个黑箱就变成了一条流水线。
案例:汽车的动态
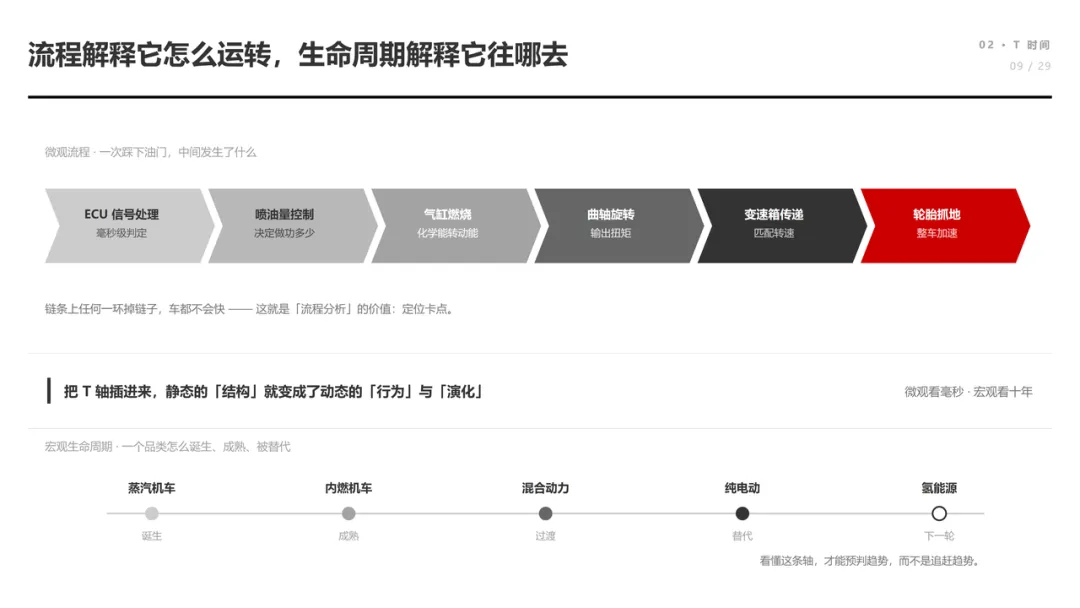
从踩下油门到车辆真正加速,中间发生了一串连锁反应:ECU 先处理信号,判断驾驶意图,然后控制喷油量,燃油在气缸内燃烧做功,推动曲轴旋转,动力经变速箱按齿比传递,最后由轮胎把旋转变成对地面的推力,车才动起来。
这一串链条就是微观的动态。看懂了这条链,你才知道“加速无力”这个问题可能卡在哪一环——是信号没进来,还是喷油不够,还是变速箱没降挡。
生命周期(Lifecycle):事物的宏观演变。
任何事物都有它的一生:诞生、成长、成熟、衰退、消亡。所处的阶段不同,评价标准完全不同——成长期看增速,成熟期看利润,衰退期看现金。
案例:汽车的演化
从蒸汽机车到内燃机车,到混合动力,到纯电动,再到氢能源。这条曲线不是技术清单,而是替代节奏。
理解了这个 T 轴,你才有可能做预判。否则你永远只能解释已经发生的事,而预判不了将要发生的事——这恰恰是认知模型最有价值的部分。
2.2 系统思维(Systems Thinking)—— 认知的进阶
把 N、E、T 三个维度都扫完了,是不是就够了?
还不够。如果只把要素一个个看清楚,却不看要素之间的连接,你手里仍然只是一堆碎片——你知道每个零件是什么,但不知道它们连起来会怎样。系统思维要补的正是这一块:关注关系,而不只是关注要素。
2.2.1 相互连接与反馈循环
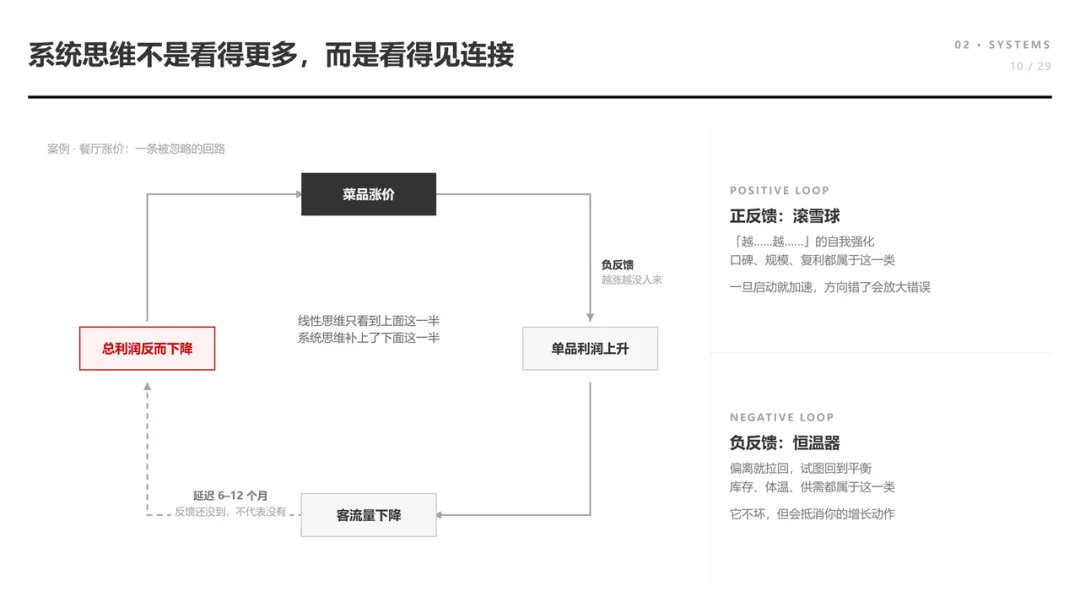
系统中的要素通过因果链条互相牵动,牵动会绕回来,绕回来又改变最初的那个动作。这种“绕回来”就是反馈,它只有两种形态。
- 正反馈(Reinforcing Loop):滚雪球效应。A 增强 B,B 又回头增强 A,于是越滚越大——越有钱越容易赚钱,越有人看越容易被推荐。它推动增长,也放大崩塌。
- 负反馈(Balancing Loop):恒温器效应。A 增强 B,B 反过来抑制 A,系统试图回到平衡——体温高了就出汗散热,价格高了需求就下降。它维持稳定,也抵抗改变。
真正的麻烦在于:同一个系统里,正反馈和负反馈往往同时存在,而且启动时间不同。
案例分析:餐厅涨价策略
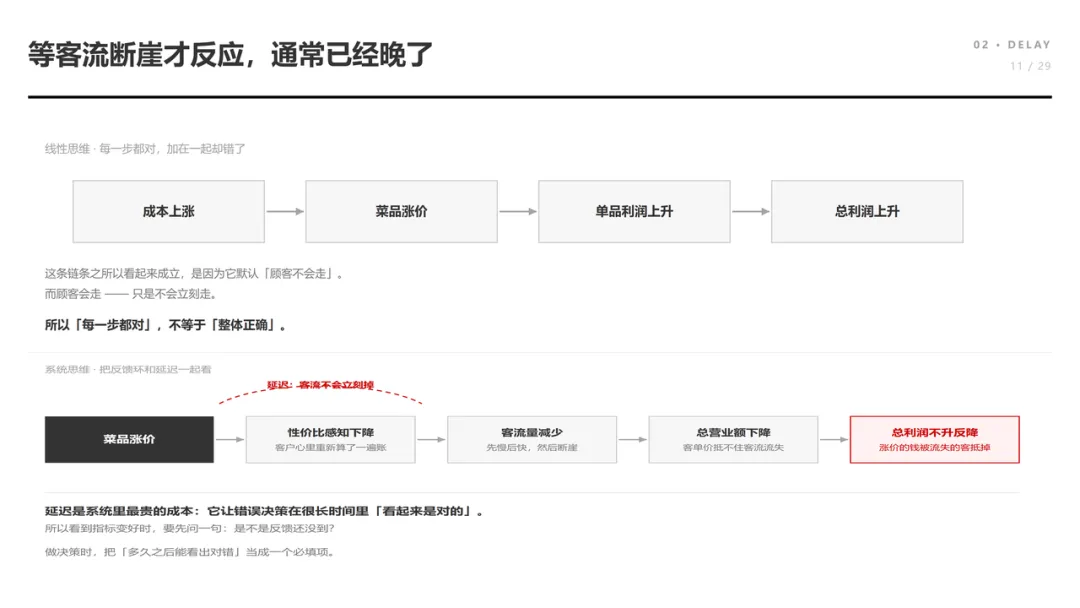
一家餐厅成本上涨,决定涨价。用线性思维推一遍:成本涨了,菜品涨价,单品利润增加,总利润增加。结论是“涨得对”。
用系统思维再推一遍:菜品涨价,顾客感知到的性价比下降,客流量减少——这是一条负反馈;客流减少之后,总利润可能不升反降。
两条推理都成立,区别在于后者多算了一个“人会怎么反应”。
这里还有一个更隐蔽的机制,叫延迟效应(Delay):涨价的头一两个月,客流往往不会立刻减少,因为老顾客有习惯、有惰性。这段“看起来没事”的窗口期,会给出一个错误信号——“涨对了”。等到客流开始断崖式下跌,改回来已经很难,因为流失的顾客不会因为你降价就马上回来。
系统思维要求的,就是能看到这种时间滞后:不要拿今天的反馈,去验证昨天的决策。
2.2.2 辩证思维(Dialectical Thinking)
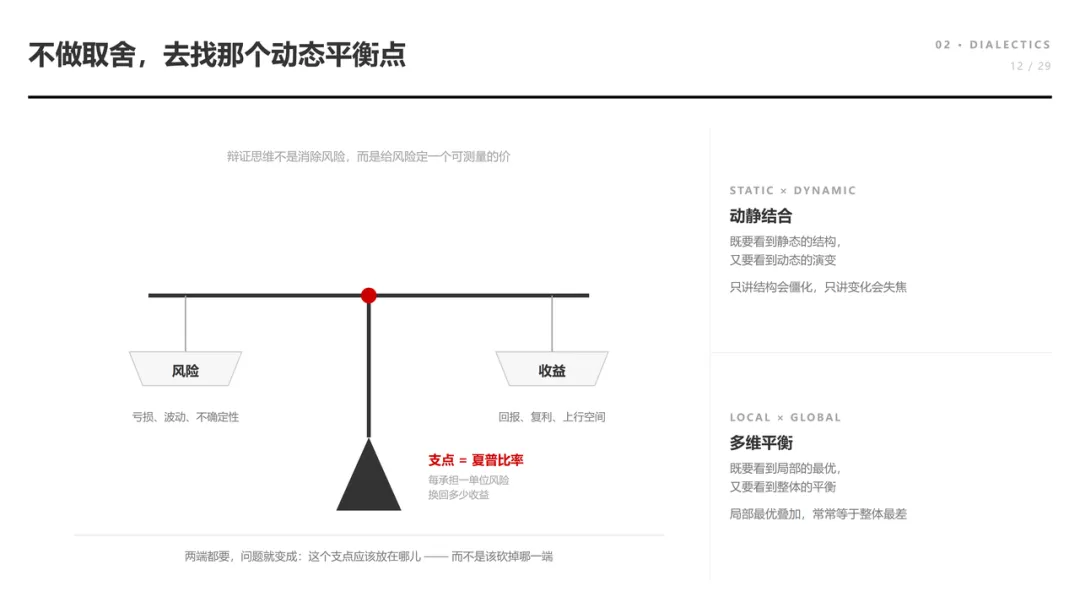
辩证思维是系统思维的哲学那一层。它主张一件事:对立的两面不必二选一,真正的答案常常在两者之间的动态位置上。
- 动静结合:既要看静态的结构,也要看动态的演变。只看结构,你会以为世界是固定的;只看演变,你会不知道当下该抓什么。
- 多维平衡:既要看局部的最优,也要看整体的平衡。每个部门都做到最好,整体可能是最差的——这是组织里最常见的悲剧。
案例:投资决策
风险与收益就是一对矛盾。想要高收益,就得多承担风险;想睡得安稳,就得接受低回报。
辩证的处理方式不是消除风险——风险消不掉,消掉了收益也没了。它做的是找一个动态平衡点,也就是所谓的夏普比率:每承担一单位风险,能换回多少超额收益。这个比值高的方案,未必收益最高,但它“划算”。
从“选最高收益”到“选最划算”,这就是辩证思维带来的视角切换。
第三章 问题解决引擎 —— 从理解到改变的算法
认知的目的是行动。看懂世界只是第一步,接下来得动手改。
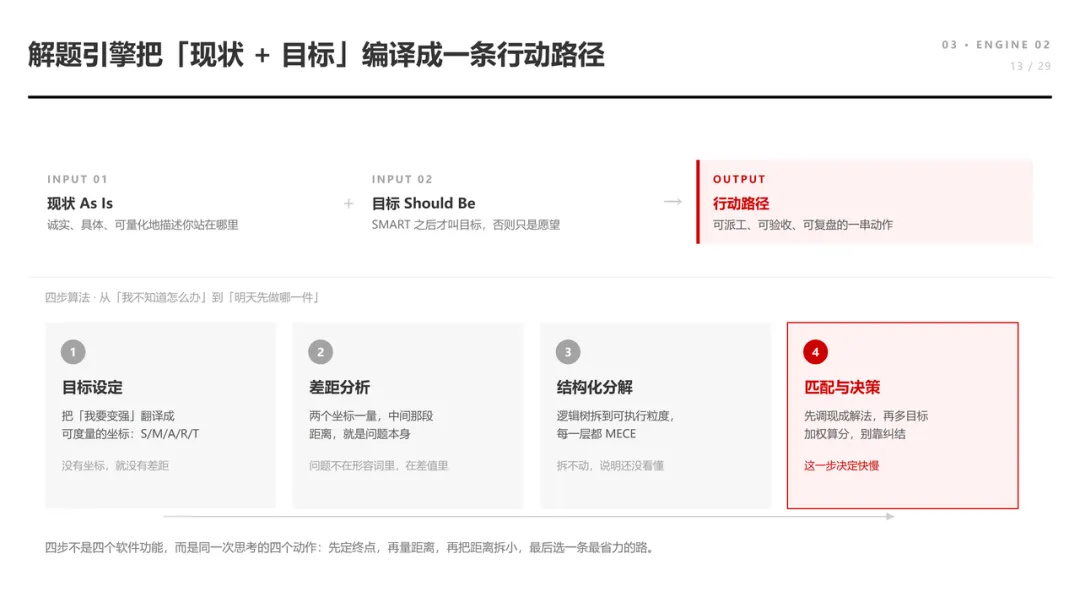
问题解决引擎可以当成一段算法来看:输入是“现状”和“目标”,输出是“行动路径”。中间要跑四个模块——先量出差距,再把差距拆小,再调用已知解法,最后在多个解法里做选择。
3.1 目标驱动与差距分析(Goal Driven & Gap Analysis)
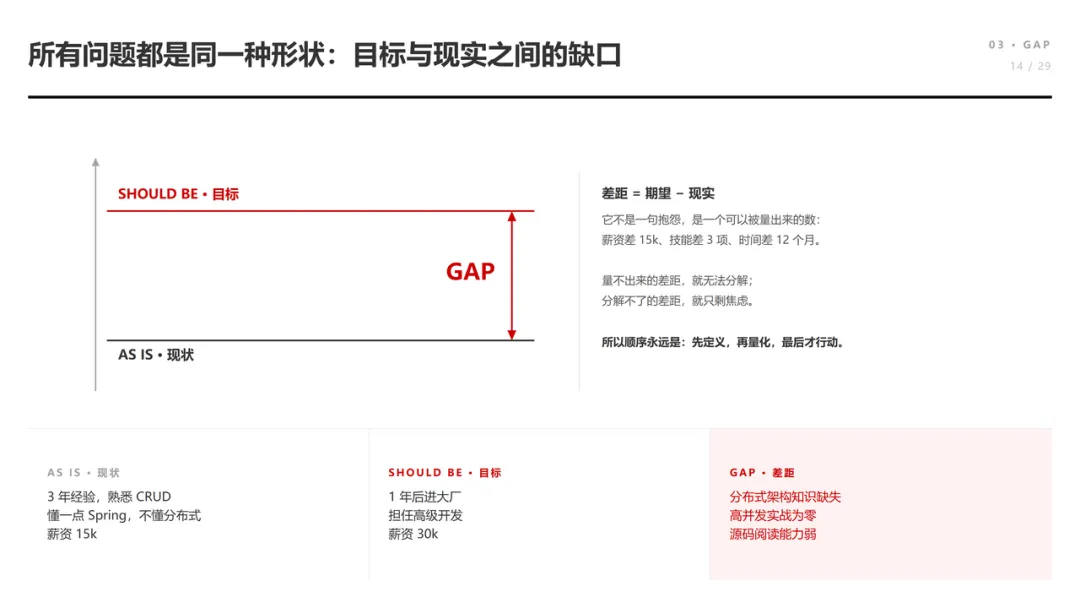
一切问题的本质,都是“期望目标”(Should Be)与“现实状态”(As Is)之间的差距(Gap)。
这句话值得反复用。它意味着:没有目标就没有问题,只有状况。你觉得“最近很累”,那不是问题,那是一种状态;只有当你说“我想在三个月内把体重降到 70 公斤”,疲惫、作息、饮食才突然变成一堆可被处理的问题。
所以解决问题的第一步永远不是想方案,而是把目标说清楚。
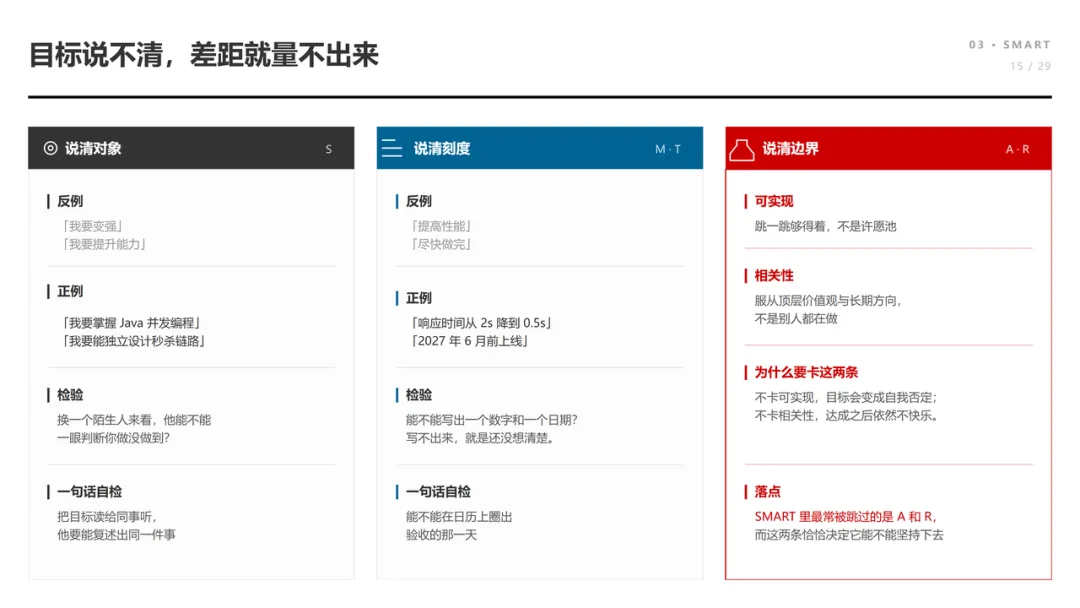
3.1.1 目标的 SMART 原则
目标不清晰,差距就无法定义;差距无法定义,问题就无法解决。这不是修辞,是逻辑顺序。
判断一个目标合不合格,用五个字母过一遍:
- S(Specific)具体的。 不要说“我要变强”,要说“我要掌握 Java 并发编程”。前者无法验证,后者可以。
- M(Measurable)可度量的。 不要说“提高性能”,要说“响应时间从 2 秒降到 0.5 秒”。有数字才谈得上“差多少”。
- A(Attainable)可实现的。 目标要够得着,是跳一跳能拿到的。定一个不可能完成的目标,等于没有目标,因为它同样无法指导行动。
- R(Relevant)相关的。 目标要和你的顶层价值观、长期方向对得上。否则你会用极高的效率,跑向一个自己并不想去的地方。
- T(Time-bound)有时限的。 没有截止时间的任务,永远不会被开始。
五条全过,目标才算“可执行”。缺哪一条,后面所有步骤都会在模糊处失焦。
3.1.2 差距分析三部曲
目标清楚了,接着量距离。三步:
- 精准定义现状。 用 N+E+T 那套方法,诚实地描绘你现在站在哪个坐标。难点不在方法,在诚实——人评估自己时天然会美化,会把“看过教程”记成“会”,把“参与过”记成“负责过”。
- 明确定义目标。 设定未来的那个坐标,同样要具体到可验证。
- 量化差距。 算两点之间的距离,并把距离拆成“缺哪几样东西”。
案例:职业转型
- 现状:3 年工作经验,熟悉 CRUD,懂一点 Spring,不懂分布式,薪资 15k。
- 目标:1 年后进入大厂,担任高级开发,薪资 30k。
- 差距:分布式架构知识缺失,高并发实战经验为零,源码阅读能力弱。
注意这个差距清单的写法——它写的不是“我不够好”,而是三个具体缺口。前一种说法会让人焦虑,后一种说法可以直接变成学习计划。这就是“量化”的作用。
3.2 结构化分解(Structured Decomposition)—— 化整为零
面对一个巨大的差距,直接跨越是不可能的。没人能“一年之内从 CRUD 变成架构师”,但每个人都能“这周把 CAP 定理搞明白”。
分解的要义,是把“不可能一步做到”变成“可以一步步做到”。
3.2.1 逻辑树与 MECE
- 逻辑树(Logic Tree):把大问题层层拆成小问题,每往下一层,问题就更具体、更容易动手。
- MECE 原则:每一层的拆解都要做到“不重不漏”——不重复计算,也不遗漏关键项。
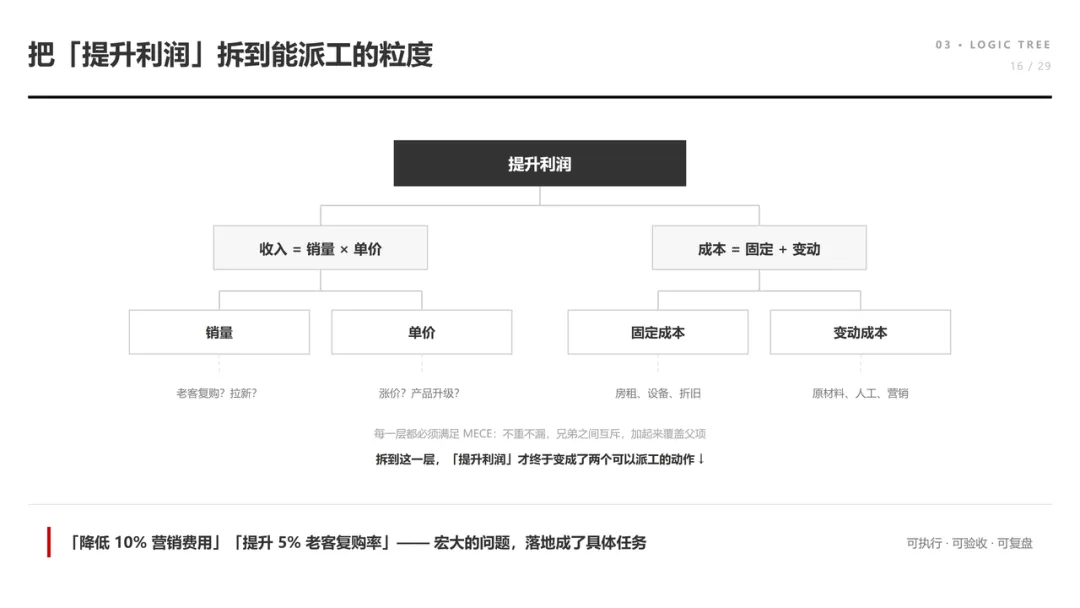
案例:如何提升利润?
先拆第一层,用一条恒等式:利润 = 收入 − 成本。一个模糊的愿望,就这样变成了两个可攻的方向。
再拆收入:收入 = 销量 × 单价。于是提高收入只有两条路——卖得更多,或者卖得更贵。
- 卖得更多又分两条:让老客户多买几次(提复购),或者让新客户进来(拓新客)。
- 卖得更贵也分两条:直接涨价,或者把产品升级到能支撑更高价格。
再拆成本:成本 = 固定成本 + 变动成本。
- 固定成本:房租、设备这类不管业务多少都要付的钱。
- 变动成本:原材料、人工、营销这类随业务量起伏的钱。
拆到这里,“提升利润”这个宏大的命题,已经落地成了几个具体动作:把营销费用压 10%,或者把老客户复购率提 5%。这些动作可以写进周计划,可以派给具体的人,也可以在一周后检验有没有做到。
这就是分解的全部意义——不是把问题说得更复杂,而是把它说到能派活为止。
3.2.2 粒度控制
但分解不是越细越好。拆得太细,会掉进细节里出不来,管理成本超过收益。
合适的粒度有一个判断标准:可执行(Actionable)。也就是一个人拿到这个子任务,知道明天早上第一件事做什么。
三个层次可以对照着看:
- 子目标:对应 SMART 原则,是“要达成什么”。
- 影响因素:对应 CSF(Critical Success Factor,关键成功要素),是“什么决定了能不能达成”。
- 控制变量:对应具体行动,是“我现在能拧动的那个旋钮”。
拆到“能拧的旋钮”这一层,就可以停手开工了。
3.3 模式匹配(Pattern Matching)—— 专家的捷径
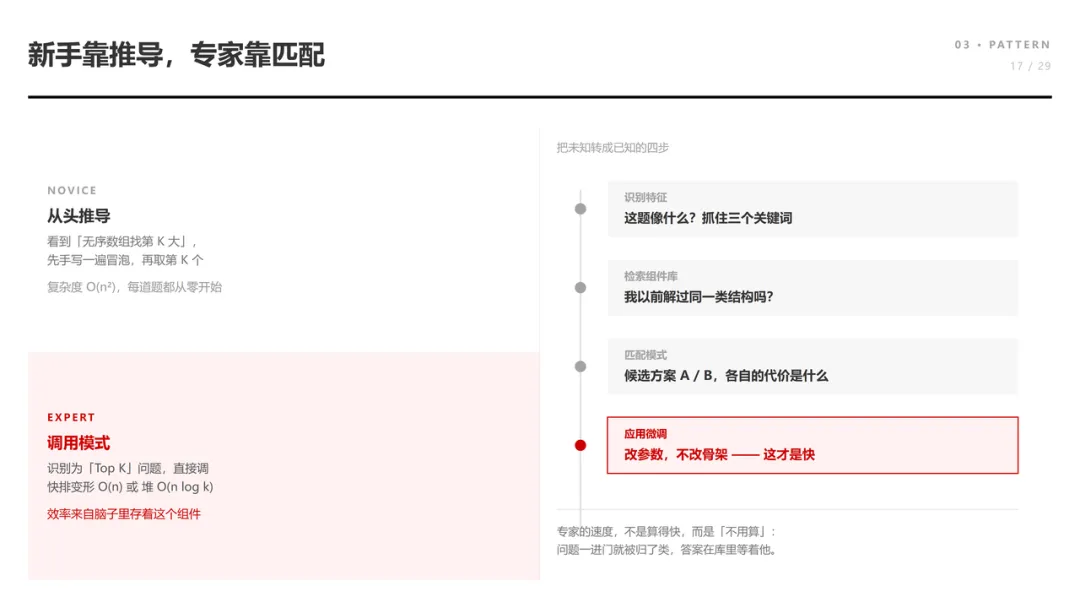
新手解决问题靠推导,专家解决问题靠匹配。
这句话解释了一个常见困惑:为什么同样的问题,老手几秒钟就有方向,新手要熬三个通宵?不是智商差距,是索引差距。专家脑子里存着成百上千个“问题—解法”的配对,看到症状就能直接检索。
3.3.1 将未知转化为已知
模式匹配的完整动作是四步:识别问题特征,检索大脑数据库,匹配已知模式,应用并微调。关键在于第一步——你能不能从一堆表象里,抽出那个“特征”。
案例:编程算法
题目是“在无序数组中找第 K 大元素”。
- 新手:从零开始推导,先手写一个冒泡排序,排完再取第 K 个。能做出来,但复杂度是 O(n log n),而且下次换个题,还得从头想。
- 专家:先抽特征——“无序”“第 K 大”,这两个词一组合,直接命中“Top K 问题”这个模式。模式库里挂着两个方案:方案 A 是快排变形,平均 O(n);方案 B 是堆排序,O(n log k)。看一眼数据规模和内存限制,选方案,动手编码。
差别不在聪明,在于专家脑子里存着“Top K 问题”这个已经封装好的知识组件。他不是在解题,是在认题。
这也解释了为什么“刷题”有用,也解释了为什么“只刷题”没用——如果只记住了题目,没抽出特征,模式库是空的,换个壳就又不认识了。
3.3.2 假设驱动(Hypothesis Driven)
碰到完全非结构化的问题,连特征都抽不出来,模式库检索不到东西,怎么办?
这时候不能再想“我要穷举所有可能”——真实系统的可能性是无穷的。可行的做法是反过来:先基于经验提出几个假设,然后用最小的成本去验证或推翻它们。
案例:系统崩溃
现象:接口响应极慢,CPU 打满 100%。
面对这个现象,可以提出两个最可能的假设:
- 假设 1:代码里有死循环。 死循环会让一个线程持续占满一个核,CPU 曲线会很平、很高。
- 假设 2:频繁 Full GC。 内存回收不停触发,同样会把 CPU 吃满,但表现是周期性的锯齿。
验证顺序很关键:先看监控和日志。CPU 曲线是“平顶”还是“锯齿”,一眼就能区分。如果不是假设 1 的表现,再去验证假设 2。
这比一头扎进几万行代码里逐行翻,快了不止一个量级。假设驱动的价值就在这里:它把搜索空间从“所有代码”缩小到“两三个可能”,让你的每一次查看都有目的。
3.4 结构化决策(Structured Decision)
有了若干可行方案,接下来是选。选不好,前面全白做。
3.4.1 多目标平衡
决策往往不是为了满足单一目标,而是多目标之间找平衡——既要……又要……。
- 投资:既要高收益,又要低风险,还要流动性。
- 架构:既要高性能,又要高可用,还要低成本。
这三样通常没法同时拉满。承认这一点,决策就从“找一个完美方案”变成了“明确我这次愿意牺牲哪一个”。这个转变很重要,因为前者永远找不到答案,后者当场就能拍板。
3.4.2 决策矩阵(Decision Matrix)
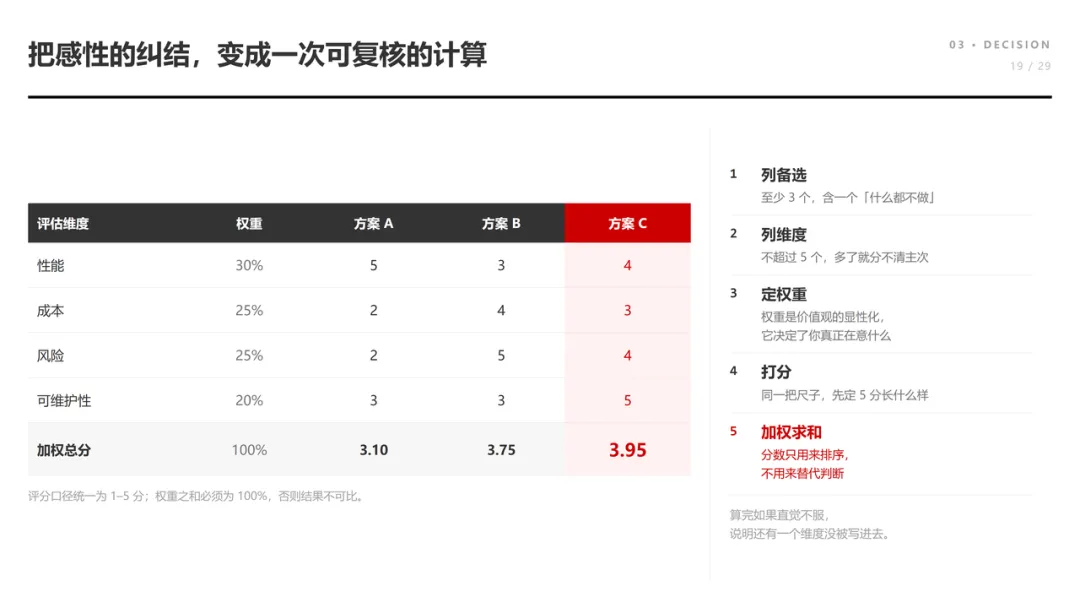
当纠结来自“感觉各有各的好”,就把它变成算数。五个步骤:
- 列出备选方案(Option A、B、C)。
- 列出评估维度(成本、周期、风险、可维护性……)。
- 给维度设权重(Weight)。这一步最容易被跳过,但它决定了结论。权重不明说,纠结就永远在“我觉得”的层面打转。
- 逐项打分(Score)。
- 加权求和,得分高者胜出。
这么做不是为了让机器替你做决定,而是把“我倾向于 A,但说不清为什么”摊开成一张表——你很可能在填权重的时候,突然发现自己真正在意的是哪一项。那才是决策的转折点。
第四章 知识管理 —— 打造思维的核燃料库
引擎再强,没有燃料也是废铁。
但这里要先纠正一个普遍误解:知识管理不是收集信息。收藏夹里存三千篇文章,那不叫知识管理,那叫囤积。知识管理真正做的事是构建结构——把散落的信息,长成一棵有主干、有分支的树。
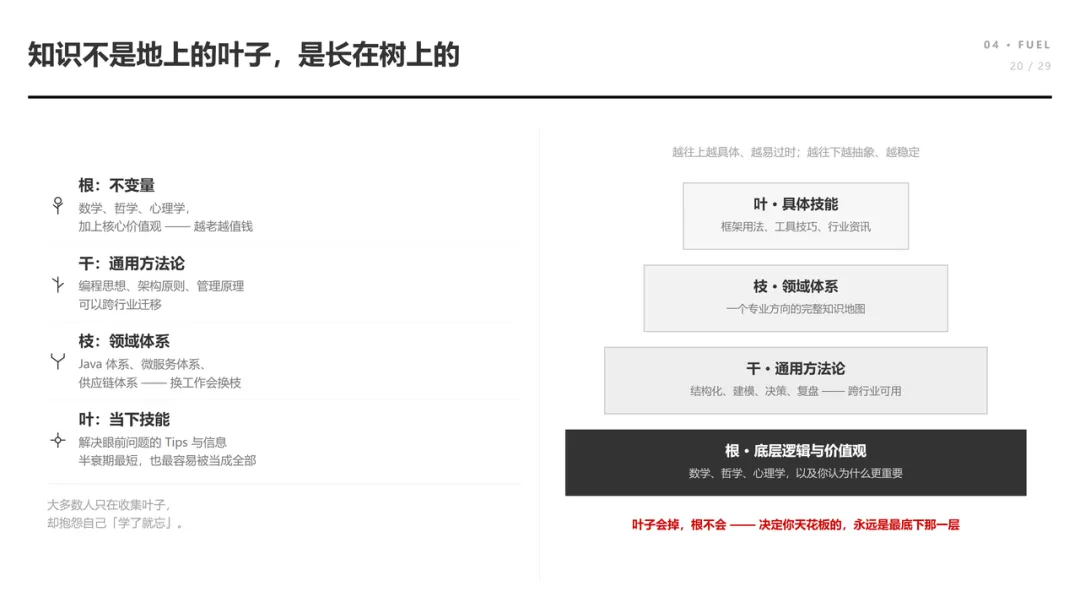
4.1 知识树的生长原理(The Knowledge Tree)
知识不是散落在地上的叶子,而是长在树上的果实。
这个比喻之所以好用,是因为它自带三个约束:果实必须挂在枝上(不能悬空);枝必须连着干(不能各长各的);干必须扎在根上(不能没有营养来源)。
4.1.1 根—干—枝—叶 结构
- 根(Roots):底层逻辑、基础学科(数学、哲学、心理学)、核心价值观。这是不变量——它长得最慢,但决定了整棵树能长多高、抗不抗风。
- 干(Trunk):核心方法论、通用的能力架构,比如编程思想、架构设计原则、管理学原理。它跨领域通用,换个行业依然有效。
- 枝(Branches):具体的领域知识,比如 Java 体系、微服务体系、供应链管理体系。它决定你在哪个领域能干活。
- 叶(Leaves):碎片化的、为了解决当下问题的具体技能、信息和技巧。它生命周期最短,但也最贴身。
四层的更新速度完全不同:叶几个月就换一茬,枝能撑三五年,干可以撑十年,根基本一辈子不动。多数人的问题不是叶子太少,而是叶子和根之间没有连接——学了一堆技巧,却说不出它背后依赖什么原理。
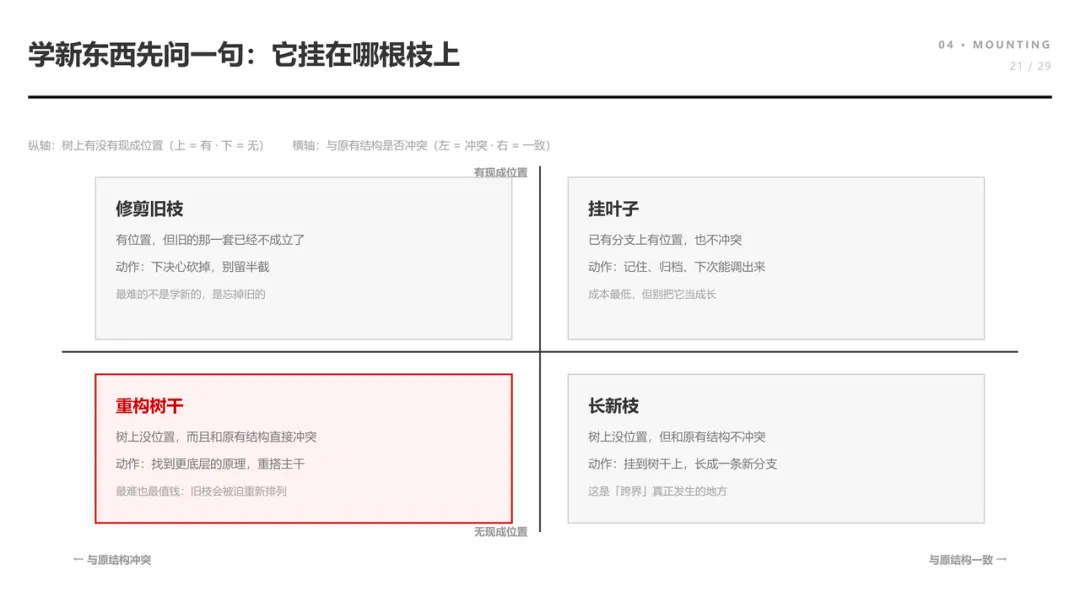
4.1.2 挂载与重构
有了树的结构,学习就多了一个必做动作。
挂载。 学任何新东西,先强制自己回答一个问题:它属于哪根枝?如果是片“叶子”,就把它挂到对应的枝上;如果它自成一系,那就该在树干上长出一根新枝。
这个动作只花三十秒,但它决定了这条知识将来能不能被检索到。没有挂载的知识,等于随机丢进抽屉,当下记得,三个月后找不到。
重构。 还有一种更麻烦的情况:新学的知识,和原来的结构冲突了。这时人的本能是打补丁——把新知识硬塞进旧框架,勉强自圆其说。
正确的做法正相反:不要修补,要重构。承认旧结构错了,拆掉重搭。
重构很痛,因为意味着之前的部分认知作废。但它是认知升级最重要、也几乎是唯一的标志——一个人的水平,往往就体现在他重构过几次知识树。
4.2 知识组件化(Componentization)
光把知识挂上树还不够。要让它在关键时刻能被“调出来用”,还得封装。
封装的好处直接对应上一章讲的模式匹配:知识组件越标准,检索越快,复用越省力。
- 标准化。 把经验沉淀成检查表(Checklist)、模板(Template)、SOP。标准化的本质是把“靠记性和状态”的事,变成“照着做就行”的事——人的状态是会波动的,清单不会。
- 复用性。 一个好的知识组件应该像乐高积木:接口统一,能插到不同场景里,插上去就生效。
案例:办一场活动,不该每次都从零开始想。
应该封装一个“活动策划组件”,里面装着四样东西:人员分工模板(谁负责什么,避免临场找人)、物料清单检查表(对着勾,不会漏带)、风险预案库(下雨怎么办、设备坏了怎么办)、流程 SOP(几点到几点做什么)。
下一次办活动,直接调用这个组件,只改参数——场地、人数、预算。原本要熬一周的筹备,可能两天就够。
这就是组件的威力:它把一次性劳动,变成了可重复资产。
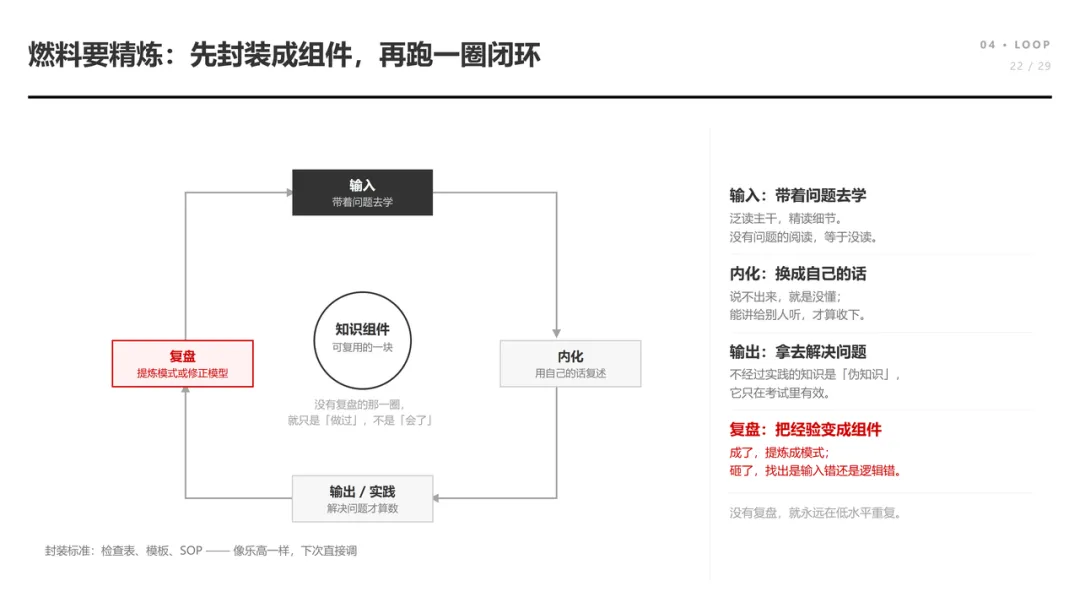
4.3 学习闭环:输入—内化—输出—复盘
知识进脑子,要转完整的一圈才算数。
- 输入(Input):带着问题去学。漫无目的地读,输入量再大也是水过地皮湿;带着具体问题去读,同一本书的信息吸收率完全不同。读法上也有讲究:泛读主干,精读细节——先知道这棵树长什么样,再挑关键枝节细看。
- 内化(Internalize):把信息变成知识树上的节点。最有效的检验方式是“用自己的话复述一遍”——凡是复述不出来的,基本等于没懂。
- 输出/实践(Output/Practice):知识的唯一验证标准是解决问题。不经过实践的知识是“伪知识”——它让你在谈话中显得懂,但在动手时帮不上忙。
- 复盘(Review):这是整个闭环里最关键的一环,也是绝大多数人跳过的一环。
复盘分两种结果走:
- 做成了:总结成功的规律,提炼成可复用的模式。注意,是提炼规律,不是记住过程——过程只对这一次有效,规律对下一次有效。
- 做砸了:分析失败的真正原因。是输入错了(信息本身有问题)?还是逻辑错了(推理链断了)?找到原因,修正模型,这次失败才有价值。
没有复盘,就没有经验的沉淀,就永远在低水平重复——所谓“十年经验”,往往只是一年的经验用了十年。
第五章 能力架构 —— 个体的顶层设计
前面四章讲的都是“怎么运转”,这一章讲“长在什么东西上运转”。
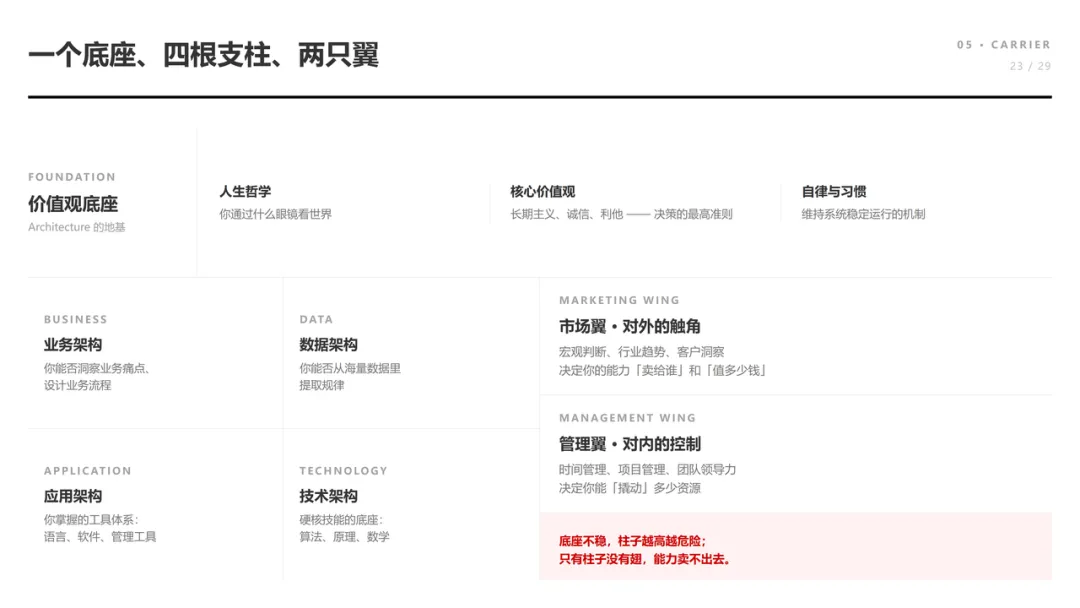
这里借用一个来自企业的概念:EA(Enterprise Architecture,企业架构)。企业用 EA 来描述一家公司由哪些层构成、各层怎么配合。把这套视角平移到个人身上,就得到个人的能力架构——它不教具体技能,它决定技能该往哪放。
5.1 价值观底座(Values Foundation)
这是整个 Architecture 的地基。
地基不显眼,但它决定了上面能盖几层、能扛几级风。
- 人生哲学:你用什么镜片看世界?同一件事,有人看到威胁,有人看到机会,差别往往不在事情本身,在那副镜片。
- 核心价值观:你决策的最高准则,比如长期主义、诚信、利他。它的作用是在信息不足、时间紧迫时,替你做出稳定的选择——没有它,你每次都要重新纠结。
- 自律与习惯:维持系统稳定运行的机制。价值观是方向,习惯是把方向变成日常的那套自动程序。
三层里,习惯最容易被低估。因为能力靠的是“状态好时能发挥”,而成果靠的是“状态差时也不掉线”,后者只能由习惯保证。
5.2 架构核心(Architecture Core)
这是个人的“核心竞争力”区域,对应企业的 4A 架构。四个视角,缺一层就会在某个场景下露怯。
- 业务架构(Business Arch):你对所在行业的理解深度。你能否洞察业务痛点?你能否设计业务流程?这一层决定你“解决的是不是真问题”。
- 数据架构(Data Arch):你的信息处理能力。你能否从海量数据中提取规律?这一层决定你的判断是“有依据”还是“凭感觉”。
- 应用架构(Application Arch):你掌握的工具体系。编程语言、设计软件、管理工具。这一层最容易被当成全部,其实它只是手脚。
- 技术架构(Technology Arch):你的硬核技能底座。算法、计算机原理、数学基础。这一层决定你的上限——工具会过时,原理不会。
四层的关系是从“懂业务”到“懂实现”的纵深。只懂工具不懂业务,做出来的是功能;只懂业务不懂实现,提出来的是空想。
5.3 市场与管理双翼(Wings)
有了底座和核心,还需要两只翅膀把你带出去、把资源带回来。
- 市场翼(Marketing):对外的触角。宏观经济判断、行业趋势分析、客户需求洞察。它决定你的能力“卖给谁”以及“值多少钱”。能力再强,如果市场不知道、不需要,价值就兑不出来。
- 管理翼(Management):对内的控制。自我时间管理、项目管理、团队领导力。它决定你能“撬动”多少资源——一个人干是一个人的产出,带十个人干是十个人的产出,差别在这一翼。
一外一内,一个决定价值,一个决定规模。少了任何一翼,飞不起来。
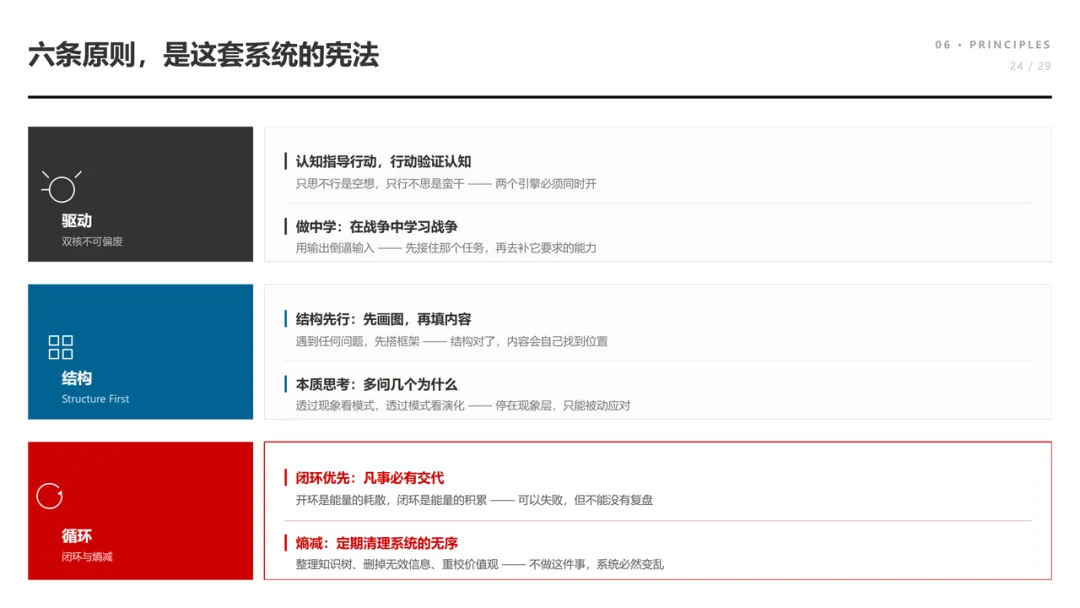
第六章 运行原则 —— 系统的宪法
前面五章是“零件”,这一章是“使用守则”。零件再好,用错了照样出事。
这六条原则不是建议,是约束——每一条背后都对应一种常见的失败方式。
1. 双核驱动不可偏废。 认知指导行动,行动验证认知。只思不行是空想,只行不思是蛮干。现实中的偏差往往很具体:想得多的人容易停在方案阶段,做得多的人容易在错误方向上勤奋。
2. 结构先行。 遇到任何问题,先画图,先搭框架。Structure First, Content Second。
为什么顺序不能反?因为内容会不断变,结构一旦对了,内容换多少遍都不散;结构不对,内容填得再满也是一团。先有骨架,再长肉。
3. 闭环优先。 凡事必有交代。可以失败,但不能没有复盘。开环是能量的耗散,闭环是能量的积累。
这句话可以当检验标准用:一件事做完,如果没有任何东西被沉淀下来(一个清单、一条原则、一段记录),那这件事就白做了。
4. 做中学(Learning by Doing)。 最好的学习是在战争中学习战争。用输出倒逼输入。
为什么输出倒逼有效?因为输出会立刻暴露你的漏洞——讲一遍、写一遍、做一遍,卡住的地方就是没懂的地方。光输入不会暴露任何东西,所以你永远以为自己懂了。
5. 本质思考。 永远多问几个“为什么”。透过现象看本质(Pattern),透过本质看演化(Evolution)。
这里有两层:第一层是往下钻,从个例钻到规律;第二层是往前看,从规律看出它会怎么变。只做第一层,你会成为一个解释者;两层都做,你才有机会成为预判者。
6. 熵减。 定期整理知识树,定期清理无效信息,定期复盘核心价值观。对抗系统的无序化。
这条最反人性,因为它不产出即时收益。但系统天然会趋向混乱——收藏夹越堆越乱,方法论越用越糊,目标越想越多。这些都不会自己变好,只能靠定期动手清一次。
结语:进化的螺旋
思维体系元模型不是一个静态的终点,而是一个动态的起点。
它更像一个活物。随着你每一次阅读、每一次实践、每一次复盘、每一次痛苦的思考,这个模型都在自我迭代、自我重构——你改它,它也改你。
这条路大致会经过三个阶段:
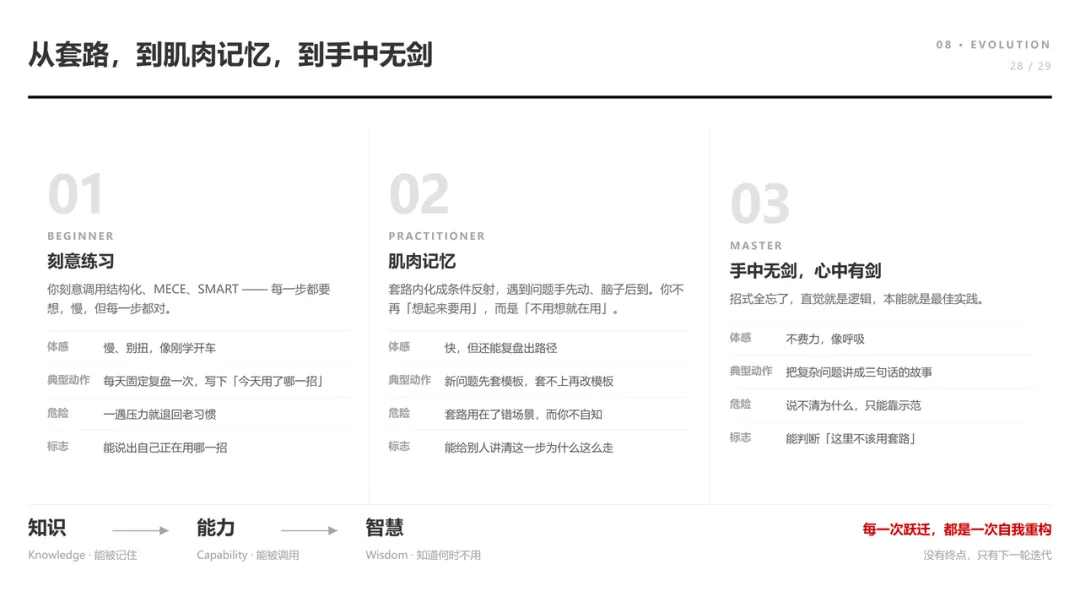
初级阶段,你在刻意练习这些套路:结构化、MECE、SMART。这个阶段很难受,因为每一步都要提醒自己“该拆了”“该量化了”“该复盘了”,效率甚至比原来更低。
中级阶段,这些套路变成了肌肉记忆。你开始能下意识地调用知识组件,遇到问题不用先想“我该用哪个模型”,而是反应已经自动走了那条路。
高级阶段,你忘记了所有的招式。“手中无剑,心中有剑”——你已经把整套操作系统内化了,你的直觉就是逻辑,你的本能就是最佳实践。
三个阶段看着像“学—熟—忘”,其实是同一个东西在不同深度上的显影。忘了招式,不是没有招式,是招式已经不需要被想起。
这就是从“知识”到“能力”,再到“智慧”的跃迁。
愿以此元模型,助你在不确定的世界中,构建确定的认知内核。
附录:深度案例分析(Appendix: Deep Case Studies)
理论只有落到具体场景里,才谈得上“被理解”。
下面三个案例,分别对应个人成长、技术排查和团队管理。读的时候可以留意一件事:每个案例的推进顺序,大多能和前面五章的顺序对上——先认知,再解决,靠知识管理支撑,最后改动能力架构。
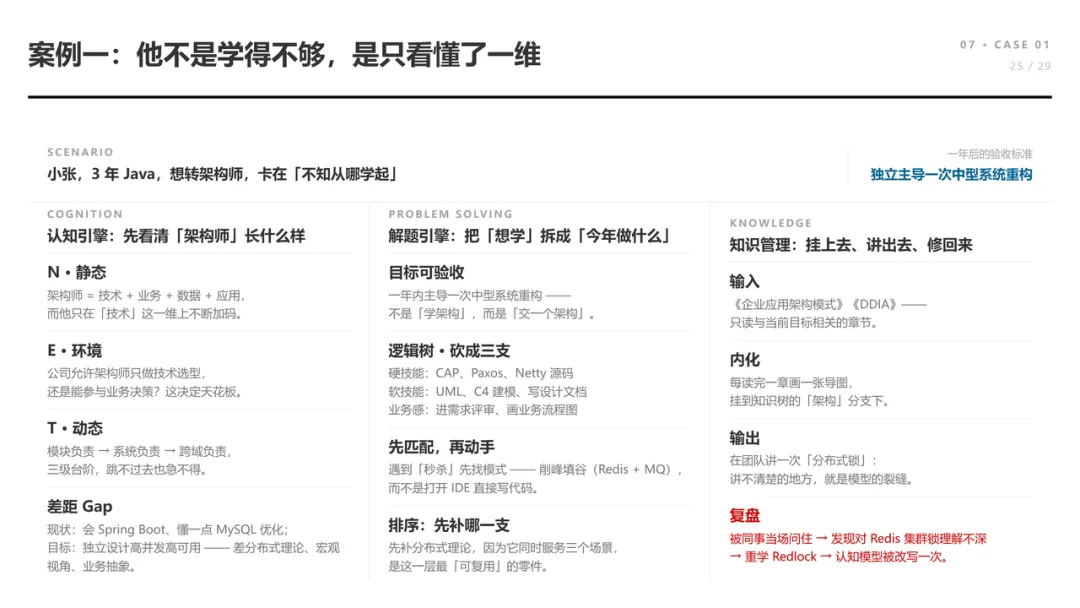
案例一:从程序员到架构师的认知升级
场景:小张是一名有 3 年经验的 Java 开发,目标是成为系统架构师,但很迷茫,不知道该从哪学起。
迷茫的典型来源,是他把“架构师”当成了一个更高版本的“程序员”——以为只要技术更深就可以了。这个假设本身就需要被检验。
1. 启动认知引擎(Cognition)
N+E+T 分析:
- N(静态):架构师的能力结构到底是什么?拆开看,不只是写代码(Tech),还包括业务拆解(Business)、数据建模(Data)和系统集成(App)。小张一对照就发现,自己这几年全押在 Tech 上,另外三个 A 几乎是空白。迷茫的根源找到了——不是不够努力,是努力全投在了一根柱子上。
- E(环境):公司这个环境允许架构师做什么?是只做纯技术选型,还是能参与业务决策?这一问决定了他成长的天花板在哪——如果公司里架构师只是“高级码农”,那在现有环境里再努力也长不出业务能力。
- T(动态):架构师的成长路径通常是:模块负责,到系统负责,再到跨域负责。这一步给出了时间表——他现在在第 0 级,需要先拿到“模块负责”的机会。
差距分析(Gap Analysis):
- 现状:熟练使用 Spring Boot,懂一点 MySQL 优化。
- 目标:能够独立设计高并发、高可用系统。
- Gap:缺乏分布式理论、缺乏宏观视角、缺乏业务抽象能力。
三个缺口,性质完全不同:第一个靠学,第二个靠练,第三个靠在环境里争取机会。混在一起谈“我要提升”,就会一直停在焦虑里。
2. 启动问题解决引擎(Problem Solving)
- 目标设定:1 年内主导一个中型系统的重构。这个目标过了 SMART——有具体对象(中型系统)、有可验证成果(主导重构)、有时限(1 年)。
- 结构化分解(Logic Tree):
- 提升硬技能:深入学习 CAP 定理、Paxos 算法、Netty 源码。这三样分别对应分布式的一致性、共识和通信,正好补“分布式理论”这个缺口。
- 提升软技能:学习画图(UML、C4 模型),学习写设计文档。这是架构师的“输出语言”——方案想得再好,画不出来、写不清楚,就推动不了。
- 提升业务感:参与产品需求评审,尝试画业务流程图。这一步是补“业务抽象能力”,只能在真实场景里练。
- 执行与反馈:
- 模式匹配:遇到新需求时,不再直接写代码,而是先在大脑中搜索“类似场景的设计模式”。比如遇到“秒杀”,直接匹配到“削峰填谷”模式——用 Redis 顶住瞬时流量,用 MQ 把请求排队削平,让后端按自己的节奏处理。
这个动作的转变很关键:从“我要实现它”变成“这属于哪类问题”。前者每次都是新活,后者一次积累、长期复用。
3. 知识管理支持(Knowledge Mgmt)
- 输入:阅读《企业应用架构模式》和《DDIA》(《数据密集型应用系统设计》)。前者给模式,后者给底层原理。
- 内化:读完每一章,画出思维导图,挂到自己的“知识树”的“架构”分支下。这一步就是前面说的“挂载”——不做这一步,读完就忘。
- 输出:在团队内做一次“分布式锁”的技术分享。输出倒逼输入,讲不清楚的地方,就是没懂的地方。
- 复盘:分享时被同事问住了,发现自己对 Redis 集群模式下的锁安全性理解不深,于是修正认知模型,回头重学 Redlock 算法。
注意这个循环的形状:不是“学完就完”,而是“学、讲、被问住、再学”。被问住的那一下,才是真正的学习起点——它精确指出了模型上的漏洞。
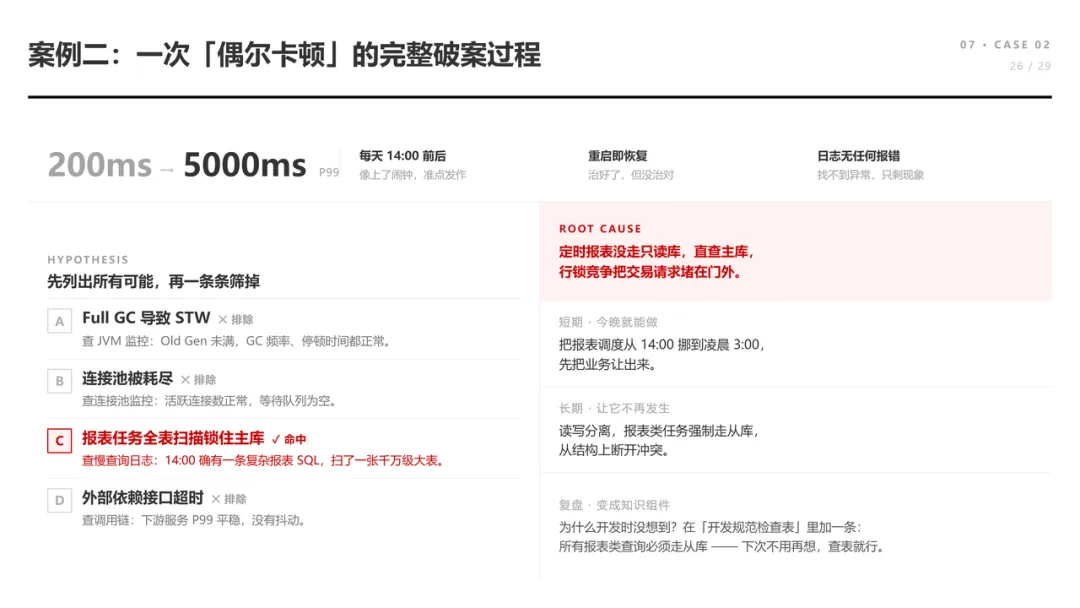
案例二:解决“系统偶尔卡顿”的复杂问题
场景:某核心交易系统每天下午 2 点左右出现间歇性响应超时,重启后恢复,日志里没有明显报错。
这个场景的难点不在技术,在“间歇性”三个字——它不可复现、没有明确报错,任何盲目的排查都是在浪费窗口期。
1. 定义问题(Define)
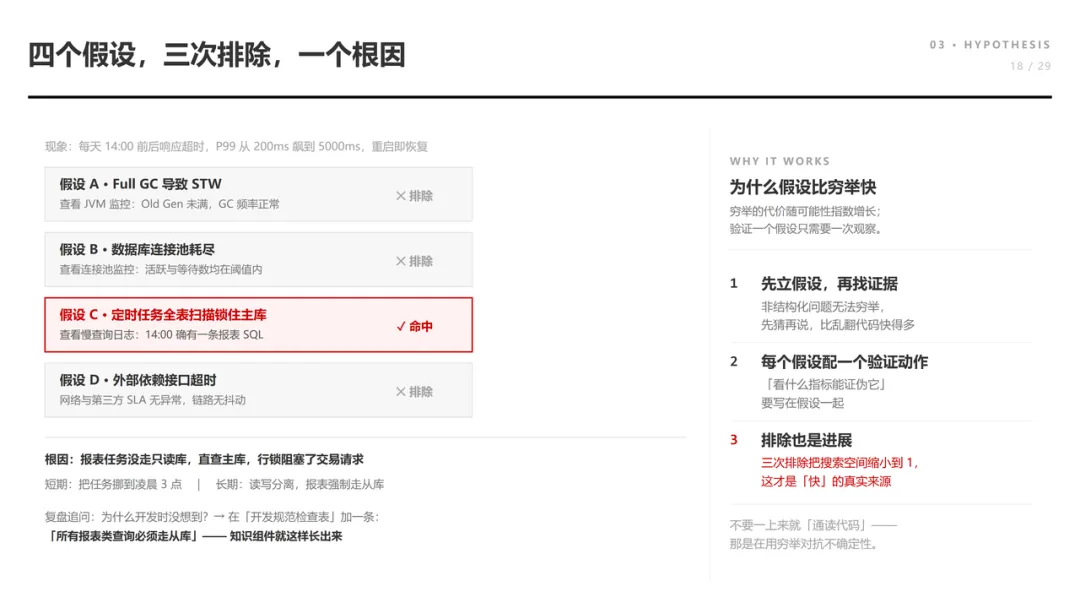
- 现象:P99 延迟从 200ms 飙升到 5000ms。(P99 指 100 个请求里最慢那一个的耗时——平均值会被大量快请求拉低,看不出问题,所以要看长尾。)
- 目标:这里要解决的问题不是“消除卡顿”,而是“找到根因并彻底解决”。
为什么要把目标说这么细?因为“消除卡顿”这个目标允许你重启、限流、加机器,问题被掩盖了,下次还会来;“找到根因”这个目标不允许,它逼你往下挖。
2. 结构化假设(Hypothesis Strategy)
用双核驱动,先铺开可能性,再逐个排除。
- 静态分析:系统架构是 Nginx 到 Tomcat 到 DB,中间还有 Redis。四个环节,每一环都可能是瓶颈。
- 动态分析:下午 2 点这个时间点发生了什么?是有定时任务?还是业务高峰?“固定时间出现”这个特征本身,就是一条极有价值的线索——它暗示存在某个周期性的触发源。
模式匹配,列出四个最可能的模式:
- 模式 A:Full GC 导致 STW(Stop The World,指垃圾回收时暂停所有业务线程)。
- 模式 B:数据库连接池耗尽。
- 模式 C:某张大表通过定时任务全表扫描,锁住了 DB。
- 模式 D:外部依赖接口超时(网络抖动)。
四个假设覆盖了四类完全不同的原因:JVM 层、连接层、数据库层、外部依赖层。
3. 验证与决策(Verification & Decision)
按“验证成本从低到高”排序,逐个排除:
- 验证 A:查看 JVM 监控。发现 Old Gen 并没有满,GC 频率也正常,于是排除。
- 验证 B:查看连接池监控。连接数正常,排除。
- 验证 C:查看 DB 慢查询日志。发现确实有一条复杂的报表 SQL,正好在 14:00 执行。
确认根因:定时报表任务没有走只读库,直接查了主库,导致行锁竞争,把交易请求阻塞住了。
回看整个过程,最有价值不是最后那个答案,而是中间“排除”掉的两个假设——每一步排除,都把搜索范围缩小一次,让下一步的查看更有针对性。如果没有假设,直接翻代码,可能三天都找不到这条 SQL。
4. 解决方案(Action)
- 短期:把报表任务的调度时间移到凌晨 3 点。先止血,让业务恢复正常。
- 长期:实施读写分离,报表任务强制走从库。从结构上消除这类冲突——报表查询本来就不该和交易抢同一个库。
- 复盘:为什么开发时没想到?于是知识组件更新:在“开发规范检查表”里增加一条——“所有报表类查询必须走从库”。
请注意最后这一步。如果只做修复不做复盘,这个问题会在下一个项目里重演;做完复盘,它变成了组织的一个组件,从此不会再犯。这就是闭环和开环的差别。
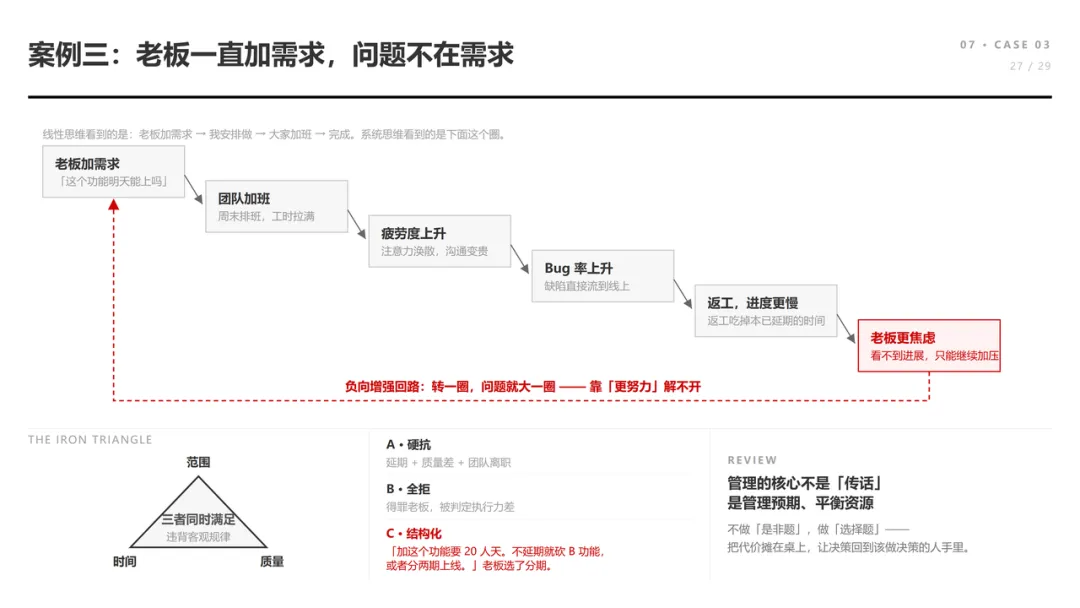
案例三:新晋管理者的困局 —— 范围蔓延(Scope Creep)
场景:老王刚升任项目经理,负责一个 App 开发。老板不断加需求,开发团队怨声载道,项目面临延期风险。
1. 系统思维(System Thinking)
老王原来的思路是线性的:老板加需求,我安排做,大家加班,完成。每一步看起来都对,问题是这条线不会自己停下来。
他忽略的是系统的反馈回路:加需求,导致加班;加班导致疲劳度上升,Bug 率增加;Bug 增加导致返工,进度更慢;进度更慢让老板更焦虑,于是加更多需求。
这是一条典型的负向增强回路——每一环都在放大下一环,而老王站在其中一环上,用“再努力一点”去对抗一个自我加速的系统。
2. 辩证思维与多维平衡
矛盾落在三个变量上:范围(Scope)、时间(Time)、质量(Quality)。这就是项目管理里著名的“不可能三角”——三者最多同时保住两个。
老王试图三个都要,这就违背了客观规律。他不是不努力,是在要求物理定律破例。
想清楚这一点,问题的性质就变了:不是“怎么把三样都做到”,而是“这次先牺牲哪一样,以及向谁明确这件事”。
3. 结构化决策(Decision)
三个方案摆开:
- 方案 A:硬抗。 结果是项目延期且质量差,团队离职。三样全丢,是最差解。
- 方案 B:拒绝所有需求。 结果是得罪老板,被认为执行力差。保住了项目,丢掉了信任。
- 方案 C:结构化处理。 不硬抗也不硬拒,把取舍摊到桌面上,让该做决定的人看见代价。
方案 C 具体做两件事。
第一件是量化影响。对老板说:“加这个功能,需要 20 人天。如果不延期,需要砍掉 B 功能;或者我们可以分二期上线。”——先把代价换算成老板能听懂的单位(人天、上线时间),再把隐含的取舍显式化。多数时候不是老板不讲理,是没人把账算给他看。
第二件是提供选项。不做“是非题”,做“选择题”。是非题只有一个答案(行或不行),选择题把决策权交回去,同时把代价一并交回去。
结果是老板选择了“分期上线”。
这个结果值得琢磨:需求没有减少,工期没有延长,团队没有加班,但问题解决了。变的只是沟通方式——从“我扛不住”变成“这是三个选项,你选一个”。
复盘:管理的核心不是“传话”,而是“管理预期”和“平衡资源”。老王在自己的能力架构“管理翼”里,加了一项核心技能——向上管理。向上管理不是讨好上级,而是主动管理上级的预期和信息输入。老王之前真正的问题,是让老板在信息不全的情况下做决策。
通过这三个案例可以看到,无论是个人成长、技术除障还是项目管理,思维体系元模型提供的都是同一套底层逻辑:先把问题看清楚(认知),再把路径拆出来(解决),把过程沉淀成组件(知识),最后把能力补到位(架构)。
这套东西不能让你少走弯路——弯路是必须走的。它能做的是:让每一次弯路都留下东西,而不是走完之后,原地不动。
完整ppt参考如下:
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
图片
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号