# 10 分钟会议录音分不清谁在说话?固定阈值 VAD 把 160 秒噪声当人声,三步治理做到 99.28% #WorkBuddy#
原创
# 10 分钟会议录音分不清谁在说话?固定阈值 VAD 把 160 秒噪声当人声,三步治理做到 99.28% #WorkBuddy#
原创
用户12784192
发布于 2026-11-15 10:42:56
发布于 2026-11-15 10:42:56
10 分钟会议录音分不清谁在说话?固定阈值 VAD 把 160 秒噪声当人声,三步治理做到 99.28% #WorkBuddy
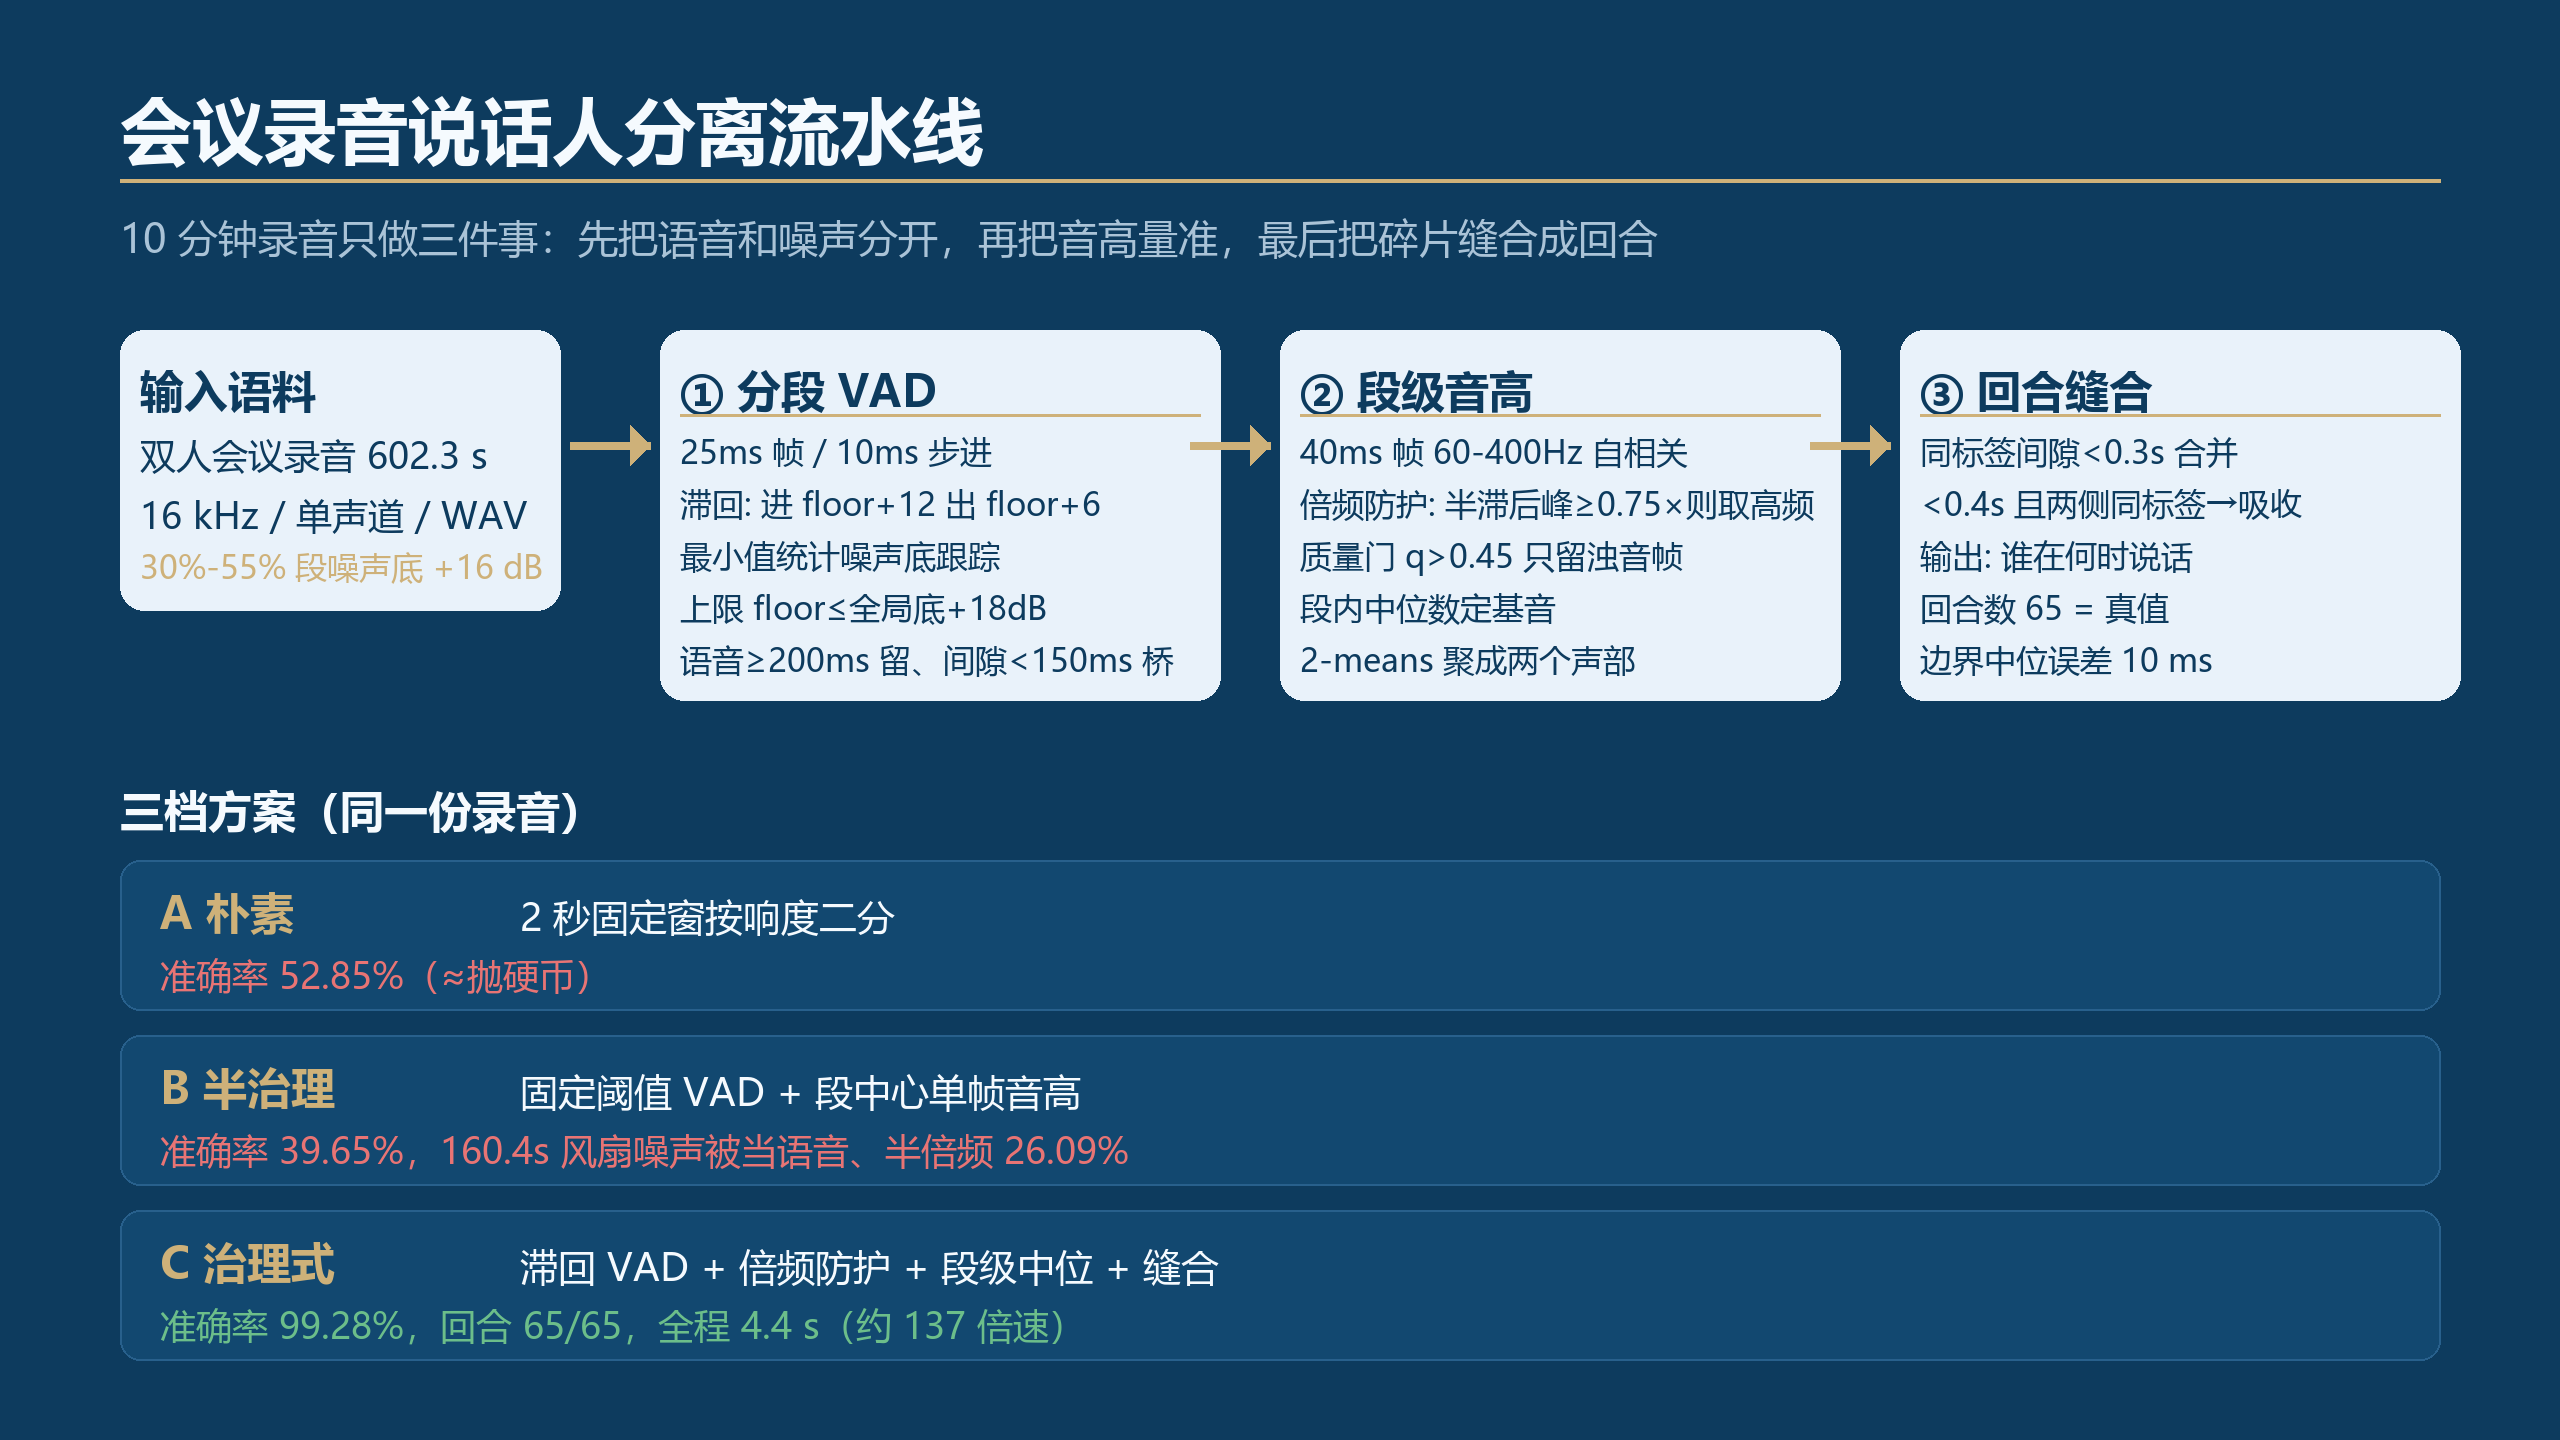
说话人分离流水线:VAD 分段 → 段级音高 → 回合缝合
一、痛点开场
老板甩来一段 10 分钟的双人会议录音,要求:"把谁在什么时间说了话整理出来,一条都不能错。"这是语音转写、会议纪要、访谈整理的前置工序,业内叫说话人分离(Speaker Diarization)。听起来像深度学习的活儿,但很多场景里根本没有 GPU,也不值得为一段录音拉模型服务——用 Python 标准库加 NumPy,几百行代码就能做到 99% 以上。前提是:你得躲开三颗雷。
我做了一个可复现的对照实验:先用脚本合成一段 602.3 秒、16 kHz 的双人会议录音(seed=20261115,两位说话人基频分别约 112 Hz 和 218 Hz,其中 30%-55% 段模拟空调启动、噪声底抬升 16 dB,中间穿插 0.35-0.6 秒的短应答),真值是 78 个语义回合(帧级标签共 65 次说话人切换)。然后分别用"朴素""半治理""治理式"三种写法跑同一份录音,所有数字都是真实跑出来的,脚本见文末。
二、根因分析:三颗雷埋在哪里
雷 1:固定阈值 VAD 在变化的噪声底面前是瞎的。 最常见的写法是取全文件能量 5 分位数再加 14 dB 当阈值。录音前段安静没问题;可一旦中间出现空调、风扇、投影仪,噪声底抬升 16 dB,整段高于阈值——结果我的实验里出现了 160.4 秒的"巨段":160 秒的风扇噪声被当成"一个人说了 160 秒话",段内 6777 帧 B 的语音全部跟错人。VAD 是整条流水线的地板:地板歪了,后面的音高聚类再准也白搭。
雷 2:单帧音高的半倍频错误。 判断一段声音属于男声还是女声,最简单的是自相关法找基频。但对谐波丰富的语音,滞后 2T 处的自相关峰几乎和 T 处一样高,全局取最大峰就会把 218 Hz 的女声读成 109 Hz 的"男声"。我的实验里,B 档对真值为女声的段,半倍频错误率 26.09%——近三分之一的段直接归错了人。
雷 3:逐样本噪声摧毁自相关。 这颗雷埋在语料合成里,但它同样是真实录音的特征:如果基频抖动是逐样本的白噪声,相位随机行走会让 2T 滞后处的相关性被抹平——任何基于长滞后的算法都会失效。真实人声的抖动是低频慢变的,建模时用 8 Hz 平滑插值才对。
三、真实数据对比
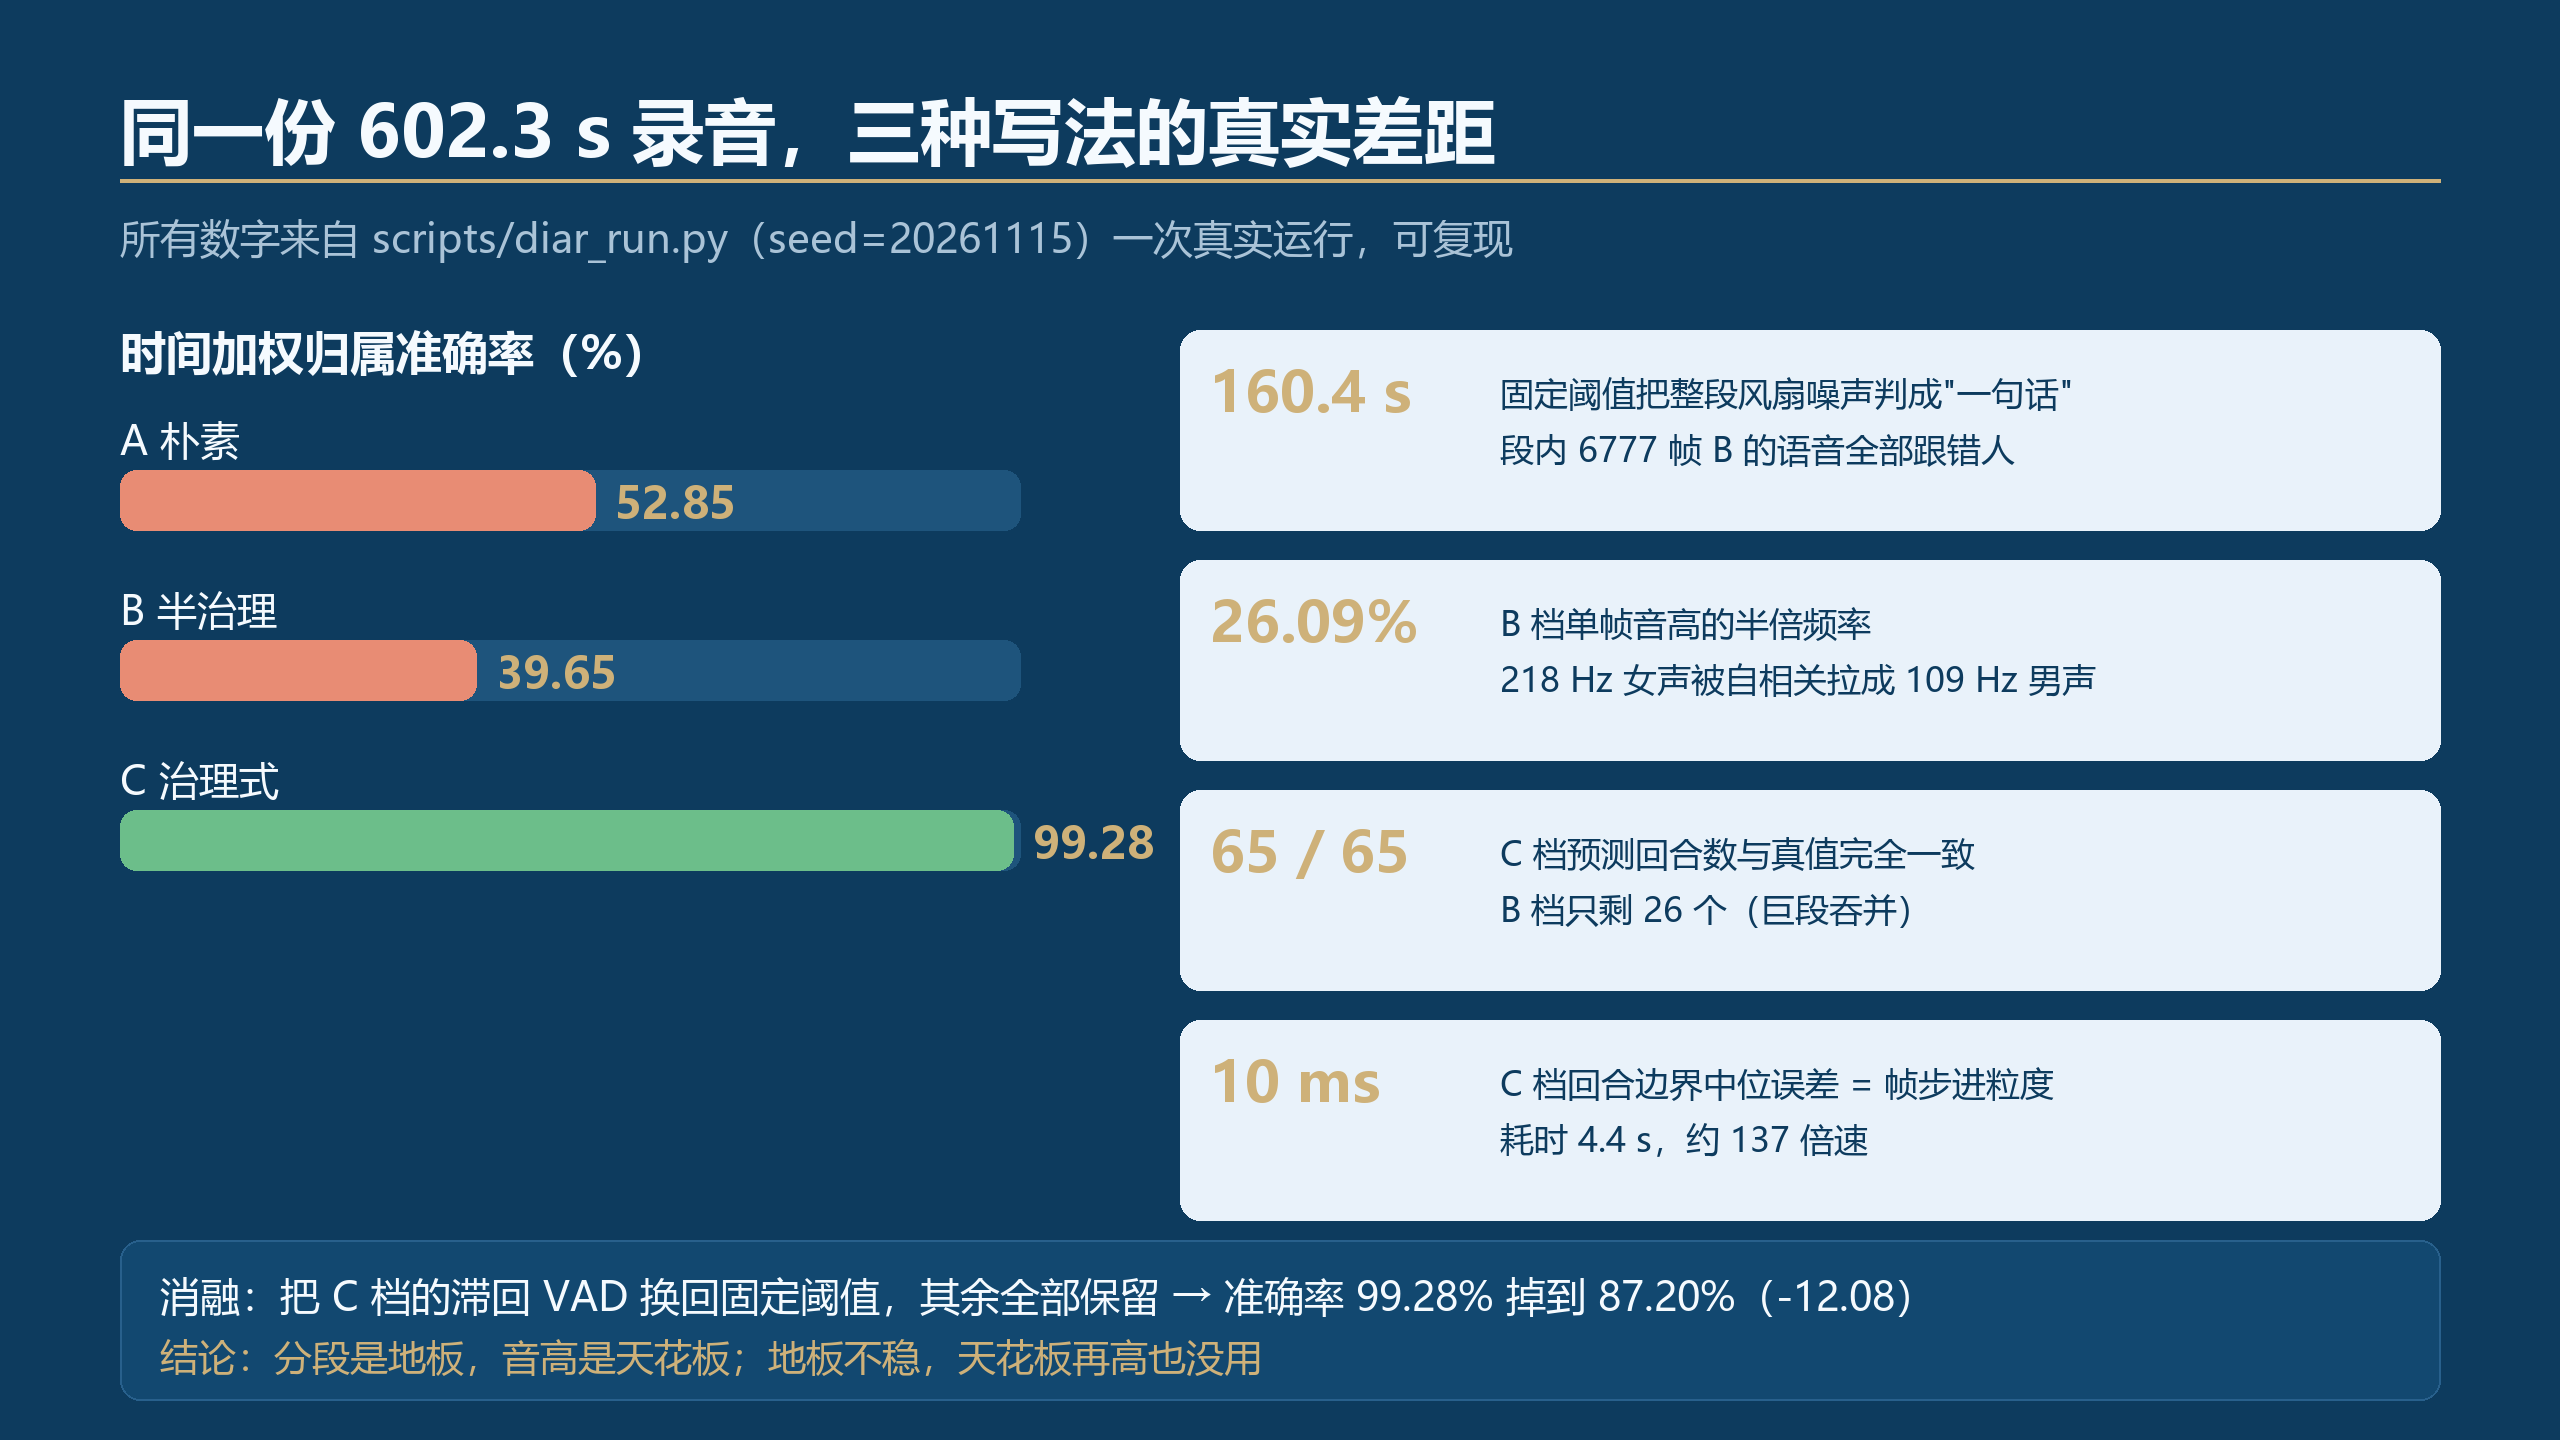
三种写法在同一份录音上的真实差距
三种写法,同一份录音(完整指标见 outputs/diar_result.json):
方案 | 写法 | 准确率 | 语音覆盖率 | 预测回合数 | 耗时 |
|---|---|---|---|---|---|
A 朴素 | 2 秒固定窗按响度二分 | 52.85% | 100% | 5 | 0.12 s |
B 半治理 | 固定阈值 VAD + 段中心单帧音高 | 39.65% | 55.4% | 26 | 0.01 s |
C 治理式 | 滞回 VAD + 倍频防护 + 段级中位 + 缝合 | 99.28% | 99.46% | 65(=真值) | 4.44 s |
几个值得展开的细节:
- B 档比 A 档还差。因为 B 档的 VAD 制造了 160.4 秒巨段(段中点恰好落在噪声上,音高无效 → 整段不标注,覆盖率掉到 55.4%),标注了的部分又被半倍频错误污染。这提醒我们:局部正确的模块拼在一起,全局可能更糟。
- 消融实验:把 C 档的滞回 VAD 换回固定阈值(其余全部保留),准确率从 99.28% 掉到 87.20%(-12.08)——分段质量吃掉了 12 个百分点。
- C 档的回合边界中位误差 10 ms,就是 10ms 帧步进的粒度本身;4.44 秒处理 10 分钟录音,约 137 倍速。
- C 档对真值为女声的段,误判为男声的帧数为 0(混淆矩阵
gt_B_pred_A = 0)。
四、可复制代码(核心 80 行)
语料与完整实验在 scripts/diar_run.py(一次运行产出全部数字),这里给治理式的三个核心函数骨架:
import numpy as np

FS = 16000
FRAME, HOP = 400, 160          # 25ms 窗 / 10ms 步进
LAG_MIN, LAG_MAX = FS//400, FS//60   # 60-400 Hz

def energy_db_frames(audio):
    nfr = (len(audio) - FRAME) // HOP
    idx = np.arange(nfr)[:, None] * HOP + np.arange(FRAME)[None, :]
    e = 20 * np.log10(np.sqrt((audio[idx] ** 2).mean(axis=1)) + 1e-12)
    return e

def vad_hysteresis(e_db):
    """治理式 VAD:最小值统计噪声底跟踪(带上限) + 滞回 + 最小时长"""
    n = len(e_db)
    cap = float(np.percentile(e_db, 5)) + 18.0    # 噪声底上限:全局底 +18dB
    floor = np.empty(n); f = e_db[0]
    for i in range(n):
        f = min(e_db[i], f + 0.05, cap)           # 回升限速 5dB/s
        floor[i] = f
    enter, exit_ = floor + 12.0, floor + 6.0      # 滞回双阈值
    state = np.zeros(n, bool); on = False
    for i in range(n):
        if not on and e_db[i] > enter[i]: on = True
        elif on and e_db[i] < exit_[i]: on = False
        state[i] = on
    # 语音<200ms 丢弃、间隙<150ms 桥接(略)
    return state

def pitch_guarded(x):
    """带倍频防护的自相关基频"""
    n = len(x); x = x - x.mean()
    fs = 1 << (2*n - 1).bit_length()
    X = np.fft.rfft(x, fs)
    ac = np.fft.irfft(X * np.conj(X), fs)[:n]; ac /= ac[0] + 1e-12
    seg = ac[LAG_MIN:LAG_MAX]
    peaks = [(seg[i], i + LAG_MIN) for i in range(1, len(seg)-1)
             if seg[i] > seg[i-1] and seg[i] >= seg[i+1] and seg[i] > 0.3]
    if not peaks: return None, 0.0
    c, lag = max(peaks)
    half = lag // 2                                # 倍频防护:半滞后处若同样有峰
    if half >= LAG_MIN and ac[half-1:half+2].max() >= 0.75 * c:
        return FS / half, float(ac[half-1:half+2].max())
    return FS / lag, c
段级分类与缝合的逻辑很短:每个 VAD 段内取浊音帧(质量 q>0.45)基音的中位数,对全部段的中位数做 2-means 分成两个声部;同标签且间隙小于 0.3 秒的段合并,长度小于 0.4 秒且两侧同标签的段吸收。中位数是保险丝——即使个别帧仍出现半倍频,也翻不动段级的中位数,这就是 C 档对女声误判为 0 帧的原因。
五、踩坑清单
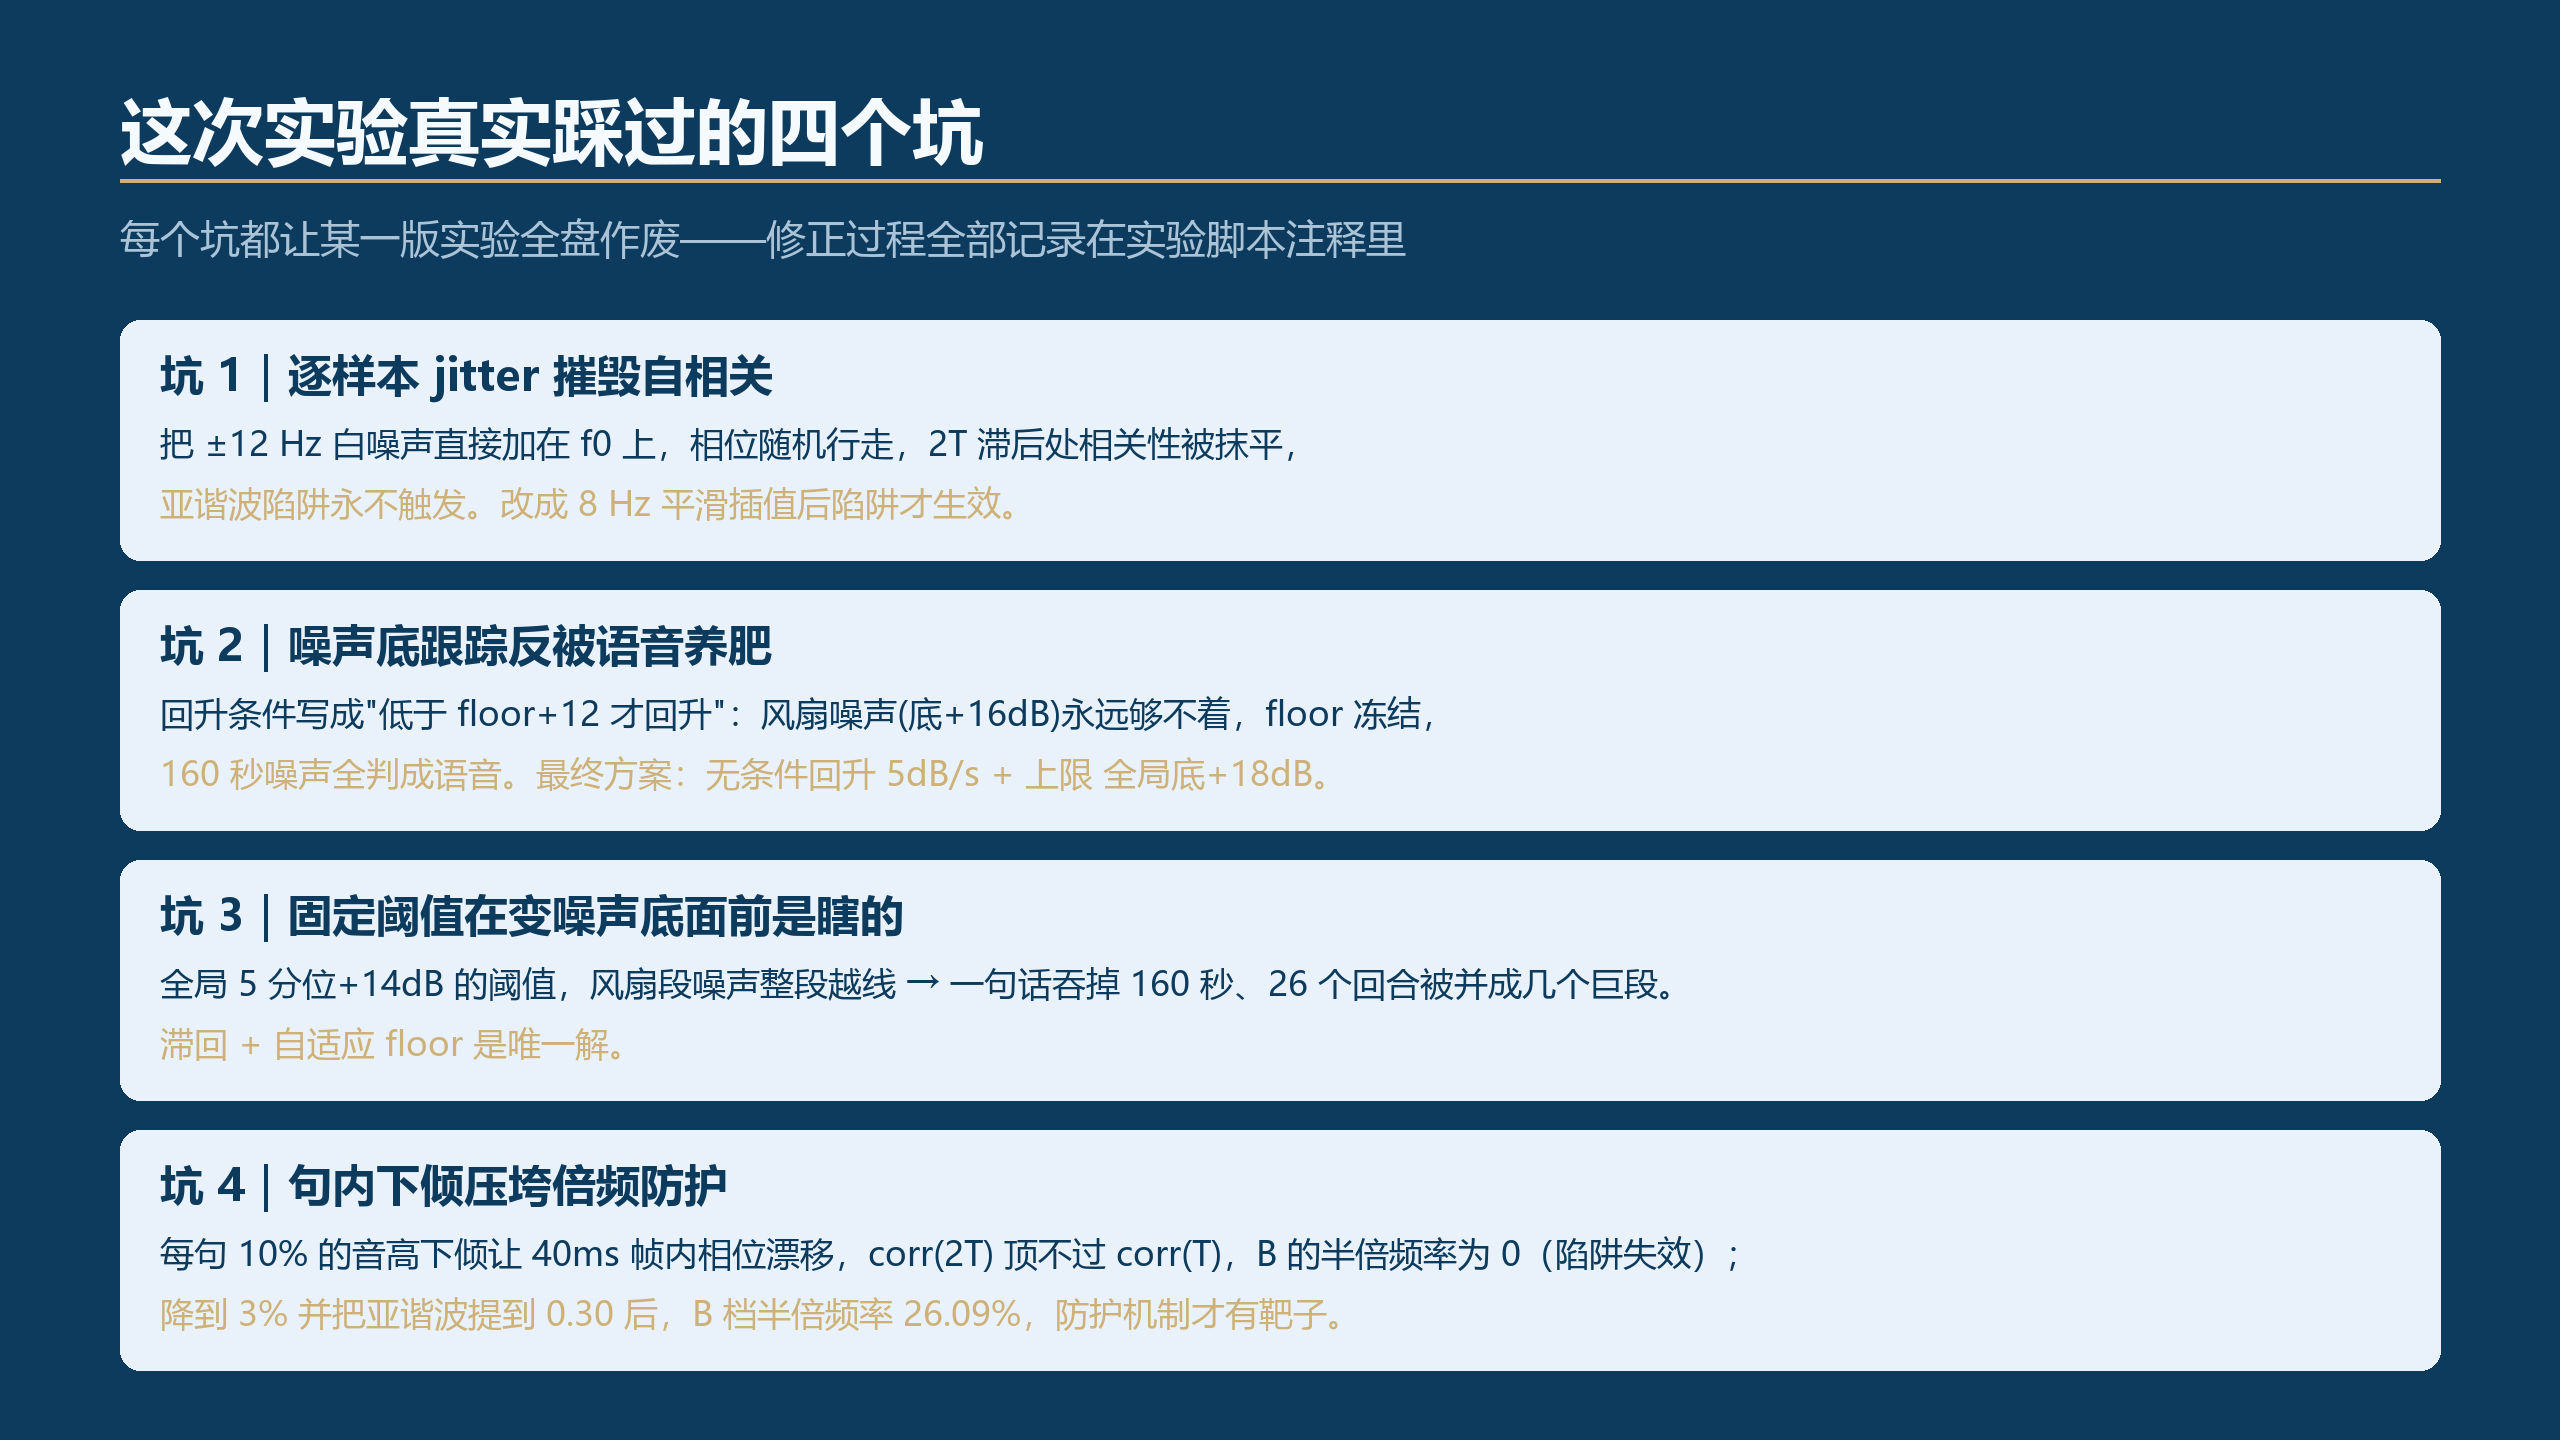
这次实验真实踩过的四个坑
这次实验改了四版才收敛,每个坑都让前一版全盘作废:
- 逐样本 jitter 是隐形杀手。 语料第一版把 ±12 Hz 白噪声直接加在 f0 上,自相关在 2T 处失相关,倍频陷阱永不触发,半倍频错误率为 0——不是算法好,是靶子不存在。改成 8 Hz 平滑插值后才复现真实攻击面。
- 噪声底跟踪会被语音"养肥"。 回升条件写成"低于 floor+12 dB 才回升"时,风扇噪声(底+16dB)永远够不着条件,floor 冻结在录音开头水平,160 秒噪声全判成语音。最终方案是无条件回升 5 dB/s + 上限"全局底+18dB":语音比噪声底高 30 dB 以上不会被跟踪,噪声抬升能在 3-4 秒内被追上。
- 固定阈值+变噪声底 = 巨段吞并。 全局阈值在风扇段整段越线,26 个真值回合被并成几个巨段,回合数从 65 塌到 26。B 档准确率 39.65% 比 A 档瞎猜的 52.85% 还低,根因在此。
- 句内音高下倾压垮倍频防护。 每句 10% 的下倾让 40 ms 帧内相位漂移,corr(2T) 顶不过 corr(T),陷阱失效;把下倾降到 3%、亚谐波提到 0.30 后,B 档半倍频率 26.09%,防护机制才有靶子可打。
六、给 WorkBuddy 的提示词模板
这类"音频结构化"任务可以直接丢给 WorkBuddy 执行,模板如下(引用块内可直接复制):
请对本地文件 <音频路径> 做说话人分离:① 用 25ms 帧/10ms 步进计算能量,VAD 用最小值统计噪声底跟踪(回升 5dB/s、上限全局底+18dB)加滞回(进 floor+12dB、出 floor+6dB),语音最短 200ms、间隙小于 150ms 桥接;② 每个 VAD 段内用自相关法提取基音(60-400Hz,带半滞后倍频防护,质量门 0.45),取浊音帧中位数,对段级中位数做 2-means 聚成 N 个声部;③ 同标签间隙<0.3s 合并、<0.4s 且两侧同标签的段吸收,输出"谁在何时说话"的回合表和带说话人标签的对话文本;④ 产出复现脚本和指标 JSON,标注所有阈值参数。不依赖 GPU 和外部模型服务。
七、收尾
分段是地板,音高是天花板;地板不稳,天花板再高也没用。 这次实验里,决定成败的不是什么深度模型,而是三个朴素的设计:噪声底要跟踪且带上限、阈值要滞回、基音要段级中位数加倍频防护。400 行纯 NumPy,10 分钟录音 4.4 秒跑完,99.28% 的归属准确率、65/65 的回合数、10 毫秒的边界误差——会议纪要、访谈整理、录音归档这类任务,本地流水线完全够用。完整的可复现脚本、合成语料生成器和全部指标 JSON 都在文末仓库路径里,seed 固定,跑一次验证一次。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号