一份 30 页的 PDF 怎么喂给 AI 才不浪费积分:先把「目录 + 页码」做出来
原创
一份 30 页的 PDF 怎么喂给 AI 才不浪费积分:先把「目录 + 页码」做出来
原创
用户12877835
发布于 2026-11-16 09:51:11
发布于 2026-11-16 09:51:11
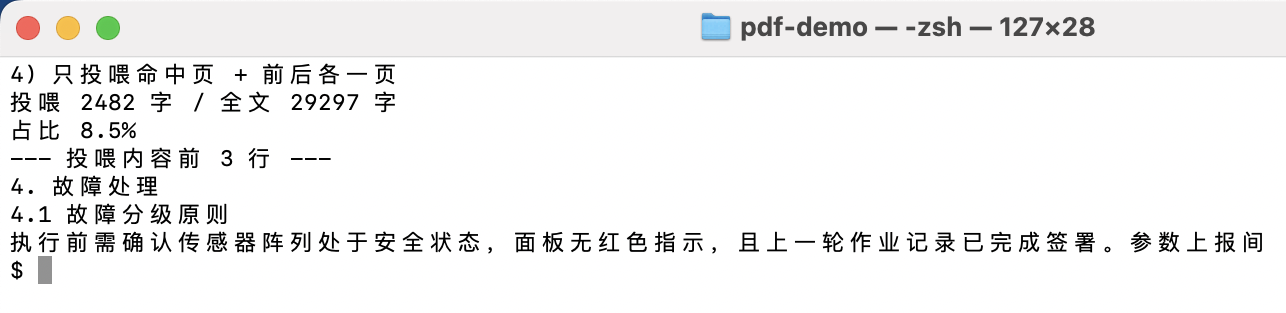
把一份长 PDF 直接拖进对话,看起来是最省事的做法,实际上是最贵的那种省事。我这周拿一份 30 页的设备运维手册完整试了一遍:全量抽成纯文本是 29297 字,而回答一个具体问题实际只需要 2482 字,占比 8.5%。省下来的不是钱,是"上下文还能装多少别的东西"。
下面整套流程在本地可复现,命令、脚本、每一步的真实输出都贴出来,数据都是跑出来的,不是估的。
一、先算清楚"全量投喂"到底有多贵
很多人对长文档的成本没有量感,先量化一次。把 PDF 抽成纯文本,看它到底多大:
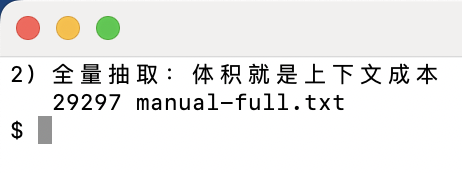
这 29297 字意味着什么:
- 它会被每一轮对话重复带上,不是只算一次。问三个追问,成本大致乘三。
- PDF 里的图片、矢量图在抽取时还要额外解析,扫描件更夸张,要先走 OCR。
- 这里面与当前问题真正相关的,通常不到一成。剩下九成是纯粹的噪声——而噪声不只是花钱,还会稀释模型的注意力。
所以问题不是"能不能喂进去",而是"为什么要把 90% 无关内容也喂进去"。
二、第一步不是抽正文,而是拿结构
拿到一个陌生长文档,先要目录,不要正文。这一步用结构抽取,比直接抽文本更有用,因为它带页码:
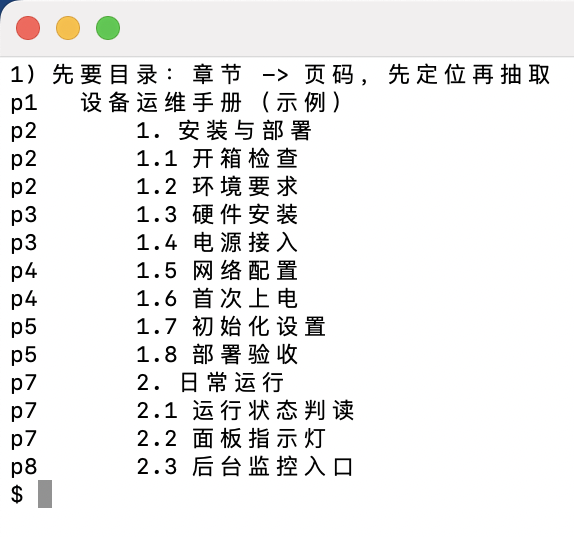
看到 p7 是第 2 章、p17 是第 4 章,你对"该翻哪里"就有判断了。这份手册最后拿到 55 个可定位标题,覆盖 30 个排版区块。
这里有个容易被忽略的点:页码是从结构信息里读出来的,不依赖文档本身印不印页码。很多内部手册、导出的报告正文根本没有页脚,这一步照样能定位——因为每一段文字在 PDF 里都带着自己的坐标和所属页。
生成目录的脚本只有十几行,读结构 JSON,把标题层级和页码打出来:
#!/usr/bin/env python3
import json, sys

data = json.load(open(sys.argv[1] if len(sys.argv) > 1 else "struct.json"))
for sec in data.get("sections", []):
    for b in sec.get("blocks", []):
        if b.get("role") != "heading":
            continue
        lvl = b.get("heading_level", 9)
        if lvl > 3:
            continue
        page = b.get("source", {}).get("page")
        page = (page + 1) if isinstance(page, int) else "?"
print(f"p{page:<3} {' ' if lvl == 2 else ' ' if lvl == 3 else ''}{b.get('text','').strip()}")workbuddy-pdf manual.pdf struct.json -f structure -q
python3 outline.py struct.json | head -20三、切页 + 建页码索引:一次 1.2 秒
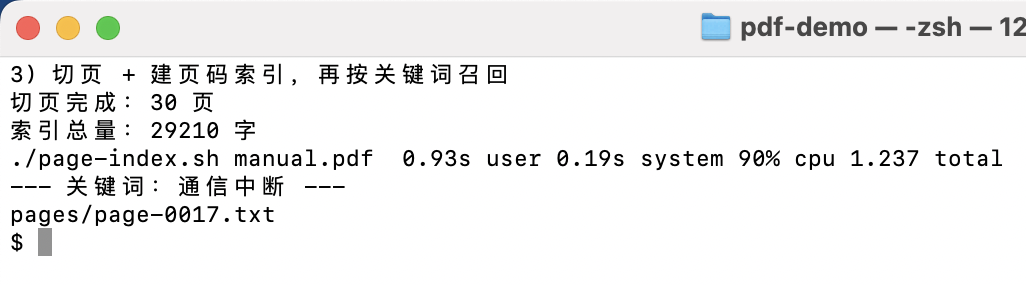
有了页码,还需要一个能把"关键词"变成"页码"的索引。做法很土但很有效:把整本切成单页,再逐页抽成 txt,页码就是文件名。
30 页切分加逐页抽取,总耗时 1.2 秒;索引总量 29210 字,比全量少了 87 字,差值是跨页重复的行。这点差异无关紧要,重要的是索引建好之后,定位就变成一条命令:
#!/bin/zsh
set -e
PDF="${1:-manual.pdf}"
OUT="pages"

[[ -d $OUT ]] || mkdir -p $OUT
workbuddy-pdf "$PDF" "$OUT" -f split -q
for f in $OUT/page-*.pdf; do
  workbuddy-pdf "$f" "${f%.pdf}.txt" -f txt -q
done

echo "切页完成:$(ls $OUT/*.pdf | wc -l | tr -d ' ') 页"
echo "索引总量:$(cat $OUT/*.txt | wc -m | tr -d ' ') 字"grep -l '通信中断' pages/*.txt # -> pages/page-0017.txt到这里,你已经可以用 grep 把任何问题映射到具体页码,成本是几秒钟。
四、定点投喂:命中页 ±1 页
只喂命中的那一页有个坑:章节标题常常出现在上一页末尾,处置步骤又经常跨到下一页。所以取命中页前后各一页,是最省事又不容易漏的粒度。
命中 p17,就投 p16–p18:
2482 字 / 29297 字 = 8.5%。同样的模型、同样的回答质量,输入小了一个数量级。而且这是每次提问都能省,不是省一次。
五、提示词要跟着一起"变小"
输入变小了,提示词反而要更严。因为范围一小,模型更容易"用常识补空白",而这正是答案失真的来源。我固定用这三条:
下面是一份手册第 16-18 页的抽取文本(共 2482 字)。

问题:通信中断的排查顺序是什么?

规则:
1. 只依据给定文本回答,不补充文本之外的知识;
2. 每个结论后用 p16 / p17 / p18 标注来源页;
3. 文本未覆盖的部分,直接写「未覆盖」,不要推测。这三条规则的价值在于自带校验:
- 回答里出现两处以上「未覆盖」,说明取的页太窄了,回第三步把命中页扩一圈;
- 回答里引用了不存在的页码,说明它在编,把第 1 条再收紧;
- 回答很长但信息密度低,说明你给的页太多,它可以随便挑。
这套闭环比"再问一遍让它别瞎猜"有用得多。
六、表格和扫描件:两条不同的路
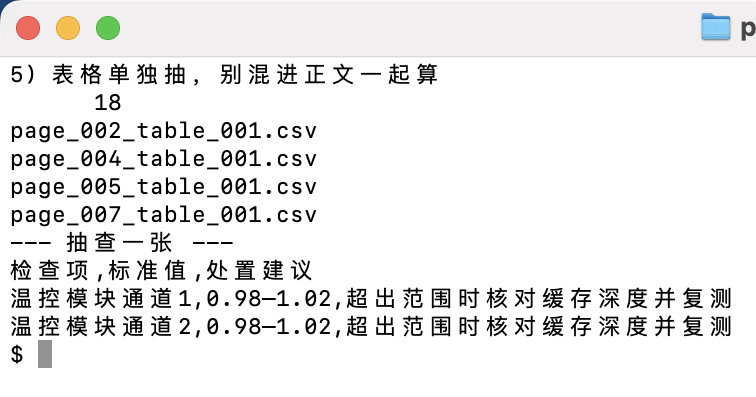
表格别混在正文里。 正文抽取时表格会被压成一行行文字,列关系就丢了。单独抽成 CSV,文件名自带页码,可以按需只取命中页的表:
18 张表一次导出,page_002_table_001.csv 这种命名让"第几页的哪张表"一目了然。要统计某个字段的分布,直接对 CSV 用 awk / pandas,比让模型从正文里捞数字可靠得多。
扫描件要认命。 没有文字层的 PDF,抽取会走 OCR,慢且容易错。这时候正确的做法是:只把命中页渲染成图片(-f png --dpi 200),别整本渲染。整本渲染 30 页再逐张识别,成本高一个量级,识别质量还更差。
只导出图片,不渲染整页。 要正文里的图,用 --image-dir 把图片单独写出来并保留在原位标记;这跟整页渲染是两件事,别混用。
七、什么情况下"全量"才是对的
前面说的都是省,但全量有时候是必须的,别把自己省进坑里:
你的问题 | 正确做法 | 原因 |
|---|---|---|
这本书/这份报告讲了什么 | 全量(或先目录再分章读) | 总结没有预设焦点,定点会漏掉主干 |
某个参数怎么调 | 定点,命中页 ±1 | 答案往往就在两三页里 |
两个章节的规定有没有冲突 | 两次定点,各取命中页 | 跨章节对比也不需要整本 |
要建长期知识库/索引 | 一次全量,落成文件 | 这是一次性投资,之后都查索引 |
要提取全文档的表格 | 全量 + 单独抽表 | 表格分布不可预测,漏一张就错 |
一句话判断:问"讲了什么"就全量,问"具体怎么弄"就定点。 前者花的是理解成本,后者花的是检索成本,两者不该混。
八、复现清单
按顺序跑,六步:
- 抽结构:
-f structure,用 outline.py 打出「章节 → 页码」。 - 量基线:
-f txt全量抽一次,记下字数。这是你的成本基线,也是后面对比的锚点。 - 建索引:
page-index.sh,切页 + 逐页 txt,页码即文件名。 - 召回定位:
grep -l '关键词' pages/*.txt,命中页前后各扩一页。 - 定点投喂:只贴命中片段 + 三条规则提示词(只依据文本 / 标页码 / 允许说未覆盖)。
- 按反馈调范围:数「未覆盖」出现次数。多了扩页,答案啰嗦了就减页。
最后留一个成本公式,随手估算用:
单次成本 ∝ 投喂字数
一轮对话成本 ≈ 投喂字数 × 轮数
省下的比例 = 1 - 命中页字数 / 全文字数
这份手册是 1 − 2482 / 29297 ≈ 91.5%。换成长一点的报告,这个比例只会更大——因为无关章节的增长速度,永远快过你真正要问的那几页。
把长 PDF 当数据库查,而不是当书读。目录是索引,页码是主键,grep 是查询条件。剩下的,交给模型做它真正擅长的那部分。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号