从查价到留证:基于元宝搜索的可部署采购成交信息工作台
原创
从查价到留证:基于元宝搜索的可部署采购成交信息工作台
原创
fanstuck
发布于 2026-11-16 11:17:28
发布于 2026-11-16 11:17:28
开源项目:GitHub · yuanbao-procurement-evidence。源码、启动步骤、实际页面截图和报告样例均在仓库中提供。
做采购相关工具时,我发现“历史成交价查询”这个需求,看起来像一个搜索框,落到实际工作却是一整段流程。
经办人员要先说清准备采购什么,再找其他项目的公告,判断是不是成交结果,确认金额属于整包、单项还是代理费,最后把网址和依据整理进材料。换一个人复核时,还得能够打开同一份来源,理解这个数字为什么被选进来。
此前,我已经做过一个预算诊断历史成交价查询 MVP。这次结合元宝搜索,我把其中的公告发现和证据核对环节整理成一个独立、可运行的 Web 项目,取名“采证”。它现在可以从前端提交任务,展示进度,查看金额依据,导出报告,并从历史记录重新打开结果。
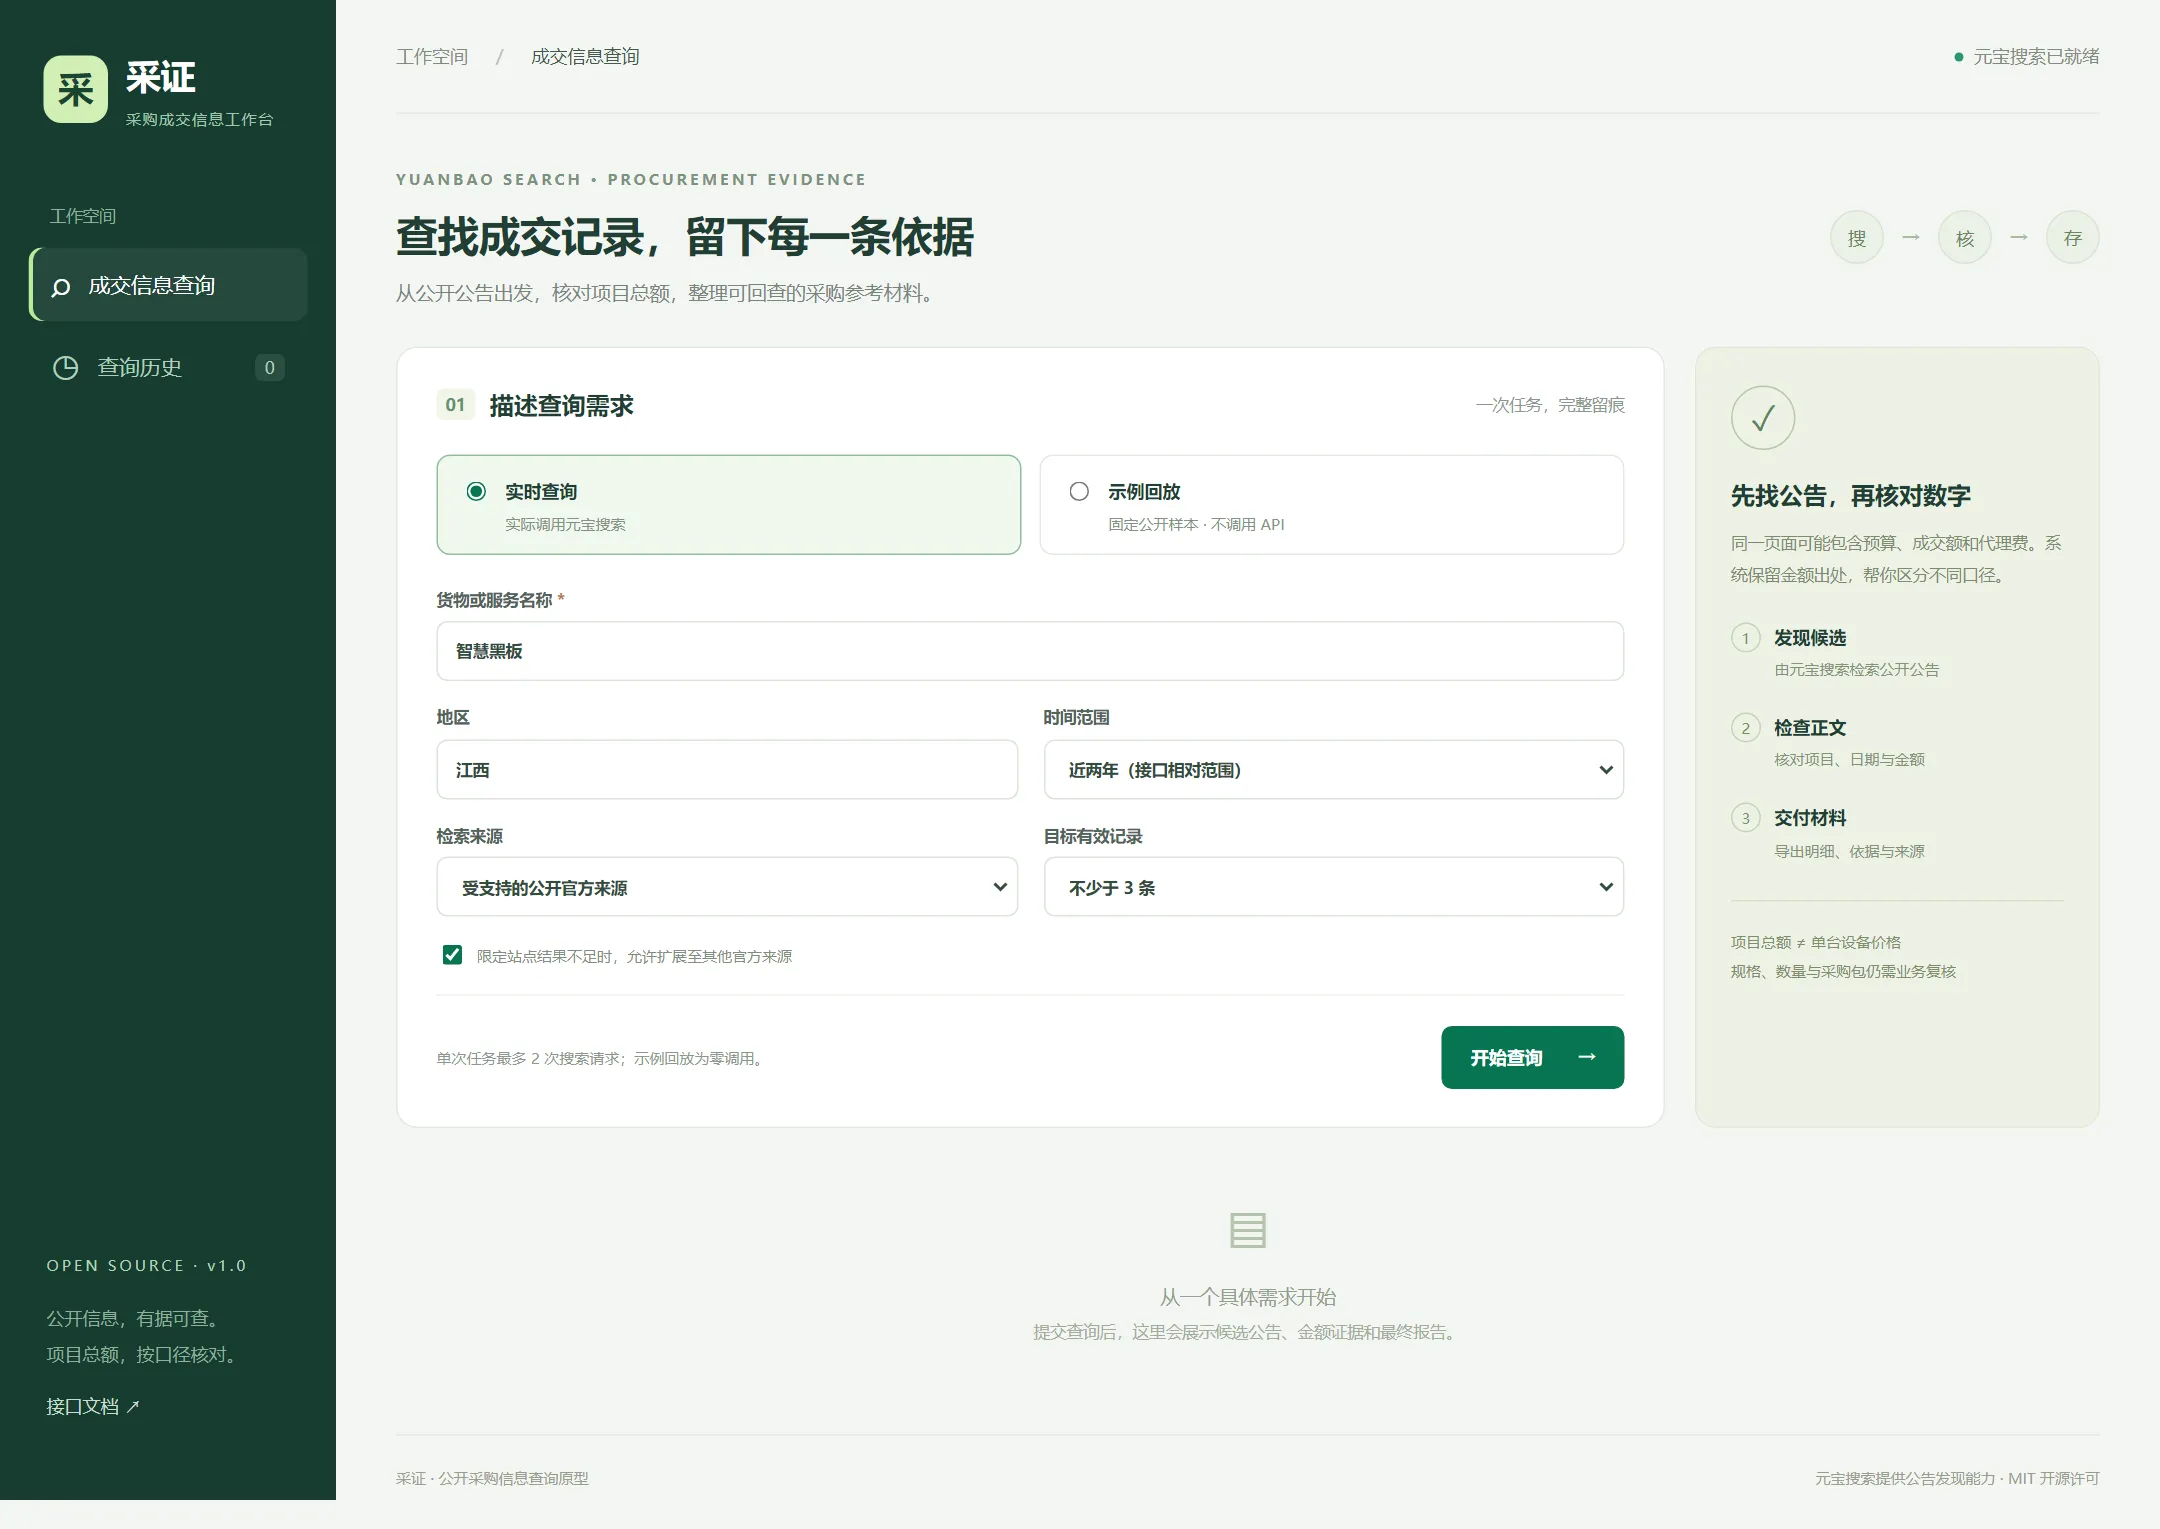
图 1:实际运行的系统首页。实时查询与示例回放分别标注,前端不配置服务密钥。
一、从旧项目的一条错误金额说起
旧原型面向预算编制、采购经办和复核人员。输入货物或服务名称后,程序查询公开交易平台,整理项目名称、金额、日期与来源,保存截图并导出报告。已有工程采用 FastAPI、站点适配器和 Playwright,具备基本查询与留痕能力。
整理历史材料时,我看到一份查询“智慧黑板”的报告,第一条记录把金额保存成了 721.74 元。
它对应“进贤县第二初级中学智慧黑板和机房设备采购项目(第二次)”。旧截图中,项目成交总额为 2,338,340.00 元,代理服务费为 29,721.74 元。本轮通过元宝搜索,又找到了中国政府采购网上的同项目公告,正文和概要能再次对应上这个成交总额。
旧代码的纯函数复现还揭示了一个具体问题:输入 1000元 会返回 000元,输入 100万元 得不到金额。原正则没有完整覆盖不带千分位的长数字和万元单位,也没有识别费用所属字段。
因此,这次改造需要分别处理三件事:找到合适公告、核对数字含义、保存判断依据。搜索接入解决的是公告发现;金额截断和代理费混淆,需要由业务代码另外修正。
二、系统服务谁,最后交付什么
采证围绕一次具体的信息收集任务设计。经办人员可以输入“智慧黑板、江西、近两年、至少三条有效记录”;系统返回候选及处理结果,并把可解释的证据交给复核人员。
使用环节 | 人员需要做的事 | 系统提供的结果 |
|---|---|---|
准备采购材料 | 查找同类项目的历史公开信息 | 项目名称、编号、公告日期和来源 |
检查金额 | 判断页面上的数字是不是成交总额 | 正文金额、概要换算值和证据片段 |
整理附件 | 把查询结果交给同事复核 | HTML 报告、CSV 明细和 JSON 记录 |
再次检查 | 找回上一次的条件和处理结果 | 持久化的历史任务与重新导出 |
了解异常 | 判断哪些记录还需要人工处理 | 原站访问、口径缺失和冲突原因 |
当前输出的核心口径是项目成交总额。它不会把“采购包数量为一”自动理解成“一台设备”,也不会在品牌、规格和服务内容不清楚时计算所谓合理采购单价。
这样做的实际意义,是把资料收集与初步检查形成可交接的材料。最终能否作为某个采购项目的参考,需要经办人员继续核对规格、数量、包件、安装维保和其他采购条件。
系统目前已经实现实时查询、固定回放、状态筛选、证据面板、任务历史和三种导出。它是单实例原型,还没有做多用户权限隔离、分布式任务队列或完整的公告版本关系。
三、为什么把元宝搜索放在公告发现环节
旧项目需要维护不同网站的检索参数、列表结构和 DOM 规则。对于一个范围有限的查询工具,这些适配工作很容易占据大量精力。部分页面可以搜到标题,正文却不一定能直接读取。
本次将元宝搜索用于运行时检索:用户提交需求之后,后端组织查询词,取得候选标题、链接和时间信息,再由原文读取与核验模块继续处理。
这里没有额外要求业务人员操作模型或编写提示词。输入框中的货物、地区、时间和来源条件,就是他们已有的工作语言。当前系统也没有调用生成式模型来补齐金额,缺失字段会保持待复核。
整体架构如下:
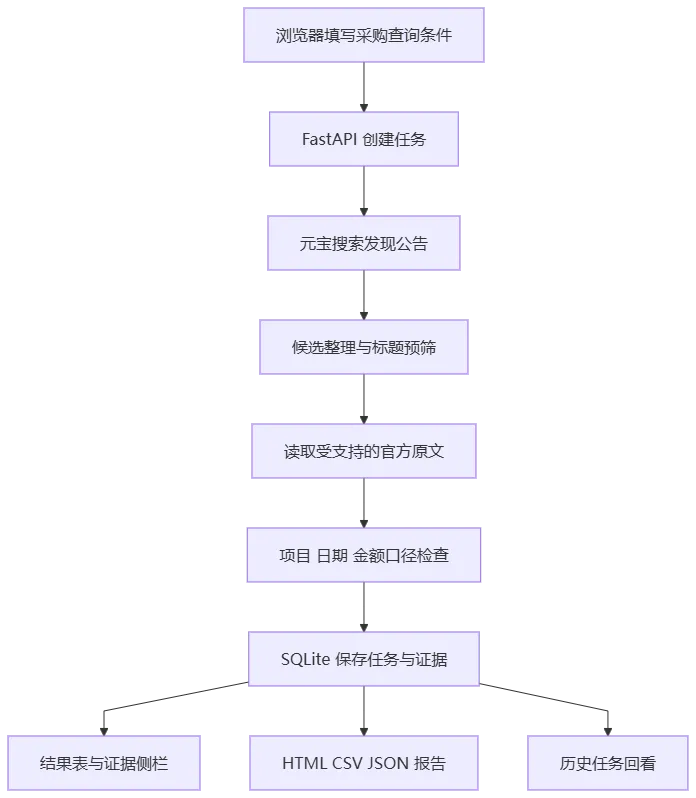
我选择 FastAPI 加原生 HTML、CSS、JavaScript,前后端由同一个服务提供,避免为这次原型额外增加构建链。SQLite 负责保存任务,读取到的网页快照写入本地数据目录。运行者不需要另外准备 MySQL 或 Redis,就能完成单用户演示。
从前端到搜索接口之间的职责也很清楚:浏览器只调用本项目后端;元宝搜索的服务密钥保留在后端;业务人员看到的是任务和证据,不需要接触认证配置。
四、从源码到打开页面
4.1 本地启动
项目源码包含以下主要目录:
yuanbao-procurement/
├── app/                  接口、任务、检索、核验、存储和导出
├── static/               前端页面、样式与交互
├── fixtures/             不含联系人信息的固定示例摘录
├── tests/                不调用真实 API 的自动化测试
├── docs/                 架构、接口和验证说明
├── examples/             实际任务导出的示例报告
├── requirements.txt      固定版本依赖
├── run.ps1               Windows 启动脚本
├── Dockerfile
├── compose.yaml
└── LICENSE               MIT
本地使用 Python 3.12,在项目目录执行:
git clone https://github.com/Fanstuck/yuanbao-procurement-evidence.git
cd yuanbao-procurement-evidence
python -m venv .venv
# Windows 激活:.venv\Scripts\activate
# Linux/macOS 激活:source .venv/bin/activate
pip install -r requirements.txt
python -m uvicorn app.main:app --host 127.0.0.1 --port 8000 --workers 1
打开 http://127.0.0.1:8000 即可看到页面。前端没有 npm 安装或单独构建步骤。Windows 还可以运行 pwsh -File .\run.ps1,由脚本创建项目内虚拟环境、安装依赖并启动服务。
4.2 配置真实搜索
本次采用元宝搜索的服务 API KEY 接入方式。可在启动服务的终端配置 YUANBAO_API_KEY。
$env:YUANBAO_API_KEY = "你的服务APIKEY"
python -m uvicorn app.main:app --host 127.0.0.1 --port 8000 --workers 1原型使用服务端环境变量,前端只知道实时模式是否可用。接口入口与认证方式参考官方 API KEY 接入说明。
4.3 Docker 部署入口
仓库提供 Python 3.12 镜像配置和持久化命名卷。准备好可用的 Docker Engine 后:
cp .env.example .env
# 编辑 .env,填写服务密钥;也可先留空体验回放
docker compose up -d --build
docker compose ps
Windows 可用 Copy-Item .env.example .env 复制配置。默认端口绑定宿主机回环地址,访问 http://127.0.0.1:8000;SQLite 与原文快照保存在命名卷中。
云服务器可以通过 SSH 转发访问,或者在宿主机配置 HTTPS 反向代理。项目提供可选工作台访问口令,适合单实例访问控制。
五、从前端跑完一次真实任务
这一节使用本轮真实浏览器操作的结果。查询条件为:
条件 | 实际输入 |
|---|---|
模式 | 实时查询 |
货物名称 | 智慧黑板 |
地区检索词 | 江西 |
时间条件 | y2,即接口相对近两年范围 |
来源 | 受支持的公开官方来源 |
目标 | 不少于三条金额核对通过记录 |
第一步:提交需求
点击“开始查询”后,前端创建任务,后端返回任务 ID,页面开始轮询任务状态。服务端依次记录联网检索、候选整理和原文核对。
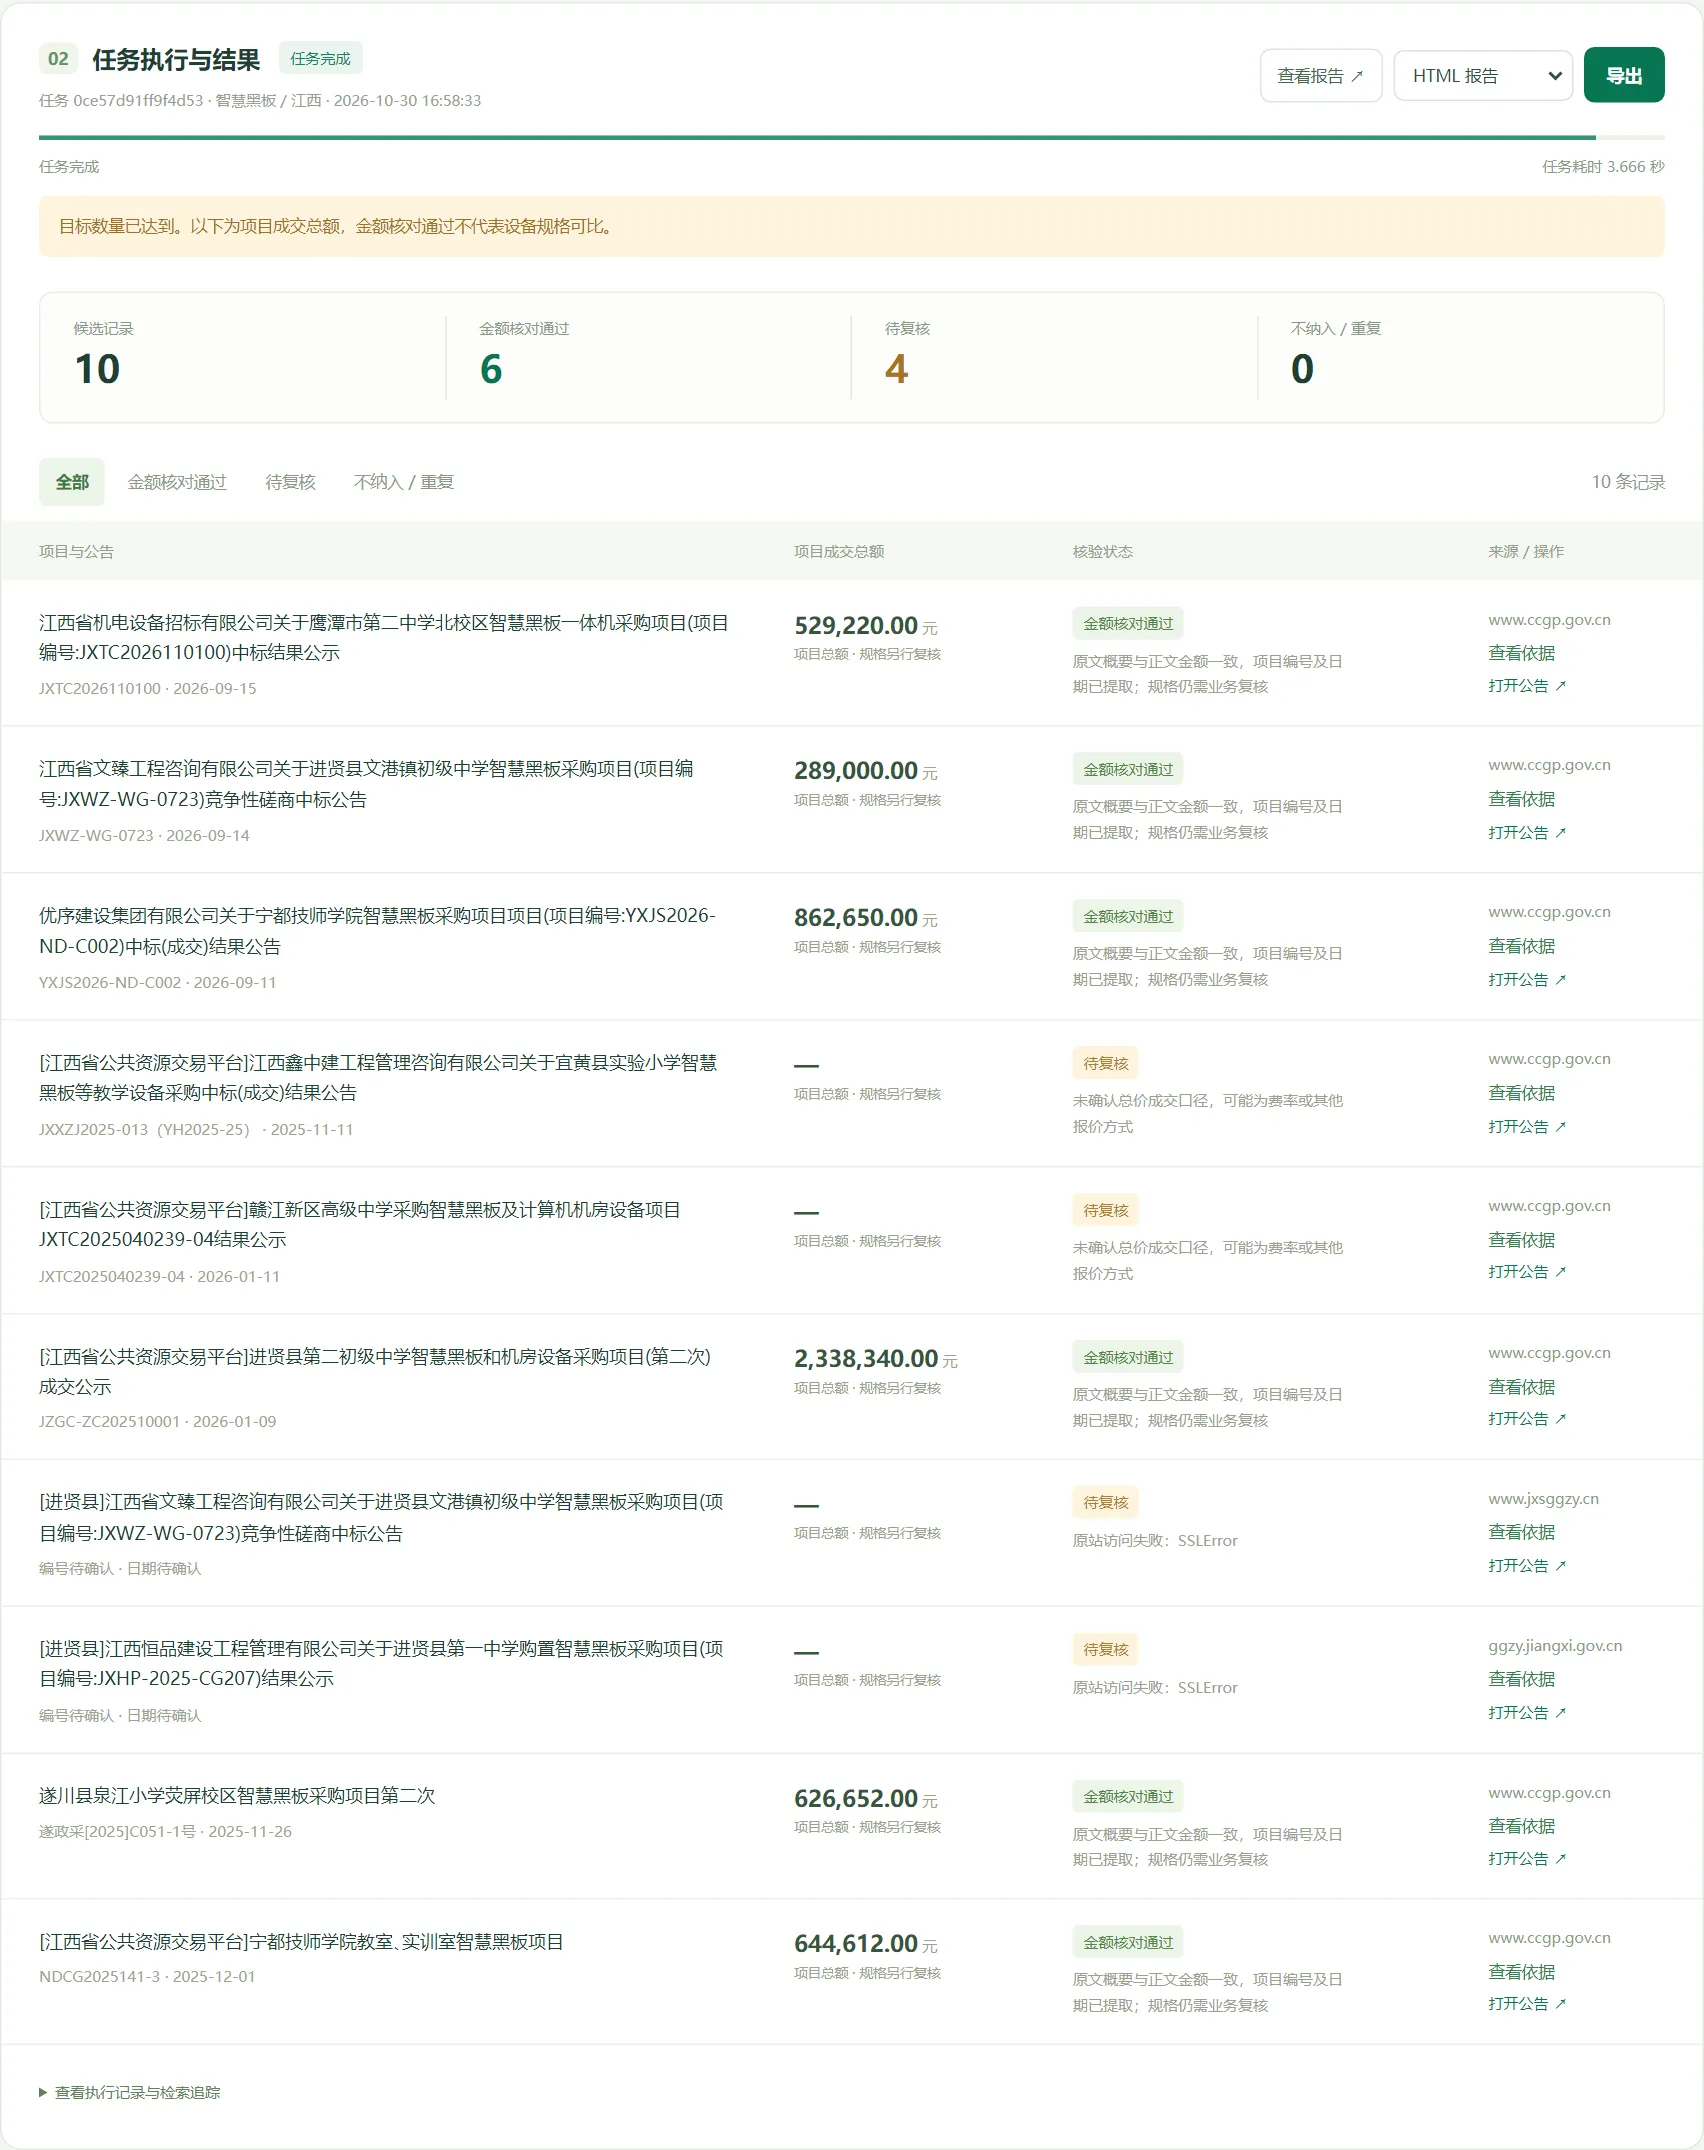
图 2:从实际页面提交任务后截取的执行中状态。结果尚未返回时,系统不会预填成功数量。
对于这次任务,后端实际发出的搜索参数是:
{
  "Query": "江西 智慧黑板 中标 成交公告",
  "Freshness": "y2"
}
地区在当前版本中用于组织检索词,还没有做完整的行政区划识别,不能把它理解成已经逐条完成了地域归属审查。时间参数也采用接口相对范围;原文读取后会另外提取公告日期,检查是否超出所选范围。
第二步:先看总体结果,再检查记录
这次实际返回十条候选,后端读取并处理后,六条通过本版金额核对规则,四条保持待复核。目标为三条,因此任务状态为“任务完成”。
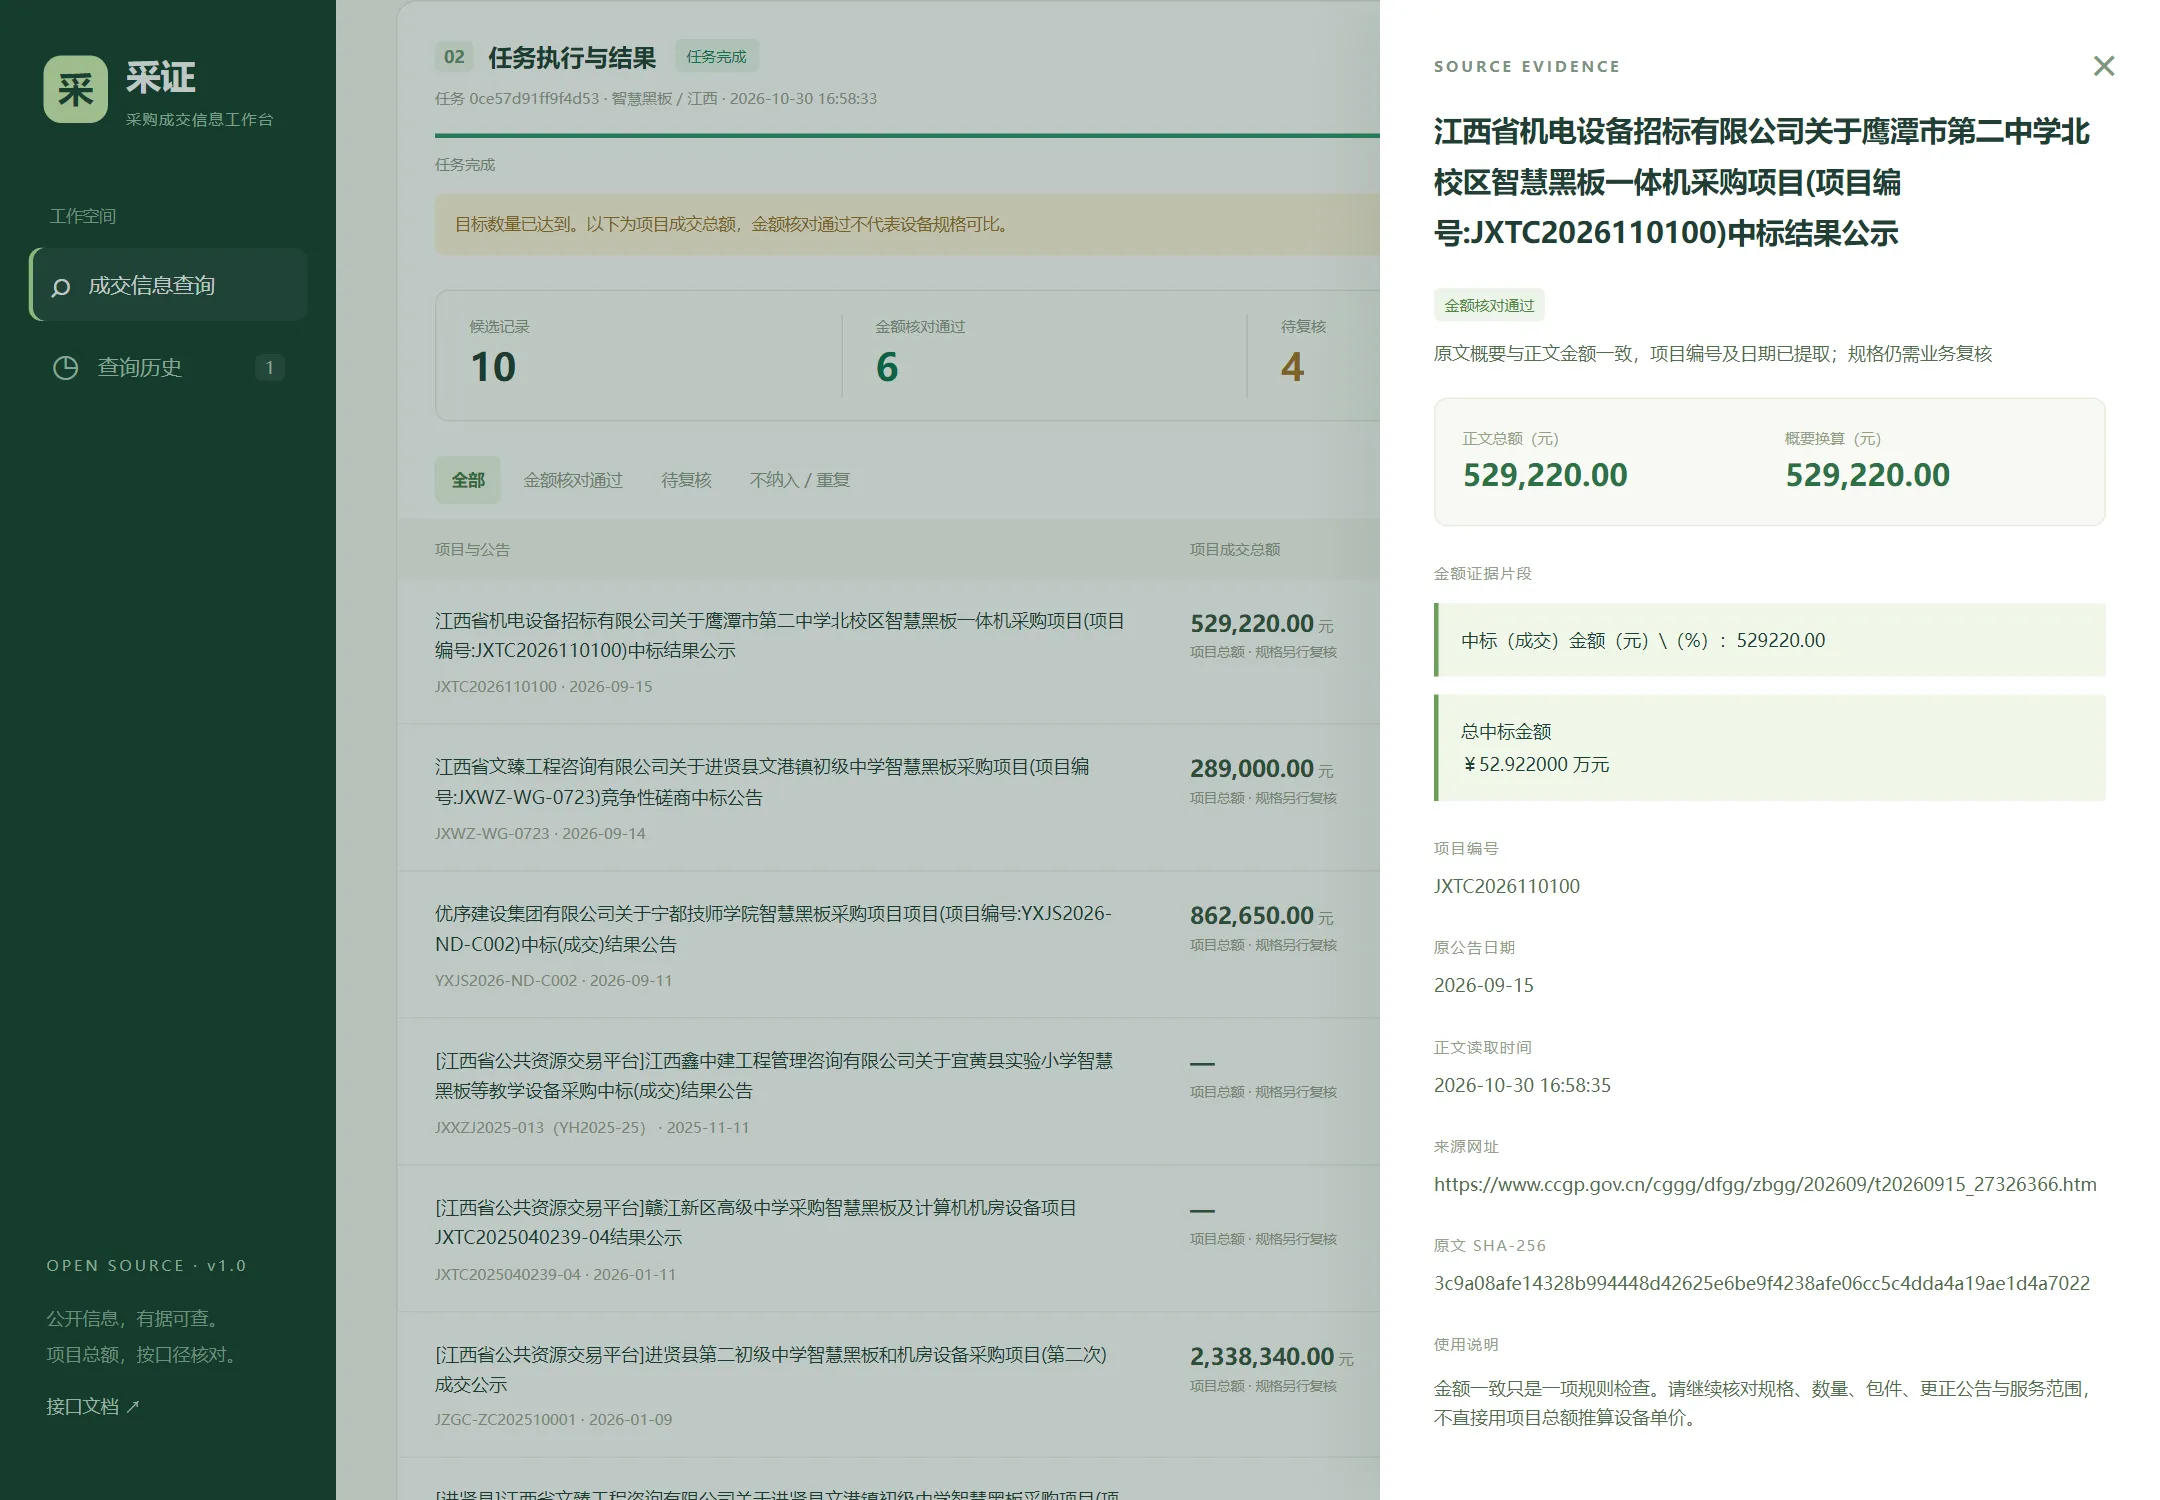
图 3:本轮实际实时查询结果。结果顺序受并发读取完成顺序影响,不作为价格或推荐排名。
通过规则的六个项目如下,全部是项目成交总额:
项目简称 | 原公告日期 | 成交总额(元) |
|---|---|---|
鹰潭二中北校区智慧黑板一体机 | 2026-09-15 | 529,220.00 |
进贤文港镇初级中学智慧黑板 | 2026-09-14 | 289,000.00 |
宁都技师学院智慧黑板采购 | 2026-09-11 | 862,650.00 |
进贤二初智慧黑板和机房设备(第二次) | 2026-01-09 | 2,338,340.00 |
遂川泉江小学荧屏校区智慧黑板(第二次) | 2025-11-26 | 626,652.00 |
宁都技师学院教室、实训室智慧黑板 | 2025-12-01 | 644,612.00 |
第三步:打开证据侧栏,确认金额来自哪里
以鹰潭二中项目为例,点击“查看依据”,页面右侧会显示正文总额 529,220.00 元,以及概要 52.922000 万元换算后的结果。下面保留两段对应文本、项目编号、原公告日期、读取时间、原始链接和网页内容哈希。
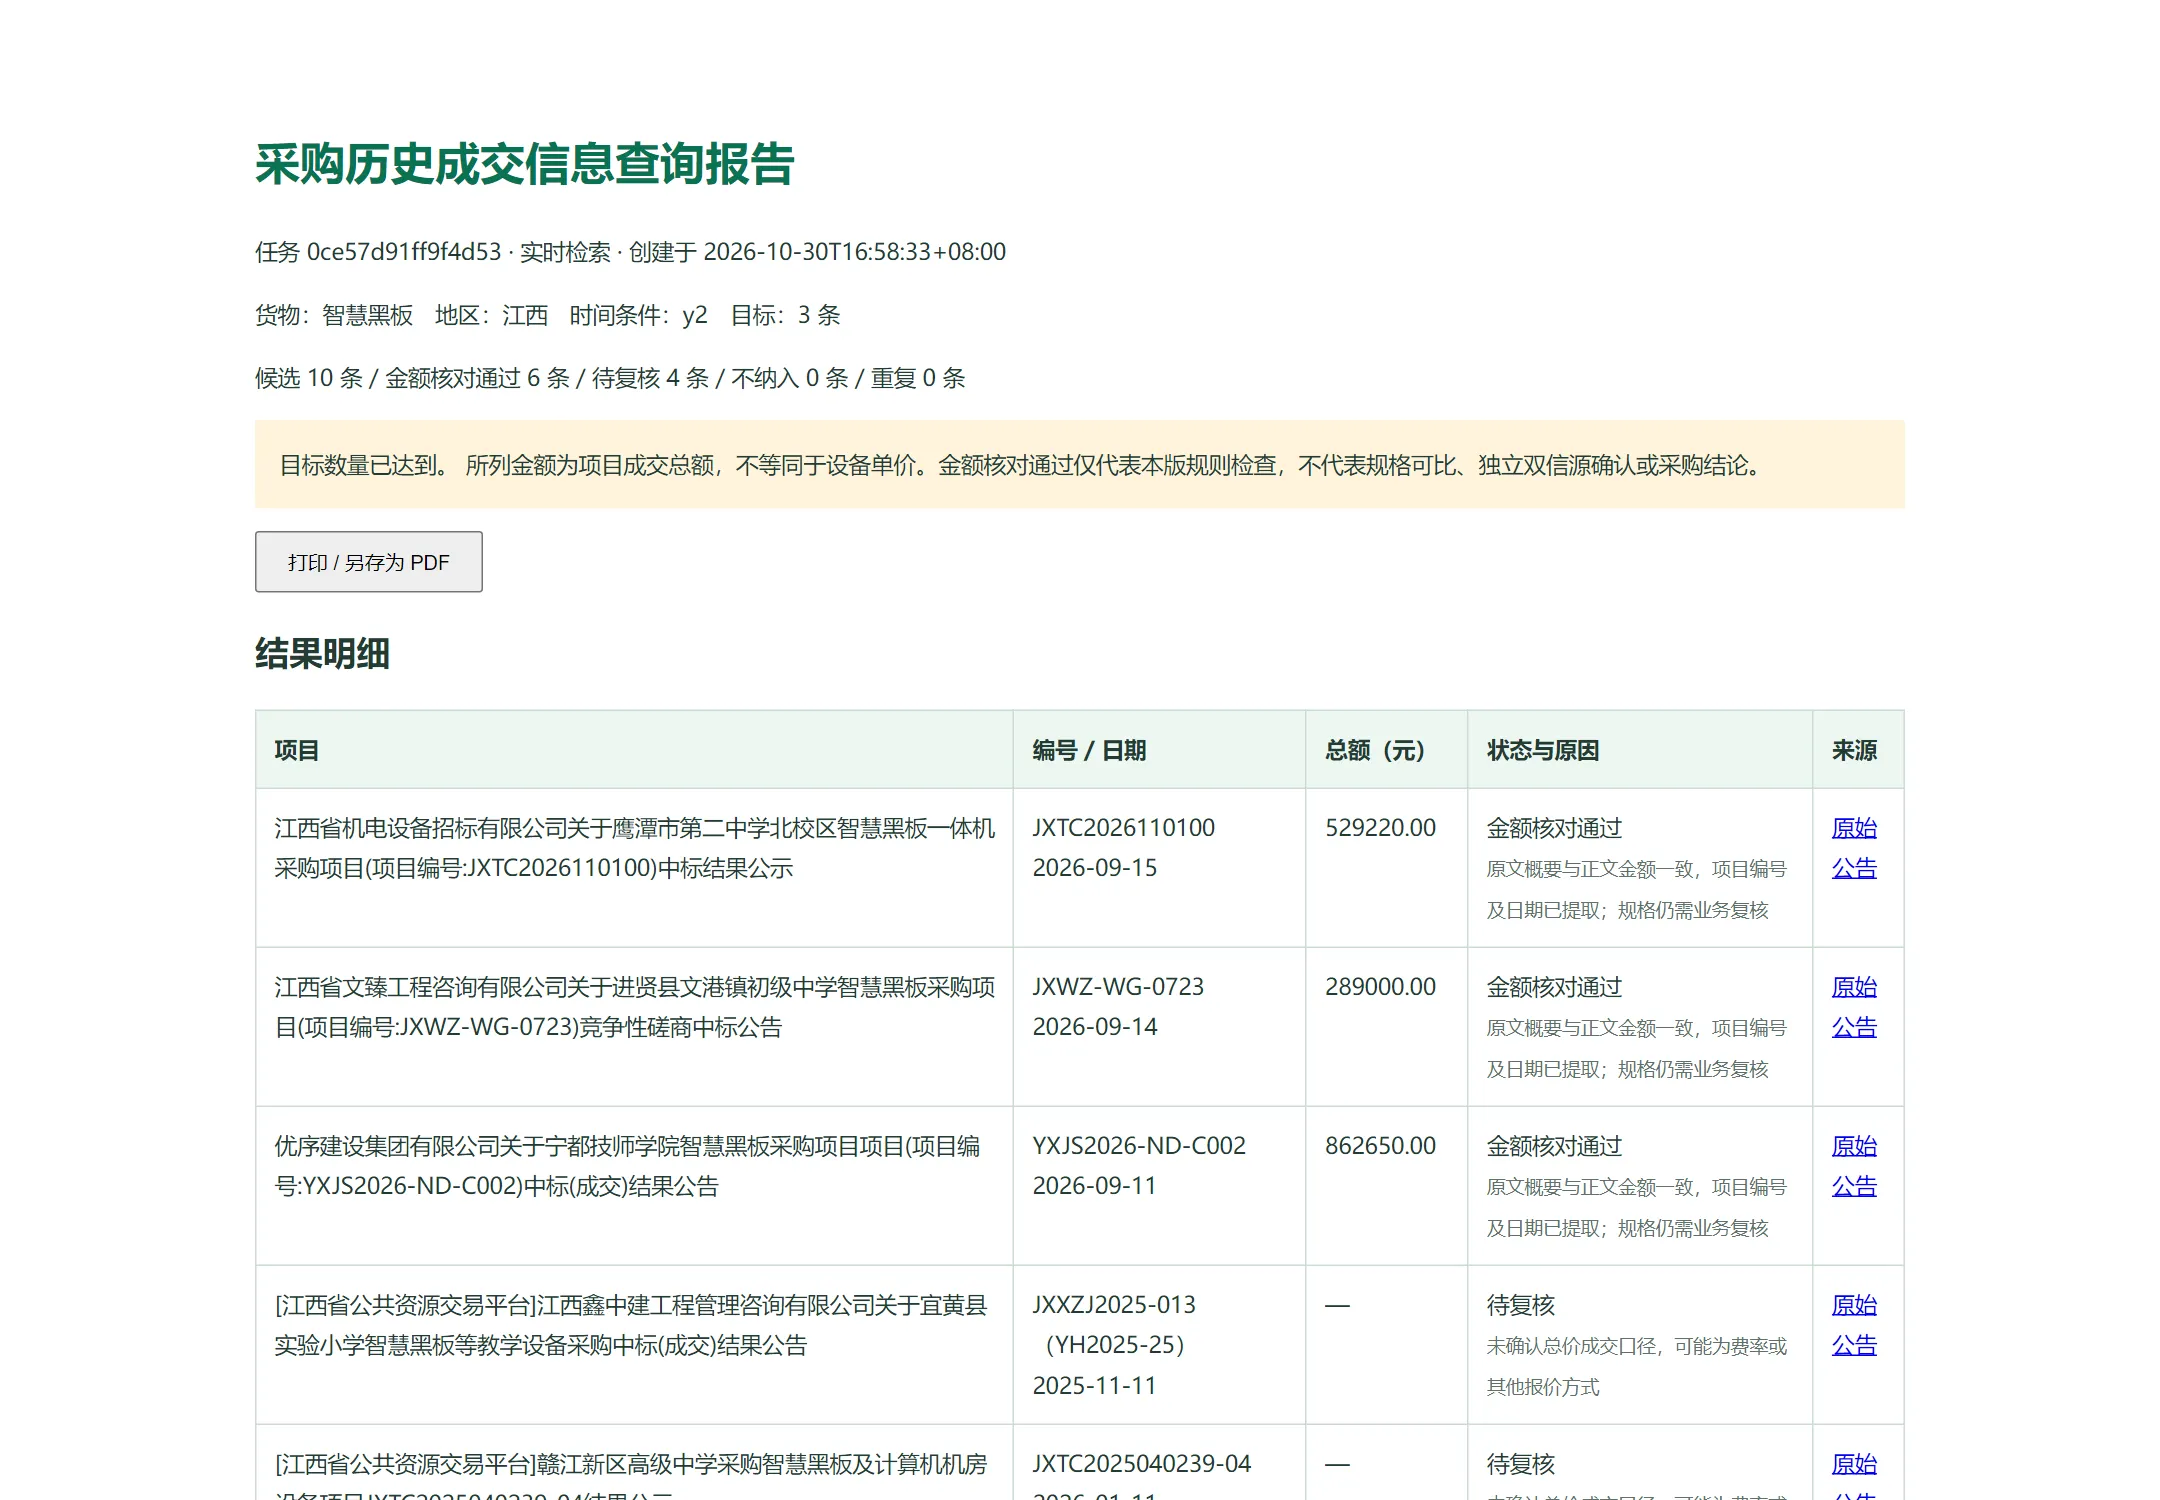
图 4:实际点击结果行打开的证据面板。哈希用于定位本次保存的内容,不能代替来源真实性判断。
这一页的作用,是让复核人员不必先翻查程序日志,也能知道“系统看到了哪两处金额”。若需要确认规格或附件,可以继续打开原公告,沿着同一个项目核查。
本轮两处金额来自同一公告页面,属于页面内部交叉检查。它能够发现单位或解析冲突,但不是两个独立信源的事实确认。
第四步:查看报告并完成下载
任务结束后,可以直接查看报告,或从页面下载 HTML、CSV、JSON。我通过浏览器依次操作了三种格式的导出,并检查下载文件确实非空。
HTML 报告适合直接阅读和打印:顶部包含查询条件、模式、任务 ID、数量与不足提示,正文包含所有记录及状态,后面列出金额证据和检索追踪。CSV 便于经办人员继续在表格中整理,JSON 则保留程序处理所需的结构。
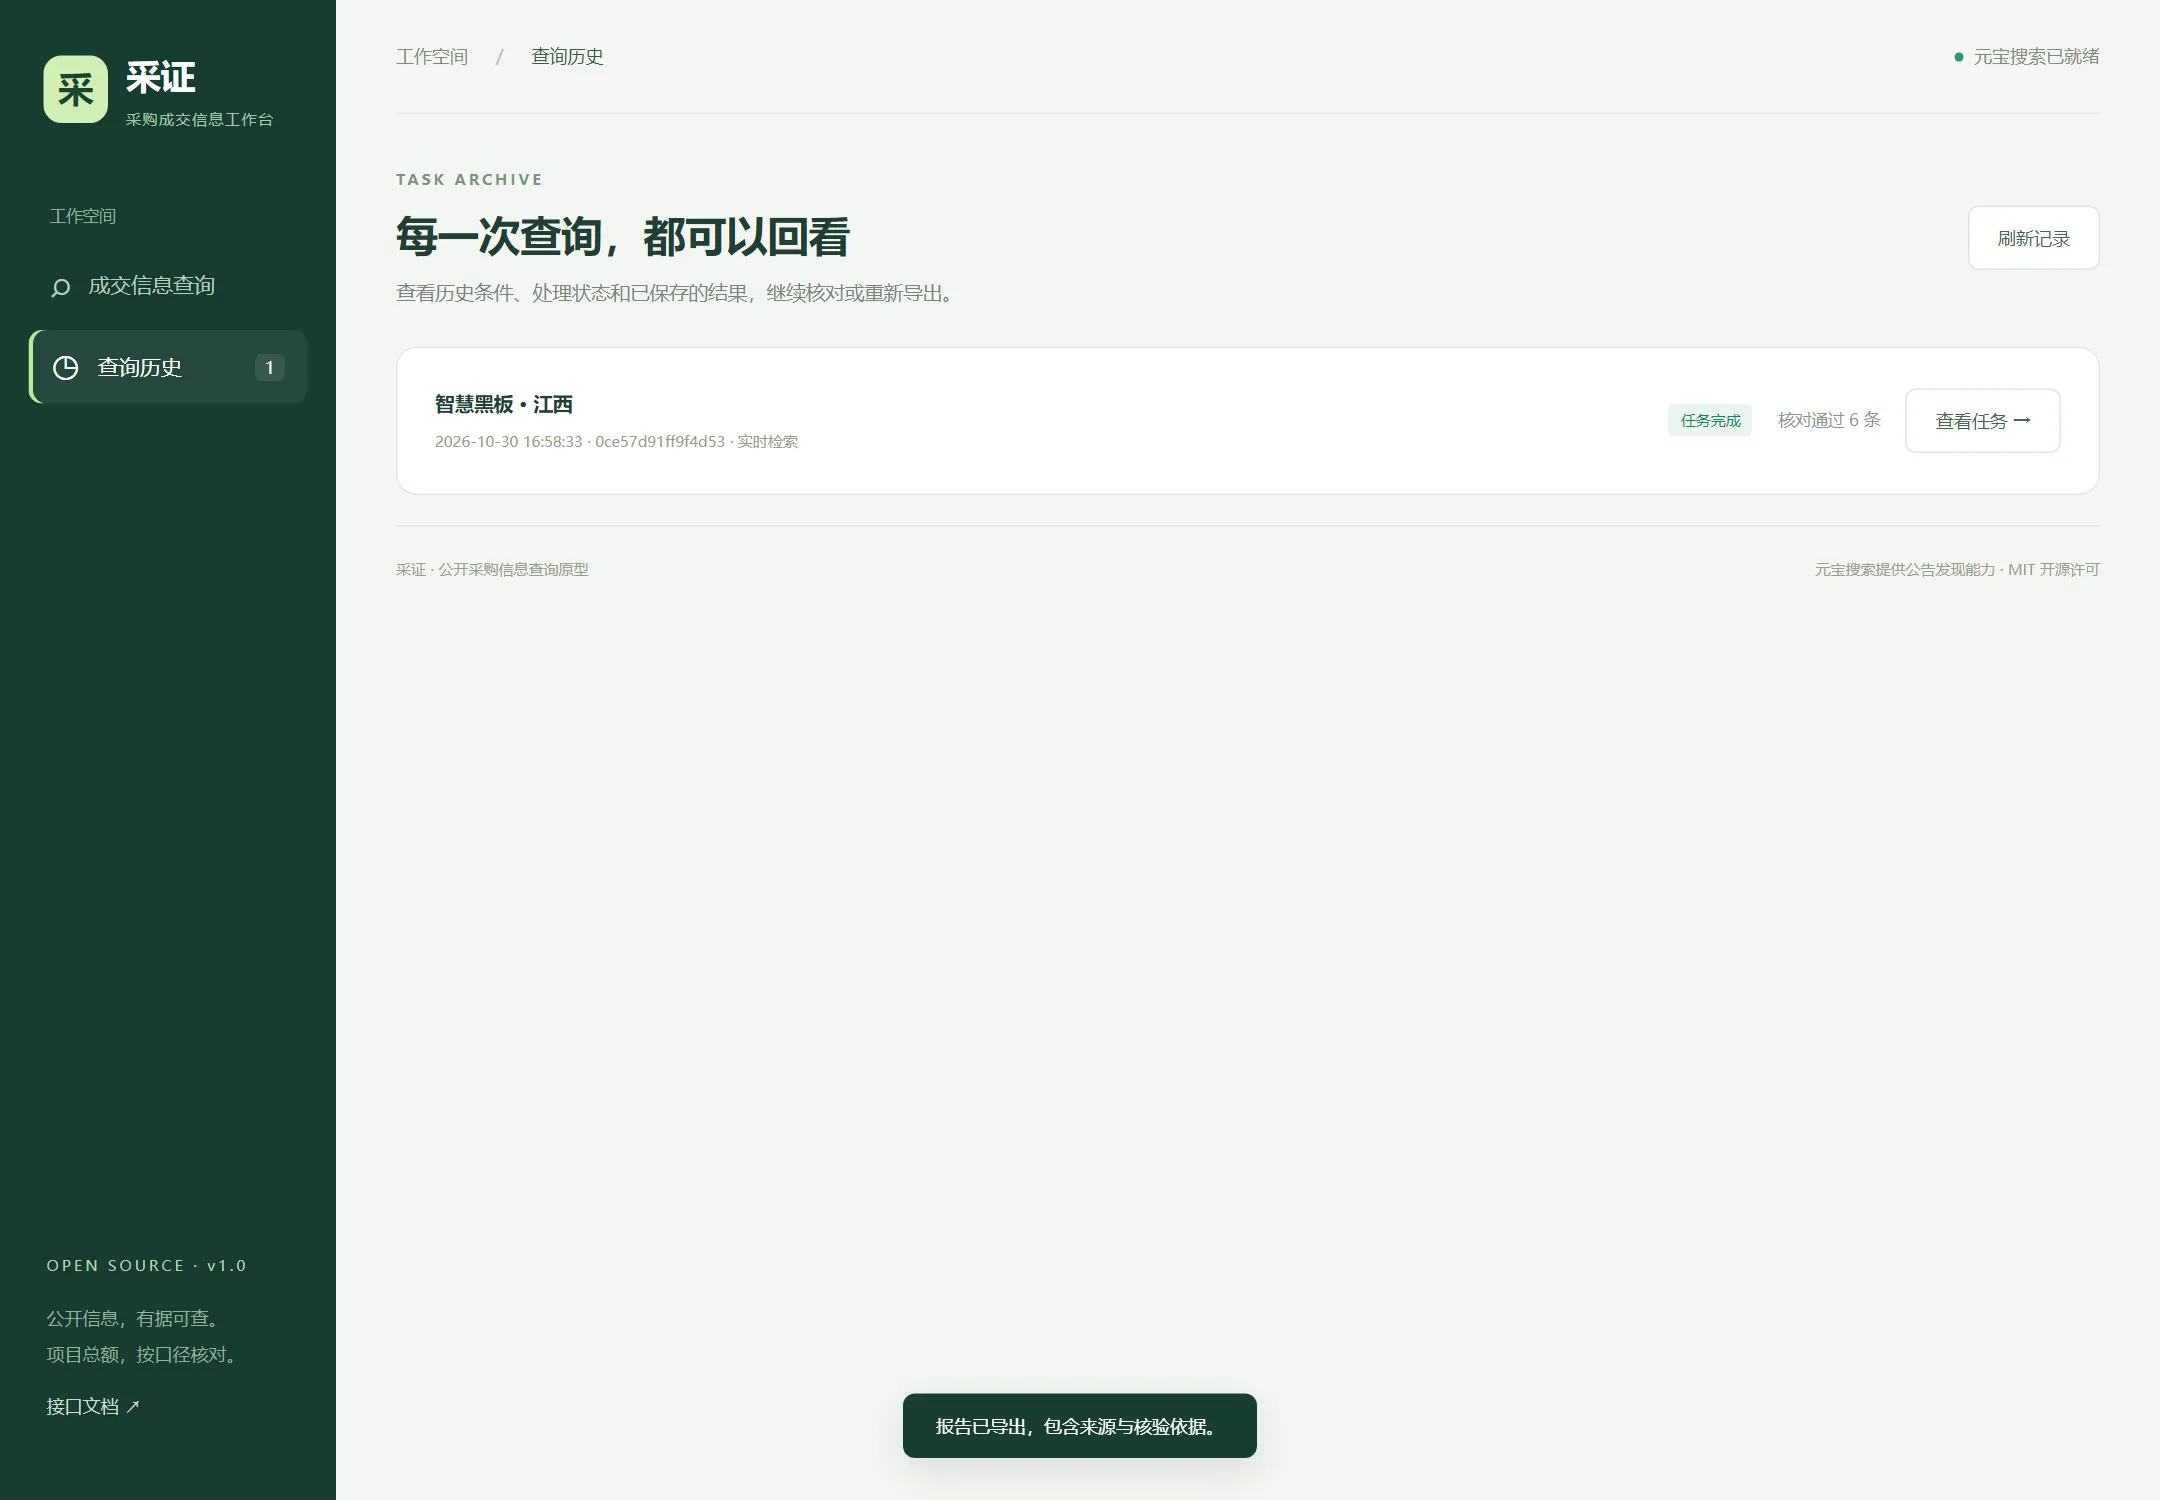
图 5:真实任务导出 HTML 后打开的页面。报告同时保留通过与待复核记录,避免只给出成功样本。
这个输出已经能作为资料收集的交接起点:经办人员拿到项目和来源,复核人员能看到证据及限制,开发人员能根据任务 ID 和检索请求标识追查处理过程。
第五步:在历史任务中重新打开
左侧“查询历史”保存每次查询的名称、地区、时间、模式和处理结果。点击“查看任务”,可以返回原来的明细,再次打开证据或导出报告。
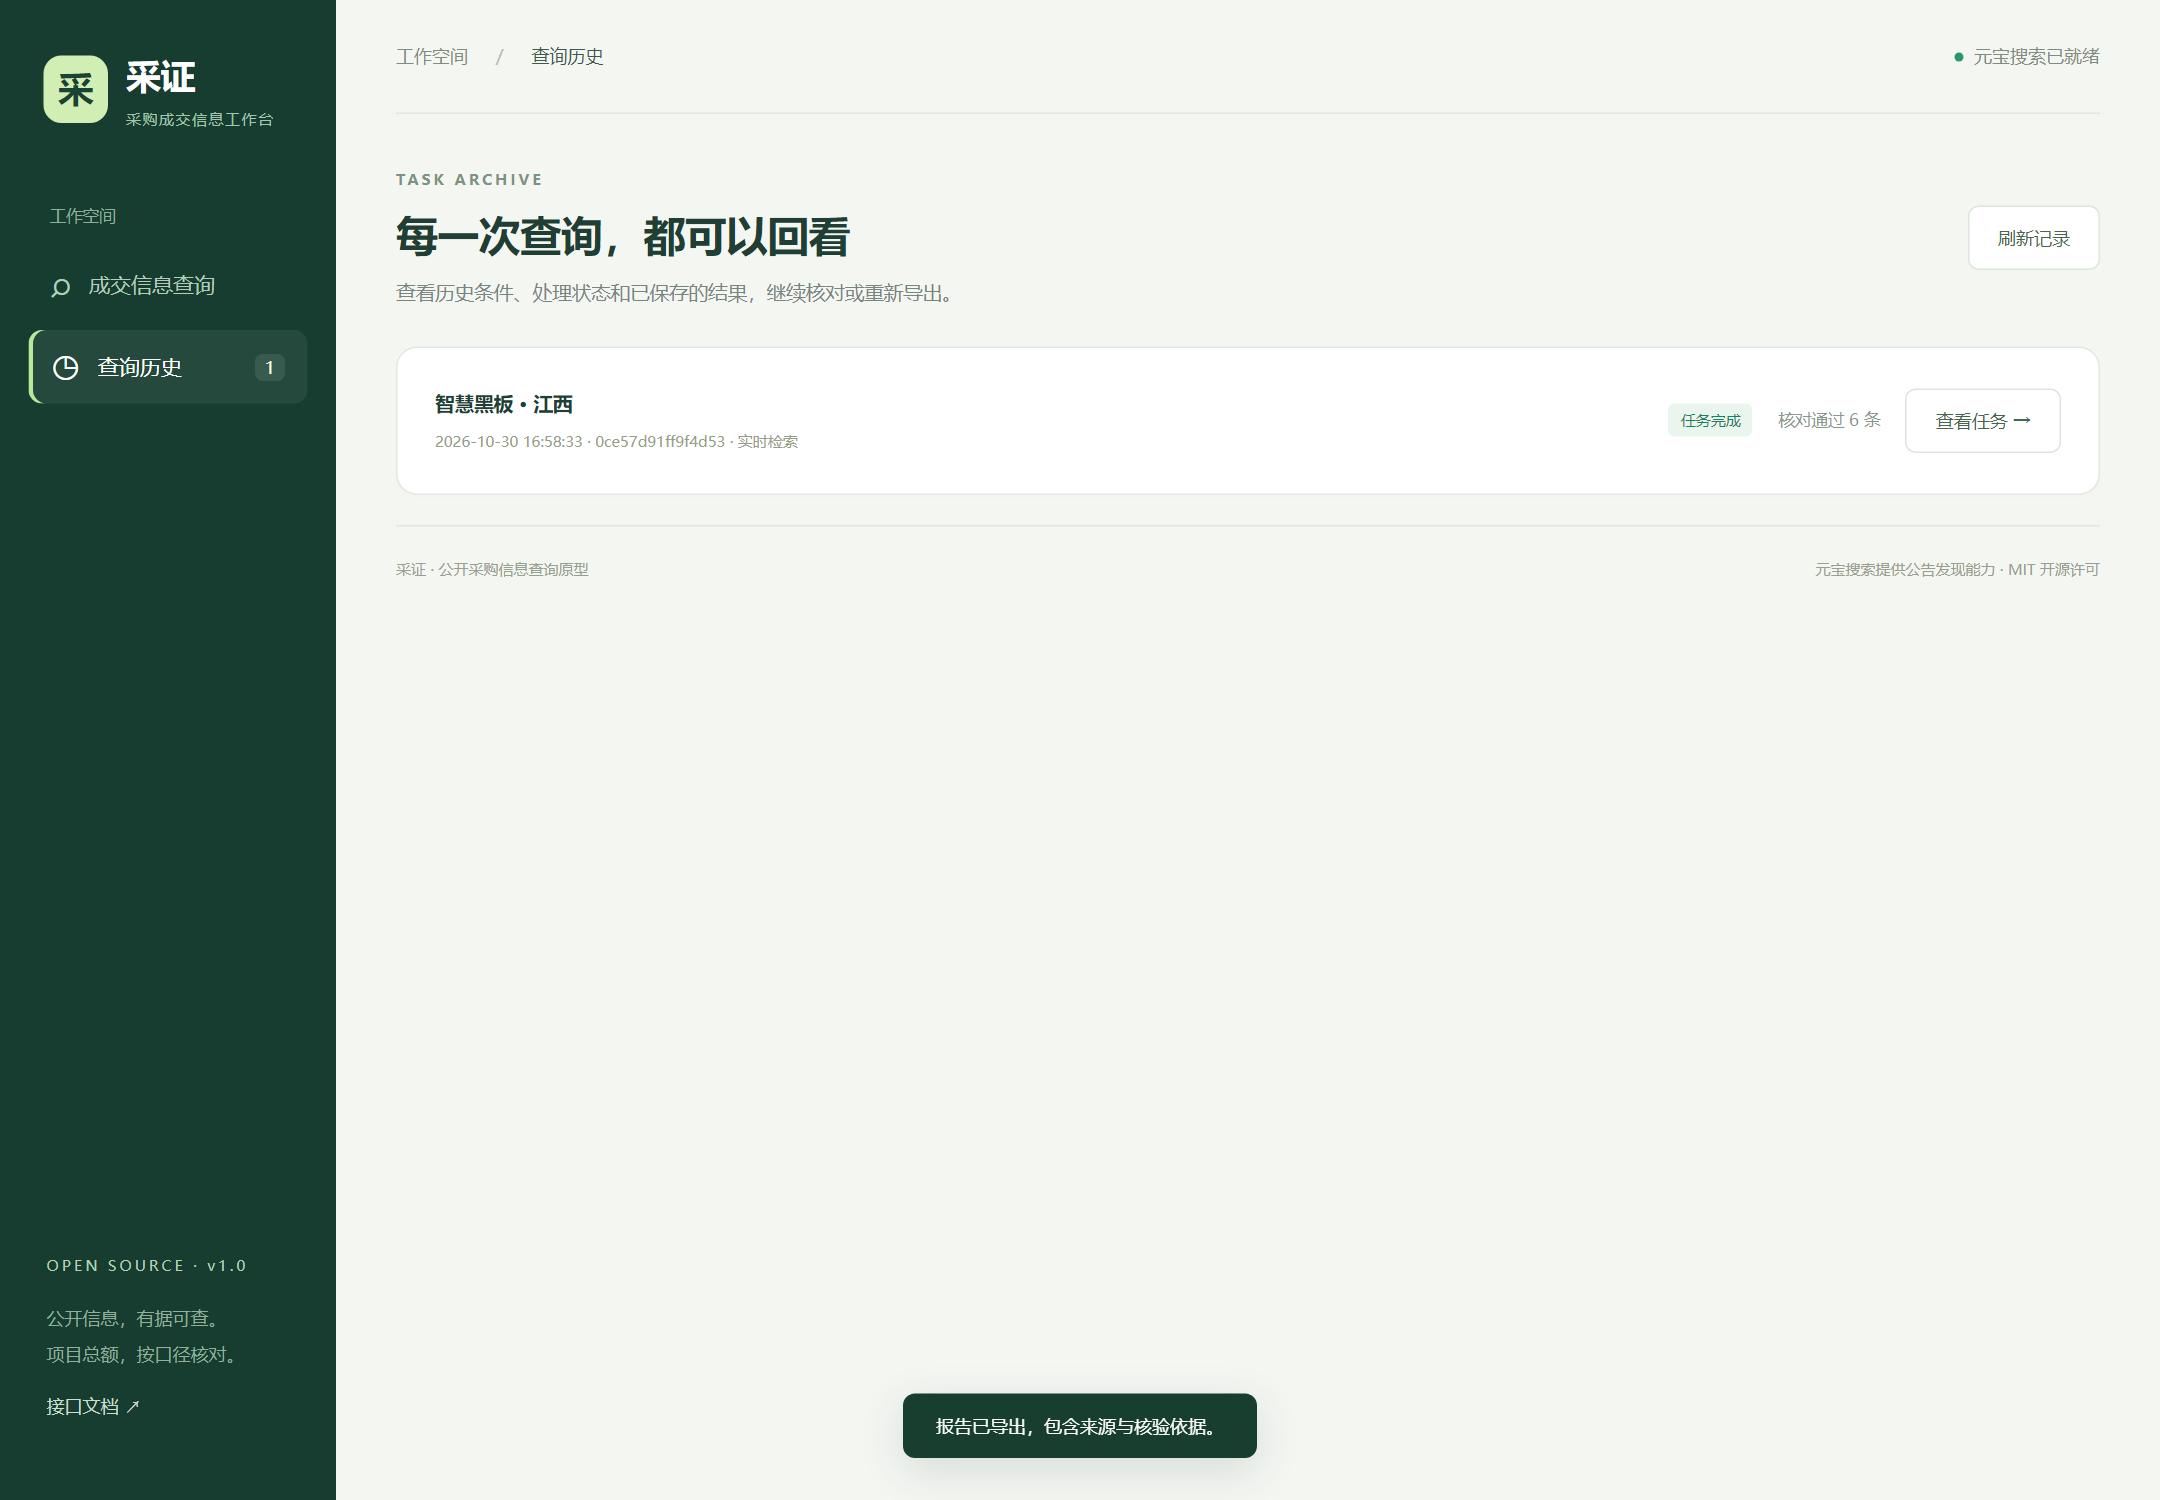
图 6:本轮真实实时任务的历史记录。之后产生的回放任务也会单独保存,并标注模式。
历史功能不是用浏览器内存保存上一屏。后端将任务写入 SQLite,测试中重新创建应用实例后,仍能读取之前完成的结果。若服务关闭时有任务未完成,重启后会将其标记为中断,要求重新提交。
六、关键实现:让每一个状态都有依据
6.1 解析搜索响应,保存检索追踪
SearchPro 的页面列表需要注意嵌套结构:Pages 中的每个条目是 JSON 字符串,解析外层后还要逐条解析。实现同时保留请求标识、返回版本、请求时间和客户端耗时,用于关联本次搜索。
result = response.json().get("Response", {})
if result.get("Error"):
    raise ServiceError(result["Error"].get("Code", "Unknown"))

pages = []
for raw in result.get("Pages", [])[:20]:
    page = json.loads(raw) if isinstance(raw, str) else raw
    if page.get("title") and page.get("url"):
        pages.append({
            "title": page["title"],
            "url": page["url"],
            "date": page.get("date", ""),
})完整实现还会处理无效条目和异常响应。接口参数及不同版本的能力,以SearchPro 文档为准;本项目不依赖所有版本都提供权威度、动态摘要或附件子链。
一次任务先执行一次搜索。如果用户指定了站点,有效记录又不足,并且勾选了允许扩展,才会再去掉站点限定执行一次,时间条件不变。上限是两次,不以无限重试的方式补足数量。
6.2 金额计算使用 Decimal,并匹配完整数字
修复旧问题时,除了处理“元”和“万元”,还需要防止正则只匹配长数字的尾部,或者把畸形千分位拆成一个较小数值。当前金额入口要求完整数值格式匹配,再转换为 Decimal。
NUMBER = r"(?:[0-9]{1,3}(?:,[0-9]{3})+|[0-9]+)(?:\.[0-9]+)?"

def money(number: str, unit: str) -> str:
    if not re.fullmatch(NUMBER, number.strip()):
        raise ValueError("金额格式需要确认")
    if unit not in ("元", "万元"):
        raise ValueError("金额单位需要确认")
    value = Decimal(number.replace(",", ""))
    if unit == "万元":
        value *= Decimal("10000")
    return format(value.quantize(Decimal(".01")), ".2f")
金额以十进制字符串保存,不在序列化时转成浮点数。更重要的是,匹配前先找成交金额字段及总价中标上下文,不从整个网页任取第一个“元”前面的数字。
本版核对规则比较保守:确认总价口径,提取项目编号和原公告日期,定位正文金额与概要总额,两处换算一致才进入“金额核对通过”。多金额、缺字段、费率或冲突情形保持待复核。
6.3 将候选状态和任务状态分开
任务完成不代表每一条候选都通过。十条候选中存在四条待复核,也不意味着任务失败,因为用户需要至少三条有效资料,而本次已经取得六条。
对象 | 状态 | 对使用者的含义 |
|---|---|---|
记录 | 金额核对通过 | 满足本版金额规则,仍需检查规格和业务条件 |
记录 | 待复核 | 内容不足、规则未覆盖、来源失败或出现冲突 |
记录 | 不纳入 | 明确废标、流标、终止或原文日期超出范围 |
记录 | 重复记录 | 已取得的同编号、同总额来源,不重复计数 |
任务 | 任务完成 | 核对通过数量达到目标 |
任务 | 记录不足 | 正常处理结束,但未达到目标 |
任务 | 失败或中断 | 服务错误,或任务随服务关闭中断 |
重复处理也保留了一条边界:相同项目编号但金额不同,不自动选择其中一个,而是将相关记录转为待复核,交给包件或更正关系检查。
6.4 三种时间和原文快照分别保存
搜索结果中的时间、公告页面自己的发布日期,以及这次程序读取正文的时间,不是一回事。数据模型分别保存 search_date、published_date 和 fetched_at。
网页快照保存在运行数据目录,报告只输出必要的结构化字段与金额片段。原文可能包含公开联系方式,因此运行数据库和完整快照不随源码提交,前端也没有把快照目录作为静态目录公开。
6.5 前端展示外部内容时保留文本边界
搜索标题和公告片段都属于外部数据。前端使用 textContent 创建标题、原因和证据块,不把返回内容直接拼成 HTML。导出 HTML 对文本作转义;CSV 对可能被表格软件解释成公式的开头字符作处理。
这些处理服务于实际交付:同事打开报告时,看到的是来源文本和数值,而不是由外部页面内容带来的可执行片段。
七、四条待复核记录,应该怎样解释
本轮四条待复核中,有两条原站访问出现 TLS 错误,系统保存了失败原因。它们不能被算作已经核验的成交记录,但“访问失败”也不能解释成“这个项目没有成交事实”。
另两份页面没有匹配本版要求的总价成交上下文。当前规则没有覆盖这两份页面的表达,因此保留待复核,而不是从其他金额里选一个填上。
在前面的接入实验中,我还做过一次限定江西平台及相对时间的搜索:十条返回中,七条标题明确属于更正、变更、澄清、补遗或废标。这让我在系统里保留了标题预筛和关联复核状态。
更正公告可能改变原项目事实,所以“不独立计为一条成交记录”不等于可以忽略。当前版本只保留提示,还没有自动建立完整更正关系;复核人员需要继续打开对应来源确认。
对于正文打不开、金额只在附件里、采购包包含多类设备等情况,保留具体原因,比输出一个看似完整却无法解释的金额更有助于后续工作。
八、开源先体验再接入
实时密钥属于各自账号的配置。为了让读者拿到源码就能检查交互,我给项目加入了固定示例回放。
示例使用 2026-10-30 保存的十条候选及四份最小公告事实摘录。它不包含联系人、电话、地址和服务密钥,不是完整网页镜像。界面明确写出“示例回放”,执行记录中的历史请求标识也带回放标记。
将目标设置为五条时,四条通过的固定样本不足以完成目标,页面会显示“记录不足”。未收录的正文维持待复核,系统不会为演示补出第五条。
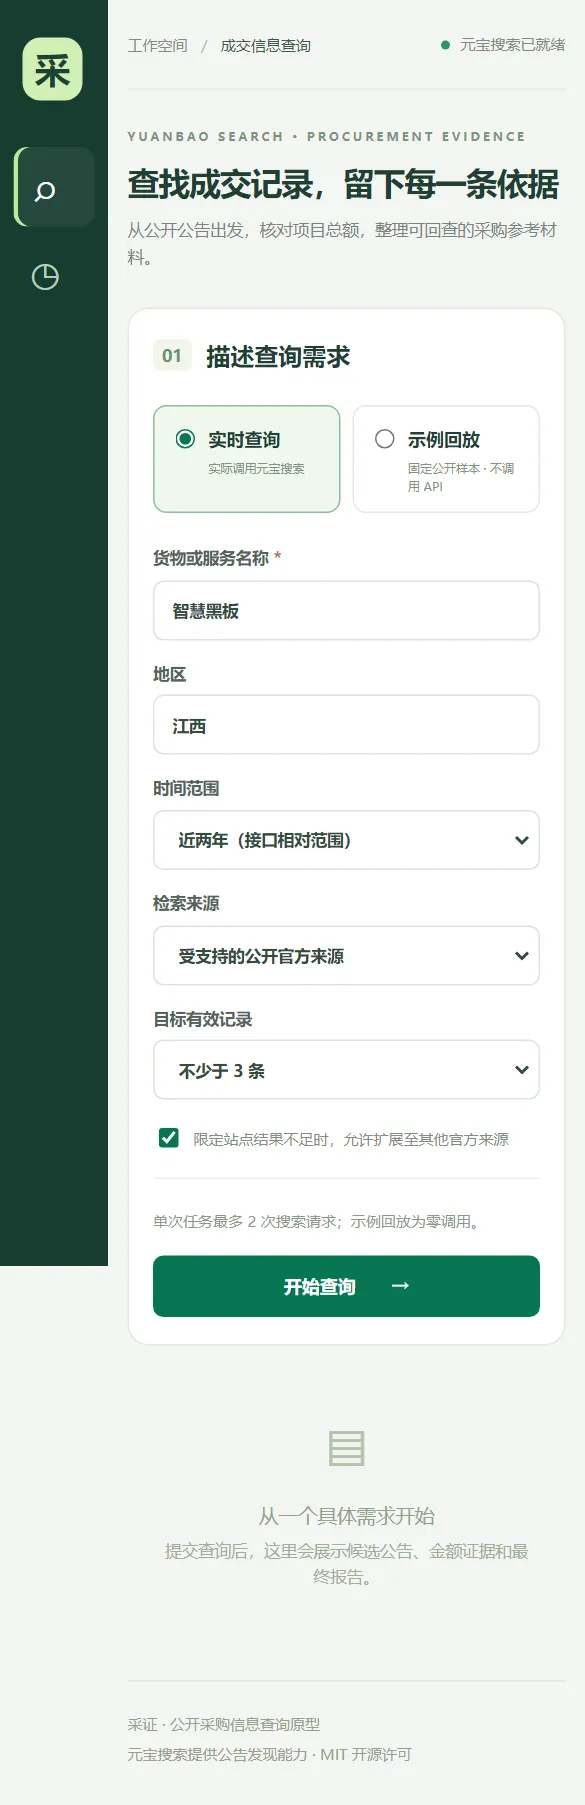
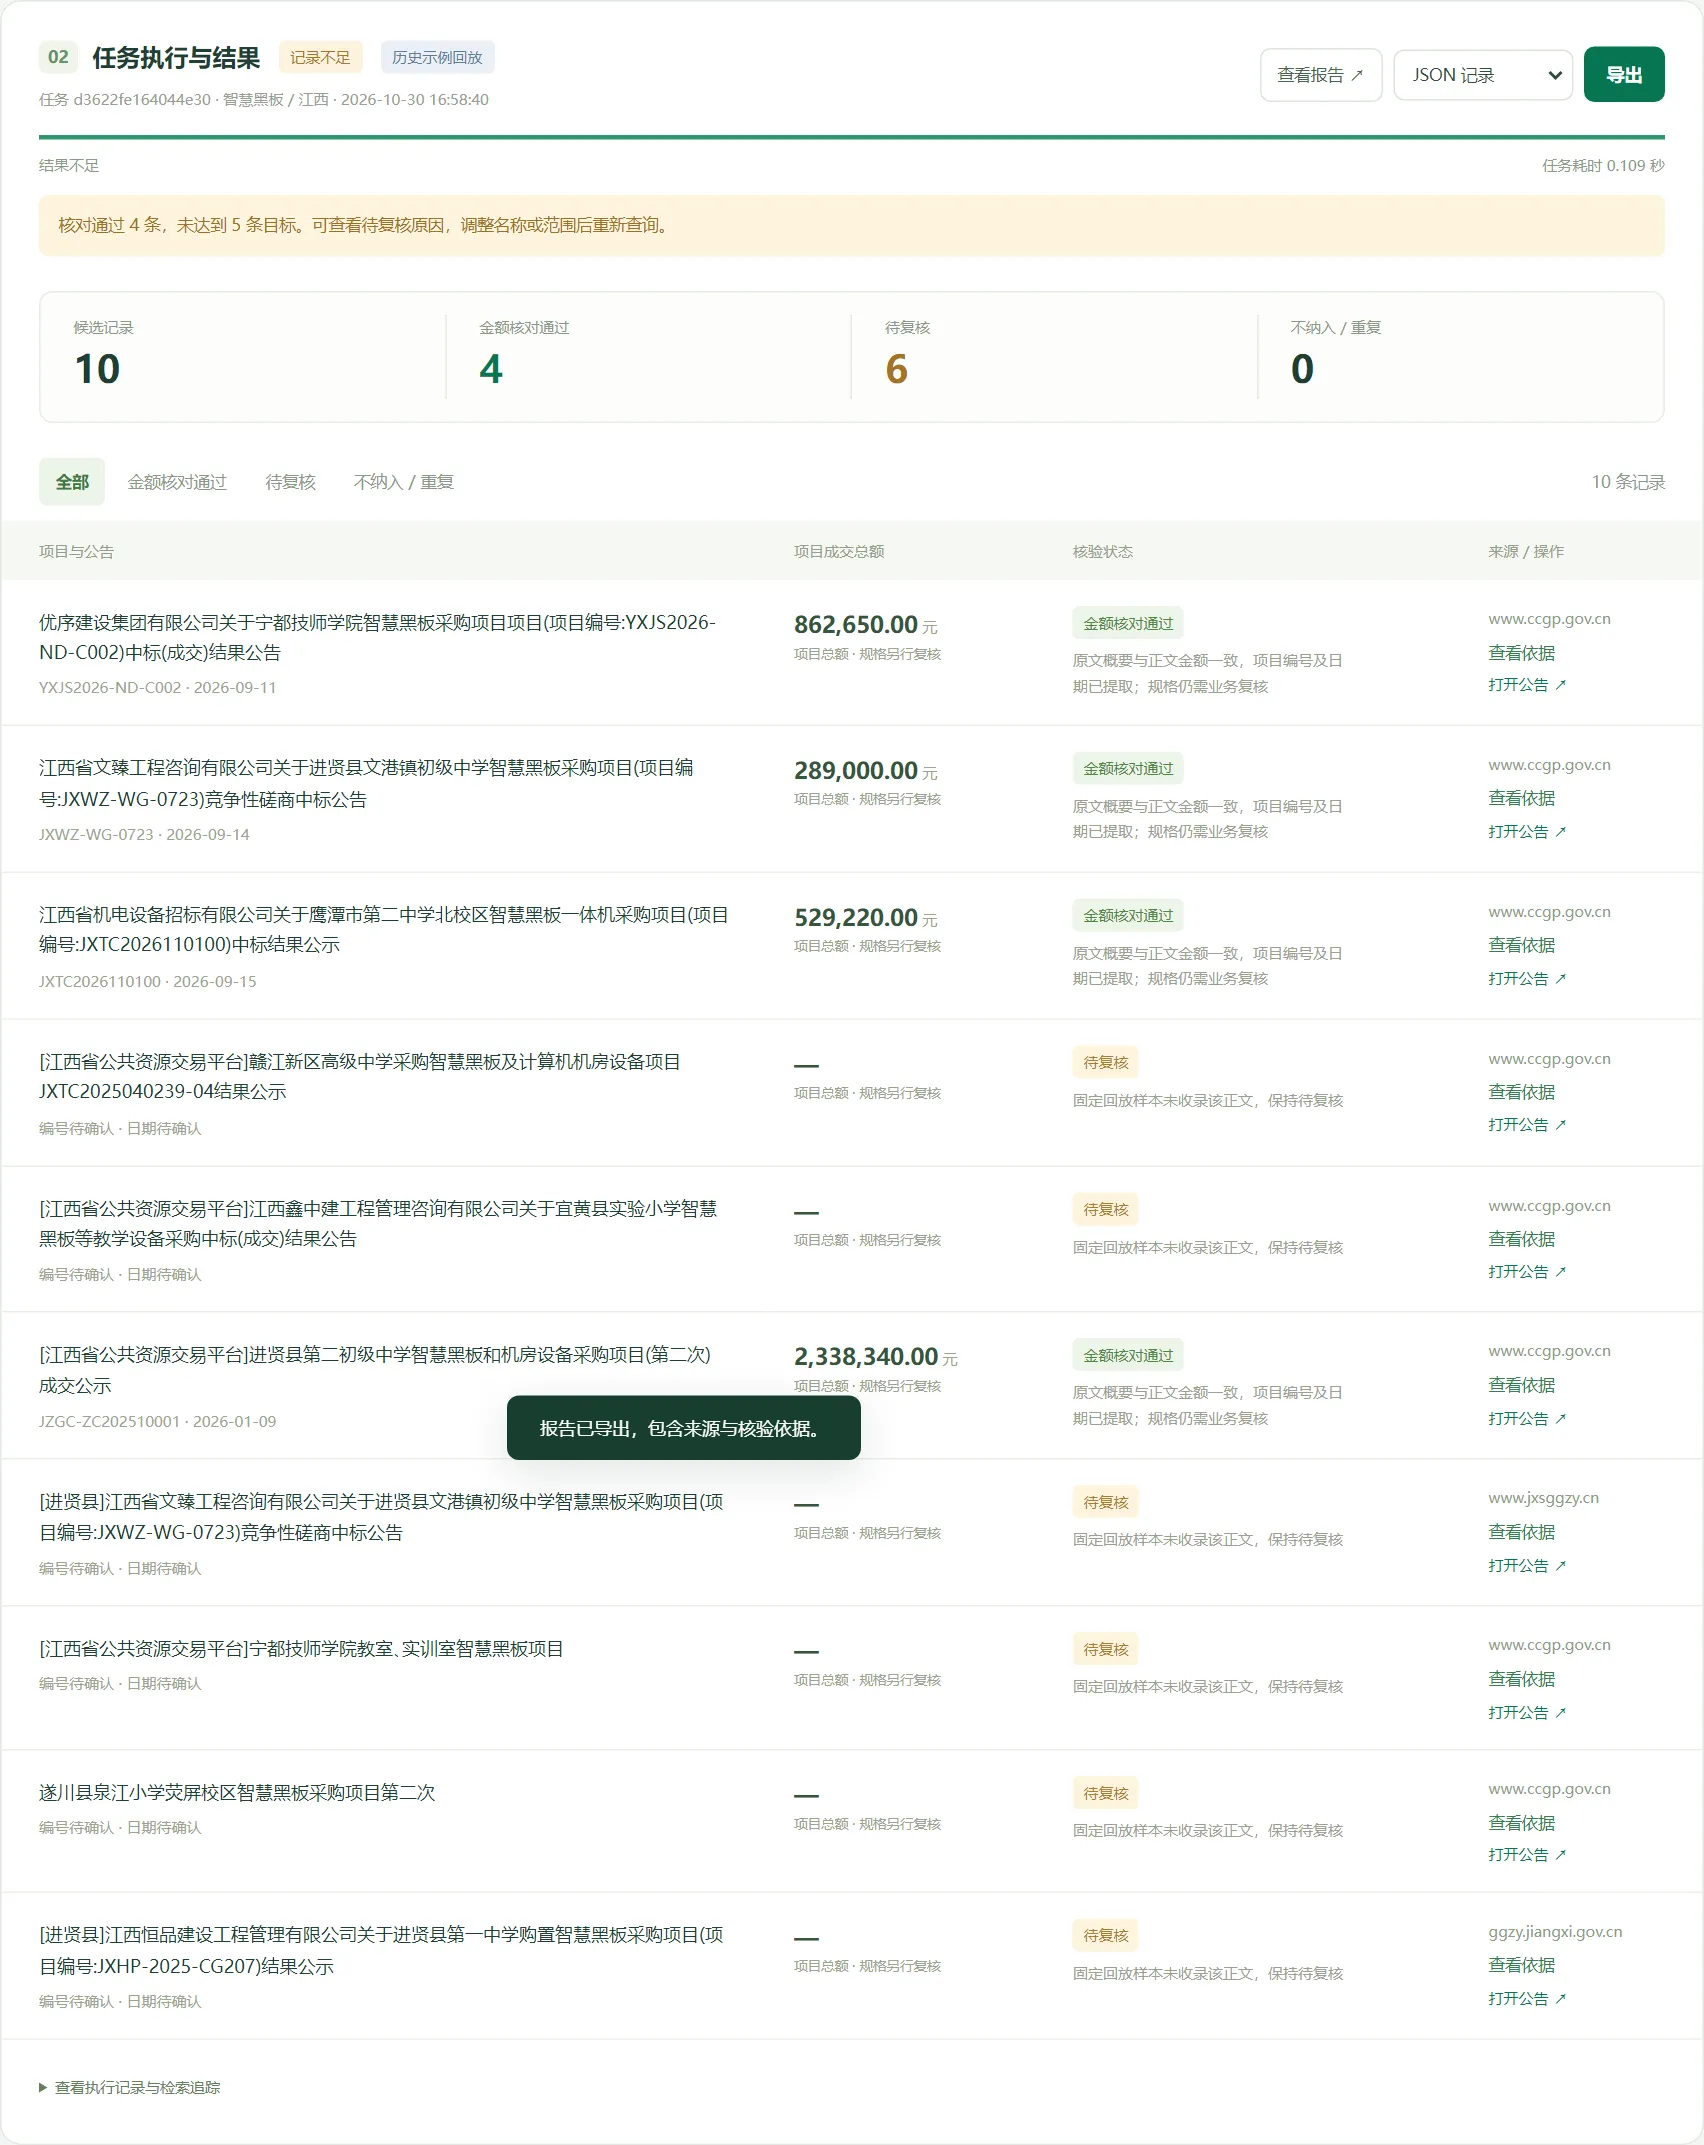
图 7:不调用外部接口的固定回放。它用于验证操作和不足处理,不计入实时调用结果。
这提供了一条较容易复现的路径:先不配密钥,用回放完成创建任务、看依据、导出和历史回看;确认运行环境正常,再切换到自己的真实接口。
前端同时做了响应式布局。小屏幕上需求表单改单列,明细表保持横向可滚动,避免把较长公告标题挤成无法阅读的碎片。
图 8:390px 宽度下的实际页面截图。本轮检查了页面整体无横向溢出;结果表自身允许横向浏览。
十、怎样进入实际工作
以一个学校设备采购资料收集任务为例,使用者可以先确定设备名称、地域和时间条件,通过采证收集项目线索,再把导出的明细交给负责规格核对的同事。
复核时,先看项目是否确实相关,再查看金额证据和原始公告,最后确认包件、数量及服务内容。对于待复核记录,按原因分别处理:来源访问失败的换一个合适时段或发布入口;规则未覆盖的人工阅读;更正和澄清材料继续关联项目;附件中的明细则单独检查。
这样,系统参与的是采购前资料收集、初步核对和材料交接,不会越过业务人员直接给出采购价格结论。即使有一部分记录还需要人工工作,也能把“哪些已经检查、哪些尚未确认”明确交代下来。
下一步最有价值的改进,是增加具体公告模板和附件明细解析,并引入人工复核记录。跨站项目关系、包件拆分、最新更正状态也需要继续完善。只有这些边界清楚后,才适合进一步讨论可比单价和更复杂的预算分析。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号