大数据平台对接网络型温湿度变送器:TCP/IP、UDP、SNMP 多协议解析笔记
原创
大数据平台对接网络型温湿度变送器:TCP/IP、UDP、SNMP 多协议解析笔记
原创
BJ盛世宏博小程
发布于 2026-11-16 16:32:28
发布于 2026-11-16 16:32:28
大数据平台对接网络型温湿度变送器:TCP/IP、UDP、SNMP 多协议解析笔记
物联网 · 大数据平台 · 多协议解析 · 盛世宏博
一、笔记概述与业务需求背景
随着数据中心、智能制造、智慧档案馆、生物医药实验室等场景的环境感知点位持续规模化增长,传统动环监控平台的存储、计算、分析能力已经难以支撑海量时序感知数据的深度挖掘。业务侧不再只满足于温湿度实时展示、超限告警,进一步提出环境大数据分析需求:机房热场推演、库房温湿度趋势预测、设备能耗与环境参数关联分析、合规报表自动生成、多维度数据看板、机器学习异常预判等。在此背景下,将网络型温湿度变送器接入大数据平台,构建感知层到大数据计算层的完整数据链路,成为环境监控系统升级的主流方向。
本笔记面向后端开发、物联网集成工程师,聚焦大数据平台对接RJ45网络型温湿度变送器的工程落地,覆盖TCP/IP、UDP、SNMP三类主流通信协议的报文解析、数据归一化、协议网关开发、数据清洗、入湖入仓、链路可靠性处理等全流程内容。项目核心痛点集中在多协议异构、报文格式不统一、设备厂商私有协议差异、网络抖动丢包、粘包、Trap告警丢失、时序数据乱序、流量削峰、数据质量治理等问题。
大数据平台一般由消息队列、时序数据库、离线计算引擎、实时计算引擎、数据仓库、可视化模块共同组成,常见技术栈包含Kafka、Flink、Spark、TDengine、InfluxDB、Hive、ClickHouse等。和传统动环平台的采集逻辑有本质区别:传统动环系统以“实时展示、告警”为目标;大数据平台以“数据标准化、可回溯、可计算、可复用”为核心,对字段规范、时间戳精度、标签体系、数据质量、元数据管理有严格要求,不能直接把原始报文不经处理写入存储。
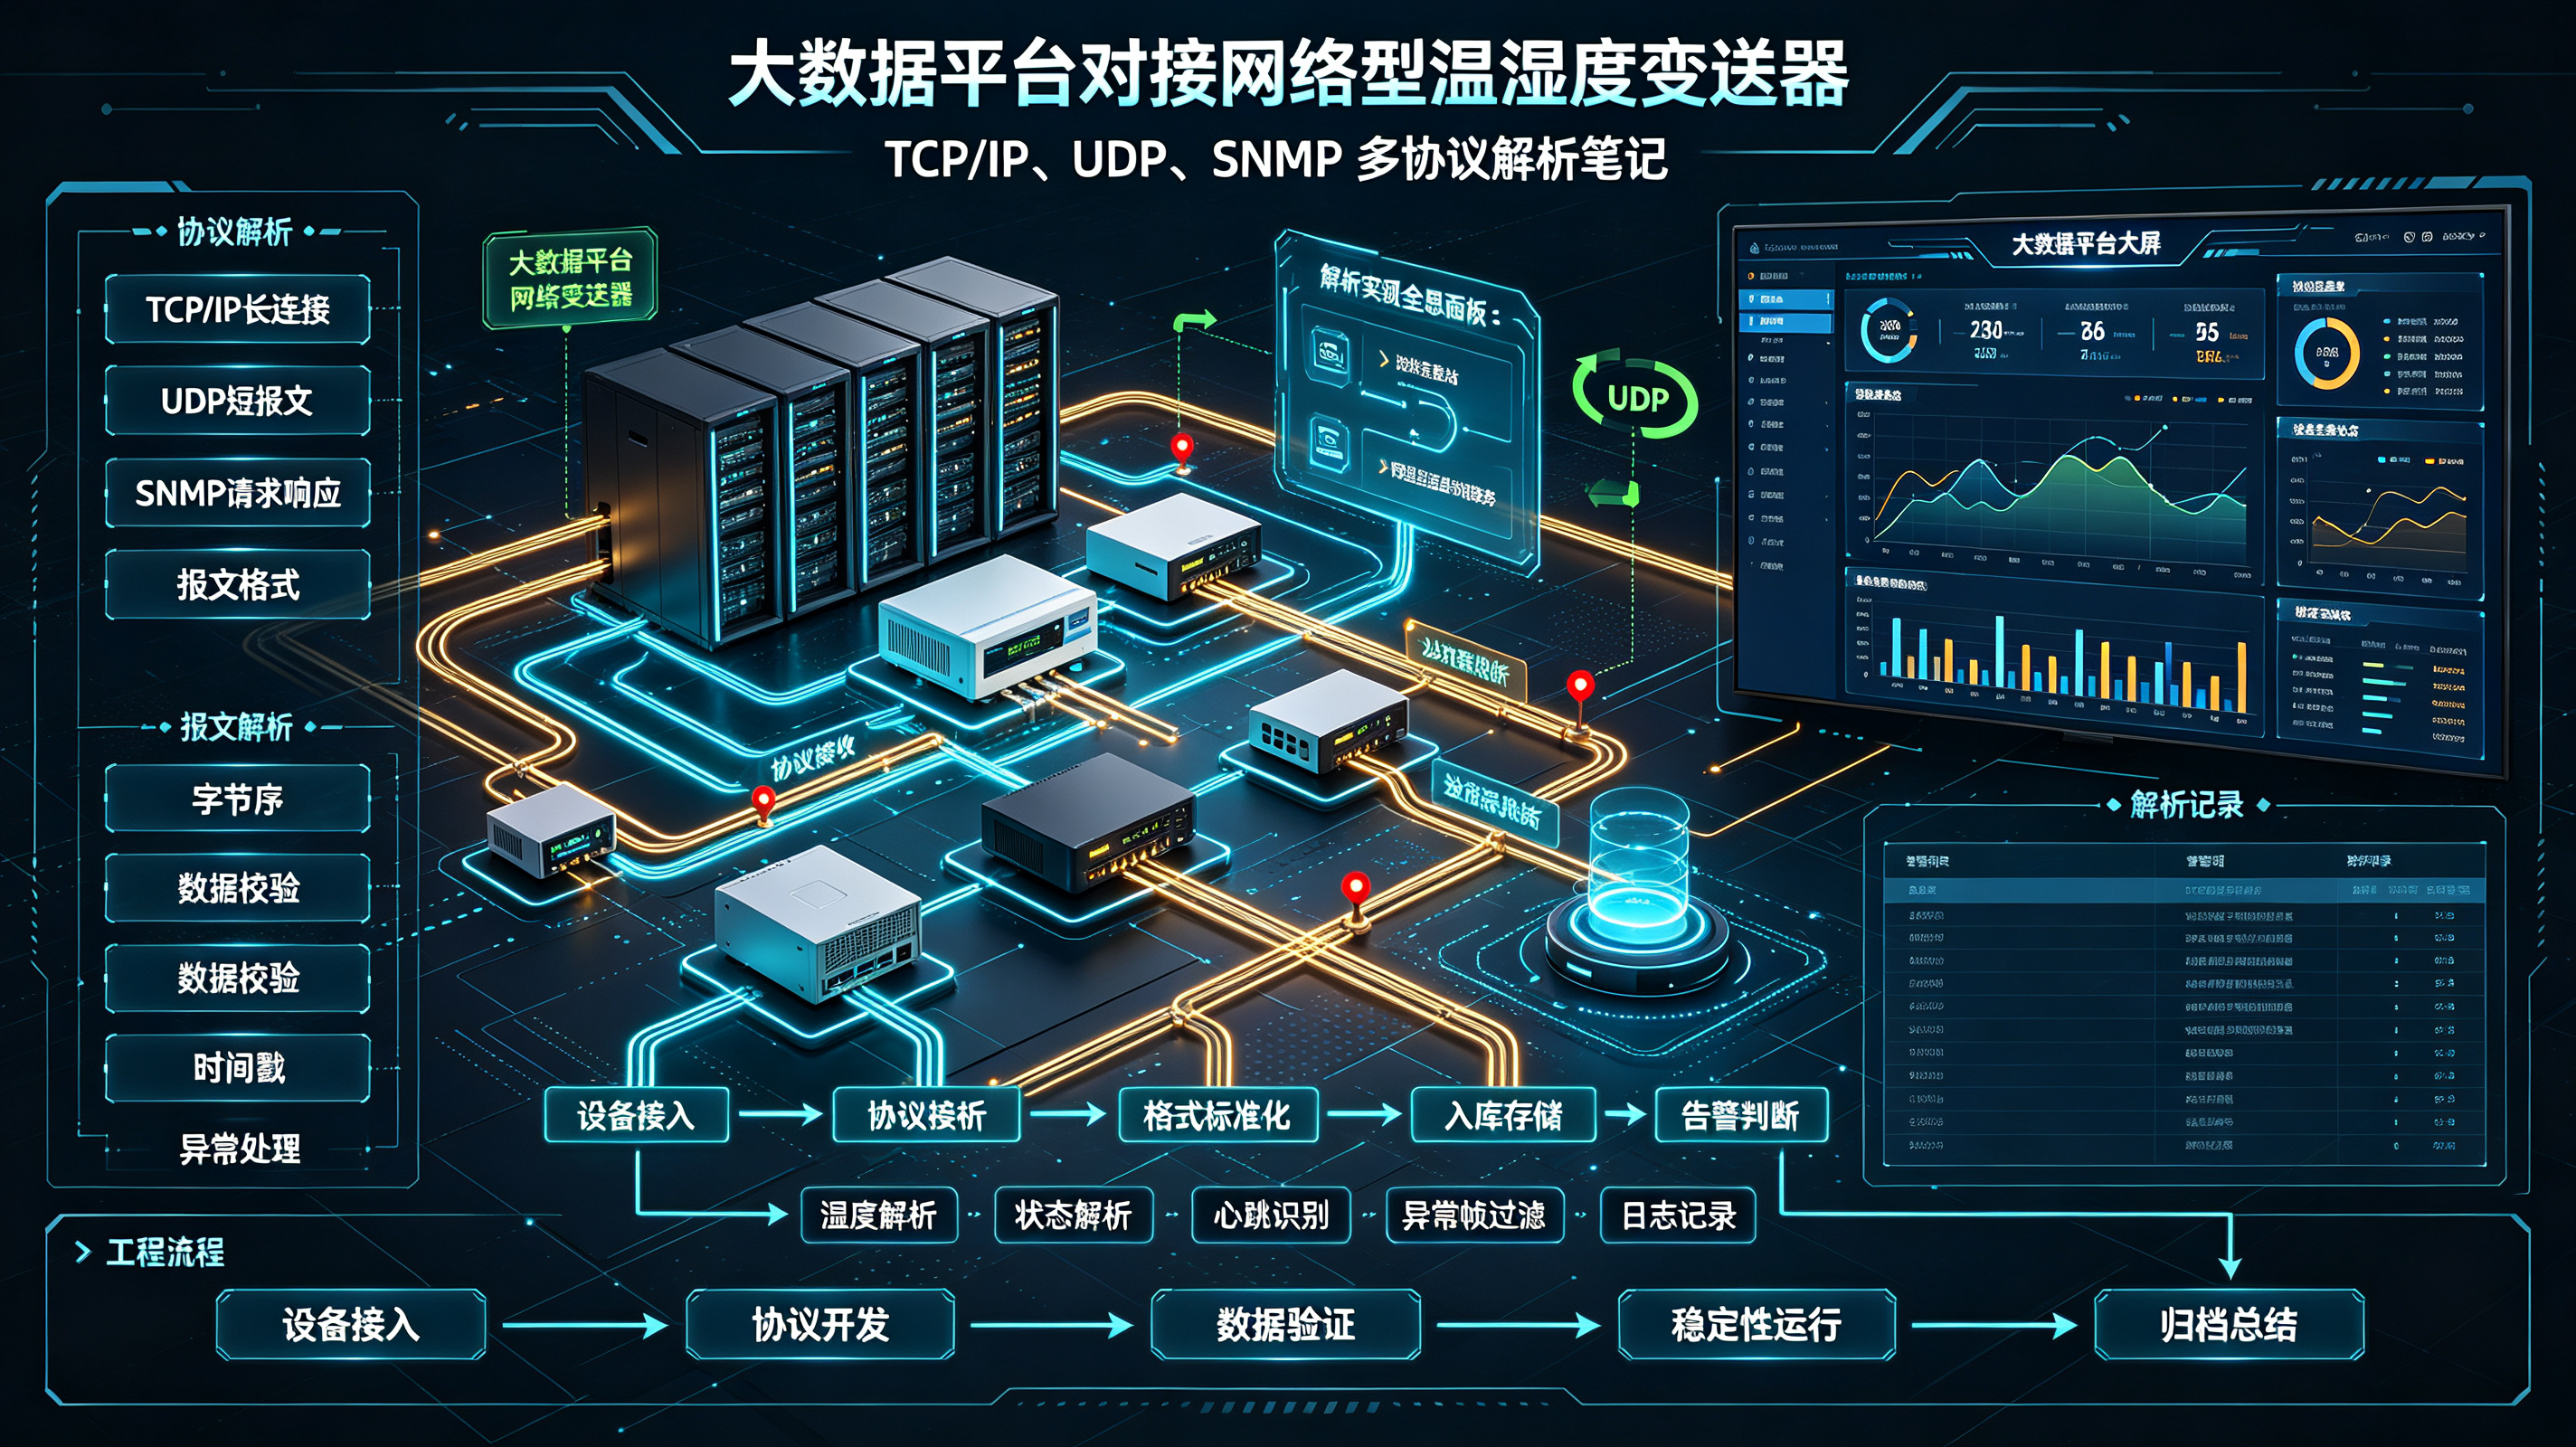
在接入之前,首先明确数据链路分层:感知终端层(网络型温湿度变送器,支持TCP Client/Server、UDP上报、SNMP Agent)→ 协议解析网关层(协议转换、报文解析、校验、清洗、归一化、削峰)→ 消息队列层(Kafka,解耦采集与计算)→ 大数据计算层(Flink实时处理、Spark离线分析)→ 存储层(时序库、数仓)→ 应用服务层(看板、告警、报表、预测模型)。协议解析网关是整个链路的核心,也是本笔记重点阐述的部分。
本方案遵循GB 50174-2017《数据中心设计规范》、DA/T 42-2022《档案库房技术管理规范》、GB/T 2887-2011《计算机场地通用规范》等行业标准,温湿度数据除支撑业务分析外,同时满足监管审计、合规追溯的数据留存要求。
二、三类协议报文基础特性对比与接入选型逻辑
网络型温湿度变送器的三类通信协议,在报文结构、连接模型、可靠性、资源开销、适配大数据场景的优缺点差异显著,在项目前期需要根据测点属性、网络环境、业务目标做选型,不建议全部设备统一使用单一协议。
2.1 TCP协议(面向连接流式传输)
TCP是面向连接、可靠的流式传输协议,具备三次握手、ACK确认、超时重传、拥塞控制、流量控制机制。变送器分为两种工作模式:TCP Client、TCP Server。
- TCP Client模式:变送器主动向解析网关监听端口发起长连接,周期上送报文,附带心跳包;适合跨网段、异地机房、电池室、档案室等高优先级测点,数据不允许丢失。
- TCP Server模式:网关作为客户端主动发起连接轮询查询;适合本地局域网、测点数量少、需要按需拉取数据的场景。
TCP的核心工程难点是无报文边界带来的粘包、拆包问题。TCP是字节流,操作系统缓冲区会把多条短报文合并,或者单条报文拆分,直接按换行符读取极易解析失败。因此所有私有TCP报文必须在应用层定义帧结构:帧头、长度域、有效载荷、校验和、帧尾。 标准帧结构示例: 0xAA 0x55 | len(1Byte) | devId(4Byte) | temp(2Byte) | humi(2Byte) | status(1Byte) | crc(2Byte) | 0x0D 0x0A 长度域标记载荷长度,解析程序读取到帧头之后,根据长度域读取完整报文,再做CRC校验,是解决TCP粘包的标准方案。
优点:可靠性高,断线自动重连,适合高价值测点;缺点:占用连接资源,测点上千规模时需要网关做连接池、空闲连接回收,连接泄漏会导致网关服务崩溃。
2.2 UDP协议(无连接数据报)
UDP属于无连接协议,没有握手、确认、重传机制,报文独立封装,天然不存在粘包问题,报文头部短小,CPU和网络开销极低,支持海量测点并发上报。变送器定时向网关UDP监听端口推送数据帧,一报一数据。 适合冷通道、机柜高密度测点、车间大面积环境监测,以趋势统计、批量分析为主,允许极低概率丢包的场景。
UDP短板十分突出:报文发出后无应答,网络抖动、交换机风暴抑制、ACL拦截都会直接丢包。在大数据链路中,丢包会造成时序断点,影响算法分析。对应的补偿方案:应用层增加序列号、时间戳;重要测点采用UDP上报+TCP兜底;网关侧记录报文丢失统计指标,上报监控系统。
UDP报文同样建议增加帧头、CRC校验,过滤广播报文、干扰乱码,避免脏数据进入Kafka,污染大数据链路。
2.3 SNMP协议(网管标准协议)
SNMP基于UDP,分为轮询GET/GET-NEXT和Trap主动上报两种模式,设备内置SNMP Agent,数据以OID树形节点定义。 轮询模式:网关作为SNMP Manager,定时向设备161端口发起请求读取OID;Trap模式:设备触发超限、断电等事件时,主动向网关162端口发送告警报文。 SNMP优势:标准化,Zabbix、Prometheus、各类国产动环平台原生支持,存量利旧场景改造成本低;缺点:浮点数支持差,行业通用做法是温湿度放大10倍以整数存储;Trap报文不可靠,属于单向UDP报文。 版本选型:内网VLAN内使用SNMPv2c简化部署;跨园区、跨专线链路统一使用SNMPv3,开启认证加密,规避团体字明文传输风险。
2.4 多协议选型矩阵(大数据平台接入场景)
测点类型 | 推荐协议 | 大数据侧关注点 |
|---|---|---|
蓄电池室、档案库房、精密实验室 | TCP Client | 数据完整性优先,断点续传,不能丢数 |
冷通道、机柜高密度海量测点 | UDP | 低开销、高吞吐,允许少量丢包,统计趋势 |
原有网管利旧、需要对接现有SNMP网管 | SNMPv2c/v3 | 兼容存量设备,告警Trap事件单独分流 |
异地跨专线远距离测点 | TCP Client | 单向出网,防火墙策略简单,心跳保活 |
超限告警事件 | TCP Trap/SNMP Trap | 事件单独标签,实时告警分流至Flink |
三、协议解析网关架构设计(多协议统一收口)
大数据平台不能直接暴露Kafka端口给前端大量变送器,存在安全风险、流量冲击、协议杂乱问题。因此必须独立部署协议解析网关,作为感知层和大数据平台的隔离层,网关的核心职责:多端口监听、协议识别、报文解析、校验过滤、数据归一化、标签注入、流量削峰、本地缓存、消息转发。 网关推荐采用微服务拆分,或者基于Netty、Go标准库、pysnmp开发,分为四大监听模块:TCP监听服务、UDP监听服务、SNMP轮询服务、SNMP Trap接收服务。
3.1 网关核心模块说明
- TCP监听模块:基于Reactor模型,维护连接池,每个连接绑定解析状态机,处理帧识别、粘包拆分、CRC校验、心跳检测、断线回收;心跳超时判定设备离线,生成离线事件。
- UDP监听模块:单端口或者多端口异步接收报文,校验帧头、CRC,提取设备数据;做限流,设置单IP报文速率上限,防止设备故障疯狂上送报文打满Kafka。
- SNMP轮询模块:基于协程池并发轮询,控制并发令牌,分级轮询周期;读取OID数值,完成数值换算(除以10还原温湿度);维护设备在线状态。
- SNMP Trap接收模块:监听UDP 162端口,解析Trap VarBind,区分告警事件、告警恢复,做防抖、去重,事件单独标记。
- 数据归一化模块:本模块是对接大数据平台的关键。TCP、UDP、SNMP解析出来的原始字段结构完全不一样,需要统一映射为标准JSON结构,统一字段名、单位、时间格式、标签体系。 标准化数据结构示例:
{
  "deviceId": "TH-2026001",
  "deviceType": "RJ45温湿度变送器",
  "protocol": "TCP",
  "ip": "192.168.50.12",
  "temp": 24.6,
  "humi": 48.2,
  "status": 0,
  "eventType": "data",
  "ts": 1763265600000,
  "tags": {
    "park": "一号园区",
    "room": "主机房A",
    "position": "A05机柜",
    "vendor": "盛世宏博"
  }
}eventType分为两类:data是周期采集的常规温湿度数据;alarm是超限、断电等告警事件,Flink任务可以根据eventType分流,实时告警流和时序数据流分开处理。
- 本地缓存与断点续传模块:网关内置Redis或者本地文件缓存,当Kafka链路中断、大数据平台故障时,报文缓存;链路恢复后批量续传,避免数据丢失,保障时序链路连续性。
- 监控指标上报模块:网关自身采集解析成功率、CRC错误率、TCP离线数、UDP丢包计数、SNMP超时数量,上报至Prometheus,监控网关解析服务健康状态。
3.2 网关部署模式
- 边缘分布式部署:每个机房部署一台边缘解析网关,只负责本机房变送器解析,归一化后再推送到中心Kafka集群。优势:隔离机房网络故障,流量本地化,专线只传输标准化JSON,不传输原始私有报文,安全、带宽压力小,是大数据项目推荐方案。
- 中心集中部署:所有变送器直接跨网段接入中心网关,适合测点数量少、园区集中的小型场景;不适合上千点位、异地多机房集群,容易出现网关单点压力过大、安全管控复杂。
四、各协议报文解析开发细节与代码示例
4.1 TCP报文解析(Netty/Go 状态机解析思路)
TCP流式解析不能按行分割,采用状态机: STATE_IDLE → 等待帧头0xAA 0x55; STATE_READ_LEN → 读取1字节长度; STATE_READ_PAYLOAD → 根据长度读取载荷+CRC; STATE_CHECK_CRC → CRC校验,校验成功提取数据,校验失败丢弃,记录错误日志; STATE_RESET → 回到空闲状态,等待下一帧。
4.2 UDP报文解析
UDP每次recv拿到完整报文包,直接校验帧头、长度、CRC,不需要处理粘包。开发注意:UDP报文存在分片、重复报文,需要依靠seq序列号去重。
4.3 SNMP OID解析(pysnmp示例)
SNMP读取OID之后,原始数值是放大整数,必须做换算。
from pysnmp.hlapi import *

def snmp_get(host, community, oid, timeout=0.5):
    errorIndication, errorStatus, errorIndex, varBinds = next(
        getCmd(SnmpEngine(),
               CommunityData(community),
               UdpTransportTarget((host, 161), timeout=timeout, retries=1),
               ContextData(),
               ObjectType(ObjectIdentity(oid)))
    )
    if errorIndication:
        return None
    for varBind in varBinds:
        raw_val = int(varBind[1])
        real_val = raw_val / 10.0
        return real_val
Trap解析使用snmptrapd或者pysnmp的Trap接收回调,提取varbind里的告警掩码、设备位置标签,封装为eventType=alarm的消息。
4.4 多协议适配层设计
项目中存在多品牌变送器,不同厂商TCP、UDP报文格式、SNMP私有OID不一样。网关内部维护设备配置表,根据deviceId、设备型号绑定对应解析脚本/解析模板,实现解析逻辑可配置,新增设备型号不需要修改网关主程序,只新增解析模板,降低迭代成本。
五、大数据侧数据处理链路:Kafka → Flink → 存储
标准化JSON消息由网关推送到Kafka,建议Topic分区按园区、机房拆分,分区键使用deviceId,保证同一个设备的数据进入同一个分区,时序顺序不乱。Topic分为两个:
env_data_topic:常规周期温湿度时序数据,高吞吐;env_alarm_topic:告警事件Trap、离线事件,低延迟,优先处理。
Flink实时计算任务处理逻辑:
- 数据清洗:过滤非法字段、空值、超出合理范围的异常值(温度<-10℃或者>60℃直接标记脏数据,写入脏数据Topic);
- 水位线与乱序处理:传感器时间戳、网关接收时间存在偏差,设置水位线,处理网络延迟带来的时序乱序;
- 实时指标计算:滑动窗口计算单机房平均温湿度、最大值、最小值、温湿度波动率;
- 告警规则二次校验:虽然设备本地已经做阈值判断,Flink侧做二次校验,防止传感器逻辑异常漏告警;
- 数据分流:清洗后的时序数据写入TDengine/ClickHouse,用于实时看板;同时写入Hive,供Spark离线做日/月趋势分析、能耗关联、报表统计。
脏数据治理是大数据链路非常重要的一环:CRC校验失败、数值越界、标签缺失、时间戳异常的报文统一写入脏数据Topic,定期回溯排查是设备故障、网络干扰还是解析模板bug,持续提升数据质量。
六、链路可靠性、流量控制与安全设计
- 流量削峰:网关侧限流,限制单IP上报频率;变送器上报周期错开随机偏移,避免整点全部设备同时上报,造成Kafka瞬时流量冲击;
- 消息确认:网关向Kafka发送消息开启ACK确认,只有Kafka返回写入成功,网关才认为上报完成,否则本地缓存重试;
- 网络安全:变送器全部划入独立动环VLAN,静态IP;网关是唯一对外访问Kafka的节点,终端不能直接访问大数据集群;SNMPv2c团体字仅在内网VLAN,跨专线使用SNMPv3;网关关闭不必要端口,访问Kafka使用SASL认证;
- 时间同步:所有变送器、解析网关、大数据服务器统一对接NTP时间服务器,时间偏差控制在100ms以内,否则时序数据时间戳错位,趋势分析、关联分析失效;
- 监控告警:对解析成功率、脏数据占比、Kafka堆积、网关CPU、内存、SNMP超时率配置监控告警,链路异常提前感知。
七、高频踩坑记录(工程笔记重点)
- TCP粘包处理简单粗暴,直接按换行分割,高并发下大量解析失败,脏数据持续涌入Kafka;
- SNMP读取数值忘记除以10,温度256被识别为256℃,触发大量虚假告警;
- 多协议混合接入,字段没有归一化,上游协议一变,下游Flink、数仓全部要改代码;
- 不做本地缓存,Kafka短暂故障时,大批量数据直接丢失,时序出现断点;
- Trap告警只依赖SNMP Trap,没有轮询兜底,UDP丢包导致告警漏报;
- 设备时间未同步,传感器本地时间混乱,时序曲线错位,大数据分析结果失真;
- 未做限流,某一台变送器程序异常疯狂上送UDP报文,占满Kafka带宽,影响全部测点;
- 直接把原始报文写入大数据平台,没有标签体系,后续无法按机房、机柜做分组统计。
八、扩容、运维与版本迭代
网关服务支持水平扩容,Kafka分区充足的前提下,新增解析网关节点分担解析压力;新增机房只需要部署边缘网关,配置解析模板,对接现有Kafka集群,上层Flink、数仓逻辑不需要改动。 运维层面维护设备元数据平台:deviceId、IP、位置、协议类型、解析模板、阈值、安装时间,和大数据标签体系打通;所有解析日志、脏数据日志、Kafka消息日志留存,用于故障回溯。 迭代思路:优先标准化协议和JSON结构,底层协议细节收敛在网关内部,大数据计算层只消费统一格式消息,实现“感知层协议变化,上层大数据业务无感知”,这也是多协议接入架构的核心价值。
九、笔记总结
网络型温湿度变送器TCP、UDP、SNMP多协议接入大数据平台,核心思路是网关收口、协议隔离、归一化先行。TCP适合高可靠测点,UDP适合海量低优先级测点,SNMP适合存量网管利旧场景,三类协议不存在绝对优劣,需要混合搭配。 协议解析的难点不在于单个报文读取,而在于大规模集群下的稳定性、脏数据治理、时序保序、链路兜底。将协议解析、校验、过滤全部下沉到边缘网关,向上游大数据平台输出统一标准化时序消息,能够极大降低大数据计算任务的复杂度,让Flink、Spark聚焦在数据分析、预测、指标计算等业务价值环节,而不是处理五花八门的私有报文。 这套接入方案可复用在大数据机房、智能制造车间、智慧档案馆、医药GSP库房等各类环境感知大数据项目,是环境物联网对接大数据平台成熟的落地架构。
关键词:物联网,大数据平台,网络型温湿度变送器,TCP,UDP,SNMP,多协议解析,协议网关,时序数据,Kafka,Flink,机房动环,盛世宏博
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号