发票查验系统通过OCR和税务通道实现自动识别与验证,解决人工审核繁琐、易出错的问题
原创
发票查验系统通过OCR和税务通道实现自动识别与验证,解决人工审核繁琐、易出错的问题
原创
中科逸视OCR
发布于 2026-11-16 17:55:53
发布于 2026-11-16 17:55:53
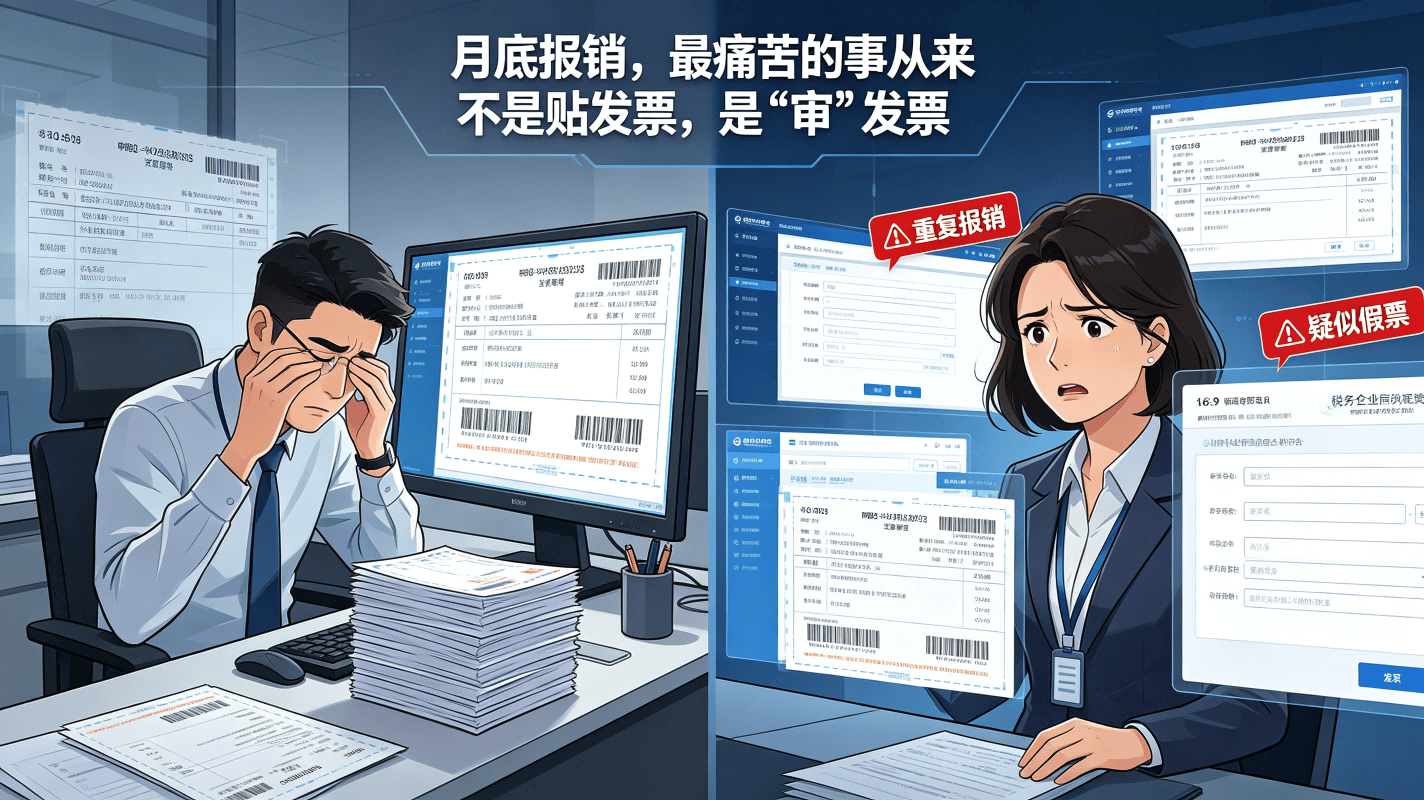
月底报销,最痛苦的事从来不是贴发票,是"审"发票。
员工这头,拍完照填单子,发票号、税号、金额、日期,一项一项抄,抄到第三十张,眼睛开始把"8"看成"3"。财务那头更惨:几百张票,张张要验真伪,逐张登录税务平台手工录入,还要防着有人拿一张票报两次销、拿一张假票蒙混过关。
纸质票好歹还能捏一捏、对着光看一看,可现在满大街都是电子发票、全电发票,连"摸"的机会都不给。发票造假这门"手艺",成本越来越低,坑越来越大。
于是就有了发票查验系统。让机器来干这个活——发票一上传,几秒钟告诉你这张票是真是假,票面上有什么,顺便把数据整整齐齐地填进系统。今天我们就拆开中科逸视的发票查验系统看看,它到底是怎么运转的。
先说清楚:查验一张发票,机器要干两件事
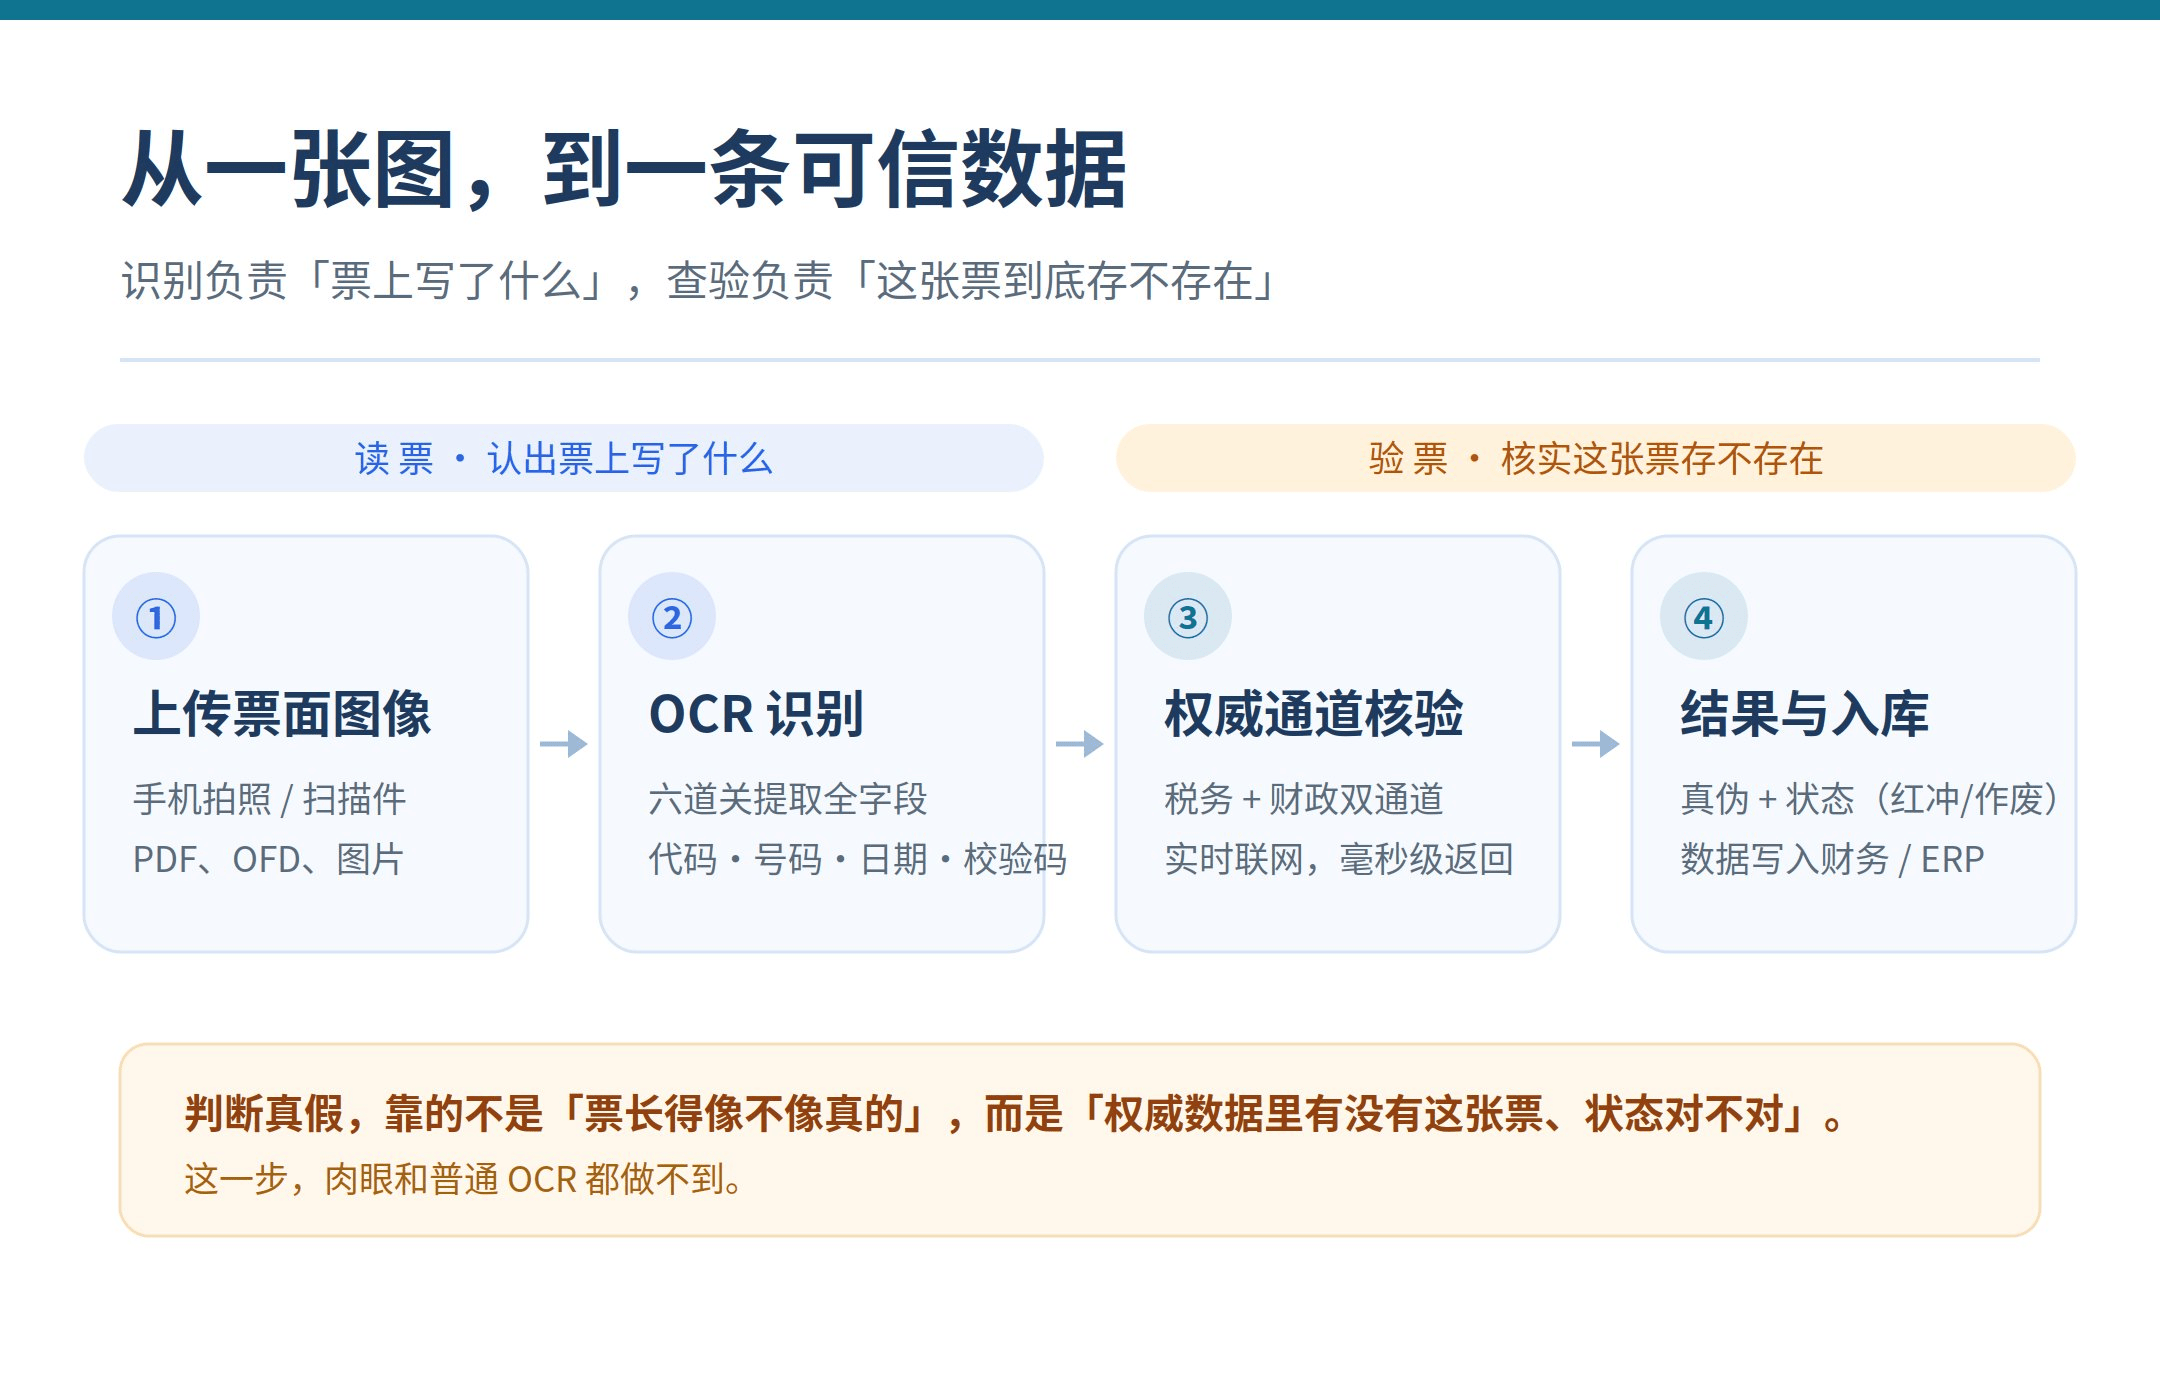
很多人以为"发票查验"就是去官方平台输个号码点一下查询。其实对机器来说,完整流程分两段:
- "读票":把发票图片上的信息认出来、提取出来——发票代码、号码、开票日期、校验码、金额、税额、购销双方……
- "验票":把这些信息送到权威数据通道去核对,确认这张票真实存在、状态正常(没作废、没红冲),再返回全票面的结构化数据。
第一段靠的是 OCR(光学字符识别),第二段靠的是直连税务权威通道的查验能力。系统把这两段串成了一条流水线:上传图片 → 自动识别 → 自动验真 → 返回结构化数据,全程不用人动手。
下面分段细说。
技术原理(上):机器是怎么"看懂"一张发票的
先泼一盆冷水:发票可不是一张普通的"带字的纸"。它有几个出了名难缠的地方:
- 结构复杂:它本质是一张表格,有表头、有表体、有合计行,还有跨行跨列的合并单元格;
- 逻辑严密:"金额 + 税额 = 价税合计",这几个数之间是有约束关系的;
- 成色感人:印章盖在字上、纸有折痕、拍照是歪的、办公室灯还不太亮;
- 版式五花八门:专票、普票、全电发票、火车票、机票行程单、财政票据……长得都不一样。
所以普通 OCR 在这儿不太够用——它只是个"认字工具",能把字抠出来,但不知道哪个字属于哪一栏,更搞不懂"含税"和"不含税"的区别。打个比方,普通 OCR 像一位视力极佳但完全不懂财务的抄写员:字抄得漂亮,账还得你自己对。
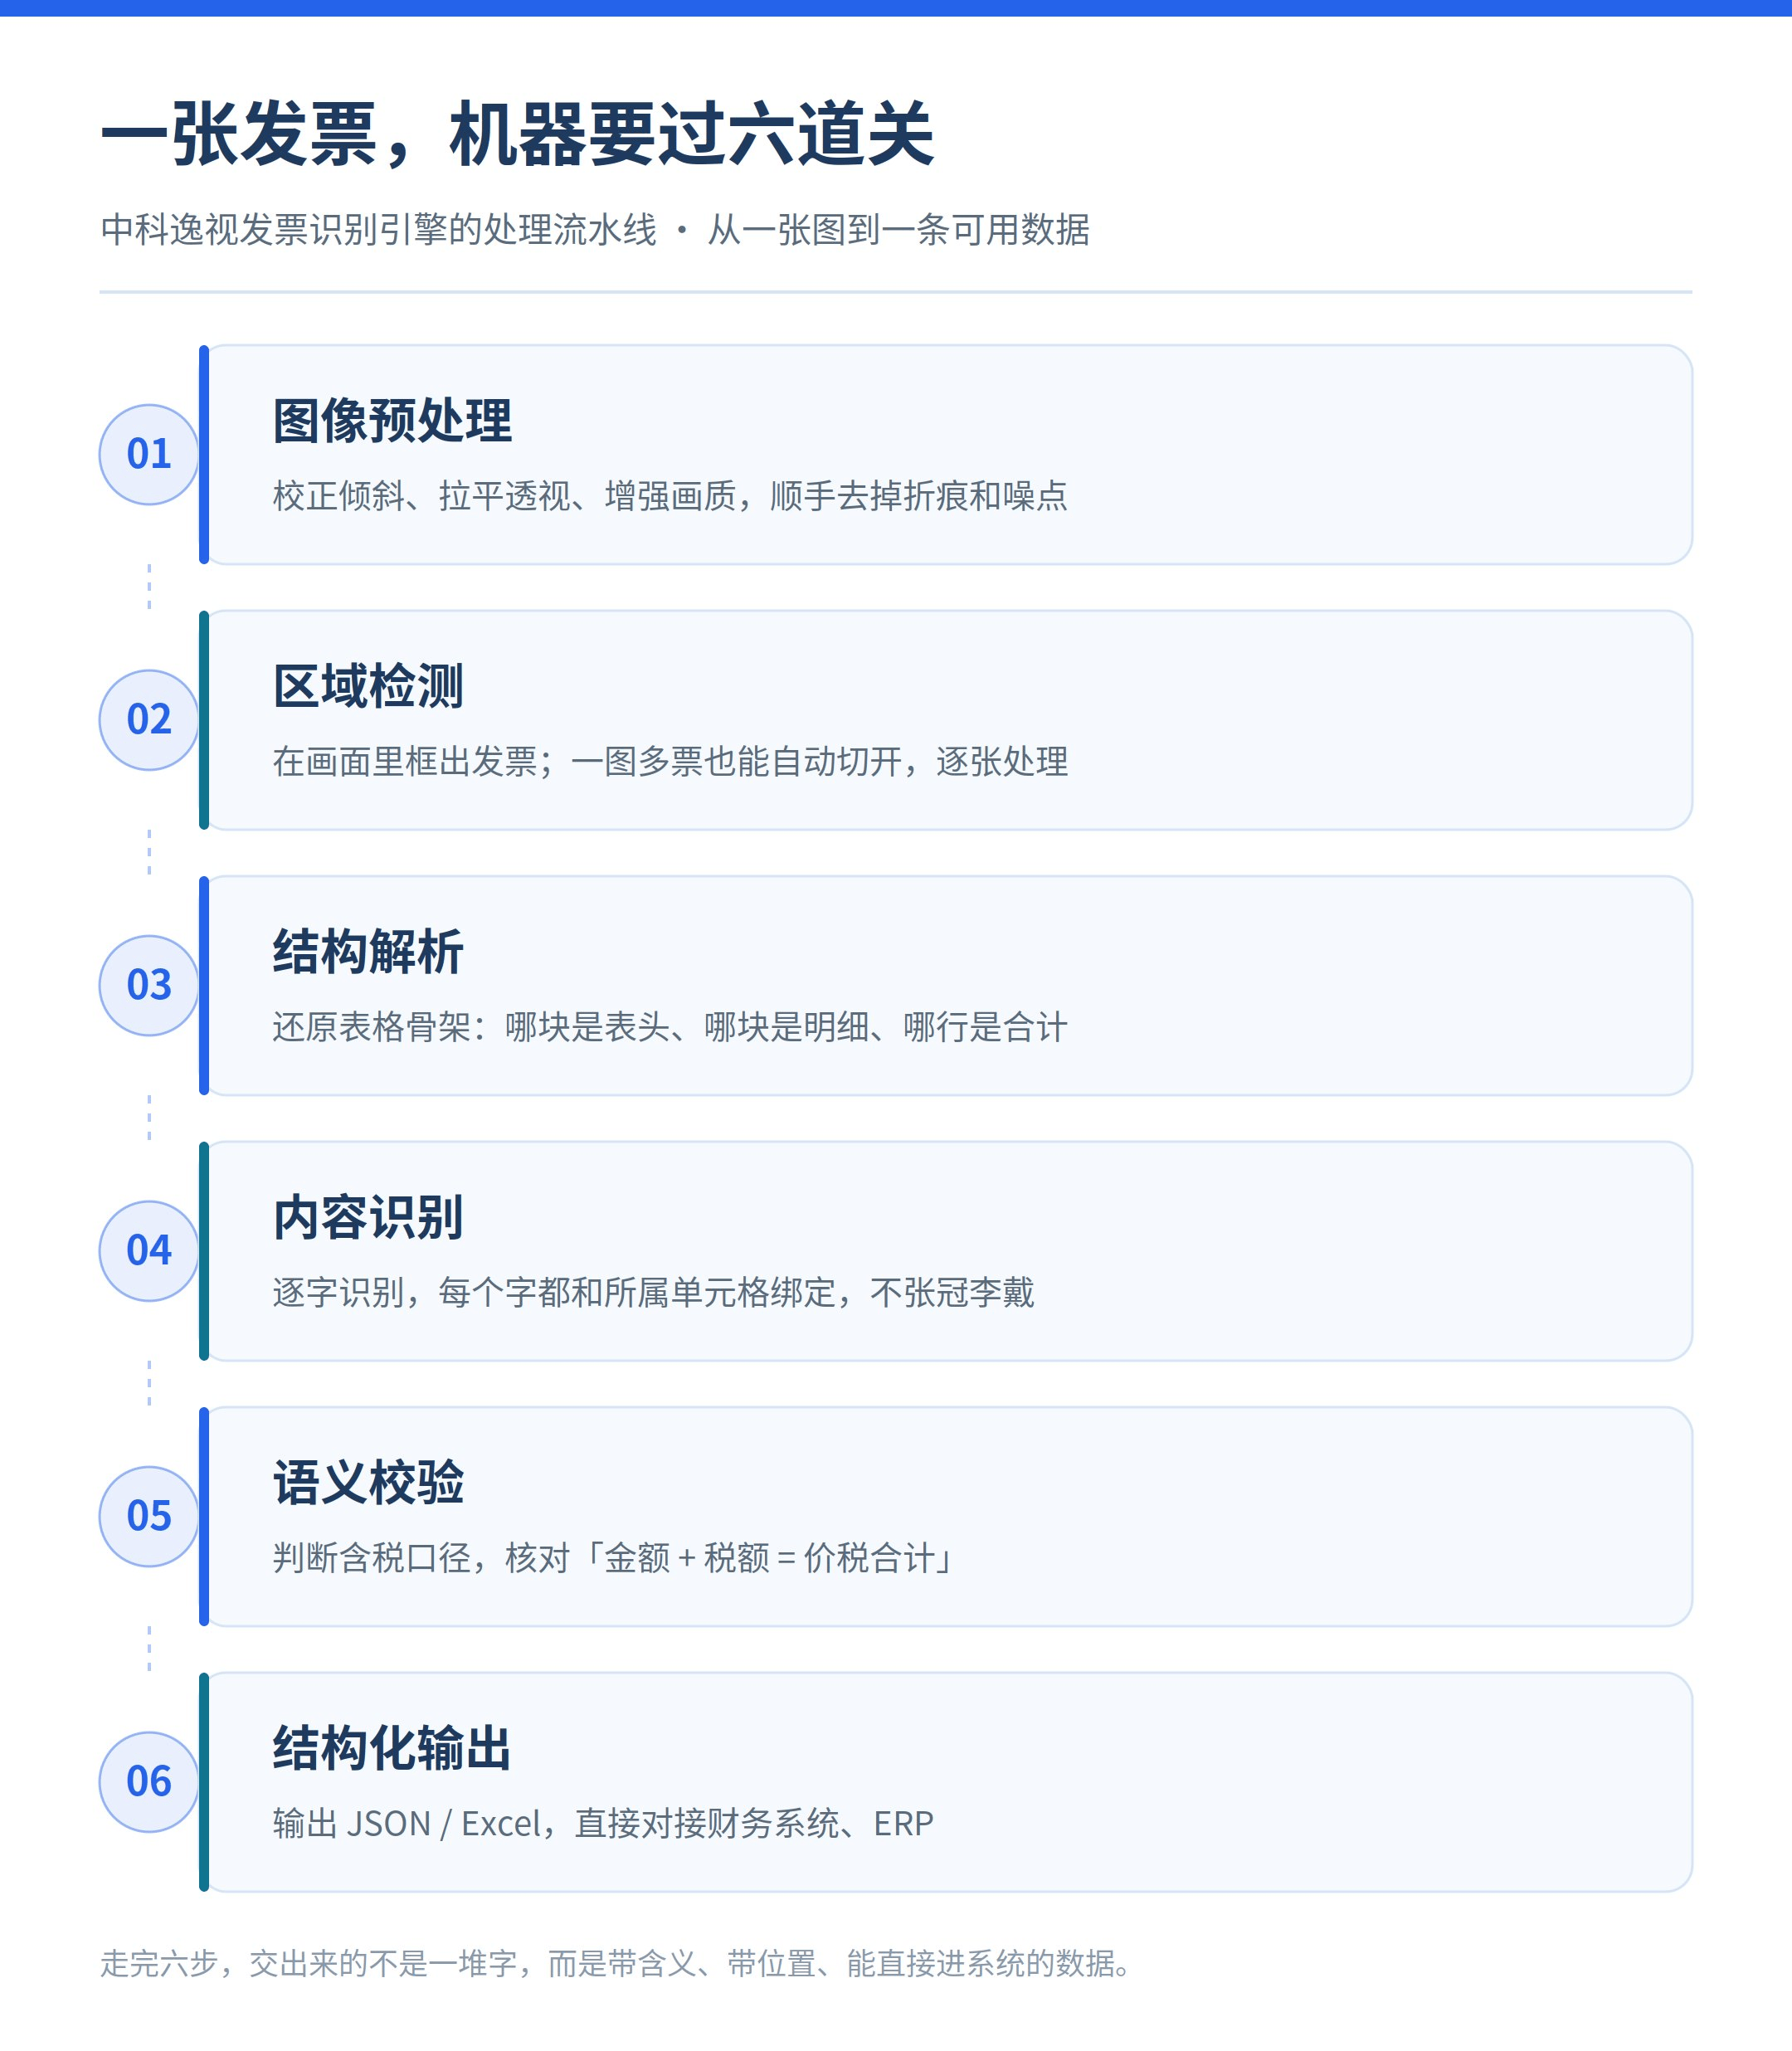
发票识别引擎要做的是"理解",流程可以拆成六道关:
第一道关:给发票"洗把脸"(图像预处理)
系统先用几何校正技术把拍歪的画面扶正,用图像增强把模糊区域"补"清楚,再去掉折痕、污渍和噪点的干扰。扫描件也好、随手拍也好,统统处理成 AI 最"顺眼"的样子。这步看似不起眼,却决定了后面所有环节的下限。
第二道关:找到发票"在哪里"(目标检测)
画面干净了,接下来要在整张图里把发票框出来,和背景、桌面、贴纸区分开。更实用的一点:一张照片里要是堆了五张发票,系统能自动把它们一一"切"开,逐张处理——对喜欢把票摞在一起拍的财务同事相当友好。
第三道关:读懂发票的"骨架"(表格结构解析)
系统先把每个单元格切出来、定好位,再把每个单元格当成图上的一个"节点",分析它们之间上下左右的邻接关系,推理出整张票的逻辑骨架——哪块是表头、哪块是商品明细、哪行是合计。连无边框表格、嵌套表格也能稳定解析。
就像玩拼图:不仅要认出每块碎片上的图案,还得知道每块应该拼在哪儿。
第四道关:一个字一个字地"读"(文字识别)
骨架搭好,开始填内容。识别引擎针对发票上常见的小号字体、倾斜文字、被印章压住的字都做了专项优化,印刷体识别准确率能达到 99.5% 以上。关键在于:识别出的每个字都和所属单元格精准绑定,不会"张冠李戴"——数字认得再准,填错格子也是白搭。
第五道关:让它"读懂",而不是"看见"(语义理解与校验)
系统不只提取文字,还理解含义。识别出"1000"之后,会根据旁边的"含税/不含税"标签判断它到底指什么;还会自动核对"金额 + 税额 = 价税合计",账对不上就报警。遇到被印章挡住、置信度不高的字,它能靠上下文"猜"个八九不离十——就像人读书遇到不认识的字,看前后文也能明白个大概。
第六道关:翻译成电脑能懂的话(结构化输出)
最后,所有信息被整理成标准格式输出:JSON、CSV、Excel 都行。发票代码、号码、日期、购销方、金额、税额、商品明细,一项项标好字段,直接对接财务系统、ERP、报销平台。它交出来的不是一堆字,而是带含义、带位置、能直接进系统的数据。
技术原理(下):真伪是怎么"查"出来的
识别只能解决"票上写了什么",解决不了"这张票是不是真的"。造假者完全可以打印一张看起来天衣无缝的假票——票面上每个数字都对得上,但税务系统里根本没有这张票。
所以查验系统的核心,是一条直连税务权威通道的数据链路:
- 系统把发票代码、发票号码、开票日期、校验码(或金额)这几项"查验要素"提交给权威数据源;
- 数据源实时联网核对,返回这张票的真伪状态,以及全票面的结构化信息;
- 除了"真"和"假",还能查到票的状态:是否红冲、是否作废——这两个坑,肉眼根本看不出来。
也就是说,判断真假的依据不是"票长得像不像真的",而是"权威数据里有没有这张票、它的状态对不对"。这是查验和人工目测最本质的区别。
几个值得单独说的技术细节:
- 财税一体,一个接口通查:除了增值税专票/普票、全电发票、电子客票、区块链发票这些"税务口"的票,系统还接入了财政票据查验通道——医疗收费票据、非税收入票据、社会团体票据这些"财政口"的票也能验。对保险理赔这类天天跟医疗票据打交道的行业,这一点特别要紧。
- 安全合规:查验过程全程加密传输,不留存敏感数据,符合 ISO 27001 信息安全管理标准——财务数据这种东西,过手不留底,才让人放心。
- OCR 与查验联动:两段流程打通之后,"识别→验真→查重→入库"一次跑完,人工成本和错漏风险一起降。
功能特点:几个让人踏实的地方
- 票种全:支持 30 多种票据,从增值税专票、普票、全电发票,到火车票、机票行程单、出租车票,再到医疗财政票据,覆盖全国各省市版式,基本来者不拒。
- 够快:单张识别 1 秒以内,查验毫秒级响应。财务月末集中报销、电商大促海量核验,批量跑几千张也稳得住。
- 皮实:折痕、遮挡、光线暗、拍摄歪,靠多尺度特征融合和鲁棒性训练照样能认,关键字段(金额、税号)准确率 99% 以上。
- 能查重:一张票报两次销,是很多公司的老bug。系统查验时顺手把重复报销也筛出来。
- 好接入:提供标准化 API、SaaS 平台、移动端多种接入方式,能和用友、金蝶等主流 ERP 无缝对接,开发者最快 1–3 天就能联调上线。
- 可私有化:数据不出内网,模型跑在本地服务器上,对数据敏感的企业和机构更放心。
应用领域:谁在用它,用在哪
发票查验听起来是财务的事,实际触角比想象的长:
- 企业报销:员工手机拍一下,系统自动识别、自动验真、自动填单,报销周期从"按天算"缩到"按分钟算"。
- 财务共享与账务处理:发票扫描上传后自动完成"识别→验真→查重→入库",凭证自动生成、自动归档,会计不用再当人肉打字机。
- 保险理赔:批量核验医疗财政票据真伪,自动读取票面数据做理赔核算。有保险公司试点后,理赔周期从 15 个工作日缩短到 2–3 天。
- 金融风控:银行和供应链金融企业批量解析上下游交易发票,核验贸易背景真实性,防的就是"虚构交易骗贷款"。
- 代账公司:一家代账公司管上百家企业的账,海量票据批量识别、批量查验、自动生成记账凭证,人力成本降得很直接。
- 政务与事业单位:政府机关、医院、学校的凭证电子化归档,结构化存档后支持关键词检索、票据溯源,虚假票据和重复报销的发现率大幅提升。
写在最后
说到底,发票查验系统在做一件很朴素的事:让机器替人看票、查票,而且看得更快、更准、更不累。
技术上,它把"认字"升级成了"理解"——先看清发票长什么样,再读懂每一栏在说什么,最后拿着这些信息去权威通道核实真伪。体验上,它把"逐张手工录入、逐张登录平台查询"这种活儿,压缩成了一次拍照、一个接口调用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号