代码多三成,交付原地踏步:AI 编程的验证税
原创
代码多三成,交付原地踏步:AI 编程的验证税
原创
顺势而为
发布于 2026-11-16 21:58:28
发布于 2026-11-16 21:58:28
摘要:四份 2026 年报告结论互相打架,其实量的是四件不同的事。把度量层级摊开后,唯一被同时指认的约束不是模型能力,而是几乎没被自动化的验证带宽。本文拆解验证税的成因、METR 结论的口径纠偏,以及一套可落地的门禁分层做法。
先看四组出自 2025–2026 年正式研究、却指向四个方向的数字。
METR 的随机对照试验说,资深开发者用上 AI 反而慢了 19%。LinearB 的遥测说,重度用 AI 的开发者每周合并的 PR 同比多了近一倍。哈佛覆盖 718 家企业的研究说,代码行数涨了 30%,真正交付的业务需求却没有统计上显著的变化。DORA 官方报告则说,AI 采纳率每提高 25%,交付吞吐反而下降 1.5%、稳定性下降 7.2%。
一位技术负责人在 36 氪的报道里讲得更直白:「AI 越写越快,我们反倒越来越不敢合代码了。」
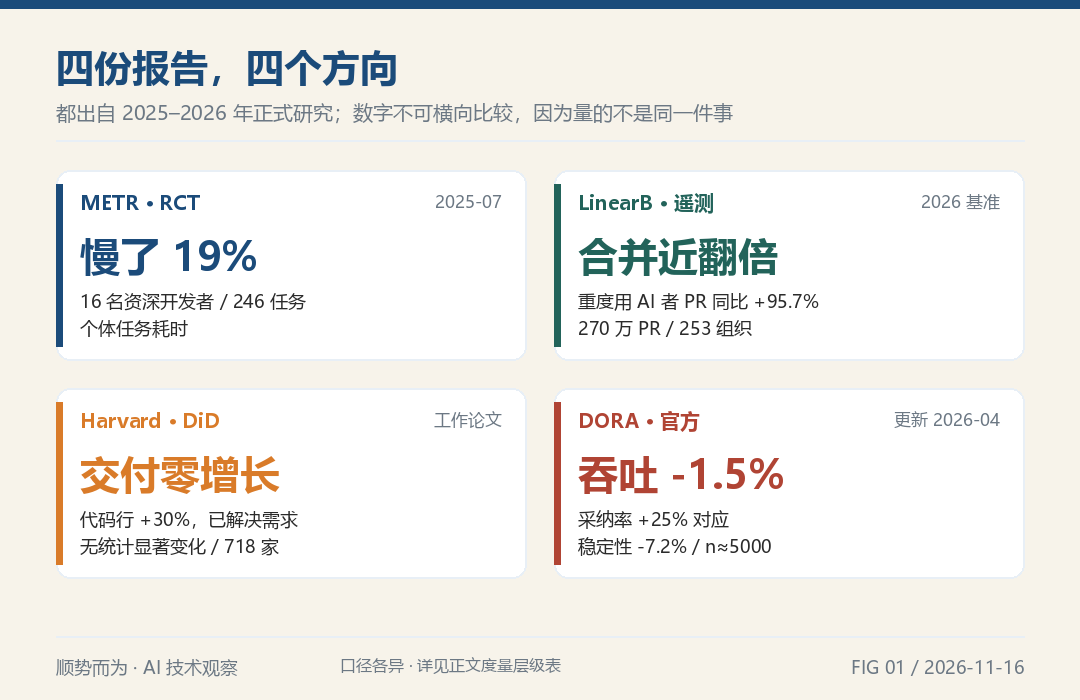
四份研究给出四个方向的数字:19% 变慢、合并近乎翻倍、代码 +30% 而交付零增长、采纳率对应吞吐下滑
只挑一组,可以轻松写出「AI 没用」或「AI 封神」,但都不诚实。本文想做件更笨的事:把四份研究摆到同一张桌上,看清各自量的是什么,找出被同时指认的那个约束。
结论先放这里:生成已自动化,验证还是人肉。AI 编程真正的成本,搬到了「写完之后」。
01 四份报告在吵什么
先把冲突摆清楚,它本身就是信号。
METR 那 19% 出自 2025 年 7 月的随机对照试验:16 名资深开源开发者、246 个真实任务,在熟悉多年的大型仓库(平均 2.2 万星、百万行以上)里,任务随机分配「允许用 AI」或「禁止用 AI」,全程录屏,报酬每小时 150 美元。结果允许用 AI 的一组耗时多出 19%。更刺眼的是感知差:开发者事前预期提速 24%,做完之后仍坚信自己提速了 20%。
LinearB 的 2026 基准报告来自 270 万个 PR、8.3 万名开发者、253 家工程组织:AI 用在 75% 以上编码日的开发者,到 2026 年 5 月合并速率是 2025 年 6 月的 2.3 倍,中位数同比提升 95.7%;完全不用 AI 的那组反而下降 3.6%。
哈佛的工作论文用另一套方法:Jellyfish 平台约 3 亿条工作事件、72 万余名员工、718 家企业,跨度 2021 年 1 月到 2026 年 3 月,用渐进双重差分比较企业采用编码智能体前后。结果代码行 +30%、提交 +20%、PR +23%,但已解决的 Jira 问题与 epic 数量没有统计上显著的变化。
DORA / Google Cloud 官方页面(最后更新 2026 年 4 月 13 日)则写着:AI 采纳率每提高 25%,与交付吞吐下降 1.5%、交付稳定性下降 7.2% 相关;39% 的开发者对 AI 输出「有点信任或完全不信任」。
四组数字,四个方向,看似学界和厂商互相打脸。但「效率」在四份研究里根本不是同一个变量。
02 一张度量层级表:它们量的是四件事
把它们按「分析层级 — 因变量 — 方法 — 能推出的结论」排开,冲突就消解了大半。
研究 | 分析层级 | 实际因变量 | 方法 | 不能推出的结论 |
|---|---|---|---|---|
METR (2025-07) | 个体任务 | 单个 issue 实现耗时 | RCT,16 人 / 246 任务 | 不外推行业整体,不外推 2026 年工具 |
DORA (2026-04 官方页) | 组织交付 | 吞吐、稳定性、自报信任 | 问卷,n≈5000 | 相关性非因果 |
Harvard / Jellyfish (2026-08 工作论文) | 企业产出 | 已解决需求数、合并耗时 | 观察性 DiD,718 家 | 未评审,样本为平台客户 |
LinearB (2026 基准) | 代码流水线 | PR 合并率、等待评审时长 | 遥测,810 万 PR | 相关性,客户自选样本 |
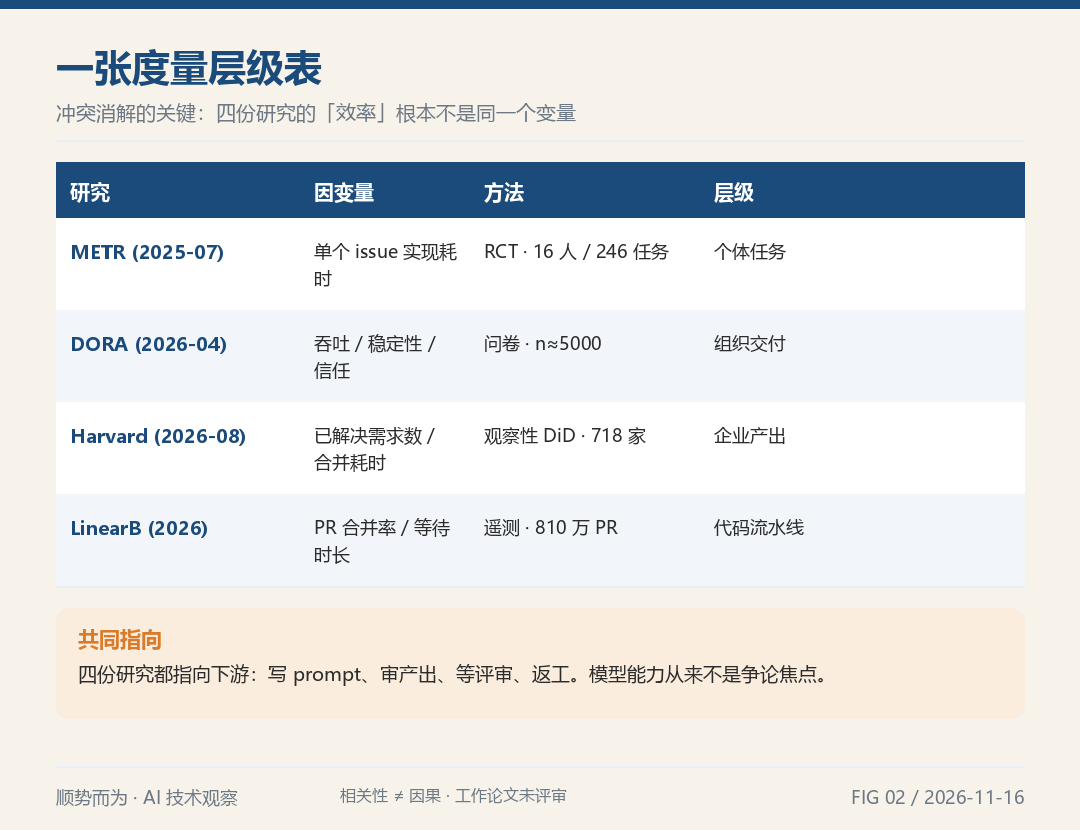
度量层级表:四份研究分别量个体任务耗时、组织吞吐、已解决需求数、PR 合并率,方法与可外推范围各不相同
看清楚这张表,有三件事浮出来。
第一,个体快不等于组织快。METR 量「一个人做完一个任务花了多久」,Harvard 量「一家公司交付了多少需求」,中间隔着评审、测试、集成、发布、审批整条流水线。个人省下的时间完全可能在队列里被吃掉。
第二,「产出代码」和「交付软件」是两种东西。LinearB 说合并的 PR 变多,Harvard 说解决的需求没变多,两者可以同时为真——同一批需求被拆成更多更大的 PR,或多出来的 PR 里相当一部分根本没合进去。
第三,也是最关键的:四份研究都把手指指向下游。METR 录屏发现时间从「写代码」挪到「写 prompt、审 AI 产出、等响应」;Harvard 发现 PR 到合并耗时涨 49%、打回修改近乎翻倍;DORA 把「审查更大批量更难」写成不稳定性的机制假设;LinearB 发现智能体 PR 等评审久得多。模型能力从来不是争论焦点,「写完之后」才是。
03 口径纠偏:METR 自己撤回了「19% 变慢」
这里插一段很少被中文文章写进去、却最该知道的一条。
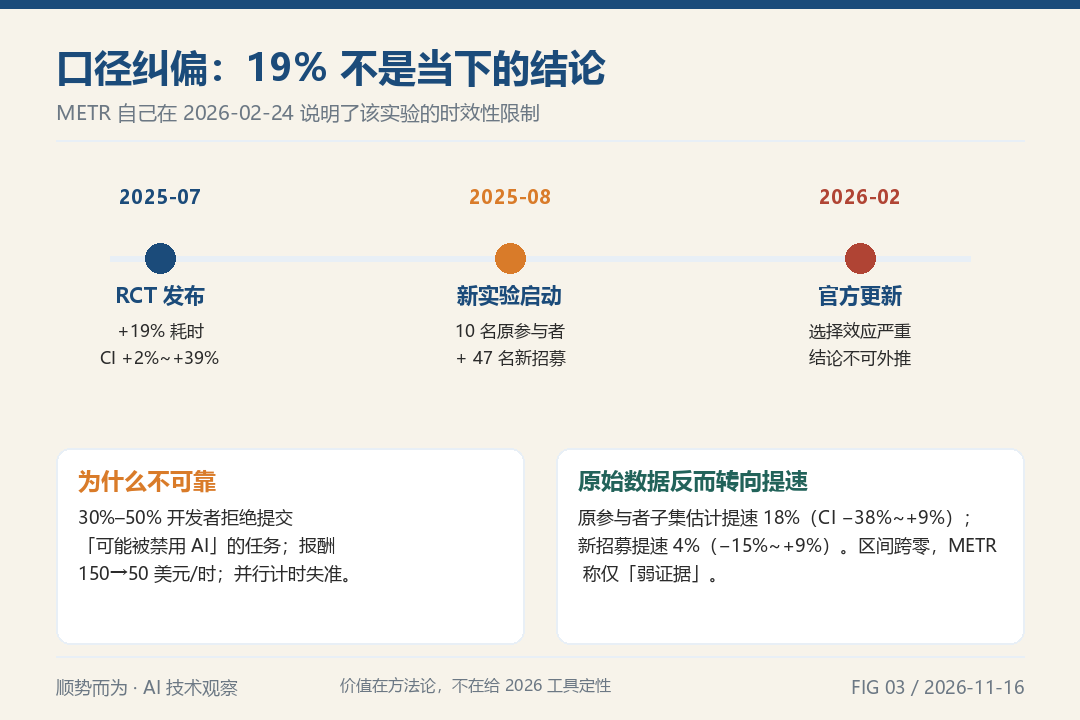
METR 时间线:2025-07 的 19% 变慢结论,到 2026-02 官方更新说明其时效性受限,新实验因选择效应给出不可靠信号
METR 在 2026 年 2 月 24 日发了官方更新《我们正在改变开发者生产力实验的设计》,说得很坦白:19% 是「early-2025 AI 能力在某一个相关场景下的快照」。他们 2025 年 8 月启动新实验(10 名原参与者 + 47 名新招募,报酬降到每小时 50 美元),却因严重选择效应给出不可靠信号——30%–50% 的开发者不愿把某些任务提交进「可能被禁用 AI」的实验组;报酬下调影响样本;多智能体并行时耗时记录也不可靠。
原始数据方向甚至反过来了:原研究 +19%(置信区间 +2% 到 +39%);原参与者子集在新实验里估计为提速 18%(−38% 到 +9%);新招募者提速 4%(−15% 到 +9%)。两个新估计的置信区间都跨过零,METR 明确说这只是「弱证据」。
所以正确写法是:「19% 变慢」是方法论上极有价值、但结论已被作者限定时效的实验。它的价值在于揭示「感知差 39 个百分点」这个认知陷阱,不在于给 2026 年的工具定性。国内 10、11 月一批文章仍把它当作当下事实引用,本身就是一次口径事故。
顺带一个更小的坑:LinearB 的「96%」指合并 PR 数量同比中位数 +95.7%,不是「效率提升 96%」。写成「提速 96%」,恰好又踩回度量陷阱。
04 瓶颈没有消失,它换了个位置
为什么四份研究会在下游汇合?因为这是一条老定律。
约束理论说:任何系统都有一个环节决定整体吞吐量,局部加速非瓶颈环节不会提升系统产出,只会让在制品在瓶颈前堆积。阿姆达尔定律是同一件事的数学形式——无法并行化的那部分决定加速比上限。
软件交付是一条串行链:需求定义 → 编码 → 评审 → 测试 → 集成 → 部署 → 监控。AI 把「编码」压到接近零成本,其余环节几乎原样,压力全挤到评审这个固定容量的闸门上。
数据卡片|瓶颈迁移的实测(哈佛工作论文,Jellyfish 遥测,718 家企业)采用编码智能体后:代码行 +30%、提交 +20%、PR +23%;已解决 Jira 问题/epic 无统计显著变化(可排除大于约 12% 的增长) PR 从提出到合并耗时 +49%(约 7 天 → 10.5 天);打回修改占比近乎翻倍(13% → 约 25%);每 PR 评论 +35%;企业约多抽 14% 人力进评审 口径:未同行评审的工作论文、观察性 DiD、样本为 Jellyfish 客户、仅软件业、窗口约一年;作者区分「更多代码」与「单位代码问题率更高」两种效应
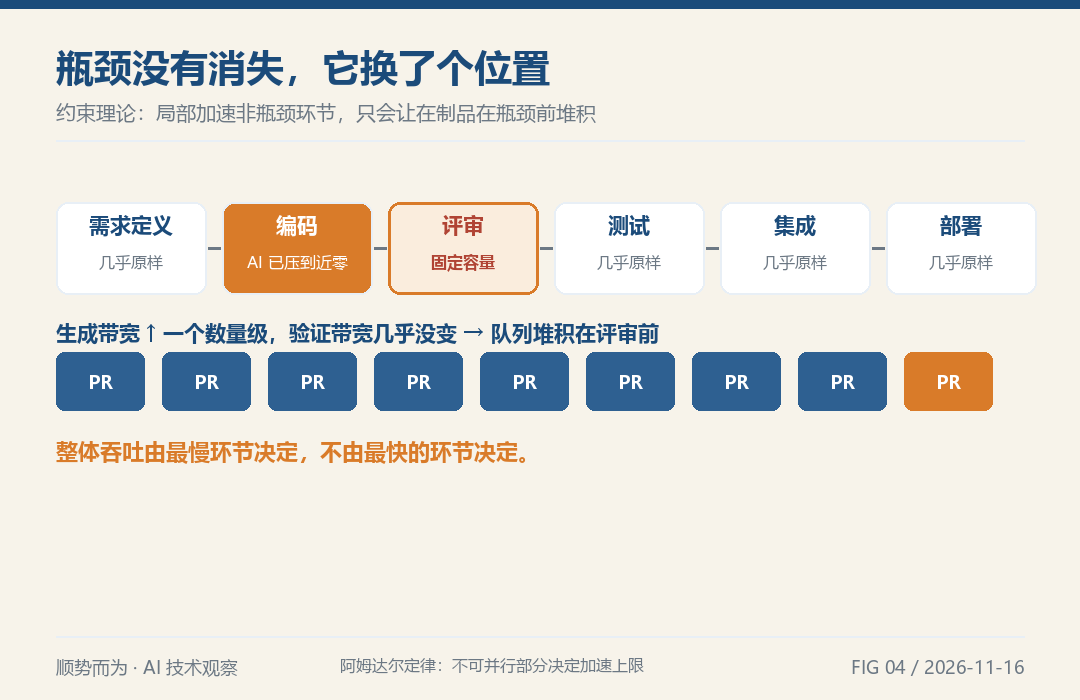
约束理论示意:编码被大幅加速后,在制品堆积在评审闸门前,整体吞吐由瓶颈决定
有个容易被忽略的细节:论文作者专门说明,多抽 14% 的人进评审收效有限,因为「更多代码」和「每单位代码需要更多检查」是两件事。加人能缓解前者,缓解不了后者。只要审查仍以人工逐行阅读为主,扩充人力的边际收益会迅速递减。
DORA 对 1,110 条 Google 工程师开放式回答(2025 年 Q3)的定性分析里,一句从业者原话比指标更准:「审别人的代码比自己写难得多。AI 工具正在提高需要被审查的代码的产出速率。」
05 生成已经自动化,验证仍是人肉
如果瓶颈只是「量大」,加机器就能解决。真正的问题在于:验证这件事本身几乎没被自动化。
Harvard 样本里,到 2026 年 3 月约 80% 的企业已用上 AI 代码评审。可 AI 只写了 23.3% 的评审意见,只触及 10.8% 的 PR。剩下那部分恰恰是最需要业务上下文、架构意图与责任归属的高价值判断。
LinearB 的数据从另一个角度画出同一条曲线:
数据卡片|验证侧的等待(LinearB 2026 基准报告,810 万 PR / 4800 团队 / 163820 贡献者 / 42 国)智能体 PR 等待首次评审(P75)17.6 小时,AI 辅助 8.3 小时,无辅助仅 3.4 小时(约 5.25 倍差距) 30 天内合并率:AI PR 32.7% vs 无辅助 PR 84.4%;头部组织智能体 PR 79%、纯人工 92%,「fair」档智能体仅 37% PR 尺寸中位数:智能体 89 行、AI 辅助 96 行、无辅助 26 行;P75 为 293 / 408 / 157 行 口径:厂商遥测基准,相关性非因果,客户自选样本;LinearB 官方写明「本页所有关系都是相关性的」
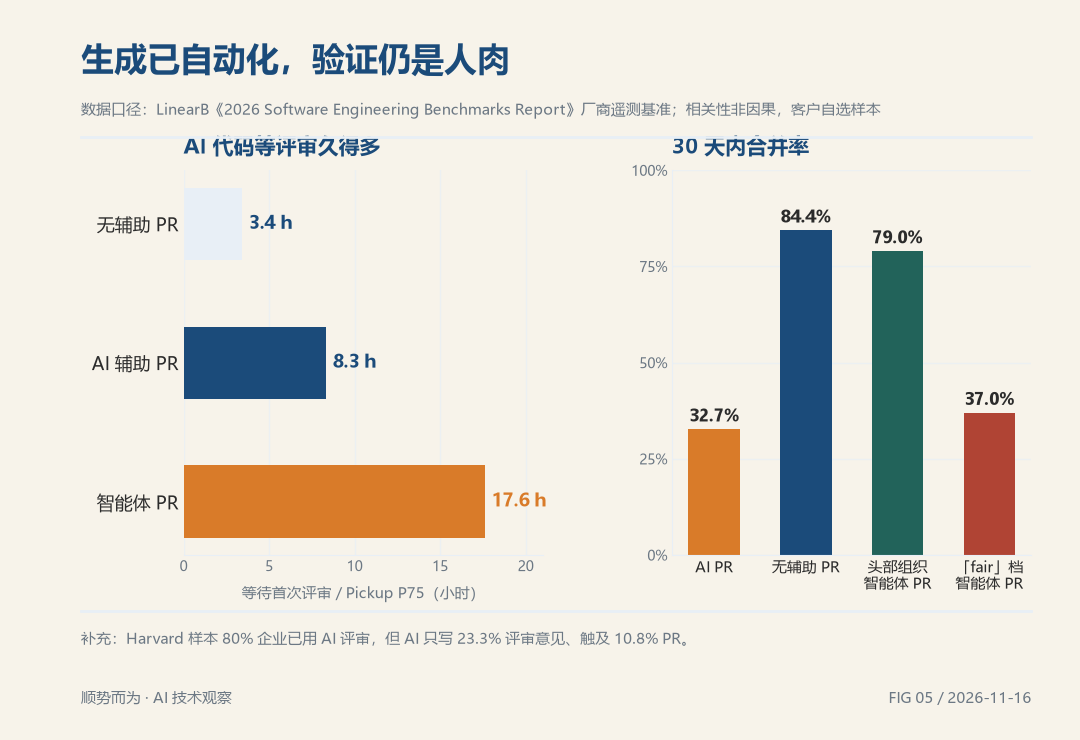
验证侧数据:智能体 PR 等待评审 17.6 小时对 3.4 小时,30 天合并率 32.7% 对 84.4%,AI 只写 23.3% 评审意见
三组数字连起来读,机制就清楚了:智能体写得快、草稿来得大,评审者要验一份自己没写过的代码,于是慢下来,相当一部分草稿最后根本没合进去。LinearB 的归因很朴素——ownership:没有开发者认领的智能体 PR,往往永远不会合并。
这也是「谁签字」变成架构问题的原因。生成可以由概率模型做,责任不能;评审除了挑错,还承担知识传递、规范维护与追责链路。
06 能跑 ≠ 能交付 ≠ 能安全交付
再往下一层:就算代码合进去了,「能跑」和「能安全上线」之间还有一道宽沟。
arXiv:2610.14766(2026-10-10 提交)《Last Secure Code Benchmark: Is the Code You Vibe Secure?》给了个扎心的测量。研究者(含新加坡国立大学、阿里等机构)从 150 个真实漏洞扩出 450 个任务,覆盖 Java、C、C++、JavaScript、Python、PHP、Go 七种语言、24 个 CWE,设置补函数、写文件、从零建仓库源码树三种 vibe-coding 场景。关键在于:任务只要求功能,规格从头到尾不提安全,再用隐藏的功能与安全测试评分。
数据卡片|功能与安全的落差(arXiv:2610.14766,2026-10-10 提交,预印本)六个前沿智能体功能通过率 73.6% – 91.3%(最高 Kimi-K3 91.3%) 「功能正确且安全」最强者(Claude Fable 5)仅 25.1%,其余 16.4% – 24.7% 最好模型跨三种 vibe-coding 场景,只通过 12% 的漏洞场景 功能最高分与安全最高分相差约 66 个百分点(据摘要数字计算) 口径:预印本 / 基准测试,非生产环境测量;任务规格刻意不提安全,测的是「不提醒时的默认表现」
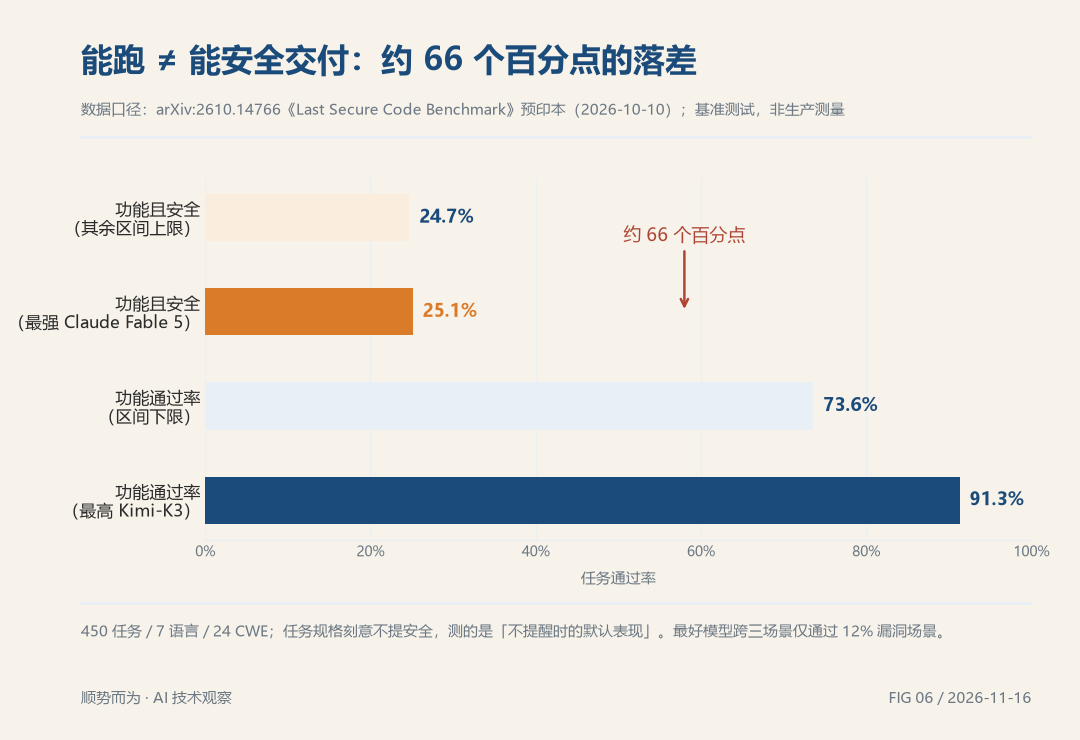
功能通过率 73.6%–91.3% 与功能且安全通过率 16.4%–25.1% 的落差,约 66 个百分点
功能最高的模型恰好安全分最低,几乎是「看着能跑」与「真的能上线」之间落差的教科书插图。这解释了安全评审为什么必须留在关键路径上,也解释了 DORA 那个 39% 低信任度为什么是理性而非保守。
补一句边界:LSCBench 是基准测试不是生产普查,测的是「规格不提安全时」的默认表现,不等于「有安全门禁时」的事故率。把 25.1% 读成「四分之三的 AI 代码不安全」是误读。但它确实说明——验证税里最贵的部分,是模型自己不会主动检查的部分。
07 验证税是可以算的
把线索收成一个式子:净收益 = 生成省下的时间 −(整理上下文 + 核验产出 + 修正 + 返工 + 等待)。
后面那一整串就是「验证税」:区别于团队本来就有的评审与测试,是因 AI 产出而新增的人力。很多人算收益只算了生成那一侧。
它为什么减不掉?因为生成与验证的带宽不对称。写作是生成式的:作者脑中持有意图,把意图展开成代码;验证是穷举式的:评审者必须从产物反推意图、逐行核对。AI 的生成带宽两年涨了一个数量级,人的验证带宽几乎没变。更麻烦的是,AI 草稿没有共享上下文——没有设计讨论、没有被否决的取舍记录,评审者要付全额「意图重建」成本。
数据卡片|时间都去哪了(METR 录屏活动分解,二次转述,未独立核验)主动编码 37% → 24.5%;阅读与检索 24.5% → 16.5% 新增:审 AI 产出约 9%、写 prompt 约 8%、等响应约 4%、空闲/杂项 6% → 10% 开发者采纳的生成内容不足 44% 口径:来自对 METR 143 小时标注录屏的社区二次转述,本文未独立核验原始表格,仅作机制示意,不作为确定性数字引用
生成速度一旦超过验证速度,团队一定会选到三种结局之一,无论有没有讨论过:排队(交付卡在队列里)、浅审(批准变成盖章,问题流到线上)、缺陷外溢(之后用返工把时间加倍还回来)。
用阿姆达尔定律做个示意计算(示意,非实测):若编码只占端到端周期 5%,把这段加速 100 倍,总周期最多缩短约 4.8%,其余 95% 原封不动。这解释了「换个更快的模型」为何在演示里惊艳、在交付报表上几乎看不见。
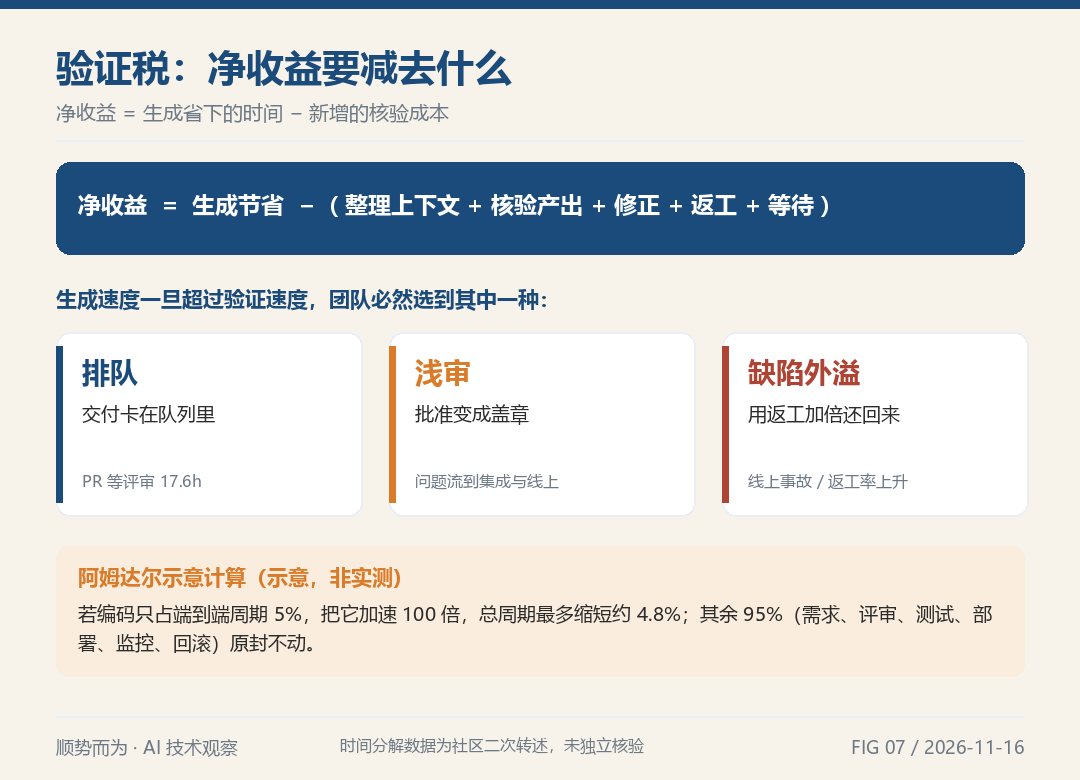
验证税公式与三选一结局:净收益等于生成节省减去核验与返工,超出验证带宽后只能排队、浅审或缺陷外溢
08 把验证左移,把门禁分层
核心不是买更强的模型,而是降低单位代码的验证成本,把验证尽可能放进生成循环里。
先换 KPI。 把「AI 代码占比」「采纳率」这类活动指标拿掉,换成返工率、缺陷率、PR→合并时长、需求交付周期、回归时长、线上事故率。DORA 那句话值得抄下来:AI 是放大器,让健康系统更强、让弱系统更快地变弱;活动指标量的是放大器输入,不是产出。
给 PR 设尺寸上限。 Google 工程实践的经验值是「100 行通常合理,1000 行通常过大」,文件分散度同样重要——200 行改一个文件可以,摊到 50 个文件通常就太大。把上限写成一句话、用仓库规则强制:超过约 400 行逻辑变更先拆分;机械性重命名单独标注,让评审者读模式而非读行数。
门禁分三层。 机器审:静态扫描、依赖漏洞、SBOM、生成代码溯源标记,提交即完成;规则审:把编码规范、架构边界、安全红线沉淀成可执行的 CI 门禁;人审只审机器审不了的——设计取舍、异常场景、业务语义匹配、责任归属。华为云社区复盘给的三条规则很实用:新增依赖说明理由、公共接口变更附调用方清单、错误处理分支必须被测试覆盖。
把知识搬出聊天框、把验证左移。 让模型直接读接口契约、历史故障记录和运行证据,chat 只讲本次新增要求与未定取舍;契约与领域知识跟代码同库同版本。再把编译、静态检查、测试套件接进工作流形成「生成—验证—修复」自检闭环,让模型在上下文还热时自己付掉一部分验证税,人只保留最终裁决。规范驱动(SDD)与 Plan-Execute-Verify-Replan 之所以流行,不是先进,而是刚好卡在「AI 输出需要被信任」这个最痛的点上。这与「模型提议、确定性代码裁决」是同一条纪律,只是从 Agent 动作权限平移到代码合入。
09 边界与自我反驳
最后把自己反驳一遍,免得成了数据堆出来的爽文。
四份研究都不是「AI 无用」的证据。 METR 是 2025 年初工具快照,作者已声明时效性受限;Harvard 是未同行评审的工作论文、观察性数据、样本为 analytics 平台客户;LinearB 与 DORA 写的是相关性非因果;LSCBench 是预印本基准非生产测量。它们共同支持「瓶颈迁移」,不是「AI 没价值」。
厂商数字要单独打折。 中文圈流传的 Sonar「AI 代码占 42%、2027 年 65%」、GitClear「返工率 +39%」、Veracode「150+ 模型 45% 测试引入已知漏洞」、Lightrun「43% 代码过质检后仍需生产调试」、Faros AI「PR 尺寸 +154%」及「每 1 美元 token 有 0.82 美元花在返工」等,多为厂商自报或二次转述,口径未独立核验,彼此互相打架。本文只在「行业讨论口径」里提及,不做确定性结论。看到漂亮数字,先问三句:谁测的、测的什么、能不能复现。
「换个更强模型就好了」和「SDD 是银弹」都过于简单:前者忽略瓶颈不在生成;后者已有实测批评「2000 行 Markdown 换 3 行代码」。以上证据又几乎全来自软件研发,把「验证税」套到客服、法务、医疗,要重新测量各自的验证带宽,不能照搬 49% 或 32.7%。
10 明天上班,先做这三件事
开发者:把补全、单测、文档解释、单任务 CLI Agent 用稳,这是 ROI 最确定的一档;项目约定写进 AGENTS.md;涉及鉴权、支付、多租户隔离的代码逐行把关;不开「完全访问 + 无沙箱」。
技术负责人:把投资重心从「多买生成工具」转到评审、集成、测试、上线的下游流水线;换掉「AI 代码占比」KPI,改用返工率、缺陷率、交付周期、回归时长;给 PR 尺寸设硬上限并用仓库规则强制;明确「生成者 / 复核者 / 签字者」。
做企业智能体:技术诊断走 RAG + 工具调用、订单库存走 API、情感安抚走话术库,但硬性人工闸门一律放在发送侧。历史邮件别只当语料,转成评测集;模型可以换,验收判据不能丢。
四份报告吵了半年,其实没有谁错。它们只是站在流水线不同位置,量了不同的一小段。拼起来是同一幅图:写代码正在变成最便宜的一环,而说清楚到底要什么、判断做出来的东西对不对,成了仅剩的稀缺品。
与其追下一个模型、下一份榜单,不如回头看看团队那条「写完之后」的链路:谁评审、怎么验、能不能回滚。模型负责提议,工程纪律负责裁决。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号