用Python跑懂MMAO,从安装到五种子验证
原创
用Python跑懂MMAO,从安装到五种子验证
原创
用户4859102
发布于 2026-11-17 12:33:31
发布于 2026-11-17 12:33:31
安装优化算法之后,最值得做的第一件事,是选一个自己知道答案的小问题。这样可以同时检查目标函数、输入范围、返回结果,以及程序实际进行了多少次尝试。
本教程使用mmao-opt==1.0.1,求解一个两参数问题,再导出搜索历史、尝试多个随机种子。下面的Python代码已在Python 3.12隔离环境中用PyPI发布版完整运行核对;使用其他版本时,接口和默认配置应结合对应文档检查。
先让目标函数接受手算检查
目标很简单,第一个参数接近1.5,第二个参数接近负0.5,将两项偏差平方后相加。最优位置为[1.5, -0.5],目标值为0。
[0, 0]的目标值为2.5,[1, 0]的目标值为0.5。先核对这些位置,再让优化器搜索,可以更早发现变量顺序和目标方向的问题。
使用Python 3.10或更高版本,在选定的Python环境中安装固定版本。
python -m pip install mmao-opt==1.0.1把下面代码保存为demo_mmao.py。calls用于统计目标函数调用,能够将搜索轮数与实际评价数量联系起来。
from time import perf_counter
from mmao import (
    ContinuousProblem,
    MMAOContinuousConfig,
    optimize_continuous,
    __version__,
)

calls = 0

def objective(x):
    global calls
    calls += 1
    return (x[0] - 1.5) ** 2 + (x[1] + 0.5) ** 2

assert objective([0, 0]) == 2.5
assert objective([1.5, -0.5]) == 0.0
calls = 0

problem = ContinuousProblem(
    name="two-variable-demo",
    dimension=2,
    bounds=[(-5, 5), (-5, 5)],
    objective=objective,
)
config = MMAOContinuousConfig(iterations=40, seed=7)
started = perf_counter()
result = optimize_continuous(problem, config)
elapsed = perf_counter() - started

assert result["nfev"] == calls

print("version:", __version__)
print("position:", result["best_position"])
print("objective:", result["best_fitness"])
print("evaluations:", result["nfev"])
print("seconds:", round(elapsed, 4))
然后运行它。
python demo_mmao.py在mmao-opt==1.0.1的核对运行中,位置约为[1.5542, -0.4497],目标值约为0.00547,目标函数共调用1397次。这对应40轮、种子7的教程配置。nfev是新版结果中记录的评价次数,断言会将它与目标函数入口的手工计数相互核对。耗时受计算机与环境影响,运行时可以连同Python版本和包版本一起保存。
best_position是返回的位置,best_fitness是对应目标值。与已知答案比较,两项参数已接近目标,但仍有进一步细化空间。
安装环境与运行环境怎样对应
电脑上可能同时存在系统Python、虚拟环境和编辑器选中的解释器。安装命令使用哪一个Python,运行脚本时也应使用对应解释器。可以先在终端查看版本与包信息,再在编辑器中确认运行配置,减少包已经安装却无法导入的情况。
如果希望单独保存教程环境,可以先创建虚拟环境,再用其中的Python安装固定版本。Windows环境中的解释器通常位于虚拟环境的Scripts目录,其他系统则采用相应位置。运行安装命令时明确使用该解释器,能够把环境与教程记录对应起来。
本教程固定包版本,是为了让接口、默认配置和输出具有可核对的条件。1.0.1还补充了输入校验、评价预算和运行元数据,并修正了连续优化最好结果的归档。以后切换版本时,可以重新运行同一个小问题,检查配置字段、返回结构和目标评价次数。这样更容易发现版本变化对使用方式的影响。
代码里的输入怎样对应到问题
dimension=2表示候选包含两个数,bounds分别给出两项范围。objective接受这一数值序列并返回需要最小化的目标。真实问题也可以按相同思路定义,但应先明确每一项变量的单位、范围和可行条件。
两个断言检查的是目标函数本身。第一个确认原点的偏差平方和为2.5,第二个确认已知最优位置返回0。它们会调用目标函数,因此代码随后将计数归零,让打印的调用数只统计正式搜索阶段。
配置中的40轮与种子7规定了这次运行的条件。种子帮助复查随机过程,轮数规定外层搜索长度。其他默认参数仍然参与候选、资源和种群更新,正式比较时可以把完整配置保存下来。
计时从优化调用前开始,到调用结束停止,覆盖这次搜索的执行时间。导入库、安装包和后续写文件的时间各有用途,是否计入应用成本需要说明。本教程打印的时间只对应这段明确范围。
怎样检查返回位置与评分一致
得到位置之后,可以用原始目标表达式重新计算。把返回的两项数值分别减去1.5和负0.5,再将平方相加,应与返回目标值一致。若明显不一致,就需要检查变量顺序、单位和使用的目标函数。
也可以逐项查看偏差。这里的位置分别接近目标,但距离精确答案仍有差距。若业务要求每项误差在一定范围以内,可以直接根据位置核对,或推导一个足够的目标阈值。这样,输出就对应到具体使用要求。
为什么40轮会调用目标函数很多次
公开连续实现中,一个个体会进行正、反两侧试探,再评价一个组合候选。轮末新增的个体也需要评价,种群数量还会变化。因此,实际调用次数需要由程序统计。
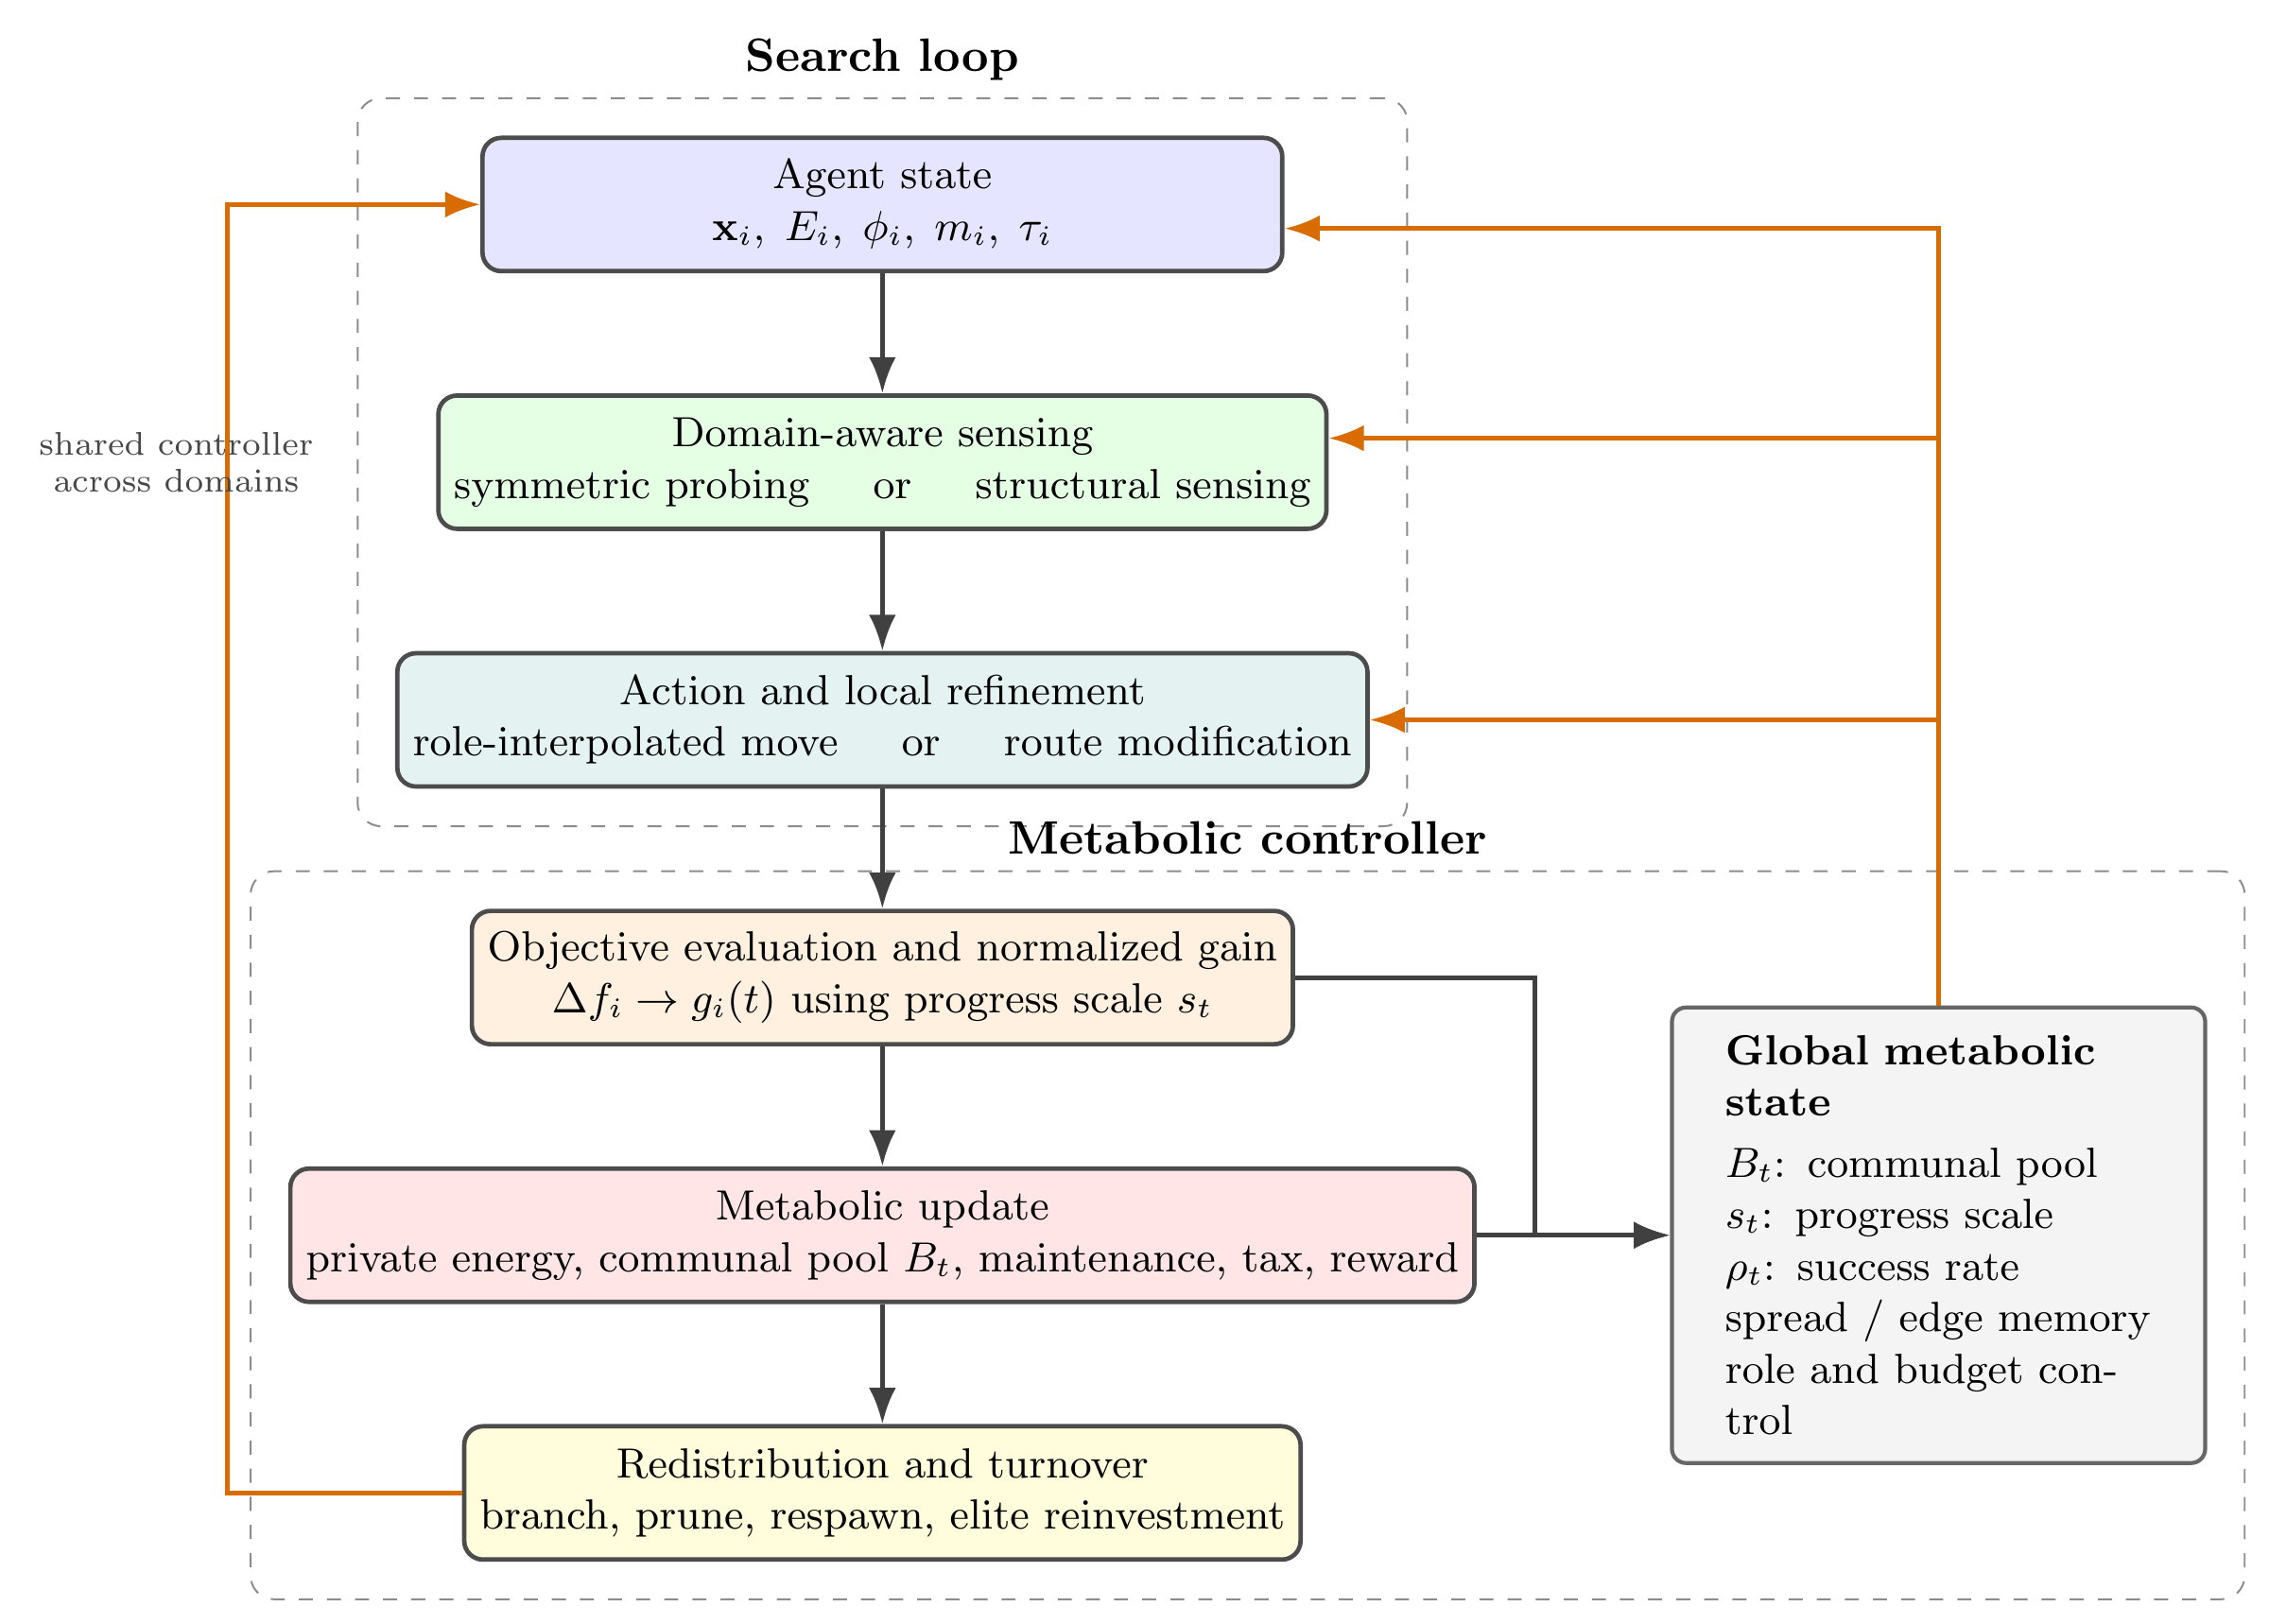
MMAO的控制循环与任务接口
图1 期刊论文对应项目中的MMAO架构,帮助定位候选生成、评价与资源反馈。
前面的objective位于图1的评价环节。换成业务函数时,可以在这里计算方案成本、调用仿真或执行模型训练。记录单次评价时间,有助于判断优化开销主要来自业务评价还是搜索控制。
目标函数还应在允许范围内返回有限数值。若某些输入会导致计算失败,应先明确定义可行域和失败处理,再接入长时间搜索。
调用计数能帮助发现什么
本次示例在40轮内调用目标1397次,平均每轮包含多次评价。这个平均值还混合了初始化、普通候选和新增个体,因此进一步分析时可以给不同调用路径分别标记,观察成本集中在哪里。
如果把目标替换成一次需要训练模型的过程,每次调用的耗时可能比示例大很多。可以先测量少量代表性输入,再估计预算。这样能够在完整搜索之前判断运行规模是否合适,也能设置合理的外部终止条件。
目标函数中若包含随机训练、外部请求或文件读取,还应保存相关条件。同一个数值位置可能因为评价过程变化而得到不同结果,资源反馈也会接收到这种波动。固定或记录评价随机性,可以让调试更清楚。
对于有缓存的目标,还要说明计数含义。一次函数入口调用可能命中缓存,真正执行昂贵计算的次数则更少。可以分别记录请求次数与实际评价次数,解释搜索动作和真实开销之间的联系。
什么时候适合增加轮数
增加轮数可以提供更多搜索机会,但效果要从历史中判断。如果目标仍在持续下降,可以观察额外预算是否继续带来收益。若很早进入平台,则先检查动作尺度、边界与角色变化,再决定怎样追加投入。
本次种子7在第10轮附近已经得到较低目标,之后到第40轮保持相近水平。这个小例子展示了目标进入平台后,末期状态仍然持续变化的过程。可以对照公共池和种群,检查后续尝试采用了怎样的安排。
如果希望更精确地理解某次停滞,可以缩短运行并打印单个个体的候选位置、目标和接受结果。候选是否足够接近当前好区域,是否频繁落在边界,以及是否重复产生相同位置,都能从细记录中查到。
把一次运行导出成可以查看的记录
在同一个demo_mmao.py末尾追加以下代码,会生成mmao_history.csv,用表格软件即可打开。
import csv

history = result["history"]
with open("mmao_history.csv", "w", newline="", encoding="utf-8-sig") as handle:
    writer = csv.DictWriter(handle, fieldnames=list(history[0]))
    writer.writeheader()
    writer.writerows(history)

for row in history[::10]:
    print(
        row["iteration"],
        round(row["best_fitness"], 6),
        row["population"],
        round(row["resource_pool"], 3),
        round(row["mean_role"], 3),
)在表格中,先用iteration与best_fitness画目标曲线,再分别查看population、resource_pool和mean_role。1.0.1还记录了累计评价次数nfev、success_rate与total_private_energy,可用于继续跟踪评价预算和内部反馈。
本次运行第10轮时目标已约为0.005468,到第40轮仍保持这一水平。同期种群从14降到7,平均角色降到0附近。这显示后续状态仍在调整,目标却进入了平台,适合继续检查动作尺度与后期细化。
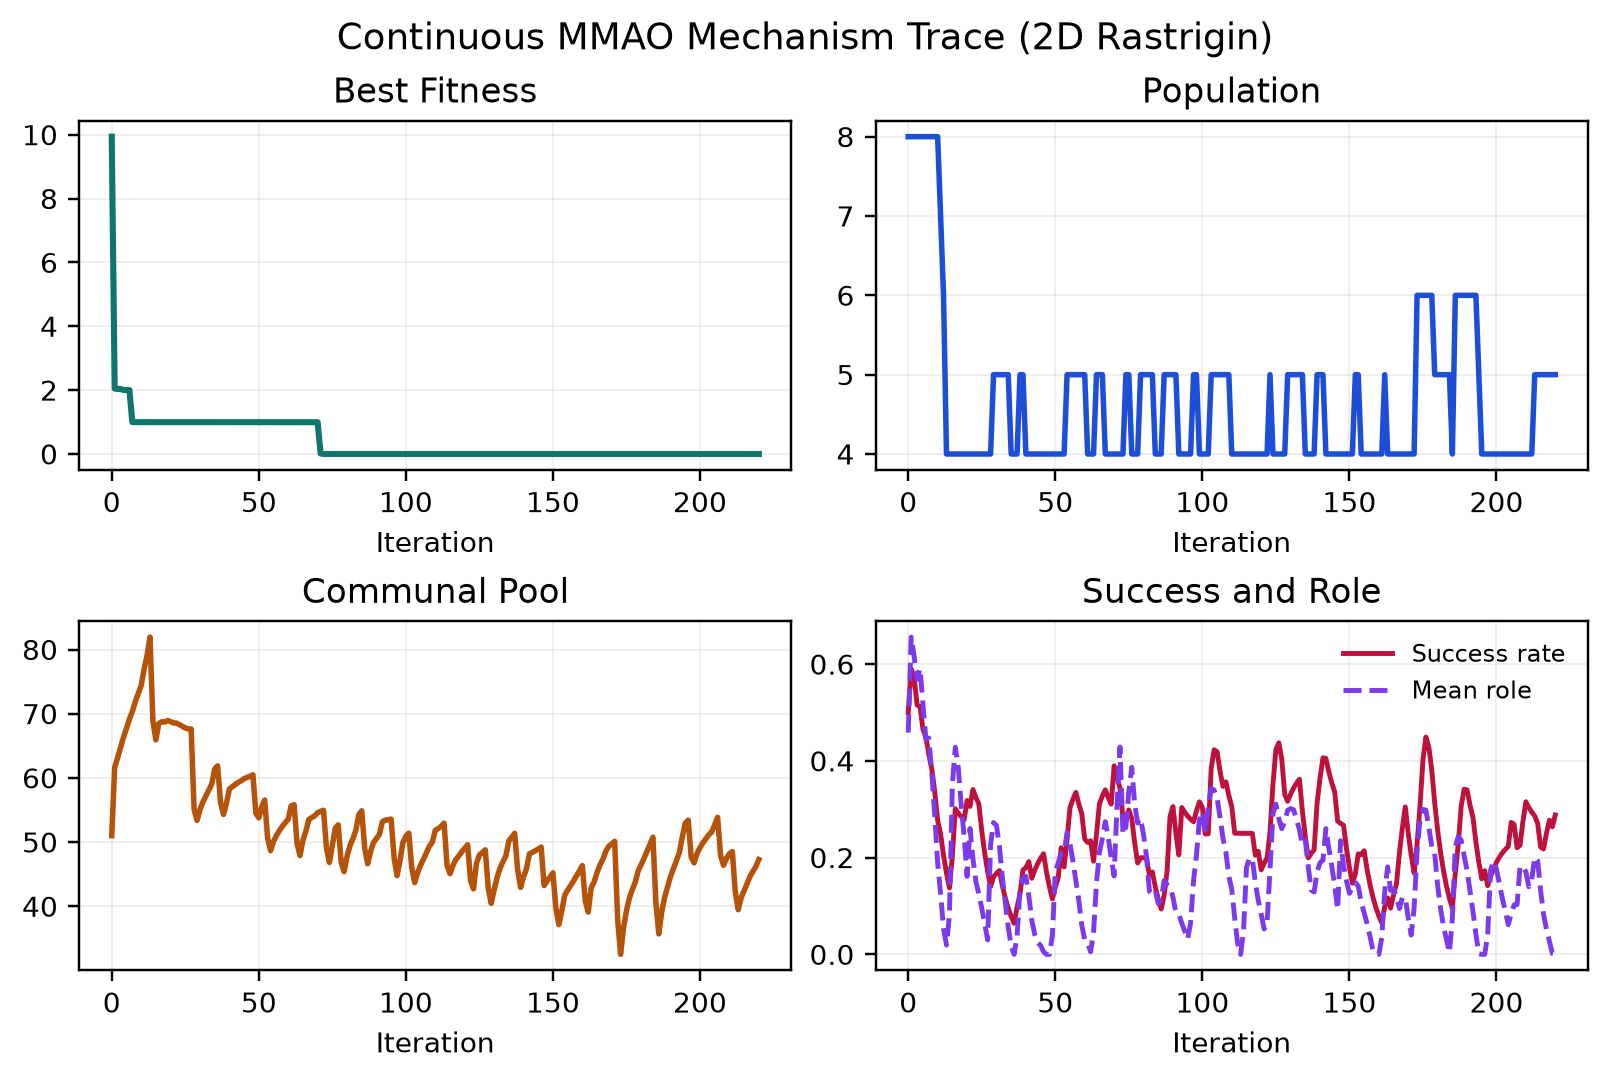
论文中的连续优化机制记录
图2 框架论文的二维Rastrigin轨迹,展示目标、种群、公共资源池和角色等记录的读法。
图2使用Rastrigin任务,教程运行使用两参数平方偏差目标,两者应分别解释。图中约70轮附近目标发生明显改善,之后长时间接近零,但种群与公共池仍有变化。导出自己的历史后,也可以找出类似区间,检查目标停滞时内部仍在做什么。
CSV里的每一列应该怎样读
iteration表示记录对应的轮次,初始状态也占一条记录。nfev表示截至该行累计完成的目标评价次数,best_fitness描述当前已保存的最好目标,population记录活动个体数量,resource_pool记录公共储备,mean_role则汇总角色状态。
可以先画目标与轮次的关系,找到快速改善和平台区间。随后在同一时间段查看种群和公共池,判断状态变化是否集中在这些阶段。将几列放在同一张表中对照,能够避免只根据单独曲线猜测原因。
success_rate与total_private_energy还能继续解释收益和维持状态。成功率下降时,可能有更多候选无法改善。私有能量变化则受奖励、支出与个体更替共同影响。若需要区分这些原因,可以再保存个体级更新。
CSV使用带字节顺序标记的UTF-8编码,便于常见表格软件读取中文或字段内容。每轮一行的形式也适合后续用脚本汇总。保存文件时,可以在文件名或旁边记录中注明问题、版本、配置和种子,避免不同运行互相覆盖。
论文图与教程输出怎样配合阅读
图2的Rastrigin曲线具有多个平台与后续改善,而教程的平方偏差目标更简单。可以借助论文图理解哪些状态值得保存,再用自己的输出检查同类字段。不同任务的曲线形状应按各自目标和配置解释。
例如,论文图中的种群会收缩并短暂增加,公共池也有多次支出。教程中相同字段发生怎样的变化,可以直接从CSV读取。把这些字段对应到源码更新位置之后,就能进一步追踪一次新增或一次角色变化的原因。
如果准备在文章或报告中展示自己的运行,应同时标明所用目标与参数。这样,读者能够区分论文实验与教程检查,并根据完整条件复查结果。已有图提供阅读示范,自己的历史记录则提供当前运行证据。
接着改变种子,观察结果是否稳定
保留目标和边界,在同一文件末尾继续追加。下面为每个种子重新创建配置,并单独统计调用。
from statistics import mean, stdev

scores = []
for seed in (3, 7, 11, 19, 23):
    calls = 0
    run_result = optimize_continuous(
        problem,
        MMAOContinuousConfig(iterations=40, seed=seed),
    )
    assert run_result["nfev"] == calls
    score = float(run_result["best_fitness"])
    scores.append(score)
    print(seed, round(score, 6), run_result["nfev"])

print("mean:", mean(scores))
print("standard deviation:", stdev(scores))
本次五种子检查中,目标值约在0.002898到0.019938之间,均值约0.009938,样本标准差约0.008483。调用次数在1351到1464之间,同样40轮也会产生不同成本。
这几次运行可以帮助检查小例子的随机波动。若要比较方法,应继续对齐问题、种子、评价预算和停止条件,并保留每次结果。改变迭代数时,也应重新统计调用次数,观察增加的评价究竟换来了多少精度。
五个种子能告诉读者什么
五次运行的目标值存在差别,说明随机初始位置与候选过程影响最终结果。均值概括这组检查,样本标准差描述相应波动。想比较另一配置时,可以使用同样的种子列表,保留每次结果,而只给出最好一次会丢失波动信息。
本次最多与最少评价次数相差113次。种群与新增机会随搜索变化,即使外层轮数一致,实际成本也会不同。因此,多种子汇总可以同时报告目标与调用,观察质量较好的运行是否也花了更多评价。
这组小检查主要帮助熟悉接口与运行行为。正式比较还需要更合适的任务、预算与参照,并在事先确定的协议下重复运行。可以先把当前脚本改成保存每种子的结果,再逐步增加实验内容。
只改一个参数,怎样保留解释能力
假设准备调整局部步长,可以先固定问题、边界、种子与轮数,只改变对应配置项。保存每次目标、调用和历史,再查看平台是否缩短、后期精度是否变化。若同时扩大种群与轮数,就更难解释哪个调整带来作用。
另一个可以检查的参数是初始个体数量。更多初始位置可能增加覆盖,也会消耗更多评价。比较时应根据研究目标对齐预算,并查看种群后续是否迅速收缩。初始投入与长期活动人数之间的关系,也能从历史记录读取。
若改动使结果变差,可以保留这次配置与输出,回到候选过程检查。变差信息能够帮助定位尺度或资源设置的边界,后续调整也可以基于具体记录继续推进。
怎样观察停滞后的探索是否真的发生
教程的平方偏差目标只有一个最优区域,适合检查接口和精度。要研究突破局部最优,可以换成定义清楚的多峰函数,保存相同的种子与评价预算,并记录候选位置。第3篇的双低谷教学函数就能用于理解跨区域动作。采用该一维函数时,目标读取x[0],将dimension设为1,边界可以设为[(-2, 2)]。
已有history可以展示角色、公共池与种群变化。若要判断哪些候选真正离开当前区域,还需增加位置与候选来源记录,再核对接受结果。只看到平均角色降低,还需要追踪它在动作生成中改变了哪些尺度。
配置试验可以先检查探索尺度,再检查补充个体的来源。一次只改变一项规则,记录跨区域成功次数与评价成本。教程中固定版本的连续实现采用改善接受,因此候选直接跳入更好区域以及新增个体的采样范围,尤其值得检查。
遇到问题时,沿着运行入口排查
出现ModuleNotFoundError,先用运行脚本的同一个python执行python -m pip show mmao-opt,核对包是否装在该解释器中。出现参数或字段错误时,检查实际包版本与教程版本是否一致。
若位置看似合理但目标值异常,直接把返回位置代回目标函数,检查单位和最小化方向。若多次运行很快进入平台,可以先查看边界尺度、试探幅度与角色轨迹,再一次只调整一个参数。只增加迭代数,有时仍会重复缺少收益的尝试。
迁移到自己的任务时,先替换目标函数并手算几个输入,再修改维度和边界。分类、路线等任务需要使用各自的表示与接口。把这个小例子的输入核对、调用计数和历史记录带过去,会更容易判断新任务中的搜索是否有效。
把教程目标替换成自己的问题
先明确输入与输出。假设两项变量分别代表设备参数,目标返回误差或成本,就可以保持相同接口形式。替换之后,先单独评价几个边界点和人工可理解的位置,确认返回值符合业务含义。
随后核对量纲。若一个变量在0到1之间,另一个范围很大,应查看实现怎样根据边界构造尺度。必要时可以在目标接口内定义清楚的归一化与反变换,再保证所有返回位置能正确转换为业务配置。
如果存在联合约束,需要确定生成、修复或评价处理方式。例如两个份额相加不能超过总量,就应记录候选是否合法,以及修复后实际评价了哪个方案。修复与外部调用的成本也可以进入计数。
正式运行前,再用一组较小预算检查整个流程。确认最终位置合法、目标可复算、历史记录完整,然后逐步扩大规模。这样,每次增加计算投入,都建立在已经核对的输入输出之上。
完成一次运行后,可以留下一个简短记录,写明任务、软件环境、配置、种子、最好方案与评价成本。若后续修改包版本或业务目标,就用同样的小问题重新检查入口,再继续开展比较。这个教程脚本由此成为一个可以反复使用的操作起点。
资料来源
mmao-opt软件发布信息,本文示例固定使用1.0.1。mmao-opt(PyPI)- 源码和版本文档。wolfbrother/mmao(GitHub)
- 算法期刊论文与框架研究。DOI:10.1109/ACCESS.2026.3752083 · arXiv:2606.28109
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号