MMAO-Dyn动态优化入门与实现思路
原创
MMAO-Dyn动态优化入门与实现思路
原创
用户4859102
发布于 2026-11-17 12:34:22
发布于 2026-11-17 12:34:22
1. 项目概述:当多智能体遇上动态优化
最近在优化算法圈子里,一个名为“MMAO-Dyn”的概念开始被频繁提及。它全称是“Metabolic Multi-Agent Optimizer for Dynamic Optimization”,直译过来就是“面向动态优化的代谢多智能体优化器”。这名字听起来有点唬人,但拆开来看,它其实精准地指向了当前算法工程领域两个非常“痛”的挑战:一是如何处理那些目标函数、约束条件会随着时间或环境参数变化而改变的“动态优化问题”;二是如何设计一个既高效又鲁棒的优化器内核。
传统的优化器,无论是经典的梯度下降家族,还是启发式的遗传算法、粒子群,在面对动态环境时常常显得力不从心。它们要么需要频繁重启,浪费大量计算资源,要么跟踪变化的能力不足,容易陷入过时的局部最优解。而“多智能体”和“代谢”这两个词的引入,提供了一种全新的思路。你可以把它想象成派出一支分工明确、能自我调节的侦察小队,去探索一片地形时刻在变化的山脉。每个智能体(侦察兵)不仅负责探索一片区域,还能根据自身“能量”状态(代谢机制)和队友的信息,动态调整自己的行动策略,从而更快、更准地追踪到那个移动中的最高峰(最优解)。
这个项目对于从事运筹学、机器人路径规划、实时控制系统、金融交易策略优化,乃至最近火热的AI智能体应用开发的工程师和研究者来说,都极具吸引力。它不只是一个理论玩具,而是瞄准了那些真实世界中变量随时在变的棘手问题。接下来,我就结合自己的理解和实践,深入拆解一下MMAO-Dyn背后的核心思路、关键实现以及那些在实操中容易踩到的坑。
2. MMAO-Dyn的核心设计思想拆解
要理解MMAO-Dyn,不能把它简单看作是多智能体系统(MAS)和动态优化(DO)的粗暴拼接。它的精妙之处在于借鉴了生物代谢系统的核心原理,将其作为协调多智能体在动态环境中行为的“操作系统”。
2.1 从“静态”到“动态”:优化问题的范式转变
我们熟悉的绝大多数优化问题都是静态的。比如,训练一个 神经网络 ,损失函数在数据集确定的情况下是固定的;或者为一个仓库规划最短配送路径,客户点和道路网络在单次计算中是不变的。这类问题,优化器可以心无旁骛地朝着一个固定目标前进。
但动态优化问题(Dynamic Optimization Problems, DOPs)是另一回事。它的目标函数、约束条件或问题参数本身会随时间(或某个外部变量)发生变化。这种变化可能是周期性的、随机的,甚至是混沌的。例如:
- 实时机器人控制 :机器人的运动路径规划需要根据传感器实时感知到的障碍物位置进行调整。
- 动态资源调度 :云计算中心的负载均衡,需要根据用户请求的实时波动来分配计算资源。
- 自适应投资组合 :金融市场瞬息万变,最优的投资资产配比需要跟随市场状态动态调整。
传统优化器应对DOPs,要么采用“检测-响应”策略(检测到变化后重新初始化或重启优化过程),要么引入记忆或预测机制。但这些方法要么响应滞后,要么计算开销大。MMAO-Dyn的设计出发点,就是让优化器本身“内生”地具备适应动态变化的能力,将变化视为环境的一部分,持续追踪而非间断重启。
2.2 “代谢”机制:智能体的能量循环与行为驱动
“代谢”(Metabolic)是整个模型中最具生物启发性的部分,也是区别于普通多智能体优化的关键。在这里,每个智能体都被赋予了一个虚拟的“能量”状态。这个能量并非固定不变,而是会随着智能体的行为和所处环境动态变化,形成一个完整的“代谢循环”:
- 能量获取 :当智能体探索到一个更优的解(即目标函数值更佳)时,它会获得能量奖励。这模拟了生物体觅食成功获得营养。
- 能量消耗 :智能体的每一个行动,如移动、探索、与同伴通信,都会消耗能量。这迫使智能体必须高效利用资源,不能盲目乱跑。
- 能量状态决定行为模式 :这是核心控制逻辑。一个“高能量”的智能体可能处于“开拓”模式,敢于向未知区域进行长距离探索;而一个“低能量”的智能体则会转入“保守”模式,倾向于在已知优质解附近进行精细搜索,或者向高能量同伴靠拢以获取“支援”(信息共享)。
- 能量传递与群体协同 :智能体之间可以按一定规则传递能量。这模拟了群体内的协作。一个陷入局部最优(能量枯竭)的智能体,可以通过接收来自成功同伴的能量“输血”而恢复活力,从而有机会跳出陷阱。
这种代谢机制巧妙地解决了多智能体系统中探索与利用(Exploration vs. Exploitation)的平衡问题,并且是自适应的。在环境稳定时,系统会逐渐收敛,能量流动减缓;一旦环境发生变化(原有优质解变差),相关智能体会迅速损失能量,触发行为模式切换和新的探索,从而实现快速响应。
2.3 多智能体架构:分工、通信与涌现
多 智能体框架 为应对动态环境的复杂性提供了天然的分布式解决方案。MMAO-Dyn中的智能体通常不是同质的,它们可能承担不同的角色:
- 探索者 :专门负责搜索新的、未开发的区域,对变化敏感。
- 开发者 :围绕当前已知的较优解进行深度挖掘,提高解的质量。
- 哨兵 :监控环境变化的指标,如最优解附近函数值的变化梯度。
- 通信中继 :负责在智能体间传递解的信息和能量状态,维持群体网络。
智能体之间通过特定的拓扑结构(如环形、星形、全连接或小世界网络)进行通信,共享位置(候选解)和能量信息。优秀的解和策略能够通过这种网络快速传播。整个群体的智能——即快速、鲁棒地追踪动态最优解的能力——并非来自某个中心控制器,而是从大量简单智能体的局部交互中“涌现”出来的。这种去中心化的特性,也使得系统具有良好的可扩展性和容错性。
下面按能量阈值、邻域通信和互助等思路展开教学设计。公开MMAO-Dyn论文以私有能量、公共资源池、连续角色和种群更新构成反馈循环,并在环境变化后重评旧解、调整恢复投入。实际实现时,可以沿着这些状态逐项核对所用版本的更新规则。
3. 核心模块实现与参数解析
理解了设计思想,我们来看看如何将其落地。一个基础的MMAO-Dyn实现通常包含以下几个核心模块,每个模块的参数选择都至关重要。
3.1 智能体状态与代谢模型实现
每个智能体 Agent i 可以用一个结构体或对象来定义,其核心属性至少包括:
- 位置 :
X_i,代表当前搜索空间中的一个候选解。 - 能量 :
E_i,一个标量值,范围可设为[0, E_max]。 - 行为模式 :
Mode_i,由能量值映射(如E_i > threshold_high为“探索”,E_i < threshold_low为“开发”)。 - 个人历史最优解 :
Pbest_i。
代谢更新的伪代码逻辑如下:
# 在一次迭代后更新智能体能量
def update_metabolism(agent, fitness_new, fitness_old, base_cost):
    # 1. 计算能量收益:找到更优解则获得奖励
    if fitness_new better than fitness_old:
        energy_gain = gain_coeff * (improvement_magnitude)
    else:
        energy_gain = 0

    # 2. 计算能量消耗:移动、计算都有成本
    movement_cost = cost_coeff * (distance_moved)
    computation_cost = base_cost

    # 3. 更新能量:考虑自然衰减(如模拟新陈代谢)
    agent.energy = agent.energy + energy_gain - movement_cost - computation_cost - decay_rate * agent.energy

    # 4. 能量钳制
    agent.energy = max(0, min(E_max, agent.energy))

    # 5. 根据新能量更新行为模式
    agent.mode = determine_mode(agent.energy)
关键参数解析 :
gain_coeff(收益系数):决定了找到好解时的激励强度。系数太大会导致智能体过于激进,容易振荡;太小则激励不足,响应迟钝。通常需要根据目标函数值的大致范围进行归一化后设定。cost_coeff(移动成本系数):控制探索的“代价”。增大此值会促使智能体更珍惜移动,倾向于局部搜索;减小则鼓励大范围探索。它与问题搜索空间的尺度相关。decay_rate(能量衰减率):模拟能量的自然消耗。这是一个非常重要的稳定性参数。适当的衰减能防止能量无限累积,让陈旧的“成功”被逐渐遗忘,这对于追踪动态最优解至关重要。一般设置为一个较小的正数(如0.01-0.05)。
3.2 动态环境检测与响应策略
如何让智能体感知到环境变化?工程设计中可以考虑隐式反馈和显式检测两种方式。公开论文的受控测试按照预设节奏更新环境,业务应用则需要另外定义变化信号及其观测方式。
- 隐式反馈 :通过持续重评当前解,观察其质量与近期收益的变化,再把反馈传递给资源与行为更新。采用这种方式,需要明确重评频率、额外评价成本和噪声处理,才能判断响应是否及时。
- 显式检测 :定期重评估一部分固定监测点(如历史全局最优解)的适应度值。如果发现显著下降,则向全体或部分智能体广播“环境变化”信号,触发一个强制的能量重置或行为重置。
响应策略 通常与检测方式绑定:
- 对于隐式检测 ,响应是自动且分布式的,主要依靠低能量智能体的模式切换和能量传递来驱动群体向新区域迁移。
- 对于显式检测 ,可以引入更强烈的响应,如:随机重置一部分智能体的位置;暂时提高所有智能体的探索倾向;在疑似的新最优解区域周围增加智能体投放等。
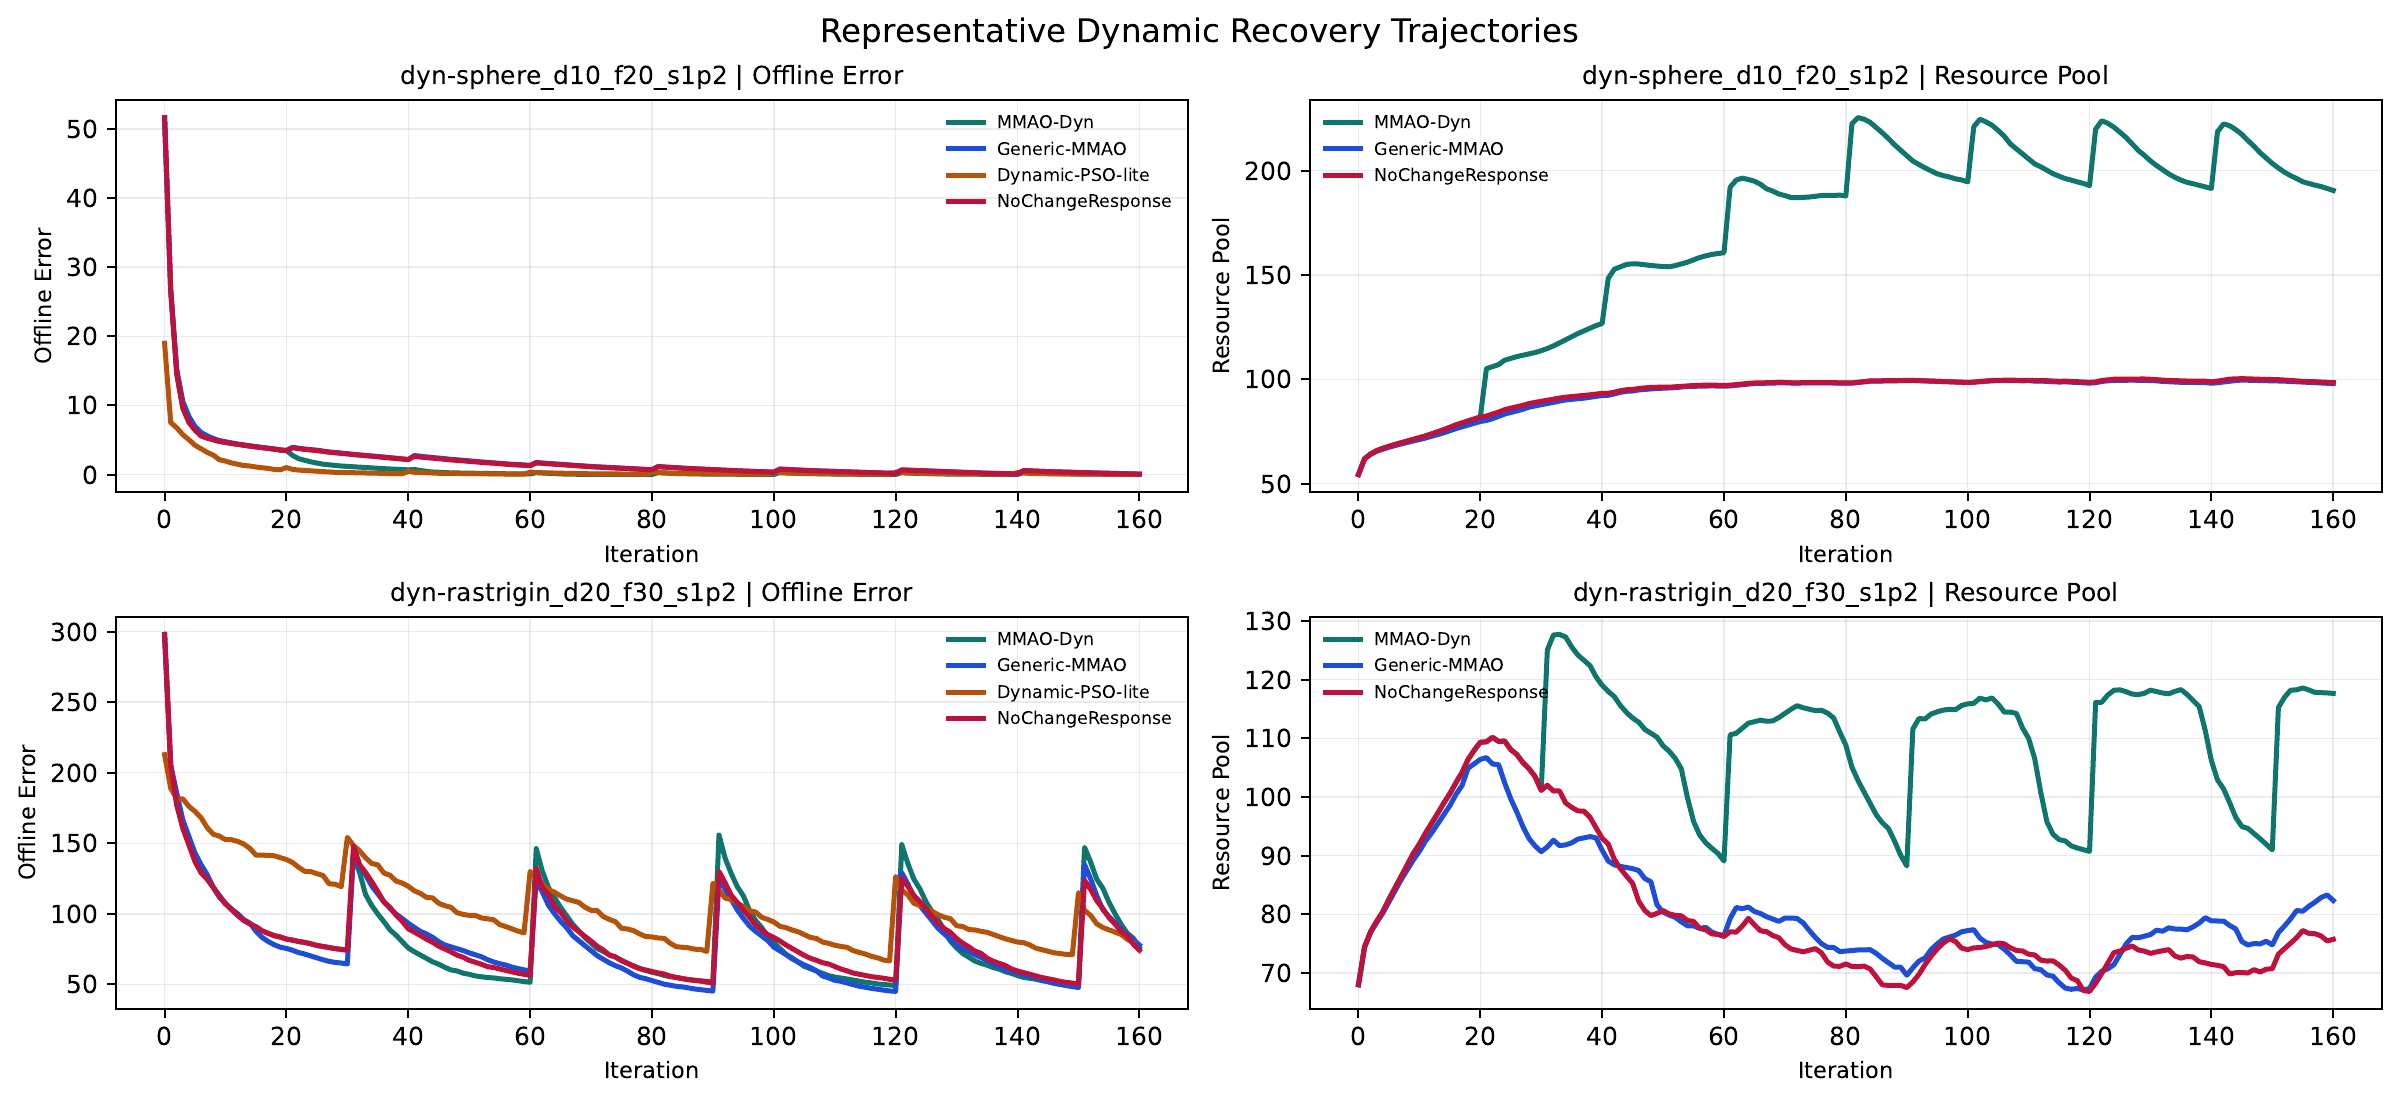
环境变化后的误差与公共资源池轨迹
图1 MMAO-Dyn论文中的代表性恢复轨迹。上排为平移Sphere,下排为平移Rastrigin,左列为误差,右列为公共资源池。来源见文末图表资料。
图1上排约每20轮出现一次环境变化,完整方法的公共资源池在变化附近抬升,随后逐步支出。下排的多峰场景出现更明显的误差跳升与恢复过程。观察响应效果时,可以同时查看变化发生时的损失和之后若干轮的恢复速度。
图中实验采用平移连续函数,具体配置按论文读取。下文的移动峰代码用于展开另一种教学场景的实现思路。
3.3 智能体间交互与信息素通信
除了能量传递,智能体间更重要的交互是信息(解)的共享。这里可以借鉴蚁群优化中的“信息素”概念,但更加通用。
- 局部通信 :每个智能体只与拓扑结构定义的邻居通信。例如,定期将自己的
Pbest_i和能量E_i发送给邻居。邻居收到后,可以根据发送者的能量高低,以一定概率采纳其解作为自己搜索的参考方向。高能量智能体的解具有更高的影响力。 - 全局知识库 :维护一个全局的精英解档案。智能体在能量极低时,可以从这个档案中随机抽取一个优质解进行“学习”或直接“迁徙”,避免群体多样性丧失。
- 能量借贷 :当智能体
A的能量低于生存阈值且其邻居B能量较高时,可以发生能量转移:E_A += delta,E_B -= delta。这能有效防止智能体过早“死亡”(失去搜索能力),维持群体规模。
通信频率 是一个需要权衡的参数。频繁通信能加速信息传播,但会增加计算和通信开销,也可能导致群体过早收敛。通常设置为每若干次迭代进行一次同步通信。
4. 实战:构建一个简易的MMAO-Dyn求解动态函数
让我们以一个经典的动态优化测试函数——移动峰模型(Moving Peaks Benchmark)为例,手把手实现一个简化版的MMAO-Dyn。
4.1 问题定义与环境设置
移动峰模型模拟了一个多维空间中多个峰值的位置、高度和宽度随时间变化的情景。我们的目标是追踪到最高的那个峰值。
import numpy as np

class MovingPeaks:
    def __init__(self, num_peaks, dim, change_frequency):
        self.num_peaks = num_peaks
        self.dim = dim
        self.cf = change_frequency # 环境每多少次迭代变化一次
        self.counter = 0
        # 初始化峰值参数(位置、高度、宽度)
        self.peak_positions = np.random.rand(num_peaks, dim)
        self.peak_heights = np.random.rand(num_peaks) * 10 + 5
        self.peak_widths = np.random.rand(num_peaks, dim) * 0.5 + 0.1

    def evaluate(self, x):
        # x是一个dim维向量
        values = []
        for i in range(self.num_peaks):
            distance_sq = np.sum(((x - self.peak_positions[i]) / self.peak_widths[i]) ** 2)
            values.append(self.peak_heights[i] / (1 + distance_sq))
        return max(values) # 返回最近峰的高度作为适应度

    def change_peaks(self):
        # 每隔cf次迭代,随机扰动峰值参数
        self.counter += 1
        if self.counter % self.cf == 0:
            self.peak_positions += np.random.randn(self.num_peaks, self.dim) * 0.1
            self.peak_heights += np.random.randn(self.num_peaks) * 1.0
            # 确保高度为正
            self.peak_heights = np.maximum(1.0, self.peak_heights)
            print(f"Iteration {self.counter}: Environment changed!")
4.2 MMAO-Dyn智能体类实现
class MMAgent:
    def __init__(self, dim, search_range):
        self.dim = dim
        self.range = search_range
        self.position = np.random.rand(dim) * (search_range[1] - search_range[0]) + search_range[0]
        self.energy = 50.0  # 初始能量
        self.pbest_position = self.position.copy()
        self.pbest_value = -float('inf')
        self.mode = 'exploit'  # 初始模式

    def move(self, global_best_position, env, W=0.4, C1=1.5, C2=1.5):
        # 根据模式决定移动策略
        if self.mode == 'explore':
            # 探索模式:更多随机性,向全局最优学习减弱
            inertia = W * 0.5  # 更小的惯性
            cognitive = C1 * 0.8 * np.random.rand(self.dim) * (self.pbest_position - self.position)
            social = C2 * 0.8 * np.random.rand(self.dim) * (global_best_position - self.position)
        else: # exploit
            # 开发模式:更强地向个人和全局最优学习
            inertia = W
            cognitive = C1 * np.random.rand(self.dim) * (self.pbest_position - self.position)
            social = C2 * np.random.rand(self.dim) * (global_best_position - self.position)

        velocity = inertia * (self.position - self.prev_position if hasattr(self, 'prev_position') else 0) + cognitive + social
        self.prev_position = self.position.copy()
        self.position += velocity
        # 边界处理
        self.position = np.clip(self.position, self.range[0], self.range[1])

        # 评估新位置
        new_value = env.evaluate(self.position)
        # 更新个人最优
        if new_value > self.pbest_value:
            self.pbest_value = new_value

        return new_value

    def update_energy(self, old_value, new_value, move_cost=0.5, decay=0.02):
        # 能量变化
        if new_value > old_value:
            gain = (new_value - old_value) * 10  # 收益系数
        else:
            gain = 0

        consumption = move_cost + decay * self.energy
        self.energy += gain - consumption
        self.energy = np.clip(self.energy, 0, 100)

        # 更新模式
        if self.energy > 70:
            self.mode = 'explore'
        elif self.energy < 30:
            self.mode = 'exploit'
        # 介于30-70之间保持原模式
4.3 主循环与群体协同
def run_mmao_dyn(num_agents=30, dim=2, total_iter=500, change_freq=50):
    env = MovingPeaks(num_peaks=5, dim=dim, change_frequency=change_freq)
    agents = [MMAgent(dim, search_range=[0, 100]) for _ in range(num_agents)]

    global_best_position = None
    global_best_value = -float('inf')
    history_best = []

    for iter in range(total_iter):
        # 环境可能变化
        env.change_peaks()

        iter_best_value = -float('inf')
        iter_best_agent = None

        # 所有智能体移动并评估
        for agent in agents:
            old_value = env.evaluate(agent.position)
            new_value = agent.move(global_best_position, env)
            agent.update_energy(old_value, new_value)

            # 更新本次迭代最佳
            if new_value > iter_best_value:
                iter_best_value = new_value
                iter_best_agent = agent.position

            # 更新全局最佳
            if new_value > global_best_value:
                global_best_value = new_value
                global_best_position = agent.position.copy()

        history_best.append(global_best_value)

        # 简单的群体能量互助(每10次迭代进行一次)
        if iter % 10 == 0:
            agents.sort(key=lambda a: a.energy, reverse=True)
            for i in range(num_agents // 2):
                donor = agents[i]
                receiver = agents[-i-1]
                if donor.energy > 60 and receiver.energy < 20:
                    transfer = 10
                    donor.energy -= transfer
                    receiver.energy += transfer

        print(f"Iter {iter}: Global Best Value = {global_best_value:.4f}")

    return history_best
上述代码展开了移动、能量更新和互助流程。将其补充成完整实验时,可以按下表检查初始化、记忆同步和环境切换,再记录当前环境中的表现。
检查时点 | 实现要点 | 建议保存的记录 |
|---|---|---|
首轮移动前 | 评价初始个体,建立全局参考位置 | 初始位置、评分与随机种子 |
个人最好评分改善时 | 同步保存对应的位置 | 个人记忆位置及评分 |
环境切换后 | 重评当前位置与历史参考,更新当前环境的最好解 | 环境编号、切换时点与重评次数 |
每轮搜索结束 | 记录当前环境的较好值与能量状态 | 误差、评价次数和能量分布 |
这样可以检查环境变化后的性能下降与恢复。用于绘制动态跟踪曲线的评分,需要随环境切换重新建立比较基准。
5. 调参心得与常见陷阱规避
MMAO-Dyn的强大依赖于一组精心调校的参数。根据我的经验,以下几个点需要特别注意:
5.1 代谢参数:系统动态性的“节拍器”
- 能量收益与成本系数 :这是驱动智能体行为的“油门”和“刹车”。一个实用的调参技巧是 先让系统在一个静态问题上运行 。观察智能体能量的整体分布:如果大部分智能体能量很快饱和并长期处于高位,说明收益系数过大或成本系数过小,系统可能过于活跃,在动态环境中容易振荡。反之,如果能量普遍低迷,则激励不足,响应变化会太慢。理想状态是能量在一个中等范围内动态波动,有高低交替。
- 能量衰减率 :这是 遗忘因子 。在变化缓慢的环境中,衰减率应设小(如0.01),让智能体保留较长时间的记忆;在变化快速或随机性强的环境中,衰减率应增大(如0.05-0.1),迫使系统更快地抛弃过时信息,适应新环境。可以将其设置为一个与预估变化频率相关的函数。
5.2 群体拓扑与通信:信息传播的“高速公路”与“隔离带”
- 拓扑结构的选择 :
- 全连接网络 :信息传播最快,收敛迅速,但容易导致群体思维过早统一,降低多样性,在动态环境中一旦追错方向很难调头。适用于变化平缓、峰值较少的环境。
- 环形或网格拓扑 :信息传播慢,群体多样性保持好,探索能力强,但追踪变化的速度也慢。适用于复杂、多峰且变化剧烈的环境。
- 小世界网络 :在规则网络中随机添加一些“捷径”,在保持较好多样性的同时加速信息传播,是大多数情况下的折中优选。
- 通信频率与内容 :不要每轮迭代都进行全局信息同步。尝试每2-5轮迭代同步一次,给智能体留出独立探索的时间。传递的内容也不宜过多,通常只传递位置和适应度值即可,能量状态可用于决定是否采纳该信息。
5.3 动态响应过冲与振荡问题
这是实操中最常见的问题。当环境发生变化,系统检测到后,所有智能体一窝蜂涌向疑似的新区域,导致过度探索,反而错过了真正的最优解,甚至引发群体在几个潜在解之间来回振荡。
解决方案 :
- 分批次响应 :不要一次性重置或引导所有智能体。例如,当检测到变化时,只让能量最低的30%的智能体执行随机重置或强探索,其余智能体保持原有搜索模式。这保持了群体的记忆和多样性。
- 引入响应延迟 :对于周期性变化,可以尝试让系统“学习”变化周期,在预期变化点附近提前提高探索性,而不是在变化发生后才仓促响应。
- 设置“冷静期” :在发生一次大规模群体移动后,强制几个迭代周期内降低移动速度或探索倾向,让系统在新的区域进行精细搜索,避免刚找到近似解就又跳走。
5.4 计算效率与可扩展性
多智能体系统天然适合并行计算。每个智能体的移动和评估是独立的,可以轻松利用多核CPU或GPU进行加速。在实现时,务必确保评估函数( environment.evaluate(x) )是向量化的,或者将智能体批量提交评估。
对于高维问题(例如维度>50),所有基于种群的优化器都会面临“维数灾难”。MMAO-Dyn也不例外。此时,需要:
- 考虑使用 维度分组 策略,让不同的智能体子群负责优化不同的变量子集。
- 大幅增加群体规模,但相应地需要调整代谢参数,防止计算开销爆炸。
- 结合局部搜索算子,在智能体找到 promising region 后,进行梯度下降等快速局部优化。
6. 进阶思考:MMAO-Dyn与现代AI智能体框架的联想
看到“多智能体优化器”,很难不联想到当前 大模型 驱动的AI智能体(AI Agent)热潮。MMAO-Dyn的哲学与构建复杂AI智能体系统有异曲同工之妙。
在诸如AutoGPT、 CrewAI 等多智能体协作框架中,我们同样需要调度多个具有不同角色(如研究员、写作者、校对者)的智能体去完成一个动态变化的任务(用户可能随时提出新要求)。每个智能体都有自己的“状态”(任务完成度、可用工具、历史记录),这类似于MMAO-Dyn中的能量和位置。智能体之间需要通信和协作,优秀的中间结果(类似优质解)需要在群体中传递。
MMAO-Dyn中的“代谢”机制,可以启发我们为AI智能体设计更精细的 资源管理与调度策略 。例如,为每个智能体分配“计算预算”或“API调用额度”,成功完成子任务获得“预算”奖励,失败则扣除。预算充足的智能体可以尝试更具探索性(风险性)的策略,而预算不足的则需采取保守策略。这能有效防止智能体陷入无意义的循环或滥用资源。
将MMAO-Dyn的思想应用于AI智能体系统的元调度层,或许能创造出更高效、更鲁棒、更能适应复杂动态任务的智能体团队。这不再仅仅是优化一个数学函数,而是优化一个由 LLM 、工具调用和环境反馈构成的复杂动态系统。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号