MMAO-Cls联合特征选择与分类器调优
原创
MMAO-Cls联合特征选择与分类器调优
原创
用户4859102
发布于 2026-11-17 12:34:48
发布于 2026-11-17 12:34:48
1. 项目概述:当多智能体遇上代谢优化
最近在折腾一个老生常谈但又总让人头疼的问题:如何在一个 机器学习 项目中,既能把那些冗余的、甚至是有害的特征精准地踢出去,又能把分类器的参数调得恰到好处,让模型性能真正起飞?这俩事儿,特征选择和分类器调优,理论上应该手拉手一起干,但实际操作里,往往是你干你的,我干我的,最后结果凑一块儿总觉得差点意思。传统的网格搜索、随机搜索,或者一些元启发式算法像遗传算法、粒子群,要么计算开销大得吓人,要么容易陷入局部最优,对于这种高维、复杂的联合优化问题,总感觉有点力不从心。
所以,当我看到“MMAO-Cls: Metabolic Multi-Agent Optimization for Joint Feature Selection and Classifier Tuning”这个标题时,眼前确实一亮。这名字拆开看就很有意思:“Metabolic”让人联想到生物体内的新陈代谢,一种动态、平衡、能量驱动的过程;“Multi-Agent”则是多个具有自主性的智能体协同工作;合在一起,目标直指“联合特征选择与分类器调优”。这显然不是简单地把两个算法拼起来,而是试图构建一个仿生学的、自组织的优化框架,让特征子集和分类器参数在一种模拟的“代谢”环境中,通过多智能体的交互与竞争,共同进化到最优状态。
简单来说,MMAO-Cls想干的,就是让机器学习的模型配置过程变得更“聪明”、更“自动”。它试图模拟一个微观生态系统,其中每个智能体代表一种可能的“特征子集+分类器参数”组合方案。这些智能体像细胞一样,会进行“代谢”(评估自身适应度,即模型性能),会“繁殖”(生成新的候选方案),也会“死亡”(淘汰劣质方案)。通过这种群体智能的涌现,最终找到那个在给定数据集上表现最好的联合配置。这对于处理高维数据(比如基因表达数据、图像特征、文本向量)的场景尤其有吸引力,因为手动或半自动地遍历所有可能性几乎是不可能的。
如果你正在为你的分类模型寻找一个更自动化、更强大的配置方案,特别是当你的数据特征维度成百上千,而你对哪些特征真正有用心里没底时,那么深入理解MMAO-Cls背后的思路和可能的实现路径,会给你打开一扇新的大门。它不仅仅是一个工具,更是一种解决复杂优化问题的新范式。
2. MMAO-Cls核心思路与设计哲学
要理解MMAO-Cls,我们不能只盯着“优化”这个词,得把“代谢”和“多智能体”这两个核心隐喻吃透。这决定了整个算法的设计哲学和运行逻辑,跟传统的优化算法有本质区别。
2.1 “代谢”隐喻:能量、生存与进化驱动力
在生物学中,代谢是生物体维持生命活动的一系列化学反应,核心是物质与能量的转换。将这个概念引入优化算法,意味着我们需要为每一个候选解(在这里是“特征子集+参数组合”)定义一种“能量”或“适应度”,并且设计一套规则,让解能够根据其“能量”水平进行“生长”、“繁殖”或“消亡”。
在MMAO-Cls的语境下,一个智能体的“代谢”过程可以这样理解:
- 能量摄入(适应度评估) :智能体当前的配置(即它选择的特征子集和分类器超参数)被用于在训练集上拟合分类模型,再在验证集上评估。评估指标(如准确率、F1分数、AUC)经过某种转换(例如,直接作为能量值,或进行归一化、加权处理)后,就成为该智能体的“能量值”。性能越好,能量越高。
- 能量消耗(复杂度惩罚) :纯粹的模型性能可能不是唯一目标。我们通常希望模型更简洁(特征更少)、更高效。因此,“代谢”过程需要包含“消耗”。例如,一个选择了过多特征的智能体,即使准确率略高,也可能因为模型复杂度高、泛化能力存疑而被扣除一部分“能量”。这通常通过正则化项来实现,比如在适应度函数中加入与特征数量成正比的惩罚项。
- 能量状态决定行为 :高能量的智能体“生存”状态好,有更高的概率被选中进行“繁殖”(产生新解),也可能有更强的“抵抗力”避免被淘汰。低能量的智能体则面临“能量枯竭”,有更高概率被从种群中移除。
这种设计巧妙地将多目标优化(最大化性能、最小化复杂度)融入到了单个“能量”指标中,并通过代谢过程自然地进行权衡。
2.2 “多智能体”架构:分布式、协同与竞争
与传统优化算法中只有一个“种群”概念不同,多智能体系统将每个候选解视为一个具有简单感知、决策和行动能力的自主实体(智能体)。在MMAO-Cls中,每个智能体至少需要维护以下信息:
- 状态 :当前的特征选择掩码(一个二进制向量,表示每个特征是否被选中)和分类器超参数向量。
- 能量 :当前适应度值。
- 位置 :可以想象智能体存在于一个离散的网格环境(如二维网格)中。这个“位置”主要用于定义智能体之间的邻域关系。
智能体之间的交互规则是整个算法的引擎,主要包括:
- 竞争 :一个智能体会感知其邻域(如上、下、左、右相邻的网格)内其他智能体的能量。如果自身能量低于某个邻居,它可能会被该邻居“取代”或“吸收”。具体实现上,可以是低能量智能体直接复制高能量邻居的状态(带有一定变异),然后自身被移除。这模拟了优胜劣汰。
- 合作/繁殖 :高能量的智能体可以“繁殖”新的智能体。繁殖不是简单的克隆,而是包含变异和交叉操作。例如,两个高能量的“父代”智能体,通过交换部分特征选择位或超参数值(交叉),并随机翻转某些特征位或扰动某些参数(变异),产生“子代”智能体。子代智能体会被放置在父代智能体附近或种群中空闲的位置。
- 自学习 :除了群体交互,每个智能体也可以进行局部搜索。例如,以一定概率随机翻转一个特征选择位(即增加或删除一个特征),或对某个超参数进行小范围随机扰动,然后重新评估能量。如果能量提升,则接受这个改变;否则,可能以某种概率接受(模拟退火思想)或拒绝。
这种多智能体架构的优势在于其 并行性和涌现性 。优化过程不是由一个中央控制器主导的,而是由大量简单个体的局部交互自发形成的。这有助于维持种群的多样性,避免早熟收敛(陷入局部最优),并且算法天然地适合并行计算,因为每个智能体的评估和局部更新在很大程度上是独立的。
2.3 联合优化的编码与解码策略
MMAO-Cls要同时优化特征子集(离散二进制问题)和分类器参数(可能是连续值、离散值或混合类型),如何将这两部分统一编码到一个智能体的“状态”中,是关键的一步。
一种直观的编码方式是 串联编码 。假设我们有 D 个原始特征,分类器有 K 个需要调优的超参数。那么一个智能体的状态可以表示为一个长度为 (D + K) 的向量。向量的前 D 位是二进制位,0表示不选择该特征,1表示选择。后 K 位则是对应超参数的实际值或归一化值。对于连续参数,可以在其定义域内取实数值;对于离散参数,可以直接用整数或枚举索引表示。
解码过程 则对应于模型训练:
- 根据前
D位二进制码,从原始数据集中抽取对应的特征列,形成新的训练子集。 - 将后
K位映射回分类器可接受的超参数值。 - 使用这个特征子集和超参数配置,在训练集上训练分类器,在验证集上评估性能,得到适应度(能量)。
这种编码方式简单直接,但需要注意,特征选择和参数调优的搜索空间性质不同,在变异和交叉操作上可能需要区别对待。例如,对二进制部分采用位翻转变异和单点交叉,对连续参数部分采用高斯扰动变异和算术交叉。
注意:适应度函数的设计是灵魂 。它直接决定了进化的方向。一个良好的适应度函数应该是:
Fitness = α * Model_Performance - β * Feature_Count - γ * Model_Complexity。其中,Model_Performance是主要指标(如交叉验证准确率),Feature_Count是所选特征数量,Model_Complexity可能与分类器本身的复杂度有关(如SVM的C参数、树的最大深度等)。α, β, γ是权重系数,需要根据具体任务调整。如果β和γ设为0,那就退化为单纯的性能优化。
以六个特征与两个SVM参数为例,候选方案可以拆成下面几部分。表中取值仅用于说明编码与解码。
组成部分 | 示例取值 | 解码后的含义 |
|---|---|---|
特征掩码 |
| 使用第1、3、5个特征 |
正则化参数 |
| 传给SVM的正则化参数 |
核参数 |
| 传给RBF核的参数 |
特征比例 |
| 用于记录紧凑性,并按目标定义参与评价 |
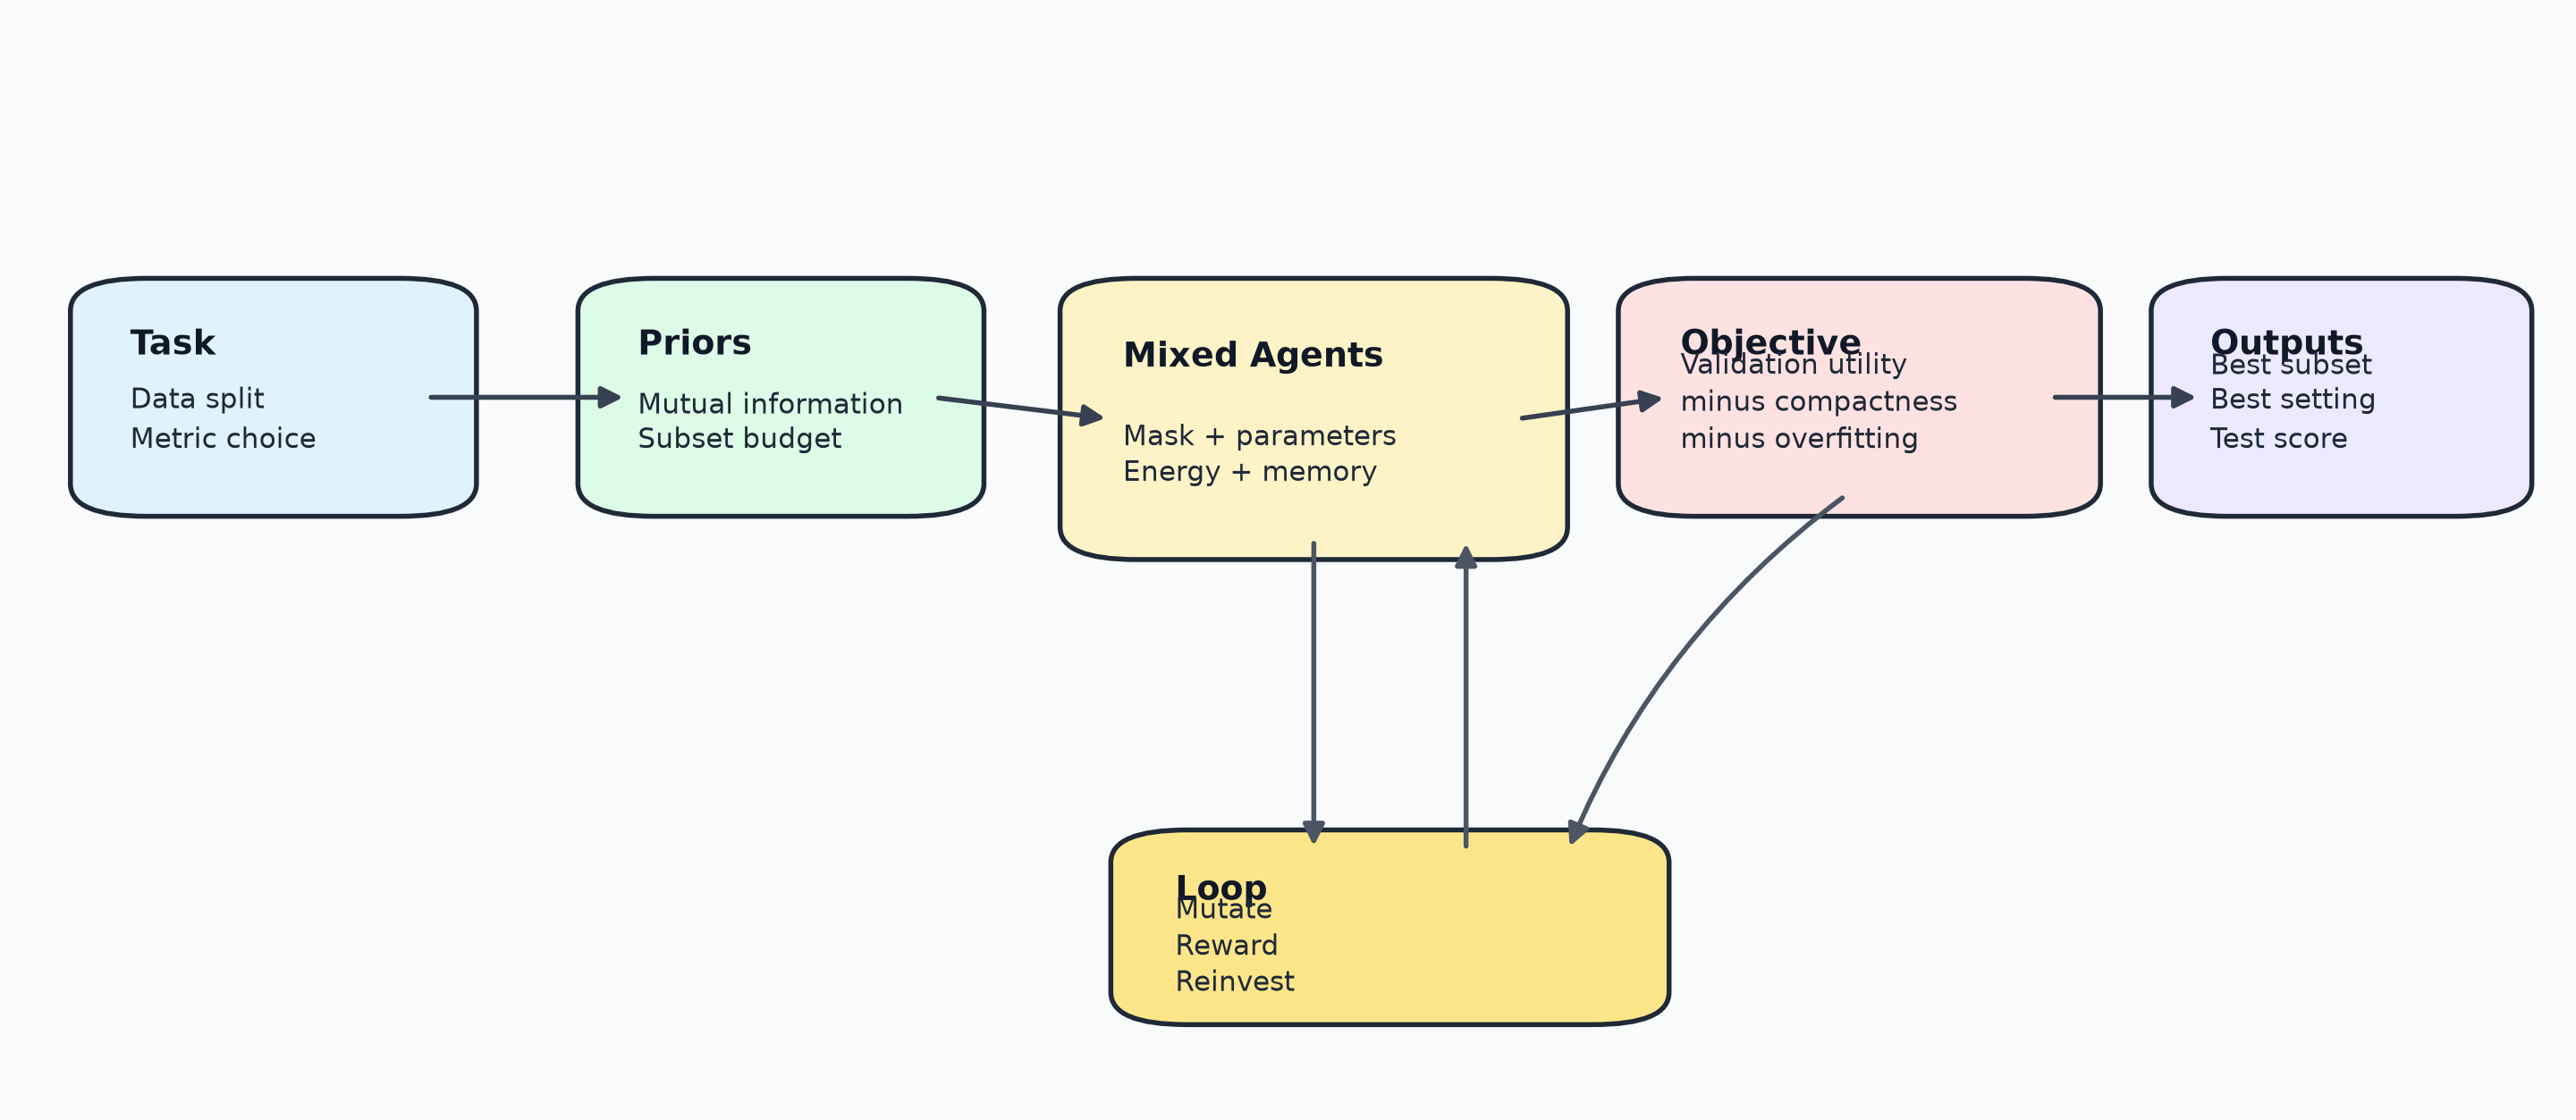
MMAO-Cls混合配置搜索工作流
图1 MMAO-Cls论文的工作流原图,展示特征先验、混合候选、分类评价与资源反馈,保留英文标注。来源见文末图表资料。
沿图1跟踪一次候选评价,可以看到分类表现与特征规模进入同一反馈过程。论文实现还维护独立的私有能量、公共资源池和连续角色状态。下文为便于展示邻域交互,采用二维网格,并用适应度直接表示示例中的能量,具体更新方式按所用实现核对。
3. MMAO-Cls核心组件与实操设计
理解了设计哲学,我们就可以动手搭建MMAO-Cls的骨架了。这里我将以一个具体的场景为例:使用支持向量机(SVM)对一组高维数据进行分类,我们需要同时选择最优特征子集并调整SVM的 C (正则化参数)和 gamma (核函数参数)两个关键超参数。
3.1 智能体与环境初始化
首先,我们需要定义智能体种群的大小和它们所处的环境。假设我们设置一个 N x N 的二维网格世界,每个格子最多容纳一个智能体。种群大小 M 可以小于网格总数( N*N ),以留出空间给新繁殖的智能体。
初始化步骤:
- 随机生成初始种群 :随机创建
M个智能体。对于每个智能体:- 特征选择部分 :随机生成一个长度为
D的二进制向量,每一位以概率p_init(例如0.3,鼓励初始选择少量特征)设置为1。 - 参数部分 :在
C和gamma的合理对数尺度范围(如C在[1e-3, 1e3],gamma在[1e-4, 1e1])内随机采样。通常在对数空间均匀采样更有效。 - 计算初始能量 :使用上述解码和适应度评估流程,计算每个智能体的初始适应度。
- 随机放置 :将这些智能体随机放置在空的网格位置上。
- 特征选择部分 :随机生成一个长度为
- 定义邻域 :通常采用冯·诺依曼邻域(上下左右四个方向)或摩尔邻域(包括对角线,共八个方向)。每个智能体都知道自己周围有哪些“邻居”。
# 伪代码示例:智能体类定义
class Agent:
    def __init__(self, agent_id, grid_position):
        self.id = agent_id
        self.position = grid_position  # (x, y)坐标
        self.feature_mask = None  # 长度为D的二进制numpy数组
        self.hyperparams = None    # 超参数字典,如 {'C': 10.0, 'gamma': 0.1}
        self.energy = -np.inf      # 适应度,初始化为负无穷
        self.age = 0               # 可选,用于模拟寿命

    def evaluate(self, X_train, y_train, X_val, y_val, fitness_func):
        """解码并评估能量"""
        # 1. 根据feature_mask选择特征
        selected_idx = np.where(self.feature_mask == 1)[0]
        if len(selected_idx) == 0:
            self.energy = -np.inf  # 没有选择任何特征,能量极低
            return
        X_train_selected = X_train[:, selected_idx]
        X_val_selected = X_val[:, selected_idx]

        # 2. 用hyperparams配置分类器并训练评估
        clf = SVC(C=self.hyperparams['C'], gamma=self.hyperparams['gamma'])
        clf.fit(X_train_selected, y_train)
        accuracy = clf.score(X_val_selected, y_val)

        # 3. 计算适应度(能量),加入特征数量惩罚
        num_features = len(selected_idx)
        self.energy = accuracy - 0.001 * num_features  # 简单线性惩罚,系数需调
3.2 代谢循环:竞争、繁殖与自学习的规则设计
这是算法的核心循环,在每一代(或每个时间步)中,所有智能体或按顺序或并行地执行以下操作:
步骤一:竞争与取代 对于网格中的每个智能体 A_i ,检查其所有邻居位置。如果某个邻居位置被智能体 A_j 占据,并且 A_j.energy > A_i.energy ,那么 A_i 有概率被 A_j “击败”。一种常见的规则是: A_i 复制 A_j 的状态(特征掩码和超参数),并施加一个小的随机变异(防止种群过早同质化),然后 A_i 用这个新的状态重新评估能量。这相当于 A_i 向更优的邻居学习。
# 伪代码:竞争操作
def compete(agent, neighbors, competition_rate=0.5):
    stronger_neighbors = [n for n in neighbors if n.energy > agent.energy]
    if stronger_neighbors and np.random.rand() < competition_rate:
        # 选择能量最高的邻居作为学习目标
        teacher = max(stronger_neighbors, key=lambda x: x.energy)
        # 复制状态
        new_mask = teacher.feature_mask.copy()
        new_params = teacher.hyperparams.copy()
        # 施加小变异
        new_mask = mutate_mask(new_mask, mutation_rate=0.05)
        new_params = mutate_params(new_params, scale=0.1)
        # 更新自身状态
        agent.feature_mask = new_mask
        agent.hyperparams = new_params
        # 需要重新评估能量
        agent.evaluate(...)
步骤二:繁殖与扩散 高能量的智能体有机会“繁殖”。我们可以设定一个能量阈值,或者按能量比例选择父代。选中的父代智能体(可以是一个或两个)通过交叉和变异产生子代。
- 交叉 :如果选择两个父代,对特征掩码可以采用单点交叉,对连续参数可以采用模拟二进制交叉(SBX)。
- 变异 :对子代的特征掩码进行位翻转变异,对连续参数进行多项式变异。 产生的子代智能体会被尝试放置到父代周围空闲的网格位置上。如果周围已满,可能替换掉一个能量最低的邻居,或者暂时放入一个缓冲池。
步骤三:自学习(局部搜索) 即使没有邻居竞争,智能体自身也可以尝试 微调 。以较低的概率,智能体对自己的状态进行轻微扰动并重新评估。如果扰动后能量增加,则保留;否则,可能以一定概率接受(模拟退火,有助于跳出局部最优)。
# 伪代码:自学习操作
def self_learning(agent, learning_rate=0.1, temp=1.0):
    if np.random.rand() < learning_rate:
        old_energy = agent.energy
        old_mask = agent.feature_mask.copy()
        old_params = agent.hyperparams.copy()

        # 尝试局部变异
        trial_mask = mutate_mask(agent.feature_mask, mutation_rate=0.02) # 更小的变异率
        trial_params = mutate_params(agent.hyperparams, scale=0.05)
        # 临时评估
        agent.feature_mask, agent.hyperparams = trial_mask, trial_params
        agent.evaluate(...)
        new_energy = agent.energy

        # 决定是否接受
        delta_e = new_energy - old_energy
        if delta_e > 0 or np.random.rand() < np.exp(delta_e / temp): # 模拟退火接受准则
            pass # 接受新状态
        else:
            # 拒绝,恢复旧状态
            agent.feature_mask, agent.hyperparams = old_mask, old_params
            agent.energy = old_energy
步骤四:能量衰减与死亡 为了模拟新陈代谢中的消耗和种群更新,可以引入“年龄”概念,每存活一代,年龄增加。能量也可能随时间缓慢衰减(模拟维持生存的成本)。当智能体的能量低于某个死亡阈值,或年龄超过最大寿命时,该智能体将从网格中移除,释放其位置。这为新的、可能更好的子代智能体腾出了空间。
3.3 算法流程与停止准则
将上述步骤组合起来,MMAO-Cls的主循环如下:
- 初始化 :创建网格环境,随机生成并放置M个智能体,评估其初始能量。
- 循环迭代 (直到满足停止条件): a. 异步或同步更新 :遍历网格中的每个智能体(顺序随机以避免偏差)。 i. 竞争阶段 :智能体查看邻居,执行竞争操作。 ii. 繁殖阶段 :如果智能体能量高,尝试繁殖并放置子代。 iii. 自学习阶段 :智能体尝试局部搜索。 b. 全局操作 (可选,每若干代执行一次): i. 死亡阶段 :检查所有智能体,移除能量过低或过于年老的个体。 ii. 信息素/扩散 (高级特性):可以让智能体释放“信息素”,吸引其他智能体向高性能区域聚集。 c. 评估与记录 :记录当前种群的最佳能量、平均能量、最佳智能体的状态等。
- 停止条件 :通常有以下几种:
- 最大迭代次数 :达到预设的代数。
- 收敛准则 :连续若干代,种群的最佳适应度没有显著提升(变化小于一个阈值)。
- 资源限制 :达到最大计算时间或函数评估次数(FEs)。
实操心得:参数设置的平衡艺术 。MMAO-Cls包含大量参数:种群大小、网格尺寸、竞争率、繁殖率、变异率、能量衰减系数、死亡阈值等。没有一套放之四海而皆准的参数。我的经验是: 从小种群开始 (如10x10网格,几十个智能体), 先确保算法能跑起来并展现出基本的优化趋势 。然后,重点关注 变异率 和 竞争/繁殖的选择压力 。变异率太高,搜索过于随机,收敛慢;太低,容易早熟。选择压力太大(只允许最高能量个体繁殖),收敛快但多样性丢失快;压力太小,进化缓慢。通常需要在一个代表性的小数据集上进行多次实验来微调这些参数。
4. 关键实现细节与 性能优化 技巧
纸上谈兵终觉浅,把MMAO-Cls实现出来并跑出效果,中间有很多坑要踩。这部分分享一些在编码和调优过程中的关键细节和技巧。
4.1 适应度评估的加速策略
整个算法最耗时的部分无疑是适应度评估——即用智能体代表的配置去训练和验证模型。对于SVM,每次训练的时间复杂度至少是 O(n_samples * n_features^2) 到 O(n_samples^2 * n_features) 级别。当种群有几十上百个智能体,迭代成百上千代时,计算量是恐怖的。
加速策略1:利用缓存(Memoization) 很多智能体的配置是相似的,尤其是经过交叉和轻微变异后。我们可以为每个评估过的“特征掩码+超参数”组合计算一个哈希值(如将二进制掩码转为字符串,与参数字符串拼接后取MD5)。在评估前,先查 缓存 。如果命中,直接返回缓存的结果。这能极大减少重复计算。
import hashlib
import pickle

fitness_cache = {}

def get_config_hash(feature_mask, hyperparams):
    """生成配置的唯一哈希键"""
    mask_str = feature_mask.astype(int).tostring()
    param_str = str(sorted(hyperparams.items())) # 确保字典顺序一致
    combined = mask_str + param_str.encode()
    return hashlib.md5(combined).hexdigest()

def cached_evaluate(agent, X_train, y_train, X_val, y_val, fitness_func):
    config_hash = get_config_hash(agent.feature_mask, agent.hyperparams)
    if config_hash in fitness_cache:
        agent.energy = fitness_cache[config_hash]
    else:
        # ... 实际训练评估计算 ...
        fitness_cache[config_hash] = agent.energy
加速策略2:使用廉价代理模型 在算法初期,很多配置明显很差,不需要用完整的训练集和复杂的模型进行精确评估。可以考虑:
- 子采样 :使用训练集的一个子集(如10%)进行快速评估,筛选出有潜力的智能体,再对它们进行全量评估。
- 低级特征 :先在一个降维后的特征空间(如PCA主成分)上进行快速评估,缩小搜索范围。
- 性能预测模型 :训练一个回归模型(如随机森林),根据“特征数量”、“超参数值”等元特征来预测配置的性能,用于初步筛选。但这需要额外的训练数据。
加速策略3:并行化评估 这是最直接的加速手段。因为每个智能体的评估是独立的,可以轻松地将种群评估任务分配到多个CPU核心或机器上。Python中可以使用 multiprocessing 库或 joblib 。
from joblib import Parallel, delayed

def evaluate_population_parallel(agents, X_train, y_train, X_val, y_val):
    """并行评估整个种群"""
    energies = Parallel(n_jobs=-1)(
        delayed(evaluate_single)(agent, X_train, y_train, X_val, y_val)
        for agent in agents
    )
    for agent, energy in zip(agents, energies):
        agent.energy = energy
4.2 特征选择与参数空间的协同变异
特征空间(二进制)和参数空间(连续/离散)的搜索特性不同,在交叉和变异操作上需要特别设计。
- 针对特征掩码的变异 :
- 位翻转 :最基本操作,以概率
p_m翻转每一位。但高维时,变异后特征数量变化可能过大。 - 自适应变异 :根据特征的重要性(可以从当前最优模型或所有模型中统计特征被选中的频率)来调整变异概率。对重要特征,降低其被移除(1->0)的概率;对不重要特征,增加其被移除的概率。
- 块变异 :随机选择连续的一段位进行翻转,这有助于保留特征之间的组合信息。
- 针对连续参数的变异 :
- 高斯扰动 :
new_param = old_param + np.random.normal(0, sigma)。sigma可以随着迭代代数衰减(模拟退火)。 - 多项式变异 :这是NSGA-II等算法中常用的,能产生更均匀分布在父代周围的子代。
- 边界处理 :变异后的参数可能超出定义域,需要处理(如反射、饱和或重新采样)。
- 交叉操作 :
- 特征掩码交叉 :单点交叉、两点交叉、均匀交叉都可以。均匀交叉(每个位独立决定来自哪个父代)在特征选择中很常用。
- 参数交叉 :对于连续参数,模拟二进制交叉(SBX)是标准选择,它能较好地保持分布特性。对于离散参数,可以直接交换或进行离散重组。
一个关键技巧:差异化变异率。 在算法早期,可以使用较大的变异率来广泛探索空间;在后期,逐渐减小变异率,进行精细开发。对于特征掩码,可以设置一个比参数变异率稍高的基础值,因为特征空间的离散性更强,需要更多的扰动来跳出局部最优。
4.3 处理类别不平衡与过拟合
MMAO-Cls的适应度函数通常基于验证集性能。如果数据存在类别不平衡,使用准确率可能不合适,应改用F1-score、加权准确率或AUC。更重要的是,要警惕 过拟合验证集 。因为算法会疯狂地优化在验证集上的表现,很容易找到一个在验证集上过拟合的配置。
防御措施:
- 使用交叉验证(CV)作为适应度 :这是最可靠但最昂贵的方法。对每个智能体的配置,进行k折交叉验证,取平均性能作为能量值。计算量是单次验证的k倍。
- 保留一个独立的测试集 :绝对不要用测试集参与优化!只在算法最终结束后,用找到的最优配置在测试集上评估一次,作为泛化性能的最终报告。
- 在适应度中加入正则化项 :如前所述,惩罚特征数量和模型复杂度(如SVM的C值过大)。这能在一定程度上抑制过拟合。
- 早停法(Early Stopping) :监控在另一个独立的验证集(或交叉验证中留出的一个折)上的性能。当性能不再提升甚至下降时,停止优化。
踩坑实录:验证集泄露的惨痛教训 。我曾经在一个项目中,图省事,直接用单次划分的验证集作为适应度标准。MMAO-Cls果然“不负众望”,找到了一个在验证集上准确率高达95%的配置。结果在完全独立的测试集上,性能暴跌到70%。原因就是算法在验证集上“过拟合”了。后来改用5折交叉验证的平均AUC作为适应度,虽然每次迭代慢了5倍,但最终得到的模型在测试集上的表现稳定且与验证集结果接近。 永远要对优化过程保持警惕,它比你想象的更擅长“作弊”。
5. 效果评估、对比分析与实战建议
实现并调优了MMAO-Cls之后,我们需要系统地评估它的效果,并与传统方法进行对比,看看这额外的复杂度是否值得。
5.1 评估指标与对比基准
评估应该从多个维度进行:
- 最终模型性能 :在独立的测试集上,比较由MMAO-Cls找到的最优配置所训练出的模型,与以下基准方法的性能:
- 基准1:全特征+默认参数 :使用所有特征和分类器的默认参数。
- 基准2:全特征+网格搜索调参 :使用所有特征,但用网格搜索或随机搜索优化超参数。
- 基准3:单独特征选择+调参 :先用一种特征选择方法(如递归特征消除RFE、基于树的重要性选择)选出特征,再对选出的特征进行参数调优。这是常见的“两步走”策略。
- 基准4:其他元启发式算法 :如使用遗传算法(GA)或粒子群优化(PSO)进行同样的联合优化,对比收敛速度和最终解的质量。
性能指标应根据任务选择:准确率、精确率、召回率、F1、AUC、对数损失等。
- 模型复杂度 :
- 所选特征数量 :MMAO-Cls是否找到了更精简的特征子集?
- 模型本身的复杂度 :例如,SVM的支撑向量数量,决策树的深度等。
- 计算效率 :
- 总运行时间 或 总函数评估次数(FEs) 。
- 收敛速度 :达到特定性能阈值所需的迭代次数或时间。
- 鲁棒性 :在不同数据集上,算法性能是否稳定?对初始种群和随机种子是否敏感?(可以通过多次运行计算均值和标准差)。
5.2 结果分析与可视化
为了深入理解MMAO-Cls的行为,可视化是关键:
- 能量进化曲线 :绘制每一代种群的最佳适应度和平均适应度随迭代次数的变化。这可以直观看到算法是否收敛,以及收敛速度。
- 特征选择一致性 :多次运行MMAO-Cls,统计每个特征被选入最优解的频率。高频特征很可能是真正重要的特征。可以绘制特征重要性条形图。
- 参数分布图 :观察最优解中关键超参数的分布情况,是否聚集在某个合理的区域。
- 智能体空间分布 (如果使用网格):可以动态可视化智能体在网格上的位置和能量高低,观察集群的形成和移动,非常有趣。
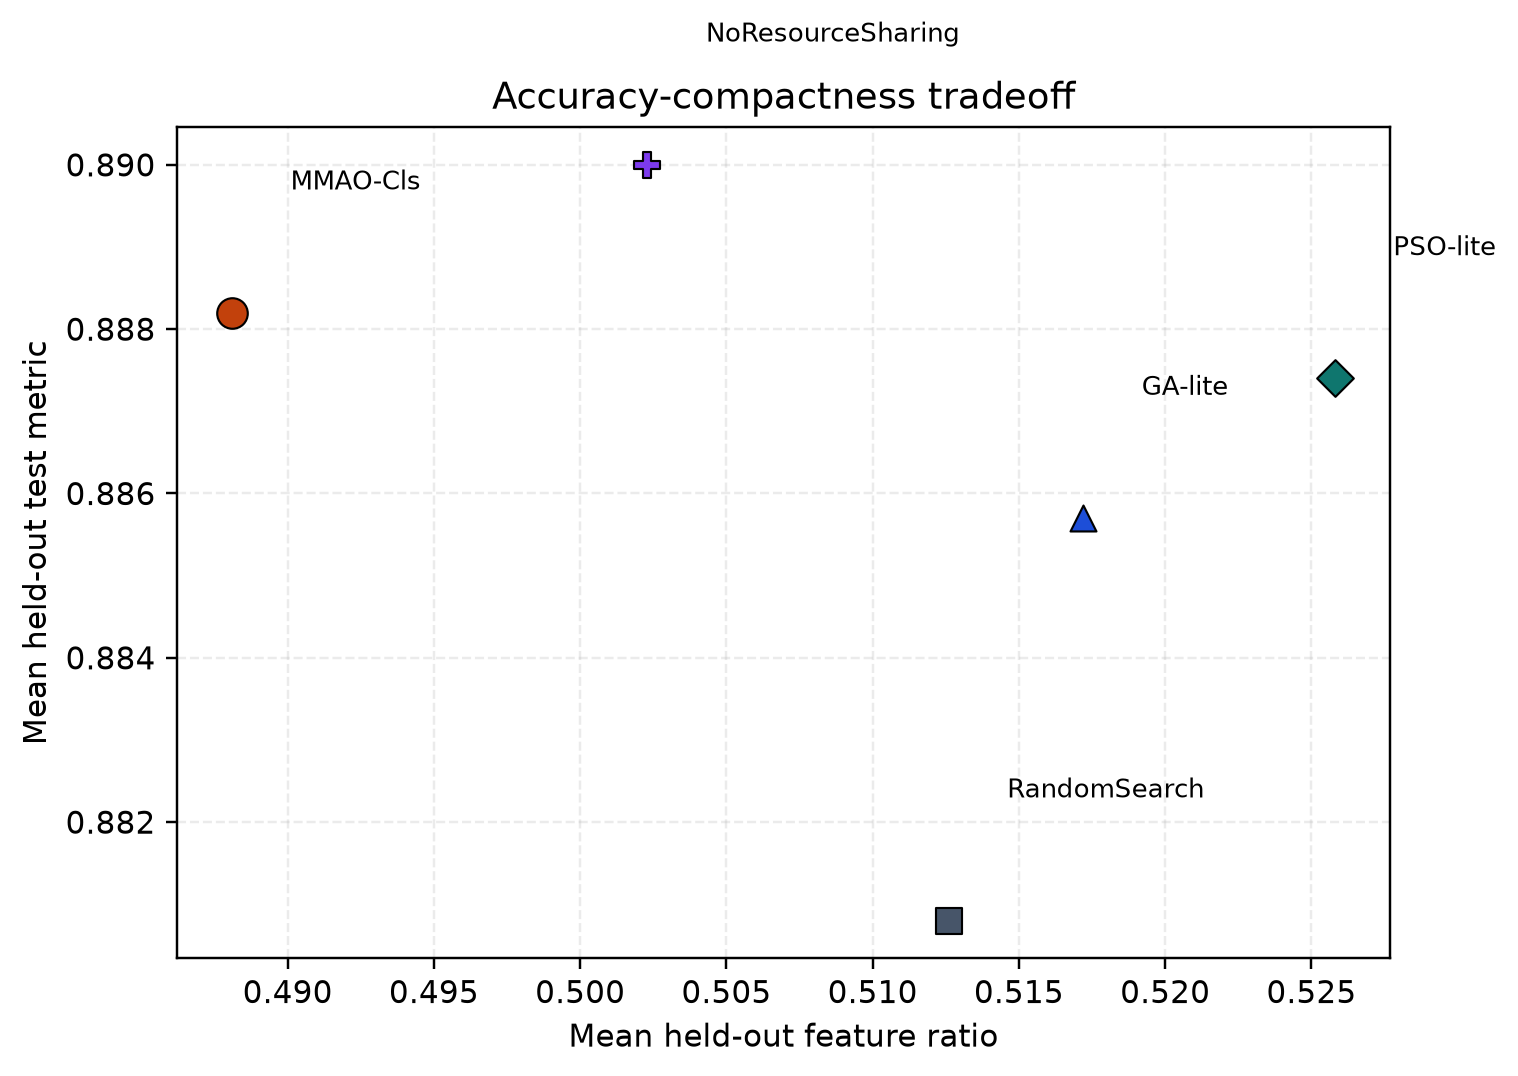
平均测试表现与特征比例的取舍
图2 MMAO-Cls论文七数据集、每个三种子的聚合结果。横轴为平均持出特征比例,纵轴为平均测试指标。各数据集采用平衡准确率或宏平均F1,汇总按论文口径理解。
图2中MMAO-Cls位于最左侧,平均特征比例为0.4881,平均测试指标为0.8882。无共享版本的测试均值略高,为0.8900,平均特征比例也更大,为0.5023。论文中的配对检验未显示显著差异,两个维度应结合逐数据集结果阅读。
实际评估时,可以同时报告测试指标、特征比例和模型训练次数。较小特征集是否降低训练时间或业务采集成本,还可以进一步实测,从而判断联合配置搜索的投入是否值得。
5.3 实战应用建议与局限性
什么时候考虑使用MMAO-Cls?
- 问题维度高 :特征数量众多(>100),且特征间可能存在复杂的交互关系,手动或简单的过滤式特征选择效果有限。
- 参数与特征耦合性强 :分类器的性能强烈依赖于特征子集。例如,SVM的RBF核参数
gamma对特征尺度敏感,不同的特征子集需要不同的gamma。 - 追求自动化流水线 :你需要一个端到端的、能自动输出“特征子集+最优参数”的解决方案,减少人工干预。
- 有充足的计算资源 :虽然我们可以优化,但多智能体优化本身比单一模型训练要耗时得多。对于超大数据集或实时性要求高的场景,需要谨慎。
局限性需要注意:
- 计算成本 :这是最大的瓶颈,尤其当基础模型训练很慢时。
- 参数调优 :MMAO-Cls自身有很多超参数(种群大小、变异率等),需要调整以取得好效果,这又增加了一层复杂度。
- 可解释性 :虽然得到了结果,但理解“为什么是这组特征和参数”可能比传统方法更困难,因为优化过程是黑箱的。
- 过拟合风险 :如前所述,对验证集的过拟合风险很高,必须采用严格的评估策略。
给实践者的最后建议 :不要试图一开始就在大规模问题上使用完整的MMAO-Cls。 从一个小的、代表性的原型问题开始 。比如,从一个公开的中等规模数据集(如UCI的某个数据集)开始,用一个小网格(如5x5)、少代数(如50代)快速验证你的代码逻辑和基本效果。然后,逐步增加复杂度,调整参数,并引入前面提到的加速技巧。把它当作你模型优化工具箱中的一件“重型武器”,在简单工具(如方差过滤、网格搜索)效果不佳时,再考虑动用它。记住,它的核心魅力在于处理 复杂的、耦合的联合优化问题 ,对于简单问题,杀鸡焉用牛刀。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号