MMAO怎么用?从参数寻优到分类建模的五个Python实战
原创
MMAO怎么用?从参数寻优到分类建模的五个Python实战
原创
用户4859102
发布于 2026-11-17 13:04:39
发布于 2026-11-17 13:04:39
优化算法真正开始有用,往往不是在读懂公式之后,而是在你能把自己的问题写成输入、目标和约束之后。
设备参数怎样调到误差最小?一组城市怎样安排更短的巡回路线?有限预算下应该选择哪些项目?环境变化后怎样继续追踪较好的方案?分类任务中能否一边选特征、一边调模型参数?这些问题表面不同,背后都在寻找一个更好的可行解。
mmao-opt 1.0.1把MMAO的多类优化能力整理成了统一的Python接口。本文不从复杂推导开始,而是沿着五个可运行例子,讲清楚怎样安装、怎样选择接口、代码怎样写、结果怎样检查,以及何时适合把自己的问题接进来。
读完后,你应该能够完成三件事:跑通一个最小示例;判断自己的任务更接近哪类问题;用断言和重复运行验证结果,而不是只看终端里出现了一个数字。
第一步:建立一个可复查的环境
建议使用Python 3.10或更高版本,并为教程建立独立环境。安装时固定版本,后续才能把代码、接口和结果对应起来。下面给出两种方案,选择一种即可。
方案一:使用venv和pip
venv随Python提供,适合希望直接控制解释器和安装命令的读者。
python -m venv .venv
.venv\Scripts\python -m pip install mmao-opt==1.0.1
.venv\Scripts\mmao --version上面是Windows写法;在macOS或Linux中,将解释器和命令入口换成.venv/bin/python与.venv/bin/mmao。如果已经激活虚拟环境,也可以直接使用python和mmao。安装成功后,版本命令应输出1.0.1。
方案二:使用uv管理项目
如果已经安装uv,可以让它同时管理Python版本、虚拟环境、项目依赖和锁定文件。下面创建一个名为mmao-demo的项目,并把1.0.1写入项目依赖:
uv init --python 3.12 mmao-demo
cd mmao-demo
uv add "mmao-opt==1.0.1"
uv run mmao --version
uv add会更新项目的pyproject.toml并生成或更新uv.lock。以后进入这个目录,可以通过uv sync按锁定文件恢复环境,通过uv run python your_script.py运行自己的脚本。这样更适合需要把示例代码、依赖和版本控制一起保存的项目。
无论选择哪种环境,都可以先用命令行做一次很小的连续优化检查。venv方案使用:
.venv\Scripts\mmao continuous --problem sphere --dimension 3 --iterations 3 --seed 7 --summary-onlyuv项目方案使用:
uv run mmao continuous --problem sphere --dimension 3 --iterations 3 --seed 7 --summary-only输出中的best_fitness是当前最好目标值,nfev是目标函数评价次数,termination_reason说明搜索因达到迭代数还是评价预算而结束。命令能正常运行,就说明解释器、依赖和命令行入口已经连通。
先判断自己的问题属于哪一类
选择接口前,先看决策变量长什么样,以及“更好”的含义是什么。
- 连续优化:变量是实数,例如温度、压力、学习率、控制增益,通常寻找更小的误差或成本。
- 旅行商问题:变量是一条访问顺序,目标是缩短完整巡回路线。
- 多维背包:变量是选或不选,目标是在多个容量约束下提高总收益。
- 动态优化:目标或环境会随时间变化,算法需要在变化后继续追踪。
- 分类优化:变量同时包含特征子集和分类器参数,需要兼顾预测表现与特征数量。
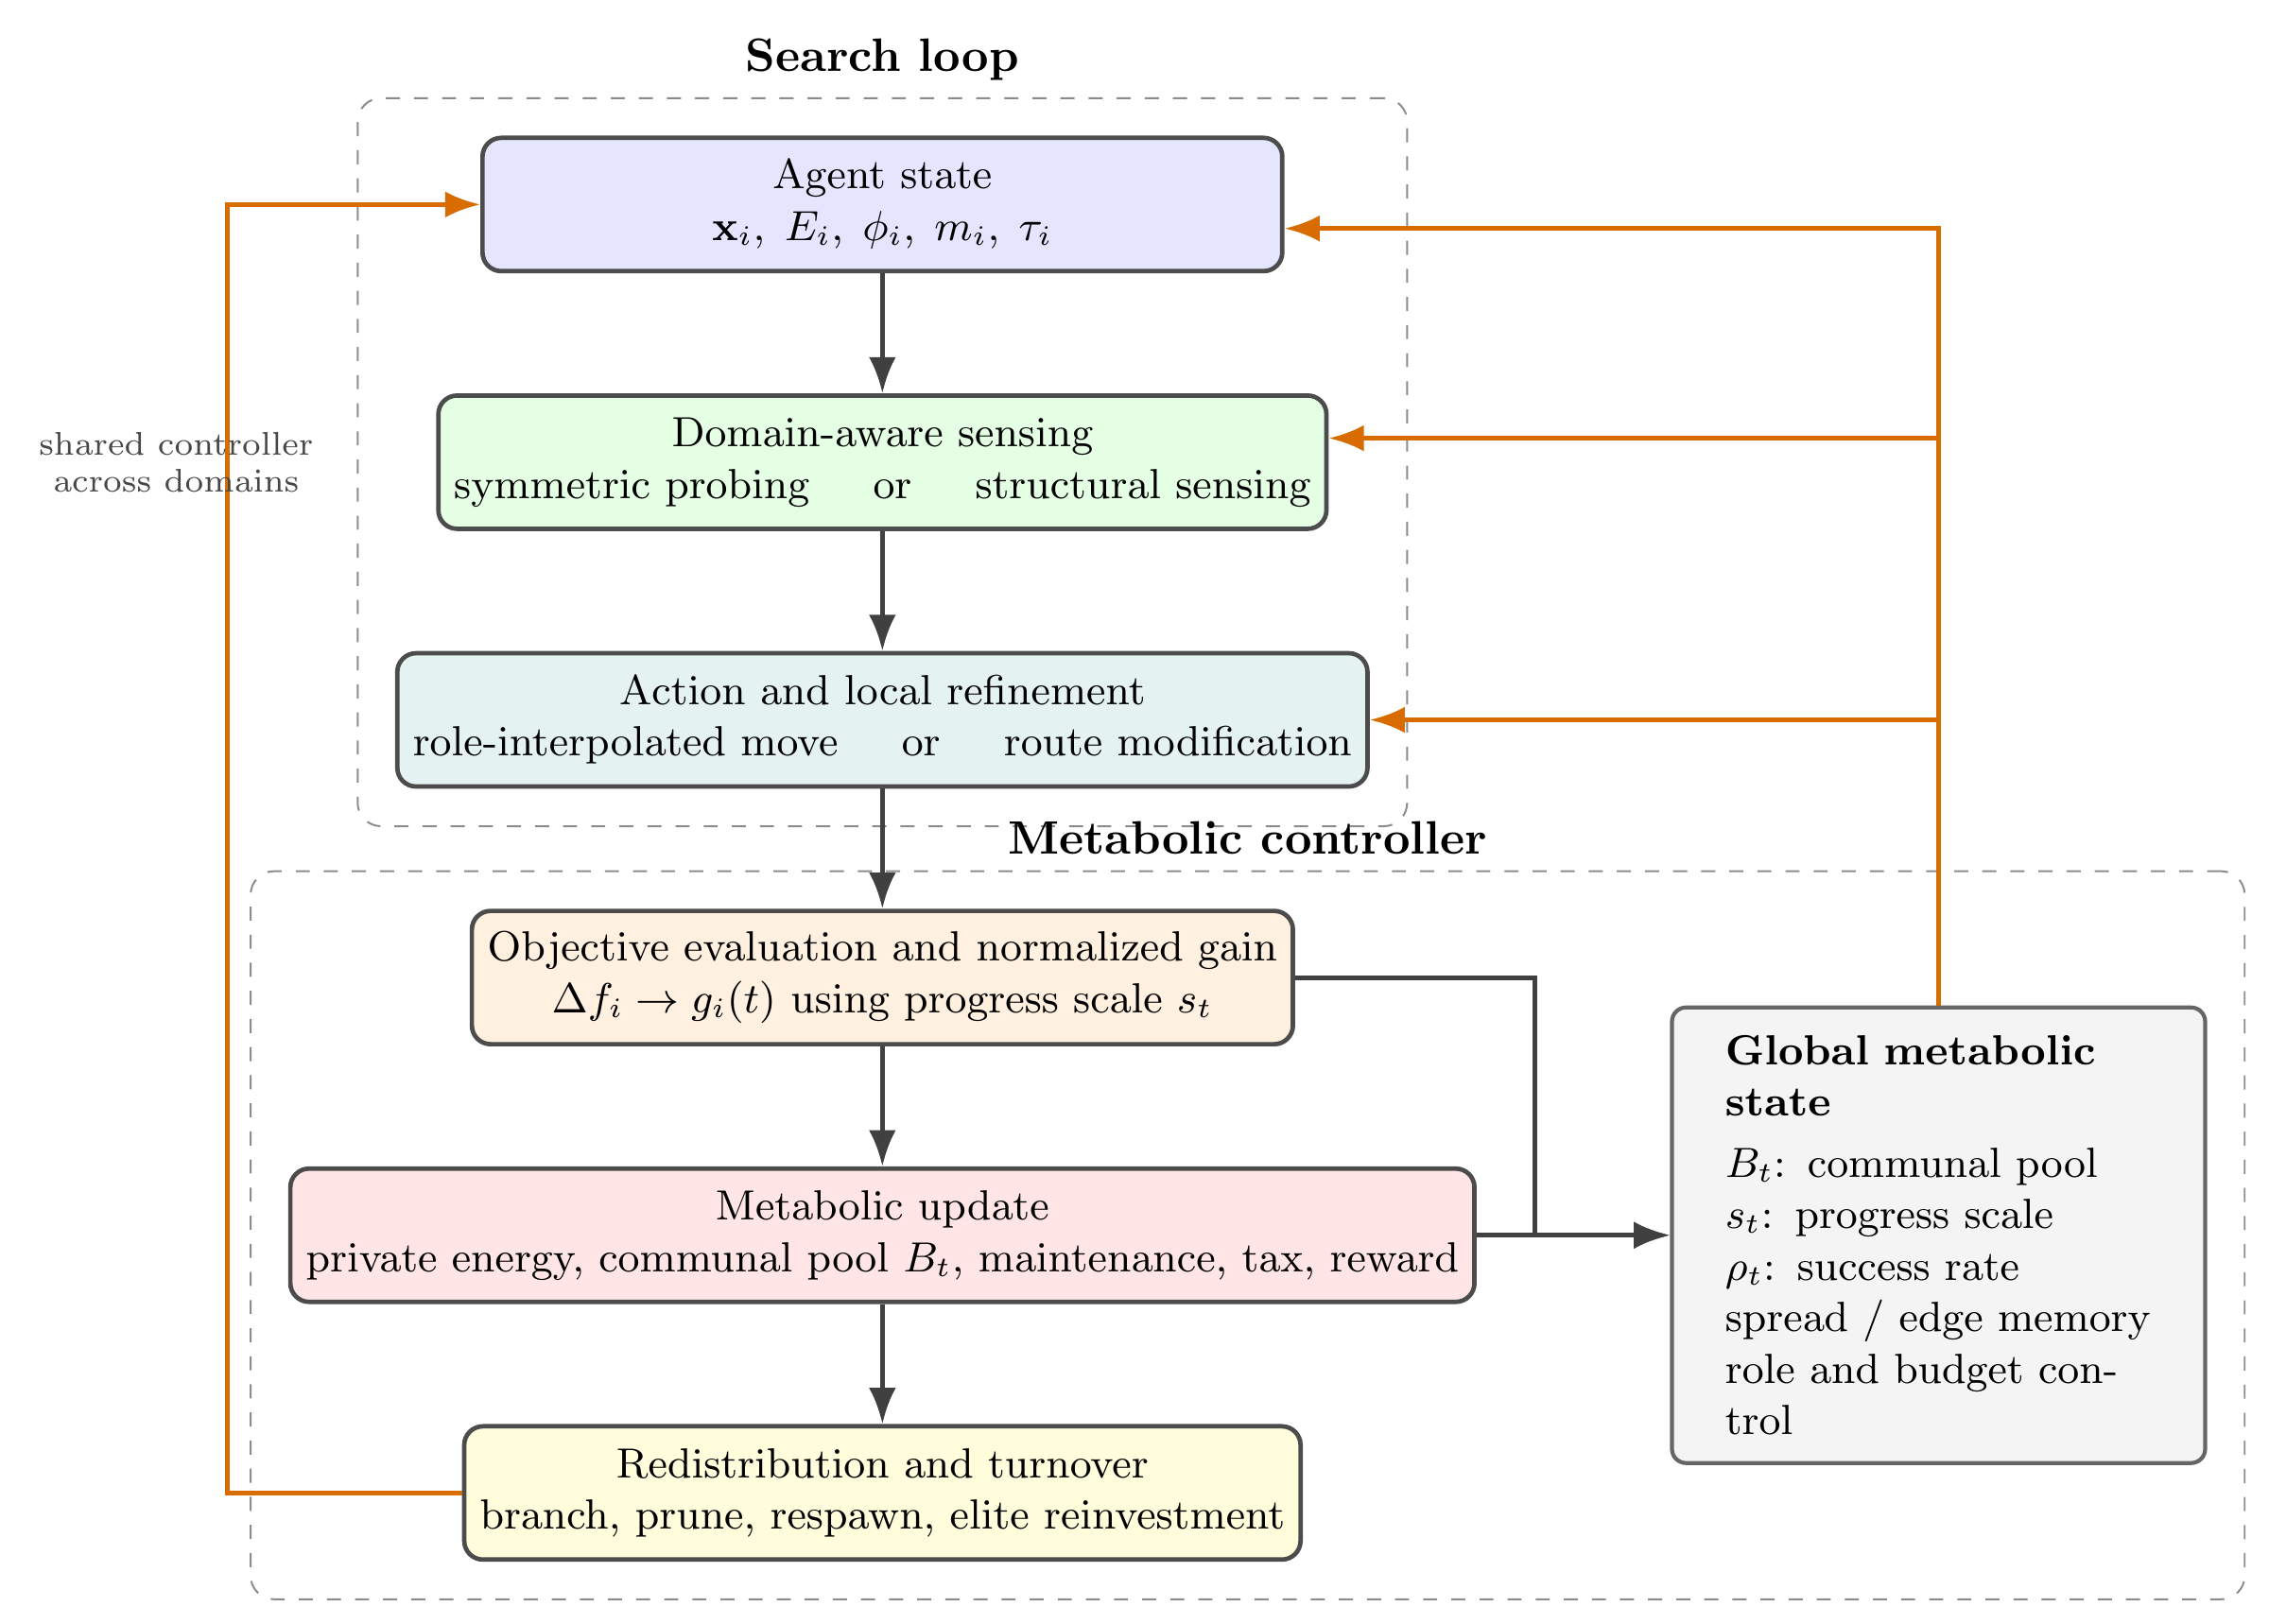
MMAO统一控制框架与任务接口
图1 MMAO统一控制框架。不同任务具有不同的问题表示与评价方式,但都通过候选生成、评价和资源反馈组织搜索。
这五类接口共享相似的调用方式:先构造问题,再构造配置,最后调用optimize_*函数。真正不同的是问题表示、目标方向和结果字段。
实战一:把业务目标写成连续优化问题
先把问题说清楚。这里要求解一个二维二次函数:
目标函数:f(x₁, x₂) = (x₁ − 1.5)² + (x₂ + 0.5)²
两个变量都限制在[-5,5]。函数由两个非负平方项相加,只有当x₁=1.5且x₂=-0.5时,两项才同时为0。因此已知全局最优位置是[1.5,-0.5],最优值是0。函数曲面像一个光滑的碗,没有额外约束,适合用来检查连续优化接口能否正确接收边界、评价候选并返回较优位置。
在业务中,同样的结构可以代表两个设备参数与目标设定值的偏差。更复杂的能耗、仿真误差或验证损失也能放进objective,只要给定一组变量后能够返回一个需要最小化的有限数值。
from math import isclose
from mmao import ContinuousProblem, MMAOContinuousConfig, optimize_continuous


def objective(x):
    return (x[0] - 1.5) ** 2 + (x[1] + 0.5) ** 2


problem = ContinuousProblem(
    name="two-parameter-demo",
    dimension=2,
    bounds=[(-5, 5), (-5, 5)],
    objective=objective,
    optimum_value=0.0,
)

config = MMAOContinuousConfig(
    iterations=100,
    seed=7,
    max_evaluations=500,
)
result = optimize_continuous(problem, config)

position = result["best_position"]
fitness = float(result["best_fitness"])
recomputed = objective(position)

assert result["nfev"] <= 500
assert isclose(recomputed, fitness, rel_tol=0.0, abs_tol=1e-12)

print("position:", position)
print("fitness:", fitness)
print("evaluations:", result["nfev"])
print("stopped by:", result["termination_reason"])本机核对中,种子7在500次评价预算内得到的位置约为[1.5542, -0.4497],目标值约为0.005468,停止原因为max_evaluations。
这里最重要的不是小数点后几位,而是问题映射方法。dimension说明有几个变量,bounds给出每个变量的合法范围,objective接收一个候选方案并返回需要最小化的数值。将设备能耗、仿真误差、模型验证损失或调度成本写成这个函数,就完成了与优化器的接口连接。
代码还把返回位置重新代入目标函数。这个断言很值得保留:它能发现变量顺序、单位换算或结果读取错误。max_evaluations则给搜索设置硬预算,适合一次评价很昂贵的仿真、训练或外部计算。
实战二:用Berlin52理解路线优化
旅行商问题要求从一组地点出发,每个地点恰好访问一次,最后回到起点,使闭环总距离最短。决策变量不是一个普通数值,而是所有地点的访问顺序,因此它属于排列优化。
Berlin52是TSPLIB中的一个对称旅行商基准,包含柏林区域的52个坐标点。软件按照TSPLIB的二维欧氏距离取整规则生成距离矩阵。一个候选解是0到51的一个排列,路线最后一个地点还要连接回第一个地点。该问题记录的已知最优闭环长度为7542,所以除了检查路线是否合法,还能计算当前结果与已知最优值的差距。
这类问题可以映射到配送巡回、设备巡检或某些加工顺序任务。下面使用内置数据,读者不需要先下载或解析外部文件。
from math import isclose
from mmao import MMAOTSPConfig, load_bundled_tsplib_problem, optimize_tsp


problem = load_bundled_tsplib_problem("berlin52")
result = optimize_tsp(
    problem,
    MMAOTSPConfig(iterations=20, seed=11),
)

route = result["best_route"]
n = len(problem.distance_matrix)

assert len(route) == n
assert set(route) == set(range(n))

distance = sum(
    problem.distance_matrix[route[i]][route[(i + 1) % n]]
    for i in range(n)
)
assert isclose(distance, result["best_distance"], abs_tol=1e-9)

print("cities:", n)
print("first ten stops:", route[:10])
print("distance:", result["best_distance"])
print("known optimum:", result["known_optimum"])
print("gap:", result["gap"])本机20轮核对得到的路线长度为8250,Berlin52记录的已知最优值为7542。这个结果并不等于“已经找到最优路线”,而是一次给定轮数和种子的搜索结果。gap让当前路线与已知最优值之间的差距变得可见。
两个断言检查了路线是否合法:城市数量必须正确,每个编号必须恰好出现一次。随后按返回顺序重新计算闭环距离,确认它与best_distance一致。接入自己的路线任务时,核心工作是准备距离矩阵;如果道路有方向、禁行或时间窗,还需要在问题表示中明确相应规则,不能直接把欧氏距离示例当成完整物流模型。
实战三:在多个约束下做选择
多维背包问题回答的是“资源有限时,哪些项目应该选”。每个项目有一项收益,同时消耗多种资源;每个项目只能选择或不选择,因此一个候选解是由0和1组成的向量。目标是在所有容量约束都满足时,让总收益尽可能大。
这里使用mknap2中的第一个实例ORL-MKP-01。它包含28个候选项目和两类资源约束,两项容量都是600。每个项目都有一个收益值,以及在两类资源上的消耗。全选通常会超出容量,少选又可能浪费资源,所以算法需要寻找收益与约束之间更好的组合。该实例记录的已知最优收益为141278。
现实中的项目组合、广告投放、设备装载和投资候选,都可能抽象成类似问题。前提是选择可以写成0或1,并且收益、资源消耗和容量能够量化。
from mmao import (
    MMAOKnapsackConfig,
    load_bundled_orlib_mkp_instance,
    optimize_knapsack,
)


problem = load_bundled_orlib_mkp_instance("mknap2", 0)
result = optimize_knapsack(
    problem,
    MMAOKnapsackConfig(iterations=10, seed=23),
)

solution = result["best_solution"]

for weights, capacity in zip(problem.weights, problem.capacities):
    used = sum(weight * chosen for weight, chosen in zip(weights, solution))
    assert used <= capacity

profit = sum(
    value * chosen
    for value, chosen in zip(problem.profits, solution)
)
assert profit == result["best_profit"]

print("selected items:", [i for i, chosen in enumerate(solution) if chosen])
print("profit:", result["best_profit"])
print("known optimum:", result["known_optimum"])
print("gap:", result["gap"])
本机10轮核对得到的收益为141258,已知最优值为141278,差距为20。MMAO在这里执行的是最大化,因此判断结果时要记住:连续示例希望目标更小,而背包示例希望收益更大。
这段代码逐条重新计算资源消耗,并检查每个容量都没有超限。只有同时通过收益复算和可行性检查,返回的0/1向量才是可以解释的候选方案。
实战四:目标变化以后继续追踪
静态优化假设问题在搜索过程中保持不变。动态优化则考虑目标随时间改变:需求、负载、价格或环境参数变化后,原来的好方案可能立刻变差,算法不仅要搜索,还要在变化后重新恢复。
这里的基础函数是五维Rastrigin函数:
Rastrigin函数:f(x) = 10n + Σᵢ₌₁ⁿ xᵢ² − 10 cos(2πxᵢ)
它在定义域内有许多局部低谷,静态版本的全局最优位置在原点,最优值为0。动态版本实际评价的是发生位移后的函数f(x-sₜ):位移向量sₜ随环境状态改变,最优区域也随之移动。示例把每个变量限制在[-5,5],每10轮触发一次环境变化,变化强度设为1.0,总共运行20轮。
因此,这个实战要观察的不是“最后有没有找到原点”,而是环境移动以后,搜索能否继续靠近新的最优区域。它适合帮助理解动态调度、在线控制和变化负载下的持续寻优,但真实任务还需要定义变化信号和新环境中的评价函数。
from math import isfinite
from mmao import (
    DynamicOptimizationProblem,
    MMAODynamicConfig,
    make_dynamic_problem,
    optimize_dynamic,
)


scenario, bounds = make_dynamic_problem(
    name="dyn-rastrigin",
    dimension=5,
    change_frequency=10,
    change_severity=1.0,
)
problem = DynamicOptimizationProblem(
    name=scenario.name,
    scenario=scenario,
    bounds=bounds,
)
result = optimize_dynamic(
    problem,
    MMAODynamicConfig(iterations=20, seed=7),
)

assert len(result["history"]) == 21
assert result["history"][-1]["regime_id"] >= 1
assert isfinite(result["offline_error"])

print("best fitness:", result["best_fitness"])
print("offline error:", result["offline_error"])
print("final regime:", result["history"][-1]["regime_id"])
print("final change gap:", result["history"][-1]["change_gap"])本机核对中,20轮结束时offline_error约为23.4897,历史共有21条记录,最终已经进入新的环境状态。change_frequency=10表示环境按设定频率发生变化,change_severity=1.0控制变化强度。
动态任务不能只看最后一个best_fitness。offline_error汇总搜索过程中对移动目标的跟踪误差,regime_id标记环境状态,change_gap帮助观察变化发生后当前解受到多大影响。要接入真实任务,还需要定义变化怎样到来,以及变化后旧评价是否仍然有效。
实战五:同时选择特征和分类器参数
这个实战使用经典Iris鸢尾花数据。数据共有150个样本、4个数值特征和3个类别,任务是根据花萼与花瓣的测量值判断鸢尾花类别。基础分类器选择K近邻:预测一个新样本时,查看训练集中距离较近的若干样本,再根据邻居类别作出判断。
这里实际要同时回答两个问题:4个特征中保留哪些,以及K近邻分类器使用什么参数。保留过多特征会增加测量和模型成本,保留过少又可能损失分类信息。MMAO分类接口把特征开关与分类器参数放进同一次搜索,默认用平衡准确率评价分类表现,并通过特征惩罚控制所选特征比例。
软件按随机种子划分训练、验证和测试数据。搜索阶段使用训练与验证数据选择方案,最后才在测试集上报告指标;设置return_model=True后,还会返回包含特征选择和分类器的预测流水线。
from pathlib import Path
from sklearn.datasets import load_iris
from mmao import (
    ClassificationProblem,
    MMAOClassificationConfig,
    optimize_classification,
    save_classification_model,
)


x, y = load_iris(return_X_y=True)
problem = ClassificationProblem(
    name="iris-knn",
    x=x,
    y=y,
    classifier_name="knn",
)
result = optimize_classification(
    problem,
    MMAOClassificationConfig(
        iterations=4,
        seed=3,
        return_model=True,
    ),
)

indices = result["selected_feature_indices"]
predictions = result["model"].predict(x[:3])

assert len(indices) >= 1
assert len(predictions) == 3

Path("outputs").mkdir(exist_ok=True)
save_classification_model(result, "outputs/iris-mmao.joblib")

print("selected feature indices:", indices)
print("classifier parameters:", result["classifier_parameters"])
print("test metric:", result["test_metric"])
print("predictions:", predictions)
本机核对中,这组配置选择了索引为2的特征,测试指标约为0.9444,前三个样本的预测结果均为类别0。分类数据由随机种子决定训练、验证和测试划分;搜索使用训练与验证数据,最终指标来自测试集。
保存的模型已经包含特征选择和分类流水线,因此预测时仍然传入完整特征矩阵。模型文件依赖相应的Python和scikit-learn环境,部署或复查时应同时记录软件版本。Iris只是接口演示,真实数据还需要处理缺失值、类别不平衡、数据泄漏和业务指标选择。
怎样保存一次运行,让结果能够复查
看到一个好结果并不等于实验完成。至少应保存软件版本、配置、随机种子、问题描述、结果和历史记录。
from mmao import write_result_json

write_result_json(result, "outputs/mmao-result.json")
print(result["metadata"]["package_version"])
print(result["metadata"]["config"])
这段代码可以接在前面的任一示例之后。运行元数据包含包版本、Python版本、依赖版本、配置、种子、耗时和问题指纹。对于自定义目标函数,仍应另外保存函数源码或对应提交版本;问题指纹不能代替业务逻辑本身。
如果要比较两种配置,不要只运行一次。固定一组互不重复的种子,对齐评价预算,再比较均值、波动和单次结果。连续优化可以用max_evaluations控制评价上限,避免某个配置只是因为调用目标函数更多而占优。
从示例迁移到自己的问题,按这六步做
第一步,写清决策变量。它们是连续数值、访问顺序、0/1选择,还是特征与模型参数?
第二步,定义“更好”。连续、路线和动态示例通常最小化误差或距离;背包示例最大化收益;分类接口则根据指标和特征惩罚形成搜索目标。
第三步,给出合法范围和约束。边界过宽会增加搜索难度,边界错误则会让结果失去业务意义。
第四步,用人工可计算的小输入检查目标函数。先确认几个已知位置、路线或选择方案,再运行优化器。
第五步,固定种子和预算跑通小规模任务。检查返回字段、重新计算目标、验证约束,并确认停止原因。
第六步,再扩大维度、轮数或数据量。保存历史和配置,观察增加的计算是否真的带来更好的结果。
常见问题从哪里排查
如果出现ModuleNotFoundError,先用运行脚本的同一个Python执行python -m pip show mmao-opt,确认软件包装在正确环境。
如果结果字段不存在,先打印mmao.__version__并核对文章版本。不同版本的接口和结果结构可能变化。
如果连续优化很快耗尽预算,查看nfev和termination_reason。一次外层迭代可能包含多次目标评价,迭代数不等于评价次数。
如果路线或背包结果数值很好但不能执行,优先检查可行性断言。优化输出必须重新放回业务约束中验证。
如果分类指标异常高,检查训练、验证和测试之间是否发生数据泄漏。特征预处理也应放在正确的数据划分内部。
如果动态任务只在环境变化前表现良好,查看regime_id、change_gap和逐轮历史,而不是只保存最后一行。
真正的入门标准:能够解释和复算结果
把示例运行起来只是第一步。更可靠的入门标准是:你知道输入代表什么,知道算法在最小化还是最大化,知道结果字段怎样解释,也能用原始目标和约束重新检查返回方案。
连续优化展示了怎样接入自己的目标函数;路线和背包展示了不同决策结构;动态优化把环境变化带入搜索过程;分类接口则把特征选择、参数搜索和模型保存连在一起。它们共同体现了一条使用路径:把问题表示清楚,给搜索设置可比较的条件,再让输出接受独立验证。
当这条路径跑通之后,MMAO就不再只是一个算法名称,而是一个可以替换目标、数据和约束的实验工具。下一步不是盲目增加轮数,而是把自己的任务缩成一个可核对的小版本,先证明输入、输出和评价都正确,再逐步扩大规模。
资料来源
- Python软件包发布信息与使用文档。mmao-opt(PyPI)
- MMAO代码仓库与版本说明。wolfbrother/mmao(GitHub)
- MMAO统一优化框架论文。DOI:10.1109/ACCESS.2026.3752083;IEEE 文献编号 11783402
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号