图片转可编辑PPT在线工具方便还是用skill方便
原创
图片转可编辑PPT在线工具方便还是用skill方便
原创
用户12848947
发布于 2026-11-17 15:25:20
发布于 2026-11-17 15:25:20
先说结论:这个问题问错了方向。
「在线工具」和「skill」不是同一层的两个竞品,它们各自擅长的是两件不同的事——一个擅长从像素里造出结构,一个擅长在已有结构上做批量加工。图片PPT 这个场景,卡住的环节恰好是前者。
所以真正该问的不是"哪个更方便",而是:你手上这份文件,缺的是结构,还是缺的是后续加工能力?
下面按工程视角拆一遍。文中所有结论都可以自己验证,第六节给了四个不依赖任何工具自述的检查点。
一、先把两个东西的定位说清楚
skill 是什么
以 Anthropic 官方 pptx skill 为例,它本质上是一套写死的操作规程:一个 SKILL.md 说清楚什么情况走哪条路,配一批脚本(unpack.py、validate.py、pack.py、thumbnail.py),再加一份 OOXML 参考文档。agent 读到任务,按规程调脚本,跑完自己校验。
它的能力边界由这三条路线决定:
路线 | 做法 | 前提 |
|---|---|---|
读 | markitdown 提文本、thumbnail.py 出缩略图网格 | 文件是 .pptx |
建 | 写 pptxgenjs 脚本(旧版走 html2pptx + Playwright) | 从零生成 |
改 | 解压 → 改 ppt/slides/slideN.xml → validate → 重新打包 | 文件里已经有 XML 结构 |
注意第三条的前提,这是全文的关键。
在线工具是什么
以我们做的解冻Pro 为例,它是一条固定的算法管线:
没有"路线选择",也不需要 agent 决策。用户把文件拖进去,跑完逐页核对,导出。
二、skill 这条路,认真评估一遍
2.1 拿它处理一张 PPT 截图,会发生什么
假设你手里是一页图片型幻灯片(NotebookLM / ChatGPT 生成的那种,整页就是一张位图),想让 agent 帮你变成可编辑的。
走"建"这条路:agent 会读图,理解内容,然后写一段 pptxgenjs 代码,或者生成 HTML 再用 html2pptx 转成形状。产物打开后,文字确实是文本框,双击能改——这一点它做得到。
但你要接受它的转换是有损的,而且这些损耗在 skill 自己的文档里就写着:
- 重排而不是对齐。它按"视觉层级"重新摆位置,不是按像素坐标还原。标题偏半个字宽、三条要点被合并成一段项目符号、强调色丢失,都是常态。
- 表格不是原生表格。早期
html2pptx.js没有原生表格渲染,需要自己补抽取逻辑;补完之后也常常是一堆矩形的拼合。 - 渲染端不一致。skill 的校验流程是用
soffice把 pptx 渲染成 PNG,再和 HTML 截图做视觉比对。但soffice ≠ PowerPoint——阴影模糊半径、字形 kerning、渐变 stop 都会偏。更要命的是 DPI:对比图统一按 96 DPI 出,DPI 不一致会造出"字号变小了"的假象,查半天查不出问题。 - 字体回退。脚本里写"微软雅黑",Linux 沙箱里没这个字体,渲染时回退,等你打开文件才发现字被换了、文本框被撑破。
走"改"这条路:直接改不了。
图片型 PPTX 解压之后,ppt/media/ 里的图片数量和页数基本相等,ppt/slides/slideN.xml 里每页只有一个 <p:pic> 节点。没有 txBody,没有可改的文本节点。unpack → 改 XML → pack 这套流程再严谨,也没有可改的东西。
2.2 但别急着否定它——skill 真正的价值在别处
公平地说,skill 有四个在线工具短期内给不了的东西:
- 可复现。脚本可以进 git,产物可以 code review,同一份输入跑两次结果一致(前提是步骤里没有 LLM 自由发挥)。
- 可批量。200 份模板固定的文件,写个循环就跑完了,人在旁边喝咖啡。
- 能改结构。改配色、套公司模板、批量替换客户名、补演讲者备注、重排页序——这些是"在结构上动刀",在线工具根本不做。
- 可进 CI。定时任务、流水线、产物归档,都是工程化能力。
一句话:skill 强在"结构已经存在之后的规模化操作"。
三、在线工具的强项,恰好是 skill 的盲区
它解决的是"没有结构,怎么造出结构":
- 版面分析 + 识别:把每块文字的外框、字号、颜色、对齐方式量出来;
- 遮罩与背景重建:按框把文字从原图上擦掉,图标、箭头、色块、照片、图表原地保留,得到一张干净的高清背景;
- 文字层重建:按量出的参数生成 PowerPoint 原生文本框(
sp+txBody),关掉normAutofit,内边距归零只留防裁切余量; - 人眼复核:三栏对照(原图 / 纯背景 / 合成结果)、每个区域可切换状态、框选一块只重跑这一块。
第 4 步是产品化的关键。区域级重跑技术上不复杂——把该区域的裁剪图重新送进识别管线——但它把流程的性质从"整份重来"改成了"局部迭代"。这一改,返工成本从分钟级掉到秒级。
推理放在客户端(ONNX Runtime Web,优先 WebGPU,不支持则回退 WASM + SIMD),换来两个工程上的好处:服务端只做静态资源分发,没有 GPU 成本和并发瓶颈;单份文件的页数只受浏览器内存限制,不受服务端配额限制。代价也很明确:首次要下几十 MB 模型、低端设备推理慢、WebGPU 兼容性不稳需要兜底。
它的硬边界同样清楚:一次一份、单份 40 页、图形不拆成独立对象、不能批量、进不了 CI。
四、七个维度拉平对比
维度 | 在线工具 | skill |
|---|---|---|
改一个错字要多久 | 点一下识别框,改文本,约 3 秒 | 改 prompt 重跑,2~5 分钟,可能连带改坏别处 |
同一文件跑两次是否一致 | 一致(固定管线) | 不保证(模型采样 + 重排) |
200 份批量 | 不支持 | 支持,写循环即可 |
环境依赖 | 浏览器 | Python / Node / 字体 / soffice,缺一个就跑不起来 |
文件是否离开设备 | 否(本地推理) | 取决于运行时;云端沙箱等于上传 |
能否改图表数据 | 不能(图表保留为背景) | 不能(除非重画并重建数据) |
能否进版本管理 / CI | 不能 | 能 |
三个最关键的差异,单独说一下:
① 迭代成本差一个数量级。 这不是效率问题,是性质问题。工具的一次修正 = 一次点击;skill 的一次修正 = 一轮"改代码 → 重跑 → 打开文件验收"。一页改五处,工具是十五秒,skill 是半小时。
② 可复现性。 甲方验收时问"为什么这次和第上次不一样",用 skill 很难解释——模型采样、DOM 遍历顺序、字体回退都可能变。固定算法管线则能给出确定答案。
③ 批量能力。 这是 skill 的绝对主场,也是工具的天花板。一份 200 页的手册,工具得一份一份来(还要拆成 5 个 40 页的文件),skill 一个 for 循环解决。
五、结论:接起来用,别二选一
真正的工程答案是分工:
在线工具负责把"像素"变成"结构",skill 负责在"结构"上做批量加工。
一旦文字变成原生文本框,python-pptx 就能精准替换文本而不动版式——这时候 skill 的价值才真正释放:批量改客户名、改日期、改金额、统一字体、套模板、归档。这些事让工具做,做不了;让 skill 从零做,又得重画一遍。
一个典型的流水线长这样:
顺手给一段能用的代码
批量替换文本,最容易踩的坑是 run 拆分:PowerPoint 会把一句话切成多个 <a:r>,你按整段做字符串替换永远命中不了。
两个必须知道的注意事项:
- 合并 run 会丢局部格式。如果一段话里只有一个词是红色,合并后全段变成首个 run 的格式。所以上面的写法只适合"整段同格式"的段落;混合格式的段落要按 run 逐个替换,或者用 OOXML 直接改
<a:t>。 auto_size = NONE是必须的。不设它,用户改长一句话,PowerPoint 会自动缩小字号,版式从这一页开始崩,而且缩过一次之后很难还原。
反过来的顺序为什么不划算
先让 skill 生成一份,再用工具精修——理论上也能跑,但成本高一截:skill 重排过的版式已经不是你原来的版式了,工具再"还原",还原的是那个被重排过的版本。除非你的目的本来就是"重做一份",那直接走 skill 的"建"路线就行,不必绕。
六、四个自检点
不管用哪条路,验收标准是同一套,而且都不依赖工具的自述:
检查一:解压数图片。 把 .pptx 改成 .zip 解压,看 ppt/media/ 里的图片数量和页数。数量约等于页数,说明每页还是一张图,文字层没有被重建。
检查二:看 XML 里有没有 txBody。 打开 ppt/slides/slideN.xml。真正的文本框会有形状节点带文本体;整页只有一个 <p:pic>,就还是图。
检查三:改长一句话。 把某个文本框里的字加长一倍,看字号有没有自动缩小。缩了,说明 normAutofit 没关,这份文件后面每改一次都会缩。
检查四:放大到 200% 看背景。 重点看图标边缘、细线、箭头的位置有没有缺口或色块残留。这是"擦字重建背景"质量最直接的体现——擦得糙,一眼就能看出来。
七、边界
按惯例把话说全:
- 图形、图表、照片保留在背景层,不能作为独立对象拖动;要改图表数据,得回源工具重做。这一条在线工具和 skill 都一样。
- 手写、模糊、倾斜的文字,工具侧会保留原图不硬擦;skill 侧则可能"猜"一个看起来合理的字。两种失败模式里,保留原图更容易被发现,猜错更难。
- 在线工具单份 40 页的上限是浏览器内存决定的,不是产品策略。
- skill 的产出质量强依赖运行时环境(字体、soffice 版本、DPI 设置),换台机器可能就不一样了。
- 两边都不承诺识别率。数字、金额、专有名词,导出前对一遍原图,这个动作省不掉。
八、小结
回到标题那个问题:
- 你手上是一份改不动字的图片PPT,只想改几个字、换个数字 → 在线工具,例如解冻Pro,专门针对图片转可编辑PPT设计的,每页转换只需几秒,别折腾环境。
- 你手上是两百份结构已经对了的文件,要批量换文案、套模板、进流水线 → skill,写脚本,一次跑完。
- 你手上是一批图片文件,既要还原版式又要批量定制 → 两个都用:工具出结构基线,脚本做批量加工。这是目前最省人力的组合。
工具和 skill 的关系,不是替代,是上下游。想清楚你缺的是"结构"还是"加工能力",选择就没有纠结的余地了。
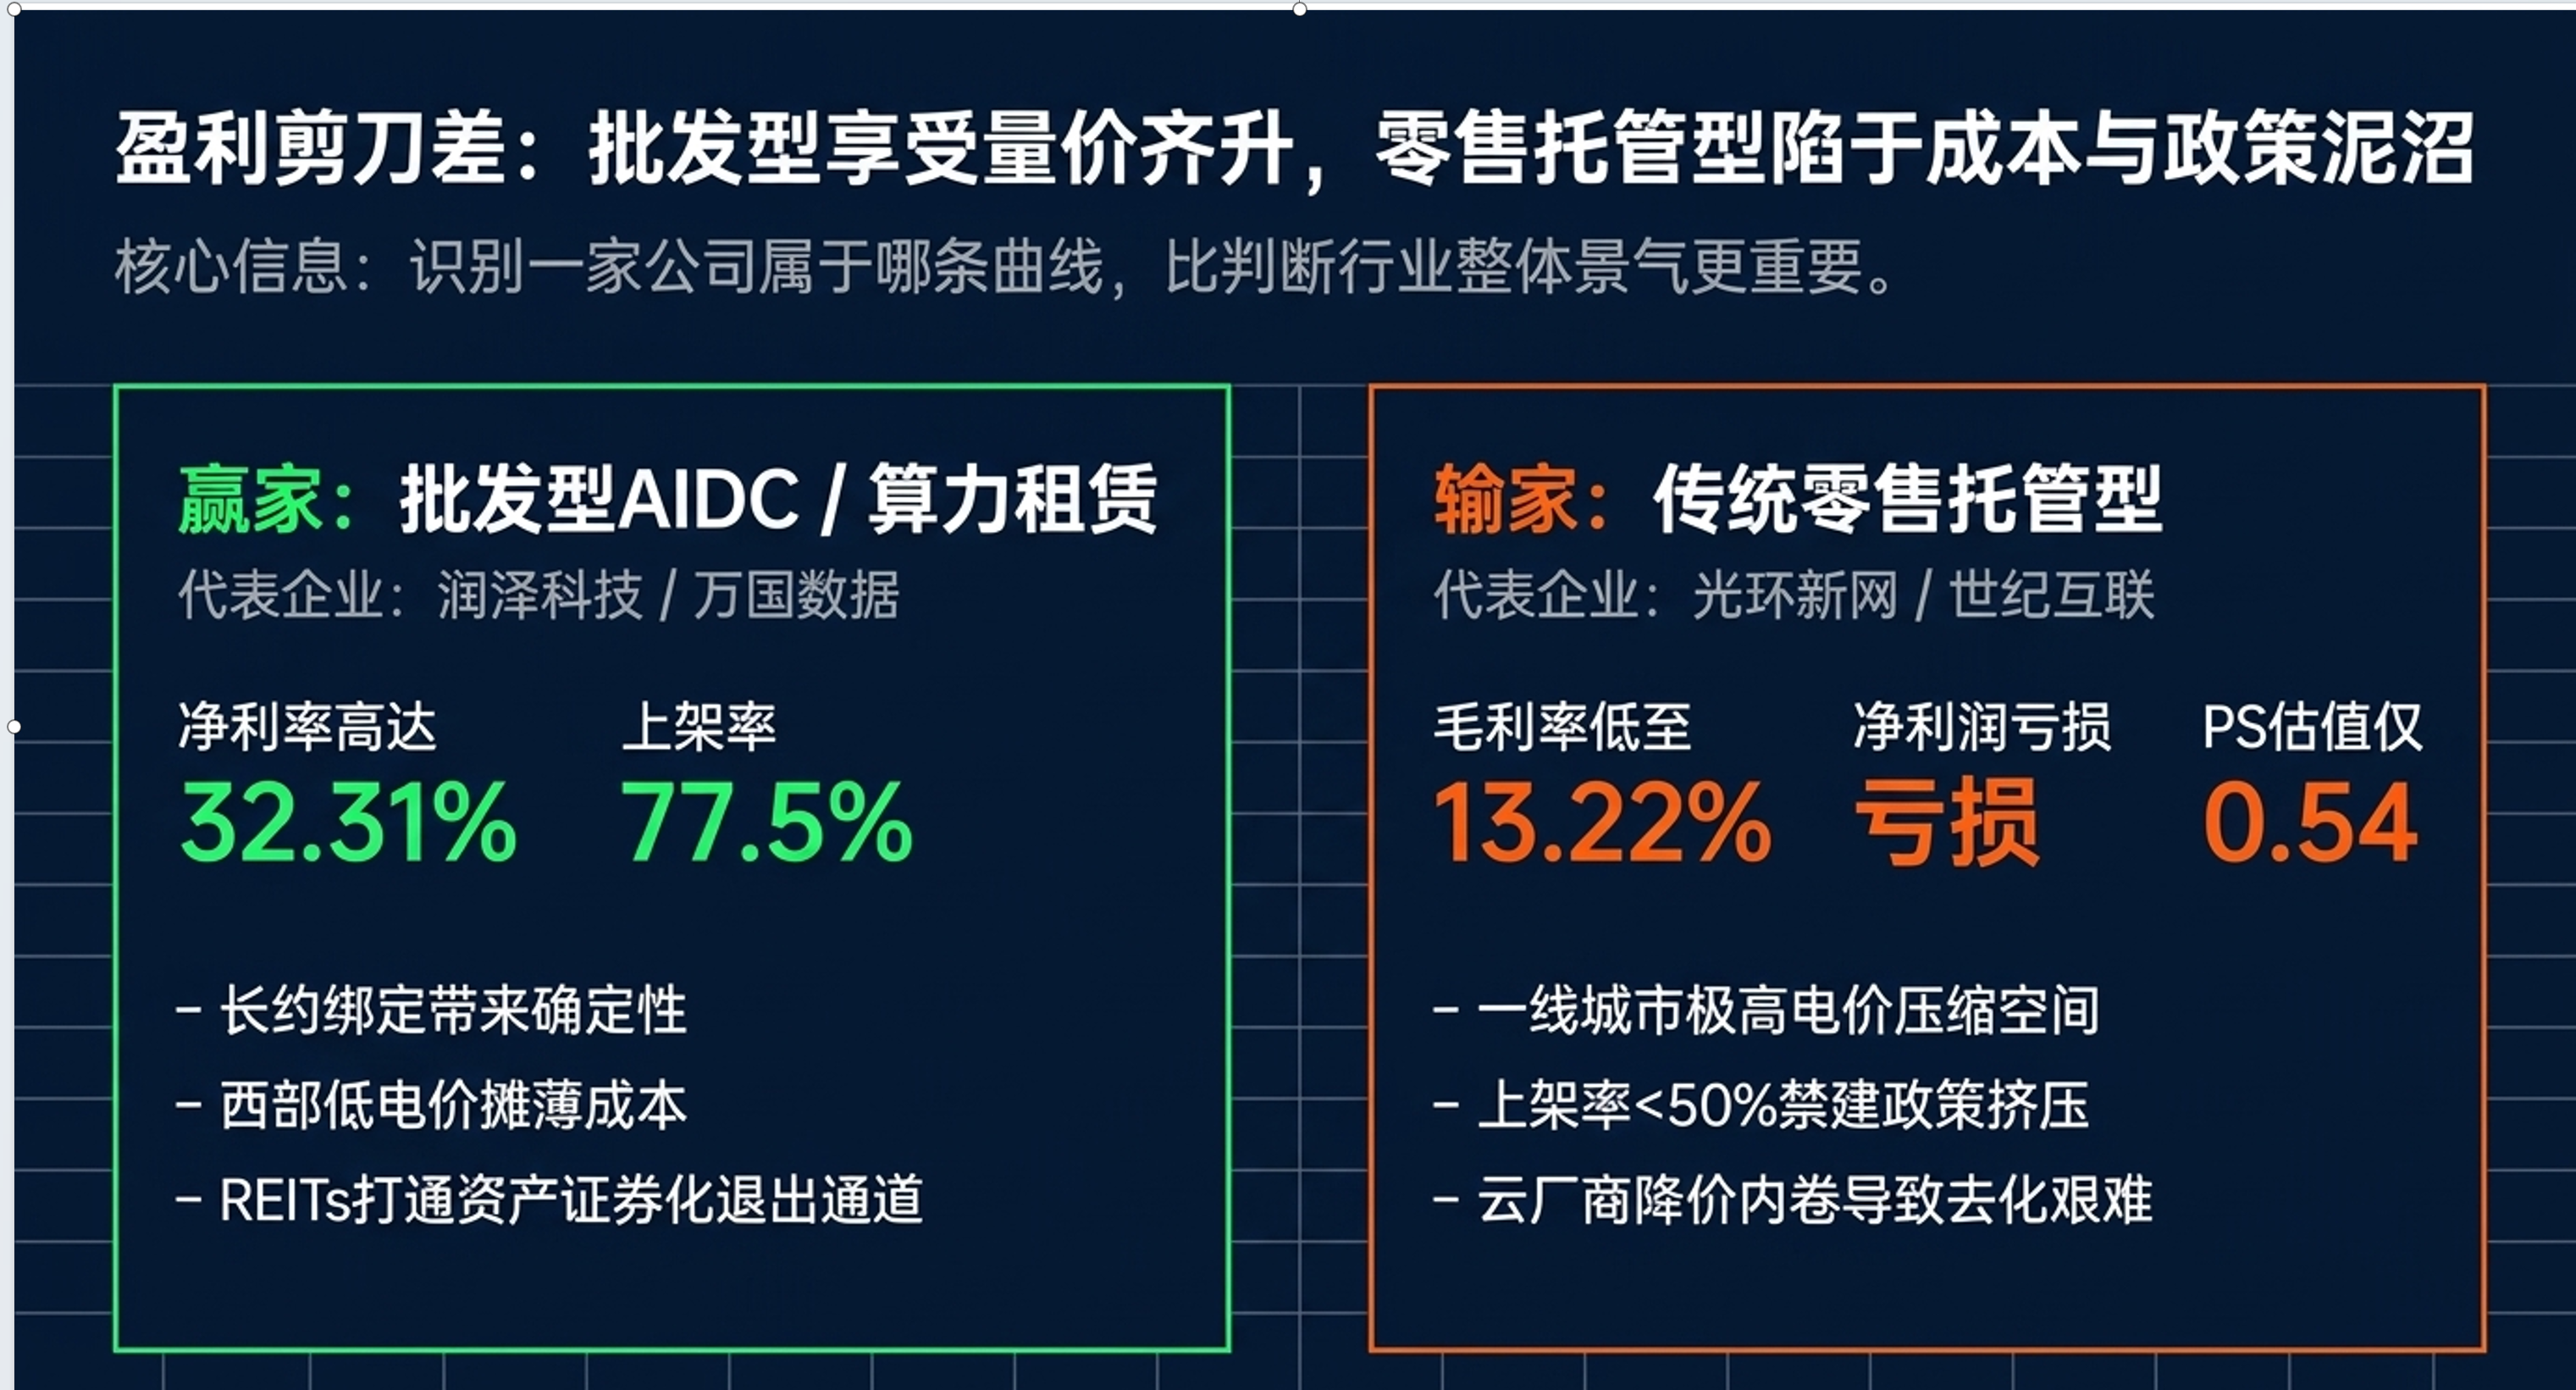
用解冻Pro转换的效果,文字均可编辑
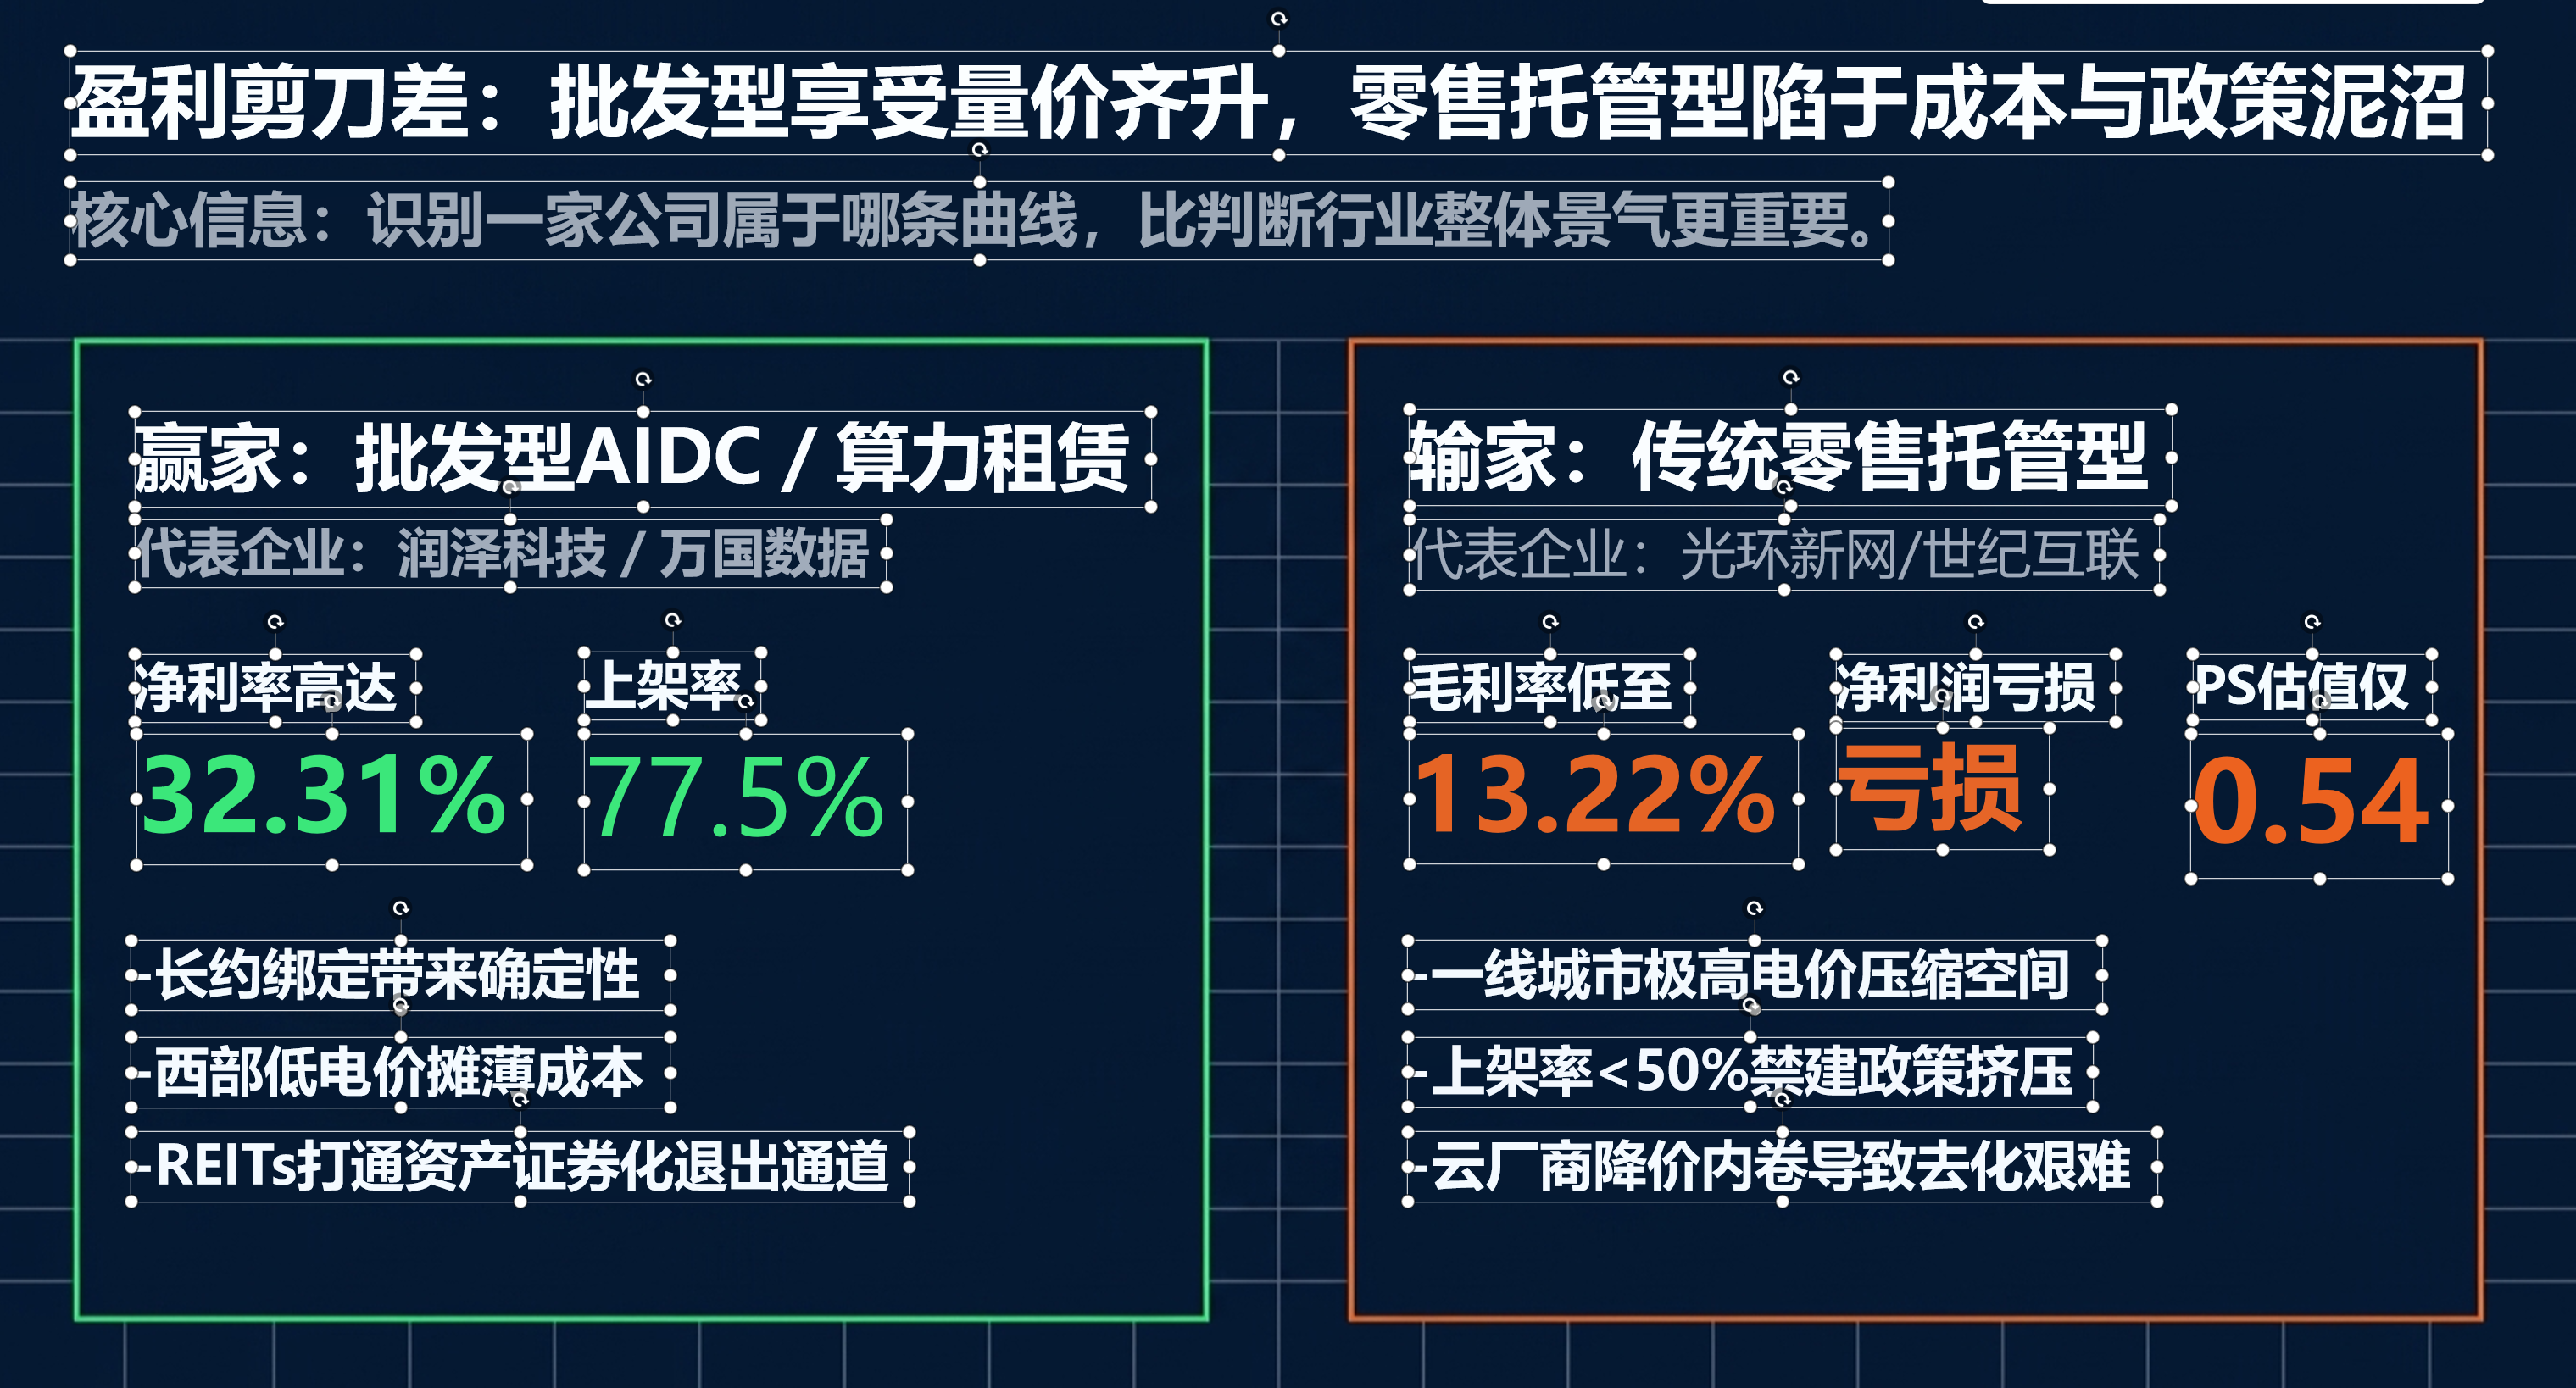
(本文提到的在线工具为解冻PRO,浏览器打开 jiedong.pro 即可使用,免费、免注册、文件本地处理不上传。文中关于 pptx skill 的描述基于其公开的 SKILL.md 与脚本实现,具体行为以你本地安装的版本为准。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号