想得越久,反而越错:AI 推理预算的拐点
原创
想得越久,反而越错:AI 推理预算的拐点
原创
顺势而为
修改于 2026-11-17 22:15:12
修改于 2026-11-17 22:15:12
摘要:我们默认让模型多想一会儿总没坏处。2026 年一篇 ACL 正式论文推翻了这条曲线:准确率会在某个预算见顶,再往下想不只烧钱,还会把答对的题改错。本文拆解负向翻转、拐点随难度移动与效率税,给出把思考预算变成可裁决工程旋钮的清单。
先看一个示意场景,用过推理模型的人大概都能对上号。
一道并不难的题,模型在几百个 token 处已经写出了正确答案。可它没停,接着「再检查一遍」「换个角度验证一下」,又生成几千个 token,最后把答案改成了另一个。人对着日志哭笑不得:第一反应明明是对的。
我们习惯把这叫「模型不够稳」。但 2026 年一批研究指向一个更别扭的结论:这不是能力不够,是不知道什么时候停。 把「思考强度」一路拧到最大,恰恰是最常见、也最贵的默认设置。
这篇文章说清三件事:为什么「更长 = 更准」被证伪;为什么最危险的不是浪费算力而是撤销正确答案;怎么把思考预算从玄学档位,变成可裁决、可记账、可复盘的工程规则。
01 那条被证伪的曲线:峰值不在最大预算处
先建立共识。过去两年大模型能力跃迁,很大一部分来自「测试时计算」(test-time compute):参数不变,回答时允许多花算力去想——拉长思维链、采样多个答案再挑、用验证器反复筛。OpenAI 的 o 系列、Anthropic 的扩展思考、Google 的 thinking budget,都把它做成了可计费档位。
隐含假设几乎是默认的:想得越久,答案越准,曲线单调向上。
2026 年 7 月 ACL Findings 的论文《When More Thinking Hurts》把它拿去做实验:两个开源 32B 模型(DeepSeek-R1-32B、s1-32B),在 AIME 2024/2025、MATH-500、GPQA Diamond 上,把思考预算从 500 到 16000 token 每 500 一档切成 32 档,用 budget forcing 强制「想满」每档,逐题记录答案怎么变。
结果是一条先升、后平、再微微回头的曲线。
数据卡片|准确率随思考预算变化(ACL 2026 论文实证,非生产环境测量)DeepSeek-R1-32B 在 AIME 上:500 token 时 28.2% → 2K 37.8% → 6K 50.2% → 8K 53.8% → 12K 55.8%(峰值) → 16K 54.9%(回落) 边际效用(每 500 token 换来的准确率):0.5–2K 为 +3.2%,8–12K 只剩 +0.1%,12–16K 转为 −0.3% 口径:budget forcing 人为约束、temperature 0、开放权重 32B 模型、4×H100;数字取自论文 Table 1,非闭源前沿模型,也非线上流量
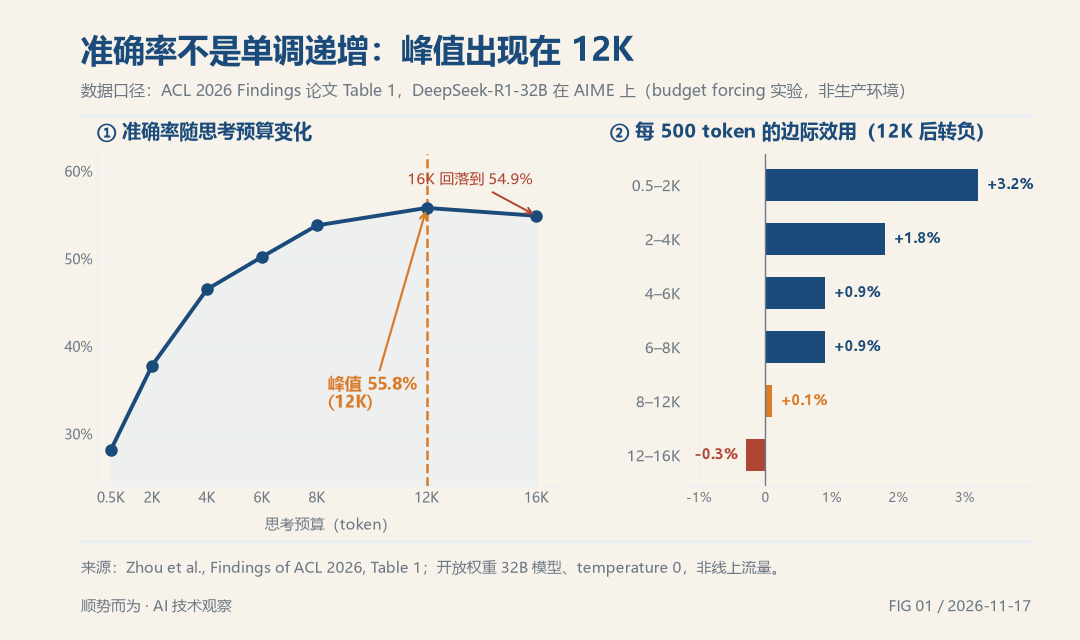
数据图:准确率随思考预算先升后回落,12K 见顶,边际效用转负
最值得盯的不是 55.8% 这个峰值,而是峰值出现在 12K,而不是最大预算 16K。把预算从 12K 加到 16K,多付三分之一算力,买回来的是 −0.9 个百分点。这三分之一不只是钱,还是延迟——客服场景里,多等十几秒本身就是失败。
一句提醒:这条曲线来自数学与科学基准、人为强制拉长的思维链。它证明「单调增益」不成立,不等于「所有模型一想久就变笨」。作者也写了,答案翻转不足以单独证明某一种内部机制必然导致过度思考——记住这个边界,后面的结论才站得住。
02 最危险的不是烧钱,是负向翻转
如果只掉一点准确率,最多算「性价比差」。论文真正扎人的地方,是它逐题追踪了答案是怎么变的。
研究者定义「翻转事件」(flip events):相邻预算档之间同一题答案发生改变。错误变正确是正向翻转,本该要的收益;正确变错误是负向翻转,纯粹的破坏。负向除以正向得到 flip ratio,大于 1 就意味着「继续想,害处开始超过好处」。
交叉点出现在约 7K token。
数据卡片|负向翻转(同一篇 ACL 2026 论文实证)flip ratio 在约 7K token 处越过 1;论文说明 ≥7K 的所有 flip ratio 均统计显著 过度思考的文本指标(犹豫词、反复改答案等)组合起来,能以 76.3% 精确率 / 80% 召回率 预测负向翻转 人工复核 80 个负向翻转样本:67.5% 是「真的重新考虑并拒绝了一个正确答案」,仅 12.5% 是退化伪影 口径:论文 §4.2 与附录,研究者实验;GPQA Diamond 上准确率也在约 10K 见顶,说明不限数学题
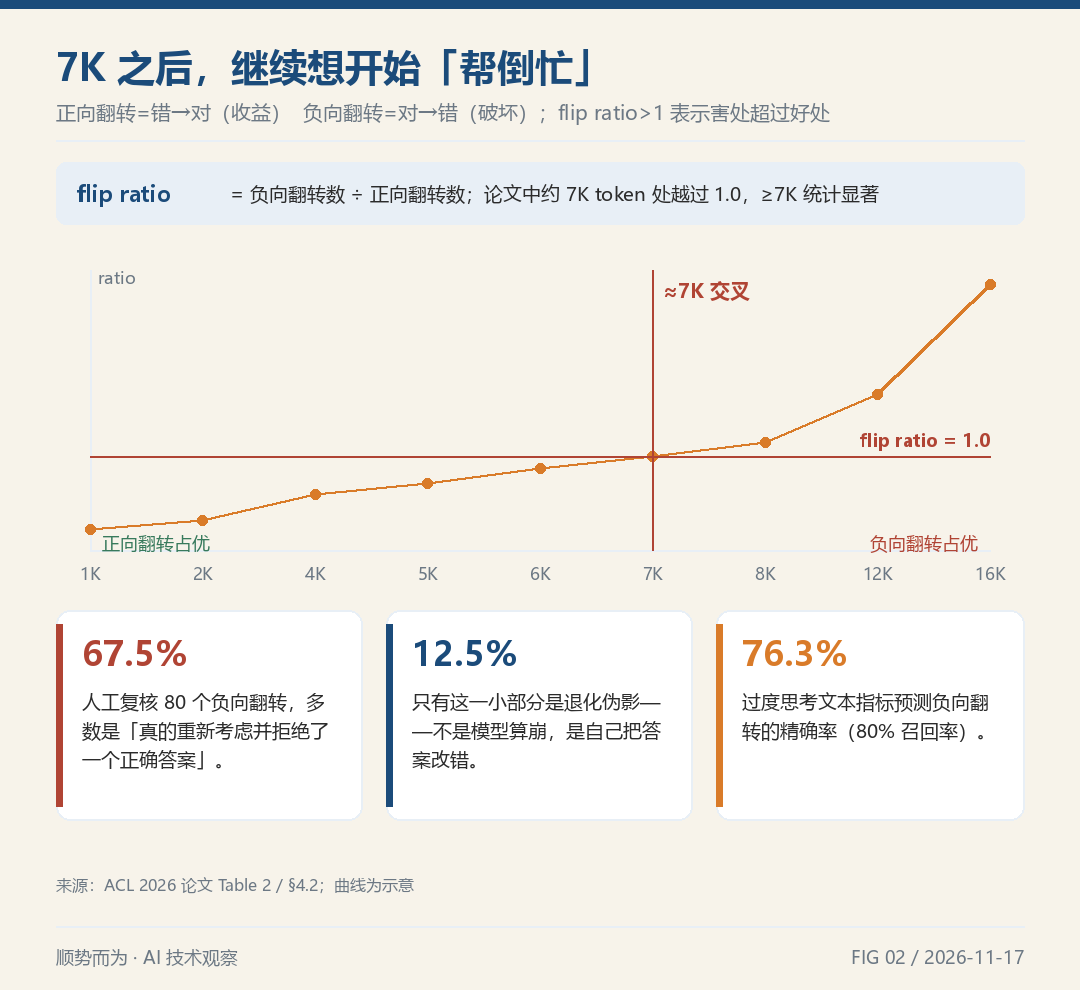
机制图:正向翻转与负向翻转随预算变化,7K 处交叉
67.5% 值得停一下:多数「想太久把题做错」,不是模型算崩了,而是它像人考试检查时一样,把第一遍做对的结果推翻了。开头那个场景不是段子,是被计数、被人工复核过的行为。
于是问题性质变了。我们原以为思考预算是个「成本旋钮」——多给算力、多花钱、换更稳的答案。现在它同时是个风险旋钮:预算过界,系统开始主动撤销已拿到的正确结果。浪费钱能靠砍预算止血,但撤销正确答案不在账单上留痕,只在准确率上留一个说不清来源的小坑,得单独把「答案被改掉」当指标观测才知道发生过。
03 拐点会跟着难度跑,所以统一预算一定是错的
一个自然的想法是:给所有请求设个「最优预算」不就行了?比如统一卡在 7K。
论文里最有工程价值的一条发现,恰恰否定了它:拐点不是一个数,它跟着题目难度移动。
数据卡片|拐点随难度分层移动(ACL 2026 论文,MATH-500 按 Level 1–5 分层)易题(Level 1–2)约 1.5K token 就见顶,约 2K 即跨过过度思考阈值 难题(Level 5)能一路受益到约 8K,约 8K 才跨阈值 换句话说:同一个 4K 预算,对易题已经过量,对难题却可能还不够
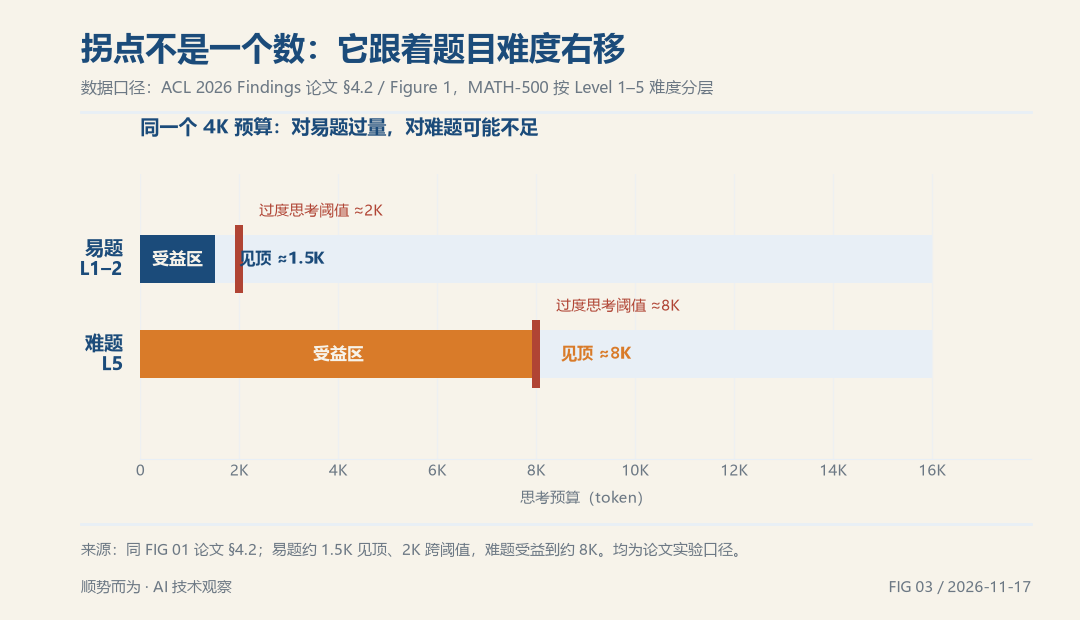
数据图:易题 1.5K 见顶、难题 8K 见顶,阈值随难度右移
这解释了「全局 effort 拉满」为什么同时犯两个错:对简单请求付了远超所需的成本、还把答案推进负向翻转区间;对难题,统一上限又可能过早截断必要推理。
另一方向证据来自 arXiv:2505.17813《Don't Overthink it》(Meta FAIR 与希伯来大学,预印本,2026 年 2 月更新版):同一问题内部较短的推理链显著更可能答对,最高比最长链准 34.5%;据此的 short-m@k 只取最先完成的 m 条链投票,低算力下最多省 40% 思考 token、墙钟最多省 33%。注意这是「同一题内短链 vs 长链」的特定口径,不是「短链整体准 34.5%」——中文圈不少转述读岔了。
统一预算的错,不在给多了或给少了,在于它假设所有题需要同样多的思考。 而证据说,需要多少是逐题、甚至逐步不同的。
04 一半以上的思考,发生在答案已经定了之后
前面讲「想过头会出错」,这一节讲更让人心疼的部分:很多算力,花在答案早就不再变化之后。
先明确口径:下面两组数字来自一篇 2026 年 11 月技术梳理文章对多篇论文的二次摘要,我未回到各篇 arXiv 原文逐项核验,只作定性佐证,不作确定性结论。
- ThinkBrake 的 oracle stopping 实验:每句末尾事后挑最佳停止点,思考 token 能砍约 72%,平均准确率反升约 8%。但 oracle 是「事后知道最优解」的上界,不是可部署收益——该文明确说实际方法最多省 30%。
- Concise-9B 强制 Qwen3.5-9B 每 2048 token 输出一次答案,难题集上 54%–64% 的思考 token 出现在「此后每次强制答案都与最终答案一致」之后。
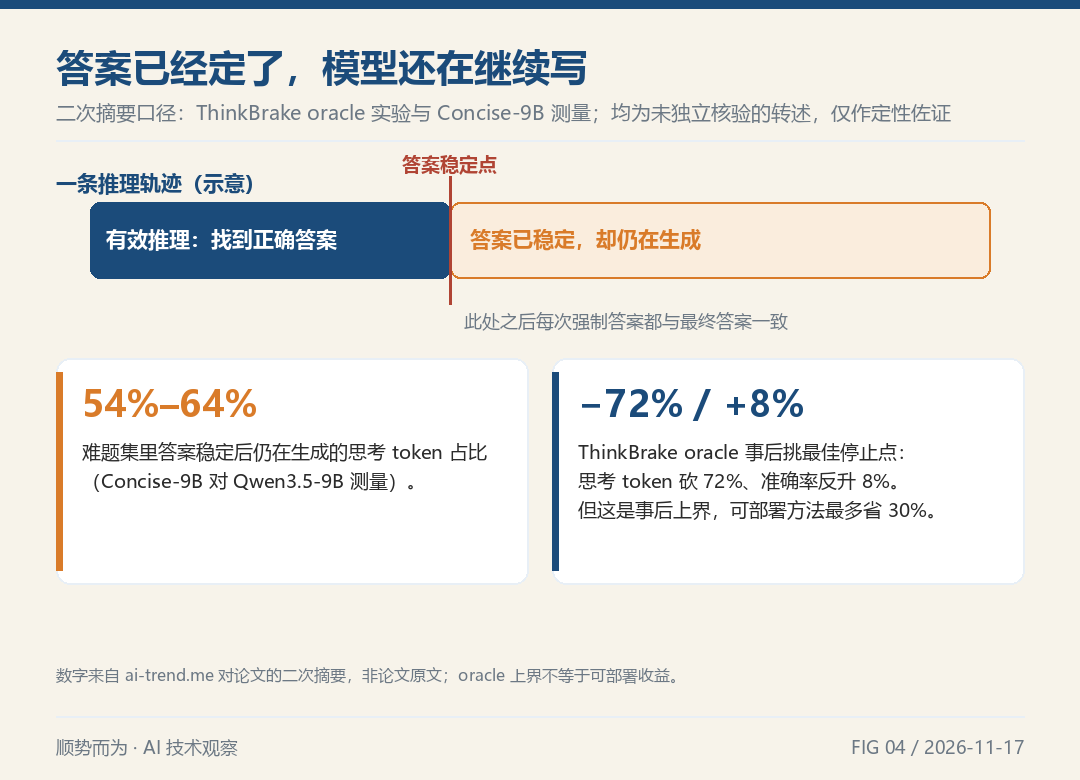
概念图:答案稳定点之后仍在生成的思考 token 占比
两组数字指向同一件事:模型常常已经想完了,却还在继续写。 这正好解释第 02 节那 67.5% 的负向翻转——答案稳定后多出来的推理没有新信息,只有自我怀疑和构造伪反例的机会。
但别急着写「连续三次答案相同就停」。同一份梳理有反证:这种简单规则套在原模型上会让准确率掉 2.4–9.2 个百分点,因为「答案何时真正稳定,只有事后才知道」——事中分不清「已收敛」和「暂时卡在错答案上」。
这个领域最诚实的一句共识是:目标不是更短,是 as much as needed——该想多少想多少。 不是把刹车踩死,是让刹车踩在对的位置。
05 反向陷阱:效率税与「欠思考」
既然「少想」有这么多好处,是不是把所有推理都压短就对了?不是。
2026 年 9 月的 arXiv:2609.19671(When2Think,预印本)给方向相反的坑起了个很准的名字:效率税(efficiency tax)。统一长度惩罚或二元「想 / 不想」路由,让简单题变便宜的同时把难题准确率一起拉下来——省下的算力,是从难题那里收的税。
它把「是否推理」和「推理多深」一起交给实例级难度感知(IDAC):训练前用参考策略对每道题多次采样,估计经验正确率(难度代理)与平均轨迹长度(专属预算),再放进奖励里。结果:
数据卡片|难度自适应的收益(arXiv:2609.19671 论文自报,Pass@3 协议)AIME24:Pass@3 从 46.0% → 56.0%(+10.0 个百分点),平均 token 从 14195 → 10236(−27.9%) GSM-Plus 对抗样本(故意用表述扰动简单数学题):反而多花 462 token(590 → 1052),换来 Pass@3 +6.3 点 口径:预印本、作者自报、骨干为 R1-distill-1.5B、依赖可验证奖励;作者明确说明不能直接外推到代码 Agent 或开放工具调用
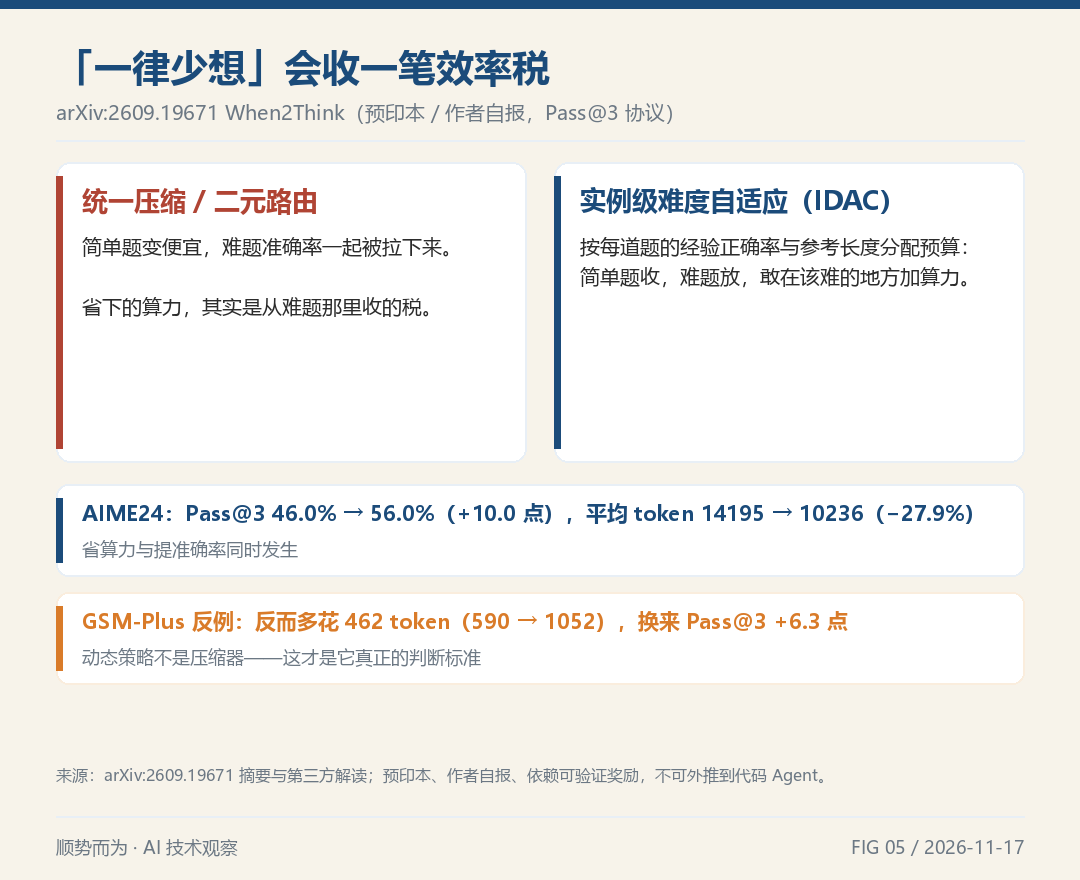
机制图:效率税——统一压缩伤难题,动态分配敢在该难的地方加算力
GSM-Plus 那一行最该抄走:动态策略不是压缩器,简单题省下的预算,要敢在「看着简单其实被改过」的题上重新花出去。只宣传「AIME 省 27.9%」,恰恰漏掉了真正的判断标准。
另一侧警告来自 ReBalance 一类工作:抑制反思短语、强行缩短,可能诱发 underthinking(欠思考)——明明有能力探索却过早收敛。过度思考和欠思考是一对反向失效,统一的长度旋钮没法同时修好两个方向。
所以「as much as needed」不是和稀泥,它是这五节证据的交集:停止时机和预算分配,都得跟着难度与错误代价走。
06 账单是乘数,不是加法
口径先摆正:以下数字出自第三方媒体 observai 对一份 2026 年生产环境基准与各厂商文档的二次整理,我未独立核验原始基准,故集中列出并统一加注,不进入确定性结论。那份基准是 100 条提示词的 SQL 生成任务、四步工具轨迹、以 95% 通过率为门槛,五档排下来:
配置 | 通过率 | p50 延迟 | 每解决一条约 |
|---|---|---|---|
GPT-4.1(不推理) | 87% | 4.2 秒 | 0.008 美元 |
Gemini 2.5 Flash Thinking(动态) | 94% | 8.3 秒 | 0.006 美元 |
o4-mini(中等努力) | 96% | 11.4 秒 | 0.028 美元 |
Claude Opus 5(8K 预算) | 97% | 22.9 秒 | 0.14 美元 |
o3(高努力) | 97% | 41.7 秒 | 0.31 美元 |
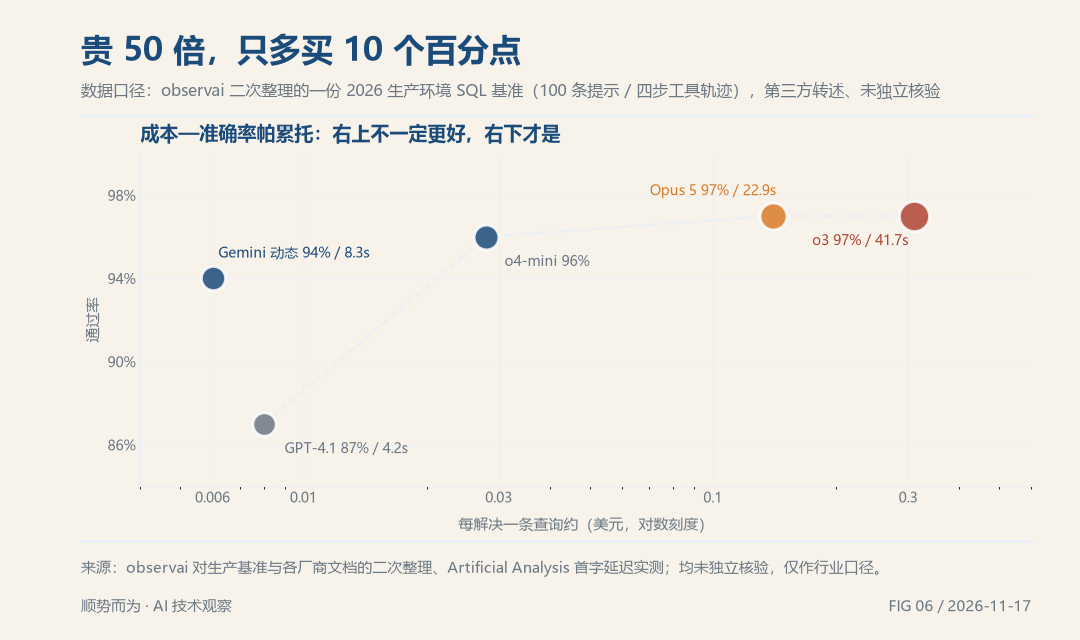
数据图:五档配置的成本—通过率帕累托,越往上越贵但收益趋平
两个对比最值得看:o3 比 GPT-4.1 贵约 50 倍,只换 10 个百分点;而 Gemini 2.5 Flash Thinking 比 GPT-4.1 更便宜,却多拿 7 个百分点。同一份整理还引了 Artificial Analysis 实测:同一套 Gemini 2.5 Flash 打开推理,首字延迟从 0.43 秒变成 14.94 秒,约 35 倍。
思考 token 按输出 token 计费,而输出是价格表上更贵的一侧;一条推理里思考 token 又常是最终答案的几倍到几十倍。所以推理档位对成本是乘数不是加法——中档 20–50 倍、高档 100 倍以上,延迟同步放大。
还有个容易忽略的结论:这份整理提到 Sonnet 5 高努力档对照实验(30 道 AIME 2026 题、每题 5 次调用),每个正确答案成本从 0.07662 涨到 0.08665 美元(约 +13%),准确率提升 0.0133,统计上不显著;研究者也说最多 4.67 个百分点的提升不能完全排除——这正是「口径」该有的样子。
一句可抄进评审意见的话:任何「推理值不值」的说法,都要说明模型、任务、档位和重复次数。 单次基准的数字,和单次调用一样不可靠。
07 把预算变成可裁决的工程旋钮
把前六节收拢成一套动作。核心不是「调低 effort」,而是把思考预算从模型的内部玄学,抬成系统里一条能被规则裁决、被日志记账、被事后复盘的配置。
- 先跑「不开推理」基线。普通模型已过准确率门槛就打住——推理只会更贵更慢。这能砍掉一多半无谓的高档调用。
- 只变 effort / budget 扫档位。固定模型、任务集、评分标准,画成本对准确率曲线,停在膝点(再多加 2000 个思考 token 只买到 0.5% 的地方),而非最大值。
- 把思考 token 当独立使用指标,与输入、输出并列记录。质量回归、账单异常时它是第一个该看的地方。
- 按错误代价分档,而非只按难度。一次错误的代价远大于一万次正确调用成本时才值得拉满;事实检索、格式转换、简单分类、摘要的瓶颈在上下文质量,开高档只是把 2 秒变 40 秒、成本乘几十倍。
- 有廉价验证器时优先并行。测试能跑、JSON 能解析、数值能核对的任务,用并行采样加验证(best-of-N、跑单测)比拉长单链划算:并行增加成本但不增加墙钟延迟;顺序扩展才适合后步依赖前步的推理。
- 锁死缓存会话里的配置。Anthropic 上请求间改
budget_tokens或effort会让提示词缓存断点失效(解析后的值被渲染进提示词),一个缓存会话内保持稳定,否则省下的缓存钱会悄悄流走。 - 把「答案被改掉」纳入观测。用翻转率、置信度波动做早停信号时,先验证难题上没丢正确答案,再看 token 节省——这正是第 05 节效率税的教训。
# 示意:按错误代价与验证器可用性裁决档位(伪代码,非某厂商真实 API)
def choose_effort(task):
    if not exceeds_baseline(task):        # 先跑不开推理的基线
        return "none"
    if has_cheap_verifier(task):          # 测试/JSON/数值可核对
        return "parallel_n"               # 并行采样 + 验证,别拉长单链
    if task.error_cost == "high":         # 错一次代价极大
        return "high"                     # 该花的算力花在刀刃上
    return "low"                          # 默认从低档起步,不够再升

# 关键:effort 一旦选定,缓存会话内不要逐请求改动,否则打断提示词缓存这段把「多想一会儿」翻译成一个确定性的、可被代码审查的分支。最值得抄走的细节是:裁决权在路由代码,不在模型自己。让模型自己判断「我想完了没」,恰恰是过度思考最不可靠的那一环。
08 落到业务:制造业售后智能体怎么分档
放进一个具体场景:一家做庭院门自动开门机出口的企业,售后每天处理几十到上百封英文邮件,涉及安装调试、故障分析、订单库存、情感安抚。上智能体时最常见的错误,是给所有邮件配同一个高努力档,理由是「技术邮件不能出错」。
按第 07 节切开任务:
- 订单状态、保修期、说明书条款查询:事实检索,低 effort 或直接 RAG + 工具调用;有结构化数据库可核对,属「有廉价验证器」一类。
- 复杂故障诊断(多症状、跨型号、需查历史工单):后步依赖前步,是少数值得高 effort 或并行采样的任务;但要有确定性证据闸门,不能让长推理改掉已查证的结论。
- 情感安抚与常规回复:话术库 + 模板,几乎不需要推理预算;开高档只是把成本乘上几十倍换一堆自我检查。
再叠一条硬约束:硬性人工闸门放在发送侧,而不是模型侧。 模型可以提议回复、预算、诊断路径,但对客邮件的最终发出由确定规则与人确认裁决。这与「模型提议、确定性代码裁决」是同一条纪律,只是被裁决的对象从「动作权限」换成了「算力预算」。
高频低单价场景下,单次调用 Token 成本几乎可忽略,失控只发生在智能体循环里。要盯的不是「每封邮件多少钱」,而是「哪些任务被误判成需要深度思考」、循环有没有因反复自我验证空转——把思考 token 单独记账就能看见。
09 边界与自我反驳
得把话说回去几句,否则就成了另一种一刀切。
这不是「AI 不该思考」的证据。 多步证明、复杂调试、多约束规划,长推理确实给了模型复查回头的机会;ACL 论文也是 12K 才见顶,500 到 12K 那段收益非常真实。结论是「别过度」,不是「别思考」。
论文口径要守住。 核心数字来自数学/科学基准、budget forcing 人为约束、开放权重 32B 模型;flip ratio、Pass@3、E³ 是论文自定义评价口径,不能等同工业部署的费用、时延或能耗。arXiv:2505.17813 与 arXiv:2609.19671 均为预印本,非同行评审。
一批数字是二次转述,未独立核验。 第 04 节的 72%/8%、54–64%,第 06 节成本表与 35 倍延迟,出自技术梳理与第三方媒体整理;Anthropic 官方《Advanced tool use》里 55K/134K token 工具膨胀、Opus 4 从 49% 到 74%,是厂商内部测试、未给样本量与评测集构成。只作定性佐证,文中已逐处标注。
厂商的 effort 档是黑盒。 论文里「token 预算」是可控可数的实验变量;产品里 reasoning.effort 是离散档位,内部怎么分配、是否中途改变,调用方看不到。把论文最优预算抄成 API 参数,是两类东西错位。
「换更强模型就好了」和「一律少想」都过于简单。 前者假设能力能替代预算管理,后者把效率税转嫁给难题。推理系统的下一轮竞争,除了模型能力,还在推理策略、预算调度与评测方法上——这条趋势仍需更多跨任务、独立可复现的证据。
10 明天上班做什么
两份可直接执行的清单。
一线开发者:找出调用链里写死 effort="high" 或默认最高预算的地方,逐个问「这个任务的错误代价配得上吗」;给服务加一个「不开推理」基线对照;把思考 token 单独记成指标,先观测一周再调。
团队或系统负责人:按「错误代价 × 有无廉价验证器」画四象限,把档位策略写成配置而非散落代码里;规定缓存会话内 effort 配置锁定;要求任何「推理提效」结论同时报告准确率、token、真实时延三项,并注明模型、任务、档位、重复次数;上线前跑影子模式双跑,重点查难题有没有因早停丢掉正确答案。
会想,是能力;会停,才是工程。
过去两年,我们把模型「能想多久」当进步标志。2026 年这批研究换了方向:它知道什么时候该停吗? 答案目前不在模型里,在我们给它写的那条规则里。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号