别再每次都重新解释:用技能(Skill)把重复对话固化下来
原创
别再每次都重新解释:用技能(Skill)把重复对话固化下来
原创
用户12877835
发布于 2026-11-18 09:18:21
发布于 2026-11-18 09:18:21
如果你每天都要对 AI 重复一遍"日报要三列、不写总结段、每条不超过三十字",这不是它记性差,而是你把本该固化下来的东西留在了对话里。技能(Skill)就是给这类内容一个固定住的地方:一个 Markdown 文件写清"什么时候用、按什么步骤做",放进指定目录,以后同类请求自动命中,解释成本归零。
本文的每一步都在真实终端里操作完成,配图均为实际运行截图,可以逐步照做。
一、先判断:哪些东西值得做成技能
不是所有对话都值得沉淀,判断标准可以很简单:同一件事你解释了两遍以上,就做。常见的落点有三类:
- 固定输出格式——日报、周报、对比表,每次都要重申列名和字数限制;
- 固定多步流程——从取数、校验到汇总,步骤固定但容易漏步;
- 固定命令——每次都让 AI 现写同一段代码,输出还每次不完全一样。
三类对应的沉淀方式不同:第一类写进 SKILL.md 的"输出格式"小节就够;第二类写成编号步骤清单;第三类要把代码放进技能的 scripts/ 目录,让脚本直接跑,而不是每次重新生成。
二、技能长什么样:一个 SKILL.md 就够
先看现状。用户级技能目录 ~/.workbuddy/skills/ 目前是空的,只有两个迁移标记文件;内置技能放在插件缓存目录里。自己写的技能放前者,目录按技能名建。
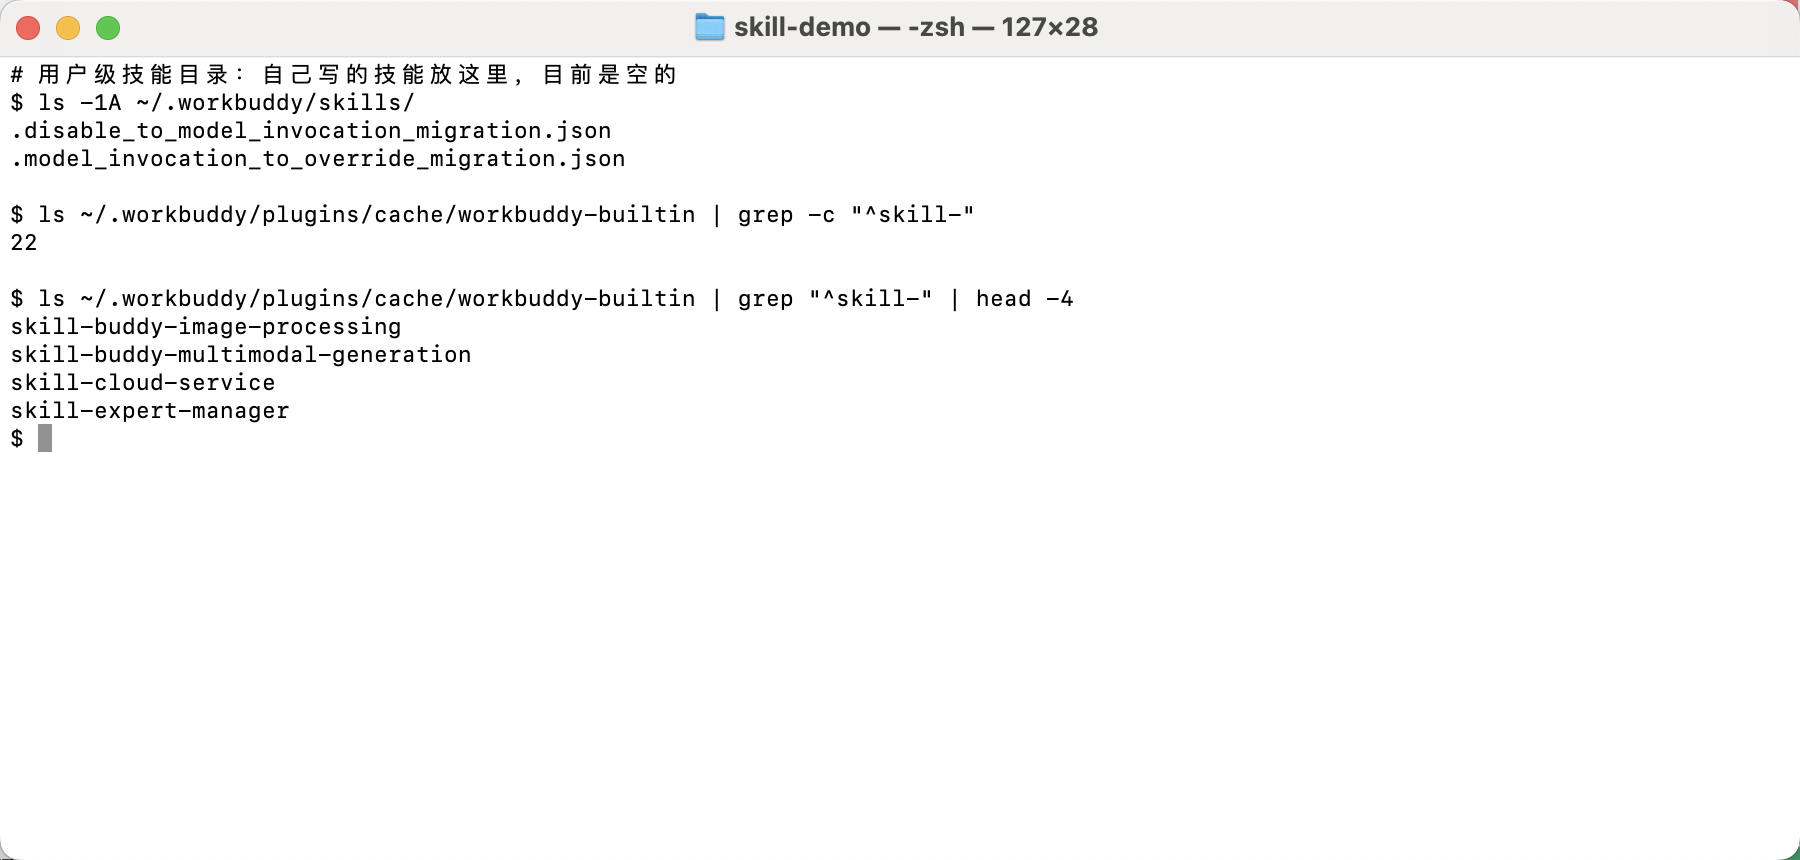
一个技能最少只需要一个 SKILL.md,可选再挂资源目录,结构如下:
skill-name/
├── SKILL.md          # 必需:frontmatter + 正文
├── scripts/          # 可选:确定性脚本
├── references/       # 可选:按需加载的参考文档
└── assets/           # 可选:输出时用的模板资源
frontmatter 里 name 和 description 是必填项;如果希望以后还能继续管理和修改这个技能,再补一行 agent_created: true。
实际写一个"每日简报"技能。两条命令:一条建目录,一条用 tee 把内容写进文件——tee 的好处是写入的同时内容直接回显在终端,当场就能核对:
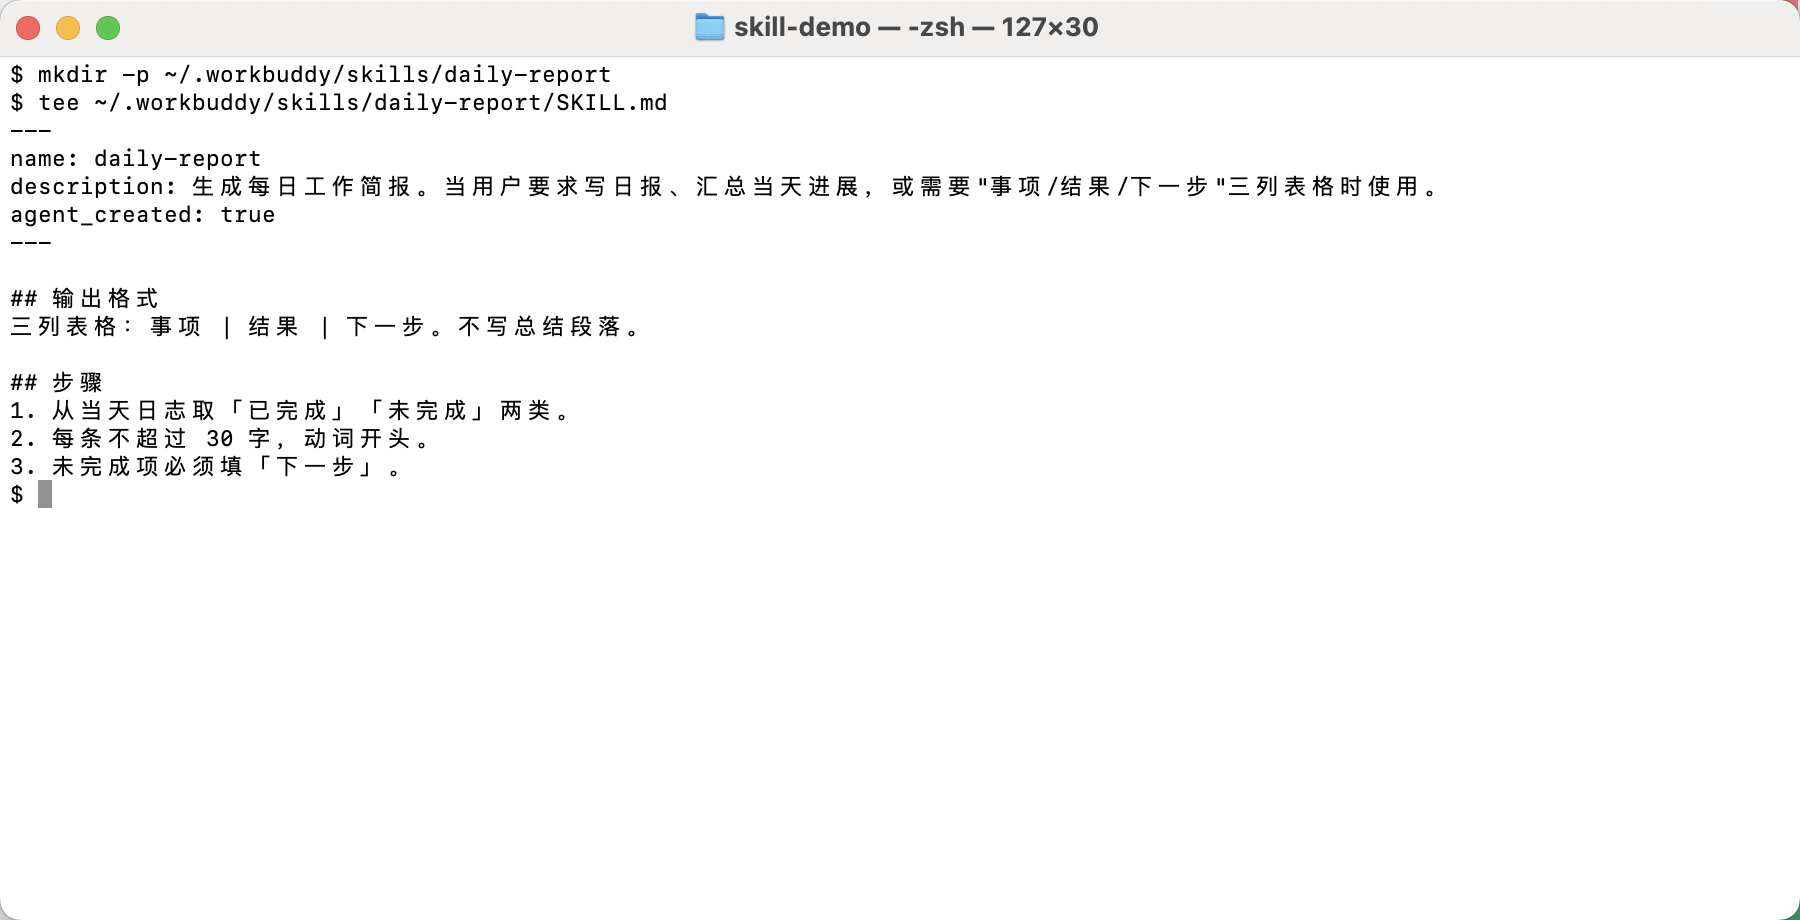
mkdir -p ~/.workbuddy/skills/daily-report
tee ~/.workbuddy/skills/daily-report/SKILL.md
frontmatter 三行说完身份,正文只留两小节:输出格式、步骤。注意正文的克制——技能文件是"操作手册"不是"说明书",每多写一句废话,命中后就多占一分上下文。
三、三层加载:为什么 description 最值得花心思
技能的真实加载机制是三层:
- name + description 常驻上下文,每轮对话都在,体积约百词以内;
- SKILL.md 正文只在命中时才加载,官方建议控制在五千词以内;
- scripts / references 按需取用,脚本甚至可以不读进上下文直接执行。
这意味着 description 是唯一永远在场的部分,命中与否由它决定。写"我是做什么的"不如写"什么时候该用我"——内置技能全部用第三人称触发式写法,中文同理用"当用户要求……时使用"。
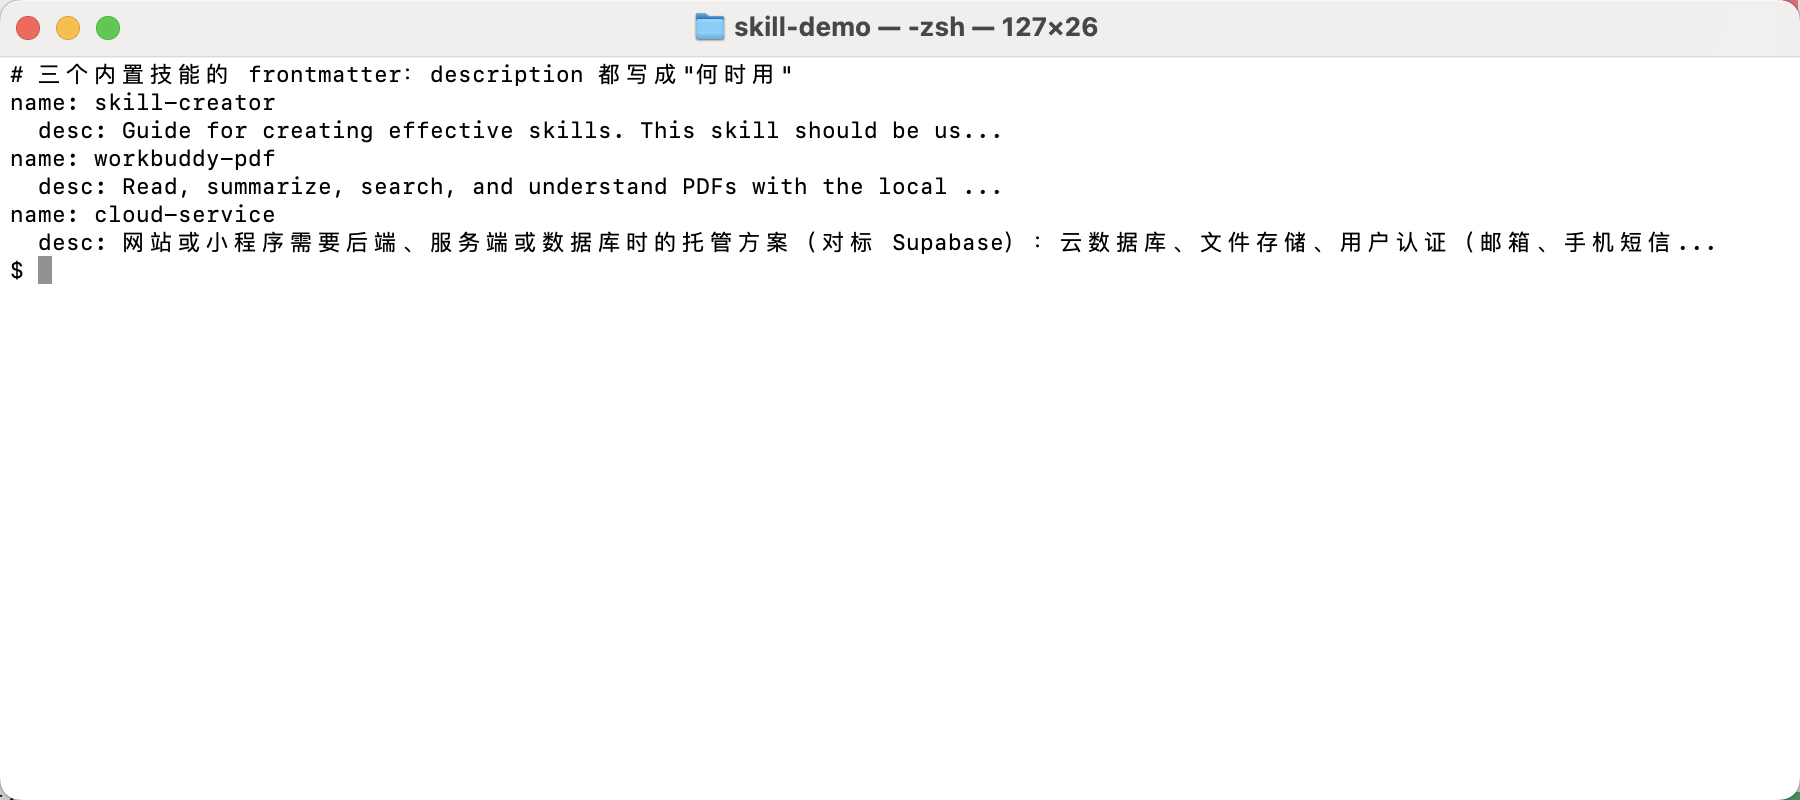
抽取三个内置技能的 frontmatter 对比,共同点很明显:先说能做什么,再说触发条件,而且条件具体到"PDF 提取""搭建后端"这类可判定的动作,不是模糊的"处理文档":
反面写法长这样:"一个帮我处理各种文档的通用助手"。"各种""通用"等于没有触发条件,真正需要它的时候反而轮不到它出场。
四、写完必自检:一个十几行的脚本
平台硬性要求只有 name 和 description 两项,但实际使用中还有几条隐性规则值得自查:name 要和目录同名、全小写连字符;description 太短说不清触发场景,太长又会挤占常驻上下文;正文至少要有小节标题,否则命中之后没有可执行的步骤。
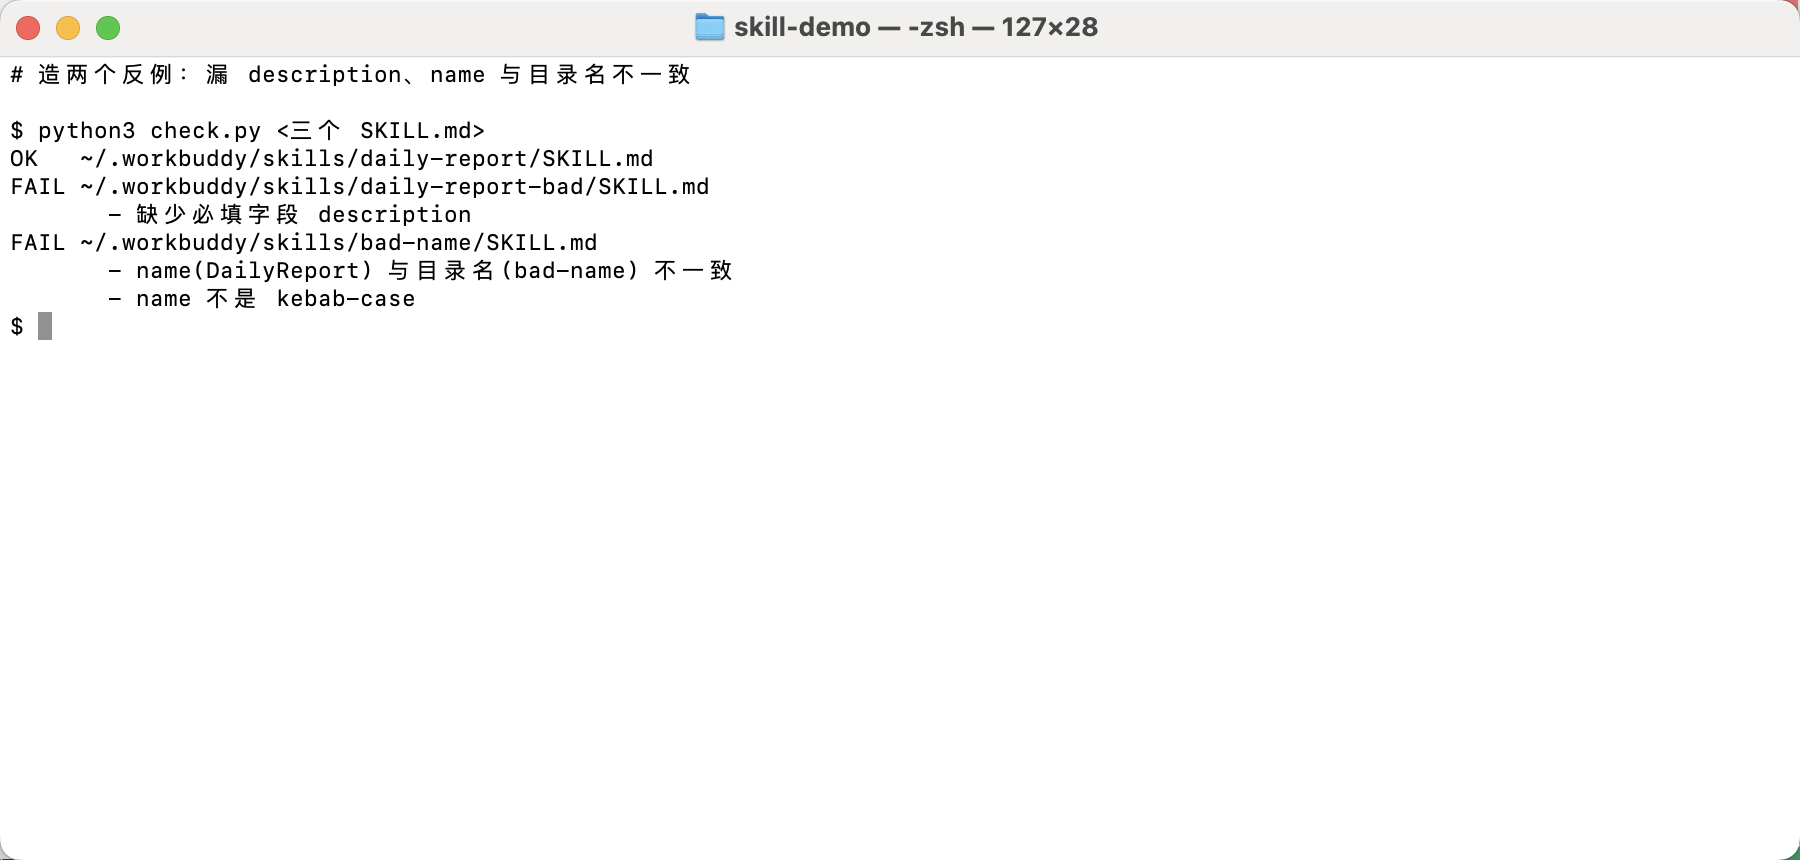
这些检查写成脚本,一次跑完。准备三个案例:写好的 daily-report、故意漏掉 description 的反例、name 写成大写驼峰的反例:
结果一目了然:正常案例 OK;漏 description 的报"缺少必填字段";name 与目录不一致的连报两条,"与目录名不一致"加"不是 kebab-case"。自检脚本 check.py 全文如下,可直接抄:
import sys, os, re


def load(path):
    t = open(path, encoding='utf-8').read()
    if not t.startswith('---'):
        return None, '缺少 frontmatter'
    end = t.find('\n---', 3)
    if end < 0:
        return None, 'frontmatter 没有闭合'
    meta = {}
    for line in t[3:end].strip().splitlines():
        if ':' in line:
            k, v = line.split(':', 1)
            meta[k.strip()] = v.strip().strip('"')
    return meta, None


def check(path):
    errs = []
    meta, e = load(path)
    if e:
        return [e]
    for k in ('name', 'description'):
        if not meta.get(k):
            errs.append('缺少必填字段 %s' % k)
    name = meta.get('name', '')
    folder = os.path.basename(os.path.dirname(path))
    if name and name != folder:
        errs.append('name(%s) 与目录名(%s) 不一致' % (name, folder))
    if name and not re.fullmatch(r'[a-z0-9]+(-[a-z0-9]+)*', name):
        errs.append('name 不是 kebab-case')
    desc = meta.get('description', '')
    if desc and len(desc) < 20:
        errs.append('description 只有 %d 字,说不清触发场景' % len(desc))
    if len(desc) > 500:
        errs.append('description 超长,会挤占常驻上下文')
    body = open(path, encoding='utf-8').read()
    if '\n## ' not in body:
        errs.append('正文没有小节标题')
    return errs


for p in sys.argv[1:]:
    errs = check(p)
    short = p.replace(os.path.expanduser('~'), '~')
    print(('OK   ' if not errs else 'FAIL ') + short)
    for e in errs:
print(' - ' + e)python3 check.py ~/.workbuddy/skills/*/SKILL.md一行命令扫全部技能,把自检挂进习惯里,比每次目视检查可靠。
五、第三类场景的答案:把命令做成脚本
前两类写完 SKILL.md 就结束了,第三类(固定命令)要多走一步:把代码放进技能的 scripts/ 目录。价值有两点——同样的输入永远得到同样的输出(确定性),以及脚本不必读进上下文,直接执行,省 token。
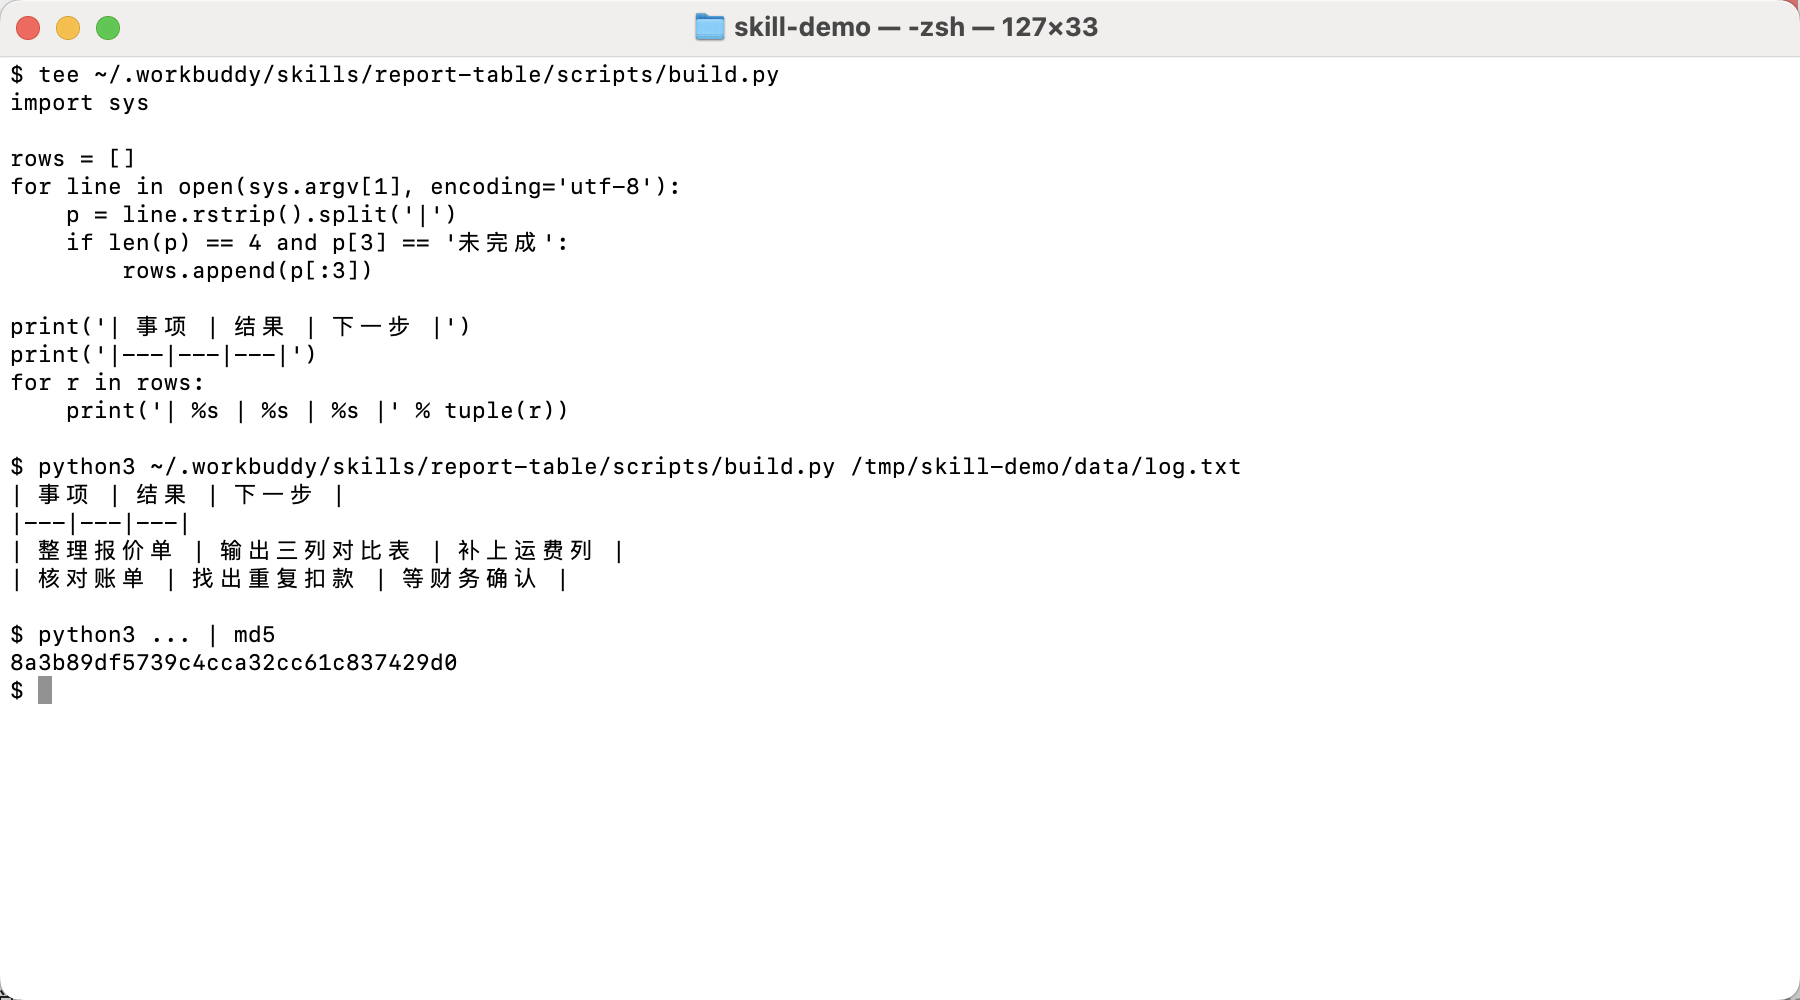
一个真实的例子:把工作日志里"未完成"的行筛出来、生成三列表格的 build.py,放进 report-table/scripts/ 之后直接命令行执行;再对同一输入跑第二次求 md5 散列,两次结果一致,说明输出完全可复现:
python3 ~/.workbuddy/skills/report-table/scripts/build.py 日志文件什么逻辑该进 scripts/,判断标准很简单:结果是查出来的,不是生成出来的,就做成脚本。计数、筛选、格式转换都算;需要理解和取舍的内容不适合,那部分留在正文里让模型处理。
六、验收清单与最后一个提醒
写完一个技能,对照这六条收尾:
- 同一件事确实解释过两遍以上,才值得做;
- description 用"当……时使用"句式,触发条件写到可判定的动作;
- name 全小写连字符,且与目录同名;
- 正文有小节标题、五千词以内,长资料挪去 references/;
- 加上
agent_created: true,方便后续维护; - 确定性逻辑放 scripts/,生成性内容留在正文。
最后一个提醒:技能列表在会话启动时载入,当前会话里新建的技能不会立即出现在可用列表中,写完当场调用是验证不了的。最稳妥的验收方式是重开一个会话,用一句自然的话去触发它——能命中,这个技能才算真正立住了。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号