#WorkBuddy# 3.6 万条链接去重只掉 3.1%:15 道归一化关口把 2,400 个资源一个不差认出来
原创
#WorkBuddy# 3.6 万条链接去重只掉 3.1%:15 道归一化关口把 2,400 个资源一个不差认出来
原创
用户12784192
发布于 2026-11-19 10:16:42
发布于 2026-11-19 10:16:42
#WorkBuddy# 3.6 万条链接去重只掉 3.1%:15 道归一化关口把 2,400 个资源一个不差认出来
把一批链接丢进 set() 去重,36,000 条变成 34,893 条——看起来"去掉了 1,107 条重复",实际上这里面藏着 2,400 个真实页面,绝大多数重复根本没被认出来。这是我在做一个链接表清洗脚本时踩到的第一个坑:去重率 3.07%,而真实重复率是 93.33%。
更麻烦的是第二层:随手补几行 lower() 和 unquote(),簇数确实降到了 29,752,看起来"效果不错",但同一批数据里有 260 个本来就不同的资源被焊死在了一起,形成 309 个误合并簇。去重去错了,比没去重危险得多——没去重只是浪费人工,去错了就是永久丢数据。
这篇文章把这件事拆开做实验:自建 36,000 条合成链接、2,400 个带真值编号的资源,三档方案同台对比,再逐条做消融,看哪一道关口真正值钱。
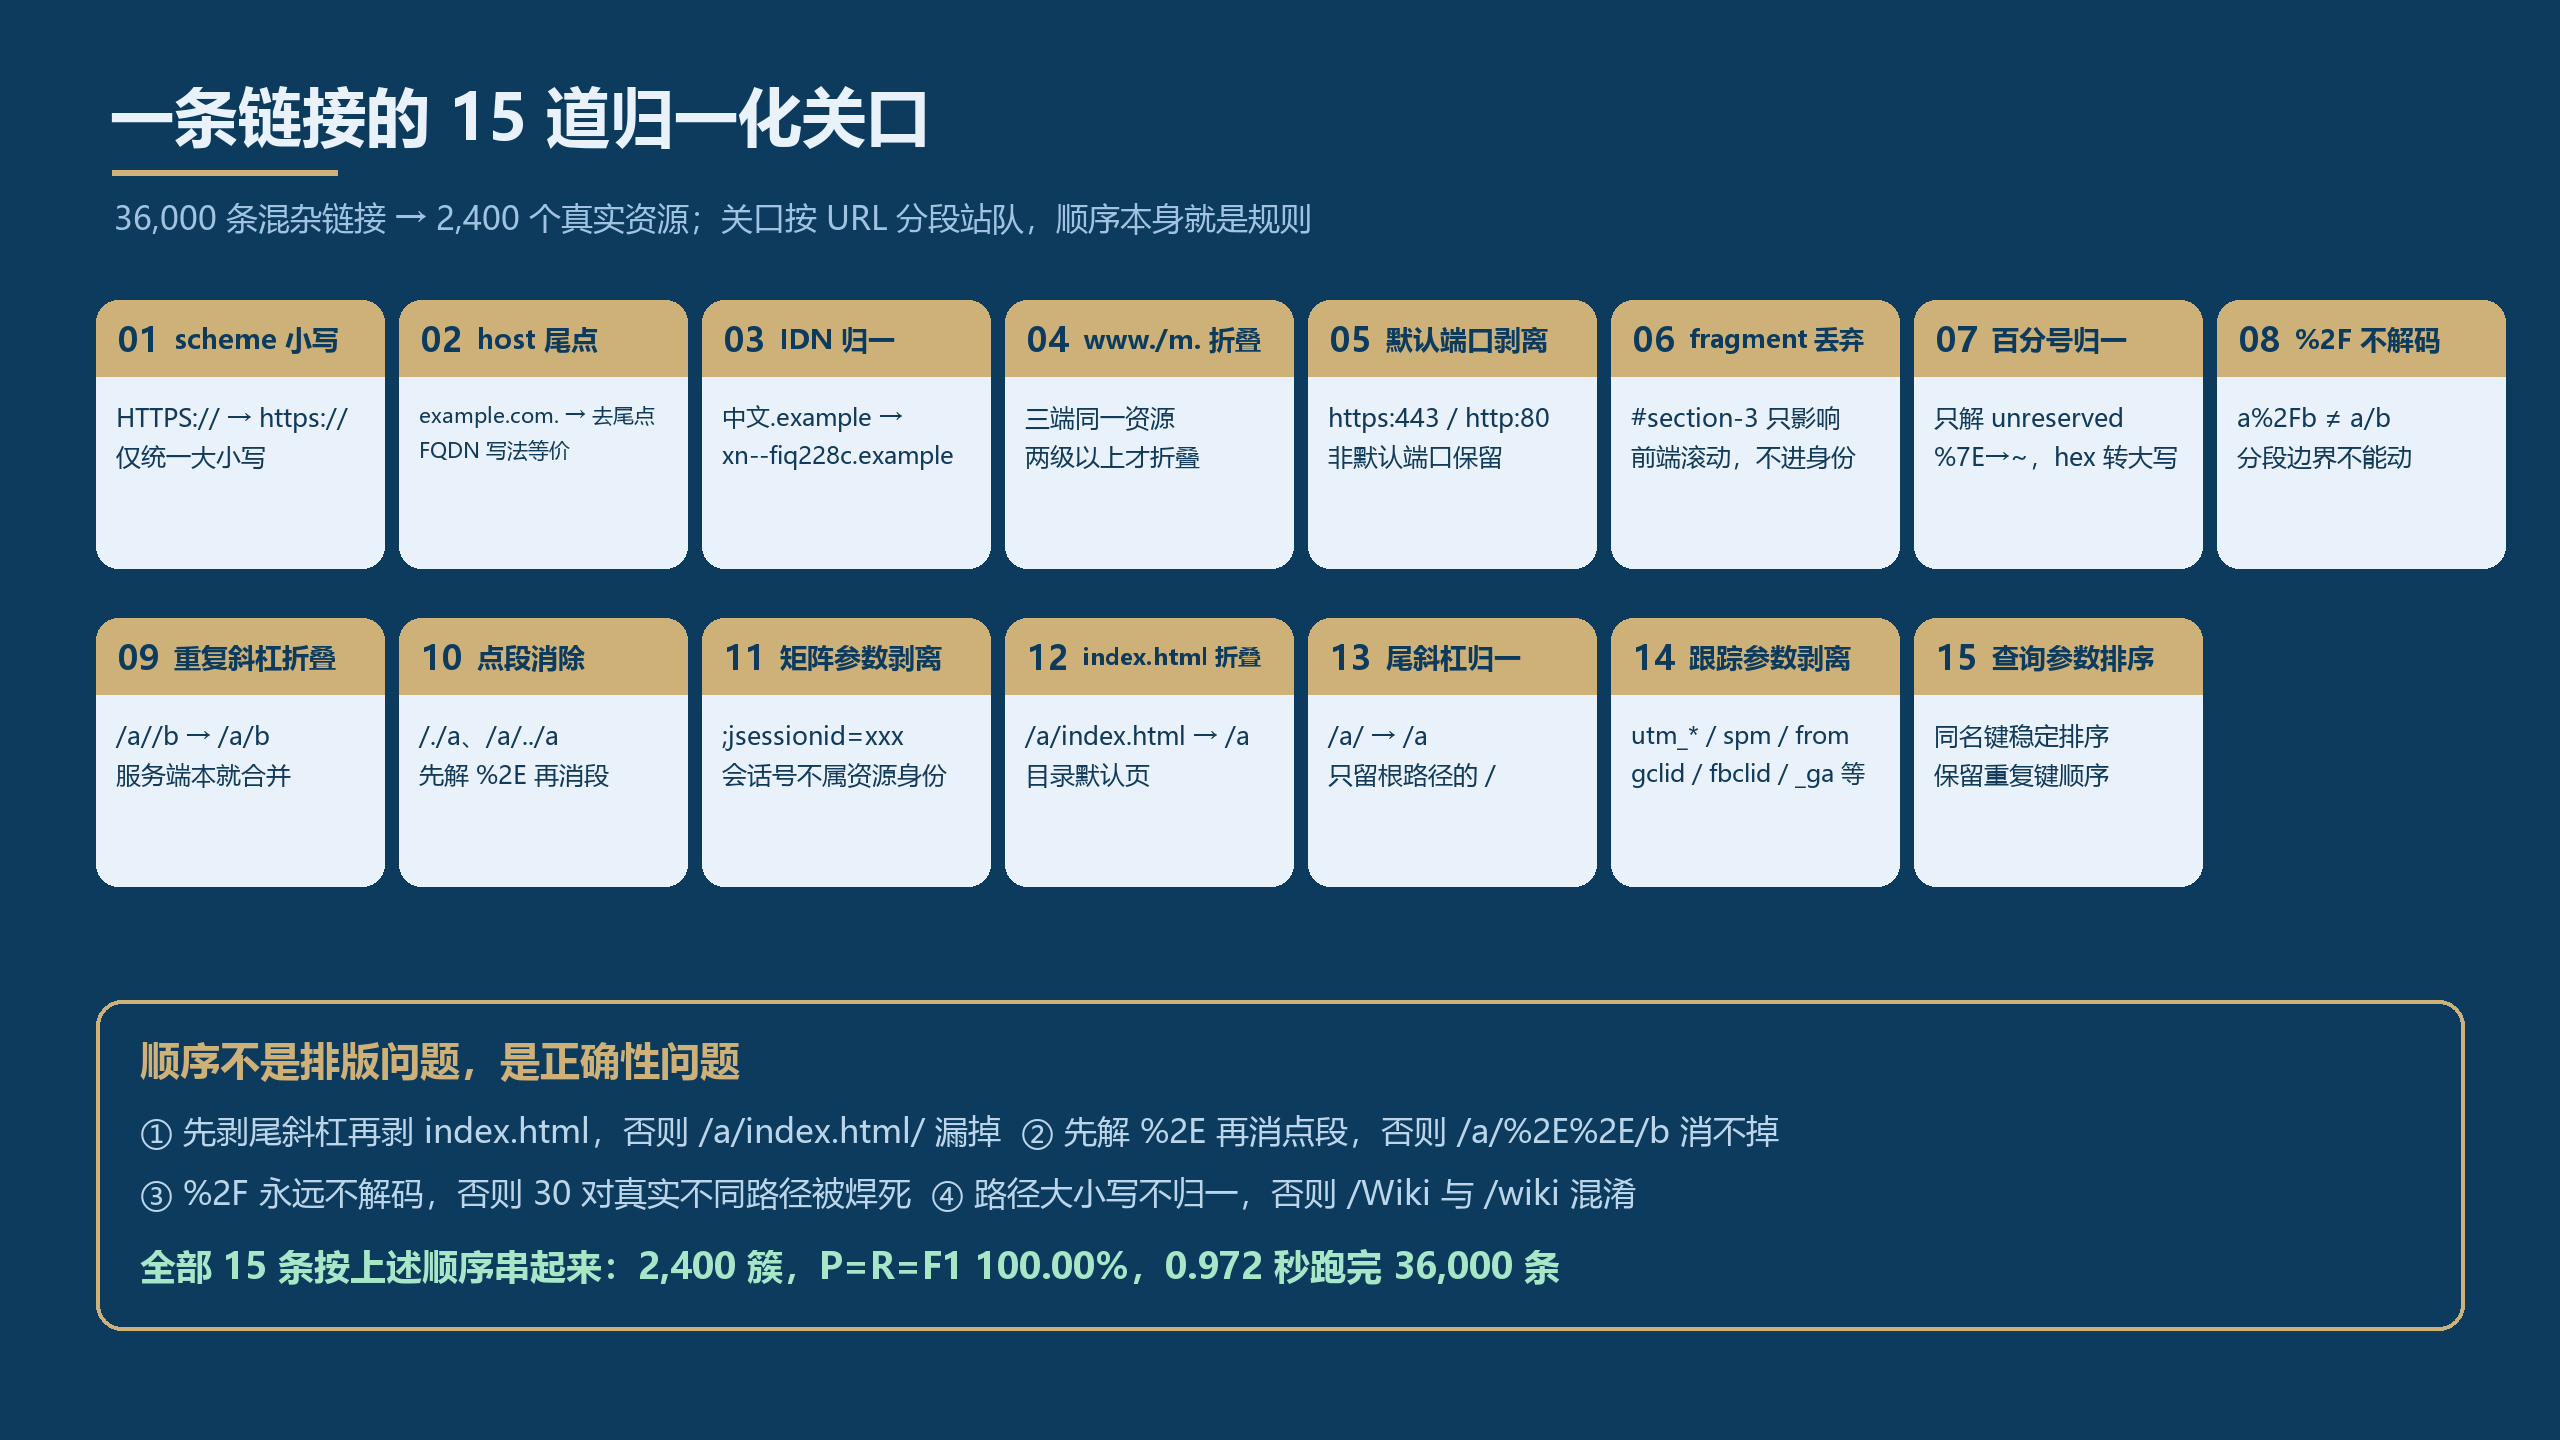
URL 归一化的 15 道关口与处理顺序
一、根因:URL 不是字符串,是"同一资源的多种写法"
一条资源的身份由五段决定,而每一段都有自己的合法变体写法。把它们混在一个字符串里比,必然对不上:
分段 | 常见变体 | 是否同一资源 |
|---|---|---|
scheme |
| 是(仅大小写) |
scheme |
| 不一定,本实验不做跨协议合并 |
host |
| 是 |
host |
| 是(IDN 两种写法) |
port |
| 是 |
path |
| 是 |
path |
| 否,分段边界不同 |
path |
| 否,很多站点大小写敏感 |
query |
| 是(集合语义) |
query |
| 是(跟踪参数不改变资源) |
fragment |
| 是(只影响前端滚动) |
所以正确做法不是"清洗字符串",而是按 RFC 3986 分段归一,每段用自己的规则,顺序还不能乱。
我最终定下 15 道关口,实测语料里各类脏写法的分布是这样的(36,000 条中):
脏写法 | 条数 | 脏写法 | 条数 |
|---|---|---|---|
跟踪参数(utm/spm/gclid/from 等) | 15,024 | 百分号编码变体 | 14,534 |
查询参数乱序 | 13,596 | host 大小写混杂 | 11,632 |
fragment 残留 | 8,367 | 默认端口显式写出 | 7,259 |
尾斜杠不一致 | 3,656 | host 尾部点 | 3,447 |
index.html 显式 | 3,119 | 矩阵参数 ;jsessionid | 3,021 |
重复斜杠 | 2,400 | IDN unicode 写法 | 297 |
二、三档方案的真实差距
同一批 36,000 条、2,400 个真值资源,跑三档:
档位 | 做法 | 簇数 | 精确率 | 召回 | F1 | 耗时 |
|---|---|---|---|---|---|---|
A 朴素 |
| 34,893 | 100.00% | 0.51% | 1.01% | 0.003s |
B 半治理 | 整体 | 29,752 | 87.53% | 3.81% | 7.31% | 0.302s |
C 治理式 | 15 道关口分段归一 | 2,400 | 100.00% | 100.00% | 100.00% | 0.972s |
三个数值得单独说:
- A 档的 34,893 看起来是"去重结果",实质等于没去重。召回 0.51% 意味着 250,725 对重复关系只认出 1,275 对,那 1,275 对还是因为语料里恰好有完全相同的字符串。
- B 档的簇数看起来很漂亮,代价是 1,369 对误合并。拆开看构成很干净:244 个簇来自"路径大小写被整体 lower",65 个簇来自"
%2F被 unquote 成/"。两类都是不可逆的信息损失。 - C 档 0.972 秒跑完 36,000 条,单条约 27 微秒。这个成本在几十万条的规模上完全可接受,没有理由为了省时间用 A 档。
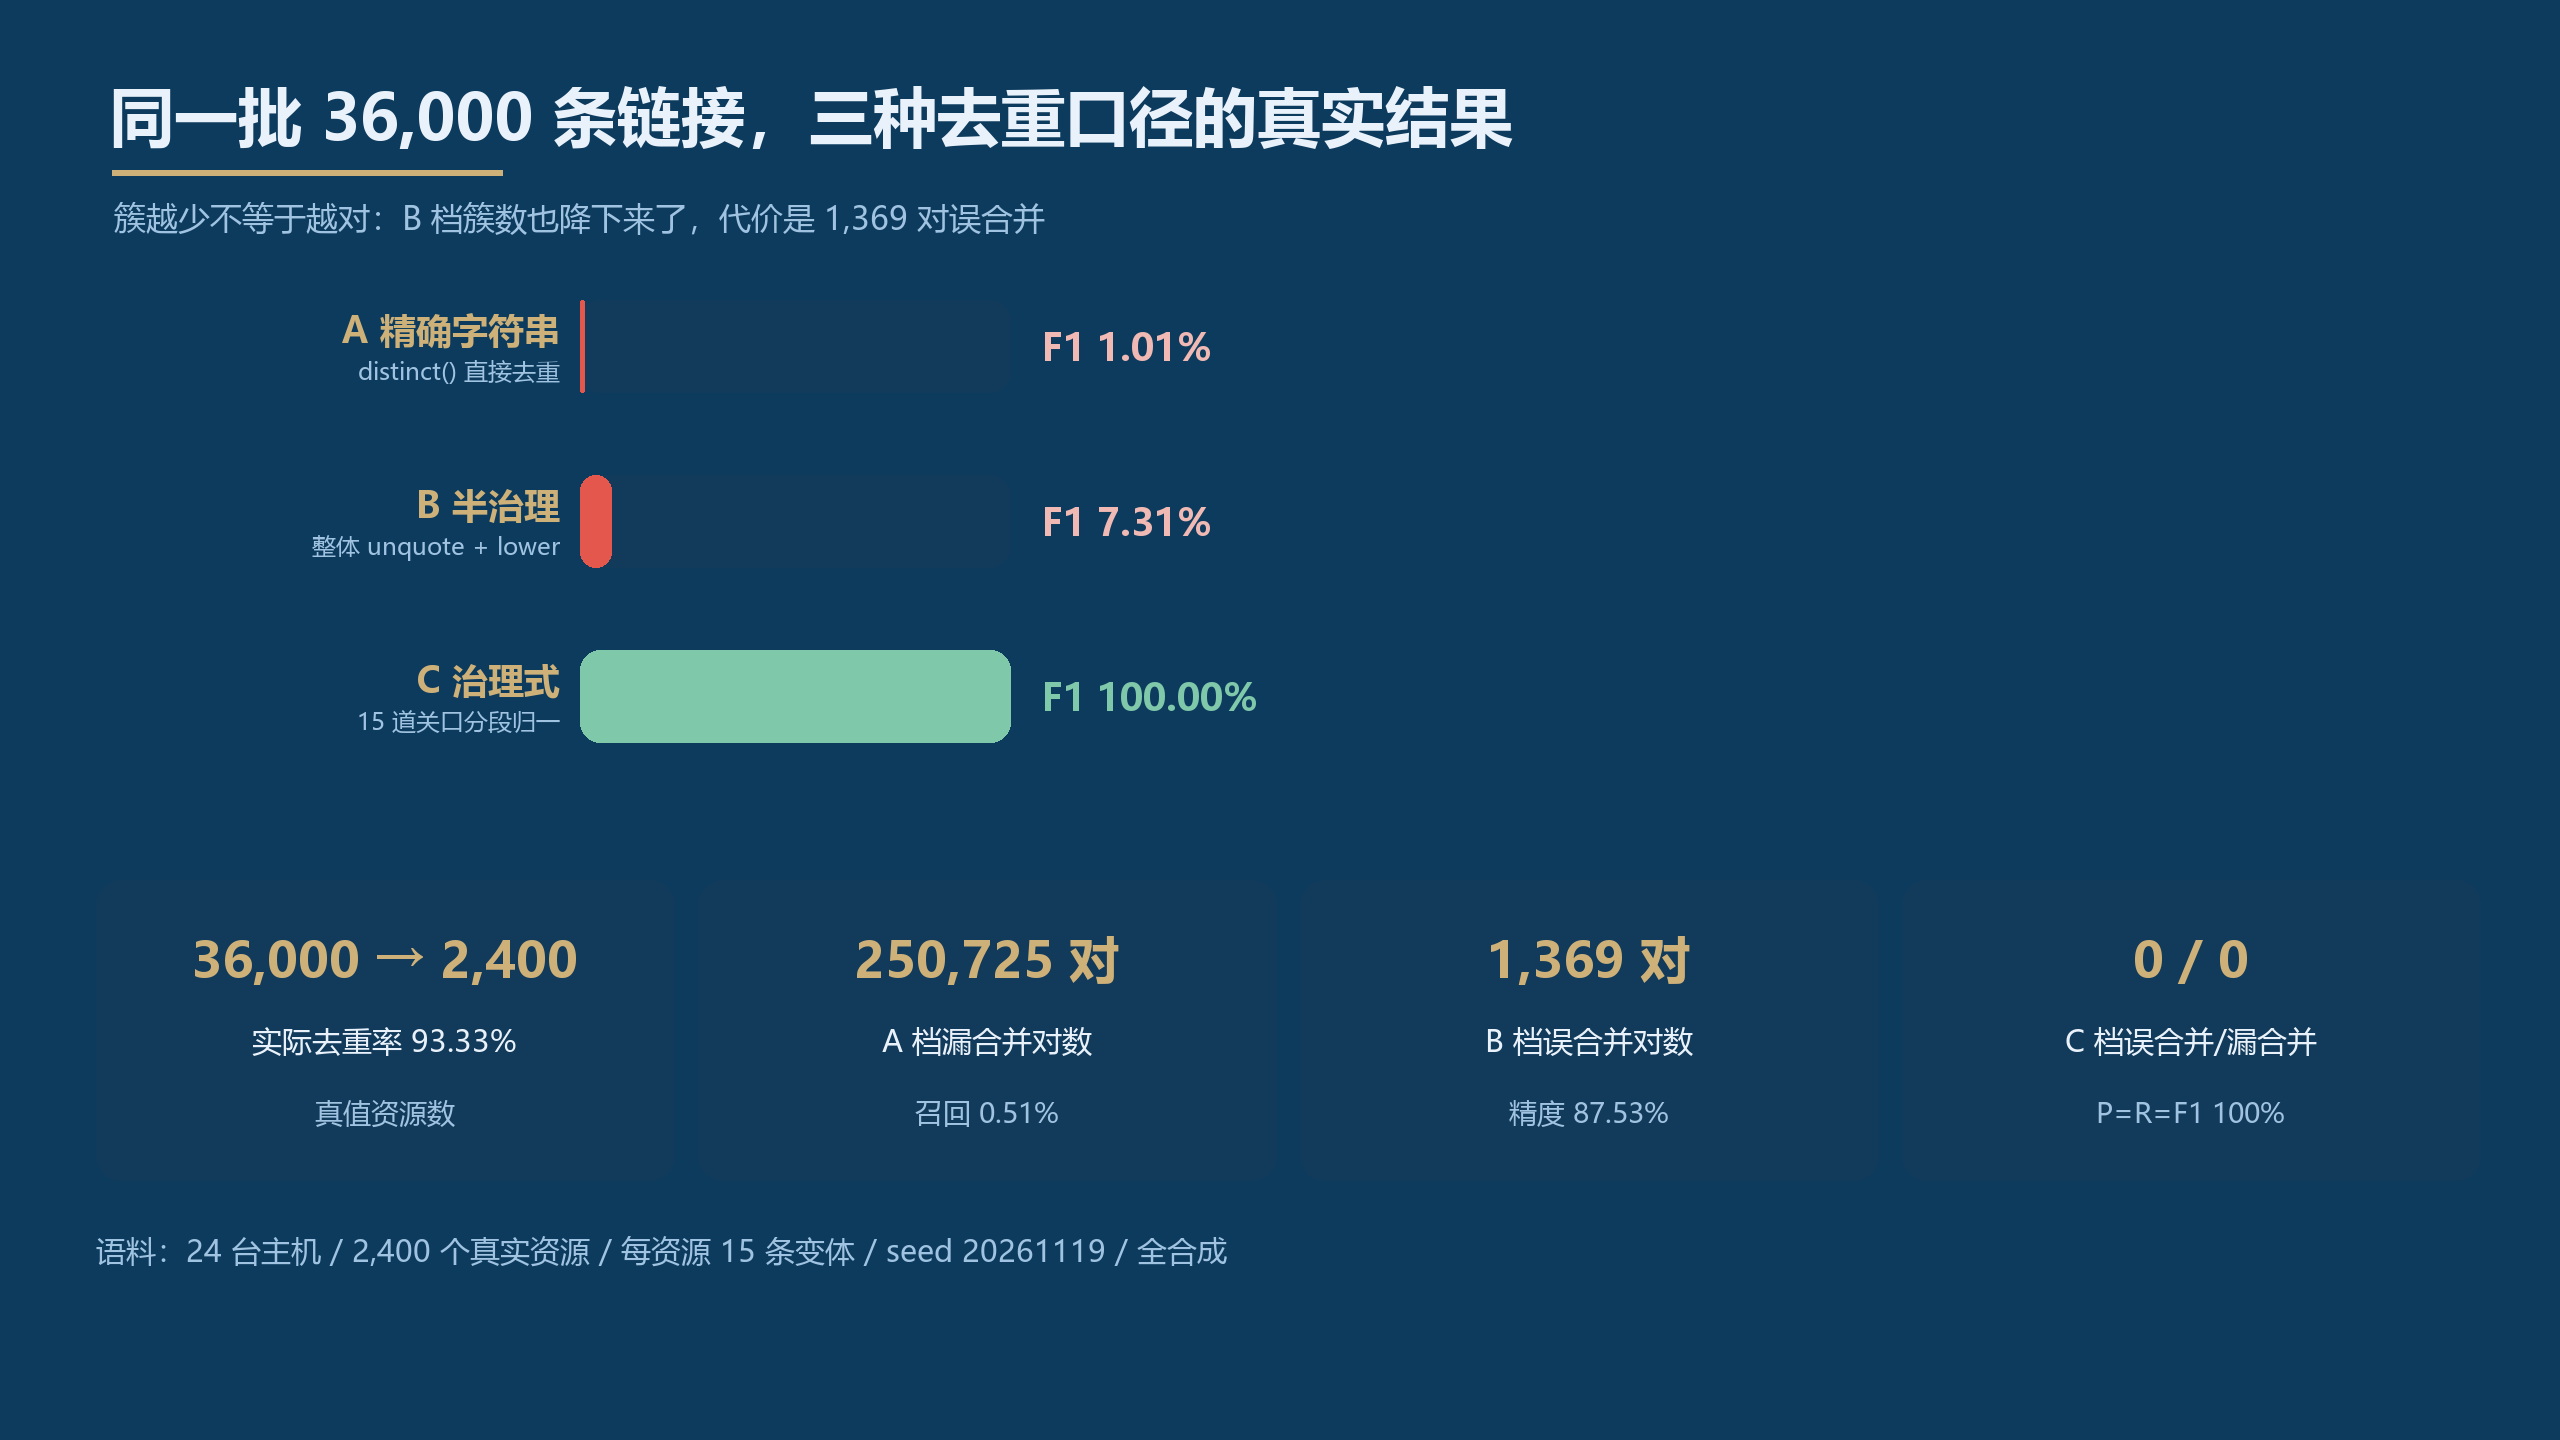
三档去重口径在同一批链接上的实测差距
指标本身也要说清楚。簇级指标会骗人(簇数少不等于对),所以我一律用 pair 级精确计算,且不抽样——用 O(n) 计数法:
from collections import Counter

def pairs_metrics(keys, rids):
    cs   = Counter(keys)                    # 每个簇多大
    ks   = Counter(rids)                    # 每个真值类多大
    cell = Counter(zip(keys, rids))         # 簇 × 真值类的交叉格
    tp = sum(n * (n - 1) // 2 for n in cell.values())
    fp = sum(n * (n - 1) // 2 for n in cs.values()) - tp
    fn = sum(n * (n - 1) // 2 for n in ks.values()) - tp
    p = tp / (tp + fp) if tp + fp else 0.0
    r = tp / (tp + fn) if tp + fn else 0.0
    return p, r, 2 * p * r / (p + r) if p + r else 0.0
TP = Σ C(交叉格,2),簇内总对数减 TP 就是误合并,真值类内总对数减 TP 就是漏合并。36,000 条的真值对数一共 252,000 对(2,400 × C(15,2)),全量精确算完不到 0.1 秒,没必要抽样。
三、留出集:别信"100%"
C 档在训练语料上是满分的。但那份语料是我按规则生成的,满分只能证明"规则覆盖了扰动",不能证明"能泛化"。所以我另做了一份留出集:300 个资源、3,000 条,扰动只允许叠加、且换成训练时没出现过的类型——协议相对写法 //host/path、前后空白、空查询 ??、把路径首字母写成 %XX、多余 &&、尾随 &。
档位 | 簇数 | 精确率 | 召回 | F1 |
|---|---|---|---|---|
A 朴素 | 1,140 | 100.00% | 31.53% | 47.94% |
B 半治理 | 356 | 50.31% | 54.87% | 52.49% |
C(首轮) | 315 | 100.00% | 98.65% | 99.32% |
C(补 1 条规则后) | 300 | 100.00% | 100.00% | 100.00% |
首轮掉的那 0.68 个点,全部来自 15 个资源被拆开,原因只有一个:查询参数尾部带空白(?id=3026 &),值被编码成 3026%20。补上 part.strip() 这一行,立刻回到 100%。留出集的价值就在这里——它能逼出训练集里根本不存在的那条规则。
四、可复制代码:核心 60 行
import re
from urllib.parse import urlsplit, quote, unquote

UNRESERVED = set("ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789-._~")
TRACK = {"spm", "from", "ref", "gclid", "fbclid", "yclid", "msclkid",
         "_ga", "share_token", "scene", "srcid"}
SAFE = "/%:@!$&'()*+,;=-._~"

def decode_unreserved(s):
    """只解 unreserved 的 %XX;%2F 必须原样保留,否则分段边界被改写"""
    def rep(m):
        ch = chr(int(m.group(1), 16))
        return ch if ch in UNRESERVED else "%" + m.group(1).upper()
    return re.sub(r"%([0-9A-Fa-f]{2})", rep, s)

def remove_dot_segments(path):
    out = []
    for seg in path.split("/"):
        if seg == ".":
            continue
        if seg == "..":
            if len(out) > 1:
                out.pop()
            continue
        out.append(seg)
    p = "/".join(out)
    if not p.startswith("/"):
        p = "/" + p
    return p

def canonical(url):
    sp = urlsplit(url.strip())
    scheme = (sp.scheme or "https").lower()

    host = sp.hostname or ""          # 注意:hostname 已自带小写
    if host.endswith("."):
        host = host[:-1]
    if any(ord(c) > 127 for c in host):
        host = host.encode("idna").decode("ascii")
    for pre in ("www.", "m."):
        if host.startswith(pre) and host.count(".") >= 2:
            host = host[len(pre):]
            break

    try:
        port = sp.port
    except ValueError:                 # "host:443." 这类畸形 netloc 会抛错
        port = None
    netloc = host if port is None or (scheme, port) in (("https", 443), ("http", 80)) \
        else f"{host}:{port}"

    path = decode_unreserved(sp.path or "/")
    path = re.sub(r"/{2,}", "/", path)
    path = "/".join(s.split(";", 1)[0] for s in path.split("/"))
    path = remove_dot_segments(path)
    if len(path) > 1 and path.endswith("/"):      # 先剥尾斜杠
        path = path.rstrip("/")
    if path.endswith("/index.html"):              # 再剥 index.html
        path = path[: -len("index.html")]
        if len(path) > 1 and path.endswith("/"):
            path = path.rstrip("/")
    path = quote(path, safe=SAFE)

    pairs = []
    for part in (sp.query or "").split("&"):
        part = part.strip()                       # 脏数据:参数尾部空白
        if not part:
            continue
        k, _, v = part.partition("=")
        k = decode_unreserved(k.replace("+", "%20"))
        v = decode_unreserved(v.replace("+", "%20"))
        if k.lower() in TRACK or k.lower().startswith(("utm_", "hmsr", "hmpl")):
            continue
        pairs.append((quote(k, safe=SAFE), quote(v, safe=SAFE)))
    pairs.sort(key=lambda kv: kv[0])              # 稳定排序,同名键保序

    q = "&".join(f"{k}={v}" if v else k for k, v in pairs)
    return f"{scheme}://{netloc}{path}" + (f"?{q}" if q else "")
用法很直接:
import csv, collections
with open("urls.tsv", encoding="utf-8") as f:
    urls = [row[0] for row in csv.reader(f, delimiter="\t")]
groups = collections.defaultdict(list)
for u in urls:
    groups[canonical(u)].append(u)
print(f"{len(urls)} 条 → {len(groups)} 个资源")
上面这段 canonical() 与跑出全文所有数字的工程实现逐条比对过:36,000 条输入,输出 0 处差异。可以直接拷走用。
五、踩坑清单(全部是这次真实踩到的)
urlsplit().port会对host:443.直接抛ValueError,不是返回None。第一版脚本没有兜住,整批 36,000 条在第 1 条畸形数据上就崩了。urlsplit().hostname已经返回小写。所以我那句"host 大小写归一"是空操作,消融实验里它的差异是 0.00——遇到消融零差异,先怀疑规则本身,别急着改实验。- 先剥
index.html再剥尾斜杠,/a/index.html/会漏掉。顺序必须反过来:剥尾斜杠 → 剥index.html→ 再剥一次尾斜杠。 ??和?&会被当成一个名为?的参数,输出变成?%3F,凭空造出一个不存在的资源。空查询必须先按"无查询"处理。- 参数尾部空白(
?id=1 &)会把值变成1%20。留出集里 300 个资源挂了 15 个,就是这一条。 - 真值本身会被污染:我第一版语料里有两个不同
resource_id撞到同一条规范 URL,结果 C 档明明写对了却报出 697 对误合并。做合成评测,资源必须按规范式唯一,否则全程白测。 %2F永远不要 unquote。解成/就把/docs/a%2Fb1000和/docs/a/b1000焊死成一个,B 档 65 个误合并簇全是这么来的。- 不要整体
lower()。/Wiki/ent2003和/wiki/ent2003在大小写敏感的站点上是两个页面,B 档另外 244 个误合并簇全在这里。 http和https不要强行合并。本实验只统一 scheme 大小写,不跨协议归并——协议、端口、证书都可能不同,甚至可能是两个站点。这一条属于口径选择,不是 bug,但必须写进文档。
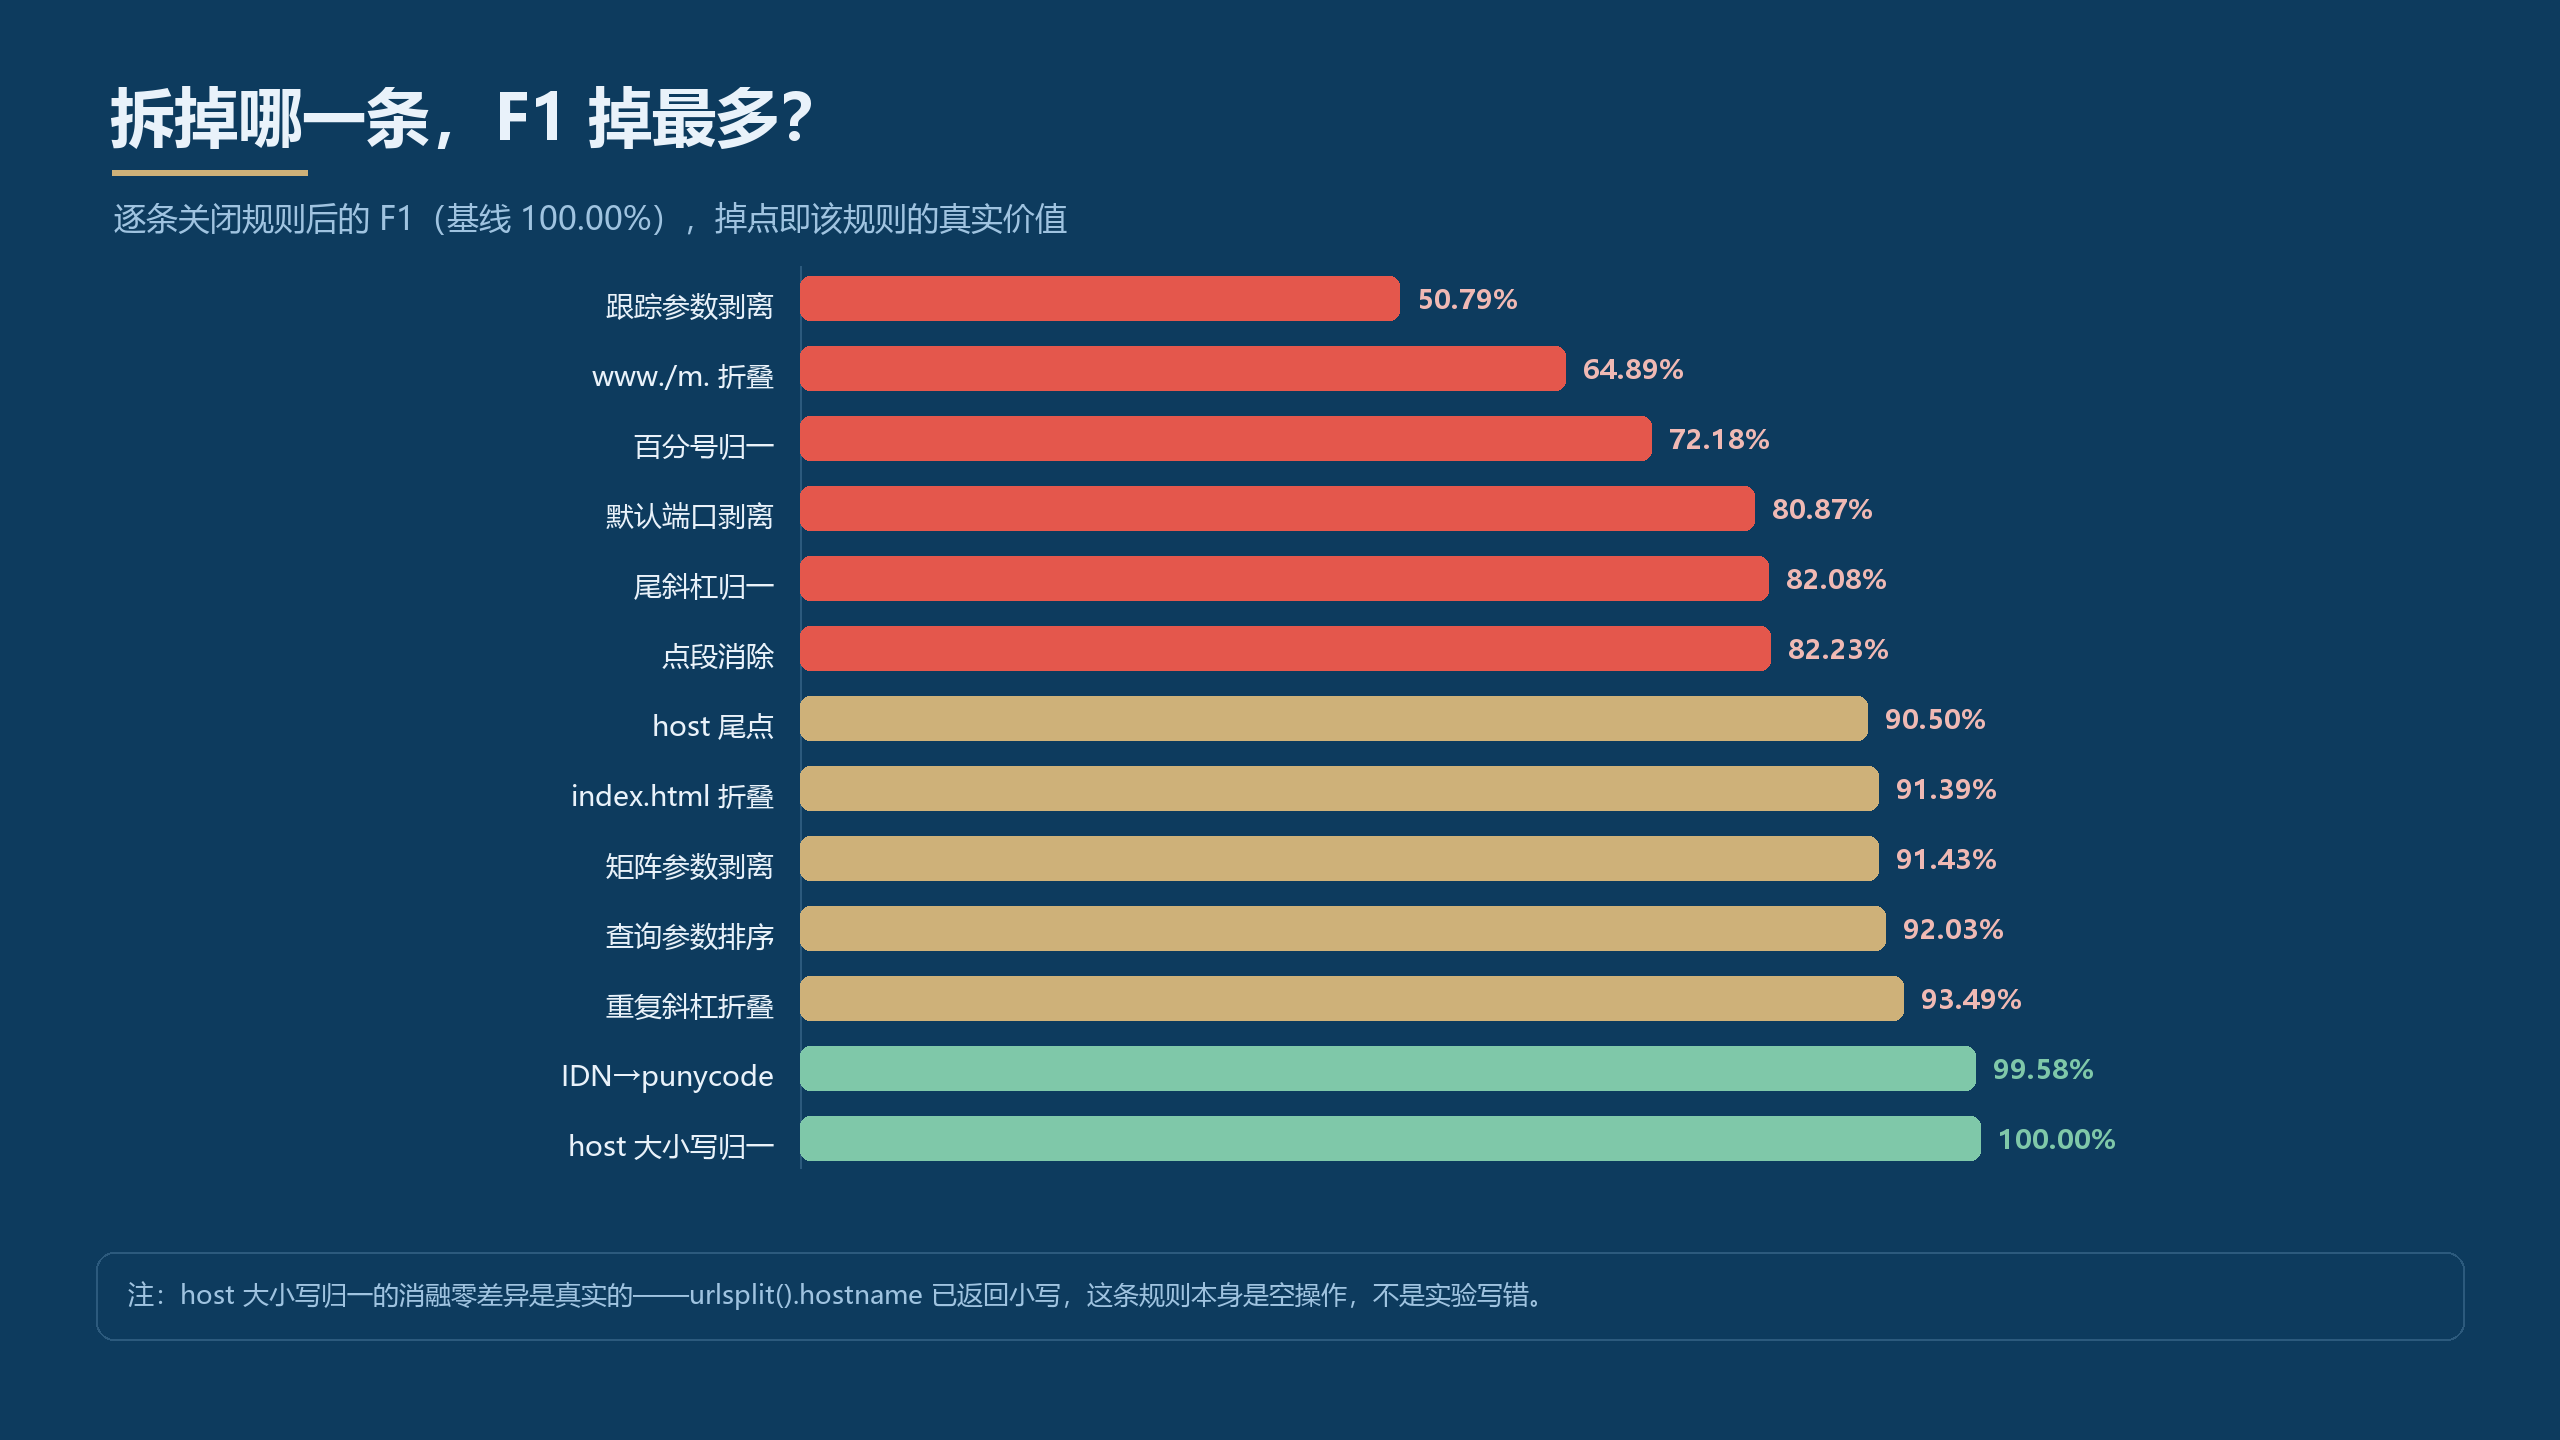
逐条关闭归一规则后的 F1 掉点
消融的排序很能说明优先级:跟踪参数剥离(-49.21)> www./m. 折叠(-35.11)> 百分号归一(-27.82)> 默认端口(-19.13)> 尾斜杠(-17.92)。如果只来得及做三条,就做这三条——它决定了 F1 是 50 还是 85。
六、给 WorkBuddy 的提示词模板
这类"口径型"任务,最难的不是写代码,是把"哪些该合并、哪些绝不能合并"讲清楚。我用的提示词是这样的:
你是一名数据工程助手,帮我写 URL 归一化函数。
输入:一批从多处导出的链接,同一页面可能有不同写法。输出:
canonical(url) -> str,同一资源必须得到同一字符串。必须处理:scheme 大小写、host 大小写与尾部点、IDN 转 punycode、www./m. 前缀、默认端口 80/443、fragment、路径百分号编码(仅 unreserved 可解码)、
%2F保持编码、重复斜杠、点段、;jsessionid矩阵参数、index.html、尾斜杠、跟踪参数(utm_/spm/from/gclid/fbclid/_ga/share_token/scene)、查询参数排序。绝对不要做:整体
lower()(路径大小写敏感)、整体unquote()(%2F会改分段)、跨 http/https 合并。处理顺序要求:先剥尾斜杠 → 再剥
index.html→ 再剥尾斜杠;先解 unreserved 的%2E→ 再消点段。交付时附一段自测:对每条规则给出"输入 → 输出"的例子,并说明如果不加这条规则会错在哪。
关键是最后一段。让它自己输出"不加会怎样",比让它写"实现了什么"有用得多——消融数据就是这么来的。
七、收尾
这次实验最反直觉的结论不是"要写 15 条规则",而是:
去重脚本的默认输出看起来永远是"成功的"。 A 档跑完不报错,输出了 34,893 条,任务"完成"了;B 档跑完也不报错,还少了 5,000 多条,看起来"效果更好"。真正的问题只在有人拿这批数据去做统计、发现 UV 虚高 15 倍的时候才暴露出来。
所以做这类清洗,一定要先把"真值"造出来。没有 pair 级 P/R/F1,你无法区分"去重效果好"和"去重去错了"。而造真值的成本,其实只有一下午——远低于事后排查一个错误合并造成的损失。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号