谁调用了这个函数?我把 JS/Python 源码画成了一张「涡轮图」
原创
谁调用了这个函数?我把 JS/Python 源码画成了一张「涡轮图」
原创
用户5921968
修改于 2026-11-19 17:25:11
修改于 2026-11-19 17:25:11
接手一个陌生的代码库,最常问的问题不是「这段代码干了什么」,而是——
「这个函数被谁调用了?删掉它会不会炸?」
IDE 的 Call Hierarchy 能回答,但要打开工程、等索引;grep 能回答,但 foo 这个词出现 30 次里有 20 次是注释和字符串。我于是自己写了个分析脚本,把源码画成一张以函数为中心的调用关系图。
先看效果——下面这张图是分析脚本自身的源码(约 1700 行 JS)得到的:
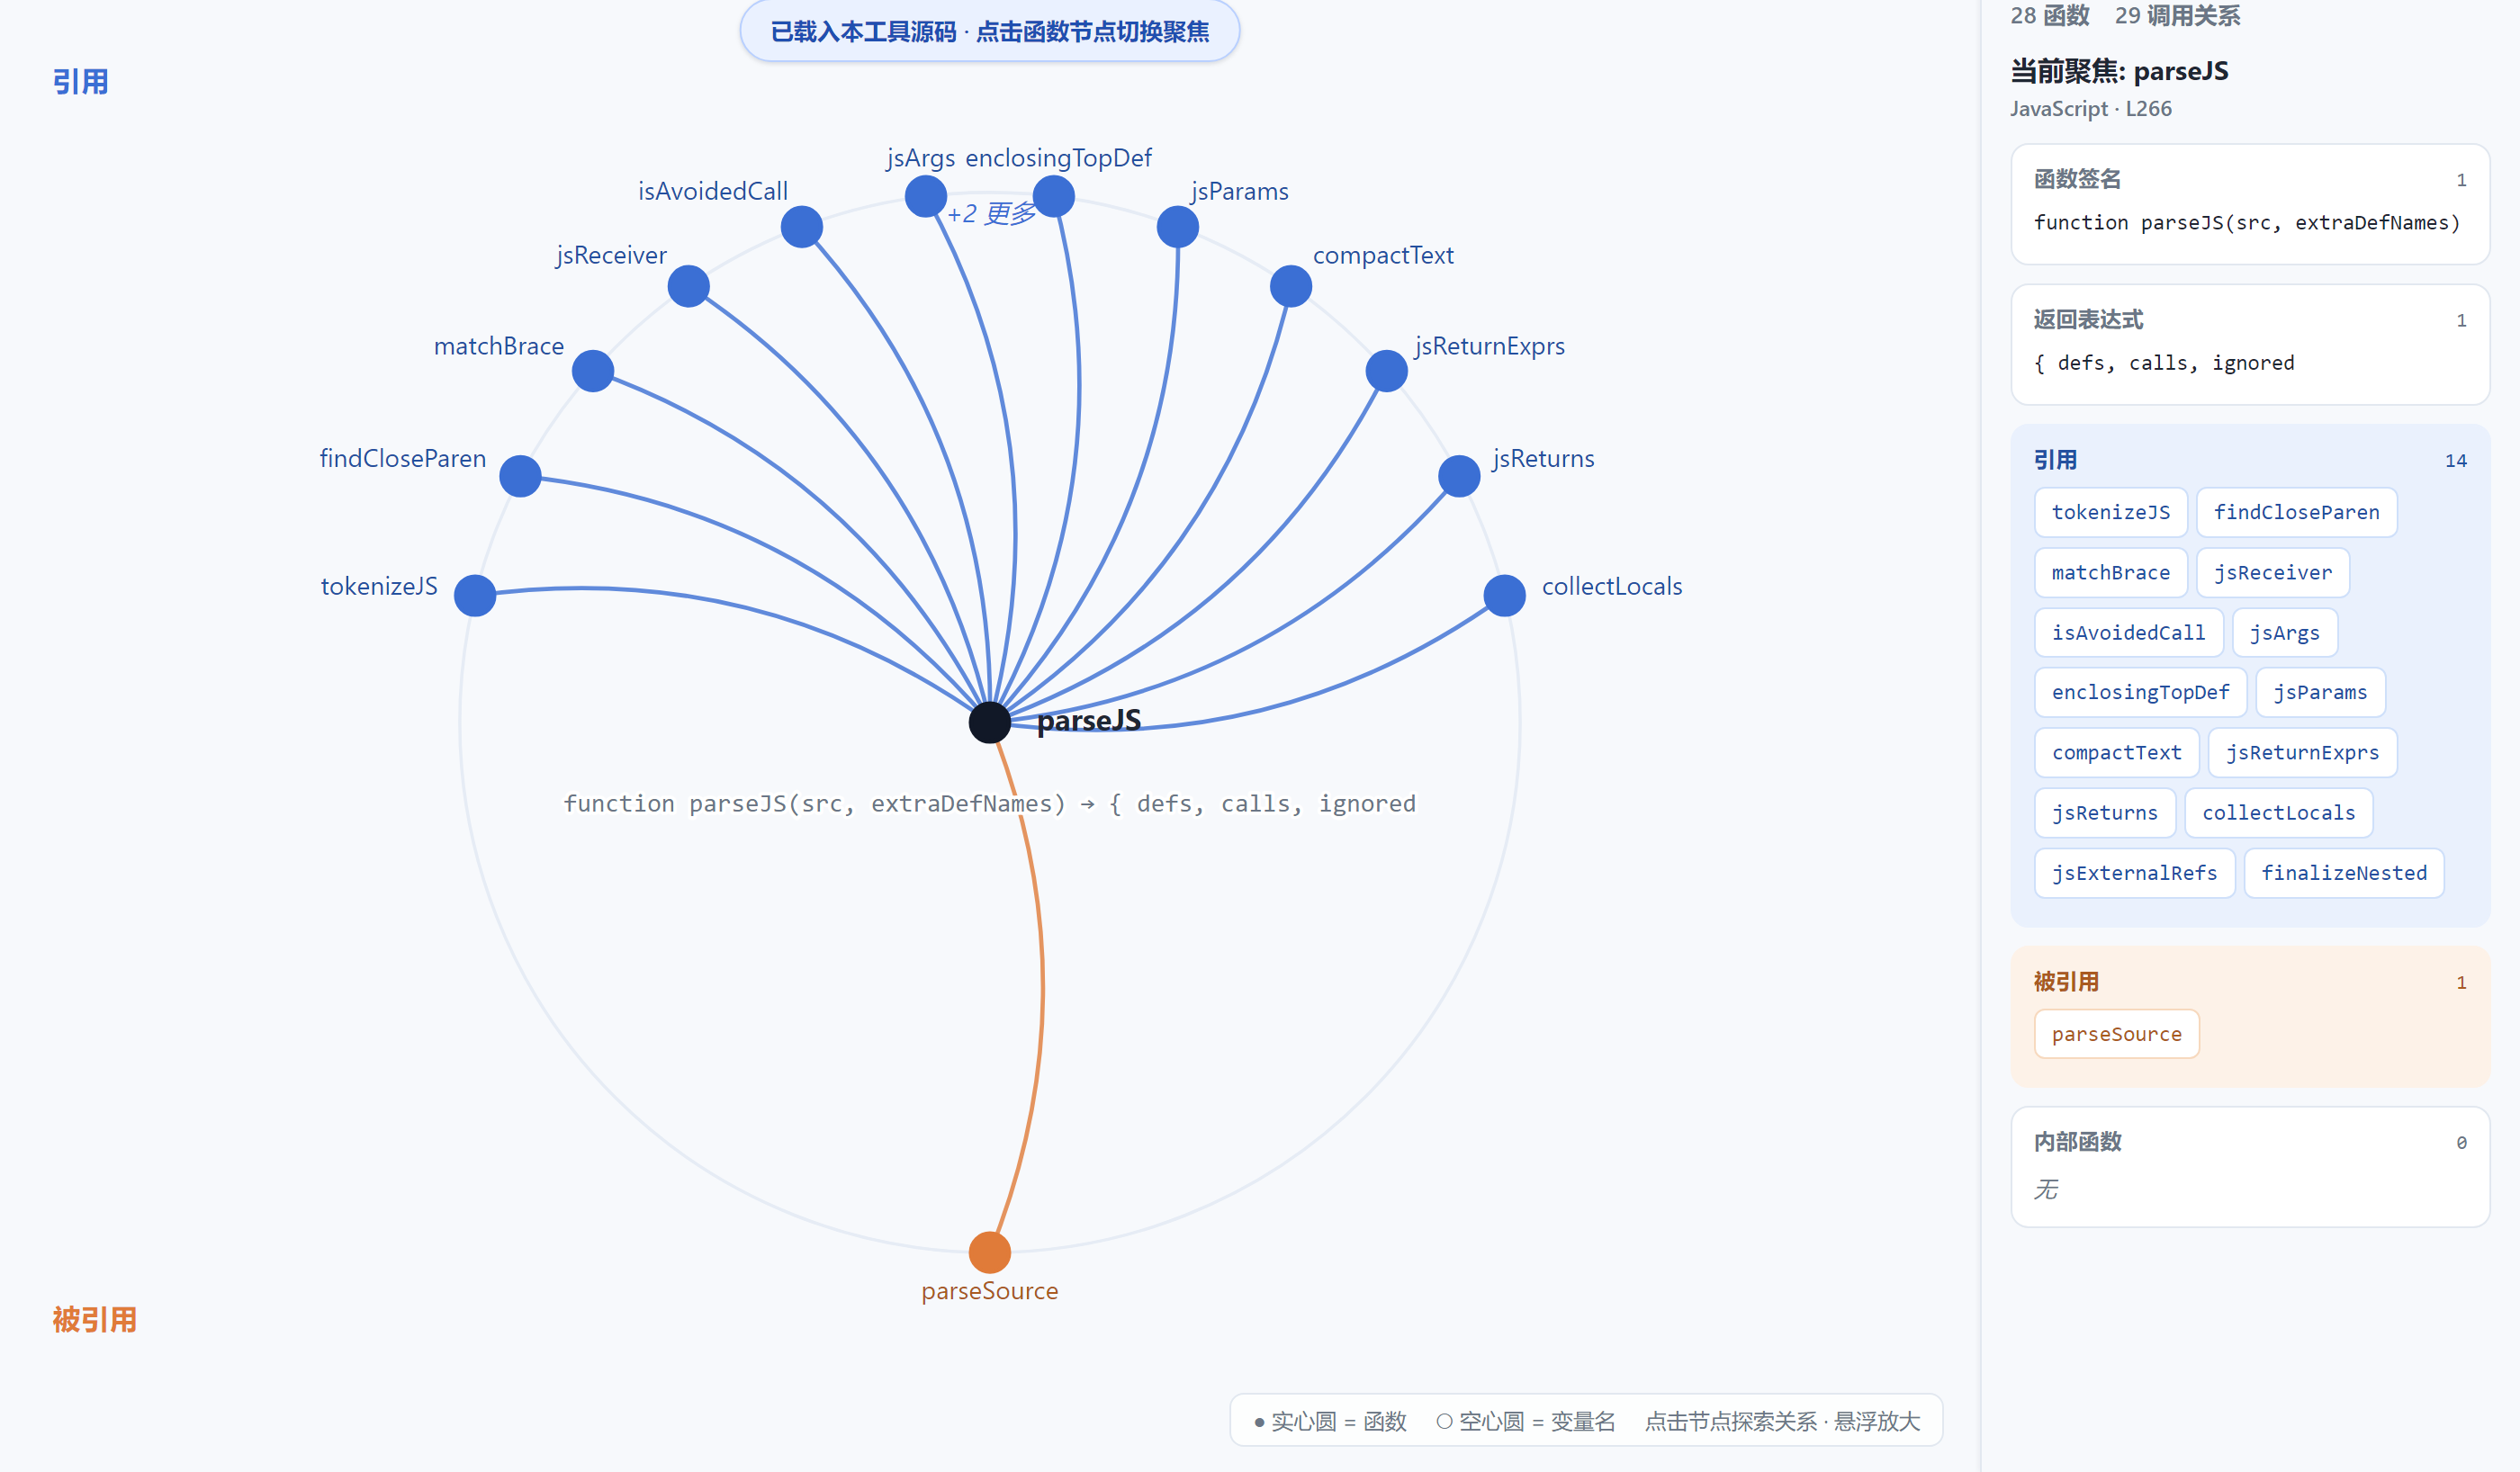
中心是 parseJS,上弧(蓝)是它引用的 14 个函数,下弧(橙)是唯一调用它的 parseSource。
一、为什么是「涡轮图」这个形状
常见的调用图有两种画法:有向图力导向布局(节点乱飞,边纠缠)和层级树(只能单向展开)。这两种在「函数很多、关系复杂」时都不太可读。
我想要的是回答一个具体问题:盯着某一个函数,它上下游是什么? 所以布局干脆以「当前焦点函数」为中心:
- 上弧(蓝)= 引用:这个函数调用了谁,沿上半圆均匀散开;
- 下弧(橙)= 被引用:谁调用了这个函数,与上半圆镜像对称;
- 连线是从中心出发的贝塞尔弧线,上下反向弯曲,形成类似涡轮叶片的对称结构。
镜像对称有个隐藏好处:一个函数「扇入大还是扇出大」,看弧线的视觉重心在上还是在下就能感知。典型的入口函数(main / runCLI)扇出远大于扇入,图的重心天然偏上;典型的工具函数则相反。这种「一眼的形状信息」是有向图布局很难给的。
点击图中任意节点,它就飞到中心成为新的焦点——顺着调用链一路点下去,像在图上「导航」:
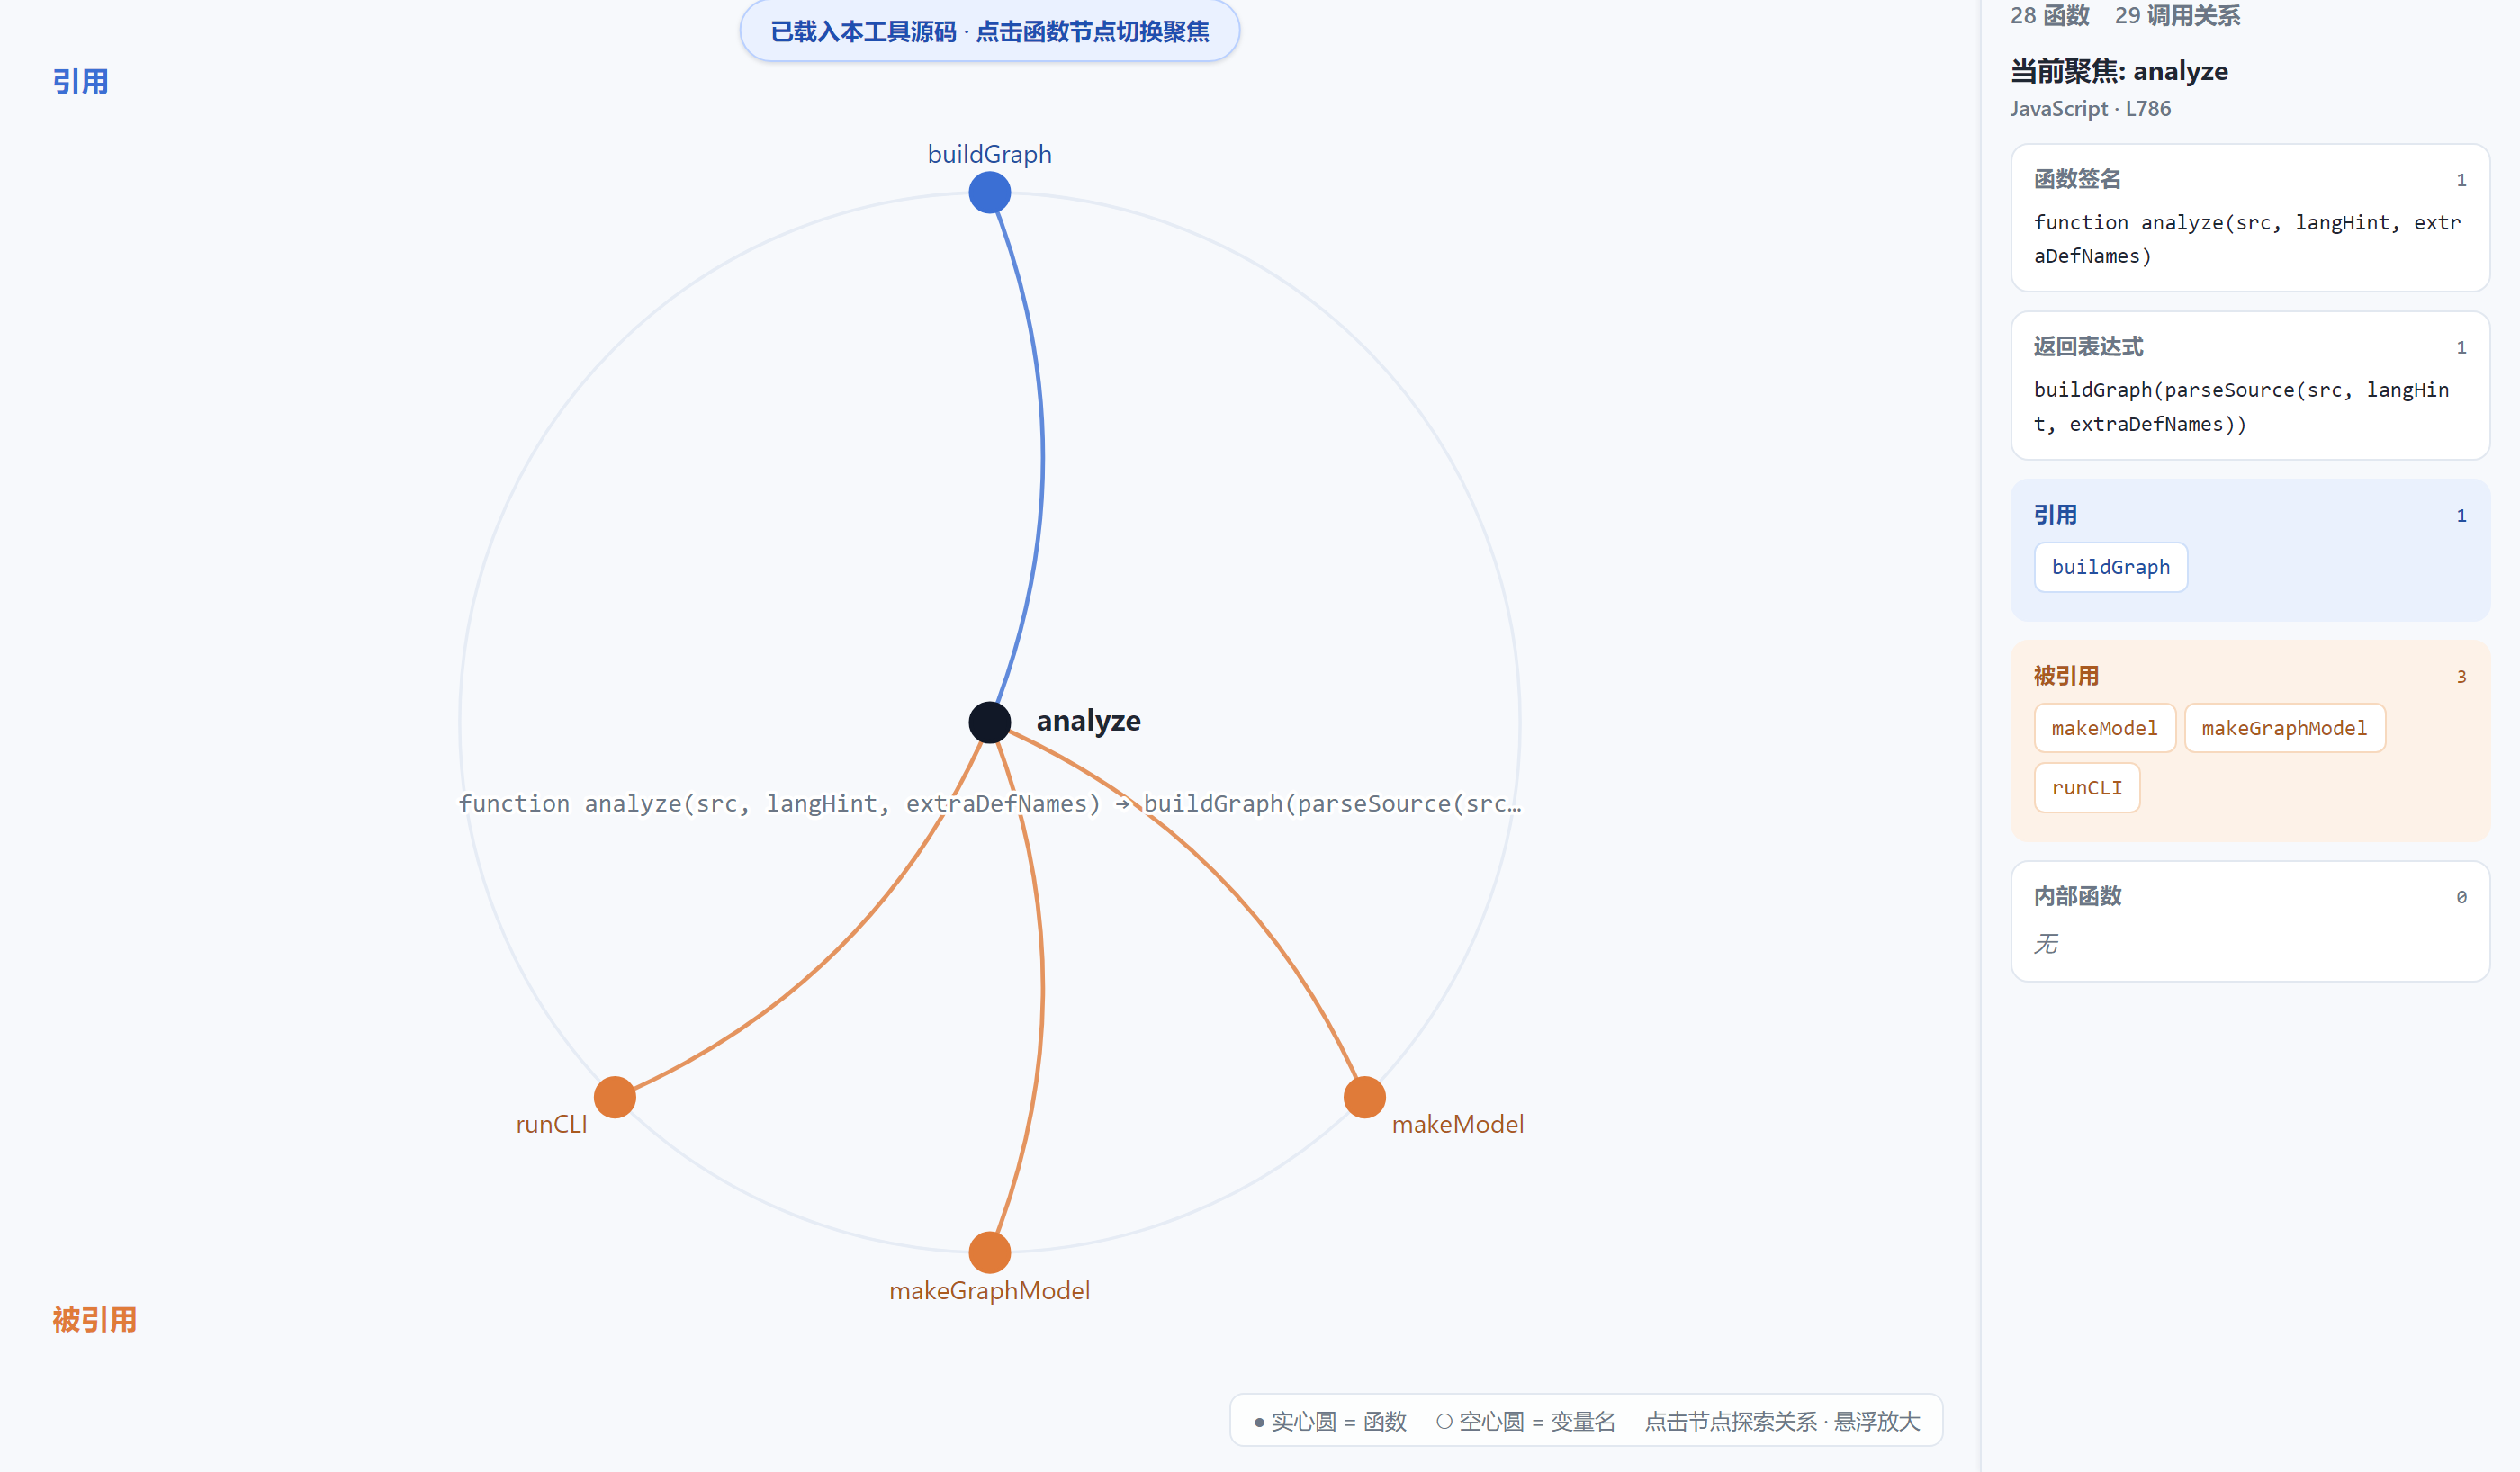
analyze 只引用 buildGraph,却被 makeModel / makeGraphModel / runCLI 三处调用——典型的中间层函数。
二、不用 AST,靠词法启发式
主流方案(js-call-graph、CodeQL 等)都要装 Node 环境、配依赖、跑脚本。我给这个脚本定的目标是:零依赖,浏览器双击 HTML 就能用,代码不出本机。这意味着不能用 acorn 这类真正的解析器,只能在词法层面做文章。
1. 括号匹配切函数体
先用手写的 tokenizer 处理字符串 / 模板串 / 注释 / 正则字面量,保证括号计数不被干扰,再用栈匹配花括号切出每个函数的边界:
2. 调用识别与「豁免名单」
词法层面识别函数调用的最大敌人是误报:arr.push()、obj.map()、console.log() 这些都不是对自定义函数的调用。维护一份 143 项的豁免名单(receiver + 常见内置方法)过滤噪音:
3. 函数 / 变量双视图
除了函数调用,还能聚焦一个变量看它的输入输出流向——对理解「数据怎么流过这个函数」很直观:
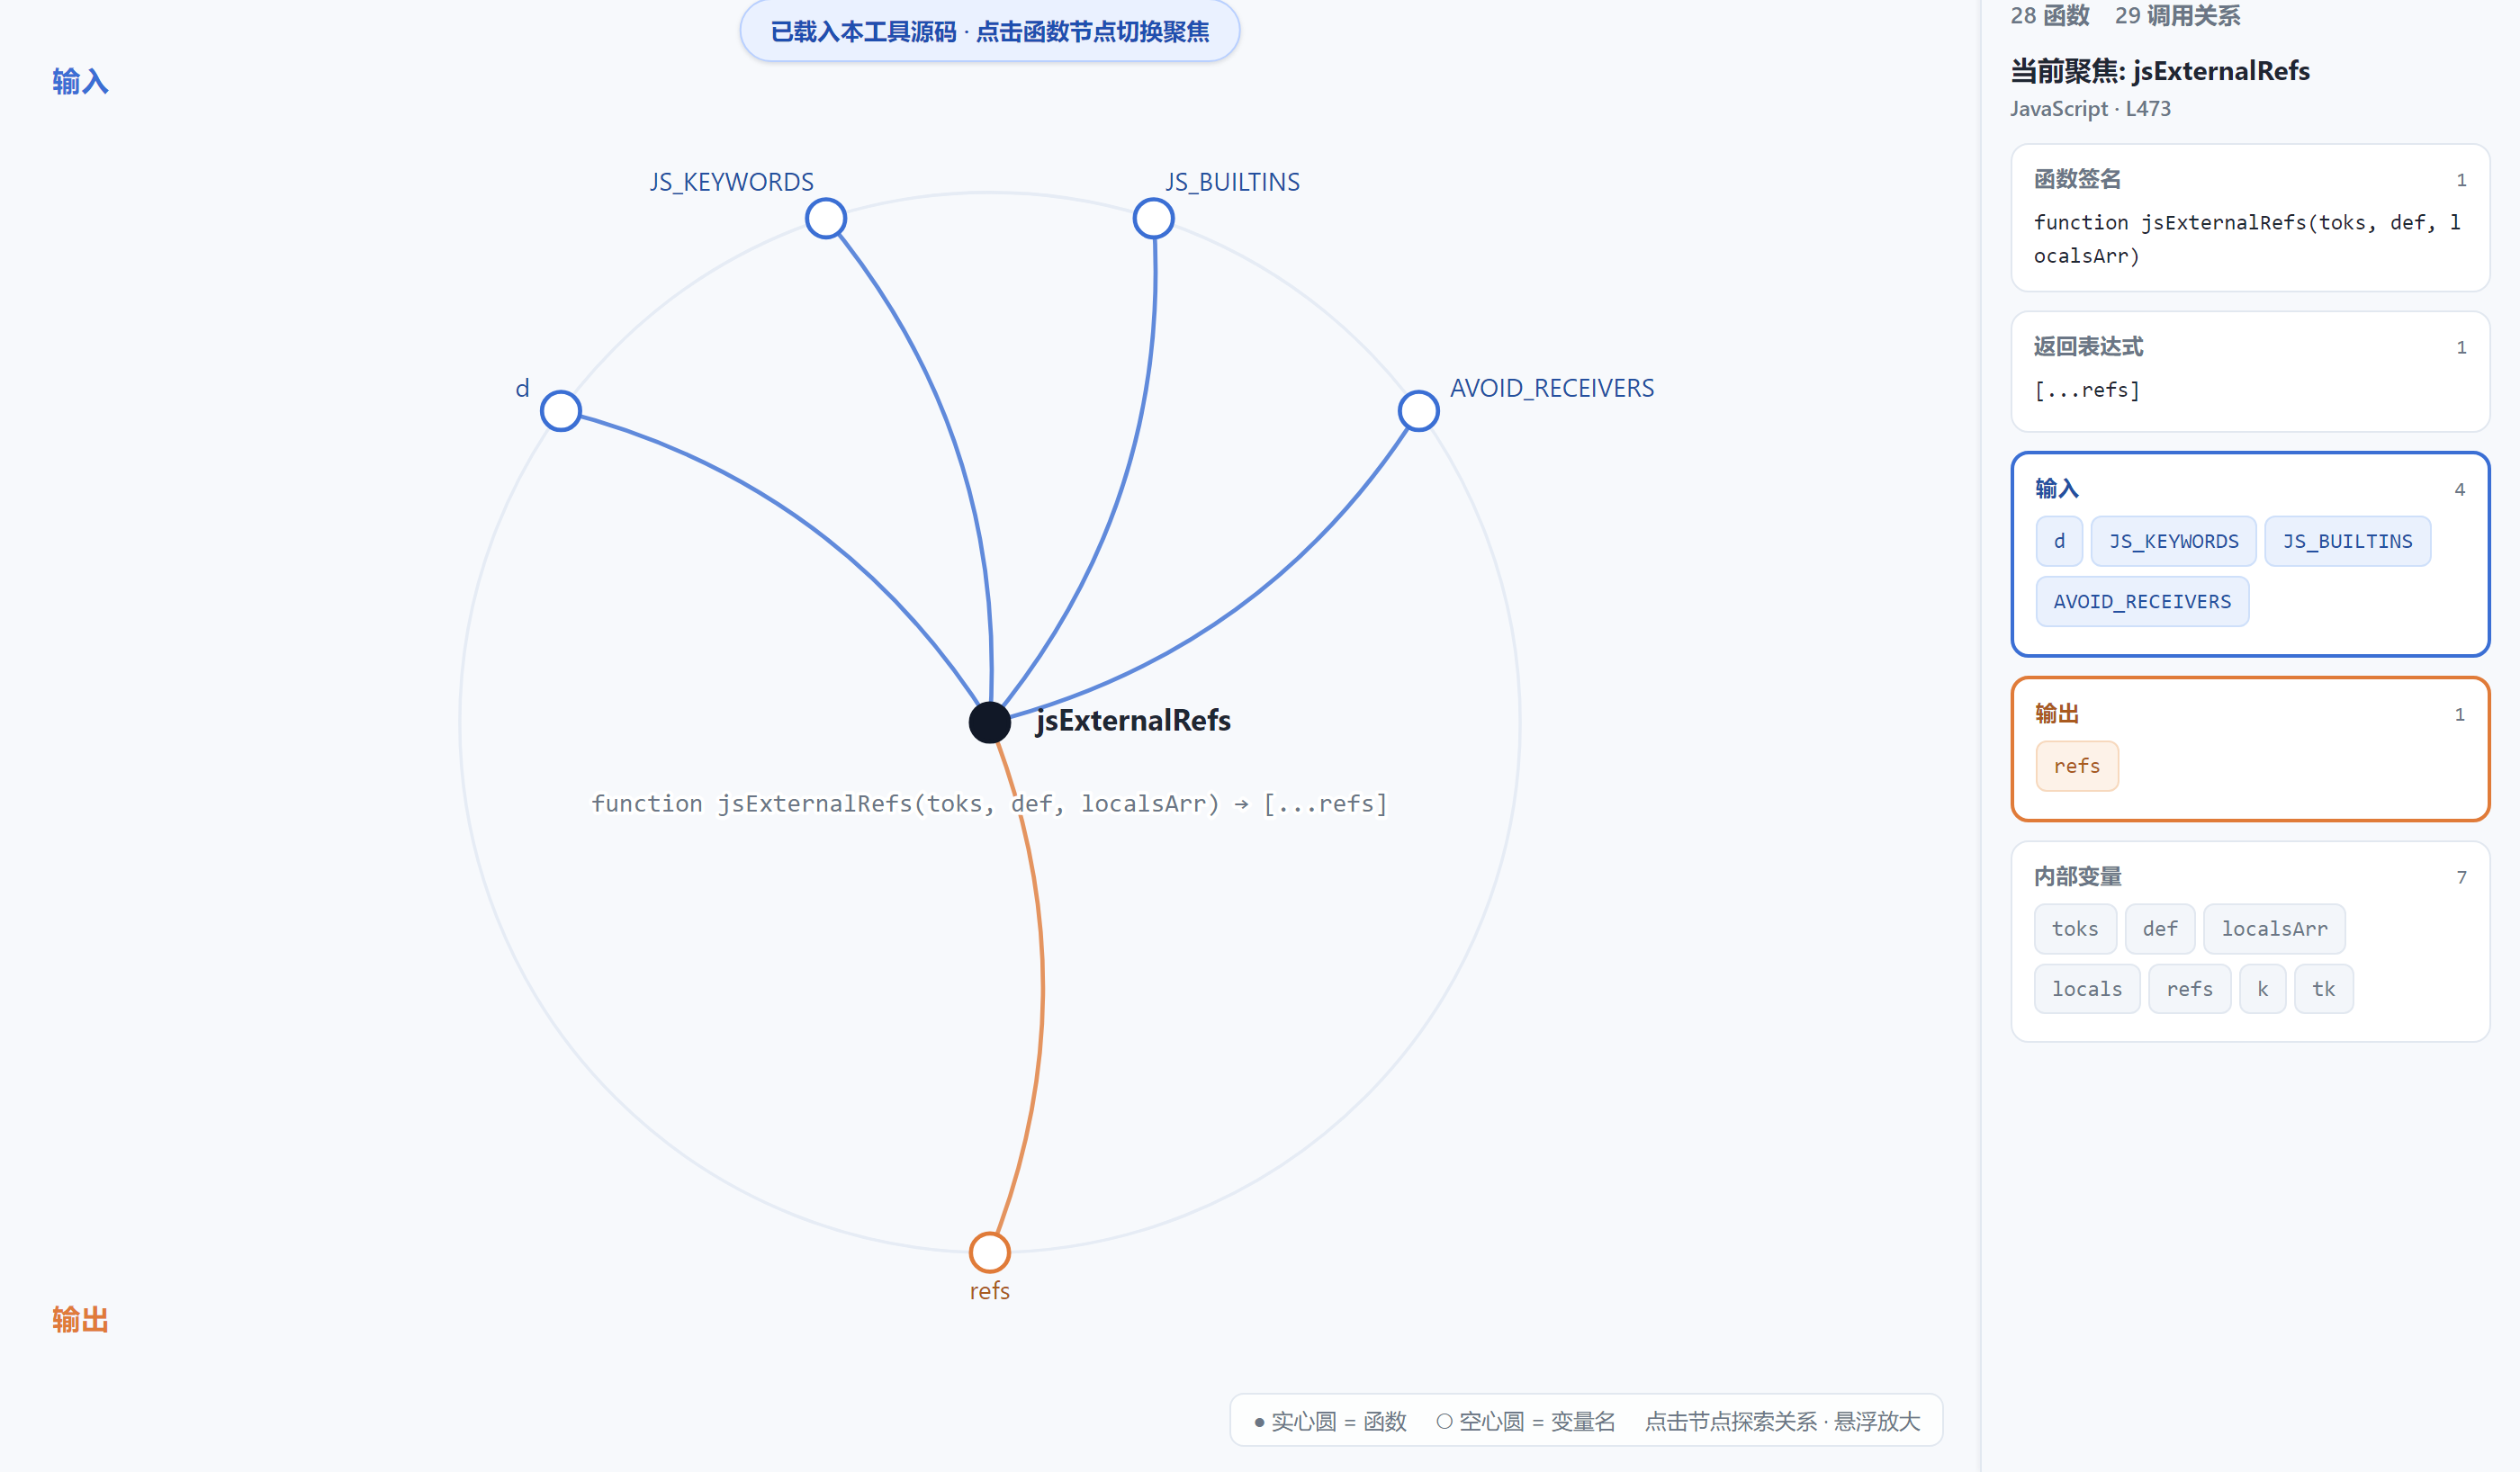
空心圆代表变量,实心圆代表函数。
三、一个诚实的局限:启发式的天花板
一个分析工具最需要交代清楚的就是它什么时候会错。以下是一个真实踩到的漏判案例。
脚本自己的源码里,lineOf 被调用了 6 次,但图上它的「被引用」一度是空的。二分排查后定位到根因:调用嵌在「函数实参位置的对象字面量」里时,启发式无法把它归属到外层调用者:
这种写法里,f(x) 与外层 push 之间隔着匿名对象,词法层没有作用域信息,无法可靠判定归属。这类写法在构造配置对象、事件参数时并不罕见,所以这个局限是真实存在的。
边界就在这里: 零依赖、秒开的代价是词法层盲区。要彻底解决,得上真正的 AST 解析器(JS 用 acorn、Python 用标准库 ast),做词法作用域精确归属与 import / require 溯源。两种路线共享同一套图模型 JSON,但实现成本与被信任的程度完全不同——这也是我写这篇文章想说清楚的核心取舍。
四、几个值得复用的实现细节
- 节点自适应:一侧超过 21 个函数时截断显示 10 个,补一个「+N more」,避免半圆上的文字糊成一片。
- 连线曲率:贝塞尔控制点沿半圆法向偏移固定比例(0.2),上下弧反向弯曲;同向旋转的"真涡旋"方案视觉更炫但读图成本更高,最终没采用。
- 入场动画:连线用 stroke-dasharray / dashoffset 从中心向外生长,节点按半径由内向外错峰浮现;prefers-reduced-motion 下要显式把 dashoffset 归零,否则线不可见。
- 空环节点的命中区域:空心圆若只描边不填色,指针落进圆内空白会 hover 抖动,必须设置 fill: none + pointer-events: all。
写在最后
这个脚本从竖轴布局改到涡轮布局,前后踩了不少坑:远距离细节与近距离细节的视觉层级、贝塞尔曲率的取向、无头浏览器里 CSS 动画时钟的定格……如果大家对「不用 AST 画调用图」的 tokenizer 和豁免名单设计感兴趣,评论区聊聊,下一篇展开讲。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号