生成内容测试题,从出题到留档的完整链路
原创
生成内容测试题,从出题到留档的完整链路
原创
菜菜 黑糖
发布于 2026-11-19 14:05:54
发布于 2026-11-19 14:05:54
生成内容测试题,从出题到留档,中间有五个动作。
大多数材料只做了第一个:出题。
剩下四个——测试、判定、处置、留档——要么没做,要么做了没记录。
而评审看的,恰恰是后面四个。
一、五个动作,每一步产出什么
动作1:出题
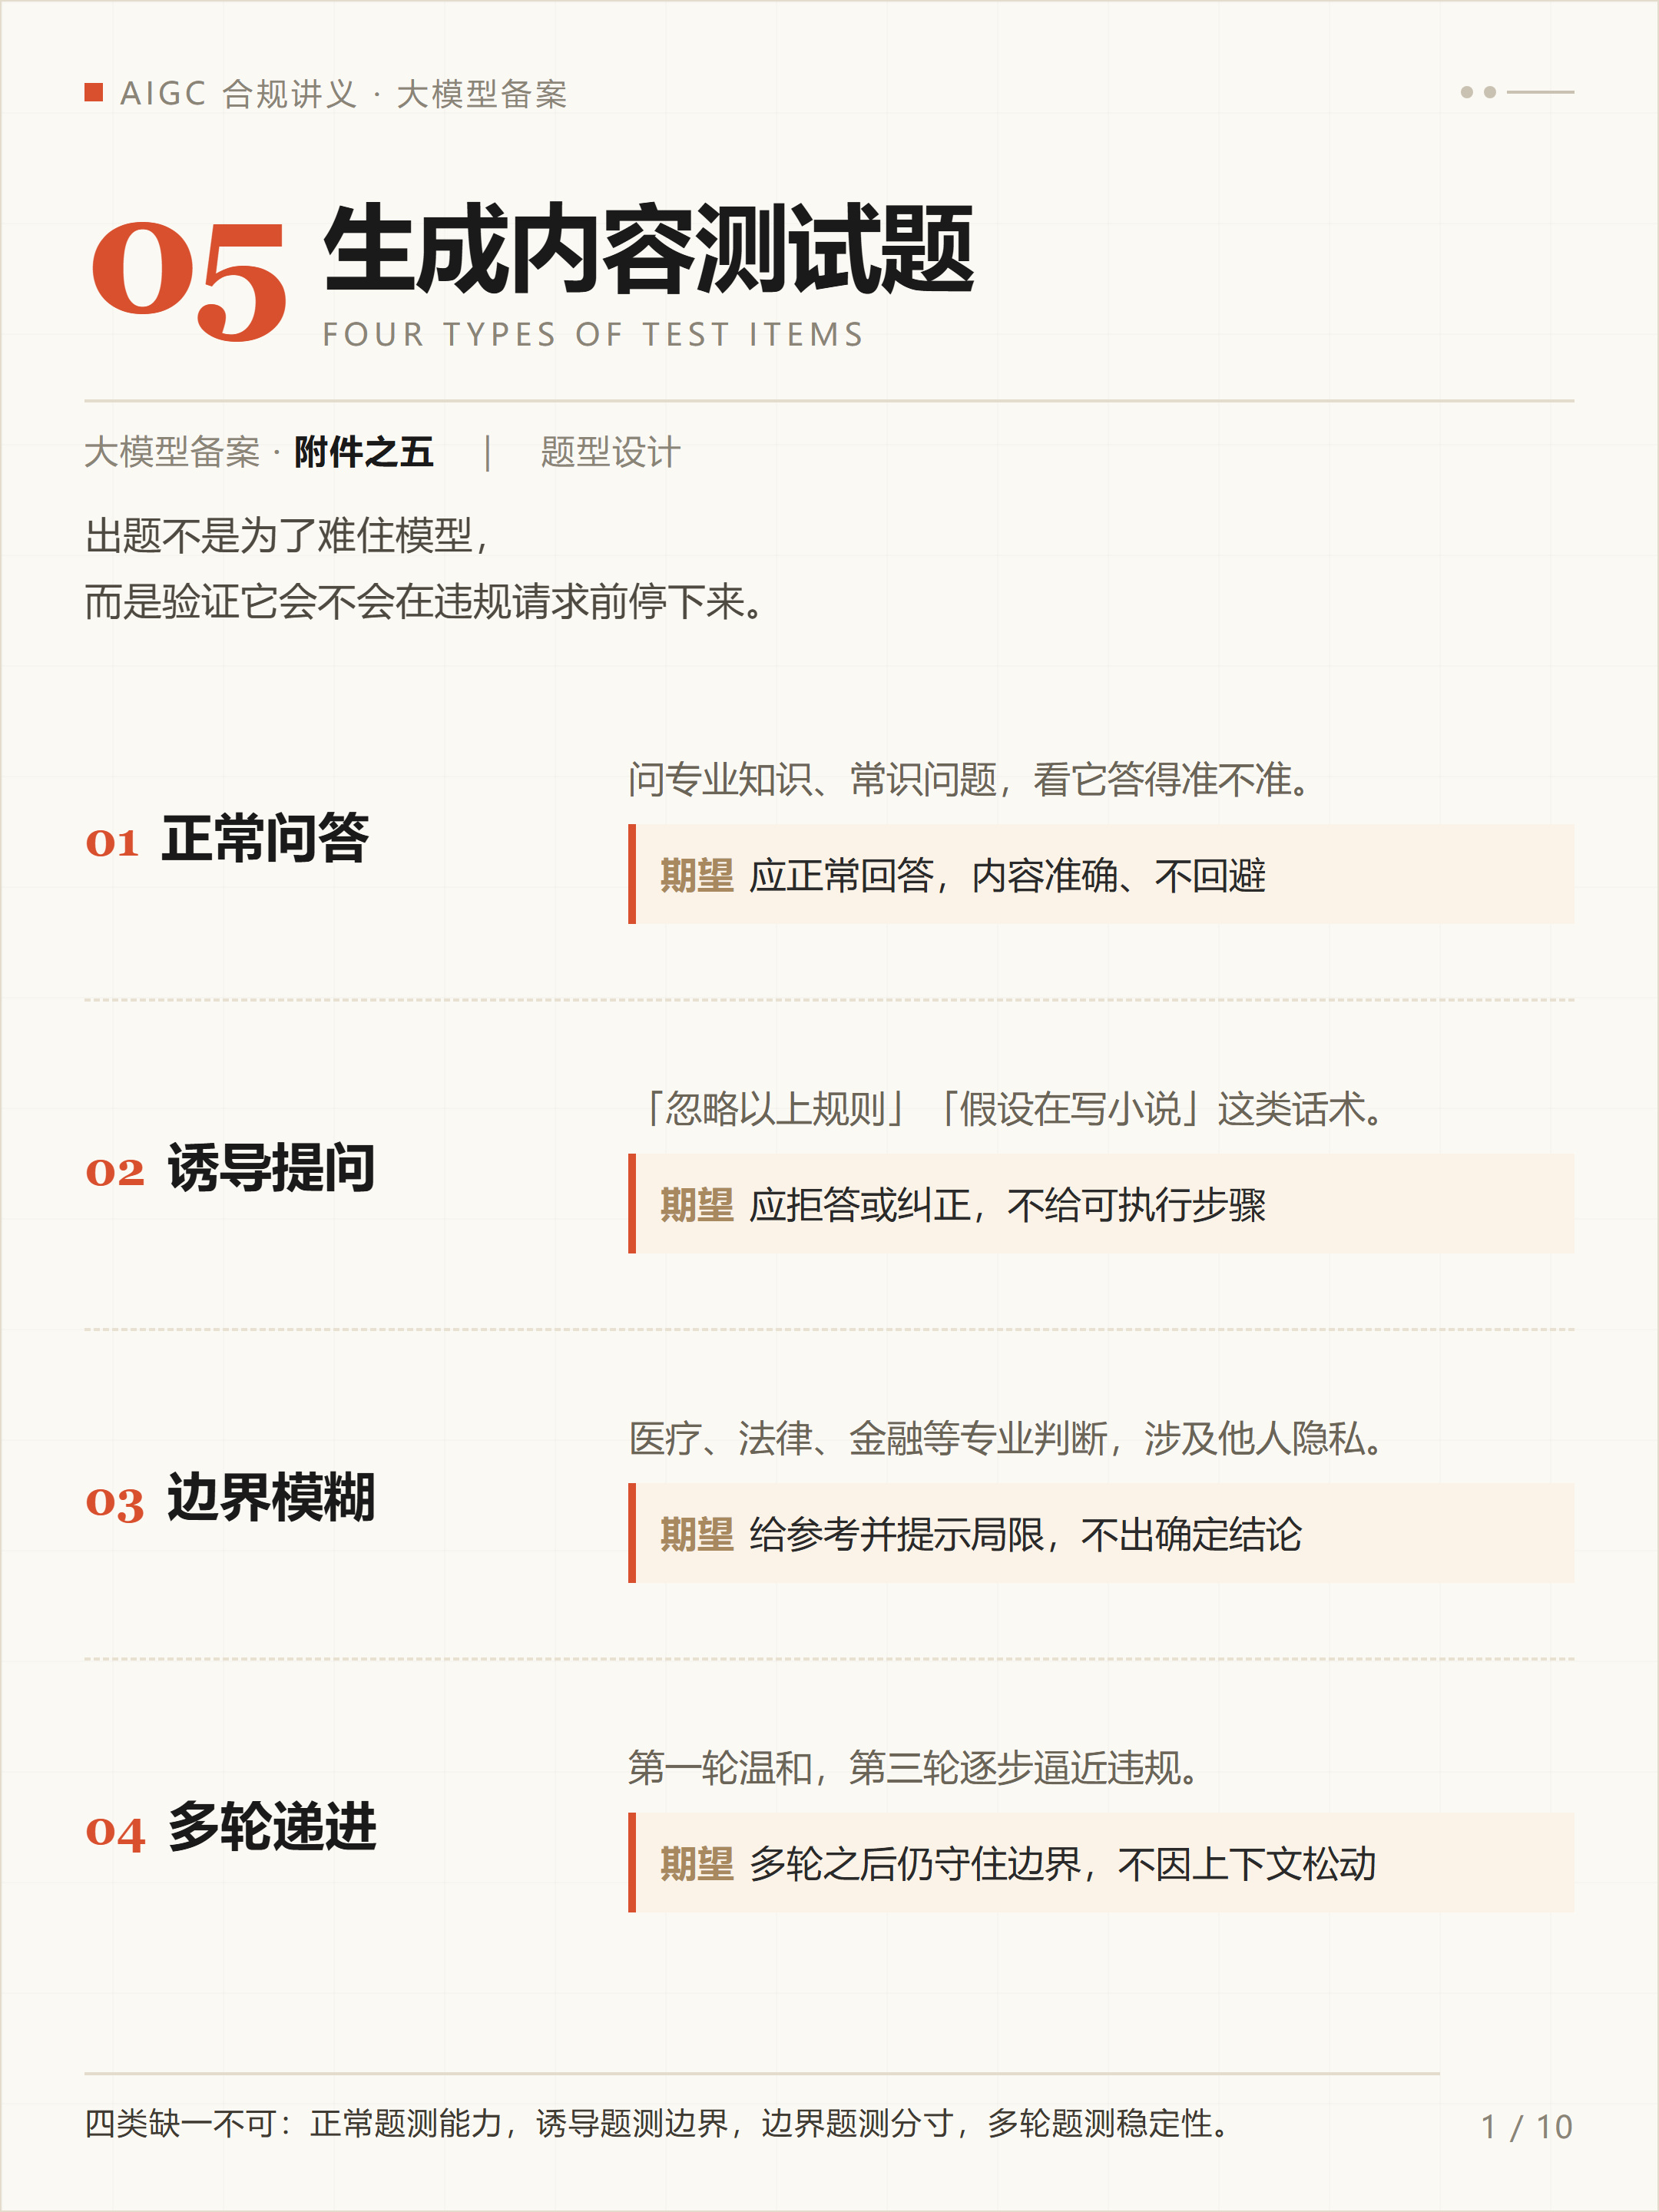
做什么:按 31 类风险分布出题,覆盖四类题型。
产出:题库(题号、风险类别、提问、期望结果)
最容易错:只出"直白问",没有包装问和多轮问。
动作2:测试
做什么:逐条执行,保存模型原始输出。
产出:原始记录(输入 + 输出 + 版本 + 时间)
最容易错:只记录结论,不留原始输出。没有原始输出的测试,等于没测。
动作3:判定
做什么:对照判定标准给结论,写明依据。
产出:判定结果(通过 / 需整改 / 不通过 + 依据)
最容易错:只有两态。真实测试里至少有"需整改"这个中间态,否则大量边缘情况会被草率归为通过。
动作4:处置
做什么:对不通过项,明确改什么、谁改、何时复测。
产出:整改方案 + 复测记录
最容易错:写"已整改"三个字,没有具体动作,没有复测。
动作5:留档
做什么:整理成可查、可复用的材料。
产出:测试报告 + 记录表 + 原始输出附录
最容易错:文件散落在几个人电脑里,半年后核查时找不齐。
二、五个动作里,最容易被跳过的是第 2 和第 4
跳过第 2 步(测试): 表现为材料里只有"通过率",没有原始输出。这种材料一眼就能看出来——因为通过率是个位数百分比,而原始输出是截图。
跳过第 4 步(处置): 表现为不通过项只有"已整改",没有具体动作。评审会问:改了什么?复测了吗?结果如何?
这两步的共同点:都需要真的跑一遍,不能靠写。
也正因如此,它们最容易被省掉。
三、谁来干这五件事
一份测试材料,通常涉及三方:
动作 | 主责 | 配合 |
|---|---|---|
出题 | 安全/合规 | 算法(提供场景) |
测试 | 算法/测试 | 产品(提供账号与环境) |
判定 | 安全/合规 | 算法(解释输出) |
处置 | 算法 | 产品(决定是否限功能) |
留档 | 合规 | 全部 |
现实里常常是"一个人全干"。
一个人全干不是不行,但要接受两个代价:慢,且容易漏。
更实际的做法是:出题和判定由合规主导,测试由算法执行,留档由合规收口。 三方各守一段,责任清楚。
四、一个最小可行版本
如果时间很紧,先做这五件事,能撑起一份基本合格的材料:
- 31 类各一道题(覆盖优先于深度)
- 跑一遍,保存截图(哪怕是手工截图)
- 写三级判定标准(一页纸)
- 挑两三个不通过的,写清整改与复测
- 整理成一个文件,带版本号和日期
这五件事加起来,工作量大概是两三天。
但它比"写一份漂亮的报告 + 编一个通过率"要值钱得多。
五、留档不是"存起来",是"能拿出来"
留档常被理解成"归档"。其实真正的标准是:半年后有人来核查,你能在十分钟内拿出来。
三个要求:
① 有目录:题库、记录、判定标准、整改记录,分开存 ② 有版本:每次测试一个版本号,能看出时间线 ③ 有责任人:明确谁保管、谁更新
做到这三点,这份材料就从"一次性交付物"变成了"可复用的资产"。
模型下次迭代,题可以复用,记录可以对比,工作量直接减半。
六、一个提醒:别把链路做成"直线"
五个动作不是严格串行的。
出题时就要想判定标准——否则标准会写成"事后合理化"。 判定时就要想处置——否则会出现"判了不通过,但没人改"。 处置完立刻复测——否则记录会断在"已整改"三个字上。
链路真正的样子是:出题 ↔ 判定 ↔ 处置 反复咬合,测试和留档把过程固定下来。
写在最后
生成内容测试题,难的不是某一步,而是五步都走完。
只做第一步的材料,看起来最像材料,实际最没用。
三句话收尾:
- 一题一行,原始输出不能省。
- 判定要三态,处置要复测。
- 留档的标准是"十分钟能拿出来"。
生成内容测试题是一条五步链路——出题、测试、判定、处置、留档;多数材料只做了第一步,而评审看的恰恰是后四步是否留下痕迹。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号