Kafka 为什么快?sendfile 到底省掉了哪几次拷贝
原创
Kafka 为什么快?sendfile 到底省掉了哪几次拷贝
原创
leikooo
发布于 2026-11-19 14:09:50
发布于 2026-11-19 14:09:50
大家多少都和「把文件发出去」这件事打过交道:
- 用过 Kafka 的都知道它快,一台 Broker 同时喂好几个消费组,CPU 还不怎么高;
- Nginx 配置里几乎都有一行
sendfile on;,很多人照抄,却不知道它开了什么; - Java 的
FileChannel有个transferTo方法,面试题里常和「零拷贝」一起出现。
这三件事说的其实是同一个东西:零拷贝。可真要问起来,大家可能也说不太清:它到底是什么(what)?sendfile 怎么做到少拷贝的,省掉的是哪几次(how)?Kafka 为什么要这么设计,别的办法为什么不行(why)?这篇文章就顺着这三个问题,一次讲清楚。
发一个文件,数据到底被搬了几次
先从最朴素的写法看起。用 Java 把一个文件发到 socket,大家第一反应大概是这样:
byte[] buf = new byte[64 * 1024];
int n;
while ((n = in.read(buf)) > 0) {
    out.write(buf, 0, n);
}
代码只有两行,但数据在机器里走的路比看起来长得多。Kafka 官方设计文档把这条路拆成了四步:
The operating system reads data from the disk into pagecache in kernel space The application reads the data from kernel space into a user-space buffer The application writes the data back into kernel space into a socket buffer The operating system copies the data from the socket buffer to the NIC buffer where it is sent over the network
翻成大白话:
- 磁盘 → Page Cache:内核把文件读进内存里的页缓存。这一步由 DMA 完成,也就是硬件自己搬,不占 CPU;
- Page Cache → 用户缓冲区:
read()返回之前,CPU 把数据复制到大家的byte[] buf里; - 用户缓冲区 → Socket 缓冲区:
write()里,CPU 再把同一份数据复制回内核; - Socket 缓冲区 → 网卡:再由 DMA 把数据交给网卡发出去。
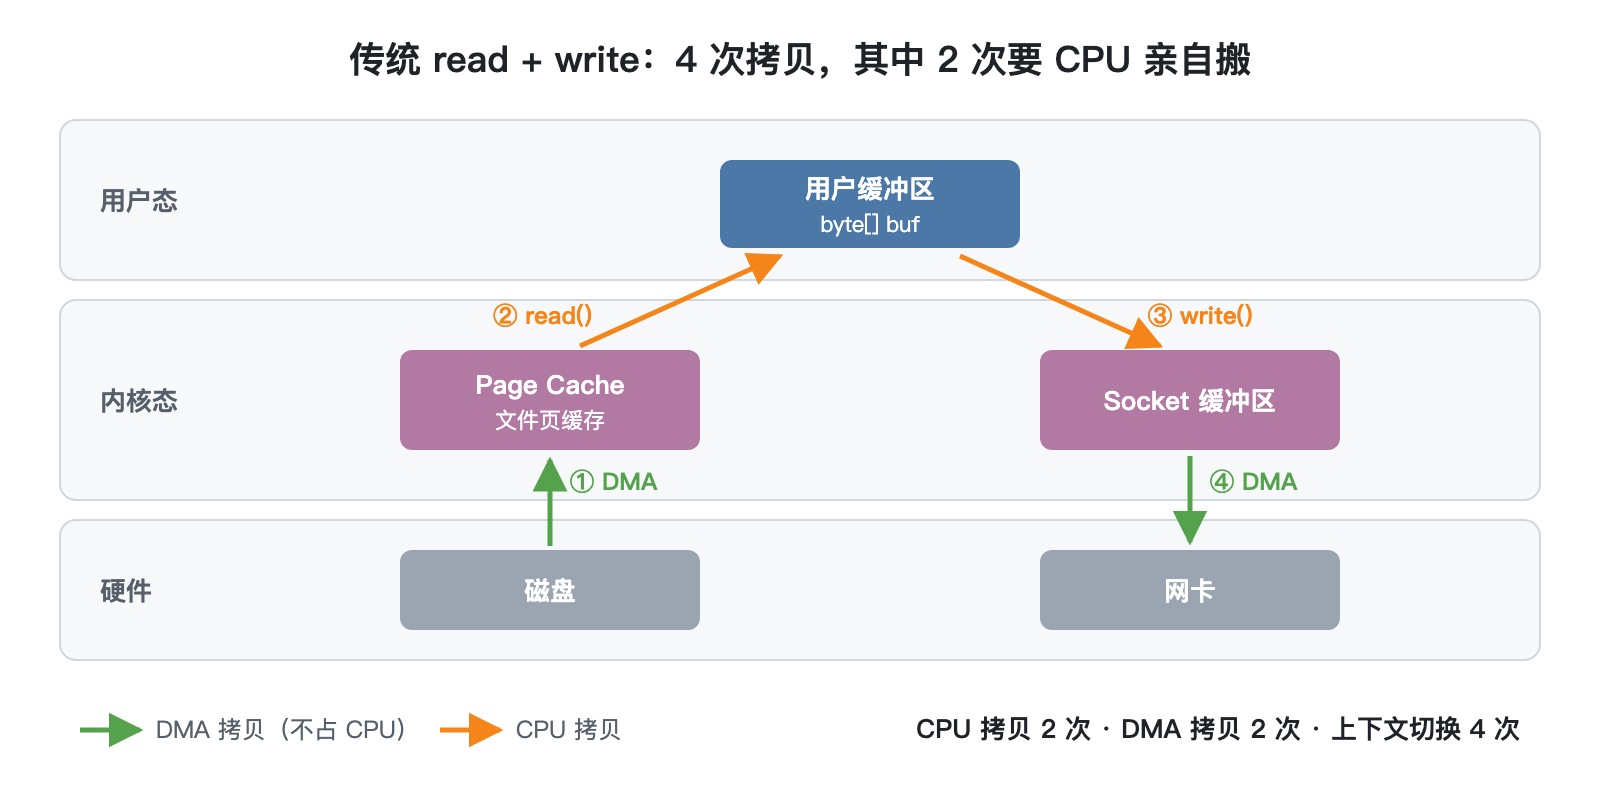
传统 read + write:4 次拷贝,其中 2 次要 CPU 亲自搬
一共 4 次拷贝,其中 2 次是 CPU 亲自搬的。另外,每次 read() 和 write() 都要从用户态切到内核态、再切回来,一来一回是 2 次上下文切换,两个调用加起来就是 4 次。
这就像寄快递:包裹从仓库运到柜台,柜台的店员(CPU)把它搬到自己桌上看一眼,什么都没改,又原样搬回柜台,最后才装上货车。中间那两趟「搬过来、搬回去」纯属白干。
这两趟白干的代价有多大? 拿发送 1 GiB 文件、64 KiB 缓冲区来算:
read()要调 1 GiB ÷ 64 KiB =16384次,write()也是16384次,一共32768次系统调用、65536次上下文切换;- CPU 一共要搬 2 GiB 的数据:读进来 1 GiB,再写出去 1 GiB。
而程序自始至终连一个字节都没看过。
sendfile 省掉了哪几次拷贝
先说零拷贝是什么:零拷贝指的是不让 CPU 在内存里来回复制数据的一类技术。这里的「零」说的是 CPU 拷贝为零,DMA 拷贝还是有的,数据总得从磁盘进内存、再从内存到网卡。
从传统写法到真正的零拷贝,Linux 上一路有三种优化,每种都比前一种少搬一点。
第一步:mmap + write,省掉一次 CPU 拷贝。 mmap 把文件直接映射进进程的地址空间,用户态看到的那块内存和 Page Cache 是同一块物理页,所以「读进用户缓冲区」那次复制就没有了。但 write() 时,内核还是要把数据从 Page Cache 复制到 Socket 缓冲区。
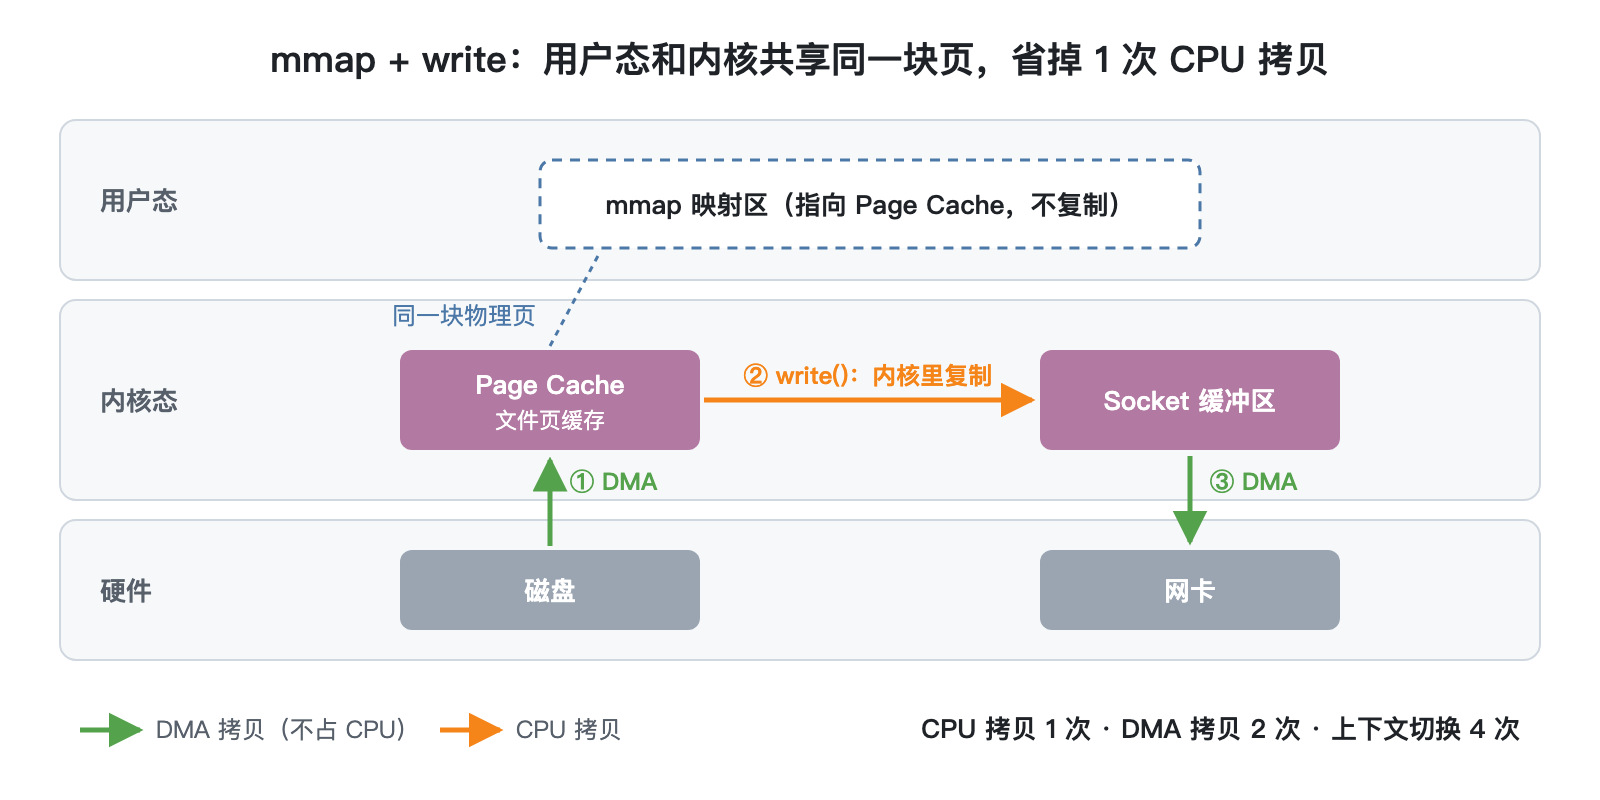
mmap + write:用户态和内核共享同一块页,省掉 1 次 CPU 拷贝
拷贝变成 3 次,可上下文切换还是 4 次:mmap 一次,write 一次。
第二步:sendfile,数据彻底不进用户态。 sendfile(out_fd, in_fd, offset, count) 的意思是:「内核,请把这个文件的这一段,直接发到那个 socket」。程序只下一条指令,数据从 Page Cache 直接在内核里复制到 Socket 缓冲区,用户缓冲区整个被绕开了。
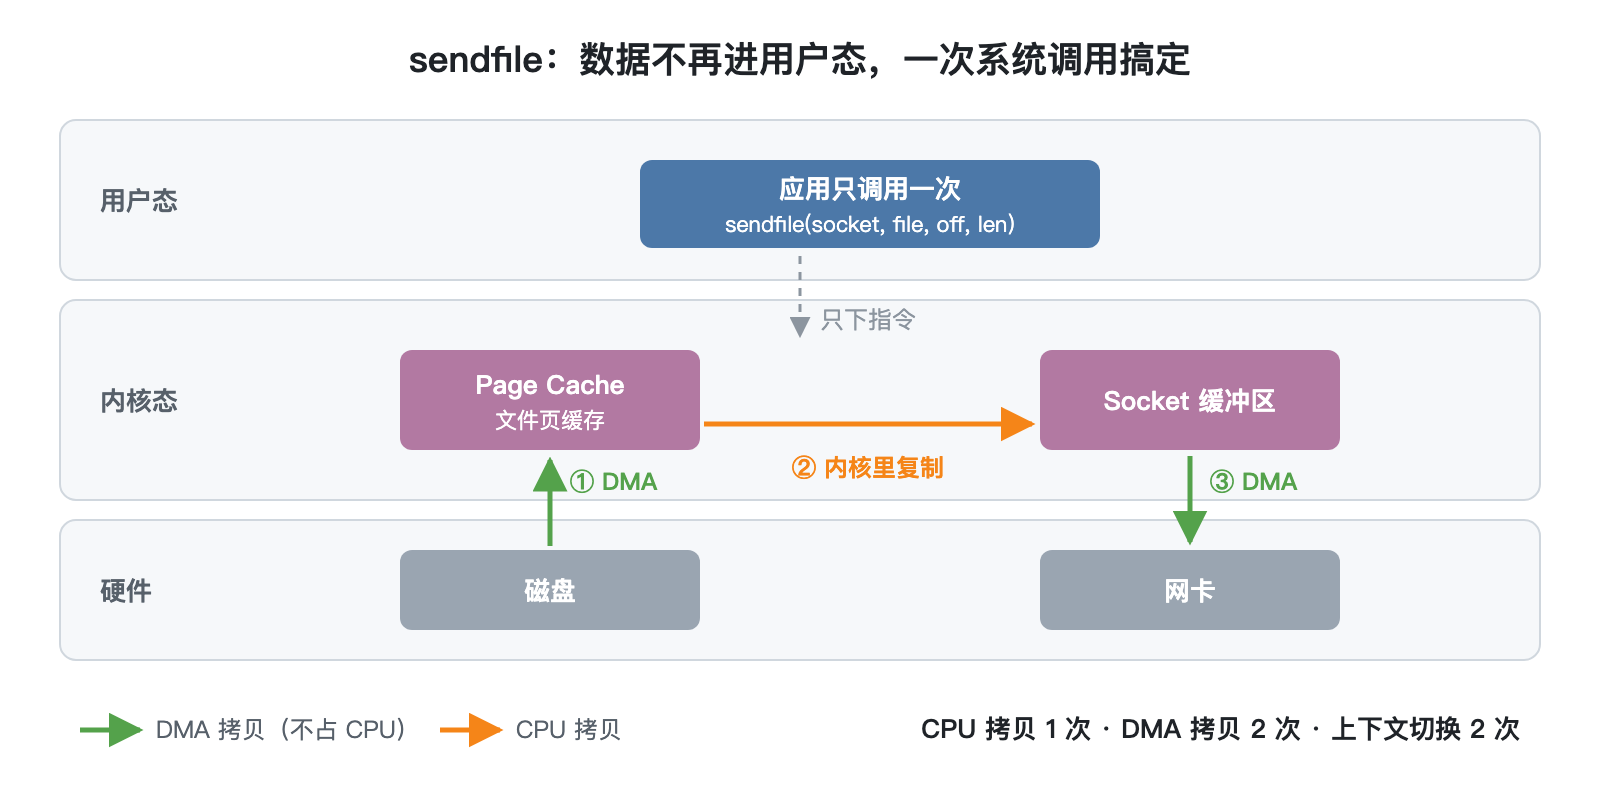
sendfile:数据不再进用户态,一次系统调用搞定
拷贝还是 3 次,但系统调用只剩 1 次,上下文切换从 4 次降到 2 次。而且一次调用能发的量很大:Linux 上单次 sendfile 最多发 0x7ffff000 也就是 2147479552 字节,比 1 GiB(1073741824 字节)还多。前面要 32768 次系统调用的活,现在 1 次就够了。
第三步:sendfile + SG-DMA,CPU 拷贝归零。 如果网卡支持 scatter-gather DMA(分散 / 聚集 DMA,现代服务器网卡基本都支持),内核连 Page Cache 到 Socket 缓冲区的那一次复制也省了:Socket 缓冲区里只放一个描述符,记着「数据在哪个地址、有多长」,网卡的 DMA 引擎按描述符直接去 Page Cache 里把数据取走。
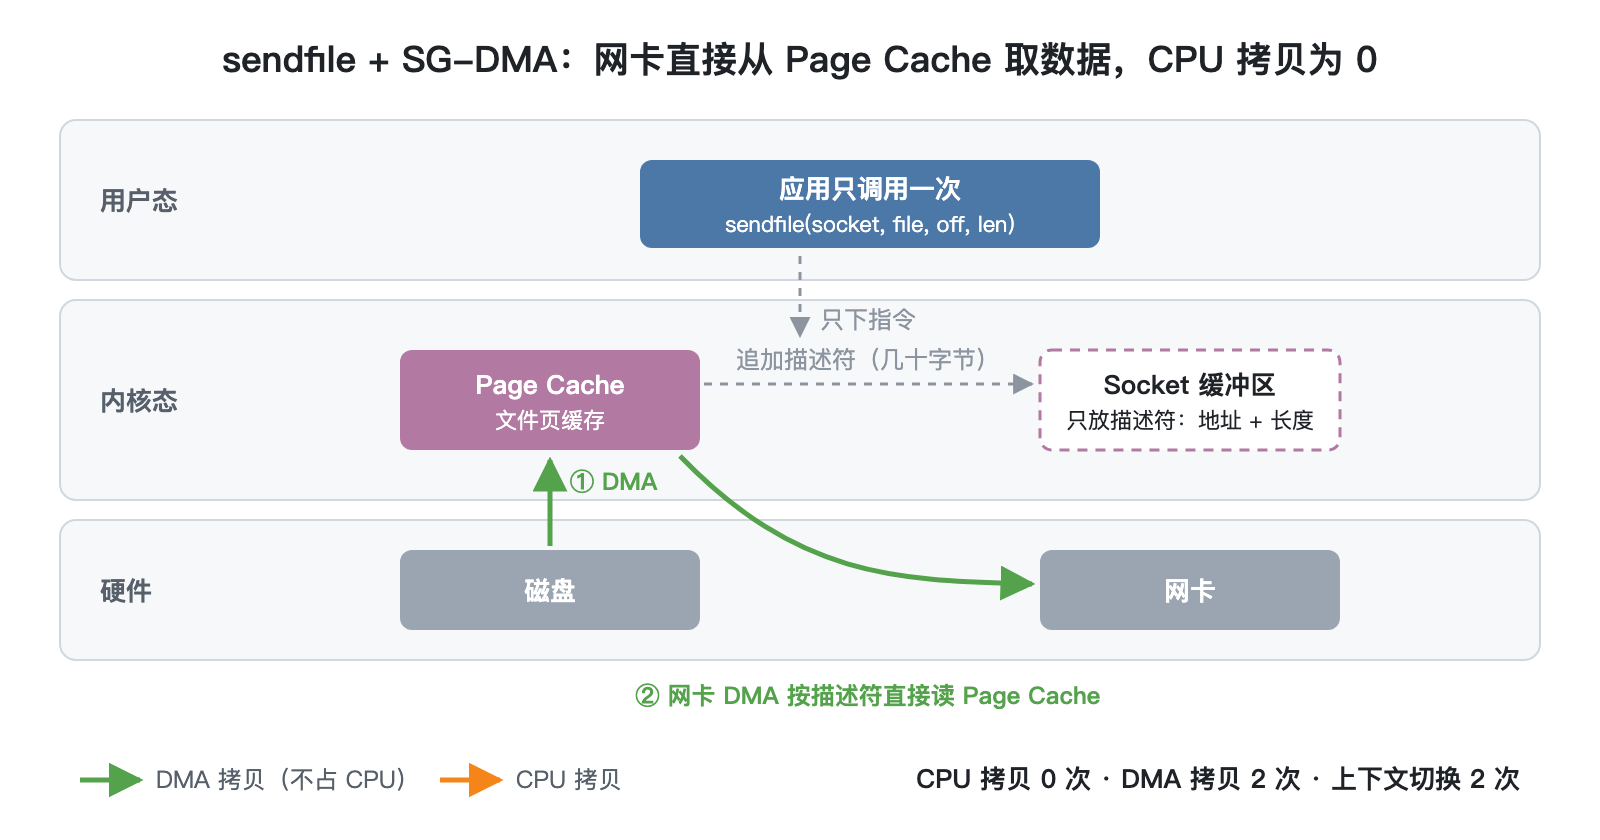
sendfile + SG-DMA:网卡直接从 Page Cache 取数据,CPU 拷贝为 0
到这一步,CPU 一个字节都没碰,这才是严格意义上的零拷贝。四种方式放在一起:
| 方式 | CPU 拷贝 | DMA 拷贝 | 上下文切换(每轮) | 系统调用(发 1 GiB) |
| -------------------------- | -------- | -------- | ------------------ | -------------------- |
| read + write(64 KiB) | 2 | 2 | 4 | 32768 |
| mmap + write | 1 | 2 | 4 | 2 |
| sendfile | 1 | 2 | 2 | 1 |
| sendfile + SG-DMA | 0 | 2 | 2 | 1 |
回到标题的问题:sendfile 省掉的,是进出用户态的那两次 CPU 拷贝(第 2、3 步);配合 SG-DMA,连内核里剩下的那一次 CPU 拷贝也省了。剩下的两次 DMA 拷贝是硬件在干活,省不掉,也不需要省。
Java 里不用直接调 sendfile,FileChannel.transferTo(position, count, target) 在 Linux 上底层就是它。
Kafka 是怎么用上它的
Kafka 的设计文档讲完上面那四步之后,紧接着说:
This is clearly inefficient, there are four copies and two system calls. Using sendfile, this re-copying is avoided by allowing the OS to send the data from pagecache to the network directly.
这里的「four copies and two system calls」,就是第一节那张图里的 4 次拷贝和 read、write 两个系统调用。Broker 把消息发给消费者时,走的就是 FileChannel.transferTo,也就是 sendfile。
为什么 Kafka 能直接用 sendfile? 因为它在设计上就为此做了一个关键决定:生产者发来什么格式,磁盘上就存什么格式,发给消费者还是这个格式。文档原话是:
The message log maintained by the broker is itself just a directory of files, each populated by a sequence of message sets that have been written to disk in the same format used by the producer and consumer.
格式三方一致,Broker 发数据时就不需要「读出来、改一改、再写出去」,直接把文件的某一段原样交给网卡就行,这正是 sendfile 擅长的事。
压缩也是同一个思路。生产者把一批消息压在一起发过来,Broker 会解压一遍做校验(比如核对批次里的条数和头部写的是否一致),但存盘时还是压缩形态,发给消费者时也是压缩形态,解压留给消费者自己做。如果 Broker 每次发送前都解压、改格式、再压缩,sendfile 就用不上了。
多个消费组读同一份数据时,零拷贝的收益会成倍放大。 文档里写:
Using the zero-copy optimization above, data is copied into pagecache exactly once and reused on each consumption instead of being stored in memory and copied out to user-space every time it is read.
数据只进一次 Page Cache,A、B、C 三个消费组各自 transferTo,都直接从这同一份 Page Cache 发出去。
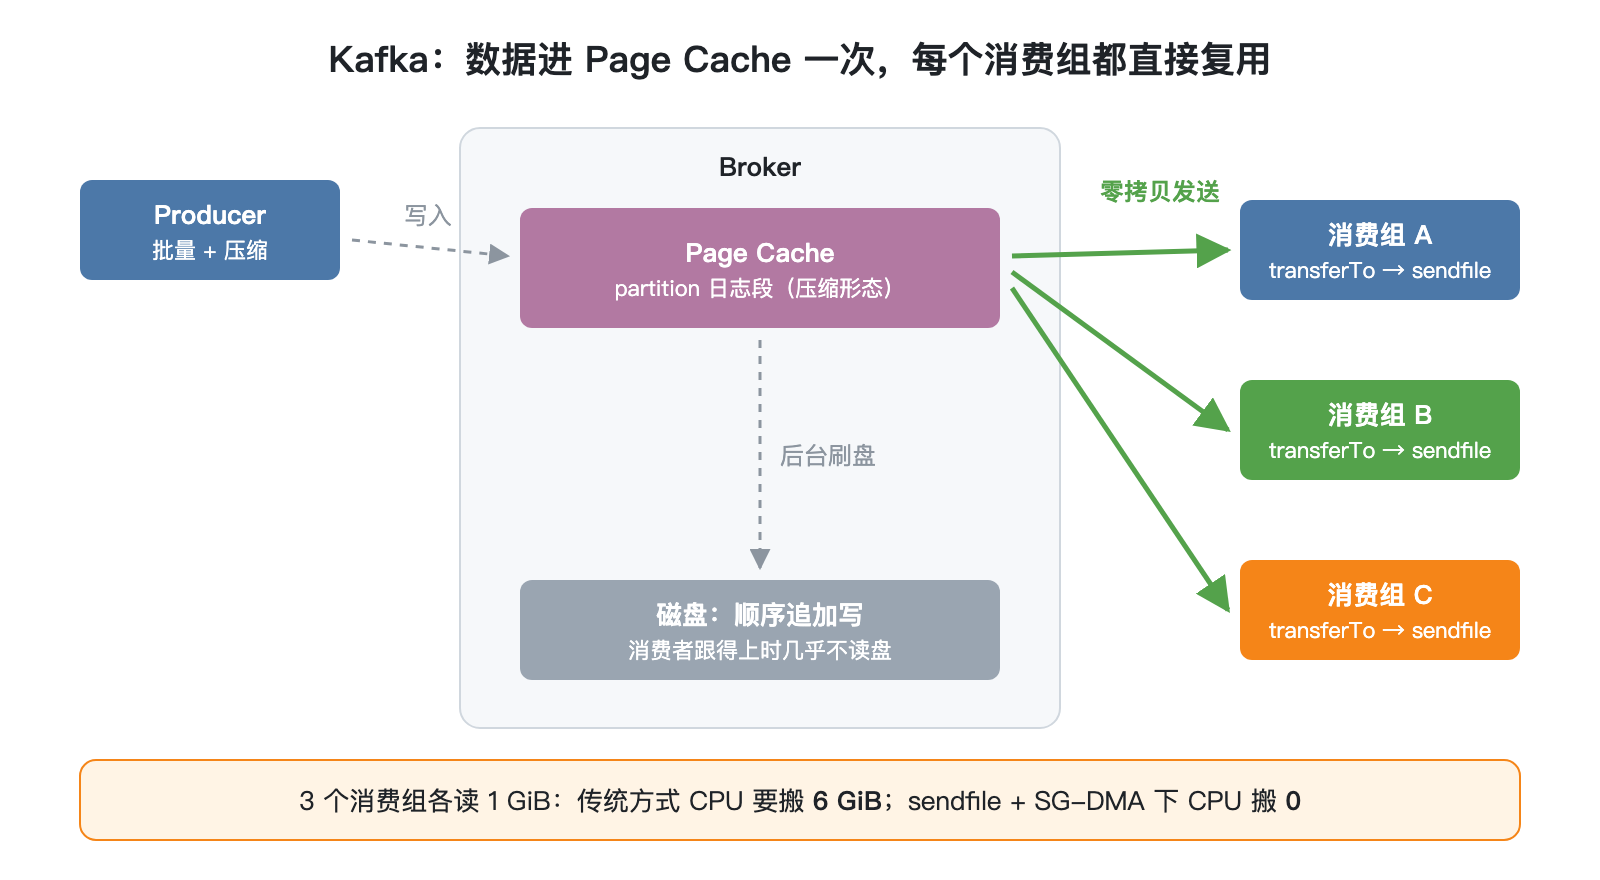
Kafka:数据进 Page Cache 一次,每个消费组都直接复用
算笔账:3 个消费组各读 1 GiB,用传统写法 CPU 要搬 3 × 2 = 6 GiB;用 sendfile + SG-DMA,CPU 搬 0 字节。
再加上 Kafka 刚写入的数据本来就在 Page Cache 里,文档里还有一句很「嚣张」的话:
This combination of pagecache and sendfile means that on a Kafka cluster where the consumers are mostly caught up you will see no read activity on the disks whatsoever as they will be serving data entirely from cache.
只要消费者跟得上,磁盘几乎完全没有读请求,数据从写进来到发出去,全程都在内存里流转。
为什么是零拷贝
前面讲的是「怎么做」,现在退一步想:Kafka 这种场景,我们真正想要的是什么?
是转发。Broker 收到一批字节,存起来,再原样发给若干个消费者。它从头到尾不需要看懂这些字节,更不需要修改。所以理想情况是:数据从磁盘(或 Page Cache)到网卡,路上谁都别碰它。
带着这个目标,把能想到的办法逐个过一遍:
- 办法一:加大缓冲区。 把 64 KiB 改成 1 MiB,系统调用从
32768次降到2048次(1 GiB ÷ 1 MiB =1024次read加1024次write)。可 CPU 还是要搬 2 GiB,拷贝次数一次没少,只是换成了大块搬运。 - 办法二:mmap + write。 省掉了一次 CPU 拷贝,但还剩一次,上下文切换还是 4 次。更麻烦的是,文件被映射期间如果被别的进程截断,访问到已经不存在的页时进程会收到
SIGBUS信号直接崩溃。Kafka 的日志会被定期删除、截断,这个坑很难完全避开。 - 办法三:O_DIRECT 绕过 Page Cache。 数据直接在磁盘和用户缓冲区之间走,看起来少了一层。但这样就没有缓存了,3 个消费组读同一份数据,磁盘就得读 3 遍,前面「磁盘几乎没有读请求」的效果也就没了。
- 办法四:DPDK 这类用户态网络栈。 干脆不走内核协议栈,网卡直接交给用户态程序。确实快,但要独占网卡、专门留几个 CPU 核一直轮询,部署和运维成本都很高,对一个通用的消息队列来说太重了。
几个办法摆在一起,问题就清楚了:它们要么还是要 CPU 搬数据,要么丢掉了 Page Cache,要么代价太大。sendfile 同时做到了两点:
- 数据不经过用户态,CPU 不再逐字节复制;
- 数据仍然走 Page Cache,写进来的热数据、多个消费者都能复用同一份缓存。
它的精髓可以压成一句话:程序只下指令,不搬数据。程序只告诉内核「把这个文件的这一段发到那个 socket」,搬运交给内核和 DMA 去做。
这样做到底能快多少? 在本机实际跑了一下:通过 127.0.0.1 发送一个 1 GiB 的文件,每种方式预热 1 轮后跑 5 轮,取中位数。
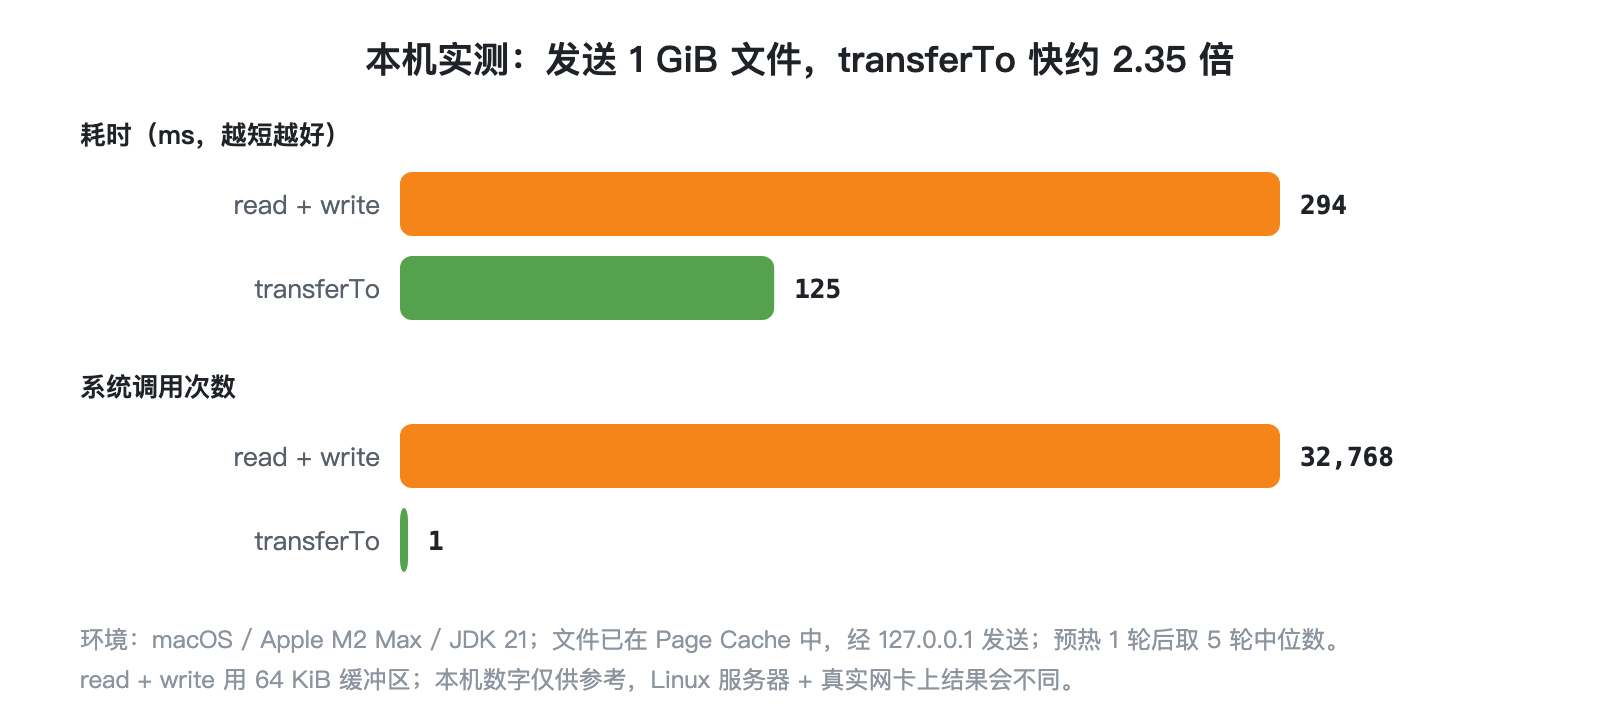
本机实测:发送 1 GiB 文件,transferTo 快约 2.35 倍
| | read + write(64 KiB) | transferTo |
| ----------------- | -------------------------- | ------------------------ |
| 耗时 | 294 ms(约 3.4 GiB/s) | 125 ms(约 8.0 GiB/s) |
| 发送线程 CPU 时间 | 291 ms | 124 ms |
| 系统调用次数 | 32768 | 1 |
transferTo 快了约 2.35 倍,CPU 时间也省了一半多。要注意这是 macOS + loopback 的结果:本机回环没有真正的网卡,内核还是要把数据复制给接收端,所以 transferTo 的 CPU 时间不是 0。换成 Linux 服务器加支持 SG-DMA 的真实网卡,CPU 节省会更明显,具体数字以实际环境为准。
零拷贝有什么代价? 「只下指令,不搬数据」反过来说,就是程序没机会碰数据。一旦需要修改数据,零拷贝就用不上了。最典型的例子是 TLS 加密:加密必须逐字节处理数据,而 TLS 库都在用户态。Kafka 文档写得很直白:
TLS/SSL libraries operate at the user space (in-kernel
SSL_sendfileis currently not supported by Kafka). Due to this restriction,sendfileis not used when SSL is enabled.
所以 Kafka 开了 SSL 之后,会退回普通的读写路径,吞吐也会跟着掉。Linux 后来有了 kTLS,把加密挪进内核,就是为了让加密和 sendfile 能一起用。同样的道理,Kafka 坚持「Broker 不改消息格式」,也是在给零拷贝让路:哪天 Broker 需要逐条改写消息,这条快速路径就断了。
回到开头
三个问题,各用一句话回答:
- 零拷贝是什么:不让 CPU 在内存里来回复制数据,数据只在磁盘、Page Cache、网卡之间由 DMA 搬运;
- sendfile 怎么省:省掉了进出用户态的两次 CPU 拷贝,把
32768次系统调用压成1次;配合 SG-DMA,连内核里的最后一次 CPU 拷贝也省了; - 为什么这么设计:Broker 只负责转发,不需要看数据,所以最好的办法就是程序只下指令,不搬数据,同时保留 Page Cache 给所有消费者共用。
所以下次再看到 Kafka 一台 Broker 喂好几个消费组、CPU 却不怎么高,或者在 Nginx 配置里看到那行 sendfile on;,大家就知道了:快,不是因为搬得更快,而是因为根本没搬 🚚
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号