DolphinDB 工业IoT指标计算实战:同比、环比与日历对齐
原创
DolphinDB 工业IoT指标计算实战:同比、环比与日历对齐
原创
Xxtaoaooo
发布于 2026-11-19 22:34:17
发布于 2026-11-19 22:34:17
摘要
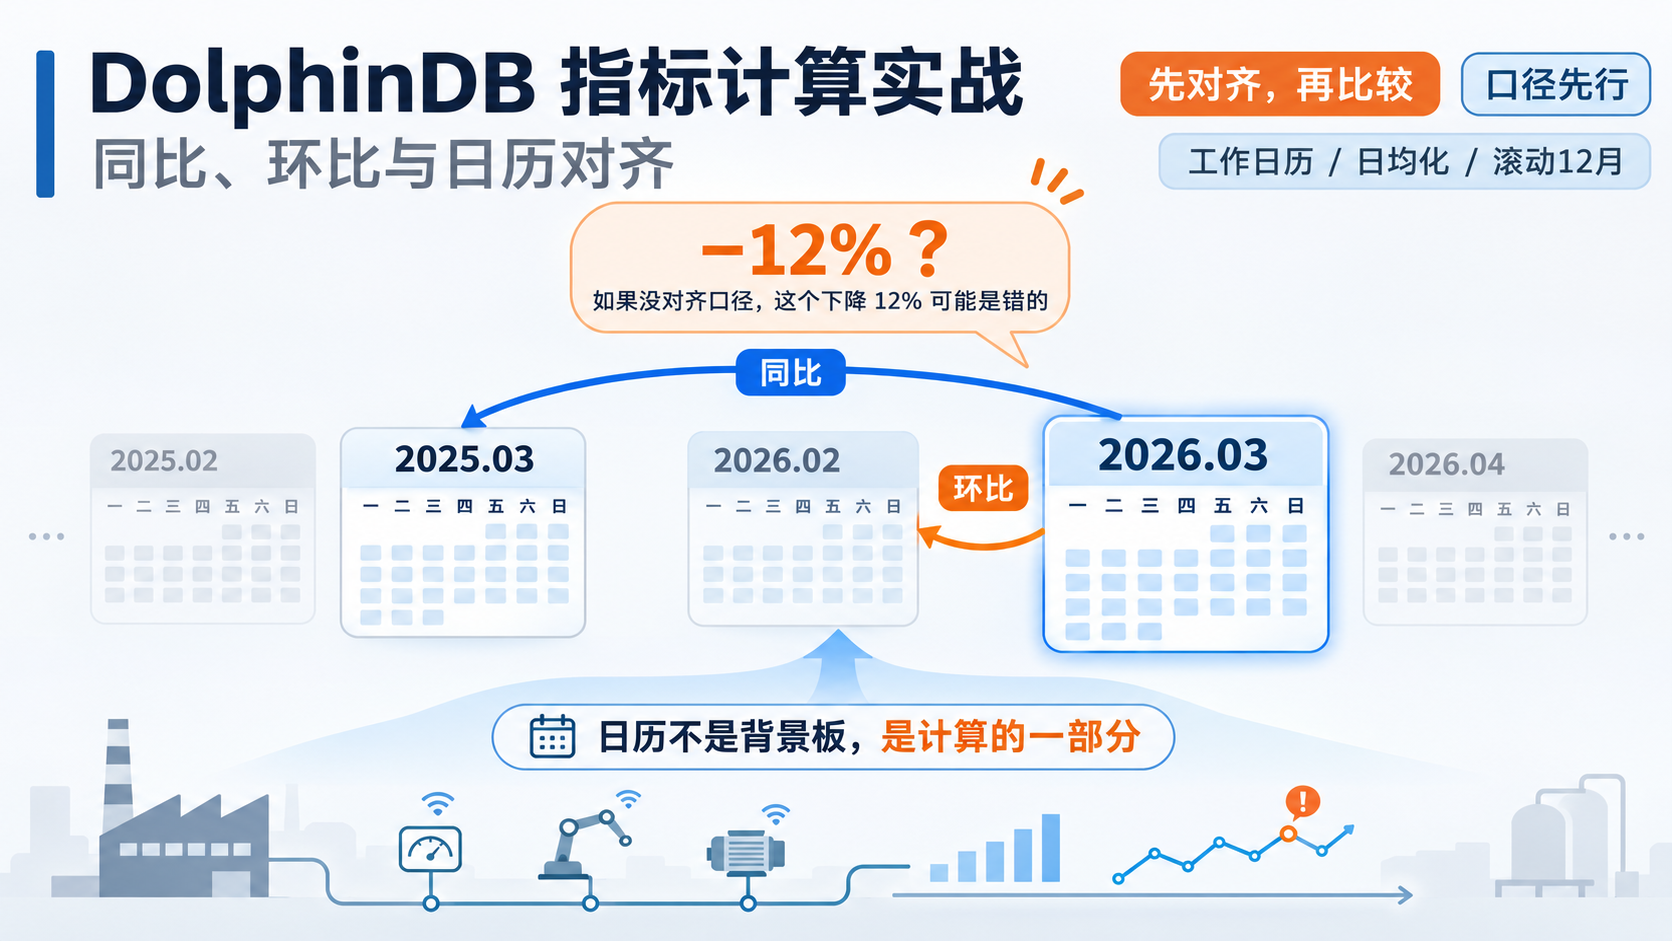
每个 IoT 数据平台的看板,都会经历同一个阶段:第一年画曲线——设备状态、告警量、能耗趋势,都是"当前怎么样";第二年开始被问"和过去比怎么样"——上月能耗同比下降了多少?今年累计产量比去年同期好还是差?告警量环比降了吗?
这些问题看起来是小学算术:拿两个月的数据一减一除。但真写起来会发现,算错的途径有一打:闰年二月比平年少一天、二月和三月的天数天生不等、春节今年在一月去年在二月、滚动窗口的起点每天在变……每个坑都能让"下降 12%"变成一句错话。
问题的根源是一个容易被忽略的事实:日历不是报表的背景板,是计算的一部分。"去年同期"不是一个固定的偏移量,它取决于你怎么定义"同一位置"——同一个月?同样的天数?同一周序号?还是同样的工作日数?每种定义都有它的适用场景,也都对应不同的 SQL。
本文把指标计算里的时间比较拆开讲透:环比(相邻期比较)、同比(四种对齐策略)、滚动窗口(YTD 与滚动 12 月)、工作日历表(把"哪天算工作日"变成数据),每个都给出能直接用的 SQL 和踩坑提示。核心主张一句:口径先行——先说清楚比较的是什么,再动手写查询。
一、为什么时间比较这么容易算错
1.1 三个经典翻车
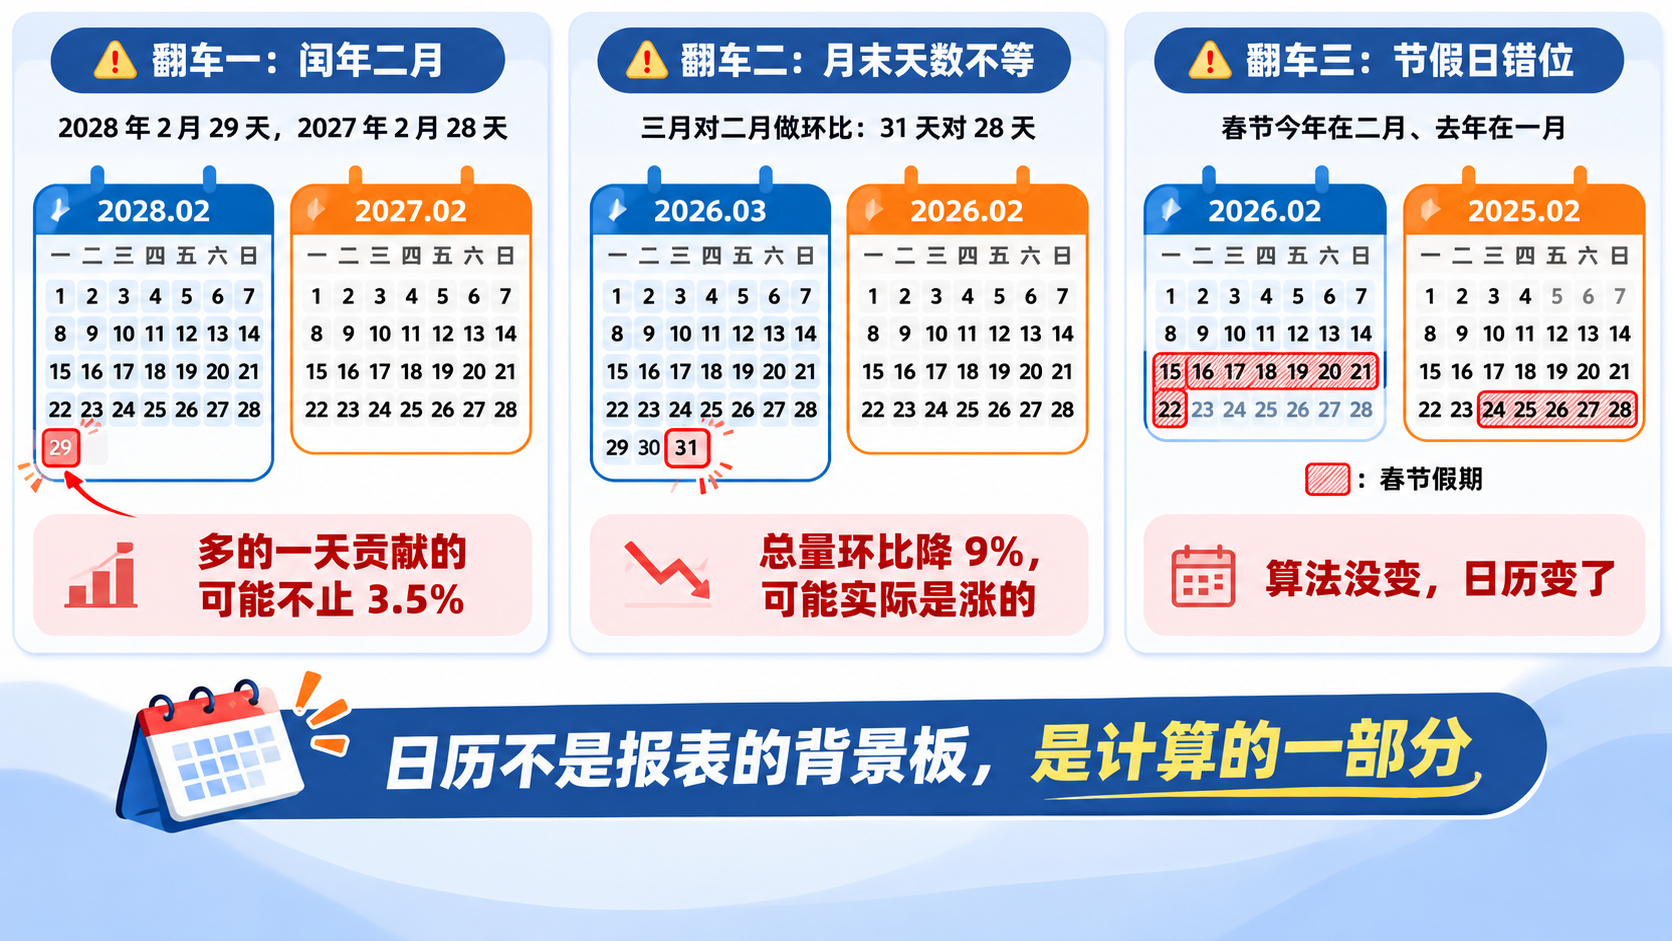
翻车一:闰年二月
2028 年 2 月 29 天,2027 年 2 月 28 天。"今年二月能耗比去年同期高 3.5%"——多出来那一天贡献的可能就不止 3.5%。直接比总量,比的其实是"29 天 vs 28 天"。
翻车二:月末天数不等
三月对二月做环比:31 天对 28 天,总量天然要低 10%。环比降了 9% 可能实际 是涨的。
翻车三:节假日错位
春节今年在二月、去年在一月。二月的产量同比暴跌 40%,不是业务出了问题,是整个长假挪了位置。同比算法没变,日历变了。
1.2 口径先行:两种"可比"的定义
所有翻车的解药都是同一件事:先定义口径,再写 SQL。时间比较的口径分两派:
口径派别 | 含义 | 适用 |
|---|---|---|
同一日历位置 | 去年同月、上季度同周 | 经营汇报("2 月比去年 2 月") |
同样长度/结构 | 日均化、工作日对齐 | 运营归因("每天平均表现如何") |
两派没有对错,只有适用场景。口径写在指标定义里,不藏在 SQL 里——这是全文的第一纪律,后面每一种算法都会回到它。
二、环比:相邻期的比较
2.1 用整数月键做自连接
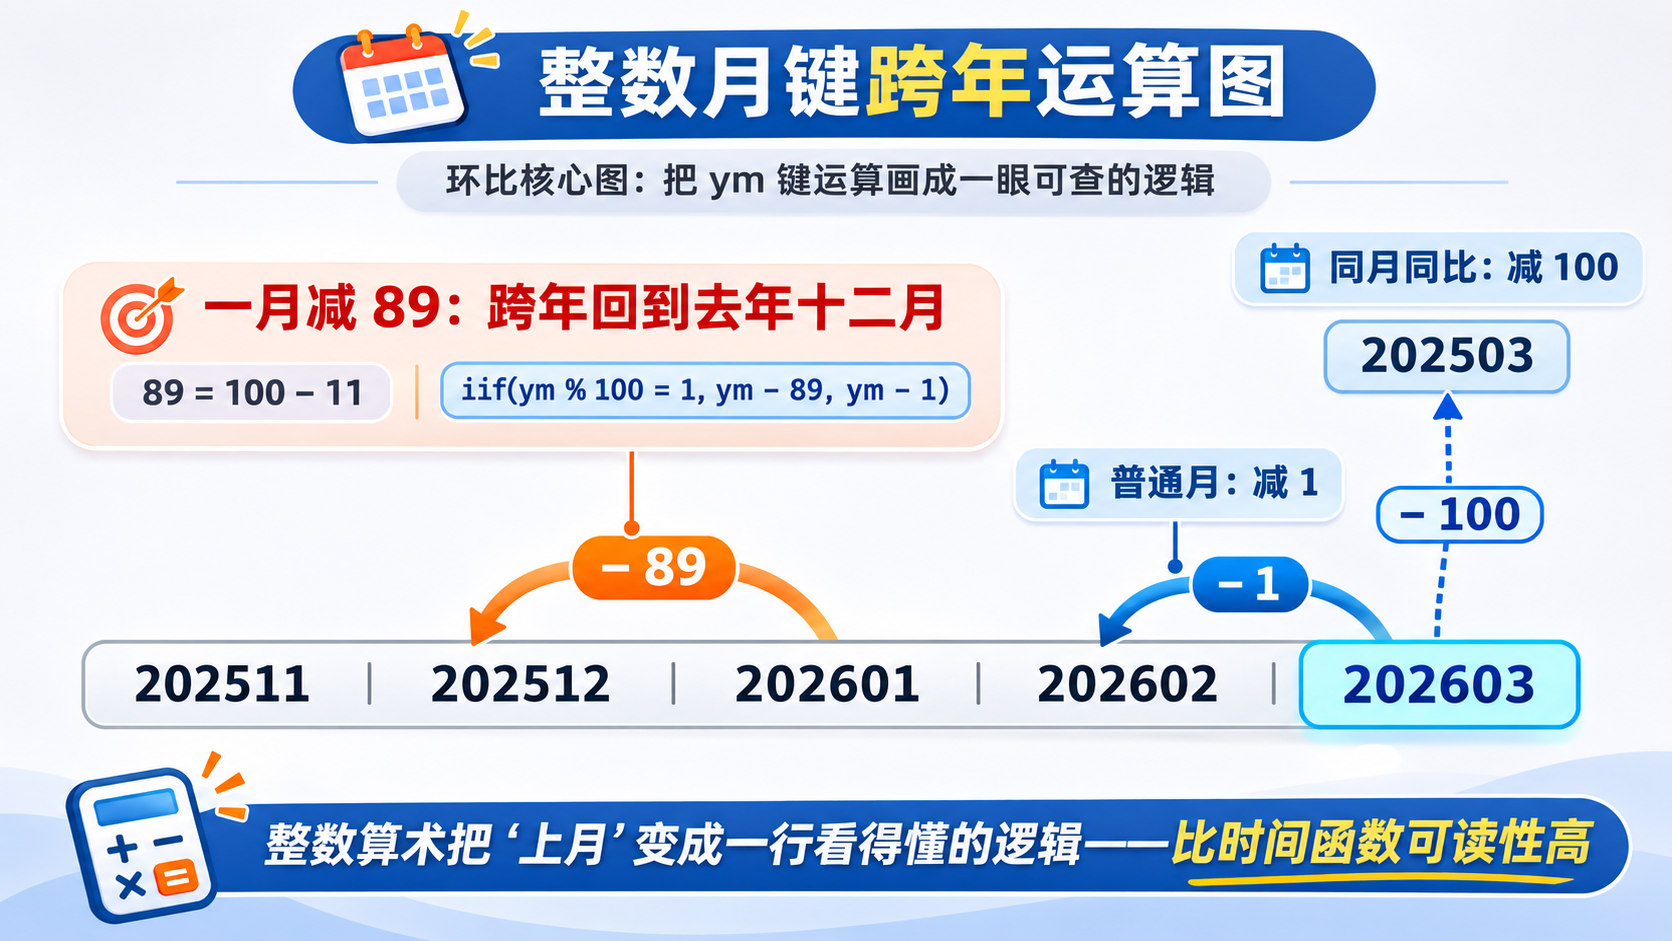
环比的实现要点是"上月"的键怎么算。推荐用整数月键(yyyymm)——算术透明,跨年一目了然:
// 第一步:日数据聚成月度表(任何指标都先落到这张粒度上)
monthly = select
    int(year(ts) * 100 + month(ts))     as ym,       // 2026.03 → 202603
    count(distinct date(ts))            as days,
    sum(value)                          as total
from loadTable("dfs://iot", "metricDaily")
group by int(year(ts) * 100 + month(ts))

// 第二步:环比自连接——"上月键"用整数算术
select
    a.ym,
    a.total                                            as cur,
    b.total                                            as prev,
    (a.total - b.total) \ b.total                      as mom_pct
from monthly as a
inner join monthly as b
        on iif(a.ym % 100 = 1, a.ym - 89, a.ym - 1) = b.ym   // 1 月跨年:202601 → 202512
关键在 iif(a.ym % 100 = 1, a.ym - 89, a.ym - 1):一月减 89(跨年回到去年 12 月),其他月减 1。整数算术把"上月"变成一行看得懂的逻辑——比时间函数的可读性高得多,跨年边界也一目了然。
2.2 月长不等:日均化还是声明口径
环比的月长坑有两种解法,对应 1.2 节的两派口径:
// 解法 A:日均化(同样长度派)——除以各自天数再比
select a.ym,
    a.total \ a.days                     as cur_daily_avg,
    b.total \ b.days                     as prev_daily_avg,
    (a.total \ a.days - b.total \ b.days) \ (b.total \ b.days)  as mom_daily_pct
from monthly as a
inner join monthly as b
        on iif(a.ym % 100 = 1, a.ym - 89, a.ym - 1) = b.ym
解法 B 是保留总量环比、在报表口径里声明"自然月口径"。哪个对?取决于受众:给管理层看总量趋势用 B,给运营找原因用 A。两个都算上、并排展示,是更常见的成熟做法。
三、同比:去年"同一位置"在哪
环比的"上月"只有一种理解,同比的"去年同期"却有四种——这是同比比环比难一档的原因。
3.1 四种对齐策略
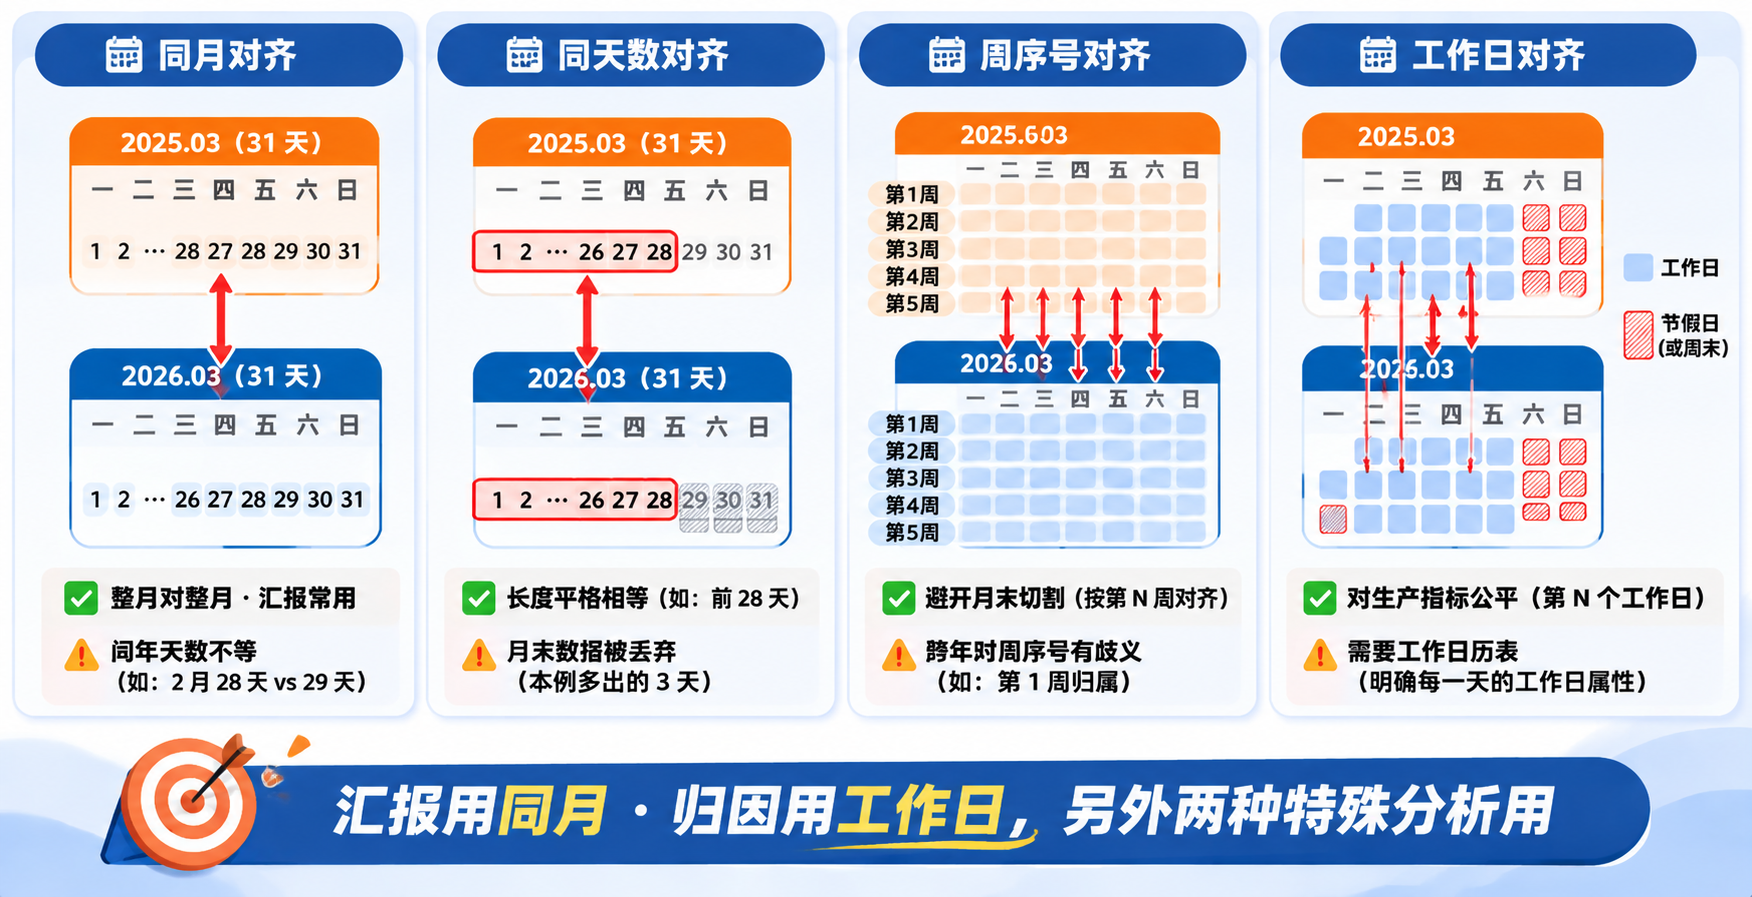
策略 | 定义 | 优点 | 坑 |
|---|---|---|---|
同月对齐 | 去年同一个月 | 口径最直白,汇报最常用 | 闰年二月天数不等 |
同天数对齐 | 今年 2/1~2/28 对去年 2/1~2/28 | 长度严格相等 | 月末数据被丢弃 |
周序号对齐 | 第几周对第几周 | 避开月末切割,周粒度分析 | 周跨年时序号有歧义 |
工作日对齐 | 第 N 个工作日对第 N 个工作日 | 对生产指标公平 | 需要工作日历表(第五节) |
选型原则:汇报场景用同月,归因场景用工作日,其余两种在特殊分析时用。
3.2 同月对齐的实现
整数月键的同比比环比还简单——减 100:
// 同月同比
select
    a.ym,
    a.total \ a.days                     as cur_daily_avg,   // 带日均,化解闰年
    b.total \ b.days                     as prev_daily_avg,
    (a.total \ a.days - b.total \ b.days) \ (b.total \ b.days) as yoy_daily_pct
from monthly as a
inner join monthly as b
on a.ym - 100 = b.ym注意这里直接用了日均化版本——同月对齐的天数坑(28 vs 29)用日均天然化解,一行除法比任何特判都干净。总量同比如果业务坚持要,配一行天数说明放进报表脚注。
3.3 节假日错位:同比算法没变,日历变了
春节类错位的本质:同月对齐假设"两个月的日历结构相似",长假跨月移动时假设失效。处理方式不是改 SQL,是换分母:
// 工作日日均:把"哪天算工作日"交给日历表(第五节)
workdayMonthly = select
    int(year(ts) * 100 + month(ts))      as ym,
    sum(m.value)                         as total,
    sum(m.value) \ sum(c.isWorkday)      as per_workday      // 工作日均值
from metricDaily as m
inner join calendar as c on m.date = c.date
group by int(year(ts) * 100 + month(ts))二月的产量同比,用"工作日均值"替代"自然日均值",长假挪动的影响即被抹平。SQL 只负责算,"什么算可比"由口径和日历表决定。
四、滚动窗口:YTD 与滚动 12 月
固定期比较之外还有一族"滚动"指标——起点随时间移动,看板上的曲线每天更新。
4.1 YTD / MTD:年内累计
年初至今(YTD)、月初至今(MTD)的本质是年内分段累计,用 context by 分组累加:
// 日粒度 YTD:按年分组,年内逐日累加
ytd = select date(ts)                     as day,
       value,
       cumsum(value)                      as ytd_value
from loadTable("dfs://iot", "metricDaily")
context by year(ts)
order by day
context by year(ts) 让累计在每个自然年重新归零——年初自动翻篇,不需要任何特判。月内至今(MTD)把分组键换成 year(ts)*100+month(ts) 即可。
4.2 滚动 12 个月:消掉季节性
月度序列上做 12 期移动求和,得到"滚动 12 月总量"——无论看哪个月,覆盖的都是完整一年,季节性天然抵消:
// 月度序列(按 ym 排序后)做 12 期滚动求和
rolling = select ym,
       total,
       msum(total, 12)                    as rolling_12m
from monthly
order by ym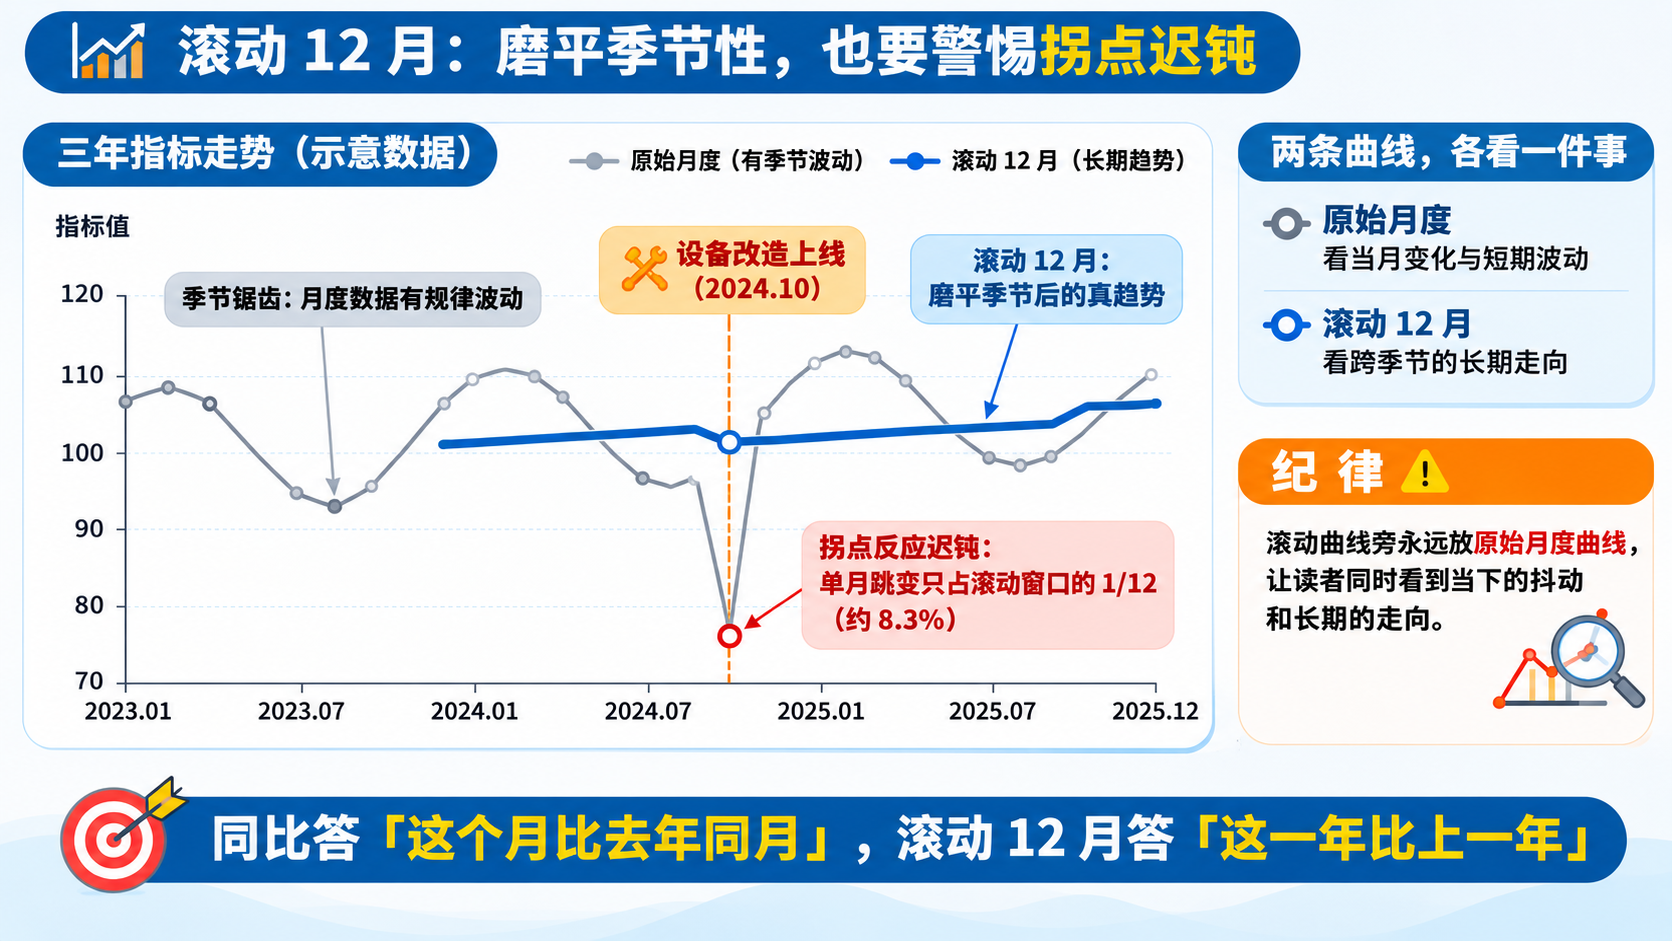
滚动 12 月和同比是一对搭档:同比回答"这个月和去年同月比",滚动 12 月回答"这一年整体和上一年比"。看趋势拐点,滚动 12 月比逐月数据安静得多——它是把季节性的锯齿磨平后剩下的那条真趋势。
4.3 滚动窗口的语义提醒
滚动窗口的曲线有个特性要提前想清楚:它对拐点的反应是迟钝的。单月数据跳水,滚动 12 月只跌十二分之一——看板读者容易误读"还很平稳"。纪律:滚动窗口曲线旁边永远放一条原始月度曲线,让读者同时看到"当下的抖动"和"长期的走向"。
五、工作日历表:把"哪天算工作日"变成数据
5.1 日历表设计
第三节已经两次用到它了。工作日历是一张维度表:
// 工作日历:一天一行
calendar = table(1:0,
    `date`isWorkday`holidayName`shiftAdjust,
    [DATE, INT, SYMBOL, INT])

// 示例:
// (2026.01.01, 0, `元旦,   0)
// (2026.02.16, 0, `春节,   0)   // 调休放假
// (2026.02.21, 1, `春节调班, 1) // 周六上班
// (2026.02.23, 0, `春节,   0)
isWorkday 不等于"周一到周五"——调休让周六变工作日、工作日变休息日,这个信息只存在于每年的放假安排里,算不出来,只能维护。
5.2 日历表参与计算的三种方式
- 工作日均值(3.3 节):分母用
sum(isWorkday),长假错位自动修正 - 工作日对齐同比:今年第 N 个工作日对去年第 N 个工作日——
cumsum(isWorkday)给每天编工作日序号,然后按序号 join - 报表筛选:班组绩效按"工作日天数"折算,日历表 join 一下就有
5.3 维护纪律
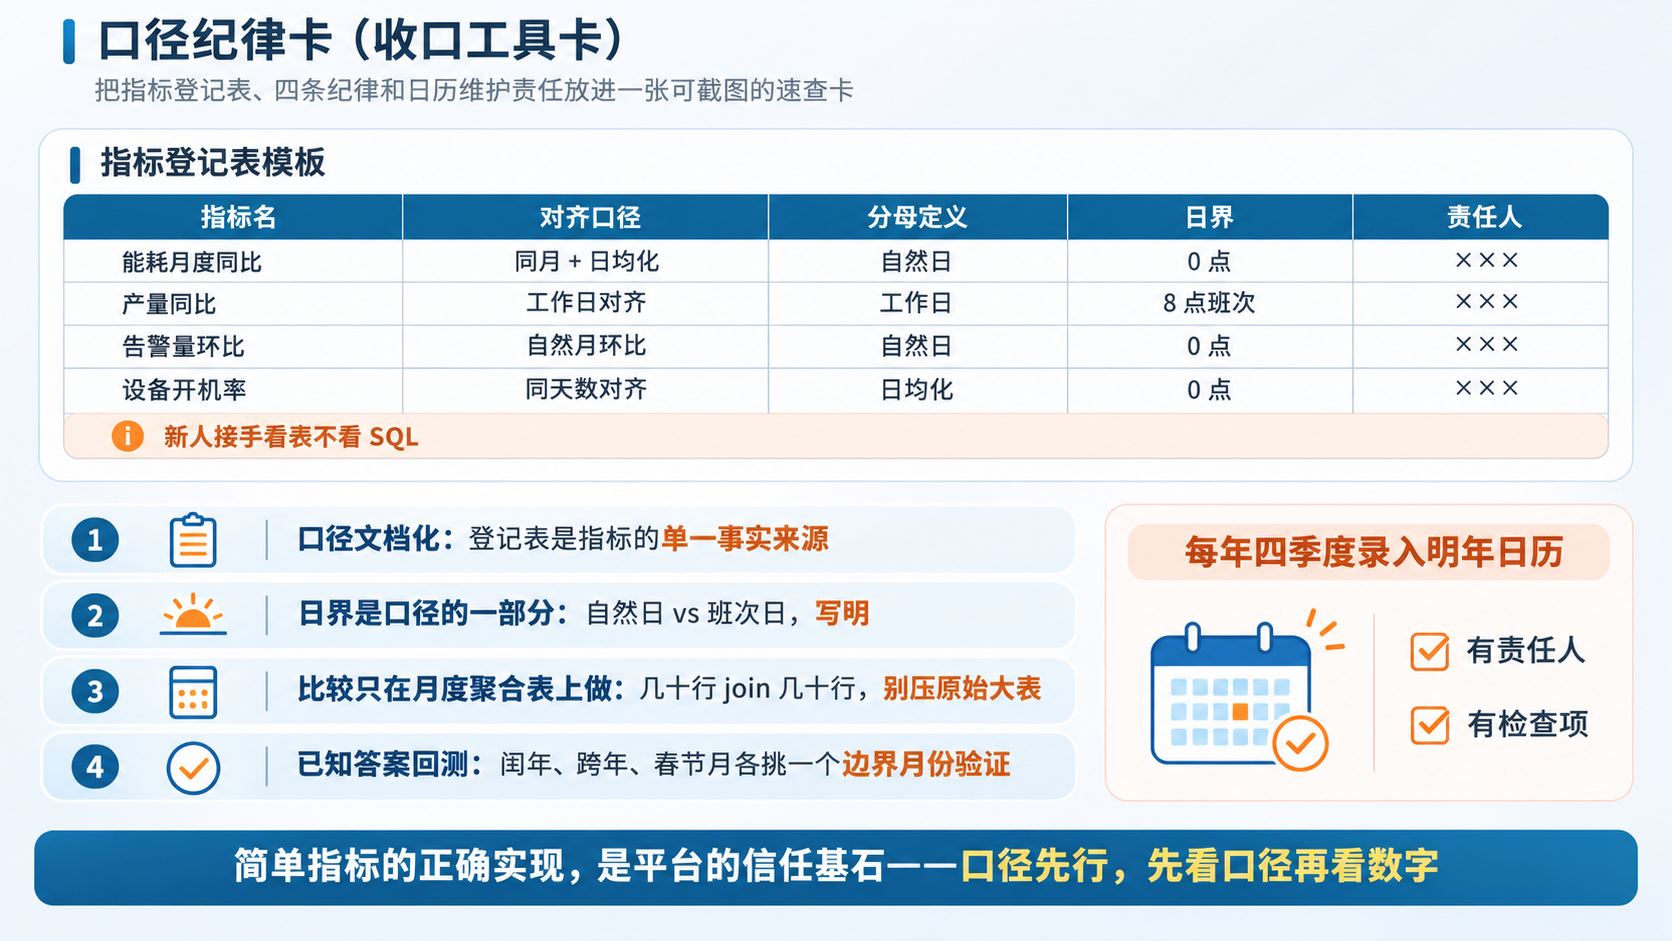
日历表每年维护一次:每年四季度放假安排公布后,把下一年的日历录进去——节前录入,别等元旦。这张表的用户是所有指标计算,它错了所有同比都错,所以它值得一个明确的维护责任人和一个"明年日历已就绪"的检查项。
六、工程细节与坑
6.1 口径文档化:每个指标一行口径说明
全文反复回到这一条,因为它是所有坑的总解药。给指标建一张登记表:指标名、口径(同月对齐/日均化/工作日对齐)、分母定义、日历表版本——新人接手看表不看 SQL。指标口径不一致引发的业务争论,几乎都源于口径只存在于某个人的 SQL 里。
6.2 日界:自然日还是班次日
三班倒的工厂,"3 月 15 日的产量"有两种日界:自然日(0 点切)和班次日(8 点切,早班从 0 点算到次日 8 点)。两种口径下同一个"日"的数字不同。纪律同前:日界是口径的一部分,登记进指标表;实现上,班次日界用 date(datetimeAdd(ts, -8*3600*1000)) 把时间轴平移八小时再按日聚合。
6.3 在聚合表上比较,不在原始表上比较
同比环比的 join 都发生在月度聚合表上(几十行 join 几十行),绝不在日明细表上做跨年 join。让聚合表由定时任务每日增量刷新,比较查询永远是轻查询。看板卡顿的指标计算,十有八九是把比较逻辑直接压在了原始大表上。
6.4 用已知答案回测口径
新口径上线前,挑两三个已经手工核对过的历史月份回测:算法结果和手工结果一致才上线。闰年、跨年、春节月各挑一个——这三个边界过了,口径基本就稳了。比"代码 review 一遍"可靠得多,因为它验证的是口径本身,不只是代码。
七、总结
指标计算是平台上"看起来最没有技术含量"的部分——不就是减一下除一下吗?这篇文章想说的是:简单指标的正确实现,恰恰是最考验工程严谨的地方。曲线画错了肉眼能看出来,"同比下降 12%"算错了没有人知道——它看起来和正确答案长得一模一样。
四块内容收拢:
- 环比:整数月键自连接,一月减 89 跨年,月长坑用日均化或口径声明
- 同比:四种对齐策略先选型,同月对齐减 100,闰年用日均天然化解
- 滚动窗口:YTD 用
context by年内累计,滚动 12 月磨平季节性,曲线旁永远放原始月度 - 工作日历:调休算不出来只能维护,每年四季度录入明年,它是所有同比的隐形地基
一条总纪律贯穿全文:口径先行——日历不是背景板,是计算的一部分;口径不写进指标登记表,就会藏在某个人的 SQL 里,然后随着那个人离职变成悬案。
下次看板上跳出"同比下降 12%",希望你的第一反应不是"业务变了",而是——先看口径,再看数字。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号