AI 总是不按格式输出?把"格式要求"写成能跑校验的约束
原创
AI 总是不按格式输出?把"格式要求"写成能跑校验的约束
原创
用户12877835
发布于 2026-11-20 09:22:47
发布于 2026-11-20 09:22:47
每周都要把同一份数据交给 AI 整理成表,每次都要手动改格式:这次表后面多了一句"以上为本周情况",下次金额带了千分位,再下次表头被"优化"成了三列以外的样子。改一次两次不算事,改到第十次,你就会开始怀疑是不是模型不行。
问题通常不在模型,而在要求本身:"按表格给我""简洁一点"这类话,人和模型都没法判定是否满足。这篇文章给一套可以照着做的办法——把格式要求写成一份带编号的契约,再用三十行脚本把它变成能跑的校验,最后把校验结果原样回喂。全程在真实终端里操作,配图为实际运行截图。
一、四种最典型的格式漂移
先明确要治什么病。同一份"输出三列表格"的要求,实际运行中最常见的偏差有四类:
- 表外多话:表格后面自动补一句总结、一句邀请、一句"如需细化请告知";
- 单位混写:同一列里出现
¥1,200、860、300元三种写法; - 行数失控:说好六行以内,给你八行,还多出一行"合计";
- 表头被改写:
花费变成花费(元),转化数变成转化。
这四类的共同点是:要求里只说了"要什么",没说"什么算合格"。人在验收时靠经验补上了这些判断,模型没有这份经验,于是每次都按自己觉得合理的方式填。
二、把要求写成契约:六条 + 四条反例
契约不需要长篇大论,六条就够,关键是每条都能用一行代码判定。以投放日报为例:
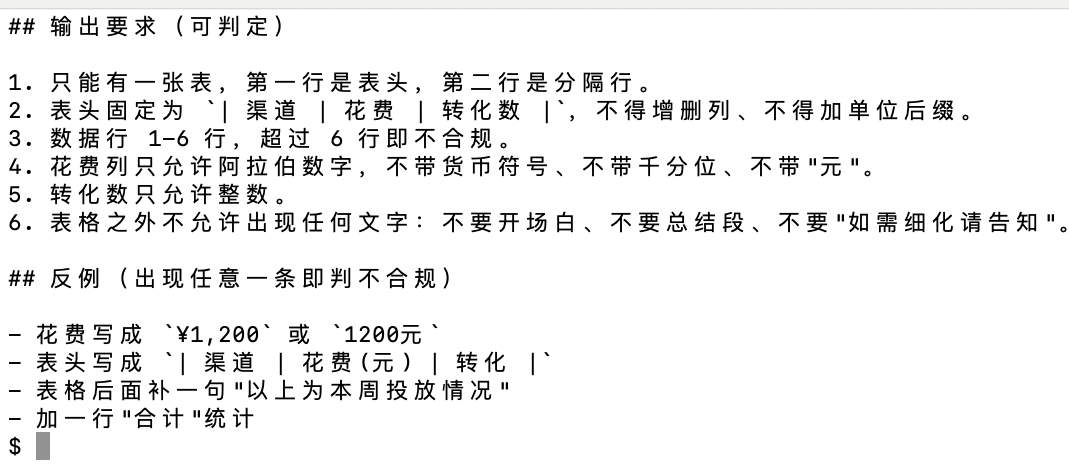
这六条里有三个值得抄的写法:
第一,用数字,不用形容词。 "数据行 1-6 行"可以判定,"行数别太多"不能。同理,"每行不超过 40 字"可判定,"写得简短些"不能。凡是能用数字表达的边界,一律换成数字。
第二,写"允许什么字符",而不是"不要什么符号"。 早期我写的是"金额不要带货币符号",模型改成了 1200.00——符号没了,小数位又来了。改成"只允许阿拉伯数字"之后,才真正封住。正面描述字符集,比列举禁止项更稳。
第三,每条规则配一个反例。 反例的作用不是给模型看的,是给写规则的人看的:写反例的时候你会立刻发现"这条规则好像还有漏洞"。上面第四条反例加一行"合计"统计,就是因为第三条只写了行数上限、没写"不许加汇总行"才漏出来的。
契约落到文件里,放在项目根目录,文件名固定(这里叫 format-spec.md),后面回喂时直接引用文件名,不用把六条规则再贴一遍。
三、契约自己也要能跑
只写契约,仍然是靠眼睛验收。真正的转折点是把它变成脚本:同一个判断标准,让人和程序用同一份实现。
为什么值得多花二十分钟写这三十行?三个理由:一是确定性,同一段输出跑一百次结论一致;二是可回归,改规则之后能拿历史样本重跑,立刻知道有没有误伤;三是能给出具体错误——这一点最关键,后面回喂全靠它。
规则按 R1 到 R6 编号,代码里也用同一个编号,报错时直接输出编号:
正在上传图片...
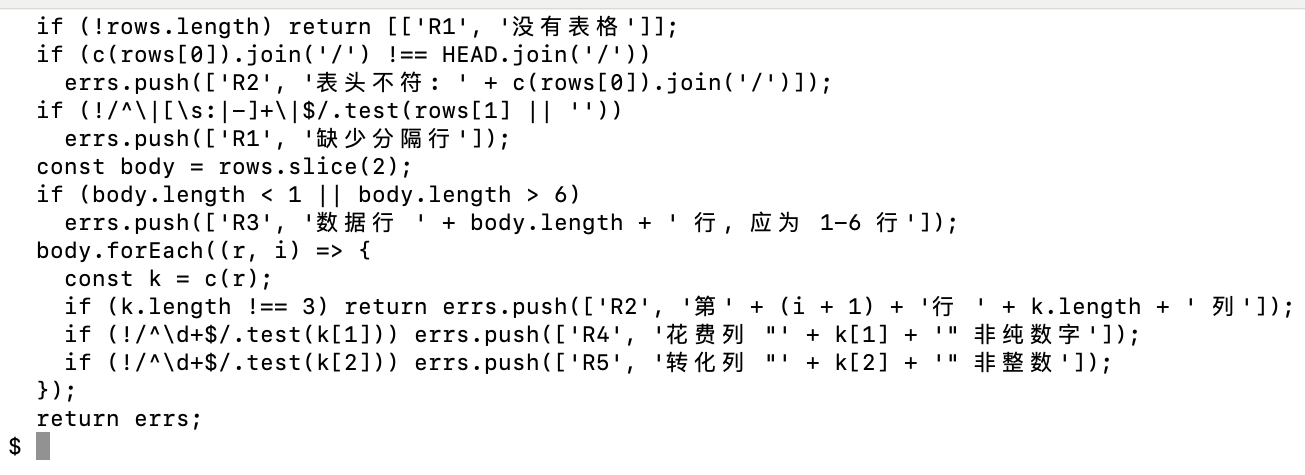
核心就是一个纯函数,输入是文件路径,输出是错误数组,没有依赖、不联网、不调用模型:
const fs = require('fs');
const HEAD = ['渠道', '花费', '转化数'];
const c = l => l.split('|').slice(1, -1).map(s => s.trim());

function check(file) {
  const lines = fs.readFileSync(file, 'utf8').replace(/\r/g, '')
    .split('\n').map(s => s.trim()).filter(Boolean);
  const rows = lines.filter(l => l.startsWith('|'));
  const errs = [];
  lines.filter(l => !l.startsWith('|'))
    .forEach(l => errs.push(['R6', '表外有文字: ' + l.slice(0, 18)]));
  if (!rows.length) return [['R1', '没有表格']];
  if (c(rows[0]).join('/') !== HEAD.join('/'))
    errs.push(['R2', '表头不符: ' + c(rows[0]).join('/')]);
  if (!/^\|[\s:|-]+\|$/.test(rows[1] || ''))
    errs.push(['R1', '缺少分隔行']);
  const body = rows.slice(2);
  if (body.length < 1 || body.length > 6)
    errs.push(['R3', '数据行 ' + body.length + ' 行, 应为 1-6 行']);
  body.forEach((r, i) => {
    const k = c(r);
    if (k.length !== 3) return errs.push(['R2', '第' + (i + 1) + '行 ' + k.length + ' 列']);
    if (!/^\d+$/.test(k[1])) errs.push(['R4', '花费列 "' + k[1] + '" 非纯数字']);
    if (!/^\d+$/.test(k[2])) errs.push(['R5', '转化列 "' + k[2] + '" 非整数']);
  });
  return errs;
}
主程序只做三件事:逐个文件调用、打印 PASS/FAIL 与规则明细、按退出码告诉调用方"这一批过没过"。退出码设计成有违规就返回 1,这样它可以被壳脚本、自动化任务直接串起来——过不了就不往下走。
注意 R2 在代码里出现了两次:一次判表头,一次判"某行列数不对"。这不是重复,而是同一类错误的两个触发点——表头被改写和行内列数不一致,本质都是"列没对齐",合成一条规则反而更好定位。
四、拿五段样本跑一遍
规则写完先别急着上生产,先造一批样本做基线。这五段样本的数据是虚构的,格式偏差是真的,分别对应第一节那四类漂移,加上一段完全合规的对照:
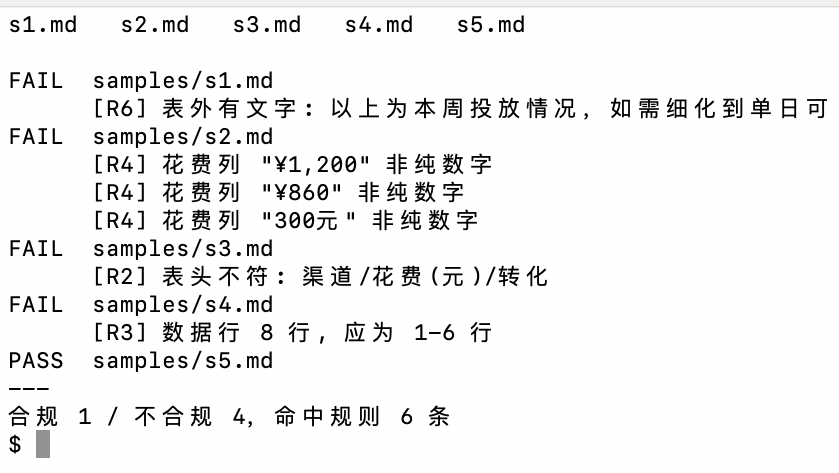
输出很直白:合规 1 / 不合规 4,命中规则 6 条,退出码 1。
这段输出里有两个细节值得停下来看:
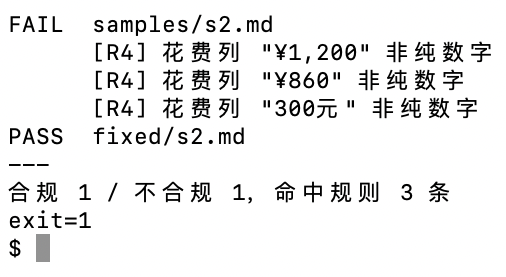
一是 s2 一次命中三条同规则。 ¥1,200、¥860、300元 都是 R4。这说明同一类错误在表格里会成片出现,不是单点问题。所以规则要按"列"设计,不能按"单元格"设计——按列判一次,就能一次说清整列的问题。
二是 s1 的错误信息被截断在 18 个字符。 这是刻意的:错误信息太长会把终端刷满,回喂时也浪费上下文。截断到"能认出是哪一句"就够了,原始文件模型自己看得到。
基线跑通之后,这五段样本就别删,它们是以后改规则的回归测试集。规则一改,重跑一遍,就知道有没有把原来合规的样本判错。
五、回喂:别说"再试一次"
校验给出了错误,接下来最容易被浪费掉的一步是:把失败结果丢回去,说一句"格式不对,再试一次"。这句话的信息量是零,模型只能重新猜一遍,猜中的概率和第一次一样。
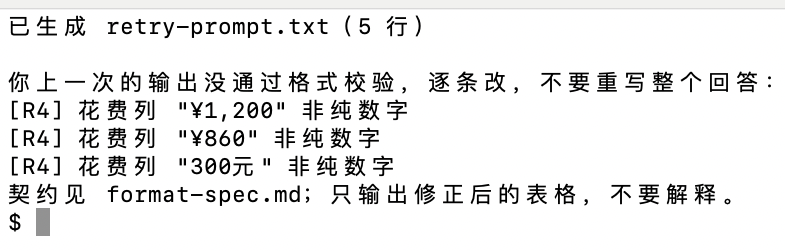
正确的做法是把规则编号、原始值、改动范围三样东西一起给回去。这一步也能自动化:校验不过时,把 [R4] 花费列 "¥1,200" 非纯数字 这类明细直接拼成一段提示词:
这段模板里有四句话,每句都在收窄模型的自由度:
- "逐条改,不要重写整个回答"——避免它顺手把没问题的列也改了,制造新错误;
- 带规则编号——模型能对应回契约里的第几条,不用从自然语言里猜你的意思;
- 给原始值(
"¥1,200")——不用它去文件里找是哪一格; - "只输出表格,不要解释"——解释段落既占篇幅,又常常把表格挤到最后,还容易带出新的表外文字。
改完再跑一次校验,把旧样本和新样本放在一起对比,确认只动了被点名的三格:
这一步别省。我踩过的坑是:模型为了"稳妥"把整表重写了一遍,格式过了,但有两行数据的数值被顺手改了——因为原文件里那两行本来就是它不确定的。校验器只管格式,不管内容,所以"改动范围"这条必须靠回喂指令约束,不能指望自动查出来。
六、约束的边界:什么时候不该写死
这套办法有明确的适用面,滥用会反噬:
探索类任务不要预先上约束。 让 AI 帮你梳理一个陌生领域的问题清单时,如果先规定"必须三列、每列不超过六个字",它会把有价值的判断砍掉来满足格式。这类任务应该先放开产出,等结论稳定了再谈格式。
规则数量控制在六条以内。 超过六条,模型遵守率会明显下降,而且你自己维护起来也乱。真需要更多,先分组:把"结构类"和"内容类"拆成两份契约,分别校验。
契约和校验器必须同时改。 这是最容易腐化的地方。如果只在 format-spec.md 里加了第七条、忘了改脚本,校验就会给出"通过"的错误结论——一个不完整的校验器比没有校验器更危险,因为它给了你虚假的安全感。所以规则编号要在两边同名同号,改一条就改两处。
七、可以直接照搬的三步
- 挑一个你每周都要人工返工的输出,只挑一个;
- 把要求改写成六条可判定条款,每条配一个反例,存成
format-spec.md; - 写三十行校验脚本 + 一段回喂模板,拿五段历史输出跑基线,记下通过率。
做到第三步,格式这件事就从"每次祈祷它听话"变成了"过不了就退回重改"的固定流程。省下的不是改格式那几分钟,而是每次打开输出前那点不确定。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号