CRM 数据清洗:用免费API批量回填企业工商信息
原创
CRM 数据清洗:用免费API批量回填企业工商信息
原创
Xxtaoaooo
修改于 2026-11-20 11:06:10
修改于 2026-11-20 11:06:10
做客户管理、供应商入库、CRM 数据治理的朋友,难免会碰到「只有公司名,需要批量补全工商信息」的场景,最省事的做法其实是企业数据 API:写个脚本,输入公司名列表,自动把工商字段回填进表格,跑一次几分钟搞定,还能随时重跑更新。
我找了一圈企业数据 API,市面上不少服务商要么免费额度抠抠搜搜,要么免费版只给最基础的字段,稍微全一点的企业数据就要付费。相比之下,鲸海数据会送 1000 次免费调用,而且额度是全平台所有 API 通用的,拿来做数据回填这种批量活,正好够用。
下面是我的实测过程,供参考。
一、为什么不用爬虫,也不建议纯手工
在选方案之前,先把三条路摆一摆:
- 手工查:慢、易错、不可复用。名单更新一次就得重来一遍。
- 自己写爬虫:法律风险和稳定性风险都不小,公开站点结构一变就失效,还得对付反爬,维护成本远高于想象。
- 企业数据 API:按次调用、结构化返回、字段稳定,一次写好脚本就能长期复用。规模化处理数据时,这是最划算的一条路。
对比下来,用 API 做批量回填基本没有悬念。
二、鲸海API 额度获取
API 用的鲸海数据的免费api,需要做实名认证,个人或企业信息都行,审核比较宽松,基本秒过。
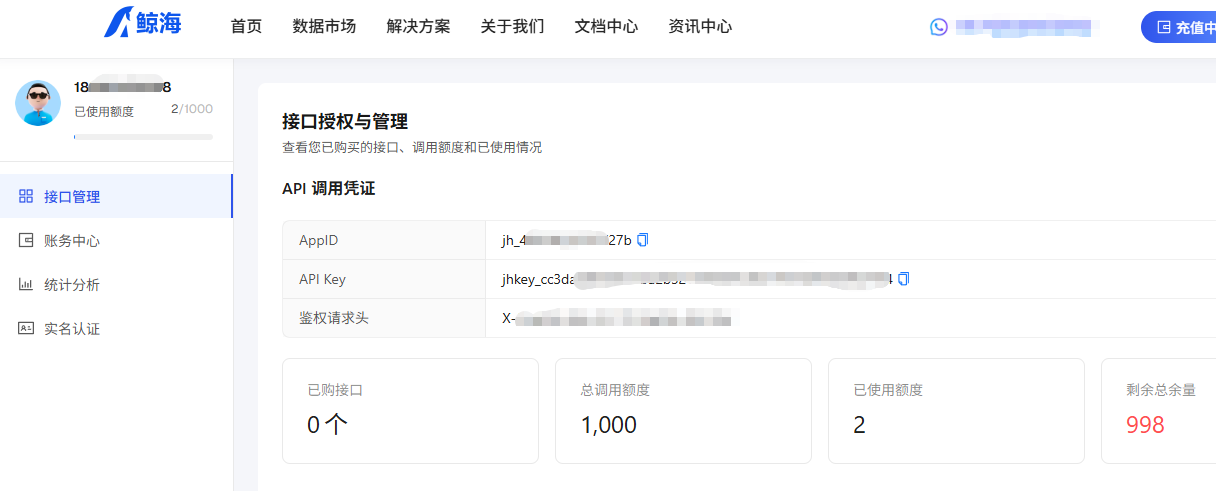
接着后台就能看到 1000 次免费额度到账,API 调用需要的 AppId 和 ApiKey 也在同一个界面,方便复制。
重点说下这个额度,它不是只让你测某一个接口,而是全平台所有 API 通用。工商信息、司法风险、知识产权、招投标,上百个细分接口都能调。对于数据回填这种一次要跑几百上千条的活,这个量足够你把流程完整跑通。
三、不只是工商信息:一套接口补全企业画像
我重点看了下这家和「企业基本信息」相关的接口,发现它没有把所有东西塞进一个大而全的接口里,而是按数据维度拆得很细,按需取用。这点在实际开发里很关键,你不需要的字段,就不必为它付费、也不必等它返回。
做客户/供应商资料回填时,常用的几个接口可以这样组合:
接口 | ID | 能补什么字段 | 典型用途 |
|---|---|---|---|
工商信息 | 10001 | 统一社会信用代码、法人、注册资本、成立日期、经营状态、所属行业等 | 补全企业身份基础档案 |
开户信息 | 10009 | 开户银行、企业税号、开户电话 | 对公打款、开票资料 |
股东信息 | 10004 | 股东名称、持股比例、认缴金额 | 股权结构、背景核验 |
主要人员列表 | 10006 | 姓名、职务、任职开始日期 | 联系人/关键人梳理 |
工商变更 | 10002 | 变更日期、变更项目、变更前/后 | 动态监控、历史沿革 |
除了工商信息,招投标、知识产权、税务、司法、招聘、媒体这些企业服务相关的数据他们也都有,可以说挺全面的了,哪怕是企业尽调、供应商持续风控、B2B 智能获客等复杂点的场景也能应对。
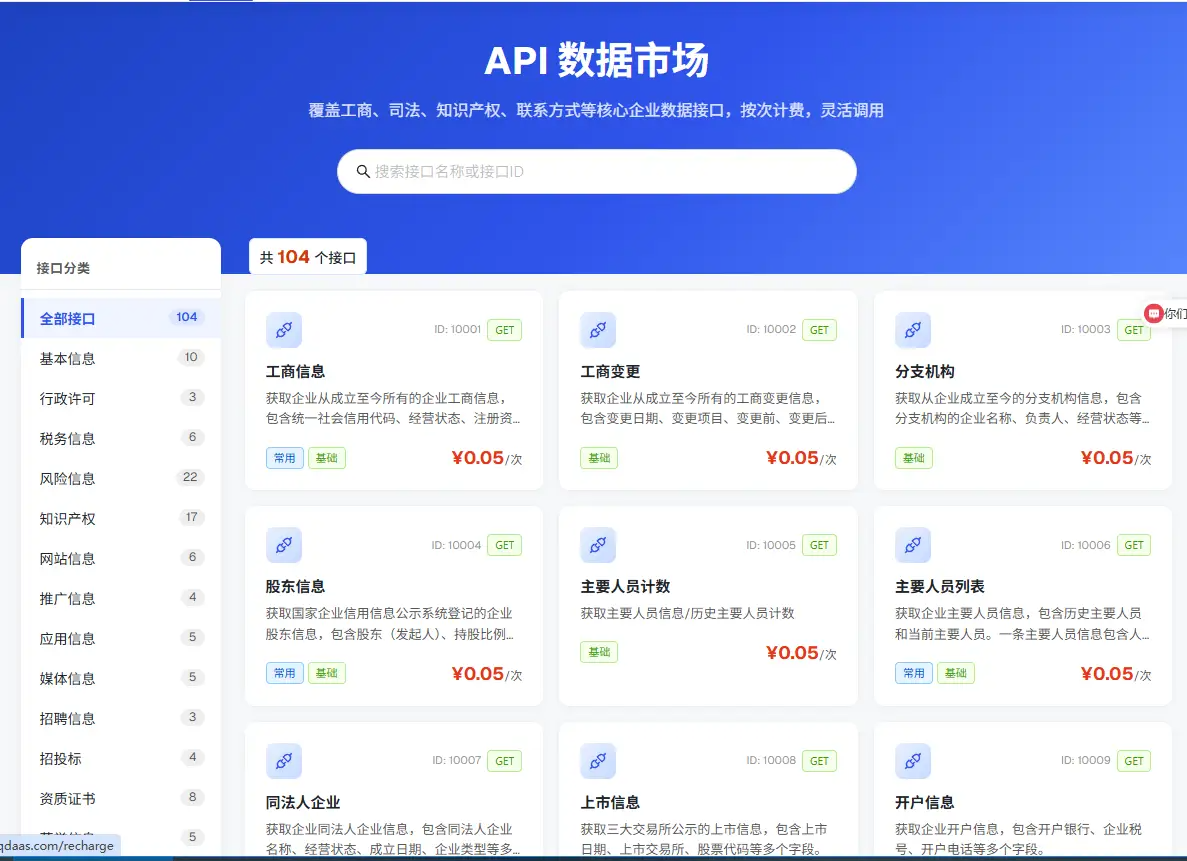
随机抽了几家有公开记录的企业测试,跟公示信息交叉比对,准确度和及时性都是ok的。
四、Python 实战:批量回填工商信息到 Excel
鲸海API的接口是标准的RESTful风格,用GET请求加Header鉴权就能调,Python几行代码的事。每个接口还有在线调试功能和详细的JSON 返回示例,方便你检查验证数据结构、字段完整性和参数逻辑。
比如「工商信息」接口的JSON 返回示例如下:
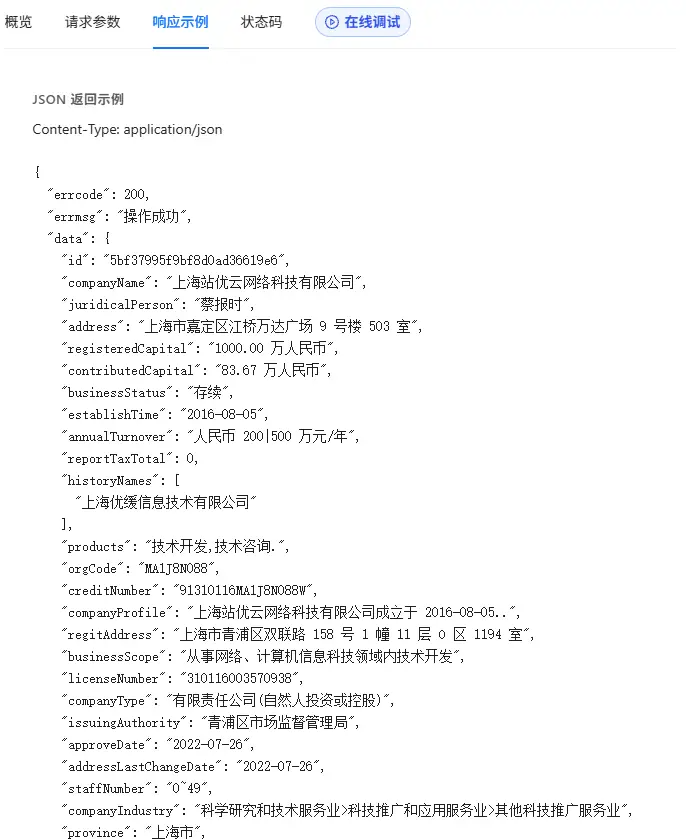
下面上代码。场景设定:有一个 companies.xlsx,A 列是公司名,我要把查到的工商字段回填到后面的列,导出成一份完整档案表。
先装个依赖:
pip install requests openpyxl核心代码如下:
import os
import time
import urllib.parse
import requests
from openpyxl import load_workbook

# ---------- 配置 ----------
BASE = os.getenv("JINGHAI_API_BASE", "https://www.kqdaas.com")
APP_ID = os.getenv("JINGHAI_APP_ID")
API_KEY = os.getenv("JINGHAI_API_KEY")

if not APP_ID or not API_KEY:
    raise ValueError("请先设置 JINGHAI_APP_ID 和 JINGHAI_API_KEY")

# 工商信息接口(ID 10001)的请求路径,以官网接口文档为准
# 发布前请到官网后台「API 数据市场 → 工商信息 → 查看详情」核对实际路径后替换
BASIC_INFO_PATH = "/DataService/api/v3/company/basic/{name}"

HEADERS = {
    "X-Jinghai-App-Id": APP_ID,
    "X-Jinghai-Api-Key": API_KEY,
    "Accept": "application/json",
}

# 表格列 -> 接口返回字段的候选 key(不同版本字段名可能略有差异,按实际返回调整)
FIELD_MAP = {
    "统一社会信用代码": ["creditCode", "unifiedSocialCreditCode"],
    "法定代表人":       ["legalPerson", "legalRepresentative"],
    "注册资本":         ["registeredCapital", "regCapital"],
    "成立日期":         ["establishDate", "estDate"],
    "注册地址":         ["registeredAddress", "address"],
    "企业类型":         ["companyType", "enterpriseType"],
    "经营状态":         ["businessStatus", "status"],
    "所属行业":         ["industry"],
}

def pick(record, keys):
    """从返回记录里按顺序取第一个存在的字段值"""
    for k in keys:
        if record.get(k) not in (None, ""):
            return record[k]
    return ""

def query_basic_info(name, query_type=1):
    """查询单个企业的工商信息,失败返回 None"""
    url = f"{BASE}{BASIC_INFO_PATH.format(name=urllib.parse.quote(name))}"
    try:
        resp = requests.get(url, headers=HEADERS,
                            params={"queryType": query_type}, timeout=15)
        data = resp.json()
        if data.get("errcode") != 200:
            return None
        # 多数接口在 data 下直接返回对象,个别版本是 list,这里做兼容
        d = data.get("data")
        if isinstance(d, list):
            return d[0] if d else None
        return d
    except Exception:
        return None

def main():
    wb = load_workbook("companies.xlsx")
    ws = wb.active

    # 第 1 行是表头,从第 2 行开始回填
    headers = [ws.cell(row=1, column=i).value for i in range(1, ws.max_column + 1)]
    col_index = {h: i + 1 for i, h in enumerate(headers)}

    for row in range(2, ws.max_row + 1):
        name = ws.cell(row=row, column=1).value
        if not name:
            continue
        info = query_basic_info(str(name).strip())
        if not info:
            print(f"第 {row} 行 {name}:未查到数据,跳过")
            continue
        for col_name, keys in FIELD_MAP.items():
            if col_name in col_index:
                ws.cell(row=row, column=col_index[col_name], value=pick(info, keys))
        print(f"第 {row} 行 {name}:回填完成")
        time.sleep(0.3)  # 控制频率,避免触发限流

    wb.save("companies_filled.xlsx")
    print("全部完成,结果已保存到 companies_filled.xlsx")

if __name__ == "__main__":
    main()
跑完之后,原来只有一列公司名的表格,就变成了一份带统一社会信用代码、法人、注册资本、经营状态的完整档案,几千条数据也就几分钟的事。
五、一个意外发现
在这次实测里我还发现,鲸海这个站本身几乎不设防,直接就能拿到数据。
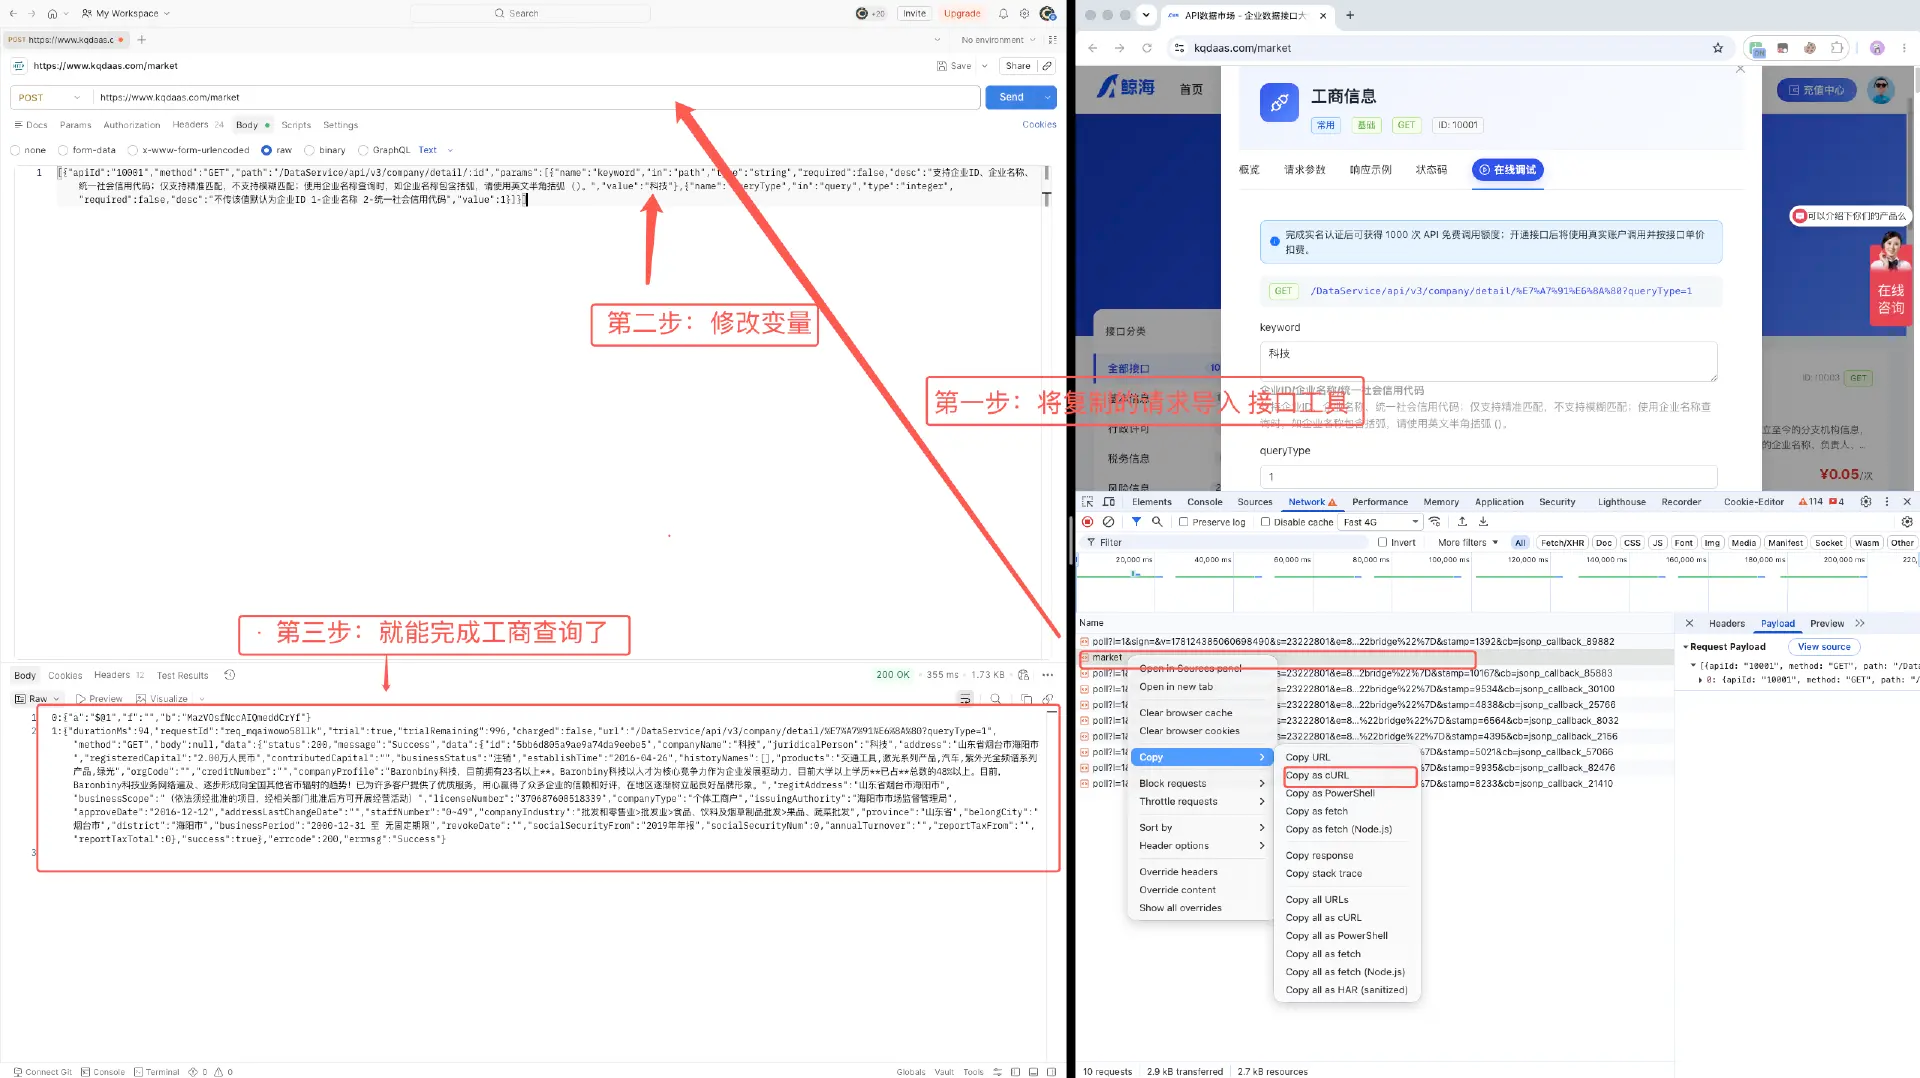
我试着连续跑了一大批,一直没摸到它的上限在哪:没封 IP、没弹验证码、也没触发任何限速提示。反正就目前的体验来说,敞开爬就对了。
不过从页面上直接能拿到的这部分数据,维度没有 API 返回的那么全,主要是一些工商基础字段,企业名称、统一社会信用代码、法定代表人、注册资本、经营状态这些,但拿来做初步筛选、存量数据清洗还是够用的。
六、总结
批量回填工商信息,写好一次脚本,无论是客户准入、供应商引入,还是 CRM 数据清洗,都能直接复用。
这次用的鲸海数据,工商相关接口按维度拆得比较细,需要哪些字段就调哪些接口,不浪费额度;接口的在线调试能把请求和返回结构看得很清楚,对接起来省了不少事。加上 1000 次全平台通用的免费额度,用来做数据回填的验证再合适不过。
有需要的可以直接去鲸海数据官网领个额度试试。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号