腾讯云国际代理商:混元 Hy4 Flash 上线|TokenHub黑五跨境 AI 客服降本方案
原创
腾讯云国际代理商:混元 Hy4 Flash 上线|TokenHub黑五跨境 AI 客服降本方案
原创
云渠道商云枢国际@yunshuguoji
发布于 2026-11-20 15:49:46
发布于 2026-11-20 15:49:46
本文由 腾讯云国际站代理商『云枢国际✈️✈️✈️ TG-@yunshuguoji - 腾讯云国际服务器服务商』撰写,可在 TG(小飞机)搜索小编,如需转载请注明!
黑五前调整 AI 客服的模型选型,最怕的是被“单任务成本 1/20”这种数字带着走。腾讯混元 Hy4 flash 11 月 16 日刚发布,官方喊出的性价比确实抓眼球,但那个数字的基准是 WorkBuddy 办公任务,不是跨境 AI 客服。拿它降本,得先搞清楚它在客服场景下到底省在哪、省不了在哪。
这篇按跨境 AI 客服的真实负载结构,把 Hy4 flash 在腾讯云国际 TokenHub 上的接入方式和成本逻辑捋清楚。
Hy4 flash 到底是个什么模型
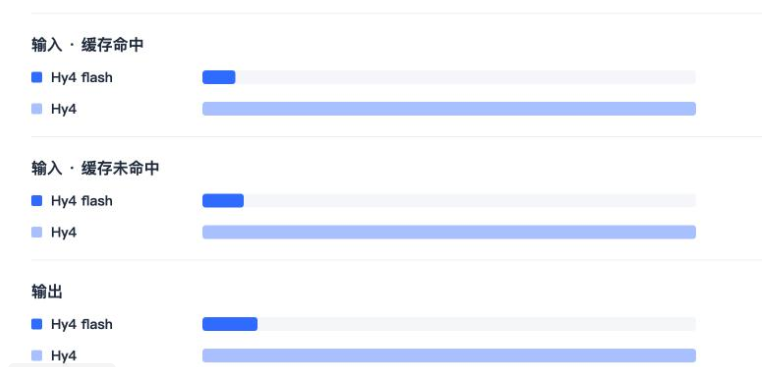
官方数据:总参数 224B,其中 64B 是 Engram 参数,每个 token 激活仅 12B。支持多模态输入和 1M 上下文。API 定价每百万 token 输入 0.5 元、输出 2 元,命中缓存时输入仅 0.02 元。
腾讯对它的定位很明确:日常办公效率场景。官方推荐用途是深度搜索、文档处理、PPT 生成、简单前端展示、Computer Use。长程软件工程这类复杂任务,官方建议交给智能上限更高的 Hy4。
AI 客服不在官方推荐场景列表里。这不是说它不能做客服,而是说它的优化方向(任务产物质量、端到端用时、输出长度压缩)是冲着办公任务去的。客服场景的负载特征——短消息、高频请求、多轮对话保持、多语言得体性——和办公任务有重叠但不完全一样。
但有一个特性对 AI 客服有直接价值:强化学习把端到端输出长度压了 50%,解码速度超过 150 tps。客服回复本来就该短,输出长度压下来,token 消耗和响应时间都受益。Hy4 flash 的用户盲测里,单任务成本 0.26 元,端到端时长中位数 6.7 分钟,满意度接近 Claude Haiku 5.5。这个数据来自办公任务,但“快且便宜”的底子对客服场景是正向的。
跨境 AI 客服的成本结构,和办公任务差在哪
办公任务通常是一次性、长输出、追求产物完整。AI 客服是高频、短输入短输出、多轮上下文重复。
这意味着两件事:
第一,缓存命中率决定实际成本。客服对话里,商品 FAQ、退换货政策、物流说明、尺码表这些固定内容,每一轮对话都要作为上下文传入。如果你把这些放在 system prompt 里,Hy4 flash 的缓存命中输入价 0.02 元/百万 token,这部分成本几乎可以忽略。但如果你的 prompt 每轮都不一样、缓存命中率低,0.5 元的输入单价就会实打实计费。
第二,输出长度是成本大头。Hy4 flash 输出 2 元/百万 token,是输入的 4 倍。客服回复如果控制得短(一两句话解决一个问题),输出占比不高。但如果模型倾向于生成长回复、或者你的 prompt 没约束好让它啰嗦,输出成本会吃掉缓存省下来的钱。Hy4 flash 的“输出长度压缩 50%”在这个场景下是实打实的优势,前提是你的 prompt 引导它往短了说。
一张表把 Hy4 flash 在 AI 客服场景的降本逻辑摆清楚
成本变量 | Hy4 flash 对应能力 | 对 AI 客服的实际影响 | 你要做什么 |
|---|---|---|---|
输入单价 | 0.5 元/百万 token | 多轮对话的上下文传入成本 | 控制对话轮次和上下文长度 |
缓存命中输入 | 0.02 元/百万 token | 固定 FAQ 和政策反复传入几乎免费 | 把不变的内容放 system prompt |
输出单价 | 2 元/百万 token | 客服回复长度的成本 | prompt 约束回复简短,别让它写小作文 |
输出长度优化 | 强化学习压缩 50% | 同样问题,回复更短,token 更少 | 验证压缩后是否丢失必要信息 |
解码速度 | 150+ tps | 用户等待时间短,体验好 | 黑五峰值时响应不拖后腿 |
多语言 | 支持多模态和 1M 上下文 | 理论上能处理多语言客服 | 拿真实对话测目标市场语言质量 |
TokenHub 接入,对出海团队的实际意义
Hy4 flash 在腾讯云国际 TokenHub 上线,TokenHub 兼容 OpenAI Chat Completions 和 Anthropic Messages 协议,新加坡、硅谷、广州三个接入点。对出海团队来说:
如果你的客服系统已经在用 OpenAI SDK 或兼容客户端,改 Base URL 和 model 名就能接,不需要重写接入层。新加坡节点覆盖东南亚,硅谷节点覆盖欧美,延迟比绕道国内低。
TokenHub 的统一入口意味着你不用单独管混元的 API Key 和计费。一个 Key、一张账单,Hy4 flash 和其他模型(DeepSeek、GLM、Kimi)可以按需切换做 A/B 测试。黑五期间用 Hy4 flash 跑主流量,如果某个场景质量不够,切到 TokenHub 上的其他模型对比,不用换平台。
11 月 30 日前 TokenHub API 限时 5 折,正好覆盖黑五窗口。但 5 折是限时活动,算长期成本时按原价算,别把折扣价当成常态。
黑五降本方案:三层配置
第一层:固定 FAQ 和标准回复,走 Hy4 flash 加缓存。商品尺码、物流时效、退换货流程这些高频、固定答案的问题,system prompt 里放好政策文本,用户问题进来直接匹配。缓存命中后输入成本可忽略,输出控制在一两句话。这是降本效果最明显的部分。
第二层:复杂咨询和情绪安抚,Hy4 flash 先出初稿,人工兜底。抱怨、投诉、纠纷类消息,Hy4 flash 生成回复草稿,客服人员审核后发送。别让它直接面对愤怒用户做承诺。它的输出速度够快(150+ tps),生成草稿不拖慢人工处理节奏。
第三层:多语言质量验证,黑五期间别全量切。如果你的客服覆盖泰语、印尼语、越南语,Hy4 flash 的多语言质量没有公开的客服场景实测数据。拿最近一周的真实对话记录,每种语言跑五十条,人工评估回复得体性。质量过关的语言全量用,不过关的语言保持现有方案或者加人工审核。
常见问题:
Q:Hy4 flash 的“1/20 成本”对 AI 客服能复现吗?
A:不能直接复现。那个数字的基准是 WorkBuddy 办公任务评测集,覆盖 PPT、文档、表格、音视频处理。AI 客服的对话轮次、输入结构、输出长度和办公任务不同。但 Hy4 flash 的底层优势(激活参数少、输出压缩、缓存便宜)在客服场景同样成立,实际降本幅度取决于你的 prompt 结构和缓存命中率。拿真实客服对话跑一百条,算出来的账才可信。
Q:缓存命中 0.02 元,我的客服场景能吃到吗?
A:取决于你的 system prompt 设计。把商品政策、FAQ、退换货规则这些不变的内容放在 system prompt 里,每轮对话都作为前缀传入,缓存命中的概率高。如果你的 prompt 每轮都拼不同的商品信息、不同的用户历史,缓存命中率会低。先看你的 prompt 结构,再判断缓存能省多少。
Q:Hy4 flash 做多语言客服,泰语和印尼语质量怎么样?
A:官方没有公布客服场景的多语言实测数据。Hy4 flash 支持多模态和 1M 上下文,语言跟随能力理论上没问题,但“能说”和“说得得体”是两回事。东南亚市场的客服语气、敬语体系、文化禁忌,需要你用真实对话测试。黑五前用目标语言跑一轮评估,记录哪些回复需要人工修正,别等黑五当天才发现小语种回复不得体。
Hy4 flash 的定价确实把轻量模型的成本又往下压了一截,腾讯云国际 TokenHub 的接入方式对出海团队也友好。但 AI 客服的降本,核心从来不是“选一个单价最便宜的模型”,是把你的 prompt 结构、缓存策略、输出约束做好。这三件事不做,什么模型都省不下来。
黑五前最务实的动作:拿你最近一周的真实客服对话,按语言和问题类型分好,用 Hy4 flash 在 TokenHub 上跑一轮。记录回复质量、人工修改率、token 消耗。算出来的单条消息成本,比任何官方数字都可靠。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号