#WorkBuddy# PPT 改完文字又变回旧文案?拆开 pptx 才发现同一句话存了两份
原创
#WorkBuddy# PPT 改完文字又变回旧文案?拆开 pptx 才发现同一句话存了两份
原创
用户12911493
发布于 2026-11-20 17:36:08
发布于 2026-11-20 17:36:08
先说结论,省得你跟着踩:
一个 pptx 里的一句话,可能在 XML 里存了两份。一份是看得见的文字 run(<a:t>),另一份压在形状的 descr 属性里——那不是备注,是整页布局的 JSX 源码,文案、字号、坐标、颜色全在里面。
只改前一份,文件打开看着完全正常。等到谁按源码重渲染一次(导出 PDF、换主题、再让 AI 改一版),旧文案就原地复活,位置字号一模一样,你会以为自己在看缓存的旧文件。
下面是我拆真文件、跑真实验的全过程。
一、事情是怎么开始的
用 AI 生成了一份 26 页的汇报 PPT,交付前有几处措辞要改。常规做法:pptx 就是 zip,解开,正则替换 ppt/slides/slideN.xml 里的 <a:t> 标签内容,重新打包。
第一轮改完,打开 PowerPoint 逐页翻,字确实变了,位置也没跑。交出去。
第二轮要出 PDF,同时让 AI 按新文案重新渲染一版图。结果回来的是第一版的文案——不是我改错的那几句,是整个位置、字号、颜色都和改之前完全一致,像是我从来没动过。
这就不是"改漏了一句"的问题了,是"我改的那份根本不是它读的那份"。
二、先把文件当 zip 拆开
63 个条目。真正装文字的是 ppt/slides/slideN.xml,一页一个,纯文本,首页 36KB。剩下的 slideLayouts、theme、slideMasters 是壳。
用 Python 读首页,数一数文本 run:
18 段,没毛病。但紧接着我又数了个东西:descr=" 出现了几次。
6 次。
一页上有 6 个形状(或文本框)带着 descr 属性。把其中一个解出来看看:
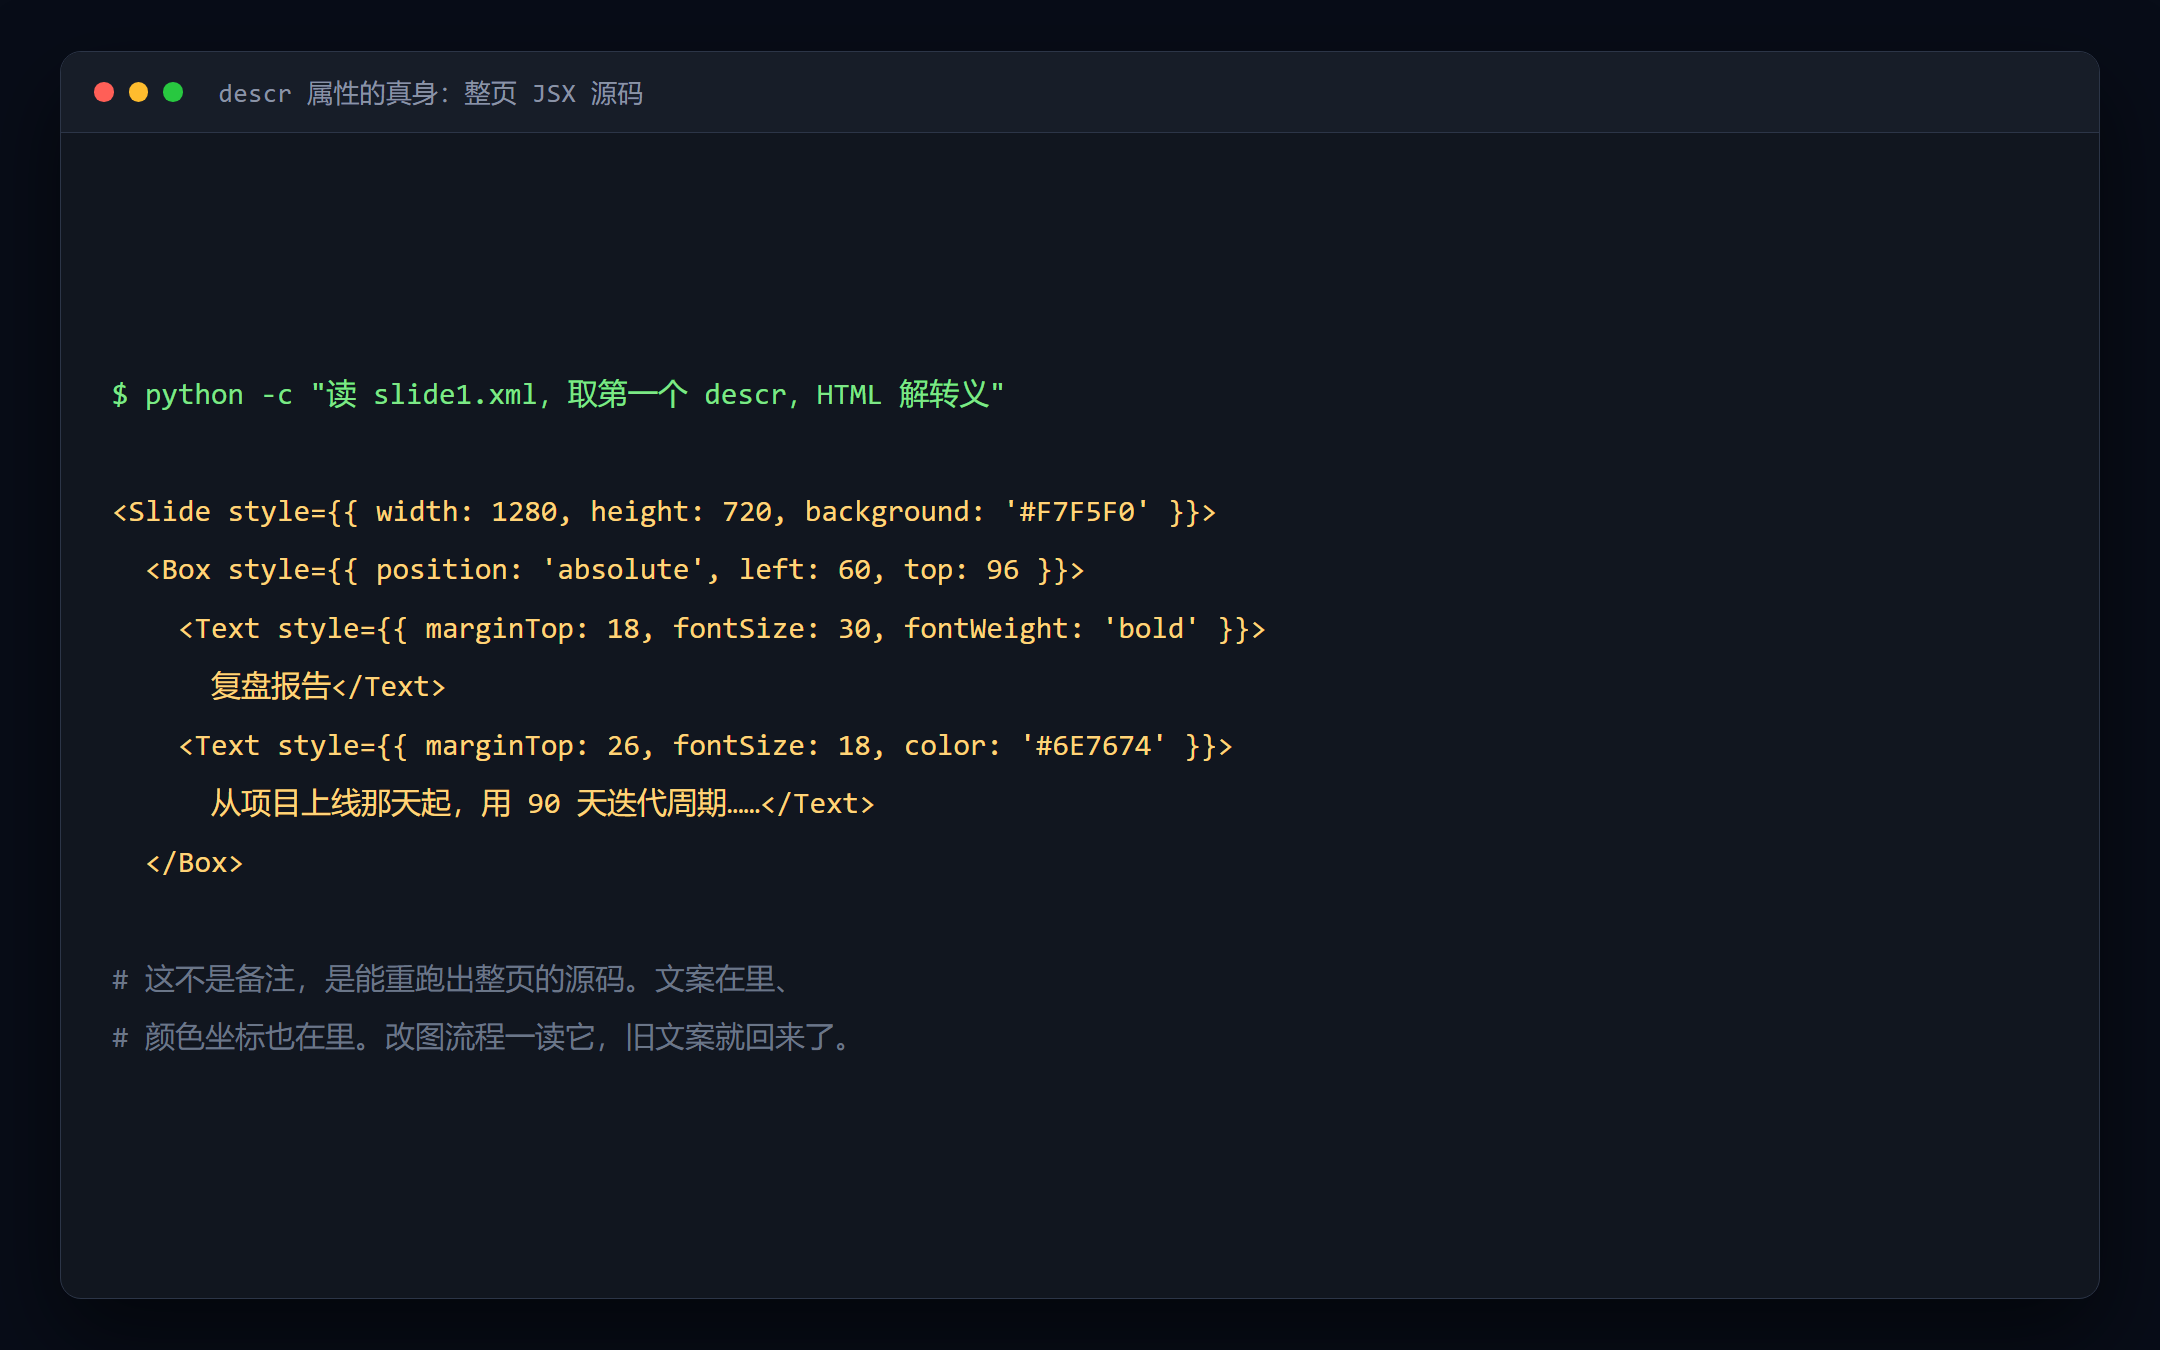
<Slide style={{ width: 1280, height: 720, background: '#F7F5F0' }}> 开头,往下是 <Box>、<Text> 一层层嵌套,文案直接用 JSX 写死在里面。整个首页的排版源码,一份不少地塞在 shape 的属性里。
到这一步谜底就清楚了一半:这份 PPT 是某个生成器「设计稿 → pptx」导出的,它把设计稿源码一起存进了文件,方便以后重新渲染。我改的是导出的结果,它读的是存下来的源码。
三、量化一下:一句话到底存了几份
别停在"大概有两份",得数准。写个探测脚本,对首页每句文案同时统计两个数:全文出现次数、run 层出现次数,差值就是 descr 层。
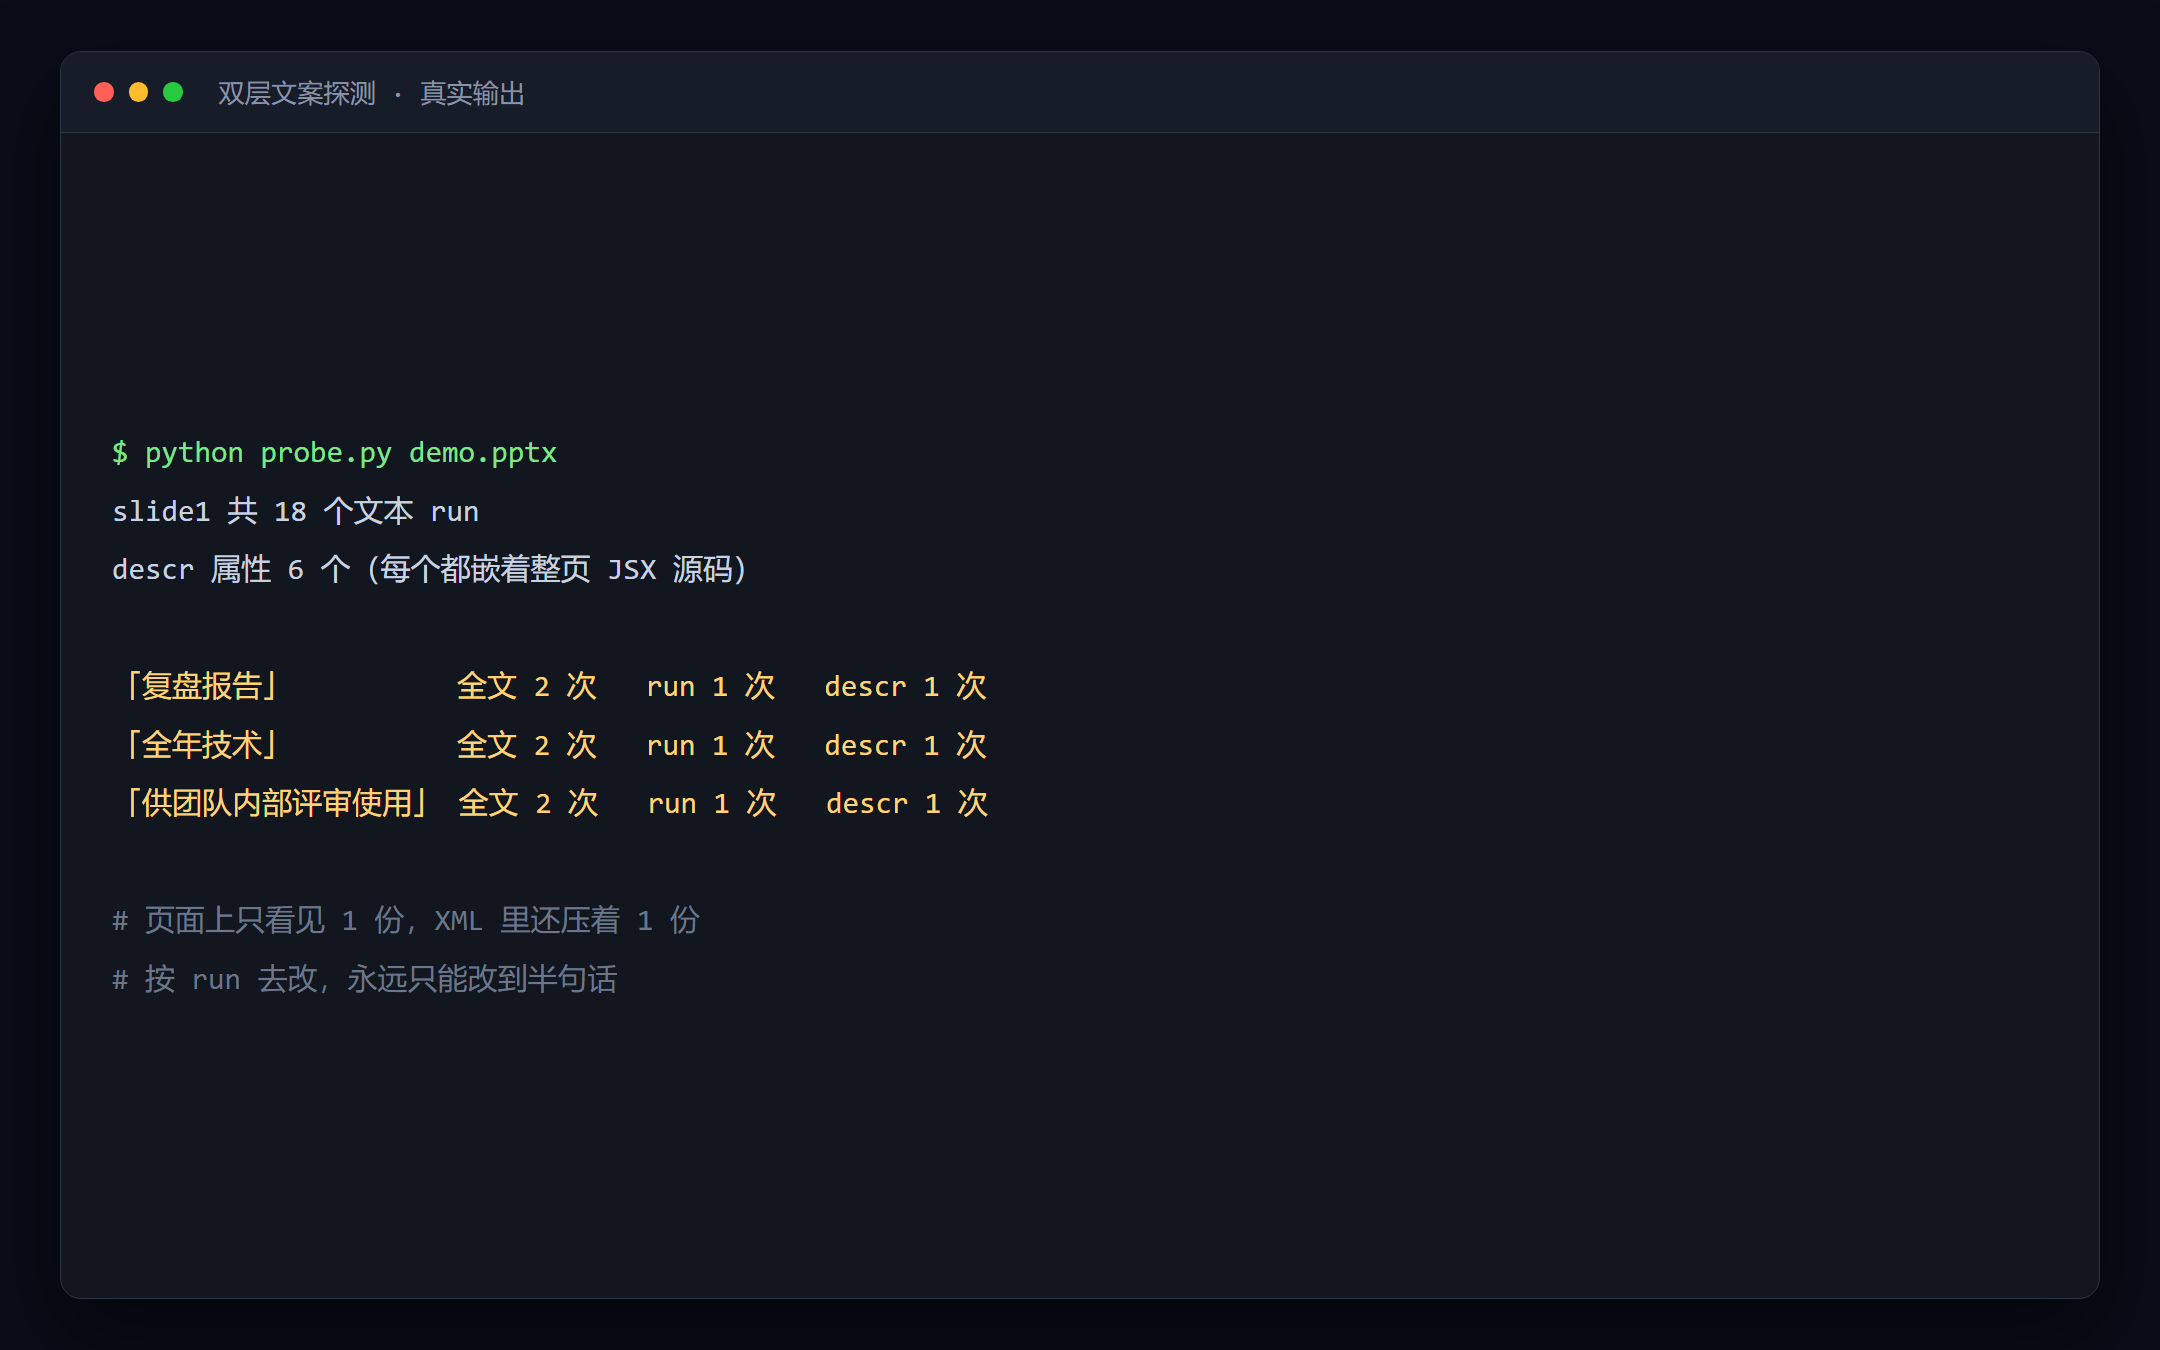
18 段文字里挑三句:
文案 | 全文 | run 层 | descr 层 |
|---|---|---|---|
复盘报告 | 2 | 1 | 1 |
全年技术 | 2 | 1 | 1 |
供团队内部评审使用 | 2 | 1 | 1 |
规律干净得让人发毛:页面上看得见的每一句,源码里都压着一份复制品。
这也解释了一个更隐蔽的现象——为什么有些"改完没生效"的反馈里,是部分文字变了、部分没变。改的时候命中的是 run 层,而 run 是按字体/颜色切的片段,一句话可能被切成三段(数字、标点、正文字体各不相同就会切开),你只替换到其中一段,看着就像"只改了一半"。
摸底:一次把整份文件扫干净
顺手做了全量统计,26 页的结果长这样:
项目 | 数量 |
|---|---|
页数 | 26 |
文本 run | 1071 |
descr 属性 | 342 |
带 descr 的页 | 26(页页都有) |
平均每页 13 个 descr。这个数字说明一件事:不是"某几页特殊",是这套导出机制的通例。所以替换逻辑必须全页覆盖,别只改你记得的那几页——第 21 页有 126 个 run,正是文案最密的一页,也是最容易漏的一页。
扫描脚本很短,改文件前先跑一遍,心里有底:
四、对照实验:只改 run 和双层替换差多少
同一份文件,同样的旧文案,跑两个版本。
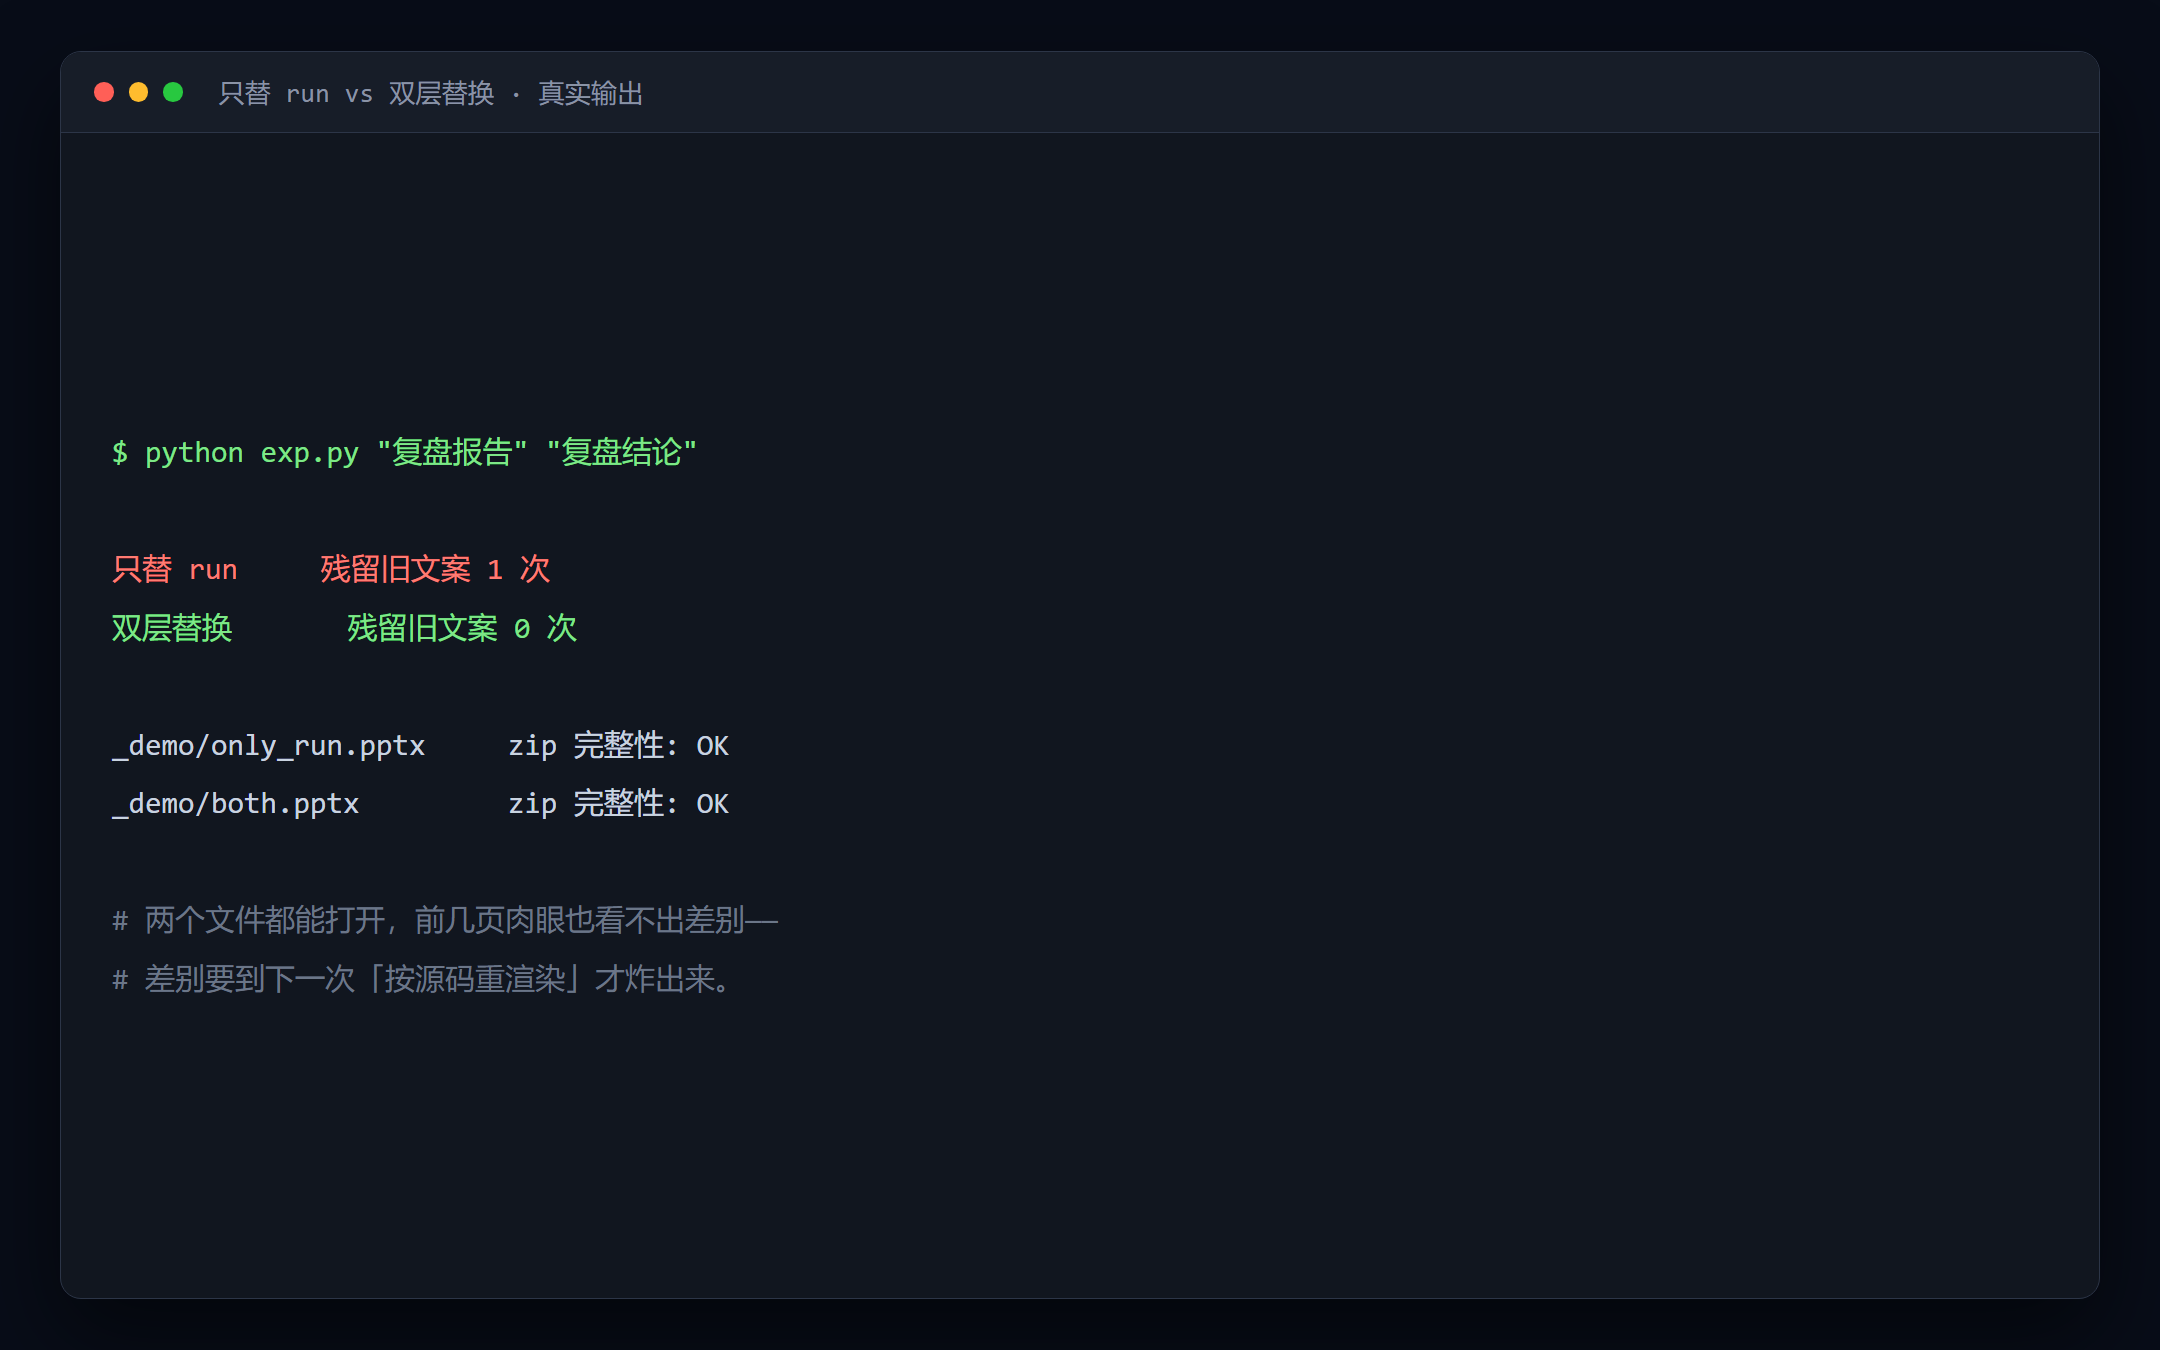
核心就两个动作:
只改第一层,残留 1 次;两层的都改,残留 0 次。
注意两个文件的 zip 完整性都是 OK,用 PowerPoint 打开也都正常,前几页肉眼根本看不出区别。这个 bug 不会在"打开"这一步暴露,只会在"重新生成"这一步暴露——这就是它最坑的地方,你验收的方式恰好绕过了它。
五、坑中坑:我的验证方法先骗了我一次
第一版脚本里,我写的新文案是「复盘报告(定稿)」。跑完一看:
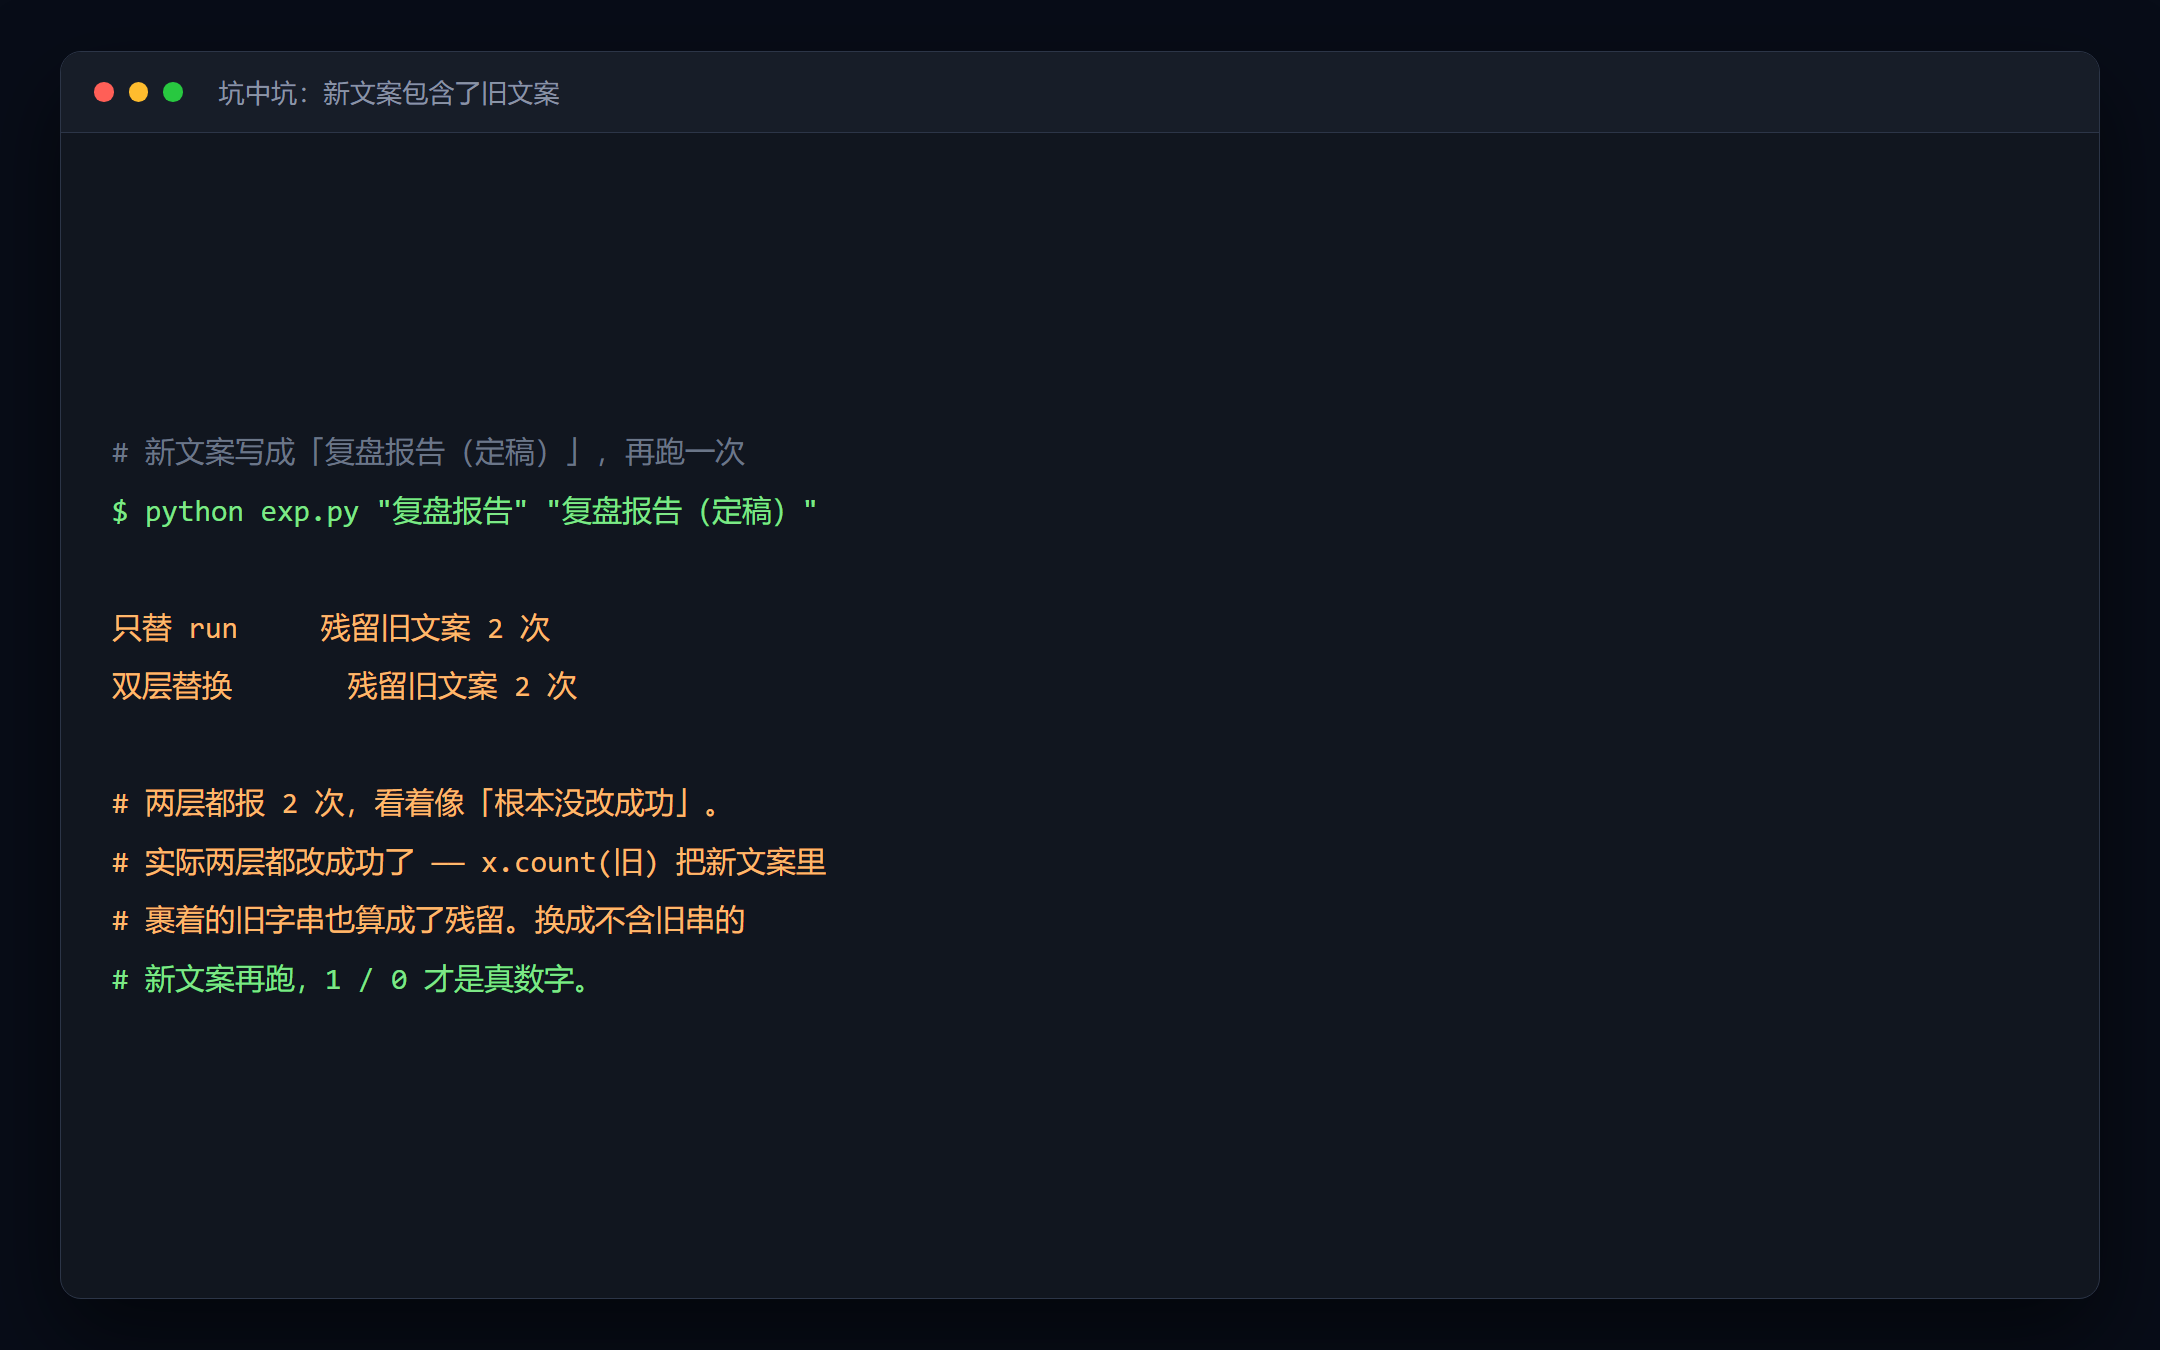
两层都显示残留 2 次。按当时的理解就是"两种改法全都没生效",差点掉头去查 zip 写入逻辑。
实际上两层都改成功了。问题在验证方法本身:
新文案包含旧文案时,count(旧) 永远清不了零。一条在新建的「复盘报告(定稿)」里,一条是没改到的真残留,两个数长得一模一样,光看数字分不出来。
换成不含旧串的新文案(「复盘结论」)再跑,1 / 0,真数字才出来。
这条记下来:验证脚本本身也要被验证。最省事的做法是换一个和旧文案没有包含关系的新词跑一遍,两次数一致才算数。
六、能直接用的脚本
把上面的东西收成一个脚本,加两条硬规则:旧文案必须彻底消失,一条都没命中就整体失败。
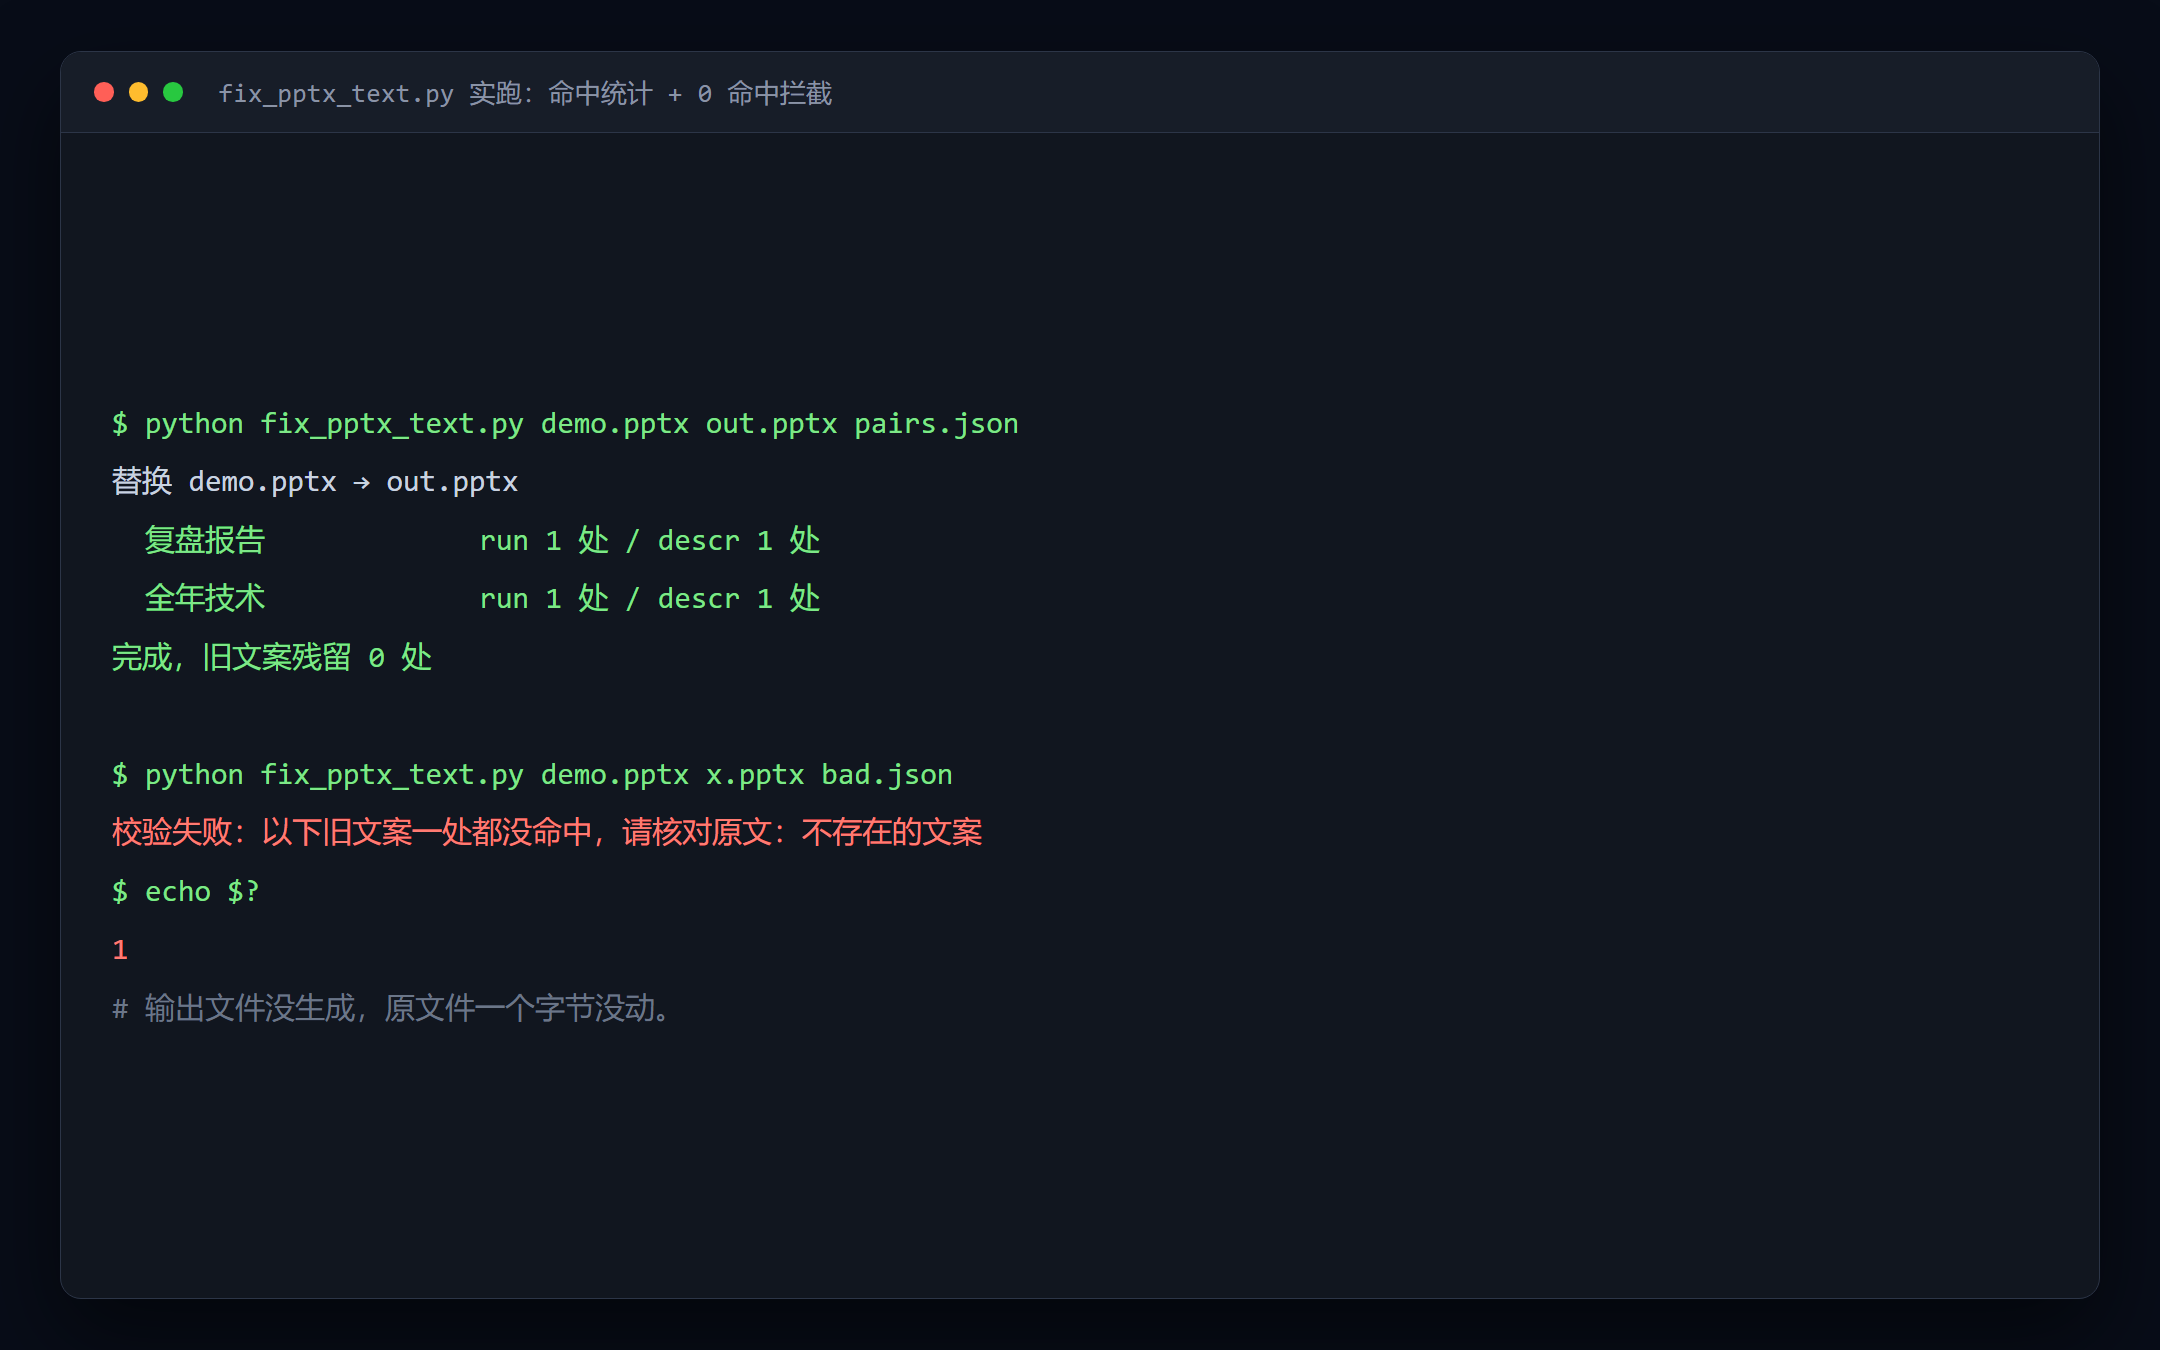
三条设计都是被坑出来的:
- 先写
.tmp,校验通过才 rename。中途任何一条不通,输出文件不存在,原文件一个字节没动。别在源文件上原地改。 - 0 命中要报错。这条最容易被忽略。我第一版没加,测的时候给了一条不存在的文案,脚本安安静静跑完、退出码 0、还生成了一个"改完了其实一个字没改"的文件。要是没发现,这文件就直接交出去了。
- 打印每条的命中分布。
run 1 处 / descr 1 处这种输出,一眼能看出双层是不是都命中了。只有 run 有数字、descr 是 0,说明这页的源码结构和你以为的不一样,别往下走。
七、还有两个容易漏的点
(1)<a:t> 别写成裸标签。
带 xml:space="preserve" 的 run 专放纯空格、数字、混排片段,裸标签正则完全匹配不到。这份样本恰好 18 个 run 都不带属性,换成别的文件就会漏,而漏掉的那几个正好是最容易被盯出来的数字。
(2)重打包时别重建 ZipInfo。
PowerPoint 对这个比想象中敏感。图片、字体那些二进制条目尤其经不起重新压一遍。
(3)整句替换 0 命中,八成是被切成了多段。
把首页那句长文案的 run 原样打出来,是这么切的:
一句话四段,中间那截纯数字单独成 run(数字走了等宽字体)。所以拿整句去替换,<a:t> 里根本找不到这一整串,命中 0。
处理办法有两个:一是按片段替换(把「 90 」这种最小单元写进替换表),二是先做一次"整页文本拼接 → 定位 → 反查所在 run"的映射。文案改动量小的时候,第一种够用;要批量改标题句式,值得写第二种。
八、交付前过一遍这个清单
- 源文件先复制一份
.bak,所有操作在副本上做 - 替换表用 JSON 存,别写在命令行里(中文和引号会被 shell 吃掉)
- 跑完看命中分布:每条都该有数字,run 和 descr 都该有
- 残留必须是 0,0 命中必须报错
- 用 PowerPoint 或 WPS 真打开一次,翻到改过的那几页
- 如果有"重新渲染"入口,一定重渲一次再看——只验证"打开正常"等于没验证
九、最后
这套东西不限于 pptx。任何"生成器把源码/配置写进文件元数据"的格式都有同一个陷阱:你看到的那份是产物,它实际读的那份可能藏在属性里。docx 的 w:document.xml 没有这个双层结构,但 Figma 导出、HTML 里的 data- 属性、SVG 的 data-name,逻辑是一样的。
真正费时间的从来不是"正则怎么写",而是"这个文件里到底有几份真话"。改之前先数一遍,比改完之后验三遍管用。
(文中的样本文件已脱敏,只保留结构,文案换成中性示例;所有数字都是在 26 页真实稿件首页上跑出来的。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号