零依赖实战:用 Python 标准库打造全国土拍成果监控看板
原创
零依赖实战:用 Python 标准库打造全国土拍成果监控看板
原创
用户12915571
发布于 2026-11-21 21:25:17
发布于 2026-11-21 21:25:17
摘要:本文用一个真实可运行的项目,演示如何仅靠 Python 标准库(不装 Flask、不装 requests、不装 pandas)完成“网页数据采集 → 清洗归并 → SQLite 入库 → 自动日报 → Web 看板”的全链路。重点讲解无头浏览器渲染、母公司归并、货值估算、定时调度以及桌面免密登录等工程细节,适合有一定 Python 基础、想快速搭建内部数据看板的开发者。
推荐标签:Python、数据采集、SQLite、数据可视化、Web 看板、定时任务
一、背景与目标
土地拍卖市场的信息分散在各地公共资源交易平台,格式不统一、更新不及时,人工整理耗时巨大。我们希望做一个“全国土拍成果监控”系统,能够:
- 每小时自动采集当日成交地块;
- 把拿地公司归并到母公司口径(例如“保利发展”和“保利(武汉)房地产有限公司”算同一家);
- 计算每幅地块的建筑面积、楼面价、估算货值;
- 每天 17:30 生成固定格式的日报(Excel + 网页);
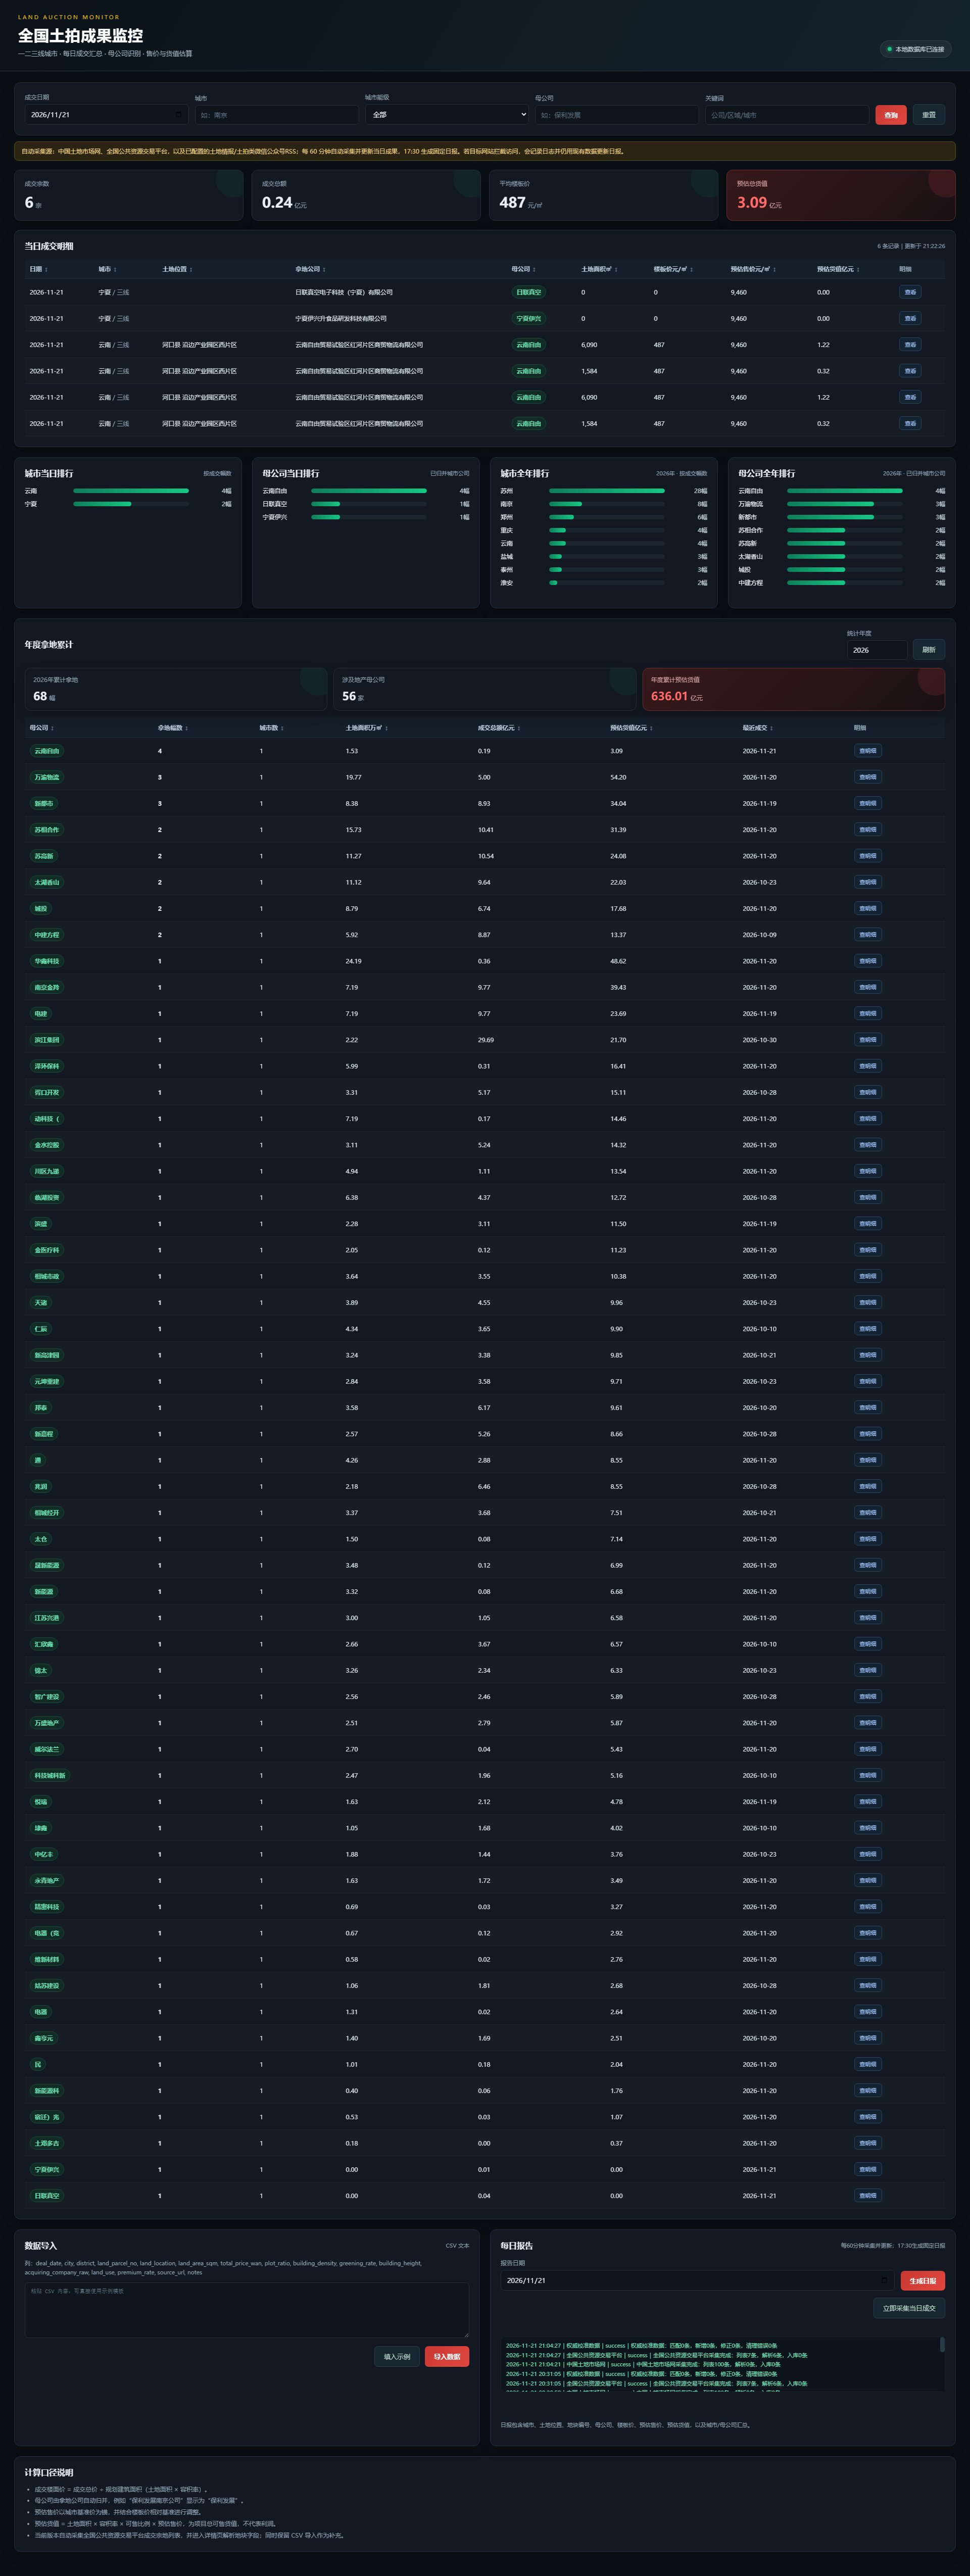
- 提供一个自适应宽屏 / iPad 的看板,四个排行榜一眼看清“谁在拿地、拿了哪里、花了多少钱”。
整个系统部署在一台轻量应用服务器上,本地只需一个浏览器即可访问。
二、最终效果
三、技术架构
┌───────────────┐   无头浏览器渲染   ┌────────────────┐
│ 公共资源交易网 │ ────────────────→ │ collector.py   │
└───────────────┘                    │  DOM + 正则兜底 │
                                     └───────┬────────┘
                                             │ 标准化 / 归并
                                             ↓
┌───────────────┐   SQLite 读写       ┌────────────────┐
│   land.db     │ ←────────────────── │  app.py 服务   │
│ deals/logs    │                     │ http.server    │
└───────────────┘                     └───────┬────────┘
                                             │ JSON API
                                             ↓
                                     ┌────────────────┐
                                     │ 原生前端看板   │
                                     │ HTML/CSS/JS    │
                                     └────────────────┘
技术选型说明:
- Web 服务:
http.server.ThreadingHTTPServer,零第三方依赖,单文件即可启动。 - 存储:SQLite 标准库
sqlite3,单文件数据库,备份就是复制land.db。 - 采集:
collector.py调用 Edge/Chrome 无头模式渲染目标页面,再用 DOM 表格解析 + 正则兜底提取字段。 - 配置:所有密码、token、城市别名、归并规则、监测关键词都放在
config.json,改配置不改代码。 - Excel 导出:
xlsx_writer.py用zipfile+ 手写 OOXML 生成 xlsx,不依赖 openpyxl。
四、核心实现
4.1 无头浏览器渲染与表格解析
公共资源交易网站通常是动态渲染的,直接 urlopen 拿不到表格。我们的做法是:先找本机 Edge/Chrome,用无头模式把页面渲染完成后再抓 DOM。
def find_edge_executable():
    candidates = [
        r"C:\Program Files (x86)\Microsoft\Edge\Application\msedge.exe",
        r"C:\Program Files\Microsoft\Edge\Application\msedge.exe",
    ]
    for p in candidates:
        if os.path.exists(p):
            return p
    return None

def render_page(url, wait_ms=9000):
    exe = find_edge_executable()
    cmd = [exe, "--headless", "--disable-gpu", "--dump-dom",
           "--virtual-time-budget=%d" % wait_ms, url]
    out = subprocess.run(cmd, capture_output=True, timeout=60).stdout
    return out.decode("utf-8", errors="ignore")
拿到 HTML 后优先用 DOM 表格解析,解析失败再用正则兜底:
def parse_ggzy_table(html):
    rows = []
    for tr in re.findall(r"<tr[^>]*>(.*?)</tr>", html, re.S):
        cells = [re.sub(r"<[^>]+>", "", td).strip()
                 for td in re.findall(r"<t[dh][^>]*>(.*?)</t[dh]>", tr, re.S)]
        if len(cells) >= 5:
            rows.append(cells)
return rows踩坑提醒:部分网站的表格由前端框架生成,--dump-dom 抓到的是渲染后的结果,所以 wait_ms 不能太小;但太大又会拖慢采集,实测 9000ms 比较稳妥。
4.2 母公司归并
拿地主体经常是项目公司,需要归并到母公司口径。我们在 config.json 里维护一张别名表:
{
  "parent_rules": {
    "保利发展": ["保利", "保利(", "保利地产"],
    "中海地产": ["中海", "中海地产集团"],
    "招商蛇口": ["招商蛇口", "招商局"]
  }
}
归并逻辑很简单:按关键词顺序匹配,命中即归母:
def normalize_parent(company):
    for parent, keys in CONFIG["parent_rules"].items():
        for k in keys:
            if k in company:
                return parent
    return company
这样即使“保利(武汉)房地产有限公司”和“保利发展控股集团”同时出现,看板上也只显示“保利发展”。
4.3 货值估算算法
每幅地块的楼面价与估算货值是看板的核心指标。calc_deal(row) 的逻辑如下:
def calc_deal(row):
    land_area = float(row["land_area"])        # 土地面积㎡
    plot_ratio = float(row["plot_ratio"])      # 容积率
    total_price_wan = float(row["total_price_wan"])  # 总价万元
    building_area = land_area * plot_ratio     # 计容建面
    floor_price = total_price_wan * 10000 / building_area  # 楼面价元/㎡
    baseline = CONFIG["city_baseline"][row["city"]]  # 城市基准房价
    factor = min(2.0, max(0.5, floor_price / baseline))
    estimated_price = baseline * (CONFIG["baseline_weight"] +
                                  CONFIG["land_weight"] * factor)
    goods_value_wan = row["saleable_area"] * estimated_price / 10000
    return floor_price, estimated_price, goods_value_wan
这里用一个“基准房价 + 楼面价修正系数”的简化模型,避免引入复杂的市场数据;权重在配置里可调,方便按城市微调。
4.4 日报生成与定时调度
generate_report(report_date) 从 SQLite 汇总当日数据,调用 xlsx_writer 生成 Excel,同时把摘要写入 daily_reports 表供网页展示。
DailyScheduler 是一个轻量调度器:
class DailyScheduler:
    def __init__(self):
        self.last_run = None

    def tick(self):
        now = datetime.now()
        if now.hour == 17 and now.minute >= 30:
            if self.last_run != now.date():
                generate_report(now.date())
                self.last_run = now.date()
采集调度同理,每 60 分钟执行一次 collect_today()。主线程里用一个后台线程循环调用 tick(),不影响 HTTP 服务响应。
4.5 后端鉴权与免密登录
系统有密码登录(AUTH_PASSWORD),同时为桌面快捷方式提供 token 免密入口:
AUTH_TOKEN = hashlib.sha256(
    ("land-monitor|" + AUTH_PASSWORD).encode()
).hexdigest()
AUTO_LOGIN_TOKEN = CONFIG.get("auto_login_token", "")
在 do_GET() 中处理 /auto-login:
if path == "/auto-login":
    token = params.get("token", [""])[0]
    if AUTH_ENABLED and AUTO_LOGIN_TOKEN and token == AUTO_LOGIN_TOKEN:
        self.redirect("/", extra_headers={
            "Set-Cookie": AUTH_COOKIE + "=" + AUTH_TOKEN +
            "; Path=/; HttpOnly; SameSite=Lax; Max-Age=604800"
        })
    else:
        self.send_json({"error": "invalid token"}, 403)
    return
Cookie lm_auth 有效期 7 天,用户点一次快捷方式即可长期免登录。
4.6 前端四排行布局
HTML 中用一个 section.chart-grid.rank-grid 包裹四个排行卡片。CSS 关键规则:
main {
  width: 100%;
  max-width: 1920px;
  margin: 0 auto;
  padding: 22px 28px 48px;
}

.chart-grid.rank-grid {
  grid-template-columns: repeat(4, 1fr);
}

@media (max-width: 1400px) {
  .chart-grid.rank-grid { grid-template-columns: repeat(2, 1fr); }
}
@media (max-width: 760px) {
  .chart-grid.rank-grid { grid-template-columns: 1fr; }
}
@media (min-width: 761px) and (max-width: 1366px) {
  .chart-grid, .bottom-grid { grid-template-columns: repeat(2, 1fr); }
}
注意 .chart-grid.rank-grid 的写法:它比单独的 .chart-grid 优先级更高,避免被通用媒体查询覆盖。
五、部署上线
- 把项目目录上传到服务器
/opt/land-monitor。 - 安装 systemd 服务文件(示例):
[Unit]
Description=Land Monitor
After=network.target

[Service]
WorkingDirectory=/opt/land-monitor
ExecStart=/usr/bin/python3 /opt/land-monitor/app.py
Restart=always

[Install]
WantedBy=multi-user.target- 启动并验证:
systemctl daemon-reload
systemctl enable --now land-monitor
systemctl status land-monitor- 配置防火墙放行 8765 端口即可访问。
六、踩坑记录
问题 | 原因 | 解决 |
|---|---|---|
桌面快捷方式打开资源管理器 | bat 在 if exist (...) 块内用 %URL%,解析阶段就展开为空 | 启用 setlocal enabledelayedexpansion,改用 !URL! |
采集到的表格为空 | 页面动态渲染未完成 | 增大 --virtual-time-budget,或用 DOM 解析替代正则 |
排行模块在 iPad 上错乱 | 通用 .chart-grid 的 1fr 规则覆盖了排行规则 | 用更高特异性的 .chart-grid.rank-grid |
Excel 打不开 | 手写 OOXML 少写了 Content_Types | 用 zipfile.writestr 补全 [Content_Types].xml |
七、总结
这个项目证明了一个观点:很多内部数据看板并不需要复杂框架。Python 标准库 + SQLite + 原生前端,就能完成从采集到可视化的闭环。如果你也想做类似系统,建议按这个顺序推进:
- 先把采集跑通,哪怕只抓一个网站;
- 再设计数据结构和归并规则;
- 然后做 Web API 和简单看板;
- 最后加定时调度和部署。
完整源码已在本地工作区整理好,你可以直接替换配置中的城市基准价和归并规则来适配自己的业务。
安全提示:公开发布教程时,请把密码、token、服务器 IP 替换为占位符,例如
<你的密码>、<你的auto_login_token>、<服务器公网IP>,不要泄露真实凭证。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号