DolphinDB 端到端延迟实战:逐跳测量、延迟瀑布与预算分配
原创
DolphinDB 端到端延迟实战:逐跳测量、延迟瀑布与预算分配
原创
Xxtaoaooo
修改于 2026-11-21 21:41:41
修改于 2026-11-21 21:41:41
摘要
每个 IoT 平台的运维都接过这个问题:"为什么看板上的数比现场慢了两分钟?"
更委屈的是做平台的人:流计算引擎的延迟明明是毫秒级的,数据进来到告警输出,几毫秒完事。引擎 5 毫秒,端到端 2 分钟,中间那 1 分 59 秒去哪了?
答案是:延迟不是藏在数据库里,是藏在链路的每一跳里。从传感器到看板,数据要走完一整条链:采集周期、网关缓冲、网络传输、写入攒批、引擎计算、订阅分发、看板刷新——每一跳都加一段等待,而其中数据库内部的计算,往往只占端到端预算的百分之一。盯着引擎优化到微秒级,端到端一秒都省不出来。
所以延迟优化的正确姿势不是"哪里慢优化哪里"的直觉反应,而是一套预算游戏:把链路拆成跳、给每一跳打时间戳、画出延迟瀑布找出大头、按目标分配预算、把杠杆花在占预算最多的跳上。
本文按这个顺序完整走一遍。核心主张一句:先测量,后优化——不占预算的跳,优化了也白优化。
一、先把链路拆成跳
1.1 六跳模型
一条数据从传感器到看板,标准路径拆成六跳:
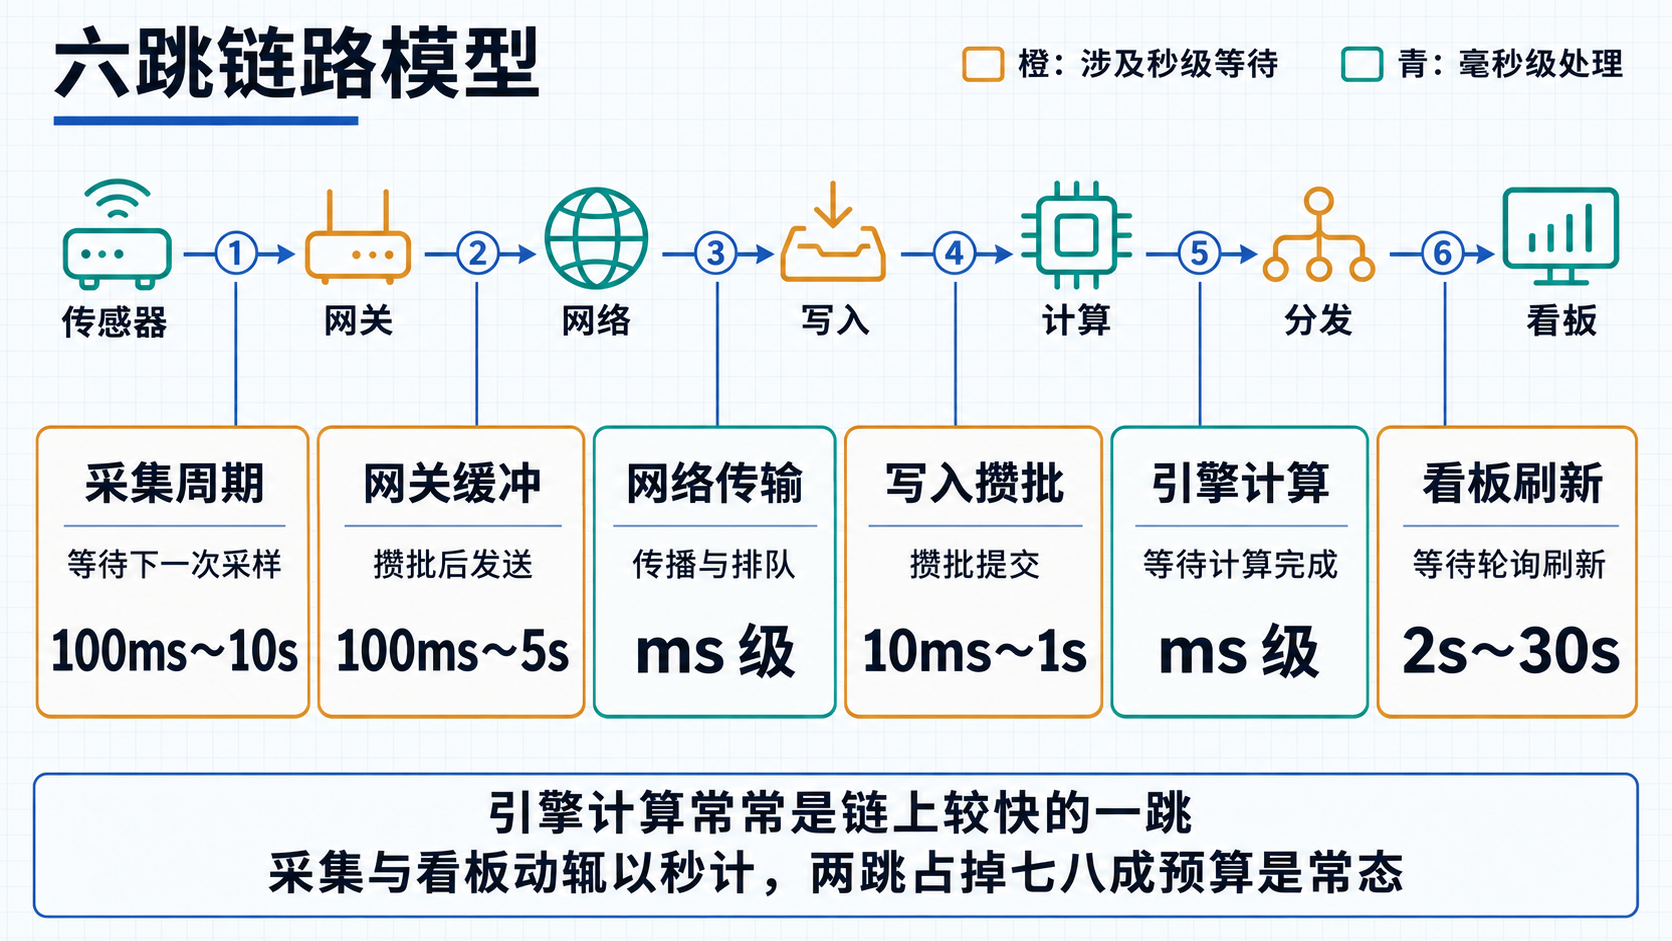
传感器 ──①──▶ 网关 ──②──▶ 网络 ──③──▶ 写入 ──④──▶ 计算 ──⑤──▶ 分发 ──⑥──▶ 看板
      采集周期        传输            攒批           引擎          订阅         刷新
跳 | 名称 | 等什么 | 典型量级 |
|---|---|---|---|
① | 采集周期 | 传感器到下一个采样点 | 100ms ~ 10s |
② | 网关缓冲 | 网关攒够一批再发 | 100ms ~ 5s |
③ | 网络传输 | 链路传播与排队 | ms 级(内网) |
④ | 写入攒批 | 数据库端攒批提交 | 10ms ~ 1s |
⑤ | 引擎计算 | 流引擎算完输出 | ms 级 |
⑥ | 看板刷新 | 看板下一次轮询拉数 | 2s ~ 30s |
1.2 大头通常不在数据库
把这张表竖着看一遍就会发现:引擎计算(⑤)常常是整条链上较快的一跳,而采集周期(①)和看板刷新(⑥)动辄以秒计——这两跳加起来占掉端到端预算的七八成是常态。
这就是"引擎 5 毫秒、看板慢 2 分钟"的真相:一分钟在采集和网关缓冲里,一分钟在看板刷新里,引擎贡献的那几毫秒在误差线以内。不把六跳拆开测量,这个问题永远只能吵架不能回答。
二、测量先行:给每一跳打时间戳
2.1 时间戳体系
测量的前提是每一跳的边界有时刻记录。四个关键时刻:
- ts(数据时刻):传感器采样的时刻——一切延迟的基准
- gatewayTs(网关时刻):网关发出这批数据的时刻
- writeTs(写入时刻):数据落进流表的时刻
- queryTs(查询时刻):看板拉取数据的时刻(从看板查询日志取)
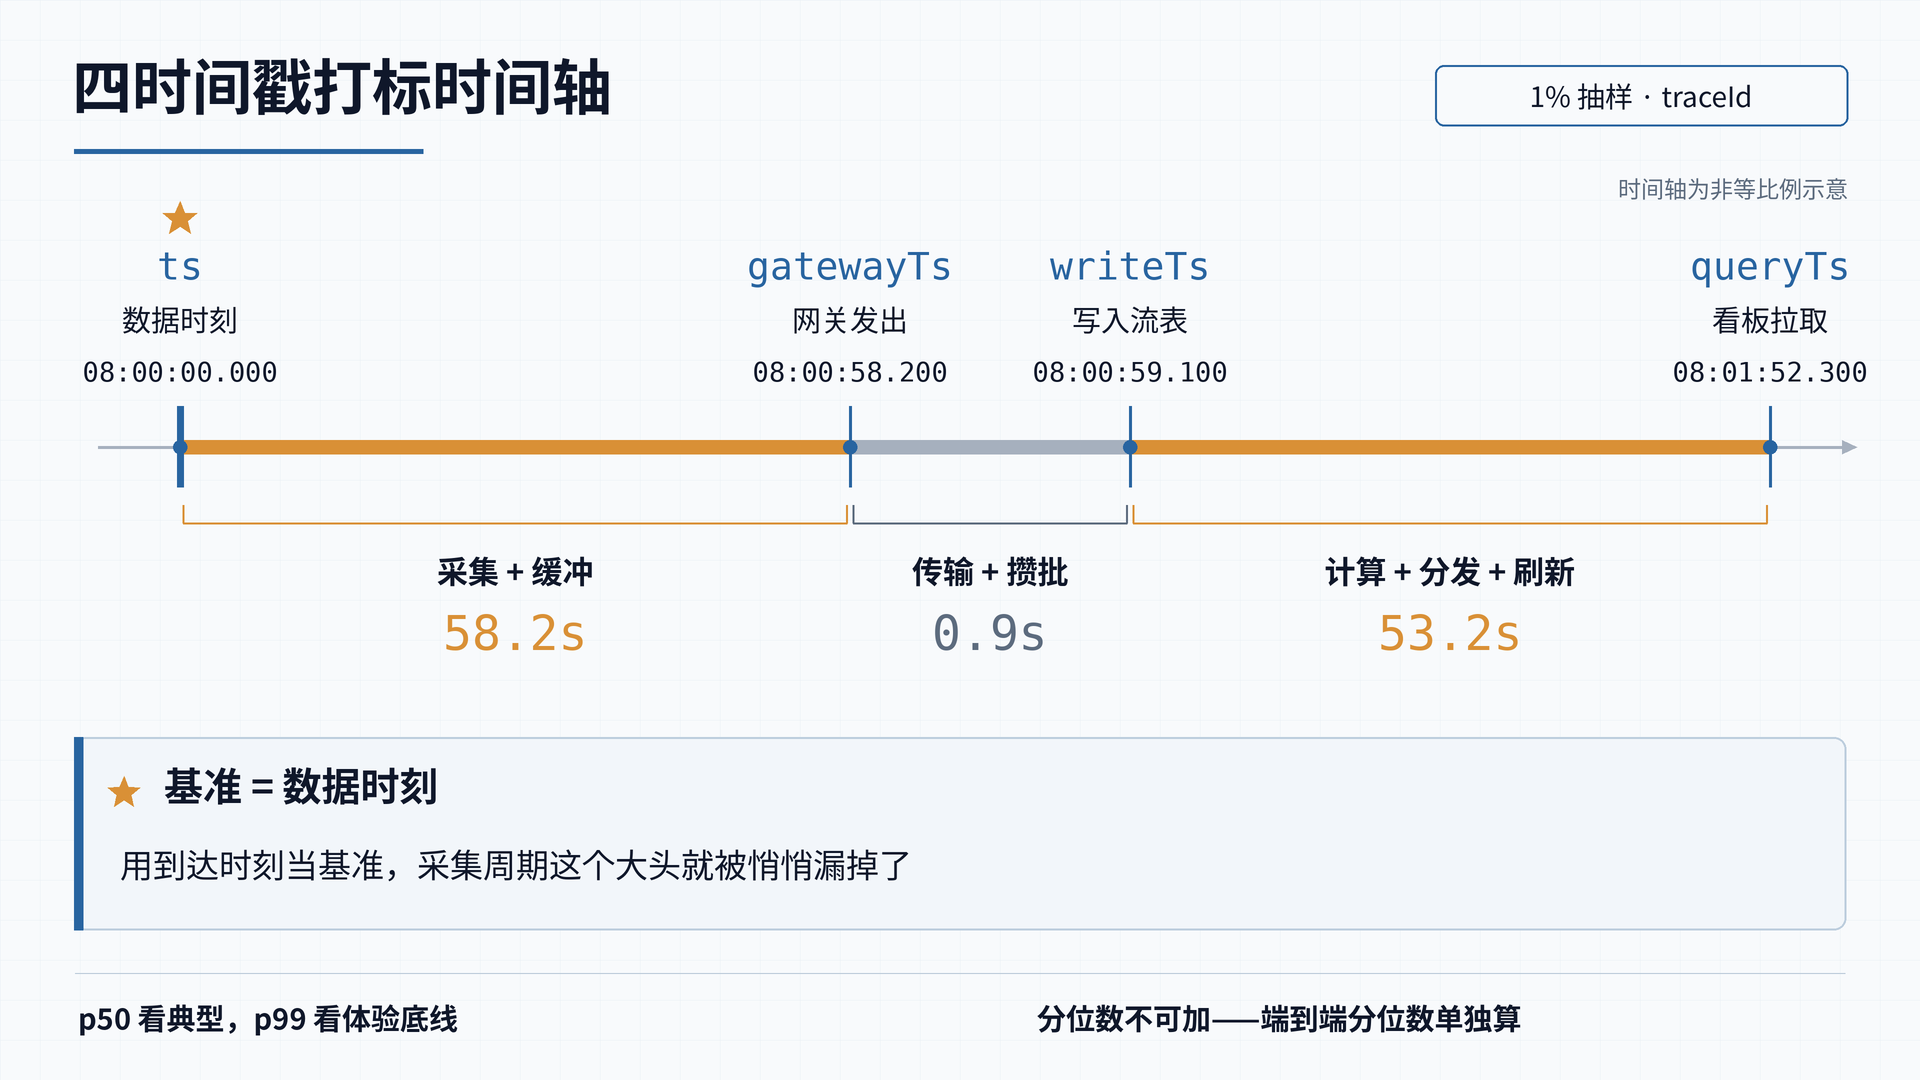
相邻时刻的差就是各跳延迟。基准必须是数据时刻——用到达时刻当基准,会把采集周期悄悄漏掉,而那恰恰是大头。
2.2 采样打标,不是全量打标
给每条数据都带全套时间戳太重。工程做法是抽样打标:网关对 1% 的数据附加完整的时刻链,下游各环节透传这些字段,落进一张追踪表:
// 延迟追踪表(1% 抽样)
trace = table(1:0,
    `traceId`ts`gatewayTs`writeTs`queryTs,
    [LONG, TIMESTAMP, TIMESTAMP, TIMESTAMP, TIMESTAMP])
2.3 延迟分解与分布统计
// 各跳延迟 = 相邻时刻差
hops = select traceId,
    gatewayTs - ts             as hop_collect_ms,   // ①+② 采集+网关缓冲
    writeTs   - gatewayTs      as hop_ingest_ms,    // ③+④ 传输+写入攒批
    queryTs   - writeTs        as hop_serve_ms      // ⑤+⑥ 计算+分发+看板刷新
from trace

// 每跳的均值与分位数——p50 看典型,p99 看体验底线
stats = select
    avg(hop_collect_ms)              as collect_avg,
    pctile(hop_collect_ms, 50)       as collect_p50,
    pctile(hop_collect_ms, 99)       as collect_p99,
    avg(hop_ingest_ms)               as ingest_avg,
    pctile(hop_ingest_ms, 99)        as ingest_p99,
    avg(hop_serve_ms)                as serve_avg,
    pctile(hop_serve_ms, 99)         as serve_p99
from hops统计口径的两个纪律:
- 看 p50 也看 p99:p50 回答"典型多快",p99 回答"最差能多差"。看板慢两分钟的抱怨,往往对应的是 p99——平均数把长尾平均掉了,用平均值汇报延迟,等于把用户抱怨的那部分体验藏起来
- 分位数相加不等于总分位数:各跳 p99 加起来通常高估端到端 p99(长尾很少同时发生)。端到端的分位数要单独算:
pctile(queryTs - ts, 99)
三、延迟瀑布:找出大头
3.1 瀑布数据
把各跳延迟按占比排出来,就是延迟瀑布:
// 各跳占端到端的比例
waterfall = select
    avg(hop_collect_ms) \ avg(queryTs - ts)   as collect_share,
    avg(hop_ingest_ms)  \ avg(queryTs - ts)   as ingest_share,
    avg(hop_serve_ms)   \ avg(queryTs - ts)   as serve_share
from hops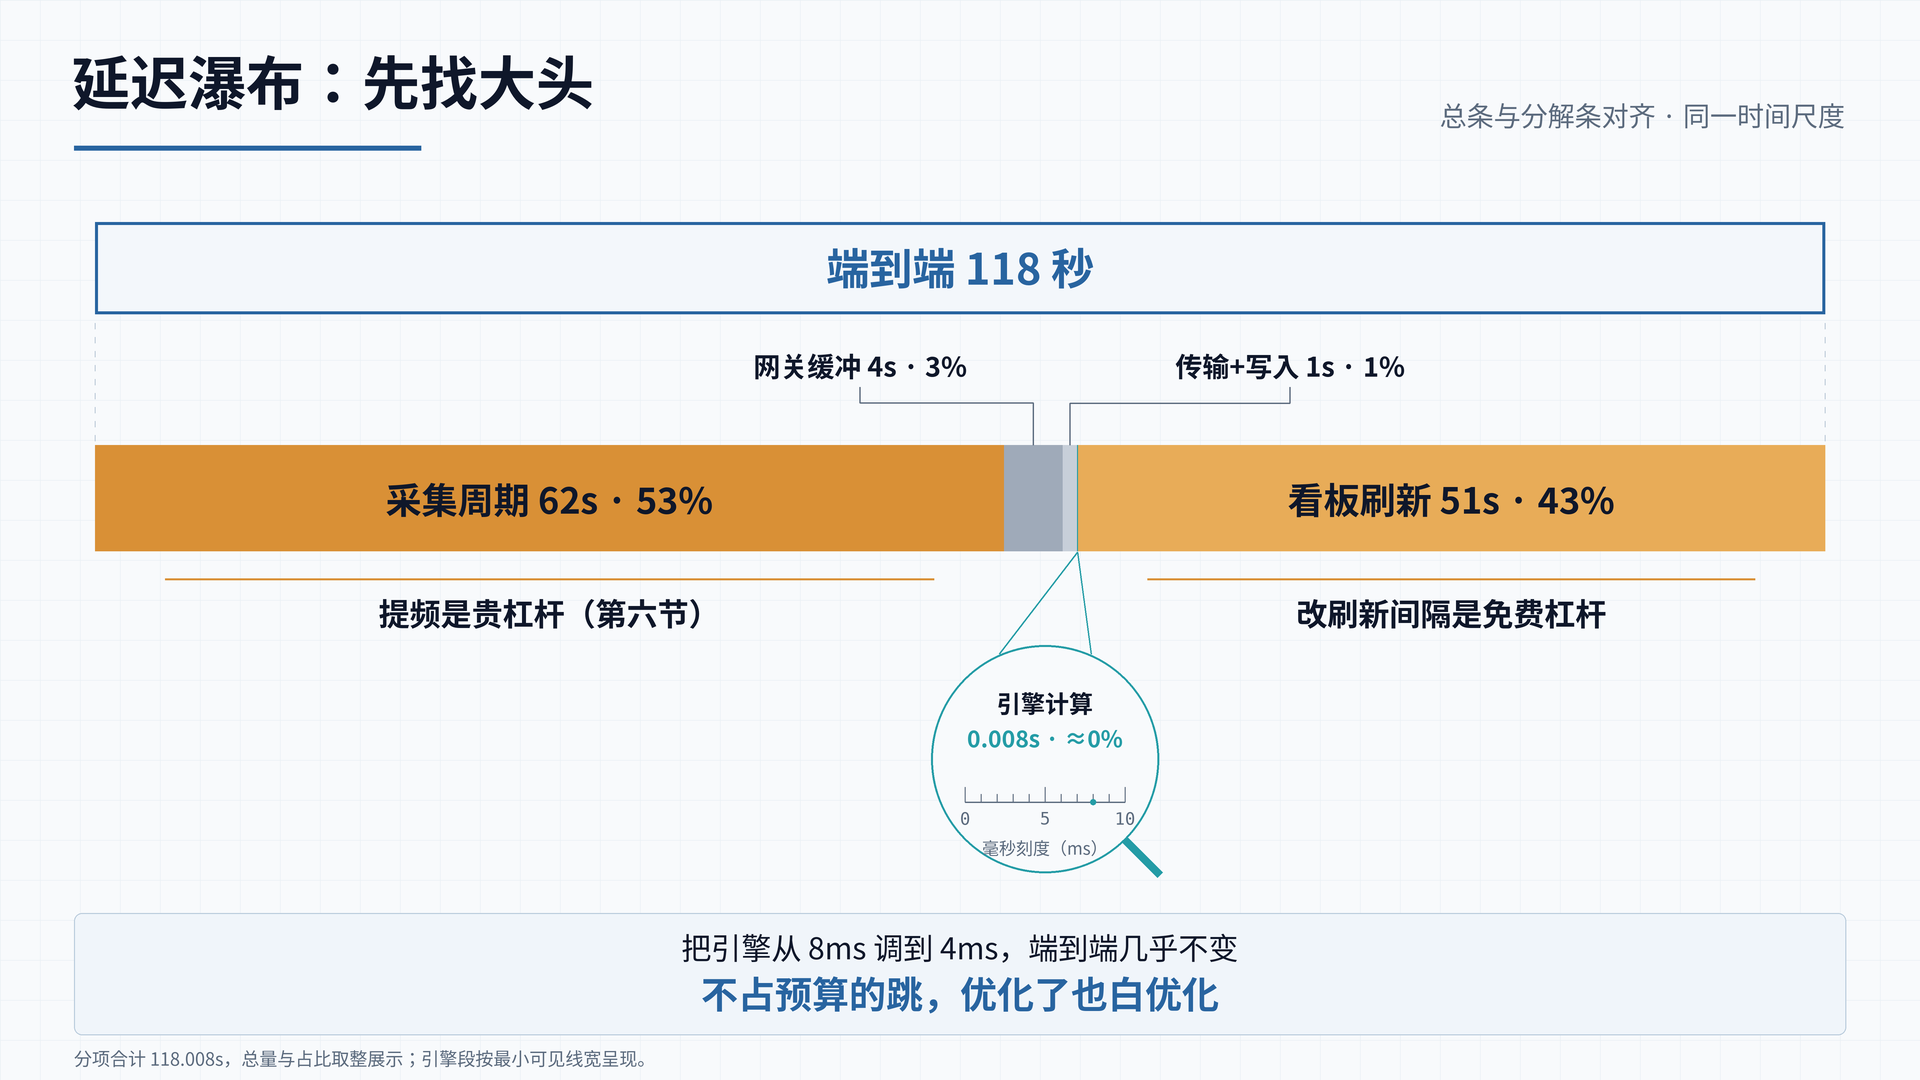
一个真实感十足的瀑布长这样:
端到端 118 秒
├── 采集周期        62s   (53%)  ← 传感器 60 秒一轮
├── 网关缓冲         4s   (3%)
├── 传输+写入攒批    1s   (1%)
├── 引擎计算      0.008s  (≈0%)  ← 毫秒级,误差线以内
└── 看板刷新        51s   (43%)  ← 看板 60 秒轮询一次
3.2 结论往往出乎直觉
这个瀑布的两个大头——采集周期和看板刷新——都不在数据库里。优化方向因此一目了然:
- 采集 60 秒一轮是业务/硬件约束(电池供电传感器、仪表通信周期),能不能提频要算成本(第六节)
- 看板 60 秒轮询是配置问题,改刷新间隔或换推送,一行配置的事
而如果当初不测量、凭直觉去"优化数据库"——把引擎从 8ms 调到 4ms——端到端纹丝不动。不占预算的跳,优化了也白优化,这是延迟核算的头号纪律。
四、预算分配:目标倒推
4.1 从目标分到每一跳
假设业务要求"现场发生,看板 10 秒内可见",预算从 10 秒倒推分配:
跳 | 预算 | 依据 |
|---|---|---|
采集周期 | 2s | 传感器提频到 2 秒一轮(需评估成本) |
网关缓冲 | 1s | 网关攒批窗口压到 1 秒 |
传输+写入 | 1s | 内网传输 ms 级,攒批留 1 秒 |
引擎计算 | 0.1s | 毫秒级,预算宽裕 |
分发+看板 | 5s | 看板轮询改 5 秒(或换推送省掉) |
合计 | 9.1s | 留 0.9s 余量给长尾 |
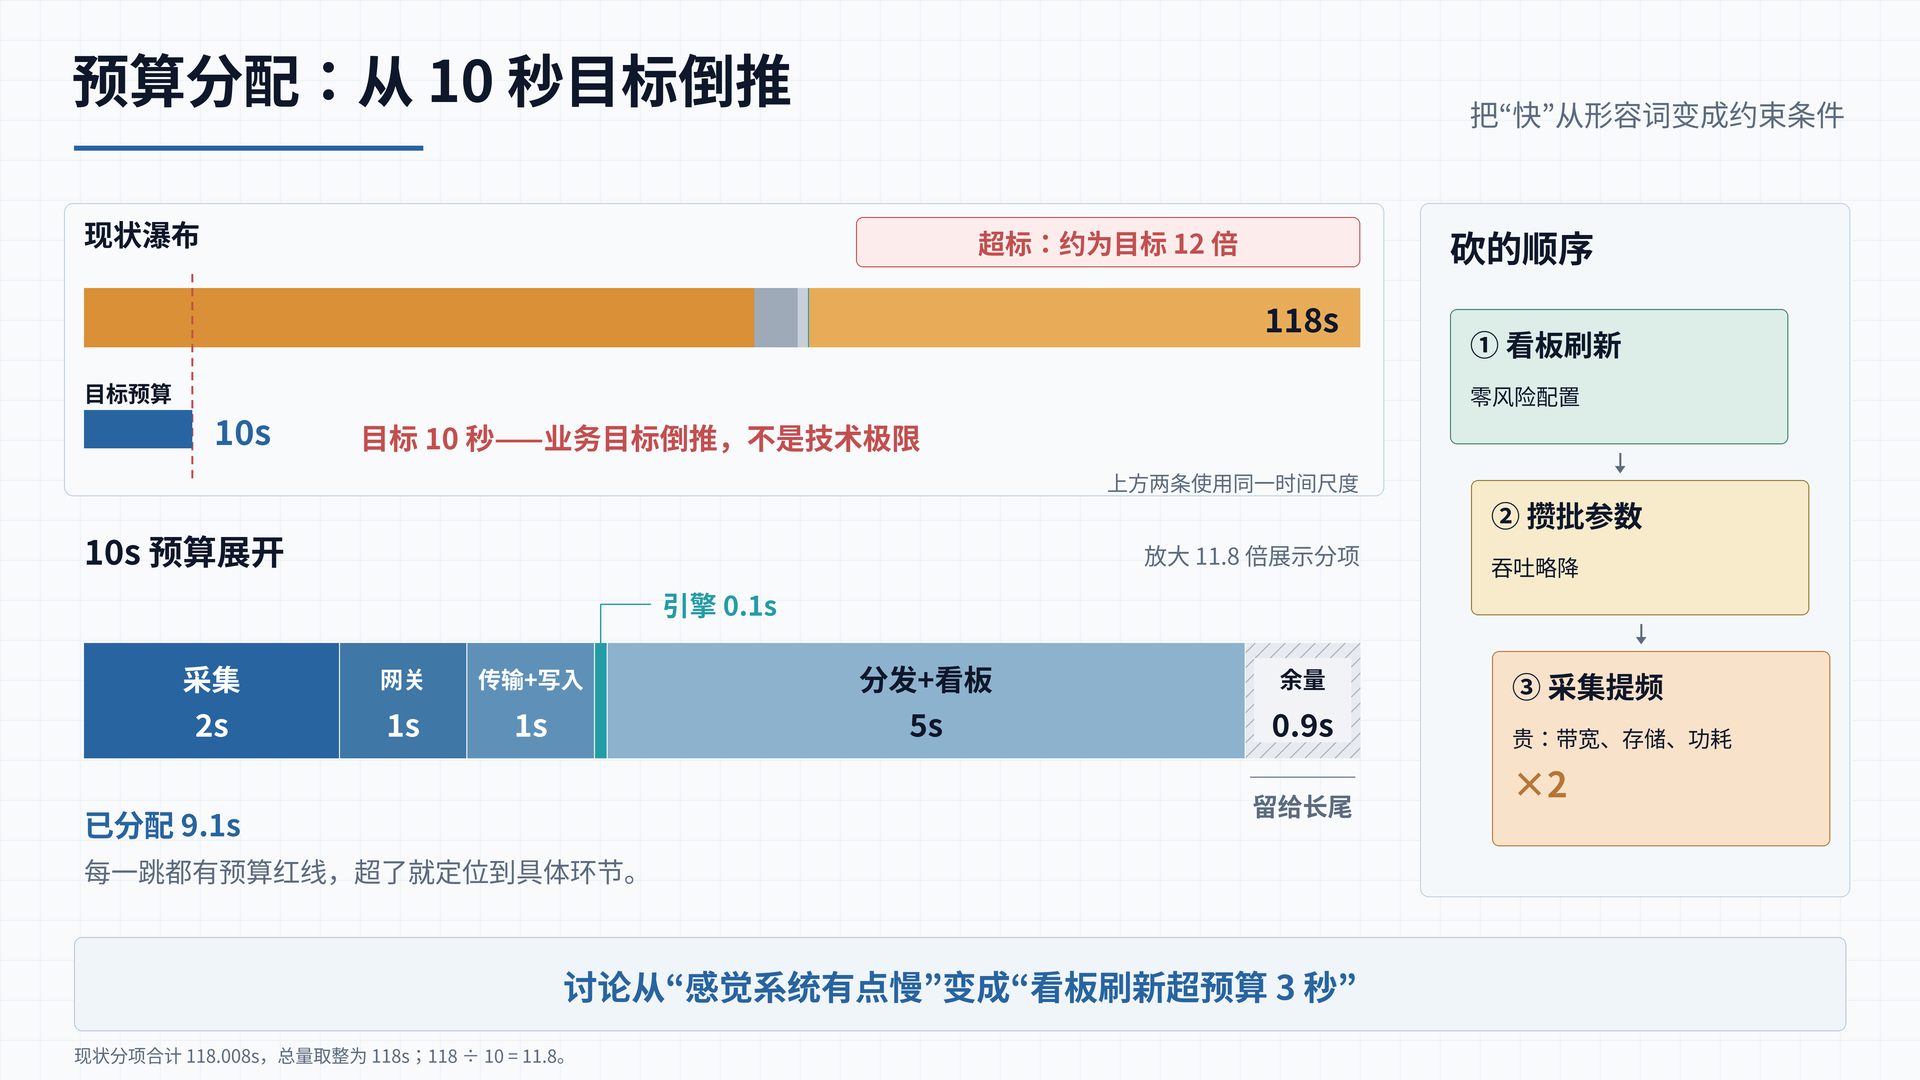
预算表的价值在于把"快"从形容词变成约束条件:每一跳都有了明确的红线,哪跳超了找哪跳,讨论从"感觉系统有点慢"变成"看板刷新超预算 3 秒"。
4.2 超预算了砍哪里
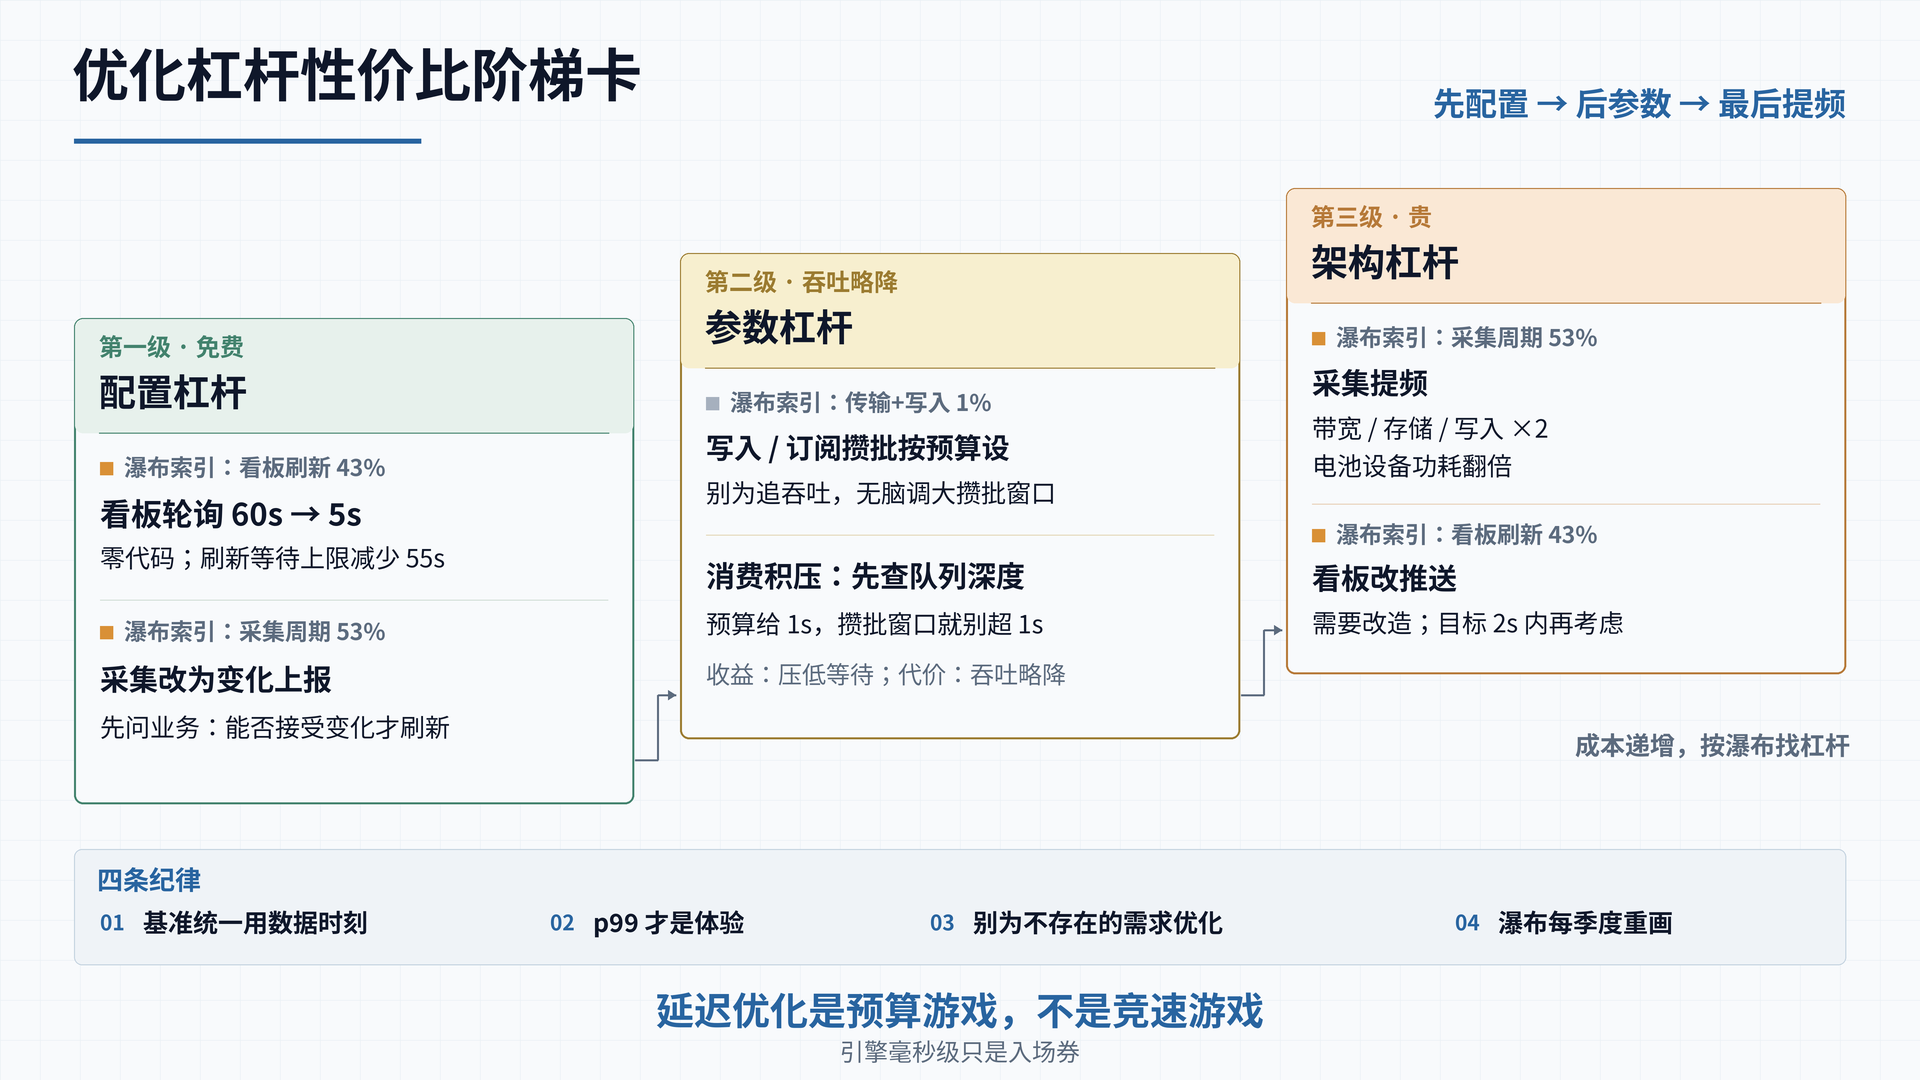
按成本效益排序砍:先动配置(看板刷新间隔——零风险)、再动攒批参数(吞吐略降)、最后才动采集频率(成本很高——带宽、存储、电池设备的功耗都跟着翻倍)。预算表配合成本排序,砍的顺序不会错。
五、优化杠杆逐个看
5.1 采集与网关:占预算大头,杠杆也贵
- 提频:采集周期减半,端到端典型减半——但带宽、存储、写入压力全部同比上涨,电池供电的传感器功耗翻倍。提频是有效但昂贵的杠杆,动之前先确认业务真的需要(第六节的纪律)
- 改上报模式:周期上报改变化上报能省传输量,但慢变量场景会让端到端变成"变化才刷新"——业务能不能接受要问清楚
5.2 写入攒批:吞吐与延迟的跷跷板
数据库端的攒批(订阅消费的批大小、批量写入的条数阈值)是吞吐和延迟的经典权衡:批越大,吞吐越高、单条延迟越长。流表订阅里攒批参数按预算表的写入预算设——预算给了 1 秒,攒批窗口就别超过 1 秒,别为了吞吐指标无脑调大。攒批省下的钱(吞吐)和花掉的钱(延迟)要放在同一张预算表里看。
5.3 引擎与分发:本来就快,别过度优化
引擎计算毫秒级、订阅分发即时——这两跳通常不用动。例外是下游消费阻塞(订阅处理不过来、消息积压)会让分发延迟飙升——这不是引擎慢,是消费端慢,治积压不治引擎。判断依据还是瀑布:serve 段的延迟如果集中在 p99 恶化,先查队列深度再查别的。
5.4 看板呈现:性价比高的杠杆
- 轮询间隔:从 60 秒改 5 秒,零代码,端到端立减 55 秒——多数"平台很慢"的问题,第一刀应该砍在这里
- 轮询改推送:彻底消掉刷新等待,但看板端要改造。预算紧张(目标 2 秒以内)时才值得
六、坑与纪律
6.1 基准统一:数据时刻
再强调一次,所有延迟从数据时刻(传感器 ts)起算。混用到达时刻、处理时刻当基准的团队,各自测出的"端到端延迟"对不上,开会能吵一下午——先对齐基准,再对齐数字。
6.2 别为不存在的需求优化
业务要 10 秒,你做到 500 毫秒——多出来的九秒半预算是纯浪费:采集提频翻倍的带宽和存储、看板推送的改造,全都花在了没人要的性能上。优化之前先问清目标,预算表的第一列是业务目标,不是技术极限。
6.3 采集提频的隐性成本清单
提频前过一遍:带宽(×2)、存储(×2,还要重算容量预期)、写入吞吐(×2)、电池设备功耗(×2,换电池周期减半)、网关并发(×2)。这些成本都不在延迟预算表里,但都在账上。延迟预算和容量预算要一起看——为快一点把存储预算撑爆,是拆东墙补西墙。
6.4 瀑布要定期重画
链路在变:加了边缘网关、换了看板、测点扩容——瀑布的形状每季度都可能不同。把延迟追踪表和瀑布统计做成定时任务,瀑布成为一张常态报表,而不是出问题时的一次性排查。延迟的漂移(原来 p99 是 8 秒,慢慢变成 15 秒)在常态报表里是趋势线,在一次性排查里是既成事实。
七、总结
延迟优化的头号误区,是把它当成数据库调优问题——引擎确实快,但引擎只占端到端预算的百分之一。延迟是链路的属性,不是组件的属性;不拆开测量,就永远在错误的跳上用力。
方法收拢成五步:
- 拆跳:六跳模型,每跳等什么心里有数
- 打标:四个时间戳,1% 抽样,基准是数据时刻
- 瀑布:各跳占比排出来,找大头——大头通常在采集和看板,不在数据库
- 预算:从业务目标倒推分配,超了按成本效益砍
- 杠杆:先配置(看板刷新)后参数(攒批)最后才提频(贵)
一句话总结这套方法的精神:延迟优化是预算游戏,不是竞速游戏——目标不是每一跳都做到极快,而是每一跳都不超过它该花的那份预算。引擎毫秒级只是入场券;从传感器到看板的每一跳都守预算,"现场发生,看板十秒可见"才是一句可兑现的承诺。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号