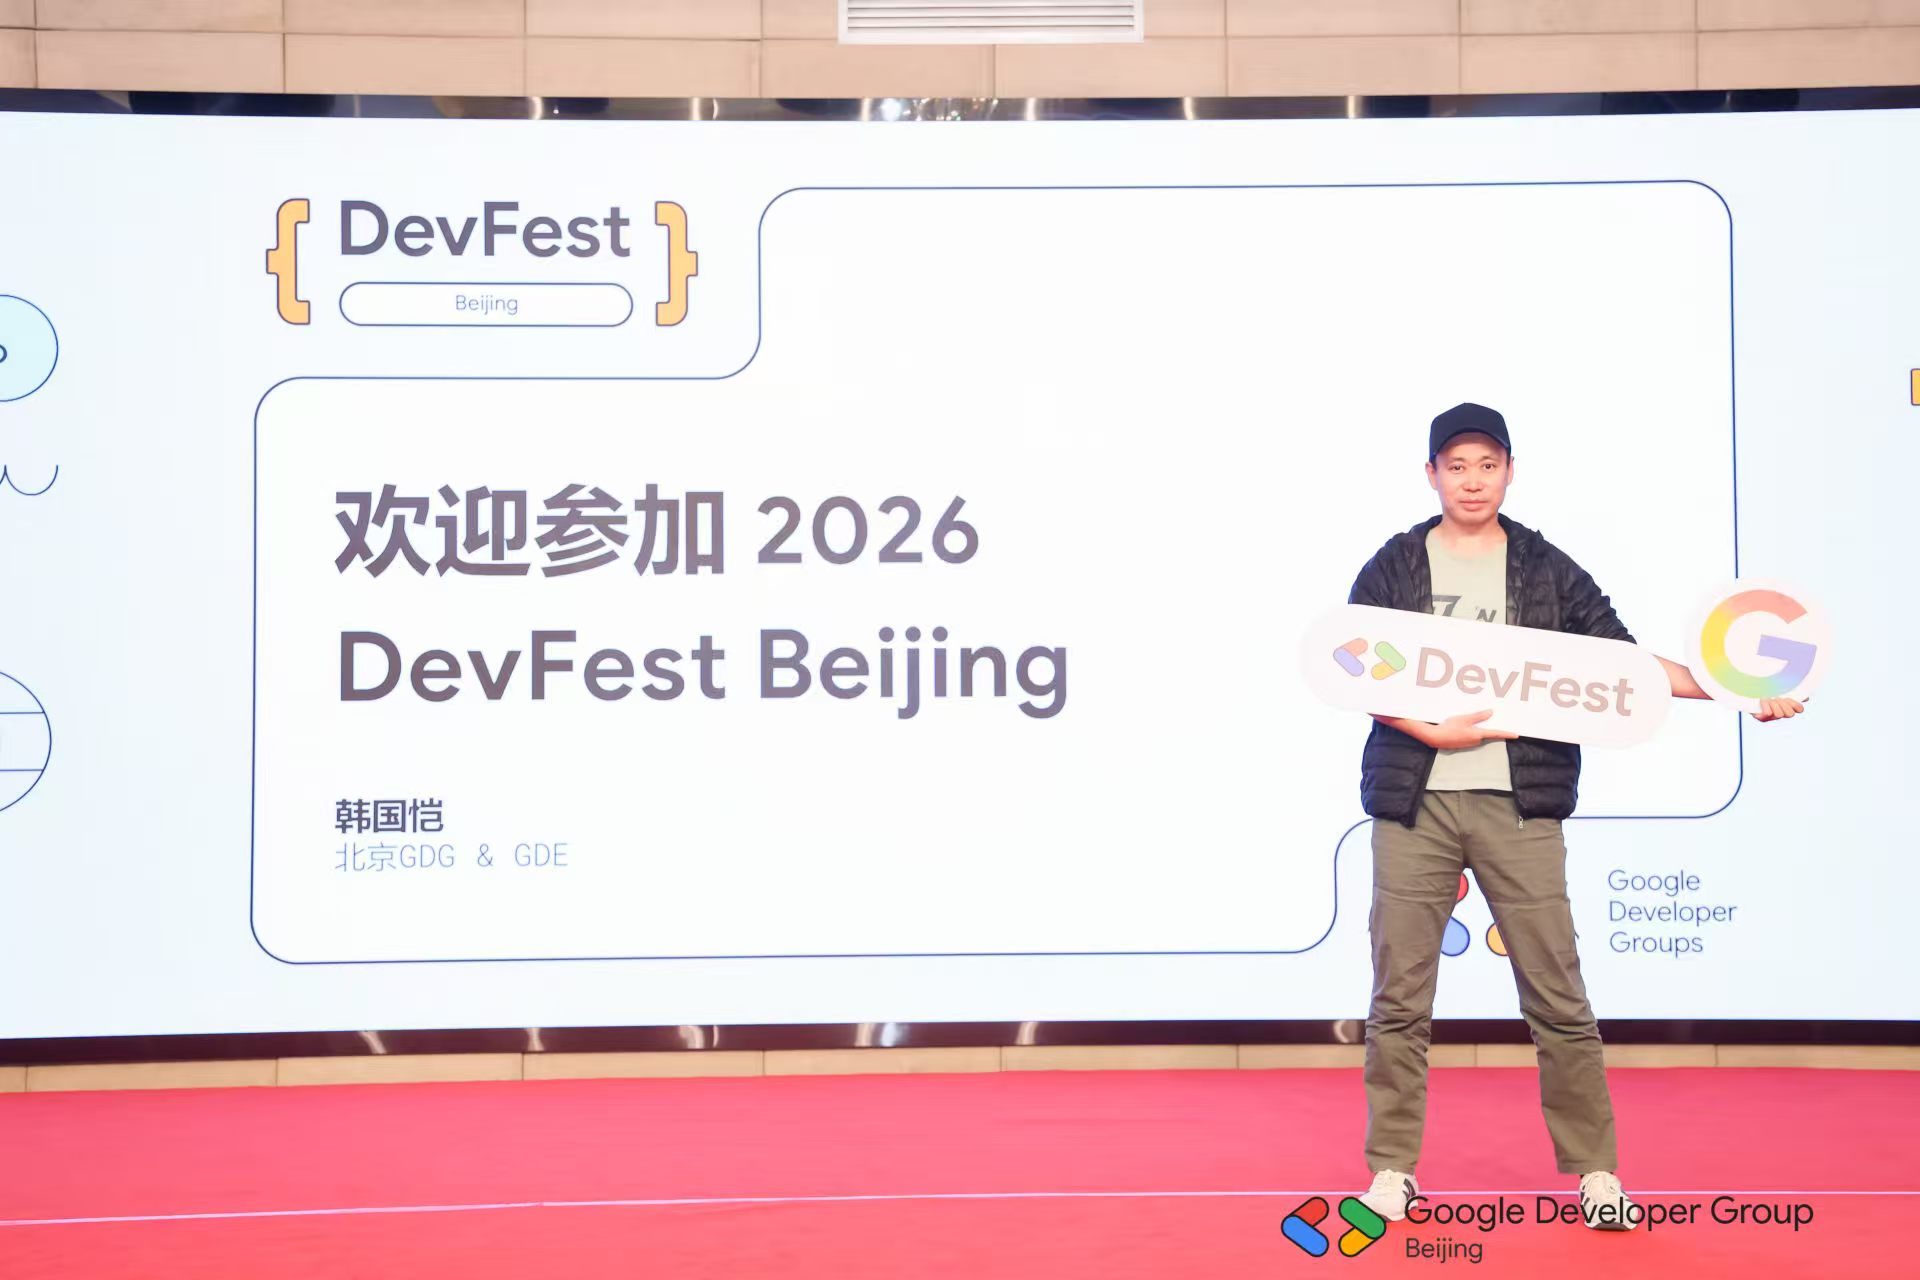
(会议纪要)2026 DevFest北京AI分会技术分享
原创
(会议纪要)2026 DevFest北京AI分会技术分享
原创
芦笛
发布于 2026-11-22 19:13:41
发布于 2026-11-22 19:13:41
一、端侧模型推理原理与Llama.cpp实践
端侧模型发展前景与生态定位
认知核心小型化趋势:Capacitor在2024年提出剔除无关知识、保留推理能力的认知核心概念,预计2025年可实现数B规模本地模型与云端大模型互补
设备能力快速增长:学术界密度定律认为模型能力约3.5个月提升一倍;干测模型从2023年7月22B发展到2026年可运行30B
Llama.cpp编排层作用:作为脱离后端硬件(CPU/GPU/NPU/XPU)的中间层,负责Session、Engine、Conversation管控,类似Coding工具中的Progress Session管理机制
端侧部署三大优势:无需网络、数据不出设备更安全、模型版本自主可控
移动端部署核心约束与实测数据
内存容量瓶颈:Gemma 2 4B模型文件大小约2.4GB,其中权重占1.85GB;实际运行时手机内存减少1.55GB而非全部占用,GPU/NPU进程内存独立计算
上下文长度对内存影响:默认4096上下文宽度若扩大至8192,内存占用直接翻倍,对12G/16G手机成本挑战大
内存带宽理论与实测差距:Mac设备理论上限395 token/s,官方实测仅131 token/s,利用率约30%-33%,损耗来自反量化、计算同步、采样等操作
功耗发热导致降频:CPU初始输出22.2 token/s,触发温控后降至15.3 token/s;GPU从41.1降至21 token/s;部分供应商GPU温控不充分导致设备烫手但性能未降
推理流水线关键步骤与统计口径
Tokenization与Pre-stage:用户输入文本转为Token后经Pre-stage处理,Decode阶段逐字生成
注意力机制与层级优化:35层解码器中前15层正常计算,15-34层跳过以节省计算;谷歌通过精调保证质量,内存收益显著
Prefill与Decode差异:Prefill为计算密集型,NPU明显优于GPU/CPU;Decode为内存带宽受限型,GPU与CPU差别不大,NPU仍具优势
TTF T统计标准:首个Token出现时间可从创建Session或程序启动算起,后者包含初始化耗时更长;同一Session内历史数据可能影响后续推理
推理优化技术与效果验证
量化精度分级策略:Attention层1.8bit、注意力层1.4bit、前15层1.4bit、15-34层1.2bit;FP16全量4GB量化后降至3.6GB,误差控制采用每32个值共享Scale
投机解码场景依赖性:草稿模型一次性生成多Token供主模型验证;代码场景接受率0.6、加速明显,故事场景接受率仅0.2、反而减速
MoE架构移动端适配:每次推理仅激活部分专家(如8/16),相比Dense模型全量加载,效率提升约6倍,内存与CPU压力大幅降低
多模态与Embedding扩展:图像经编码器转为文本Token输入;单点加速生成名义向量支持文本检索;vivo、华为宣称集成MoE 30G模型
二、Agent部署沙箱隔离技术
Agent部署资源隔离痛点
共享容器风险:单容器支撑300并发时,恶意用户可通过MCP拉取海量数据或注入代码破坏邻居Session,导致DoS或信息泄露
独立沙箱资源浪费:Agent 90%时间处于等待IO状态,为每个用户分配独立沙箱导致计算资源闲置,运营成本与用户数线性挂钩
传统挂起机制失效:Docker Pause不清空内存,Linux原生挂起恢复耗时秒级至数十秒,无法满足毫秒级响应需求
gVisor假内核实现快速挂起恢复
Syscall拦截原理:用Go重写约300个Linux Kernel Syscall,容器与假内核交互而非真实内核,可完全掌控内存状态与挂起时机
快照存档与恢复流程:容器声明挂起时打包存档至硬盘并释放CPU/内存;下次请求到达时从硬盘恢复至上一次状态继续执行
时间感知隔离:挂起期间真实时间流逝但容器内时钟停滞,恢复后程序感知时间仍为挂起前时刻,避免超时误判
与Docker本质区别:Docker共享内核难挂起,gVisor通过假内核实现百毫秒级恢复,类比30年前车管所换驾照与现在一站式体检拍照的效率差异
Agent Substrate架构与实测性能
Resumable Sandbox调度:请求进入后匹配历史快照,有空位则拉起对应沙箱执行任务,完成后清空Pod;外层货架存储所有Session快照
8 Pod支撑256用户并发:演示中3个Worker Pod + 8后台Pod,16并发请求下唤醒耗时约200ms、挂起仅20ms,沙箱数量减少79%
适用带状态长任务场景:专为Stable Box设计,区别于次抛型Tool容器;适用于需保持状态的MCP调用、代码执行等场景
安全后端双选项:gVisor适配普通用户,MicroVM轻量虚拟机适配金融等高安全需求客户;原生支持Kubernetes与GKE
三、沙箱生命周期管理现状与风险
控制权归属未定:当前由业务层通过读取内部状态、定时或超时决定挂起,未来计划允许Agent主动通知控制面
欺骗攻击潜在风险:若Agent内部代码谎报”不可挂起”或”立即可挂起”,可能导致资源泄漏或任务中断
网络IO中途挂起隐患:控制面强制挂起可能打断正在进行的关键操作,需业务层谨慎设计挂起策略
决策模型原理与实现路径
决策模型定义与传统模型对比
通用分类器定位:不同于传统ML固定任务分类器,也不同于LLM生成完整回复;接收上下文+自然语言任务描述+选项,输出概率分布而非Token序列
三种标准形式:选择题(多选项概率分布)、是非题(二元概率)、评分题(有序选项加权期望值,如紧急程度高/中/低对应1/2/3分)
Gemini Decision API对标:支持文本/图像/语音多模态输入,覆盖模型路由、安全检测、表情选择等场景;价格略高于Jais但功能更全
核心优势:仅输出单Token概率分布故速度极快;格式严格受控无幻觉,不会输出选项外内容
Prompt Engineering实现决策模型
选项Token编号绑定:在Prompt中将选项前置单独Token编号(如A/B/C或1/2/3),限定模型仅从该编号集合预测
Logits提取与归一化:获取词表全量评分后,仅提取目标编号Token的Logits,经Softmax转为概率分布直接输出,跳过自回归采样
评分题期望值计算:将概率分布与选项数值加权求和(如1×0.8+2×0.1+3×0.1=1.3),输出连续分数而非离散类别
代码实现要点:使用Transformers库加载模型,Tokenizer转换Prompt,提取指定Label ID的Logits转Float,Softmax后输出
相关技术延伸与替代方案
扩散大模型并行生成:非自回归逐Token生成,而是Block级并行迭代去噪,速度可达普通LLM 4-8倍(近1000 token/s);谷歌Diffusion LLM已开源
约束解码保障格式合法:通过文法(JSON/Python语法)动态计算每步允许输出的Token Mask,确保输出绝对符合语法;Gemini Structured Output即基于此技术
决策模型与约束解码关系:决策模型是约束解码的特例(仅约束单Token),约束解码可扩展至多Token结构化输出,两者底层逻辑一致
研究应用交叉:讲者在复旦的研究将约束解码应用于EDA逻辑电路设计,与自然语言决策模型技术同源
编辑:芦笛 (公共互联网反网络钓鱼工作组)
来源:迪妙网络空间安全学院
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号