从「看懂世界」到「改造世界」:AI 的下一站
原创
从「看懂世界」到「改造世界」:AI 的下一站
原创
顺势而为
发布于 2026-11-22 21:31:36
发布于 2026-11-22 21:31:36
摘要:当 AI 学会在动手前先预演后果,它正从数字空间迈向物理世界。世界模型、具身智能与自主实验室搭起三级台阶,但生成候选的速度已远超验证能力——改造世界真正的闸门,不是能不能想到,而是能不能证明。
阿里CEO吴泳铭把当下的 AI Coding 比作"1882 年的电灯":技术已经点亮,但真正的代表性产品还没出现。
这个比喻放在整个 AI 身上更贴切。过去十年,我们教会了机器"看懂世界"——识别图像、理解语言、生成视频,数字空间里的成绩单漂亮得近乎刺眼。可一旦走出屏幕,走进有重力、有摩擦、有容错率的世界,同一套能力就变得笨拙。
2026 年的信号正在密集指向同一个方向:AI 的下一站,是从"看懂"走向"改造"。但这条路上藏着一道多数人没注意的闸门。
01 从"看懂"到"改造",中间其实多了两层
先厘清一件事:"看懂世界"和"改造世界"之间,不是一步之遥,而是隔着一条三级台阶。
第一级是看懂世界——描述发生了什么。这是过去十年 AI 的主线,图像识别、语言理解、内容生成,本质上都停留在"给出答案"。
第二级是预演世界——推演"如果这样做,接下来会发生什么"。这一步是新增的,也是最容易被忽略的。传统模型是"看到什么就做什么",而世界模型要多走一步:先在脑子里把后果过一遍,再决定要不要动手。这一分之遥,把机器从"条件反射"推向了"谋定后动"。
第三级才是改造世界——在物理空间里真正执行,并承担后果。
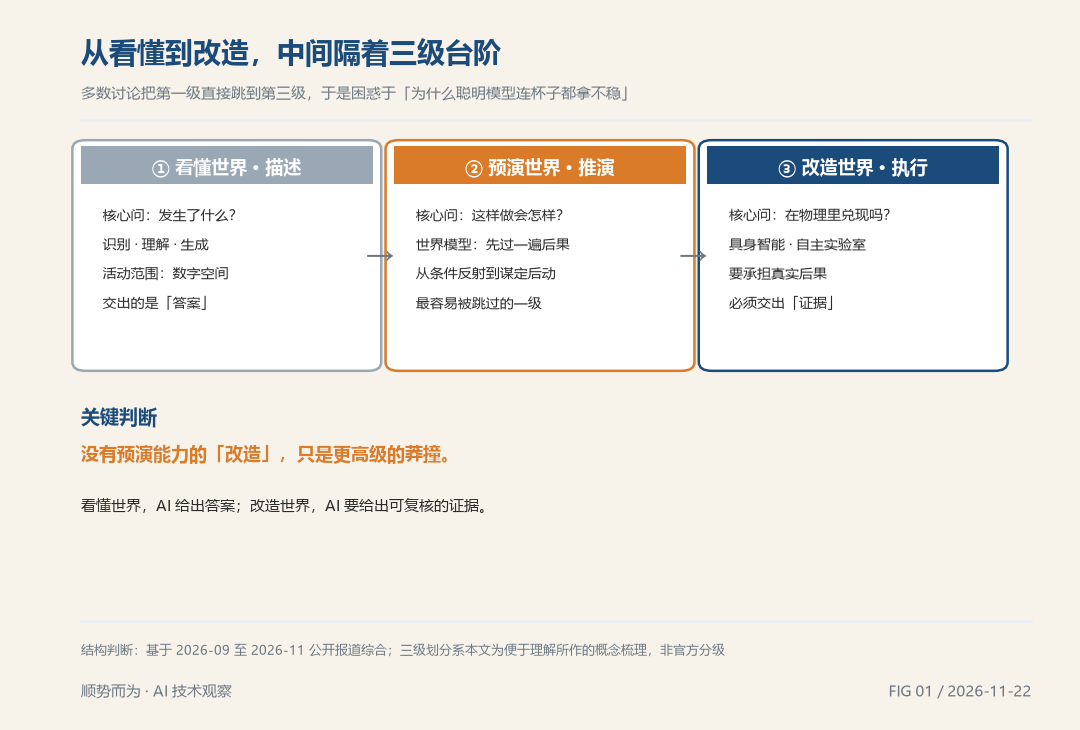
图 1 从看懂到改造的三级台阶:描述、预演、执行
很多人谈 AI 落地,直接把第一级跳到第三级,于是困惑于"为什么这么聪明的模型连个杯子都拿不稳"。答案就藏在被跳过的第二级里:没有预演能力的"改造",只是更高级的莽撞。
02 世界模型:关键不是"生成",是"压缩"
那么,预演靠什么?答案是世界模型。
上海人工智能实验室物理智能团队给过一个克制却锋利的定义:世界模型,是在有限计算资源的约束下,对物理世界状态转移过程的压缩建模。
请注意关键词是"压缩",不是"生成"。生成视频只是压缩到位之后顺带涌现的能力,不是目标本身。这个定义派生出三个属性:全模态(视觉、听觉、触觉一起建模)、多维异步性(不同传感器的采样频率天然不同)、局域性(智能体只能看到局部,天然是个不完全可观测的决策问题)。
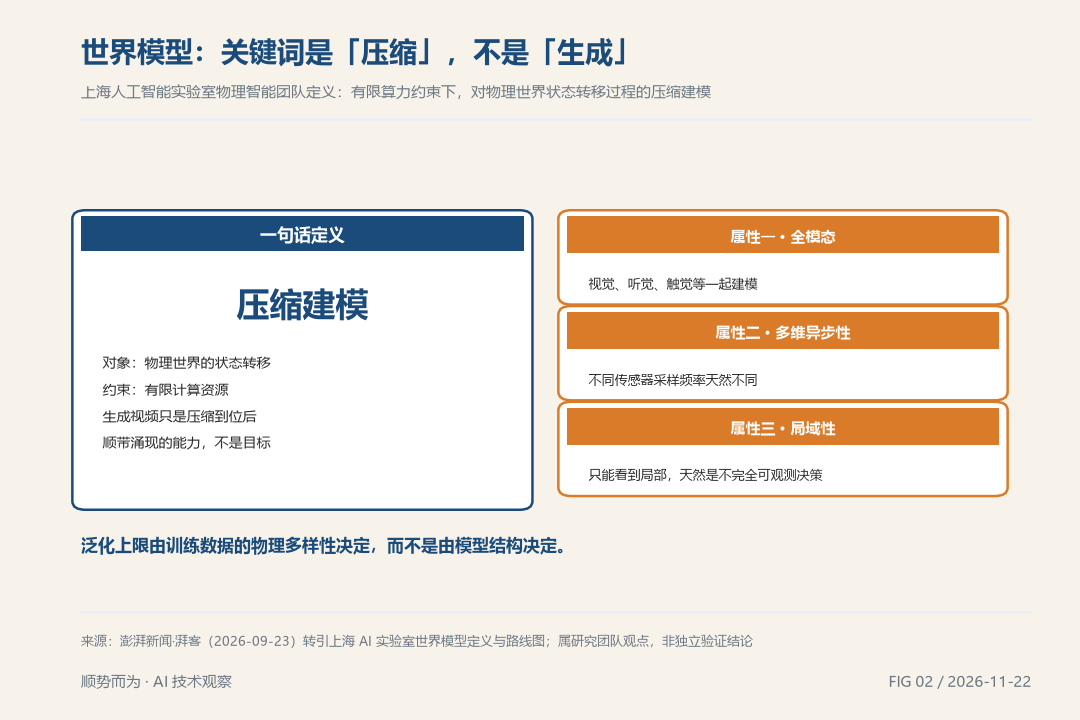
图 2 世界模型的定义与三大属性
该团队还有一句判断值得记下来:任何智能系统在物理世界的泛化上限,由训练数据的物理多样性决定,而不是由模型结构决定。
这句话改写了竞争的逻辑。过去我们比谁的参数多、架构新;现在,谁能让模型见过足够多真实的物理变化,谁才有资格谈泛化。
03 从"预演"到"动手":数据正在成为胜负手
预演要落到动作上,需要一个接口。近几个月,这个接口有了名字:世界-动作模型(World Action Model,WAM)。
一批进展密集出现,密度高到让人眼花:
智元机器人发布的 GE-Act 2.0,自称是首个"原生"世界-动作模型——从随机初始化开始,在具身数据上从头训练。它用自研编码器把一帧 256×384 的画面压成 24 个 token,只有 DINOv3 的十六分之一,在 RTX 5090 上生成一个动作块约需 104 毫秒。更值得注意的是它验证的"机器人 Scaling 定律":训练数据从 300 小时拉到 3 万小时(100 倍),机器人在陌生场景里能完成的精细任务从 39 项涨到 76 项。
另一个样本是 τ0-WM:在约 2.73 万小时的异构语料上预训练(含 1.78 万小时真机遥操作、6500 小时 UMI、3000 小时第一人称视频),模型只有 5B 参数,却把动作生成、视频预测、任务评估统一进一个表示。推理时它先采样多个候选动作,再用视频模拟器"预演"未来,挑出最有前景的一条——一个"提议—评估—修正"的闭环。
海外的 Riemann-1.0 则用了 20 万小时以上的交互数据,在 RoboTwin2.0 上报告 94.3%、LIBERO 上 99.0% 的成功率。
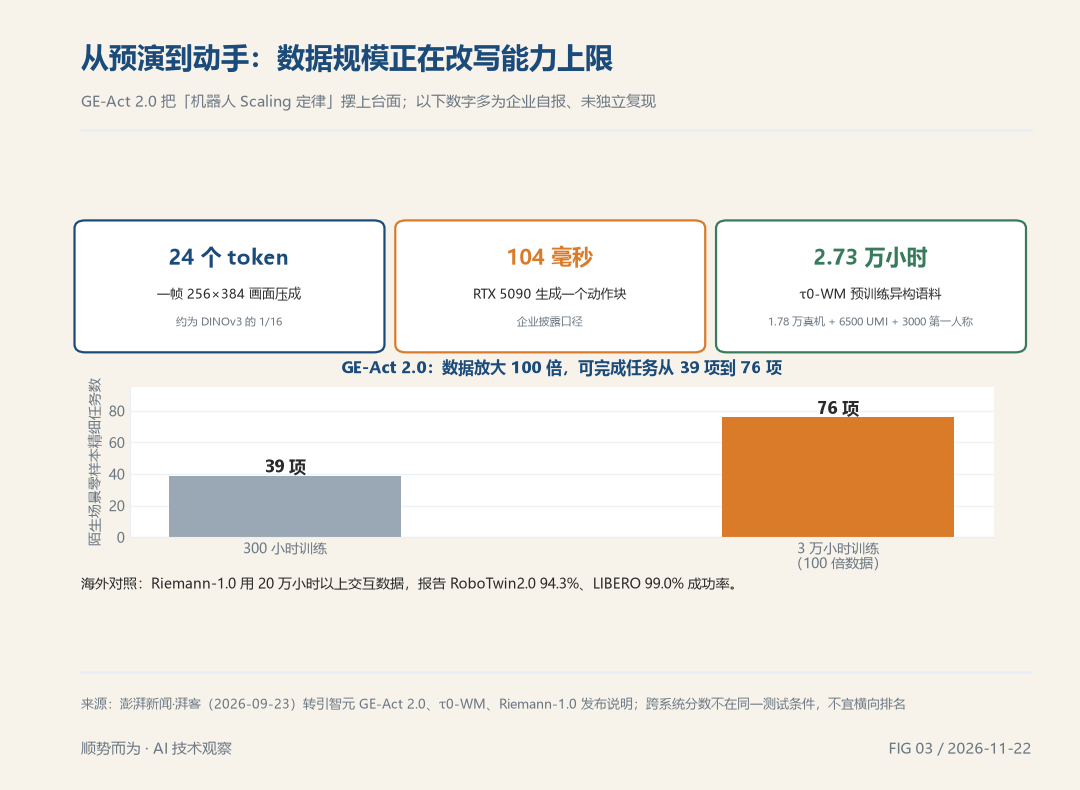
图 3 数据规模与机器人能力:从 300 小时到 3 万小时
把这些数字放在一起看,方法上的共识已经很清楚:先用数十亿量级的互联网视频解锁隐含的物理先验,再逐层过滤、合成、提纯,最后变成任务对齐的真实数据。有人称之为"倒置金字塔"。
但需要给这些数字加上口径说明:上述性能多来自企业发布说明与媒体转述,属企业自报、未经独立复现,跨系统的分数也不在同一测试条件下,不宜直接横向排名。它们共同说明的只是方向——数据规模与多样性,正在成为这个赛道的硬通货。
04 改造世界跑得最快的一站:无人实验室
如果具身智能是"改造世界"的漫长赛道,那么 AI for Science(人工智能驱动的科学发现)就是最先跑出成绩的短跑——因为这里的反馈闭环短、结果可量化。
看几组来自《科普中国》与新华社系报道的数字:
中国人民大学高瓴人工智能学院与阿里巴巴达摩院的 ElementsClaw"智能体科学家",用 28 个 GPU 小时,从 240 万种稳定晶体中圈定了 6.8 万个超导候选目标——而人类数十年积累的超导结构数据库,只有约 2000 种已知样本。随后,科研人员成功合成了 4 种新的超导体。
中科院上海高等研究院的团队用生成式 Transformer 一次性生成 1000 万种甲烷转化催化剂结构,把同类研究的探索空间拓展约两个数量级,筛出 26 种已被实验证明有效的催化剂,并输出了 1200 多种候选清单。
美国北卡州立大学的自主实验室 PoLARIS,12 小时内完成 120 次实验,从七种变量的组合里筛出一种明亮、无铅的发光纳米材料,全程无人触碰反应容器。
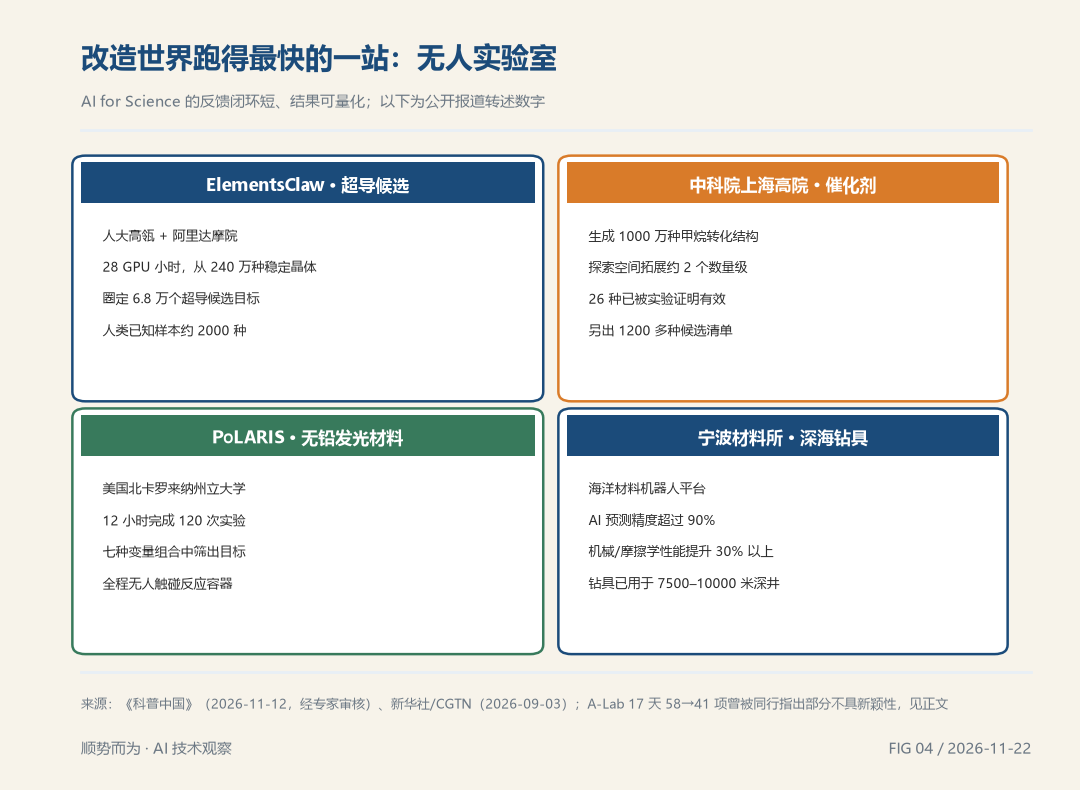
图 4 无人实验室的效率:几组可核查的数字
更"硬"的落地来自宁波:中科院宁波材料所的机器人海洋材料平台,AI 预测精度超过 90%,新材料的机械与摩擦学性能较传统三元材料提升 30% 以上,用该材料制成的螺杆钻具已在 7500 至 10000 米的深井中部署。
从"算出来"到"用下去",这条链第一次被完整打通。
05 但在"改造"的门口,卡着一道验证闸门
现在到了这篇文章最想说的地方。
上面那些漂亮数字,如果你把它们并排放,会发现一个刺眼的落差:6.8 万个超导候选,最终只验证了 4 个;1200 多种催化剂候选,大部分还停留在计算阶段。
这不是某一家团队的问题,而是整个领域结构的错配。AI 生成实验方案的速度,已经远远超过了人类和实验室验证的速度。人类文明第一次遇到这样的局面:待筛选的对象数量,超过了我们的验证能力。
最典型的例子是 DeepMind 的 GNoME。2023 年它宣称发现 220 万种新晶体、38 万种稳定结构,一度被形容为完成了"相当于人类科学家 800 年的产出"。但据《科普中国》报道,2026 年初利物浦大学的研究指出:该数据库中超过 10% 被标记为"稳定"的晶体,其实只是已有结构替换了一两个原子;另有 1224 对完全一致的"双胞胎"样本。争议之后,超过 8 万个条目被移除,谷歌未就此公开回应。
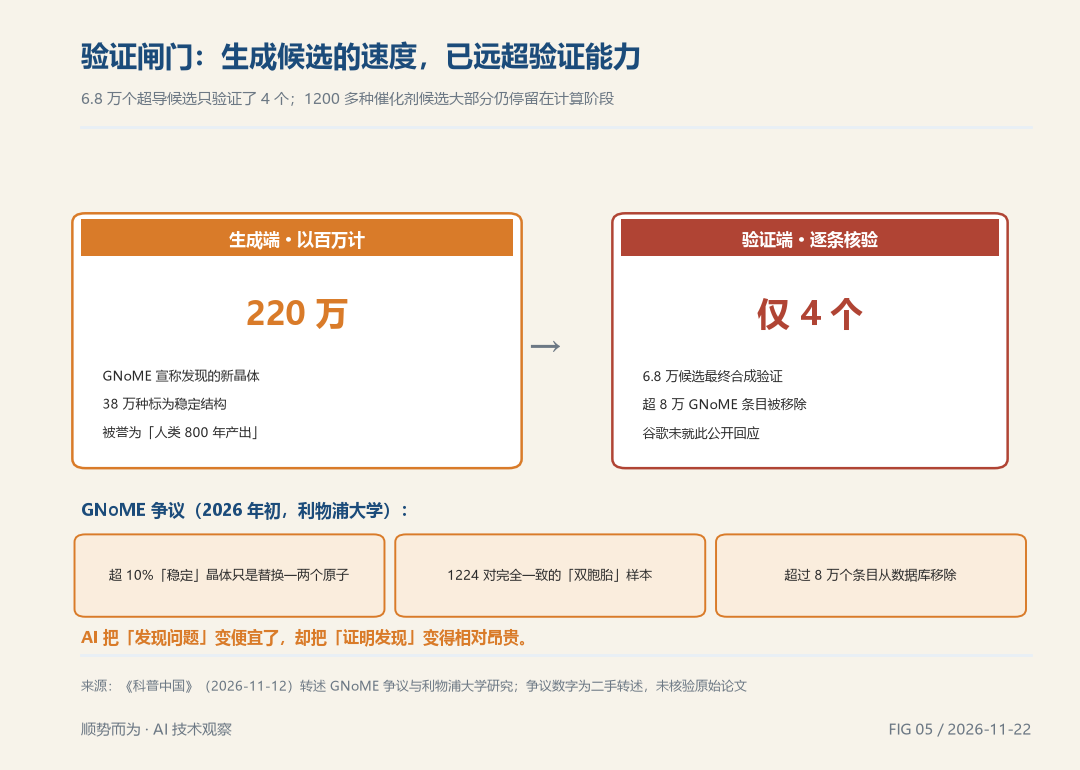
图 5 验证闸门:生成速度远超验证能力
这件事的启示不是"AI 不行",而是:AI 把"发现问题"变便宜了,却把"证明发现"变得相对昂贵了。 当候选可以以百万计地生产,稀缺的就不再是想象力,而是判别力——谁能证明哪个候选是真的,谁就掌握了下一阶段的主动权。
好消息是,规则正在补位:全国首个自主实验室国家标准《人工智能自主实验室通用技术要求》已于 2026 年启动公开征求意见。验证能力的标准化,正在从"各家自己说了算"走向"有统一标尺"。
06 可靠性,而不是能力,才是落地的关口
如果说验证是实验室里的闸门,那么在开放的物理世界里,这道闸门叫可靠性。
几位院士的判断出奇一致。中国工程院院士戴琼海说,物理 AI 正从模拟世界走向预测世界、推演世界,最终改变世界;美国国家工程院外籍院士沈向洋指出,AI 走进物理世界最大的挑战,是缺少可对齐的交互经验;图灵奖得主姚期智强调,可靠性是物理 AI 从演示走向落地的关键关口;智源行为世界模型创新中心负责人陈博远则说,物理 AI 目前仍处在"100 公里马拉松的起跑阶段"。
企业披露的数据也印证了这种谨慎:华为云在 11 月发布的世界模型材料中提到,目标遮挡可让检测 F1 值从 68% 跌至 28%,视角分布外变化甚至能让准确率从 62.72% 骤降到 7.62%。
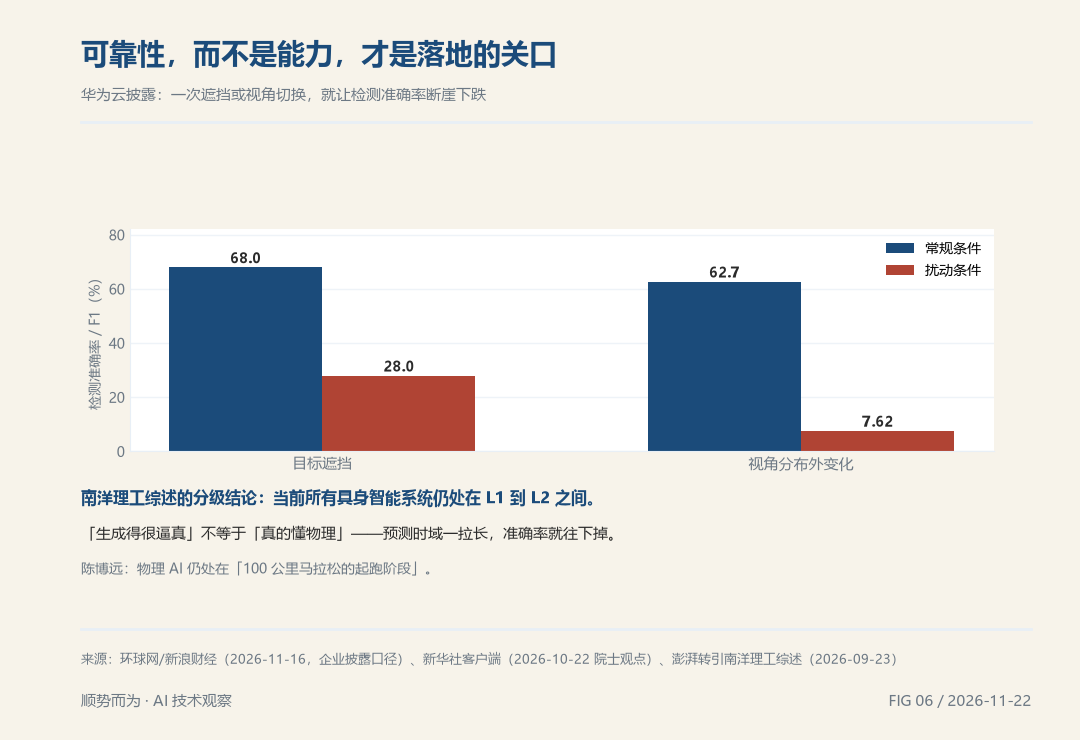
图 6 可靠性关口:演示与落地之间的落差
南洋理工大学的一篇综述把具身 AGI 分为 L1 到 L5,结论相当冷静:当前所有具身智能系统都处在 L1 到 L2 之间。其中最难的"类人认知",需要模型在部署后仍持续更新内部状态,而不是训练完就"冻结"。
一句话概括当前的位置:模型已经能"生成得很逼真",但"逼真"不等于"真的懂物理"。 预测时域一拉长,准确率就会掉下来,速度也还追不上实时控制。
07 下一站怎么走:三个判断
把上面的证据串起来,关于 AI 的下一站,可以给出三个判断。
第一,竞争重心从"堆参数"转向"拼数据多样性与闭环效率"。 谁能用更低的成本拿到足够丰富的物理数据,谁能把"设计—合成—测试—反馈"的闭环跑得更快,谁就握着入场券。参数仍是门槛,但已不是护城河。
第二,验证能力会成为新的核心壁垒。 未来的较量,不是"谁生成得多",而是"谁验证得快、验证得真"。可追溯的实验记录、可复现的流程、统一的评测标尺,这些看起来不那么性感的东西,恰恰是拦住"800 年产出"式泡沫的关键。
第三,人的角色会上移到"目标设定与责任兜底"。 从 AI 辅助人到 AI 执行、人监督,链路在变,但最后一个环节不会变——最终的判断、实验与责任,依然由人承担。当场景从屏幕走进物理世界,试错的代价不再只是一次错误的回答,而可能是真实的损失。
这也意味着,安全机制必须从第一天就内置:记忆和决策要看得见、可追溯、能叫停。一个会不请自来地应用规则的智能体,也会不请自来地应用一条过期或错误的规则——在数字世界里这叫 bug,在物理世界里这可能是事故。
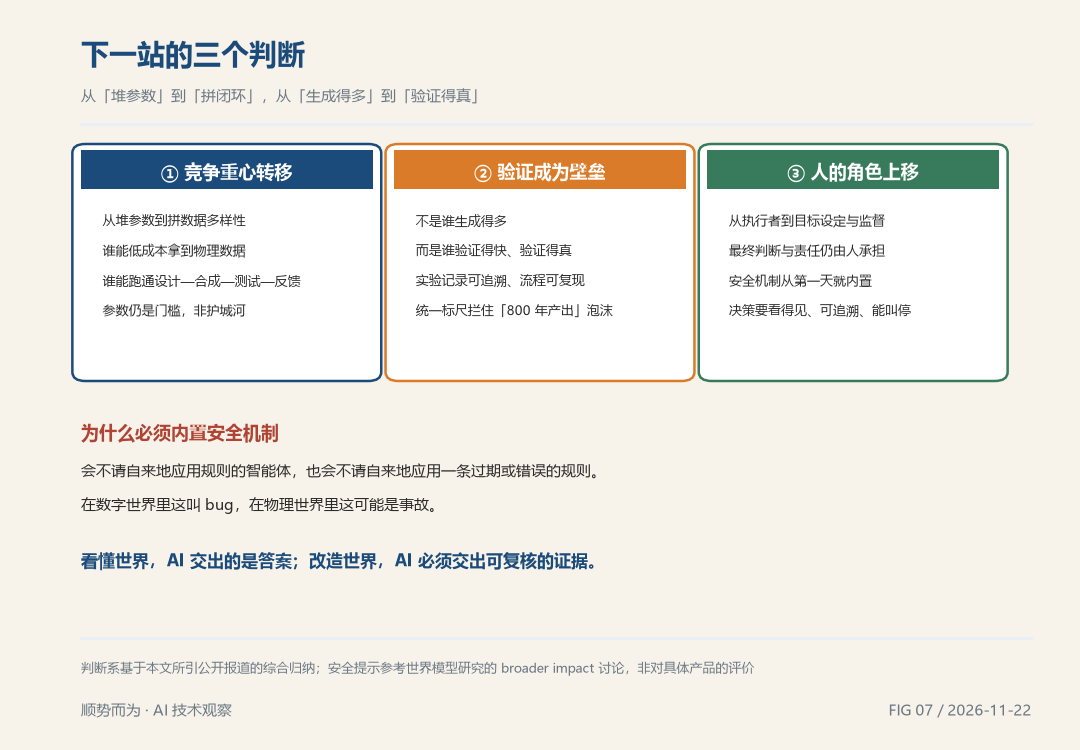
图 7 下一站的三个判断
写在最后
回到吴泳铭那个"1882 年的电灯"的比喻。电灯改变世界,靠的不是灯泡本身有多亮,而是发电、输电、开关、保险丝整套系统把它变得可用、可控、可信任。
AI 的下一站也是这样。看懂世界,AI 交出的是答案;改造世界,AI 必须交出可复核的证据。
从"想到"到"做到",中间隔着一个词:证明。而分水岭不在于模型有多聪明,而在于当它犯错时,我们能不能及时发现、及时叫停。
这,才是"改造世界"真正的入场券。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号