
为什么我在我的LSTM模型上得到滞后的结果?
为什么我在我的LSTM模型上得到滞后的结果?
提问于 2020-08-05 18:34:45
我是机器学习的新手,我正在使用Keras中的LSTMs进行多变量时间序列预测。我有一个包含4个输入变量(温度、降水、露水和wind_spreed)和1个输出变量(污染)的月度时间序列数据集。利用这些数据,我提出了一个预报问题,考虑到前几个月的天气状况和污染情况,我在下个月预测了污染。下面是我的代码
X = df[['Temperature', 'Precipitation', 'Dew', 'Wind_speed' ,'Pollution (t_1)']].values
y = df['Pollution (t)'].values
y = y.reshape(-1,1)

from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler(feature_range=(0, 1))
scaled = scaler.fit_transform(X)

#dataset has 359 samples in total
train_X, train_y = X[:278], y[:278]
test_X, test_y = X[278:], y[278:]
# reshape input to be 3D [samples, timesteps, features]
train_X = train_X.reshape((train_X.shape[0], 1, train_X.shape[1]))
test_X = test_X.reshape((test_X.shape[0], 1, test_X.shape[1]))
print(train_X.shape, train_y.shape, test_X.shape, test_y.shape)


model = Sequential()
model.add(LSTM(100, input_shape=(train_X.shape[1], train_X.shape[2])))
model.add(Dropout(0.2))
#    model.add(LSTM(70))
#    model.add(Dropout(0.3))
model.add(Dense(1))
model.compile(loss='mean_squared_error', optimizer='adam')

history = model.fit(train_X, train_y, epochs=700, batch_size=70, validation_data=(test_X, test_y), verbose=2, shuffle=False)

# summarize history for loss
plt.plot(history.history['loss'])
plt.plot(history.history['val_loss'])
plt.title('model loss')
plt.ylabel('loss')
plt.xlabel('epoch')
plt.legend(['train', 'test'], loc='upper right')
plt.show()
要进行预测,我使用以下代码
from sklearn.metrics import mean_squared_error,r2_score
yhat = model.predict(test_X)
mse  = mean_squared_error(test_y, yhat)
rmse = np.sqrt(mse)
r2   = r2_score(test_y, yhat)

print("test set performance")
print("--------------------")
print("MSE:",mse)
print("RMSE:",rmse)
print("R^2: ",r2)

fig, ax = plt.subplots(figsize=(10,5))
ax.plot(range(len(test_y)), test_y, '-b',label='Actual')
ax.plot(range(len(yhat)), yhat, 'r', label='Predicted')
plt.legend()
plt.show()运行这段代码的遇到了以下问题:
由于某种原因,
- 在我的测试集上得到了一个滞后的结果,这并不在我的训练数据中,如下图所示。我不明白为什么我有这些滞后的结果(这是否与将“污染(T_1)”作为我的输入的一部分有关)?
图表结果:
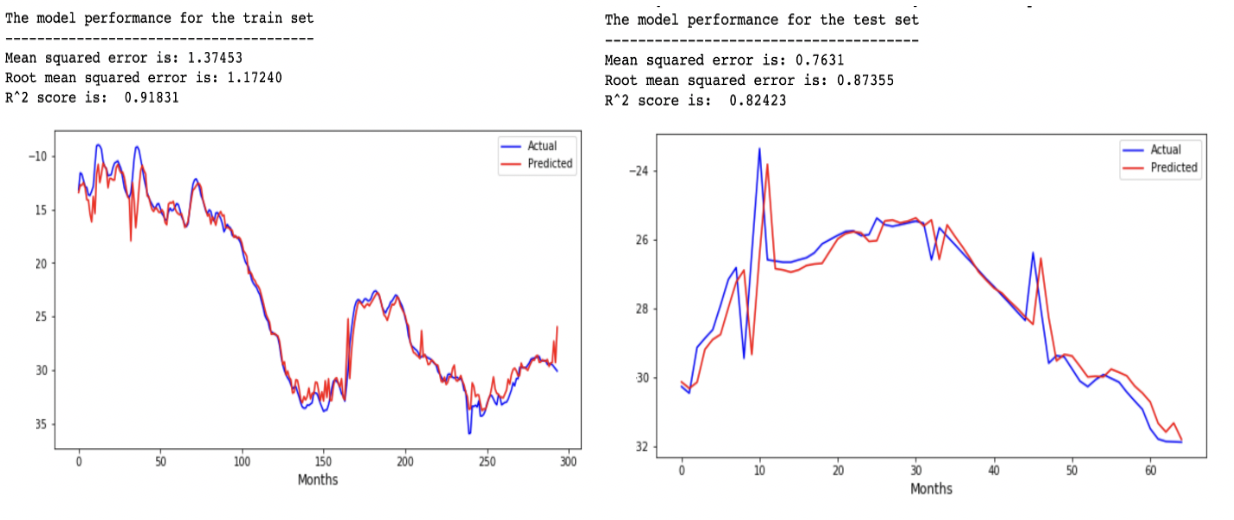
- 添加“污染(t_1)”,这是污染变量滞后1的结果,作为输入的一部分,这个变量现在似乎主导了预测,因为除去其他变量似乎对我的结果(r-平方和rmse)没有任何影响,这很奇怪,因为所有这些变量都有助于污染预测。
在我的代码中有什么事情是我做错的,这就是造成这些问题的原因吗?我对python很陌生,所以回答以上两个问题的任何帮助都会得到很大的重视。
回答 1
Stack Overflow用户
发布于 2020-08-07 09:59:48
首先,我认为输入'1‘作为时间步长值是不合适的,因为LSTM模型是处理时间序列或序列数据的模型。我认为下面的数据挖掘脚本将运行良好。
def lstm_data(df,timestamps):
    array_data=df.values
    sc=MinMaxScaler()
    array_data_=sc.fit_transform(array_data)

    array=np.empty((0,array_data_.shape[1]))
    range_=array_data_.shape[0]-(timestamps-1)
    for t in range(range_):
        array_data_p=array_data_[t:t+sequenth_length,:]
        array=np.vstack((array,array_data_p))

    array_=array.reshape(-1,timestamps, array.shape[1])
    return array_

#timestamps depend on your objection, but not '1'
x_data=lstm_data(x, timestamps=4)
y_data=lstm_data(y, timestamps=4)
y_data=y_data.reshape(-1,1)

#Divide each data into train and test
#Input the divided data into your LSTM model页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/63271509
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号