
 MCP服务端客户端添加福利群:解决AI开发者的「MCP实战痛点」
 github
Python 从零构建MCP Server & Client
中文 | English
简介
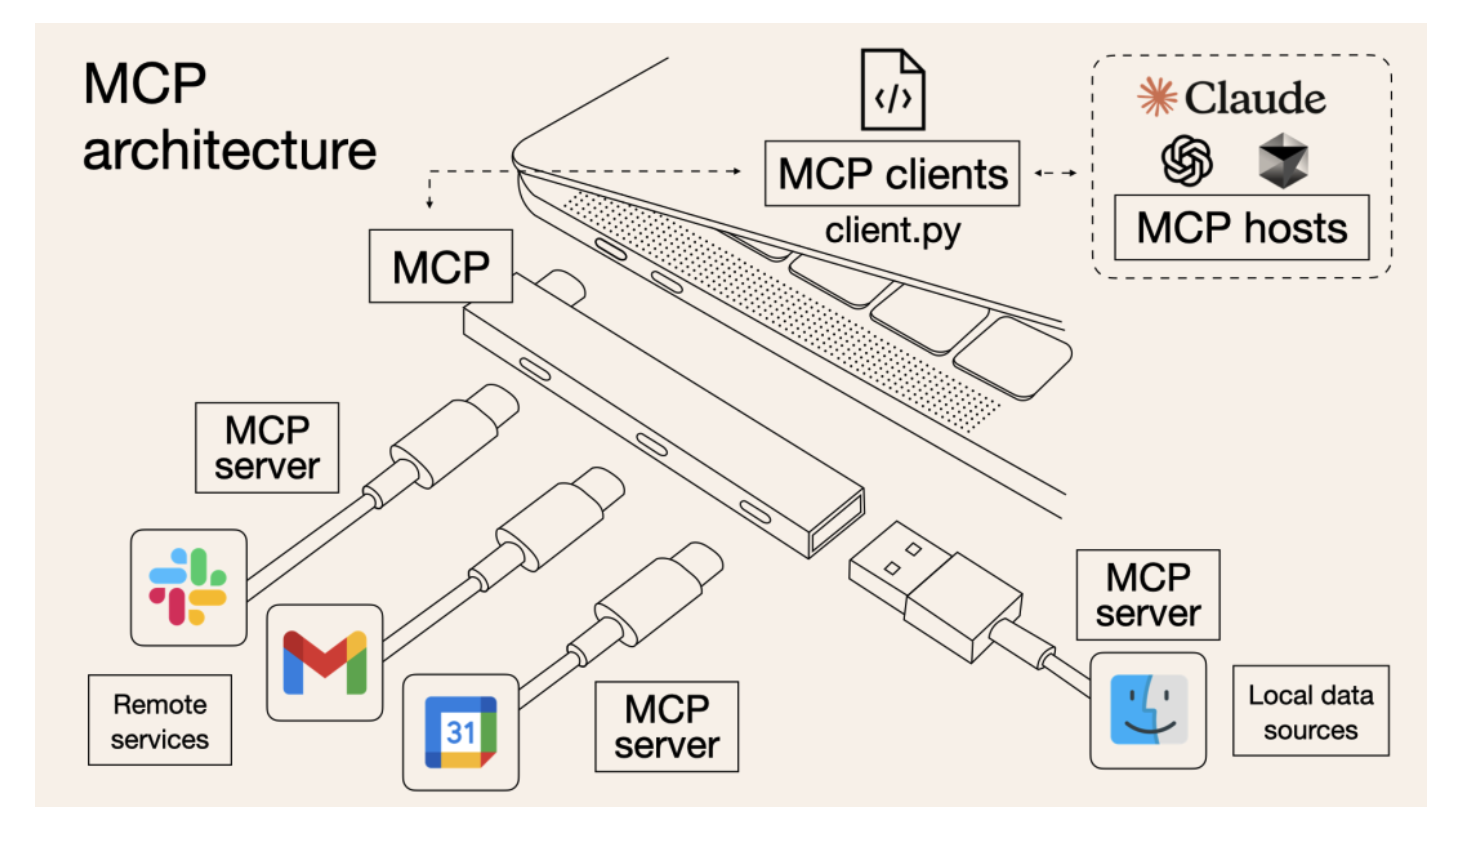
MCP Server 是实现模型上下文协议(MCP)的服务器,旨在为AI模型提供标准化接口,连接外部数据源和工具(如文件系统、数据库或API)。
MCP的优势
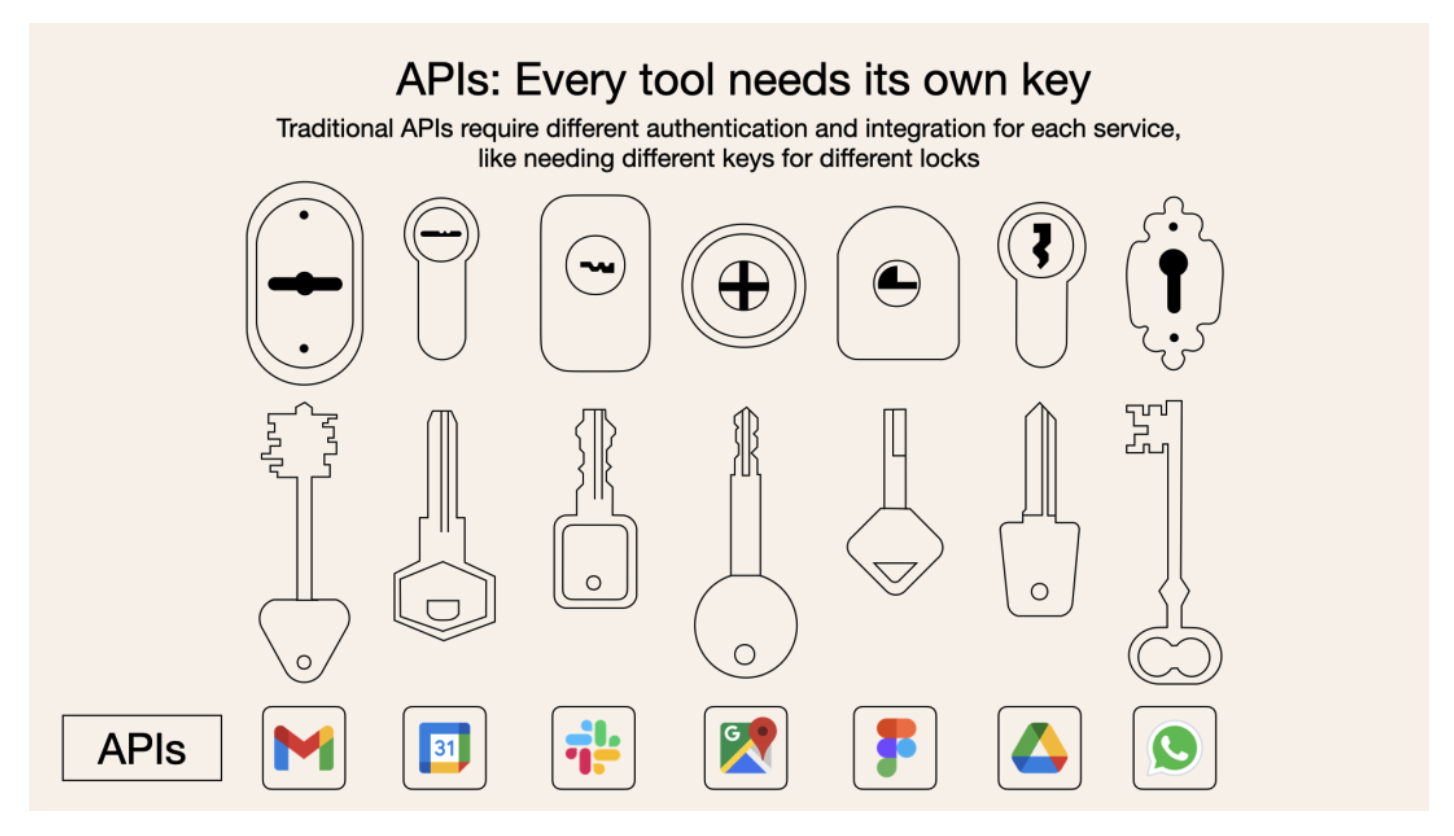
在MCP出现前,AI调用工具主要通过Function Call完成,存在以下问题:
- 不同大模型厂商的Function Call格式不统一
- 大量API工具的输入输出格式不一致,封装管理繁琐
MCP相当于一个统一的USB-C接口,不仅统一了不同大模型厂商的Function Call格式,还统一了相关工具的封装方式。
MCP传输协议
目前MCP支持两种主要传输协议:
-
Stdio传输协议
- 适用于本地使用
- 需在用户本地安装命令行工具
- 对运行环境有特定要求
-
SSE(Server-Sent Events)传输协议
- 适用于云服务部署
- 基于HTTP长连接实现
项目结构
MCP Server
- Stdio传输协议(本地)
- SSE传输协议(远程)
MCP Client(客户端)
- 自建客户端(Python)
- Cursor
- Cline
环境配置
1. 安装UV包
MacOS/Linux:
curl -LsSf https://astral.sh/uv/install.sh | sh
Windows:
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"

2. 初始化项目
# 创建项目目录
uv init mcp-server
cd mcp-server

# 创建并激活虚拟环境
uv venv
source .venv/bin/activate  # Windows: .venv\Scripts\activate

# 安装依赖
uv add "mcp[cli]" httpx

# 创建服务器实现文件
touch main.py
构建工具函数
为了让大模型能访问主流框架的技术文档,我们主要通过用户输入的query,结合指定站点的谷歌搜索来获取相关网页,并解析提取网页文本返回。
1. 构建相关文档映射字典
docs_urls = {
    "langchain": "python.langchain.com/docs",
    "llama-index": "docs.llamaindex.ai/en/stable",
    "autogen": "microsoft.github.io/autogen/stable",
    "agno": "docs.agno.com",
    "openai-agents-sdk": "openai.github.io/openai-agents-python",
    "mcp-doc": "modelcontextprotocol.io",
    "camel-ai": "docs.camel-ai.org",
    "crew-ai": "docs.crewai.com"
}
2. 构建MCP工具
import json
import os
import httpx
from bs4 import BeautifulSoup
from mcp import tool

async def search_web(query: str) -> dict | None:
    payload = json.dumps({"q": query, "num": 3})

    headers = {
        "X-API-KEY": os.getenv("SERPER_API_KEY"),
        "Content-Type": "application/json",
    }

    async with httpx.AsyncClient() as client:
        try:
            response = await client.post(
                SERPER_URL, headers=headers, data=payload, timeout=30.0
            )
            response.raise_for_status()
            return response.json()
        except httpx.TimeoutException:
            return {"organic": []}

async def fetch_url(url: str):
    async with httpx.AsyncClient() as client:
        try:
            response = await client.get(url, timeout=30.0)
            soup = BeautifulSoup(response.text, "html.parser")
            text = soup.get_text()
            return text
        except httpx.TimeoutException:
            return "Timeout error"

@tool()
async def get_docs(query: str, library: str):
    """
    搜索给定查询和库的最新文档。
    支持langchain、llama-index、autogen、agno、openai-agents-sdk、mcp-doc、camel-ai和crew-ai。

    参数:
    query: 要搜索的查询 (例如"React Agent")
    library: 要搜索的库 (例如"agno")

    返回:
    文档中的文本
    """
    if library not in docs_urls:
        raise ValueError(f"Library {library} not supported by this tool")

    query = f"site:{docs_urls[library]} {query}"
    results = await search_web(query)
    if len(results["organic"]) == 0:
        return "No results found"

    text = ""
    for result in results["organic"]:
        text += await fetch_url(result["link"])

    return text
封装MCP Server(基于Stdio协议)
1. MCP Server(Stdio)
# main.py
from mcp.server.fastmcp import FastMCP
from dotenv import load_dotenv
import httpx
import json
import os
from bs4 import BeautifulSoup
from typing import Any
import httpx
from mcp.server.fastmcp import FastMCP
from starlette.applications import Starlette
from mcp.server.sse import SseServerTransport
from starlette.requests import Request
from starlette.routing import Mount, Route
from mcp.server import Server
import uvicorn

load_dotenv()

mcp = FastMCP("Agentdocs")

USER_AGENT = "Agentdocs-app/1.0"
SERPER_URL = "https://google.serper.dev/search"

docs_urls = {
    "langchain": "python.langchain.com/docs",
    "llama-index": "docs.llamaindex.ai/en/stable",
    "autogen": "microsoft.github.io/autogen/stable",
    "agno": "docs.agno.com",
    "openai-agents-sdk": "openai.github.io/openai-agents-python",
    "mcp-doc": "modelcontextprotocol.io",
    "camel-ai": "docs.camel-ai.org",
    "crew-ai": "docs.crewai.com"
}

async def search_web(query: str) -> dict | None:
    payload = json.dumps({"q": query, "num": 2})

    headers = {
        "X-API-KEY": os.getenv("SERPER_API_KEY"),
        "Content-Type": "application/json",
    }

    async with httpx.AsyncClient() as client:
        try:
            response = await client.post(
                SERPER_URL, headers=headers, data=payload, timeout=30.0
            )
            response.raise_for_status()
            return response.json()
        except httpx.TimeoutException:
            return {"organic": []}

async def fetch_url(url: str):
    async with httpx.AsyncClient() as client:
        try:
            response = await client.get(url, timeout=30.0)
            soup = BeautifulSoup(response.text, "html.parser")
            text = soup.get_text()
            return text
        except httpx.TimeoutException:
            return "Timeout error"

@mcp.tool()
async def get_docs(query: str, library: str):
    """
    搜索给定查询和库的最新文档。
    支持langchain、llama-index、autogen、agno、openai-agents-sdk、mcp-doc、camel-ai和crew-ai。

    参数:
    query: 要搜索的查询 (例如"React Agent")
    library: 要搜索的库 (例如"agno")

    返回:
    文档中的文本
    """
    if library not in docs_urls:
        raise ValueError(f"Library {library} not supported by this tool")

    query = f"site:{docs_urls[library]} {query}"
    results = await search_web(query)
    if len(results["organic"]) == 0:
        return "No results found"

    text = ""
    for result in results["organic"]:
        text += await fetch_url(result["link"])

    return text

if __name__ == "__main__":
    mcp.run(transport="stdio")
启动命令:
uv run main.py
2. 客户端配置
2.1 基于Cline
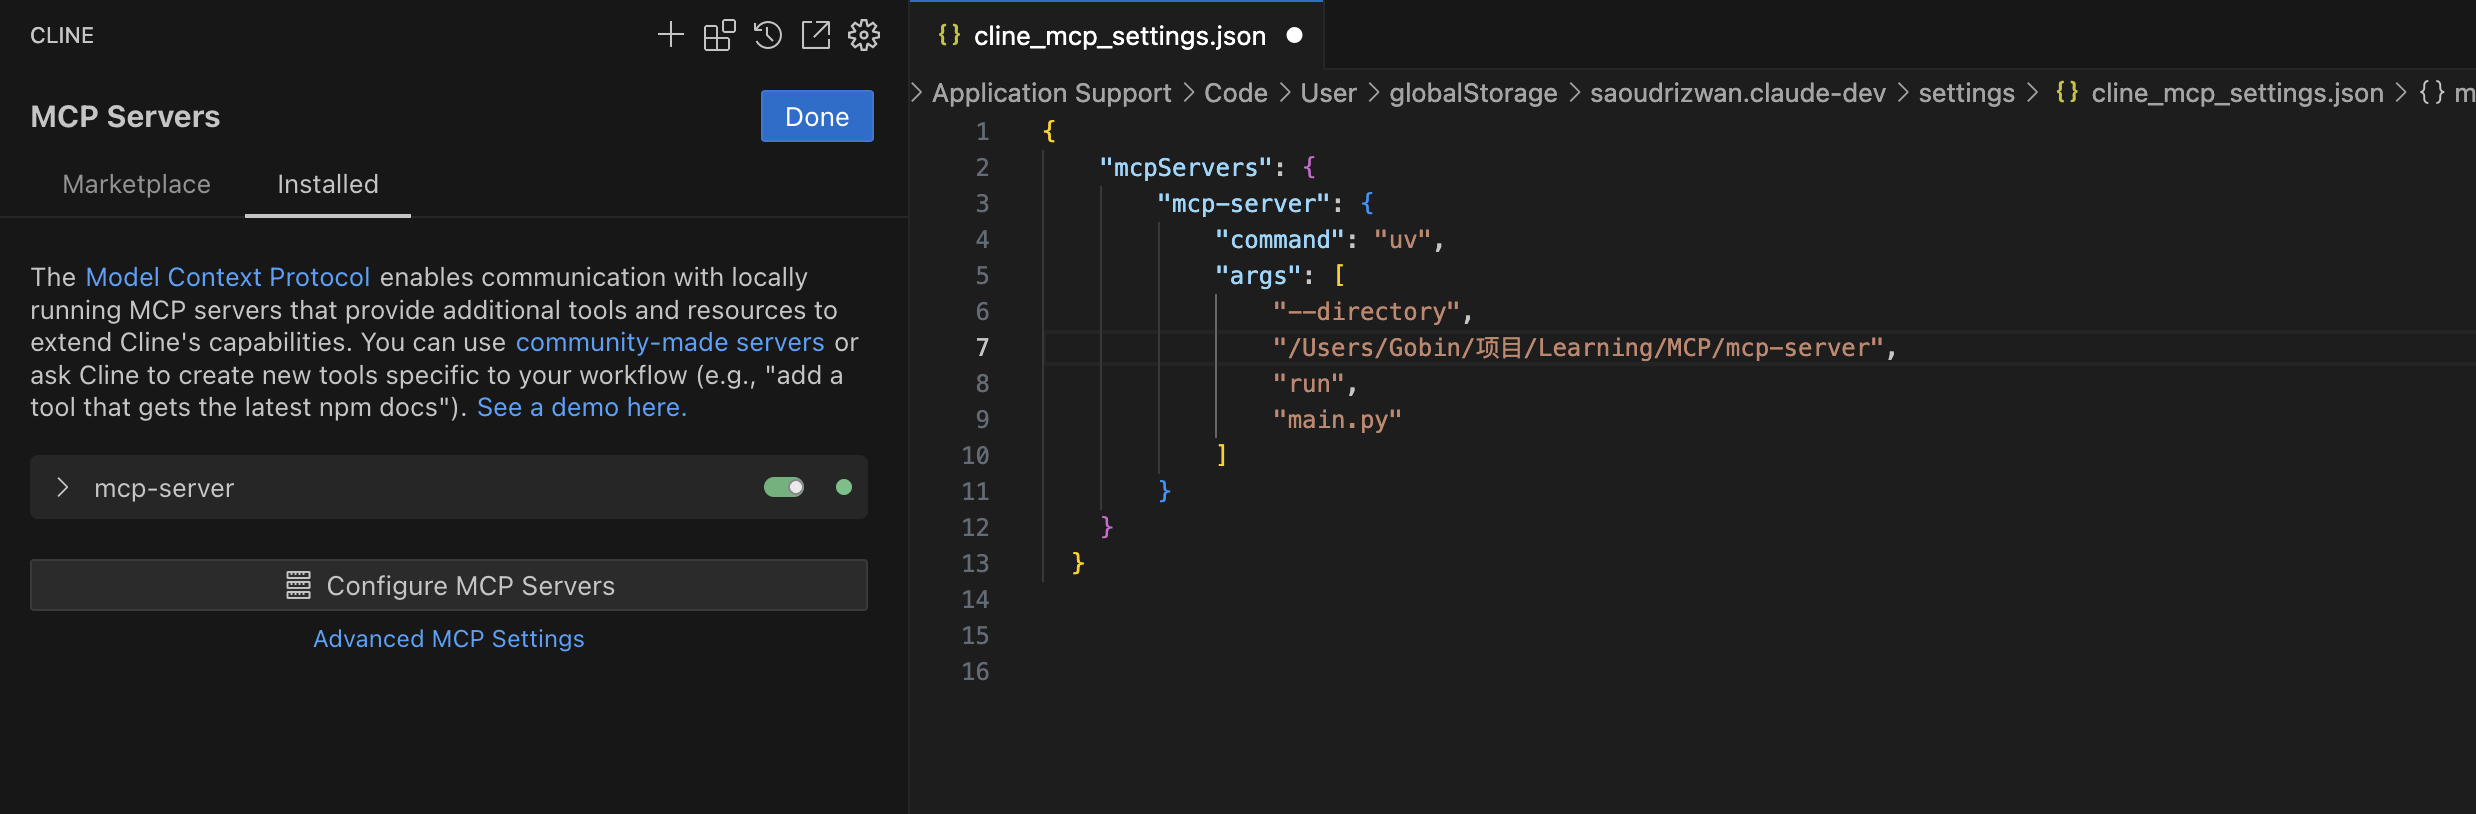
首先在Visual Studio Code安装Cline插件,然后配置MCP:
{
  "mcpServers": {
    "mcp-server": {
      "command": "uv",
      "args": [
        "--directory",
        "<你的项目路径>",
        "run",
        "main.py"
      ]
    }
  }
}
成功绑定如图(左侧绿灯):
2.2 基于Cursor
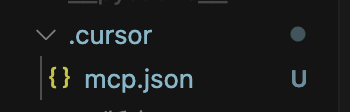
在项目根目录创建.cursor文件夹,并创建mcp.json文件:
然后粘贴以下内容到 mcp.json:
{
  "mcpServers": {
    "mcp-server": {
      "command": "uv",
      "args": [
        "--directory",
        "<你的项目路径>",
        "run",
        "main.py"
      ]
    }
  }
}
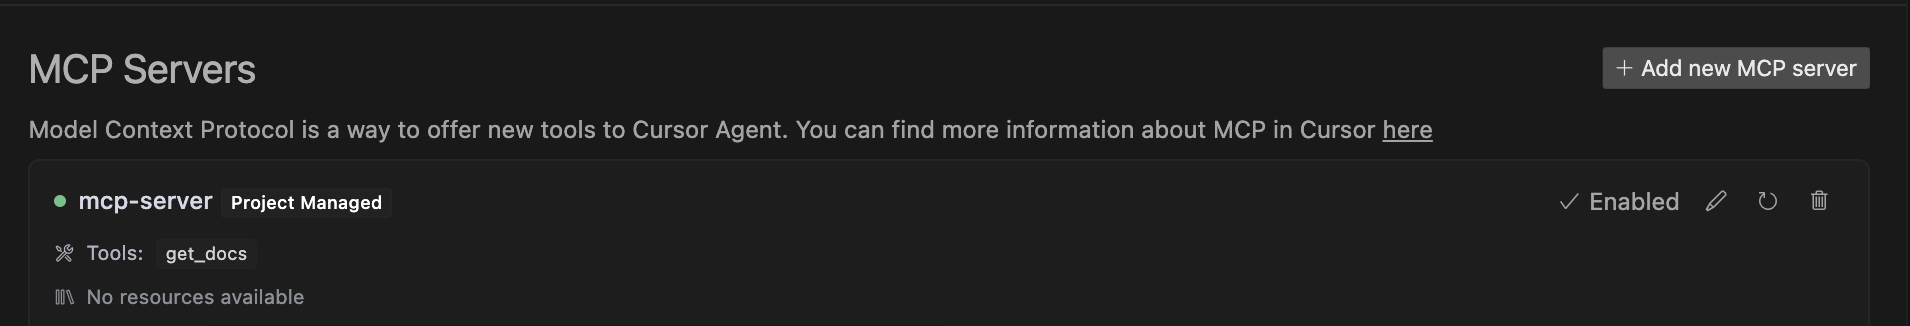
成功配置如图:
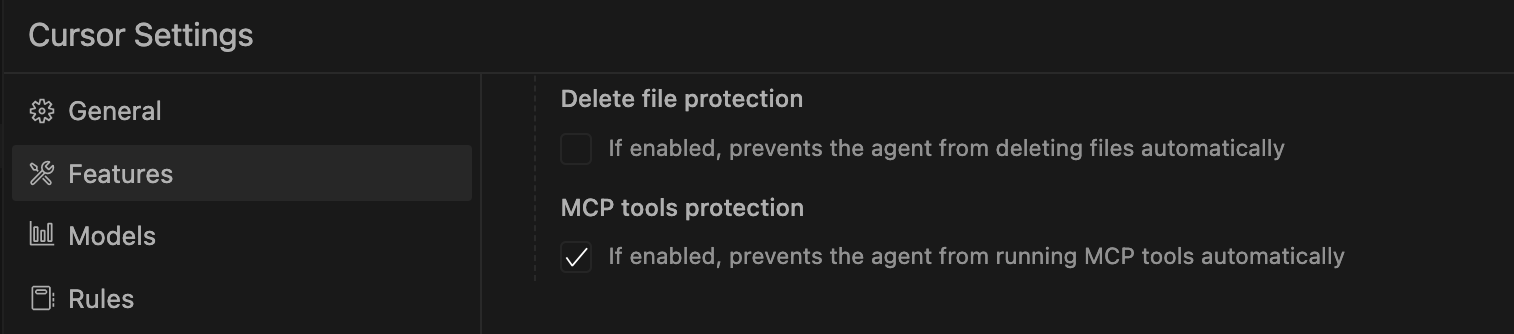
在Features中开启MCP服务:
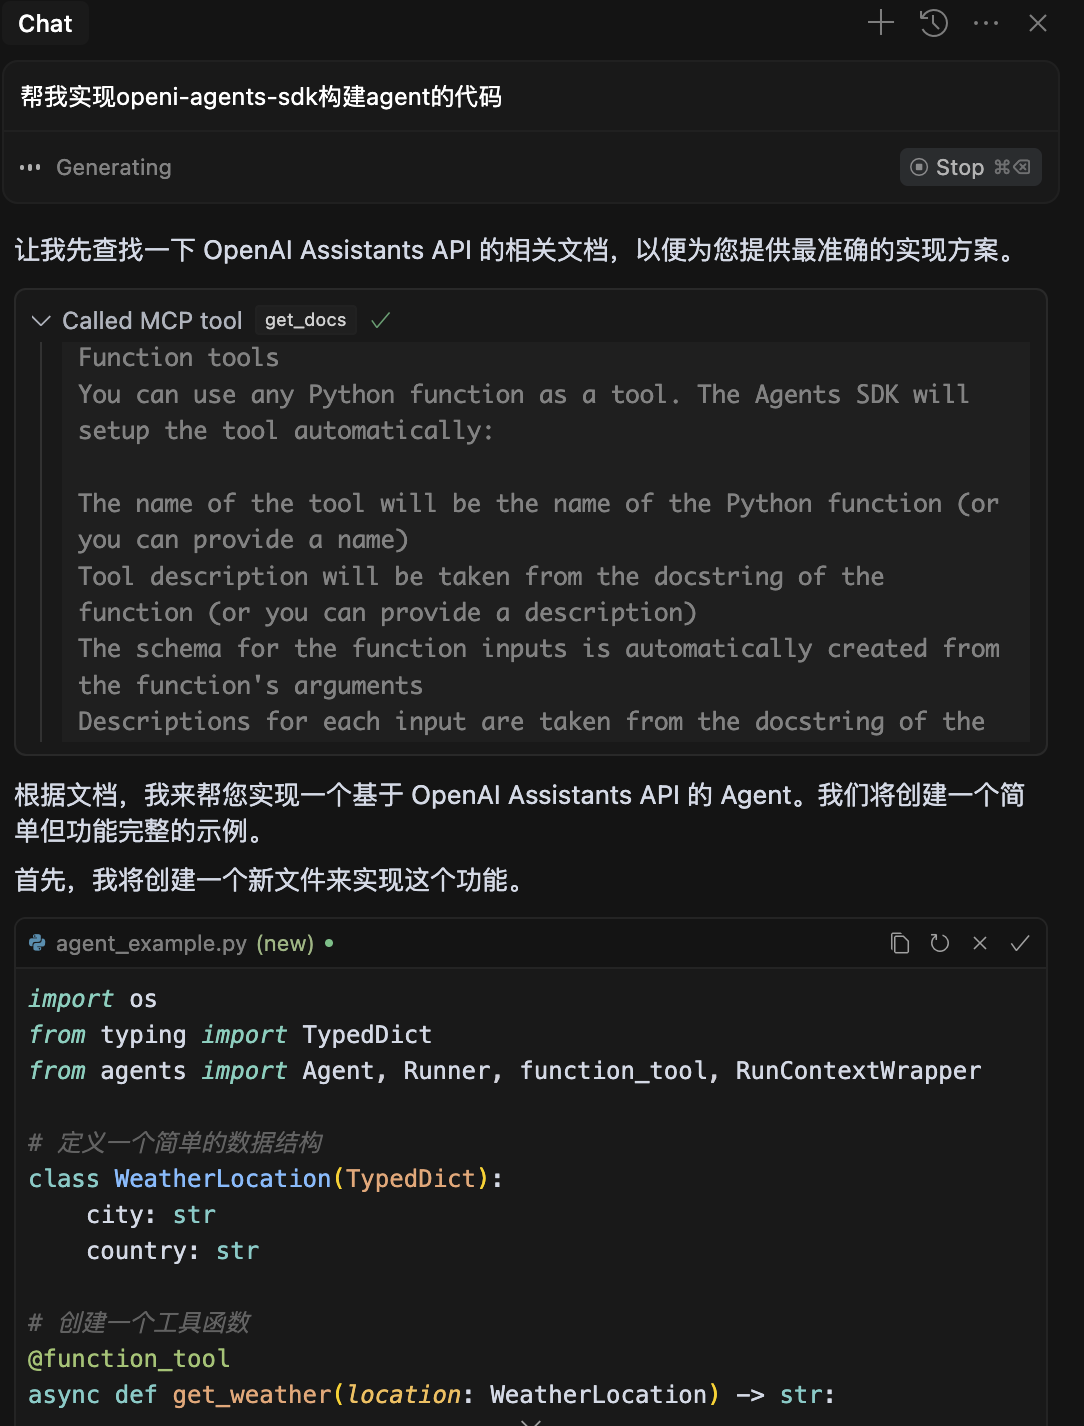
通过对话即可通过MCP获取相关文档信息进行回答:
构建SSE MCP Server(基于SSE协议)
1. 封装MCP Server
from mcp.server.fastmcp import FastMCP
from dotenv import load_dotenv
import httpx
import json
import os
from bs4 import BeautifulSoup
from typing import Any
import httpx
from mcp.server.fastmcp import FastMCP
from starlette.applications import Starlette
from mcp.server.sse import SseServerTransport
from starlette.requests import Request
from starlette.routing import Mount, Route
from mcp.server import Server
import uvicorn

load_dotenv()

mcp = FastMCP("docs")

USER_AGENT = "docs-app/1.0"
SERPER_URL = "https://google.serper.dev/search"

docs_urls = {
    "langchain": "python.langchain.com/docs",
    "llama-index": "docs.llamaindex.ai/en/stable",
    "autogen": "microsoft.github.io/autogen/stable",
    "agno": "docs.agno.com",
    "openai-agents-sdk": "openai.github.io/openai-agents-python",
    "mcp-doc": "modelcontextprotocol.io",
    "camel-ai": "docs.camel-ai.org",
    "crew-ai": "docs.crewai.com"
}

async def search_web(query: str) -> dict | None:
    payload = json.dumps({"q": query, "num": 2})

    headers = {
        "X-API-KEY": os.getenv("SERPER_API_KEY"),
        "Content-Type": "application/json",
    }

    async with httpx.AsyncClient() as client:
        try:
            response = await client.post(
                SERPER_URL, headers=headers, data=payload, timeout=30.0
            )
            response.raise_for_status()
            return response.json()
        except httpx.TimeoutException:
            return {"organic": []}

async def fetch_url(url: str):
    async with httpx.AsyncClient() as client:
        try:
            response = await client.get(url, timeout=30.0)
            soup = BeautifulSoup(response.text, "html.parser")
            text = soup.get_text()
            return text
        except httpx.TimeoutException:
            return "Timeout error"

@mcp.tool()
async def get_docs(query: str, library: str):
    """
    搜索给定查询和库的最新文档。
    支持langchain、llama-index、autogen、agno、openai-agents-sdk、mcp-doc、camel-ai和crew-ai。

    参数:
    query: 要搜索的查询 (例如"React Agent")
    library: 要搜索的库 (例如"agno")

    返回:
    文档中的文本
    """
    if library not in docs_urls:
        raise ValueError(f"Library {library} not supported by this tool")

    query = f"site:{docs_urls[library]} {query}"
    results = await search_web(query)
    if len(results["organic"]) == 0:
        return "No results found"

    text = ""
    for result in results["organic"]:
        text += await fetch_url(result["link"])

    return text

## sse传输
def create_starlette_app(mcp_server: Server, *, debug: bool = False) -> Starlette:
    """创建一个Starlette应用来提供基于SSE的MCP服务器"""
    sse = SseServerTransport("/messages/")

    async def handle_sse(request: Request) -> None:
        async with sse.connect_sse(
                request.scope,
                request.receive,
                request._send,  # noqa: SLF001
        ) as (read_stream, write_stream):
            await mcp_server.run(
                read_stream,
                write_stream,
                mcp_server.create_initialization_options(),
            )

    return Starlette(
        debug=debug,
        routes=[
            Route("/sse", endpoint=handle_sse),
            Mount("/messages/", app=sse.handle_post_message),
        ],
    )

if __name__ == "__main__":
    mcp_server = mcp._mcp_server

    import argparse

    parser = argparse.ArgumentParser(description='运行基于SSE的MCP服务器')
    parser.add_argument('--host', default='0.0.0.0', help='绑定的主机')
    parser.add_argument('--port', type=int, default=8020, help='监听的端口')
    args = parser.parse_args()

    # 绑定SSE请求处理到MCP服务器
    starlette_app = create_starlette_app(mcp_server, debug=True)

    uvicorn.run(starlette_app, host=args.host, port=args.port)
启动命令:
uv run main.py --host 0.0.0.0 --port 8020
以上MCP server代码可直接在云服务器上运行。
2. 构建MCP Client
import asyncio
import json
import os
from typing import Optional
from contextlib import AsyncExitStack
import time
from mcp import ClientSession
from mcp.client.sse import sse_client

from openai import AsyncOpenAI
from dotenv import load_dotenv

load_dotenv()  # 从.env加载环境变量

class MCPClient:
    def __init__(self):
        # 初始化会话和客户端对象
        self.session: Optional[ClientSession] = None
        self.exit_stack = AsyncExitStack()
        self.openai = AsyncOpenAI(api_key=os.getenv("OPENAI_API_KEY"), base_url=os.getenv("OPENAI_BASE_URL"))

    async def connect_to_sse_server(self, server_url: str):
        """连接到使用SSE传输的MCP服务器"""
        # 存储上下文管理器以保持连接
        self._streams_context = sse_client(url=server_url)
        streams = await self._streams_context.__aenter__()

        self._session_context = ClientSession(*streams)
        self.session: ClientSession = await self._session_context.__aenter__()

        # 初始化
        await self.session.initialize()

        # 列出可用工具以验证连接
        print("初始化SSE客户端...")
        print("列出工具...")
        response = await self.session.list_tools()
        tools = response.tools
        print("\n已连接到服务器,可用工具:", [tool.name for tool in tools])

    async def cleanup(self):
        """正确清理会话和流"""
        if self._session_context:
            await self._session_context.__aexit__(None, None, None)
        if self._streams_context:
            await self._streams_context.__aexit__(None, None, None)

    async def process_query(self, query: str) -> str:
        """使用OpenAI API和可用工具处理查询"""
        messages = [
            {
                "role": "user",
                "content": query
            }
        ]

        response = await self.session.list_tools()
        available_tools = [{
            "type": "function",
            "function": {
                "name": tool.name,
                "description": tool.description,
                "parameters": tool.inputSchema
            }
        } for tool in response.tools]

        # 初始OpenAI API调用
        completion = await self.openai.chat.completions.create(
            model=os.getenv("OPENAI_MODEL"),
            max_tokens=1000,
            messages=messages,
            tools=available_tools
        )

        # 处理响应并处理工具调用
        tool_results = []
        final_text = []

        assistant_message = completion.choices[0].message

        if assistant_message.tool_calls:
            for tool_call in assistant_message.tool_calls:
                tool_name = tool_call.function.name
                tool_args = json.loads(tool_call.function.arguments)

                # 执行工具调用
                result = await self.session.call_tool(tool_name, tool_args)
                tool_results.append({"call": tool_name, "result": result})
                final_text.append(f"[调用工具 {tool_name} 参数 {tool_args}]")

                # 继续与工具结果对话
                messages.extend([
                    {
                        "role": "assistant",
                        "content": None,
                        "tool_calls": [tool_call]
                    },
                    {
                        "role": "tool",
                        "tool_call_id": tool_call.id,
                        "content": result.content[0].text
                    }
                ])

                print(f"工具 {tool_name} 返回: {result.content[0].text}")
                print("messages", messages)
                # 获取OpenAI的下一个响应
                completion = await self.openai.chat.completions.create(
                    model=os.getenv("OPENAI_MODEL"),
                    max_tokens=1000,
                    messages=messages,
                )
                if isinstance(completion.choices[0].message.content, (dict, list)):
                    final_text.append(str(completion.choices[0].message.content))
                else:
                    final_text.append(completion.choices[0].message.content)
        else:
            if isinstance(assistant_message.content, (dict, list)):
                final_text.append(str(assistant_message.content))
            else:
                final_text.append(assistant_message.content)

        return "\n".join(final_text)

    async def chat_loop(self):
        """运行交互式聊天循环"""
        print("\nMCP客户端已启动!")
        print("输入你的查询或'quit'退出。")

        while True:
            try:
                query = input("\n查询: ").strip()

                if query.lower() == 'quit':
                    break

                response = await self.process_query(query)
                print("\n" + response)

            except Exception as e:
                print(f"\n错误: {str(e)}")

async def main():
    if len(sys.argv) < 2:
        print("用法: uv run client.py <SSE MCP服务器URL (例如 http://localhost:8080/sse)>")
        sys.exit(1)

    client = MCPClient()
    try:
        await client.connect_to_sse_server(server_url=sys.argv[1])
        await client.chat_loop()
    finally:
        await client.cleanup()

if __name__ == "__main__":
    import sys
    asyncio.run(main())
启动命令:
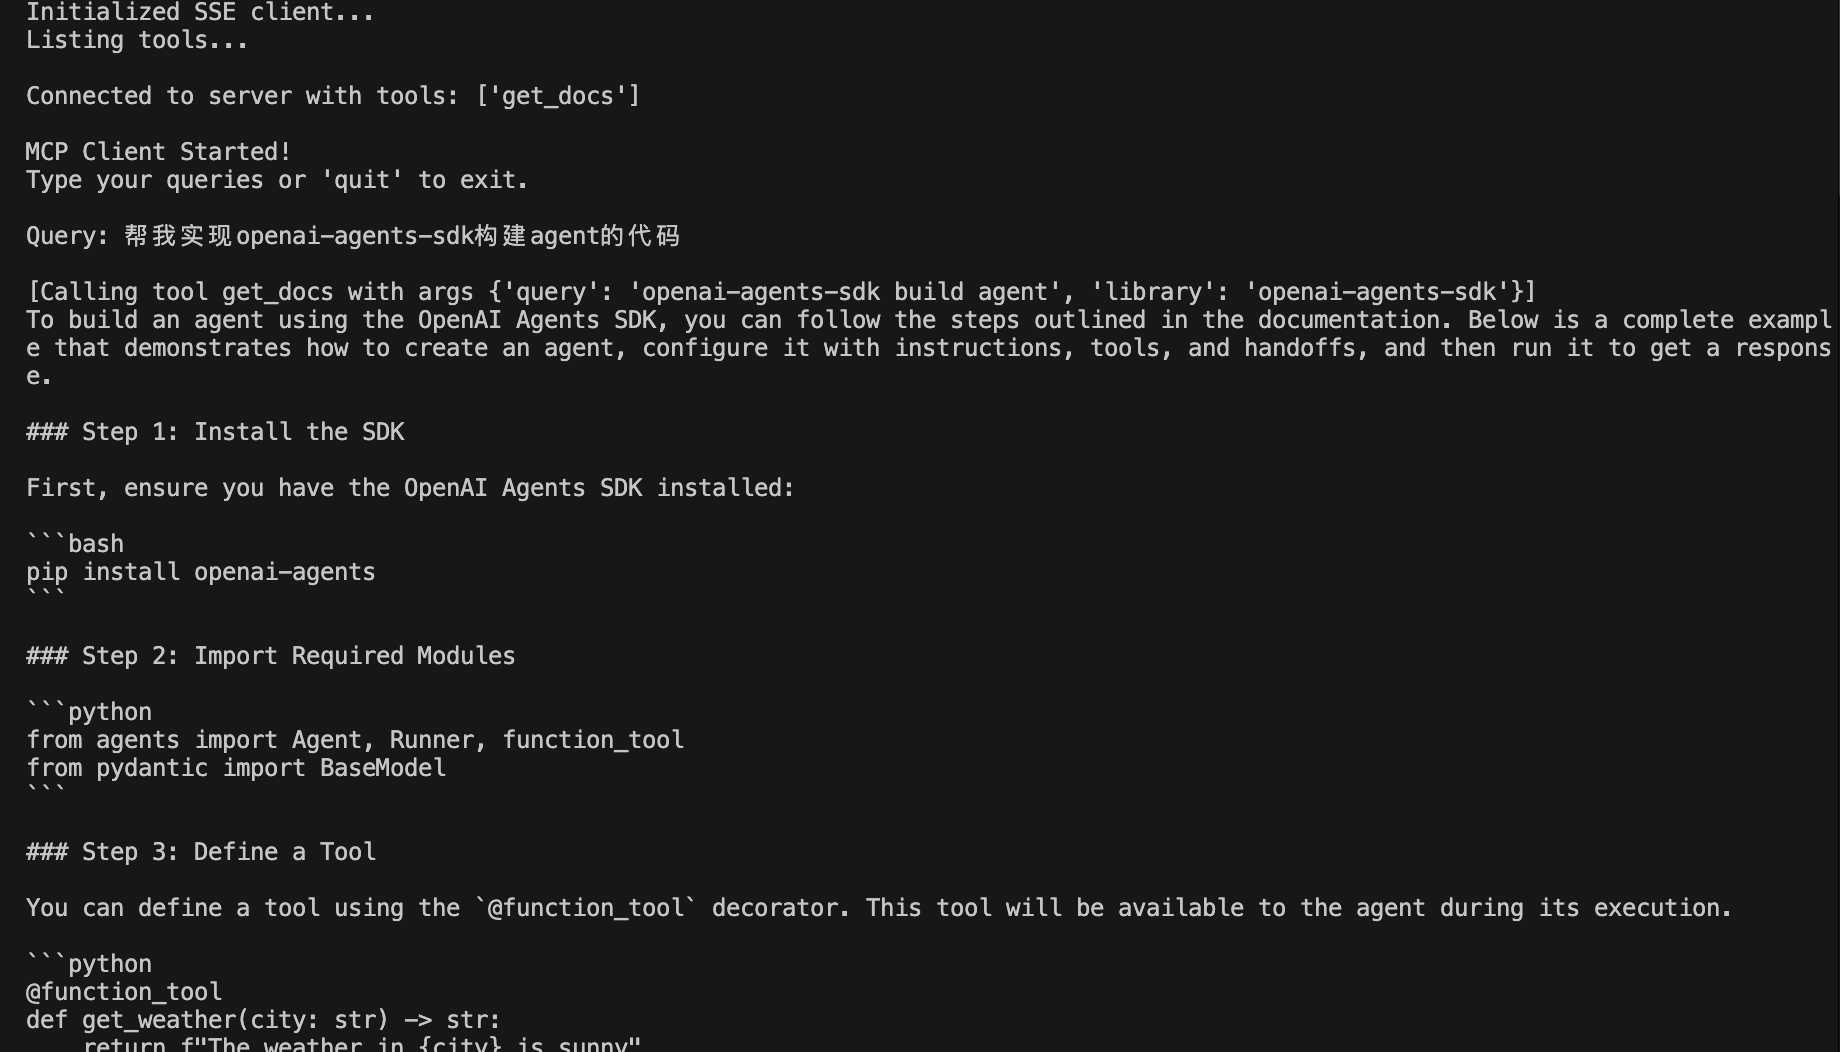
uv run client.py http://0.0.0.0:8020/sse
客户端日志:
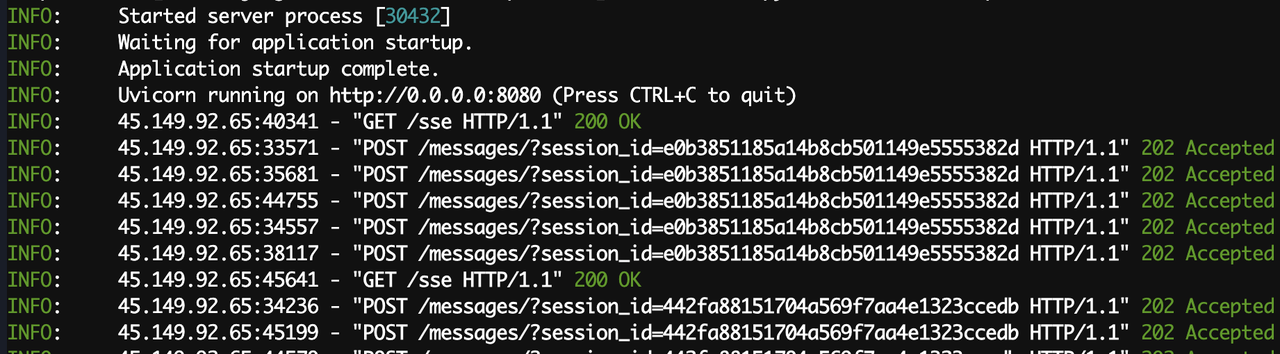
服务器日志:
以上便是 Python 从 0 到 1 搭建 MCP Server 以及 MCP Client 的完整教程。有不对的地方请多多指教。 参考相关资料:
- https://www.youtube.com/watch?v=Ek8JHgZtmcI
- https://serper.dev/
- https://modelcontextprotocol.io/quickstart/server
- https://modelcontextprotocol.io/quickstart/client
- https://docs.cursor.com/context/model-context-protocol
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号