
 模型上下文协议服务器Rememberizer添加福利群:解决AI开发者的「MCP实战痛点」
 github
MCP 服务器 Rememberizer

一个用于与 Rememberizer 的文档和知识管理 API 交互的模型上下文协议服务器。该服务器使大型语言模型能够通过 Rememberizer 搜索、检索和管理文档及集成。
请注意,mcp-server-rememberizer 目前正在开发中,功能可能会有所变化。
组件
资源
服务器提供对两种类型资源的访问:文档或 Slack 讨论
工具
-
retrieve_semantically_similar_internal_knowledge- 发送一段文本,并从您连接的 Rememberizer 个人/团队内部知识和记忆库中检索余弦相似度匹配项
- 输入:
match_this(字符串):最多 400 个单词的句子,您希望为其找到语义相似的文本块n_results(整数,可选):要返回的语义相似文本块的数量。使用 'n_results=3' 最多返回 5 个,使用 'n_results=10' 获取更多信息from_datetime_ISO8601(字符串,可选):ISO 8601 格式的起始日期,带时区(例如,2023-01-01T00:00:00Z)。使用此选项过滤从特定日期开始的结果to_datetime_ISO8601(字符串,可选):ISO 8601 格式的结束日期,带时区(例如,2024-01-01T00:00:00Z)。使用此选项过滤直到特定日期的结果
- 返回:搜索结果作为文本输出
-
smart_search_internal_knowledge- 在 Rememberizer 的个人/团队内部知识和记忆库中搜索文档,使用简单查询返回代理搜索的结果。搜索可能包括 Slack 讨论、Gmail、Dropbox 文档、Google Drive 文档和上传的文件等来源
- 输入:
query(字符串):最多 400 个单词的句子,您希望为其找到语义相似的文本块user_context(字符串,可选):查询的附加上下文。您可能需要总结到目前为止的对话,以获得更好的上下文感知结果n_results(整数,可选):要返回的语义相似文本块的数量。使用 'n_results=3' 最多返回 5 个,使用 'n_results=10' 获取更多信息from_datetime_ISO8601(字符串,可选):ISO 8601 格式的起始日期,带时区(例如,2023-01-01T00:00:00Z)。使用此选项过滤从特定日期开始的结果to_datetime_ISO8601(字符串,可选):ISO 8601 格式的结束日期,带时区(例如,2024-01-01T00:00:00Z)。使用此选项过滤直到特定日期的结果
- 返回:搜索结果作为文本输出
-
list_internal_knowledge_systems- 列出个人/团队内部知识的来源。这些可能包括 Slack 讨论、Gmail、Dropbox 文档、Google Drive 文档和上传的文件
- 输入:无需输入
- 返回:可用集成列表
-
rememberizer_account_information- 获取有关您的 Rememberizer.ai 个人/团队知识库账户的信息。包括账户持有人姓名和电子邮件地址
- 输入:无需输入
- 返回:账户信息详情
-
list_personal_team_knowledge_documents- 检索您个人/团队知识系统中所有文档的分页列表。来源可能包括 Slack 讨论、Gmail、Dropbox 文档、Google Drive 文档和上传的文件
- 输入:
page(整数,可选):分页的页码,从 1 开始(默认:1)page_size(整数,可选):每页的文档数量,范围 1-1000(默认:100)
- 返回:文档列表
-
remember_this- 在您的 Rememberizer.ai 知识系统中保存一段文本信息,以便将来可以通过工具
retrieve_semantically_similar_internal_knowledge或smart_search_internal_knowledge召回 - 输入:
name(字符串):信息的名称。用于将来识别该信息content(字符串):您希望记忆的信息
- 返回:确认数据
- 在您的 Rememberizer.ai 知识系统中保存一段文本信息,以便将来可以通过工具
安装
手动安装
uvx mcp-server-rememberizer
通过 MseeP AI 助手应用
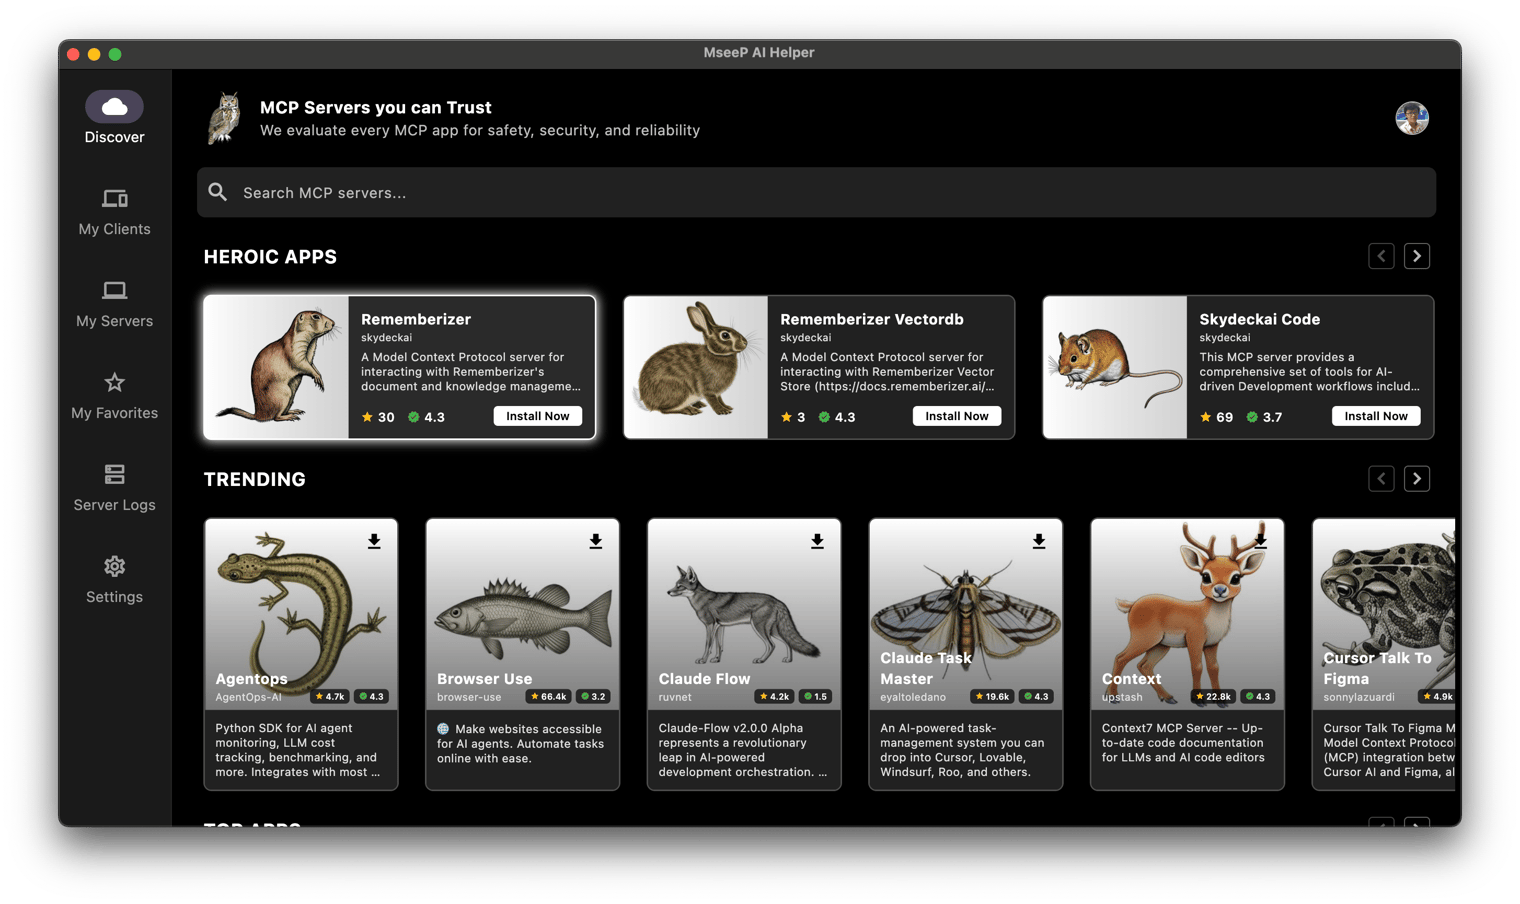
如果您已安装 MseeP AI 助手应用,您可以搜索 "Rememberizer" 并安装 mcp-server-rememberizer。
配置
环境变量
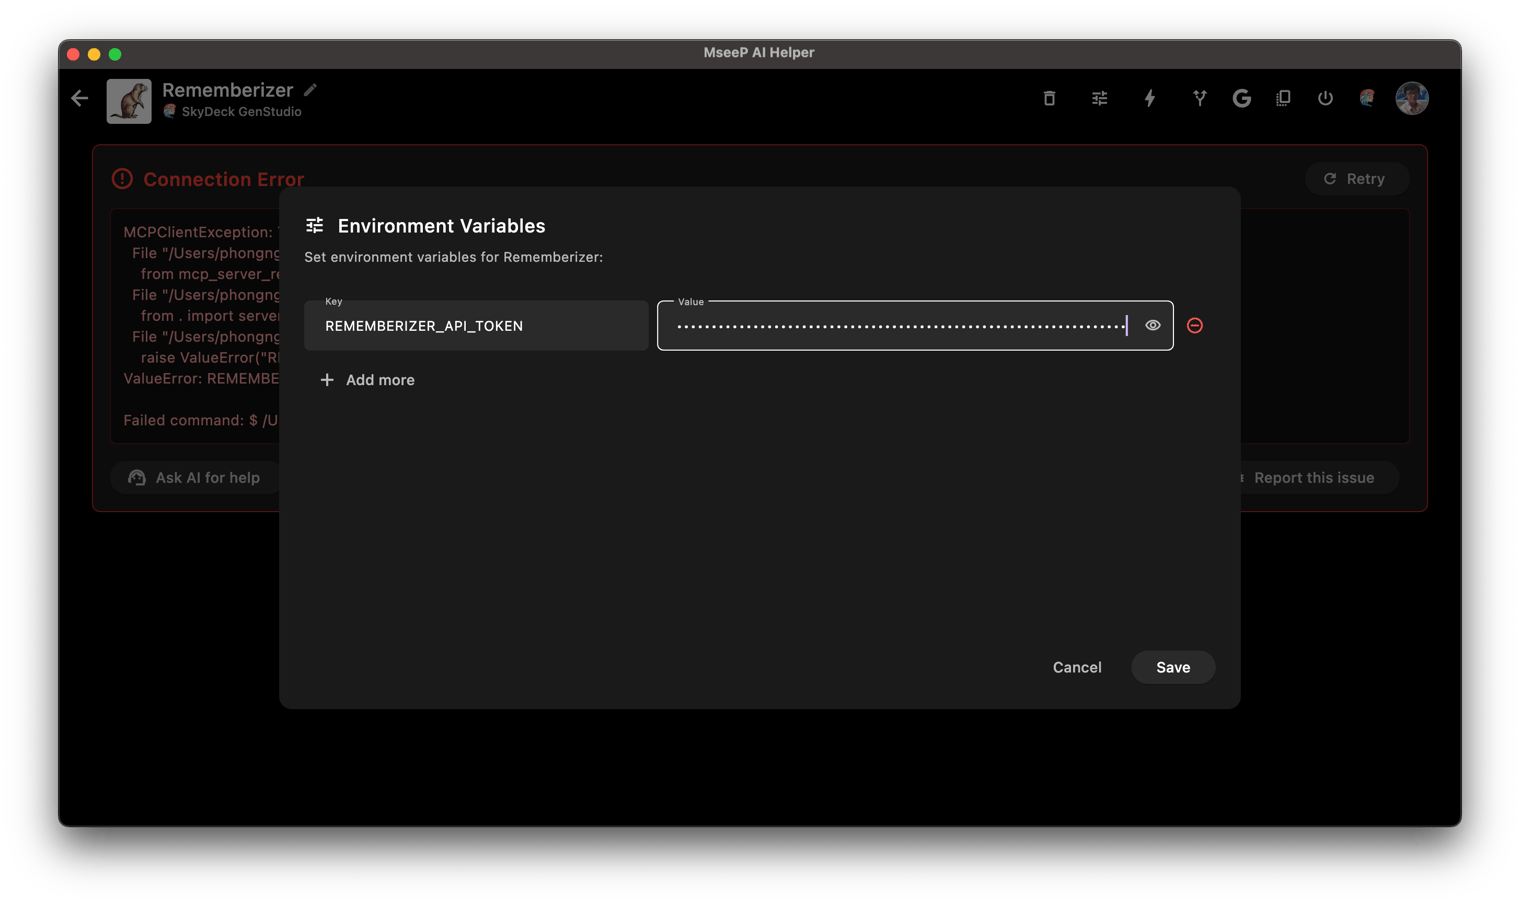
需要以下环境变量:
REMEMBERIZER_API_TOKEN:您的 Rememberizer API 令牌
您可以通过创建自己的Rememberizer 中的公共知识来注册 API 密钥。
与 Claude Desktop 一起使用
将此添加到您的 claude_desktop_config.json 中:
"mcpServers": {
  "rememberizer": {
      "command": "uvx",
      "args": ["mcp-server-rememberizer"],
      "env": {
        "REMEMBERIZER_API_TOKEN": "your_rememberizer_api_token"
      }
    },
}

与 MseeP AI 助手应用一起使用
将环境变量 REMEMBERIZER_API_TOKEN 添加到 mcp-server-rememberizer。
借助 Rememberizer MCP 服务器的支持,您现在可以在您的 Claude Desktop 应用或 SkyDeck AI GenStudio 中提出以下问题:
-
我的 Rememberizer 账户是什么?
-
列出我所有的文档。
-
给我一个关于 "..." 的快速摘要
-
等等...
要了解更多关于 Rememberizer MCP 服务器的信息:https://docs.rememberizer.ai/personal-use/integrations/rememberizer-mcp-servers
许可证
本项目根据 Apache 许可证 2.0 授权 - 有关详细信息,请参阅 LICENSE 文件。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号