
 GPT Researcher MCP添加福利群:解决AI开发者的「MCP实战痛点」
 github
🔎 GPT Researcher
GPT Researcher 是一个开源的深度研究代理,旨在为任何给定任务进行网络和本地研究。
该代理生成详细、事实准确且无偏见的研究报告,并附带引用。GPT Researcher 提供了一套完整的自定义选项,以创建量身定制和特定领域的研究代理。受最近的 Plan-and-Solve 和 RAG 论文的启发,GPT Researcher 通过并行化代理工作提供稳定的性能和更快的速度,解决了错误信息、速度、确定性和可靠性问题。
我们的使命是通过人工智能为个人和组织提供准确、无偏见和事实准确的信息。
为什么选择 GPT Researcher?
- 手动研究的客观结论可能需要数周时间,耗费大量资源和时间。
- 基于过时信息训练的 LLM 可能会产生幻觉,导致在当前研究任务中不相关。
- 当前的 LLM 存在令牌限制,不足以生成长篇研究报告。
- 现有服务中的有限网络来源导致错误信息和浅薄的结果。
- 选择性网络来源可能会在研究任务中引入偏见。
演示
https://github.com/user-attachments/assets/8fcaaa4c-31e5-4814-89b4-94f1433d139d
架构
核心思想是利用“规划器”和“执行”代理。规划器生成研究问题,而执行代理则收集相关信息。发布者将所有发现汇总成一份全面的报告。
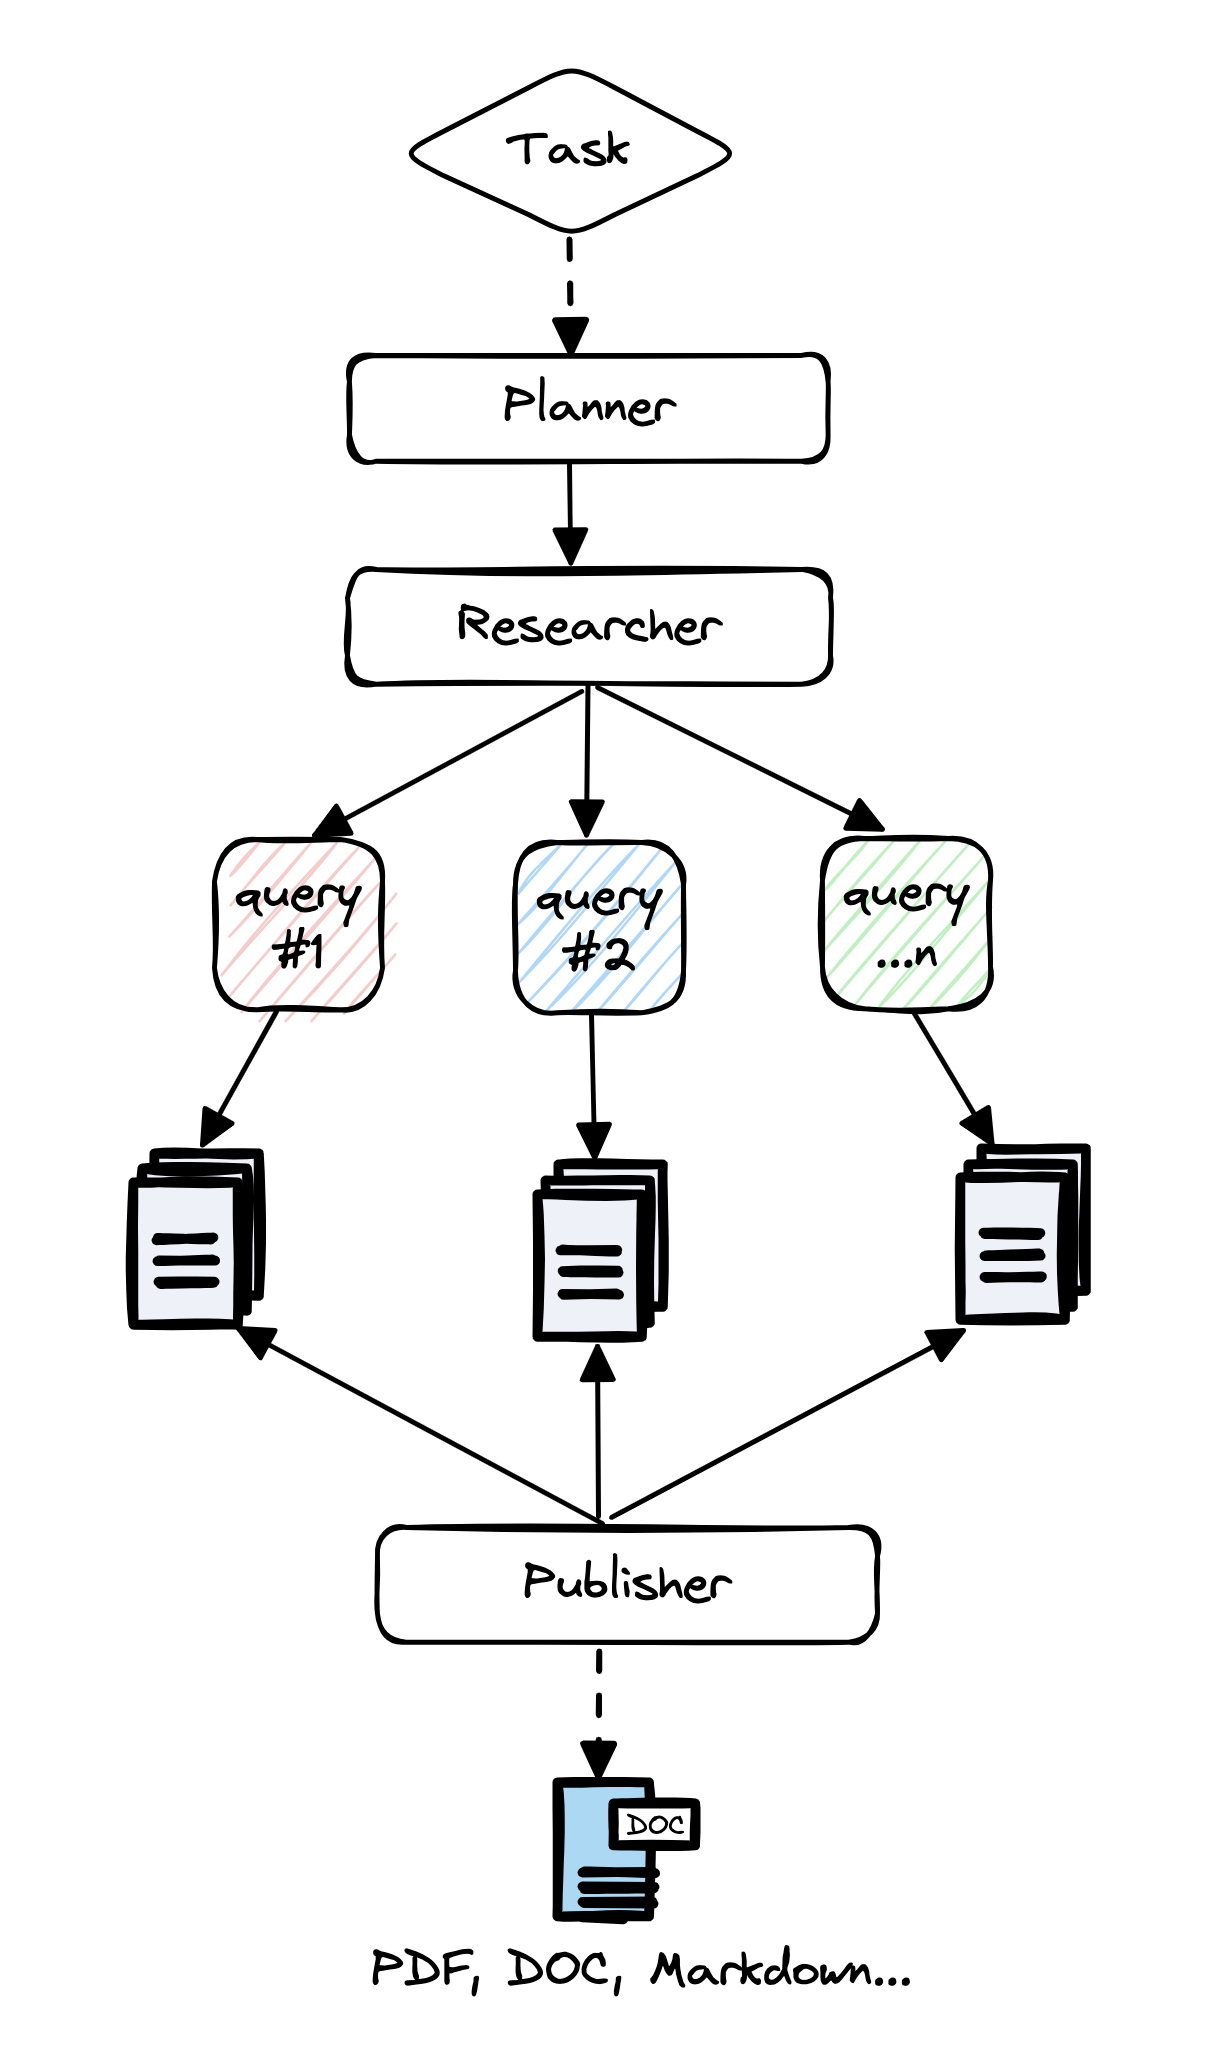
步骤:
- 基于研究查询创建任务特定的代理。
- 生成问题,这些问题共同形成对任务的客观意见。
- 使用爬虫代理为每个问题收集信息。
- 总结并跟踪每个资源的来源。
- 过滤并汇总摘要,形成最终的研究报告。
教程
功能
- 📝 使用网络和本地文档生成详细的研究报告。
- 🖼️ 智能图像抓取和过滤,用于报告。
- 📜 生成超过 2,000 字的详细报告。
- 🌐 汇总超过 20 个来源,形成客观结论。
- 🖥️ 前端提供轻量级(HTML/CSS/JS)和生产就绪(NextJS + Tailwind)版本。
- 🔍 启用 JavaScript 的网络爬取。
- 📂 在研究过程中保持记忆和上下文。
- 📄 将报告导出为 PDF、Word 和其他格式。
📖 文档
查看 文档 了解:
- 安装和设置指南
- 配置和自定义选项
- 操作示例
- 完整的 API 参考
⚙️ 入门指南
安装
-
安装 Python 3.11 或更高版本。指南。
-
克隆项目并导航到目录:
git clone https://github.com/assafelovic/gpt-researcher.git
cd gpt-researcher
-
通过导出或存储在
.env文件中设置 API 密钥。export OPENAI_API_KEY={您的 OpenAI API 密钥} export TAVILY_API_KEY={您的 Tavily API 密钥} -
安装依赖项并启动服务器:
pip install -r requirements.txt
python -m uvicorn main:app --reload
访问 http://localhost:8000 开始。
对于其他设置(例如 Poetry 或虚拟环境),请查看 入门页面。
作为 PIP 包运行
pip install gpt-researcher
示例用法:
...
from gpt_researcher import GPTResearcher

query = "为什么英伟达股票在上涨?"
researcher = GPTResearcher(query=query)
# 对给定查询进行研究
research_result = await researcher.conduct_research()
# 撰写报告
report = await researcher.write_report()
...
更多示例和配置,请参阅 PIP 文档 页面。
🔧 MCP 客户端
GPT Researcher 支持 MCP 集成,以连接到 GitHub 仓库、数据库和自定义 API 等专门的数据源。这使得可以在网络搜索的同时从数据源进行研究。
export RETRIEVER=tavily,mcp # 启用混合网络 + MCP 研究
from gpt_researcher import GPTResearcher
import asyncio
import os

async def mcp_research_example():
    # 启用 MCP 与网络搜索
    os.environ["RETRIEVER"] = "tavily,mcp"

    researcher = GPTResearcher(
        query="什么是顶级的开源网络研究代理?",
        mcp_configs=[
            {
                "name": "github",
                "command": "npx",
                "args": ["-y", "@modelcontextprotocol/server-github"],
                "env": {"GITHUB_TOKEN": os.getenv("GITHUB_TOKEN")}
            }
        ]
    )

    research_result = await researcher.conduct_research()
    report = await researcher.write_report()
    return report
有关全面的 MCP 文档和高级示例,请访问 MCP 集成指南。
✨ 深度研究
GPT Researcher 现在包括深度研究——一种高级的递归研究工作流程,以代理的深度和广度探索主题。此功能采用树状探索模式,深入研究子主题,同时保持对研究主题的全面视图。
- 🌳 可配置深度和广度的树状探索
- ⚡️ 并发处理以获得更快的结果
- 🤝 跨研究分支的智能上下文管理
- ⏱️ 每次深度研究大约需要 5 分钟
- 💰 每次研究成本约为 $0.4(使用
o3-mini进行“高”推理努力)
在我们的文档中 了解更多关于深度研究 的信息。
使用 Docker 运行
步骤 1 - 安装 Docker
步骤 2 - 克隆 '.env.example' 文件,将您的 API 密钥添加到克隆的文件中,并将文件保存为 '.env'
步骤 3 - 在 docker-compose 文件中注释掉您不想使用 Docker 运行的服务。
docker-compose up --build
如果不起作用,请尝试不带破折号运行:
docker compose up --build
步骤 4 - 默认情况下,如果您没有在 docker-compose 文件中取消注释任何内容,此流程将启动 2 个进程:
- 运行在 localhost:8000 的 Python 服务器
- 运行在 localhost:3000 的 React 应用
在任何浏览器中访问 localhost:3000 并开始研究!
📄 基于本地文档的研究
您可以指示 GPT Researcher 基于您的本地文档运行研究任务。当前支持的文件格式包括:PDF、纯文本、CSV、Excel、Markdown、PowerPoint 和 Word 文档。
步骤 1:添加指向文档所在文件夹的环境变量 DOC_PATH。
export DOC_PATH="./my-docs"
步骤 2:
- 如果您在 localhost:8000 上运行前端应用,只需从“报告来源”下拉选项中选择“我的文档”。
- 如果您使用 PIP 包 运行 GPT Researcher,请在实例化
GPTResearcher类时将report_source参数传递为“local”代码示例在此。
🤖 MCP 服务器
我们已将 MCP 服务器移至专用仓库:gptr-mcp。
GPT Researcher MCP 服务器使 Claude 等 AI 应用程序能够进行深度研究。虽然 LLM 应用程序可以通过 MCP 访问网络搜索工具,但 GPT Researcher MCP 提供了更深层次、更可靠的研究结果。
功能:
- AI 助手的深度研究能力
- 通过优化上下文使用获得更高质量的信息
- 综合结果,为 LLM 提供更好的推理
- Claude 桌面集成
有关详细的安装和使用说明,请访问 官方仓库。
👪 多智能体助手
随着人工智能从提示工程和RAG发展到多智能体系统,我们很高兴推出基于LangGraph构建的全新多智能体助手。
通过使用LangGraph,研究过程的深度和质量可以显著提升,这得益于多个具备专业技能的智能体的协同工作。受近期STORM论文的启发,该项目展示了AI智能体团队如何从规划到发布,共同完成对给定主题的研究。
平均每次运行会生成一份5-6页的研究报告,支持PDF、Docx和Markdown等多种格式。
🖥️ 前端应用
GPT-Researcher现在提供了一个增强的前端,以提升用户体验并简化研究流程。该前端提供以下功能:
- 用于输入研究查询的直观界面
- 研究任务的实时进度跟踪
- 研究结果的交互式展示
- 可自定义设置,打造个性化的研究体验
提供两种部署选项:
- 由FastAPI提供的轻量级静态前端
- 功能丰富的NextJS应用,支持更高级的功能
有关详细设置说明和前端功能的更多信息,请访问我们的文档页面。
🚀 贡献
我们非常欢迎贡献!如果您有兴趣,请查看贡献指南。
如果您有兴趣加入我们的使命,请查看我们的路线图页面,并通过Discord社区联系我们。
✉️ 支持 / 联系我们
- 社区Discord
- 作者邮箱:assaf.elovic@gmail.com
🛡 免责声明
本项目GPT Researcher是一个实验性应用,按“原样”提供,不提供任何明示或暗示的保证。我们根据Apache 2许可证共享代码,仅供学术目的。此处内容并非学术建议,也不推荐用于学术或研究论文。
我们对无偏见研究的看法:
- GPT Researcher的主要目标是减少错误和有偏见的事实。如何实现?我们假设抓取的网站越多,错误数据的可能性就越低。通过每次研究抓取多个网站并选择最常见的信息,所有信息都错误的可能性极低。
- 我们的目标不是消除偏见,而是尽可能减少偏见。我们作为一个社区,致力于探索最有效的人机交互方式。
- 在研究中,人们也容易倾向于偏见,因为大多数人对他们研究的主题已有自己的观点。该工具抓取了许多观点,并会均衡地解释多样化的观点,而这些观点可能是一个有偏见的人从未阅读过的。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号