普通节点
前提条件
已开通 腾讯云容器服务,并已创建 TKE 标准集群。
集群版本不低于 1.8.x(TKE GPU 调度的最低支持版本)。
已了解业务对 GPU 驱动版本、CUDA 版本、cuDNN 版本的具体要求。
当前账号已具备目标集群的节点管理权限。
使用限制
仅 GPU 机型支持安装 GPU 驱动,CPU 机型即使加入集群也不会自动安装 GPU 驱动。
支持的驱动版本由操作系统镜像(OS)和 GPU 机型共同决定,具体兼容矩阵请参见 各实例支持的 GPU 驱动版本及安装方式。
节点加入集群后,不支持直接在控制台变更已生效的 GPU 驱动版本。需要变更时,请将节点移出集群,重装系统或销毁后重新加入并指定新的驱动配置。
独立集群的 Master 节点暂不支持设置为 GPU 机型。
驱动安装方式概览
TKE 普通节点支持以下四种 GPU 驱动安装方式,请根据业务场景选择:
方式 | 适用场景 | 推荐度 |
CVM 控制台已提供该机型 + OS 组合下的可选驱动 | 主推荐 | |
新机型上线初期,或业务对驱动/CUDA 版本有严格要求 | 高频使用 | |
节点不开启公网访问,或需指定特定驱动版本 | 按需使用 | |
节点开启公网访问,可直接从社区获取驱动 | 按需使用 |
说明:
方式一从 CVM 接口直接过滤可选项,可选驱动受机型和镜像双重校验,部分新机型或低频组合可能没有可选项,此时请使用方式二、方式三或方式四。
操作步骤
方式一:自动安装 GPU 驱动(主推荐)
适用于新建节点、批量添加节点等场景。在控制台流程中,TKE 提供 GPU 驱动、CUDA、cuDNN 的下拉选择项,由系统在节点初始化阶段后台安装。
1. 登录 容器服务控制台,在左侧导航栏中选择 集群。
2. 在集群列表中,单击目标集群 ID,进入集群详情页。
3. 选择左侧导航栏中的 节点管理 > 节点池或节点,单击新建或添加已有节点。
4. 在节点机型中选择 GPU 机型(如 GN7、GT4、GC49d 等)。仅 GPU 机型才会出现 GPU 驱动相关选项。
5. 在 GPU 设置区域,勾选后台自动安装 GPU 驱动,并按需选择:
驱动版本:从下拉框中选择目标 NVIDIA 驱动版本。
CUDA 版本:选择与上层框架匹配的 CUDA 版本。
cuDNN 版本:按需选择 cuDNN 版本,与 CUDA 版本配套。
6. 完成其余节点配置后单击 下一步,按照向导确认并提交。
说明:
节点初始化期间系统会执行驱动安装脚本,预计耗时 15 ~ 25 分钟。期间节点状态为初始化中,请勿手动重启或对节点执行高危操作。
对于部分低版本 OS(如 CentOS 7.2、Ubuntu 16),即使未勾选后台自动安装 GPU 驱动,TKE 也会安装默认驱动版本以保证节点可用。
节点初始化完成后,可登录节点执行
nvidia-smi 验证驱动是否安装成功。方式二:使用自定义镜像并预装驱动
适用于业务对驱动版本有严格要求、需使用 GRID/Tesla 驱动或闭源驱动等场景。基本思路是:基于 TKE 公共镜像构建自定义镜像,在镜像中预装目标驱动,节点加入集群时选择该自定义镜像。
1. 在腾讯云上购买 GPU 测试机器,准备目标 OS。
2. 参考 NVIDIA 官方指引下载并安装目标驱动、CUDA、cuDNN,验证
nvidia-smi 输出。3. 通过 CVM 控制台 将该测试机器制作为自定义镜像。
4. 在 TKE 控制台 新建节点 流程中,操作系统 选择 自定义镜像,并选择上一步制作的镜像。
5. 在 GPU 设置 中取消勾选后台自动安装 GPU 驱动,避免重复安装与冲突。
6. 完成后续节点配置并提交,节点初始化完成后通过
nvidia-smi 与示例 Pod 验证 GPU 可用性。注意:
自定义镜像方式下,驱动维护、内核升级、CUDA 升级均需自行管理。建议在镜像 README 中记录驱动与内核版本,便于后续节点扩容时复用。TKE 对自定义镜像有基础镜像的校验要求,制作镜像前请参考 自定义镜像说明。
方式三:自定义驱动(通过 COS 存储)
适用于节点不开启公网访问、或需要使用 CVM 控制台未提供的特定 NVIDIA 驱动版本的场景。基本思路是:将 NVIDIA 官方驱动包预先上传到腾讯云 COS,节点初始化时从 COS 内网拉取并安装。
1. 从 NVIDIA 驱动下载页 下载目标驱动安装包(
.run 文件)。2. 登录 COS 控制台,在与集群同地域的存储桶中上传驱动包,并记录文件的 COS 访问地址。
注意:
建议存储桶与节点位于同一地域,节点通过内网访问 COS,无需开通公网。
3. 登录 容器服务控制台,在新建节点或新建节点池流程中选择 GPU 机型。
4. 在 GPU 设置 区域,选择 自定义驱动 选项,并填入上一步记录的 COS 文件地址。
说明:
自定义驱动 URL 须为 HTTP/HTTPS 格式,且必须以
.run 结尾(即 NVIDIA 驱动官方安装包格式)。填写自定义驱动 URL 后,控制台中的 Driver 版本、CUDA、cuDNN 等选项将不支持填写。驱动版本、CUDA 及 cuDNN 的安装和配置须在 .run 安装脚本内部处理,或通过后续的自定义用户脚本完成。5. 完成节点其余配置并提交。
说明:
自定义驱动方式下,TKE 在节点初始化阶段从 COS 拉取驱动包并执行安装,请确保节点 IAM 角色或子网具备访问目标存储桶的权限。
推荐为 COS 对象设置长期可访问的权限策略;若使用临时签名 URL,请保证 URL 在节点初始化期间不会过期。
方式四:通过前置脚本安装驱动
适用于节点开启公网访问,可直接从 NVIDIA 社区或自建源拉取驱动的场景。
1. 准备一段 Shell 脚本,包含驱动下载、依赖安装、
.run 文件执行、nvidia-smi 校验等步骤。示例:#!/bin/bashset -eDRIVER_URL="https://us.download.nvidia.com/tesla/535.183.06/NVIDIA-Linux-x86_64-535.183.06.run"curl -fsSL -o /tmp/nvidia.run "$DRIVER_URL"chmod +x /tmp/nvidia.run/tmp/nvidia.run --silent --no-questions --accept-licensenvidia-smi
2. 登录 容器服务控制台,在新建节点流程中选择 GPU 机型。
3. 在 GPU 设置中取消勾选后台自动安装 GPU 驱动。
4. 在 高级设置的前置自定义脚本中粘贴上述脚本,并完成其余节点配置后提交。
5. 节点初始化完成后,登录节点执行
nvidia-smi 校验。注意:
前置脚本依赖节点公网访问能力,建议预估并接受 10 ~ 30 分钟的额外初始化时长(受公网带宽影响)。
脚本失败会导致节点初始化失败,建议在测试节点上验证脚本可重复执行后再用于生产环境。
如对节点初始化时间有严格要求,建议改用方式一或方式二。
验证
1. 登录目标节点,执行:
nvidia-smi
预期输出包括 GPU 型号、驱动版本、CUDA 版本,无报错。
2. 在集群中部署一个使用
nvidia.com/gpu 资源的测试 Pod:apiVersion: v1kind: Podmetadata:name: gpu-checkspec:restartPolicy: Nevercontainers:- name: cuda-vector-addimage: nvcr.io/nvidia/k8s/cuda-sample:vectoradd-cuda11.7.1-ubuntu20.04resources:limits:nvidia.com/gpu: 1
3. 查看 Pod 日志确认 GPU 计算成功,且节点的
nvidia.com/gpu 资源被正确扣减。常见问题
GPU 组件(如 nvidia-device-plugin)启动失败
可能原因与对应处理:
驱动未安装或版本不匹配:登录节点执行
nvidia-smi,若命令不存在或报错,按方式一/方式二/方式三/方式四重新安装驱动。节点机型与所选驱动不兼容:参见 各实例支持的 GPU 驱动版本及安装方式 兼容矩阵,更换驱动版本或机型。
nvidia-fabricmanager 服务异常(A100 等机型):在节点上执行 systemctl status nvidia-fabricmanager,按需重启服务。内核与驱动 ABI 不匹配:节点系统升级或自动更新内核后可能导致驱动失效。需要重新编译/安装与新内核匹配的驱动。
如何切换已有节点的 GPU 驱动版本
控制台不支持对已生效的节点直接切换驱动。推荐做法:
1. 在 TKE 控制台对目标节点执行 封锁 + 驱逐 Pod。
2. 将节点 移出节点池。
3. 重新创建节点(方式一)或重装系统(方式二/方式三/方式四),并在新节点上指定目标驱动版本。
4. 重新加入节点池。
自动安装驱动时间过长(超过 30 分钟)
通过 节点事件 / 实例自定义数据日志 排查初始化脚本是否执行失败。
部分公网受限区域可能因驱动包下载慢而超时,可改为使用 方式二(自定义镜像)或 方式三(COS 自定义驱动)规避。
控制台没有显示我需要的驱动版本
控制台中可选驱动版本受机型和镜像双重校验,TKE 直接从 CVM 接口过滤。当 CVM 暂未支持目标机型 + OS 组合的自动驱动时,下拉框会为空或缺少目标版本。处理方式:
优先尝试 方式二(自定义镜像)或 方式三(COS 自定义驱动),自行指定驱动版本。
如果是新机型(如 H20、H800)刚上线初期,自定义镜像方式通常先于 CVM 自动安装能力可用。
原生节点
原生节点支持以下两种 GPU 驱动安装方式:
方式一:控制台选择驱动版本(推荐)
创建原生节点时,可直接在 GPU 驱动配置项中,选择对应的 GPU 驱动版本、CUDA 版本及 cuDNN 版本,如下图所示:
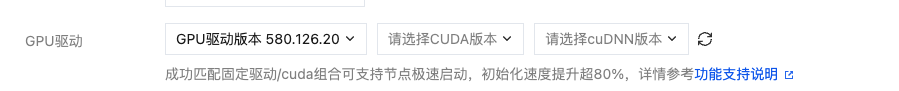
成功匹配固定驱动/CUDA 组合可支持节点极速启动,初始化速度提升超 80%,可选的版本组合详情请参考控制台中的功能支持说明。
方式二:驱动版本置空,通过自定义镜像或前置脚本安装
若需自行控制驱动的安装与升级,可在创建原生节点时将 GPU 驱动版本、CUDA 版本、cuDNN 版本全部置空(不自动安装驱动),节点加入集群后通过以下方式自行安装:
使用已预装驱动的自定义镜像,具体操作请参见上文 普通节点 > 方式二:使用自定义镜像并预装驱动。
通过前置脚本安装驱动,具体操作请参见上文 普通节点 > 方式四:通过前置脚本安装驱动。


