接口描述
本接口可对较长的录音文件进行识别,采用异步任务方式:创建任务返回
transcription_id,再通过回调或轮询获取识别结果。音频格式支持:mp3、wav、m4a、wma、aac、ogg、amr、fla。
视频格式支持:mp4、wmv、m4v、flv、rmvb、dat、mov、mkv、webm。
请求方法:HTTP POST,
Content-Type 为 application/json; charset=utf-8。音频提交方式:支持音频 URL、本地音频文件两种请求方式。
音频限制:音频 URL 时长不能大于12小时,文件大小不超过1GB;本地音频文件不能大于5MB。
如何获取识别结果:支持回调或轮询的方式获取结果。
识别结果有效时间:识别结果在服务端保存 24 小时。
前提条件
需要准备两个凭证:
SDKAppID 与 SecretKey。接口要求
内容 | 说明 |
语言种类 | 支持中文普通话、中国方言、英语,以及日语、韩语、法语等小语种。 |
支持行业 | 通用。 |
音频属性 | 采样率:16000Hz;采样精度:16bits;声道:单声道(mono)。双声道场景配置 channel_num=2。 |
音视频格式 | 音频:mp3、wav、m4a、wma、aac、ogg、amr、fla;视频:mp4、wmv、m4v、flv、rmvb、dat、mov、mkv、webm。 |
请求协议 | https 协议。 |
请求地址 | 创建任务: https://asr.cloud-rtc.com/v3/create_transcription任务查询: https://{host}/v3/describe_transcription。鉴权信息通过请求 body 的 auth 块传入,URL 均不携带 query 参数。 |
响应格式 | JSON,扁平结构。 |
数据发送 | 支持本地语音文件上传和语音 URL 上传两种请求方式。音频 URL 时长不能大于 12 小时,文件大小不超过 1GB;本地音频文件不能大于 5MB。 |
并发限制 | 默认单账号接口限频20次每秒,并发任务数上限200个。 |
说明:
同一 SDKAppID 下,直接接入 ASR、AI 对话、AI 转录/翻译等所有实时语音识别场景共享该并发池,即各类型的并发路数合计不超过账号上限。一句话识别与录音文件识别独立计算,不占用实时识别并发额度。如您有更多并发需求,请 联系我们。
业务流程图
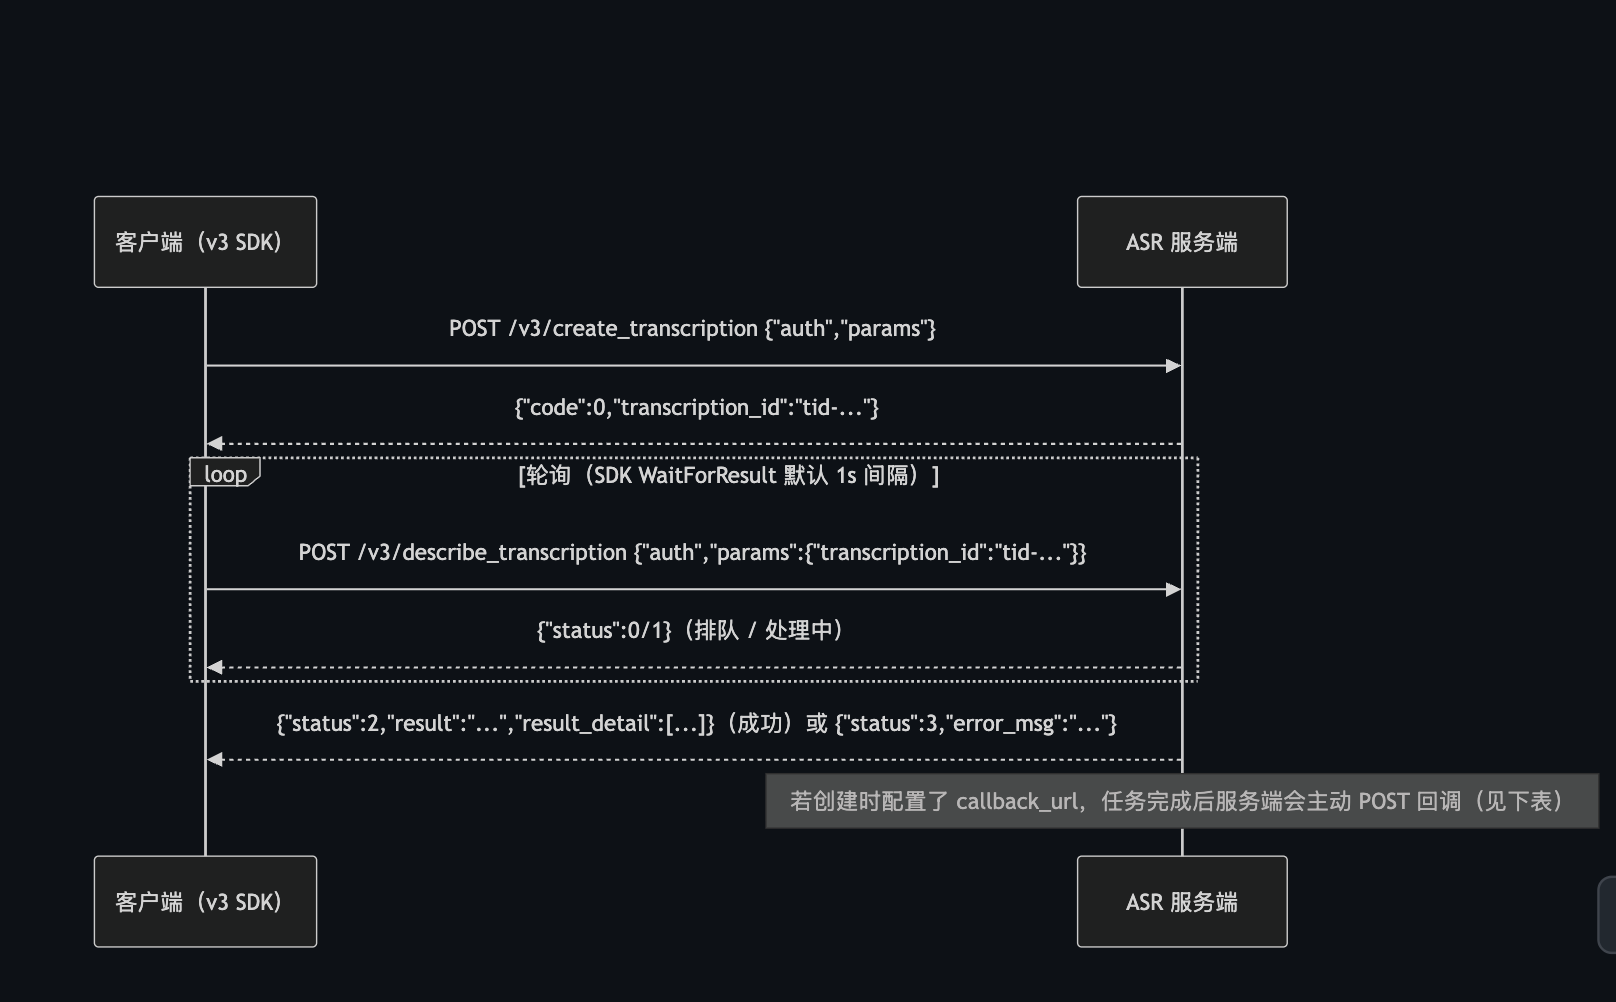
接口调用流程
请求格式
客户端发起 HTTP POST 请求,请求 URL 为:
https://asr.cloud-rtc.com/v3/create_transcription请求 body 为对称结构,格式为 json:
{"auth": {"sdkappid": "1400000001", "usersig": "eJw...", "request_id": "req-uuid"},"params": {"engine_model_type": "bigmodel", "channel_num": 1, "res_text_format": 1, "source_type": 0, "url": "https://example.com/audio.wav"}}
说明:
v3 不再使用
X-TRTC-SdkAppId / X-TRTC-UserSig 请求 header,也不再在 URL 上携带 AppId / RequestId。鉴权信息全部位于 body 的 auth 块内。请求参数(auth)
签名规则
1. 未调用
credential.SetUserSig() 时,SDK 使用 SDKAppID + SecretKey 本地生成签名,有效期86400秒,且每次请求都重新生成。2. 调用
credential.SetUserSig(sig) 传入固定签名后,SDK 不再生成也不再刷新。服务端使用当前 identifier(离线为 request_id)验签,因此签名必须用同一个 identifier 签发。3. 签名与站点绑定。国际站凭证不可用于国内站,反之亦然。
4.
SecretKey 不会传输到网络,签名只用于服务端验签。输入参数(params)
参数名称 | 必填 | 类型 | 描述 |
engine_model_type | 是 | String | 语音识别 2.0(推荐) bigmodel:大模型引擎,支持实时说话人分离。语音识别 1.0 基础版引擎: 8k_zh。标准版引擎:可配置 8k_zh_large、16k_zh_large 或 16k_zh_en。高级版引擎:小语种 ASR 引擎,传参是“16k_具体语种 code”,例如 16k_vi(越南语)。 |
language | 否 | String | 语音识别 2.0(推荐) bigmodel 支持 zh(中文普通话、中文方言和中英混)、en(英语)、yue(粤语)和小语种。中文方言:安徽、东北、福建、甘肃、贵州、河北、河南、湖北、湖南、江西、宁夏、山东、陕西、山西、四川、天津、云南、浙江、粤语(香港口音)、粤语(广东口音)、吴语、闽南语。 小语种: ar(阿拉伯语)、de(德语)、fr(法语)、es(西班牙语)、pt(葡萄牙语)、id(印尼语)、it(意大利语)、ko(韩语)、ru(俄语)、th(泰语)、vi(越南语)、ja(日语)、tr(土耳其语)、hi(印地语)、ms(马来语)、nl(荷兰语)、sv(瑞典语)、da(丹麦语)、fi(芬兰语)、pl(波兰语)、cs(捷克语)、fa(波斯语)、el(希腊语)、ro(罗马尼亚语)、hu(匈牙利语)、mk(马其顿语)。语音识别 1.0 基础版: 8k_zh 支持中文普通话和中文方言。标准版: 8k_zh_large、16k_zh_large 支持中文普通话和中文方言;16k_zh_en 支持中文普通话、中文方言、英语和中英混。高级版: vi(越南语)、ja(日语)、ko(韩语)、id(印度尼西亚语)、th(泰语)、pt(葡萄牙语)、tr(土耳其语)、ar(阿拉伯语)、es(西班牙语)、hi(印地语)、fr(法语)、ms(马来语)、fil(菲律宾语)、de(德语)、it(意大利语)、ru(俄语)、sv(瑞典语)、da(丹麦语)、no(挪威语)。如果您有更多语言需求,请 联系我们 评估。 说明: 当 engine_model_type 配置为 bigmodel,不填写 language 字段时,模型会自动识别语种;使用 SDK 时建议显式指定。 |
channel_num | 是 | Integer | 支持配置 1 或 2。当配置为 2 时,按 channel_id 出句,不能同时开启 speaker_diarization。 |
res_text_format | 是 | Integer | 识别结果返回样式: 0 基础识别结果(仅包含有效人声时间戳,无词粒度的详细识别结果)。1 基础识别结果之上,增加词粒度的详细识别结果(包含字级别时间戳、语速值,不含标点)。2 基础识别结果之上,增加词粒度的详细识别结果(包含字级别时间戳、语速值和标点)。3 基础识别结果之上,增加词粒度的详细识别结果,智能断句(包含字级别时间戳、语速值和标点、智能断句)。 |
source_type | 是 | Integer | 语音数据来源: 0 语音 URL。1 语音数据(post body)。示例值:0 |
url | 否 | String | 语音的 URL 地址,需要公网环境浏览器可下载。当 source_type 值为0时须填写该字段,为1时不填。音频时长不能超过12小时,音频文件大小不能超过1GB。示例值:https://test.com/test.wav |
data | 否 | String | 语音数据,当 source_type 值为1(本地语音数据上传)时必须填写,当 source_type 值为0(语音 URL 上传)可不写。必须使用 Base64 编码(采用 Python 语言时注意读取文件应该为 string 而不是 byte,以 byte 格式读取后要 decode()。编码后的数据不可带有回车换行符)。音频文件大小不能超过5MB(Base64 编码后)。 |
data_len | 否 | Integer | 数据长度,单位为字节。当 source_type 值为1(本地语音数据上传)时必须填写,当 source_type 值为0(语音 URL 上传)可不写(此数据长度为数据未进行 Base64 编码时的数据长度)。示例值:6400 |
audio_urls | 否 | Array | 分布式录音,格式为 [{"index":0,"url":"...","label":"..."}]。 |
callback_url | 否 | String | 注意: 如果用户使用轮询方式获取识别结果,则无需提交该参数。建议在回调 URL 中带上您的业务 ID 等信息,以便处理业务逻辑。示例值: https://xxxx.xxx.xxx/callback |
speaker_diarization | 否 | Integer | 是否开启说话人分离: 0 不开启。1 开启说话人分离(channel_num=1 时可用)。3 开启说话人分离基础上增加角色认证(即响应 speaker_id 替换成注册的名称),需配合 speaker_roles 或 voiceprint_ids 参数使用,二选一即可,若二者均填写则使用 voiceprint_ids 的 注册声纹、忽略 speaker_roles。(bigmodel 可用,可支持传入声纹对录音文件内的说话人进行角色认证。默认值为 0。) |
speaker_number | 否 | Integer | 说话人数量提示, 0 表示自动检测。 |
speaker_roles | 否 | Array of SpeakerRoleInfo | 临时声纹认证,仅在本次识别中生效。认证声纹有效音频必须在 10s~30s 之间,音频格式为 wav。开启角色分离能力需配合 speaker_diarization: 3 使用,属 ASR 增值服务,仅可传入一组声纹信息进行角色认证。示例:"speaker_roles":[{"audio_url":"需要认证角色的声纹音频地址","role_name":"需要认证角色的名称"}] |
voiceprint_ids | 否 | Array of String | 已注册声纹 ID 列表,仅 speaker_diarization=3 时生效。示例:["550e8400-e29b-41d4-a716-446655440000","550e8400-e29b-41d4-a716-446655440002"]说明: |
noise_threshold | 否 | Float | 噪音参数阈值,取值范围:[0.0, 4.0]。对于一些音频片段,取值越大,判定为噪音情况越大;取值越小,判定为人声情况越大。 0 是合法取值,Go SDK 中用 *float64 区分「未设置」与「显式传 0」。 |
vad_silence_ms | 否 | Integer | 静音断句阈值,单位 ms。 |
vad_level | 否 | Integer | VAD 场景档: 0 高召回。1 远场过滤。 |
filter_dirty | 否 | Integer | 是否过滤脏词(中文普通话): 0 不过滤脏词。1 过滤脏词。2 将脏词替换为 *。默认值为 0。 |
filter_modal | 否 | Integer | 是否过滤语气词(中文普通话): 0 不过滤语气词。1 部分过滤。2 严格过滤。默认值为 0。 |
filter_punc | 否 | Integer | 是否过滤标点符号(中文普通话): 0 不过滤。1 过滤句末标点。默认值为 0。 |
convert_num_mode | 否 | Integer | 是否进行阿拉伯数字智能转换: 0 不转换,直接输出中文数字。1 根据场景智能转换为阿拉伯数字。3 数学模式。默认值为 1。 |
hotword_id | 否 | String | 热词表 ID,SDKAppID 维度。需先在控制台创建热词表。 |
hotword_list | 否 | String | 临时热词表:该参数用于提升识别准确率。单个热词限制:“热词|权重”,单个热词不超过 30 个字符(最多 10 个汉字),权重 [1-11] 或者 100,例如 “腾讯云|5” 或 “ASR|11”;临时热词表限制:多个热词用英文逗号分割,最多支持 128 个热词,例如 “腾讯云|10,语音识别|5,ASR|11”。 注意: 热词权重设置为11时,当前热词将升级为超级热词,建议仅将重要且必须生效的热词设置到11,设置过多权重为11的热词将影响整体字准率。热词权重设置为100时,当前热词开启热词增强同音替换功能。 举例:热词配置“蜜制|100”时,与“蜜制”同拼音(mizhi)的“秘制”的识别结果会被强制替换成“蜜制”。因此建议客户根据自己的实际情况开启该功能。建议仅将重要且必须生效的热词设置到100,设置过多权重为100的热词将影响整体字准率。热词不能包含空格。 |
customization_id | 否 | String | 自学习模型 ID。 |
keyword_lib_id_list | 否 | Array | 关键词库 ID 列表。 |
replace_text_id | 否 | String | 替换词表 ID。 |
sentence_max_length | 否 | Integer | 单句最大长度。 |
extra | 否 | String | 引擎扩展串。 |
context | 否 | Object | 识别上下文: {"text":"背景文本","terms":["术语"],"general":[{"key":"domain","value":"Meeting"}]}。 |
SpeakerRoleInfo(json 格式,包含两个参数):
参数名称 | 类型 | 描述 |
audio_url | String | 需要认证角色的声纹音频地址,要求 10s~30s 内的纯净有效人声。 |
role_name | String | 需要认证角色的名称,若匹配成功,会替换说话人分离中的 speaker_id。 |
说明:
context 的消费方式与引擎能力相关:大模型类引擎可使用 text / terms / general;传统引擎仅把 terms 降级为热词使用。响应格式
参数名称 | 类型 | 描述 |
code | Integer | 状态码,0代表正常,非0值表示发生错误。 |
message | String | 错误说明。 |
request_id | String | 本次请求的 request_id,与请求 auth.request_id 一致。定位问题时需要提供该值。 |
transcription_id | String | 该参数由服务端生成,用于后续查询任务状态与结果。 注意: transcription_id 有效期为 24 小时,不同日期可能出现重复 transcription_id,请不要依赖它作为您业务系统里的唯一 ID。 |
注意:
v3 离线接口鉴权失败返回的是 HTTP 200 + body
{"code":4002},不是 HTTP 4xx。判断请求成败请以 body 的 code 为准。示例
用户通过
source_type=1 请求录音文件识别,请求如下:请求网址:
https://asr.cloud-rtc.com/v3/create_transcription
请求 body:
{"auth": {"sdkappid": "1400188366","usersig": "eJw...","request_id": "7737a081-1dd4-4b60-a08b-b34ed46243a7"},"params": {"engine_model_type": "bigmodel","language": "zh","res_text_format": 0,"channel_num": 1,"source_type": 1,"data": "xxxxxxxx","data_len": 8}}
响应结果:
{"code": 0,"message": "success","request_id": "7737a081-1dd4-4b60-a08b-b34ed46243a7","transcription_id": "tid-24fe80e8-5b0c-4232-866f-4a402ee3127b"}
录音文件回调说明
录音识别请求中,如果用户设置了
callback_url 参数,则通过回调的方式来返回识别结果。用户需要自行搭建可公网访问的 HTTP 或者 HTTPS 服务,并在创建录音识别任务时,将回调 URL 填写到 callback_url 中。回调时,使用 HTTP 的 POST 方法,将所有内容放入 Body 中,Content-Type 为 application/x-www-form-urlencoded,字段名为 snake_case。回调 Body 说明
回调 Body 示例:
code=0&request_id=7737a081-1dd4-4b60-a08b-b34ed46243a7&transcription_id=tid-DYz1ieNlIyb5nZT%2BR9kQsCAocpoDD6l1qvqam7XBk78PDQ..&appid=12516****&projectid=0&text=%5B0&audio_duration=8.420000&message=&result_detail=
回调参数说明
参数名称 | 类型 | 描述 |
code | Integer | 任务状态码,0 为成功,其他:失败。 |
message | String | 失败原因文字描述,成功时此值为空。 |
request_id | String | 创建任务时 auth.request_id 的原值。 |
transcription_id | String | 任务 ID,与创建任务返回的 transcription_id 一致。这是关联任务的字段。 |
appid | Integer | 请求的 AppId。 |
projectid | Integer | 项目 ID。 |
audio_url | String | 语音 URL,如创建任务时为上传数据的方式,则不包含该字段。 |
text | String | 识别出的结果文本。 |
result_detail | String | 包含详细识别结果,如创建任务时 res_text_format 为 0,则不包含该字段。分句结构同任务查询响应的 result_detail。 |
audio_duration | Float | 语音总时长(秒)。 |
回调状态码
数值 | 说明 |
10000 | 转码失败,请确认音频格式是否符合标准。 |
10001 | 识别失败。 |
10002 | 语音时长太短。 |
10003 | 语音时长太长。 |
10004 | 无效的语音文件。 |
10005 | 其他失败。 |
10006 | 音轨个数不匹配。 |
10007 | 音频下载失败。 |
录音文件识别结果查询
接口描述
调用录音文件识别请求接口后,有回调和轮询两种方式获取识别结果。采用回调方式时详见「录音文件回调说明」。
当采用轮询方式时,需要主动提交
transcription_id 来轮询识别结果,共有任务成功、等待、执行中和失败四种结果。请求方法为 HTTP POST,
Content-Type 为 application/json; charset=utf-8。内容 | 说明 |
请求协议 | https 协议。 |
请求地址 | https://asr.cloud-rtc.com/v3/describe_transcription |
响应格式 | JSON,扁平结构。 |
并发限制 | 默认单账号限制并发数为50次每秒。 |
注意:
任务有效期为24小时,超过24小时的任务请不要查询,且不要依赖
transcription_id 作为业务唯一 ID,不同日期可能出现重复。用 v1 的 RecTaskId 查询 v3 接口会返回 4002。请求格式
请求 body 为对称结构:
{"auth": {"sdkappid": "1400000001", "usersig": "eJw...", "request_id": "req-uuid"},"params": {"transcription_id": "tid-..."}}
auth 块字段说明同创建任务接口。输入参数(params)
参数名 | 必填 | 类型 | 描述 |
transcription_id | 是 | String | 从 create_transcription 接口获取的 transcription_id,用于获取任务状态与结果。注意: transcription_id 有效期为 24 小时,超过 24 小时的请不要再查询。 |
输出参数
参数名称 | 类型 | 描述 |
code | Integer | 状态码,0代表正常。 |
message | String | 错误说明。 |
request_id | String | 本次查询请求的 request_id。定位问题时需要提供该值。 |
transcription_id | String | 任务标识。 示例值: tid-awerwe |
status | Integer | 任务状态码: 0 任务等待。1 任务执行中。2 任务成功。3 任务失败。示例值: 0 |
status_str | String | 任务状态: waiting 任务等待;doing 任务执行中;success 任务成功;failed 任务失败。示例值: waiting |
progress | Integer | 处理进度(取值 0-100,单位为 1%)。 示例值: 90 |
audio_duration | Float | 音频时长(秒)。 注意: 此字段可能返回 null。示例值: 1.2 |
result | String | 识别结果。 示例值: 录音文件识别 |
result_detail | Array of SentenceDetail | 识别结果详情。包含每个句子中的词时间偏移,一般用于生成字幕的场景( res_text_format 为 1、2、3 时该字段不为空)。注意: 此字段可能返回 null。 |
error_msg | String | 失败原因说明。示例值: Failed to download audio file |
SentenceDetail — 单句的详细识别结果,包含单个词的时间偏移:
参数名称 | 类型 | 描述 |
final_sentence | String | 单句最终识别结果。 示例值: 您好,今天很开心注意: 此字段可能返回 null。 |
slice_sentence | String | 单句中间识别结果,使用空格拆分为多个词。 示例值: 您好 今天 很 开心注意: 此字段可能返回 null。 |
written_text | String | 口语转书面语结果,开启该功能才有值。 示例值: 您好,今天很开心注意: 此字段可能返回 null。 |
start_ms | Integer | 单句开始时间(毫秒)。 示例值: 0注意: 此字段可能返回 null。 |
end_ms | Integer | 单句结束时间(毫秒)。 示例值: 2000注意: 此字段可能返回 null。 |
words_num | Integer | 单句中的词个数。 示例值: 4注意: 此字段可能返回 null。 |
words | Array of Word | 单句中的词详情。 注意: 此字段可能返回 null。 |
speech_speed | Float | 单句语速,单位:字数/秒。 示例值: 5.9注意: 此字段可能返回 null。 |
speaker_id | Integer | 说话人 ID,开启说话人分离后返回。 示例值: 1 |
speaker_role_name | String | 说话人名称。当请求参数 speaker_diarization 为 3 且正常注册了声纹时该值有效。示例值: 主持人 |
channel_id | Integer | 双声道场景声道编号: 1 左声道。2 右声道。 |
silence_time | Integer | 句前静音时长(毫秒)。 |
language | String | 该句识别语言。 |
language_b47 | String | 该句识别语言标识。 |
Word — 识别结果中的词文本,以及对应时间偏移:
参数名称 | 类型 | 描述 |
word | String | 词文本。 注意: 此字段可能返回 null,表示取不到有效值。 |
start_time | Integer | 在句子中的开始时间偏移量。 注意: 此字段可能返回 null。 |
end_time | Integer | 在句子中的结束时间偏移量。 注意: 此字段可能返回 null。 |
查询示例
请求网址:
https://asr.cloud-rtc.com/v3/describe_transcription
请求 body:
{"auth": {"sdkappid": "1400188366","usersig": "eJw...","request_id": "2f5e8263-a23b-4e65-be22-6b7c19bd4064"},"params": {"transcription_id": "tid-24fe80e8-5b0c-4232-866f-4a402ee3127b"}}
响应结果:
{"code": 0,"message": "success","request_id": "2f5e8263-a23b-4e65-be22-6b7c19bd4064","transcription_id": "tid-24fe80e8-5b0c-4232-866f-4a402ee3127b","status": 2,"status_str": "success","progress": 100,"audio_duration": 2.38,"result": "[0:0.200,0:1.380,1] 您好。\\n","result_detail": [{"final_sentence": "您好。","slice_sentence": "您好","start_ms": 200,"end_ms": 1380,"speech_speed": 2,"words_num": 1,"words": []}],"error_msg": ""}
开启说话人分离时,
result 中会带说话人标识:{"result": "[0:0.200,0:1.380,spk:1] 您好。\\n"}
开发者资源
安装
go get github.com/Tencent-RTC/trtc-asr-sdk-go@latest
要求 Go 1.21 及以上。
SDK
SDK 调用示例
初始化凭证
import (v3 "github.com/Tencent-RTC/trtc-asr-sdk-go/asr/v3""github.com/Tencent-RTC/trtc-asr-sdk-go/common")// 第一个参数是 SDKAppID(如 1400xxxxxx);v3 不需要腾讯云 AppID。credential := v3.NewCredential(sdkAppID, "your-sdk-secret-key")// credential.SetSite(common.SiteIntl) // 国际站;不调用则走国内站
创建任务并轮询结果
recognizer := v3.NewFileRecognizer(credential)taskID, err := recognizer.CreateTask(&v3.CreateTranscriptionRequest{EngineModelType: "bigmodel",ChannelNum: 1,ResTextFormat: 1,SourceType: v3.SourceTypeURL,URL: "https://example.com/audio.wav",Language: "zh",})if err != nil {log.Fatal(err)}status, err := recognizer.WaitForResult(taskID) // 轮询直至完成,默认 1s 间隔if err != nil {log.Fatal(err)}fmt.Println(status.Result, status.AudioDuration, status.ResultDetail)
运行示例
cd examples/v3_file_asr# URL 上传go run main.go bigmodel -u https://example.com/audio.wav# 开启说话人分离go run main.go bigmodel -u https://example.com/audio.wav -diarization 1# 查看所有选项go run main.go -h
错误码
数值 | 说明 |
4001 | 参数不合法,具体详情参考 message。 |
4002 | 鉴权失败。请检查 sdkappid、usersig 是否已通过 body 的 auth 块正确传入,以及签名的 identifier 是否等于本次请求的 request_id。查询他人任务(含使用 v1 的 RecTaskId 查询 v3 接口)也返回该错误码。 |
4003 | AppID 服务未开通,请在控制台开通服务。 |
4004 | 资源包耗尽,请开通后付费或者购买资源包。 |
4005 | 账户欠费停止服务,请及时充值。 |
4006 | 账号当前调用并发超限。 |
4007 | 音频解码失败,请检查上传音频数据格式是否与调用参数一致。 |
5000 | 因机器负载过高、网络抖动等导致失败,请重新发起新识别。 注意: 该问题通常为偶发,少量出现可忽略,发起新识别即可。 |
5001 | 同 5000。 |
5002 | 同 5000。 |
HTTP 状态码与 body code 的对应关系:
HTTP 状态码 | 场景 | code |
400 | 参数错误 | 4001 |
200 | 鉴权失败 | 4002 |
429 | 并发超限 | 4006 |
413 | 请求 body 过大 | —— |
503 | 调度失败 | 5000 / 5001 / 5002 |
注意:
鉴权失败是 HTTP 200,不是 4xx。一律以
code 为准。SDK 本地错误码:SDK 返回的 error 为
*common.ASRError,其 Code 即服务端错误码。SDK 本地错误使用 10xx 区间,如 1001 本地参数错误、1002 连接失败。


