为了兼容用户通过其他实时计算平台(例如 StreamPark)提交作业的情况,使之前使用 yarn 的客户管控平台不需要进行修改;复用 Oceanus 流计算平台的优势。
目前支持 Yarn 原生命令,Dinky 和 StreamPark 平台 yarn application 模式对接 Oceanus, 仅支持 Flink-1.13、Flink-1.16、Flink-1.18、Flink-1.20(历史集群 Flink1.18 需开白使用)版本, Dinky 版本 dinky-release-1.16-1.0.3,StreamPark 版本2.1.4。
注意事项
1. 指定作业发布到指定的空间,在客户端的 flink-conf.yaml,新加一行 Oceanus.WorkspaceId: space-****(从 Oceanus 控制台获取空间 ID,工作空间目录进入),否则默认将作业发布到名称为 external 的空间。
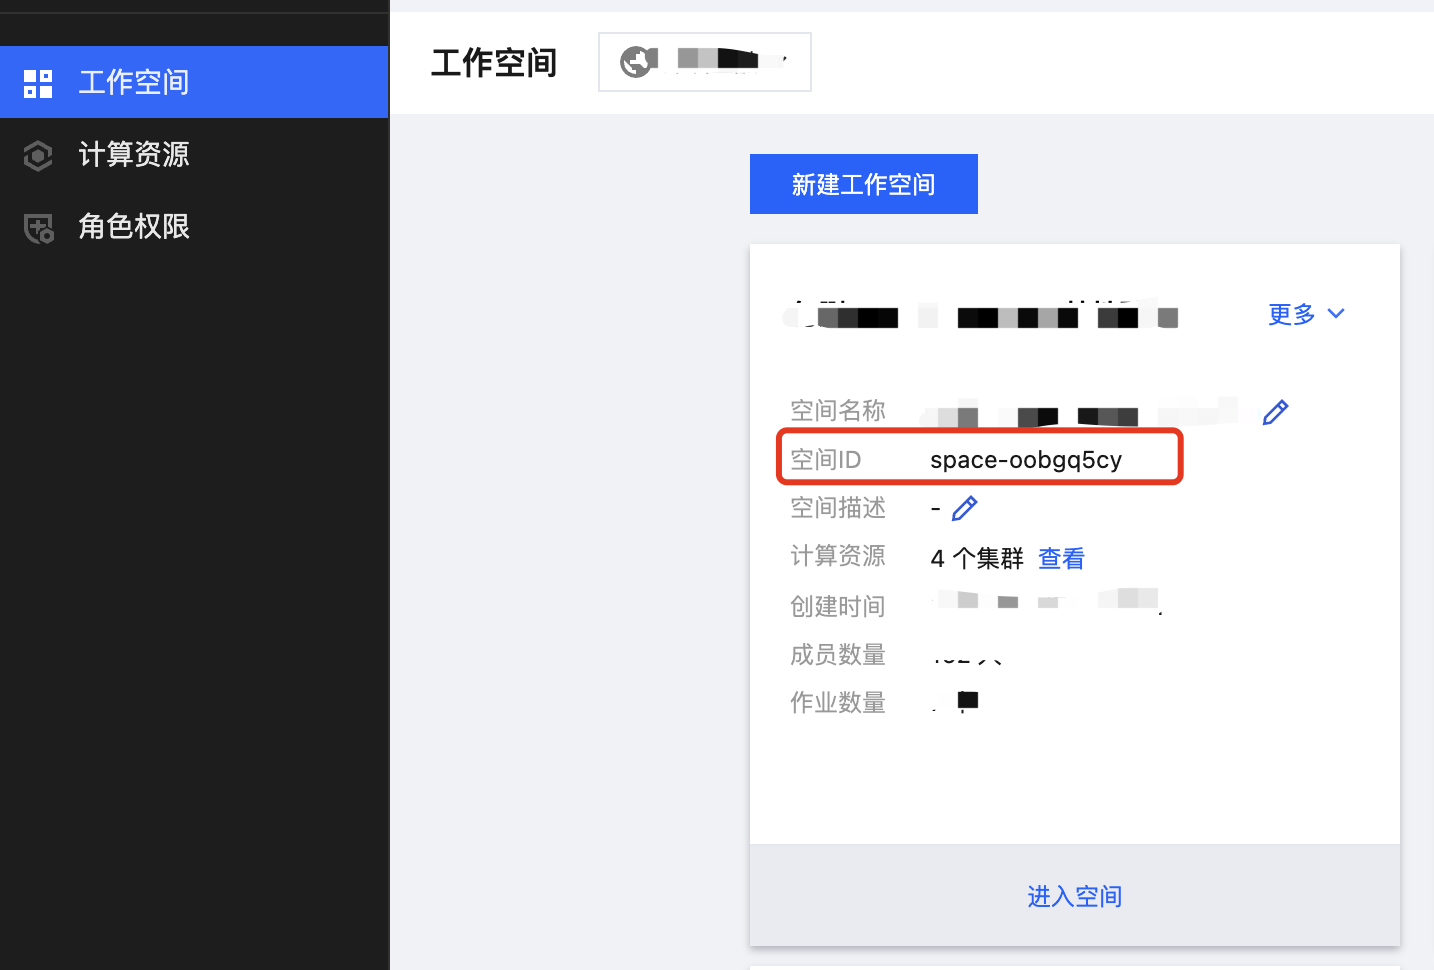
2. 启动、停止作业,触发 savepoint 等操作都可以在 Oceanus 控制台操作。
操作步骤
1. 在计算资源 > 进入目标集群页面 > 集群服务, 开启 Yarn 接口访问(实际部署了 hadoop yarn 服务),开启 Yarn 接口访问所需要的资源将从独享集群的可用 CU 数中扣除10CU。
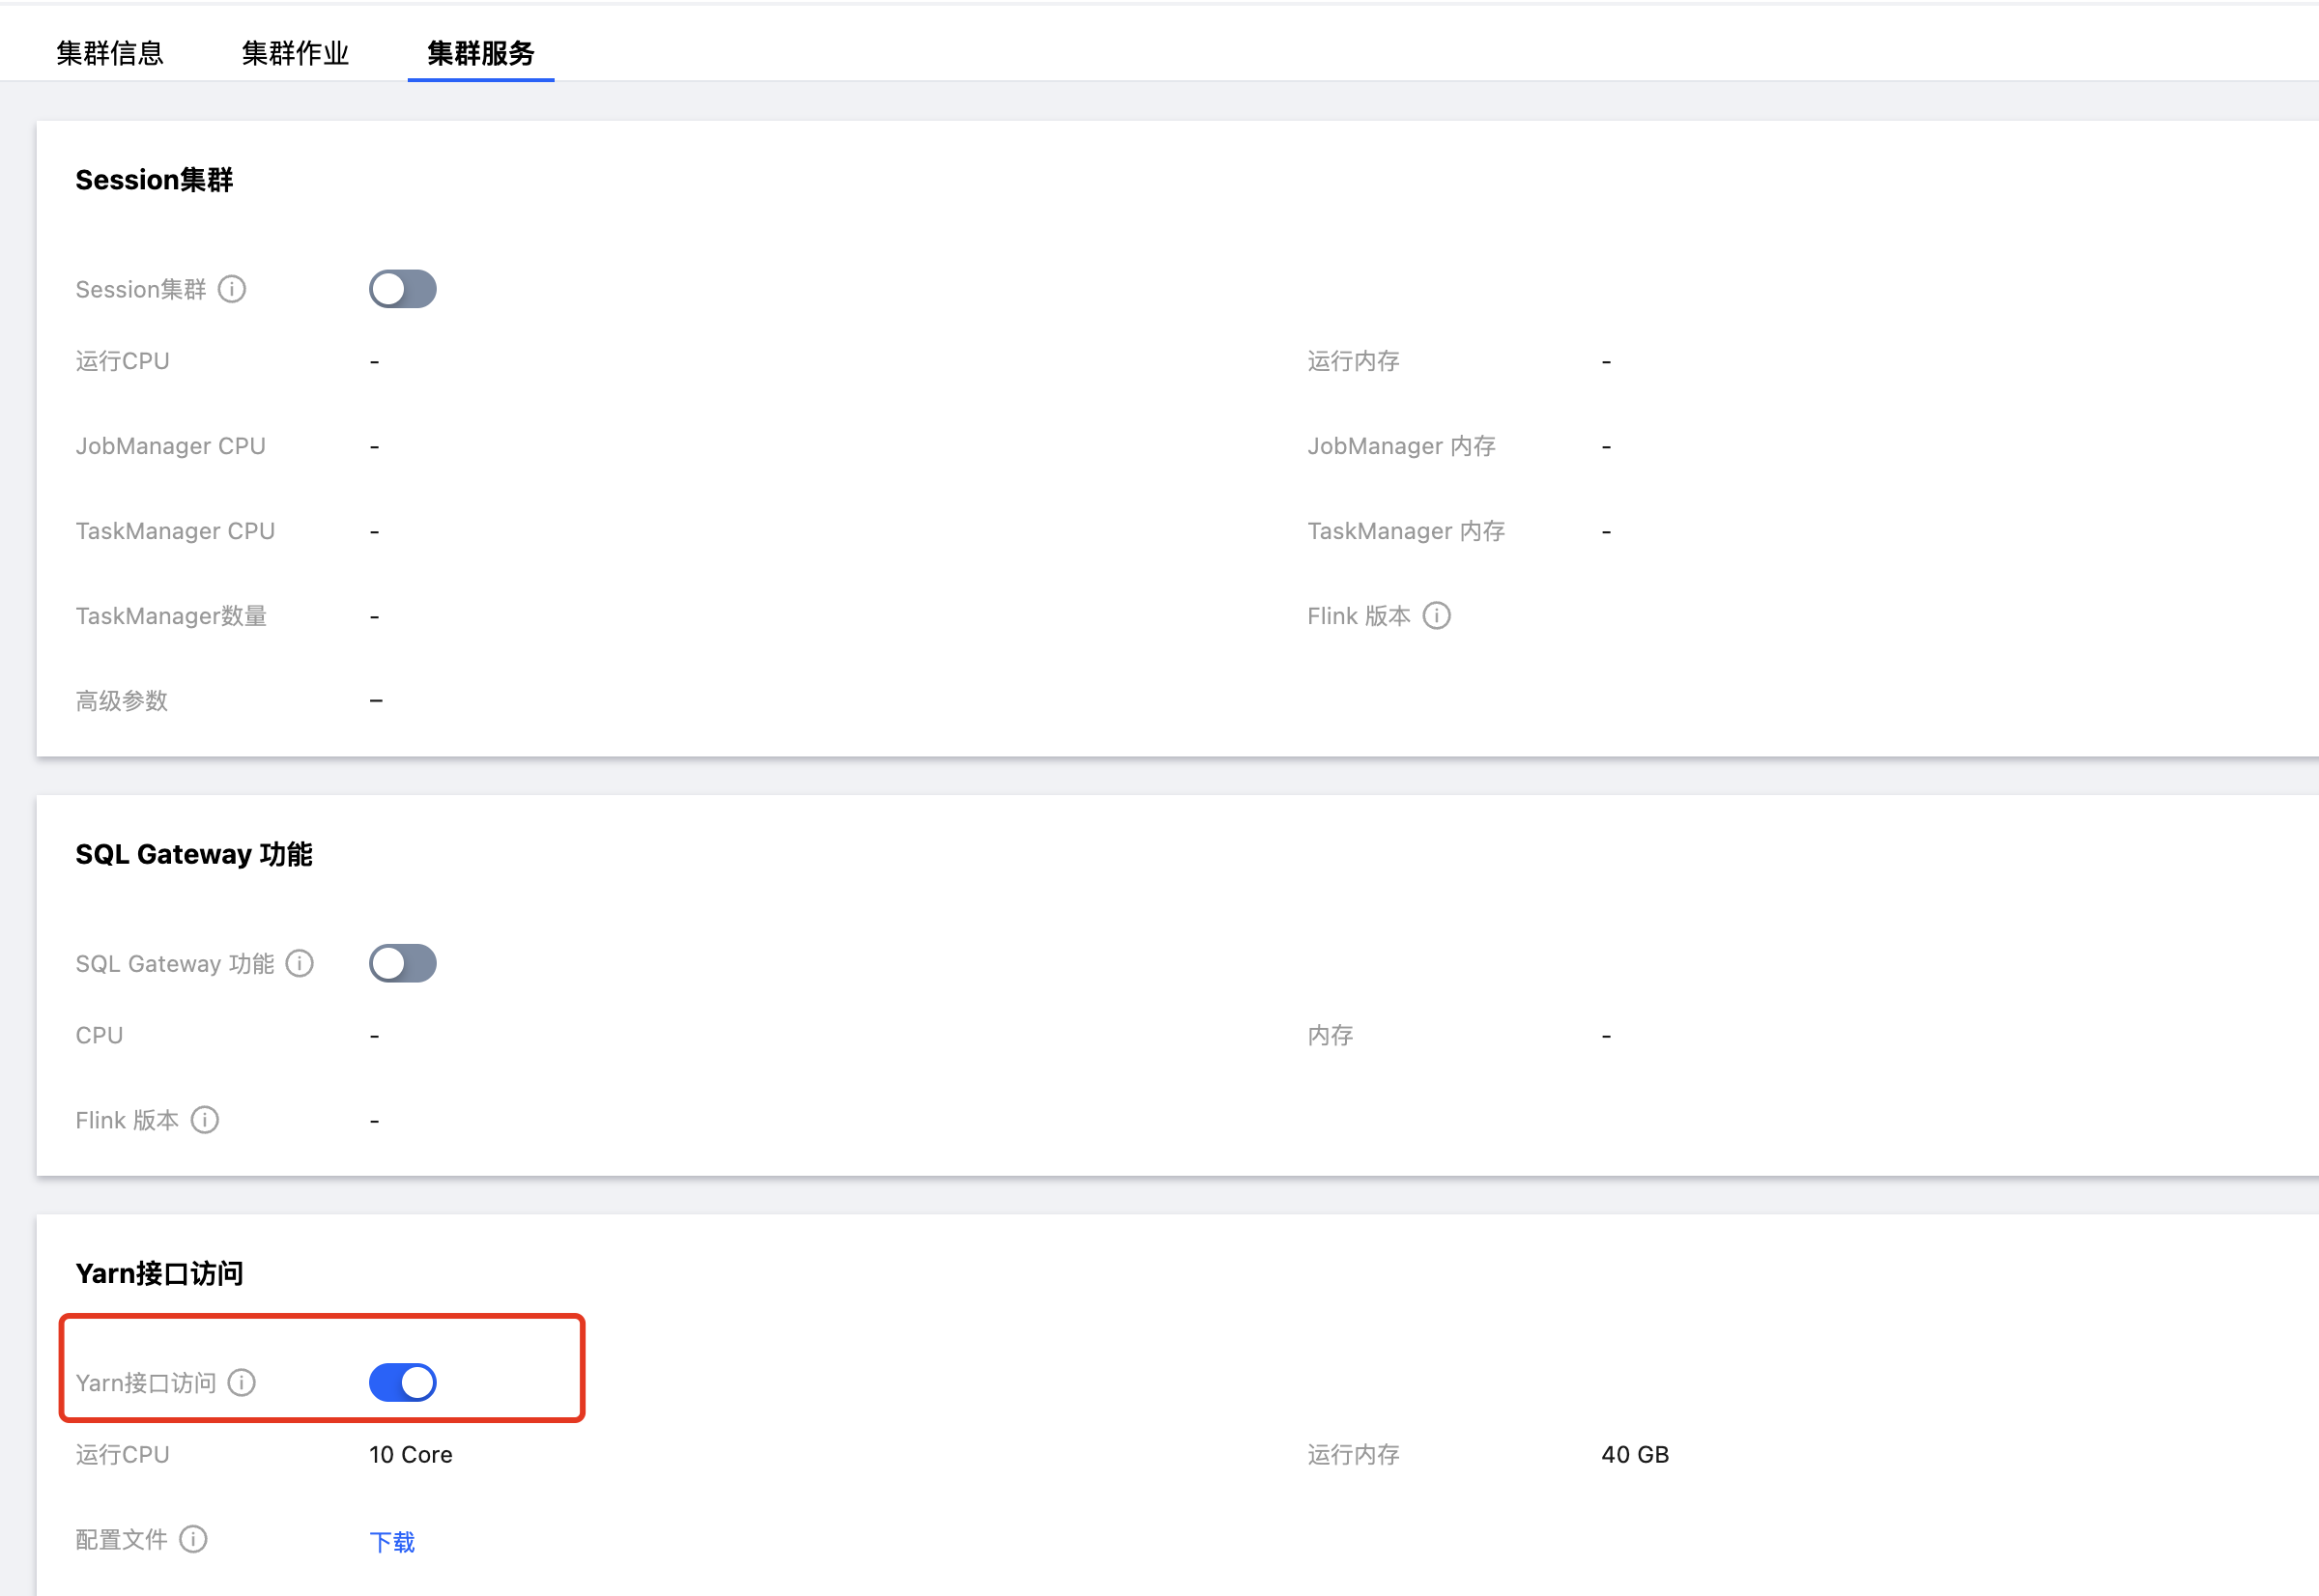
说明:
开启 Yarn 接口访问,若出现"Cluster is not supported yarn mode, please contact us to upgrade oceanus control components." 错误,请 提交工单 联系我们升级管控组件后再开启。
2. 下载配置文件,zip 包解压之后有以下7个文件。
core-site.xmlhdfs-site.xmlmapred-site.xmlyarn-site.xmldinky-config.yamlstreampark-config.yamlhosts
其中将 core-site.xml,hdfs-site.xml,mapred-site.xml,yarn-site.xml 放到 hadoop home 的目录 etc/hadoop;dinky-config.yaml 文件中有 flink 各版本 lib 路径、HDFS 操作用户名、HDFS defaultFS ;streampark-config.yaml 包含 StreamPark 服务目录 conf/config.yaml streampark 部分的内容;hosts 中内容追加到 /etc/hosts 文件中。
Yarn 原生命令提交示例
flink lib 目录下包含 flink-shaded-hadoop-**.jar,下载上述配置文件并放在指定目录;仅支持 jar 作业。
Flink 版本 | shell 命令 example |
flink 1.13 | ./bin/flink run-application -t yarn-application -Dyarn.application.name=wordcount_native_113 -DJobManagerCpu=0.5 -DJobManagerMem=2.0 -DTaskManagerCpu=0.5 -DTaskManagerMem=2.0 -Dyarn.ship-files=/opt/connector/flink-connector-logger-1.14.jar -c com.tencent.cloud.test.WordCount /tmp/flink-hello-world-4.0.0-jar-with-dependencies.jar |
flink 1.16 | ./bin/flink run-application -t yarn-application -Dyarn.application.name=wordcount_native_116 -DJobManagerCpu=0.5 -DJobManagerMem=2.0 -DTaskManagerCpu=0.5 -DTaskManagerMem=2.0 -Dyarn.ship-files=/opt/connector/flink-connector-logger-1.16.jar -c com.tencent.cloud.test.WordCount /tmp/flink-hello-world-4.0.0-jar-with-dependencies.jar |
flink 1.18 | ./bin/flink run-application -t yarn-application -Dyarn.application.name=wordcount_native_118 -DJobManagerCpu=0.5 -DJobManagerMem=2.0 -DTaskManagerCpu=0.5 -DTaskManagerMem=2.0 -Dyarn.ship-files=/opt/connector/flink-connector-jdbc-flink1.18.jar -c com.tencent.cloud.test.WordCount /tmp/flink-hello-world-4.0.0-jar-with-dependencies.jar |
flink 1.20 | ./bin/flink run-application -t yarn-application -Dyarn.application.name=wordcount_native_120 -DJobManagerCpu=0.5 -DJobManagerMem=2.0 -DTaskManagerCpu=0.5 -DTaskManagerMem=2.0 -Dyarn.ship-files=/opt/connector/flink-connector-jdbc-flink1.20.jar -c com.tencent.cloud.test.WordCount /tmp/flink-hello-world-4.0.0-jar-with-dependencies.jar |
StreamPark 示例
1. 用 streampark-config.yaml 包含 StreamPark 服务目录 conf/config.yaml streampark 部分的内容,启动 StreamPark 服务。
streampark:workspace:local: /tmp/streamparkremote: /streampark #create cos dir, 2.14 need create /streampark/plugins dirproxy:lark-url:yarn-url: http://******:8088yarn:http-auth: 'simple' # default simple, or kerberoshadoop-user-name: root
2. core-site.xml,hdfs-site.xml,mapred-site.xml,yarn-site.xml 放到 hadoop home 的目录 etc/hadoop;
3. 依赖 jar 如下 :
放在 flink 的 lib/ 目录下,cos_api-bundle-5.6.244.4.jar hadoop-cos-3.1.0-8.3.28.jar guava-24.1.1-jre.jar 放 StreamPark 的 lib/ 目录下。
4. streampark 暂时不支持 cos, 需要替换下 lib/streampark-common_2.12-2.1.6.jar
# 1. 下载 javassistcd /tmpcurl -O https://repo1.maven.org/maven2/org/javassist/javassist/3.29.2-GA/javassist-3.29.2-GA.jar# 2. 创建 patch 程序cat > /tmp/PatchHdfsOperator.java << 'EOF'import javassist.*;public class PatchHdfsOperator {public static void main(String[] args) throws Exception {ClassPool pool = ClassPool.getDefault();// 从 jar 包加载 classpool.insertClassPath("/opt/apache-streampark_2.12-2.1.6-bin/lib/streampark-common_2.12-2.1.6.jar");CtClass cc = pool.get("org.apache.streampark.common.fs.HdfsOperator$");// 找到 toHdfsPath 方法CtMethod method = cc.getDeclaredMethod("toHdfsPath");// 替换方法体method.setBody("{ return $1.matches(\\"^\\\\\\\\w+://.*\\") ? $1 : org.apache.streampark.common.util.HdfsUtils$.MODULE$.getDefaultFS().concat($1); }");// 写入 class 文件cc.writeFile("/tmp/patched");System.out.println("Patched HdfsOperator class written to /tmp/patched");}}EOF# 3. 编译运行javac -cp /tmp/javassist-3.29.2-GA.jar /tmp/PatchHdfsOperator.javajava -cp "/tmp:/tmp/javassist-3.29.2-GA.jar" PatchHdfsOperator# 4. 替换 jar 包里的 classcd /opt/apache-streampark_2.12-2.1.6-bin/libcp streampark-common_2.12-2.1.6.jar /tmp/streampark-common_2.12-2.1.6.jar.bakjar uf streampark-common_2.12-2.1.6.jar -C /tmp/patched 'org/apache/streampark/common/fs/HdfsOperator$.class'# 5. 重启cd /opt/apache-streampark_2.12-2.1.6-bin/bin./shutdown.sh./startup.sh
5. SQL 作业示例。
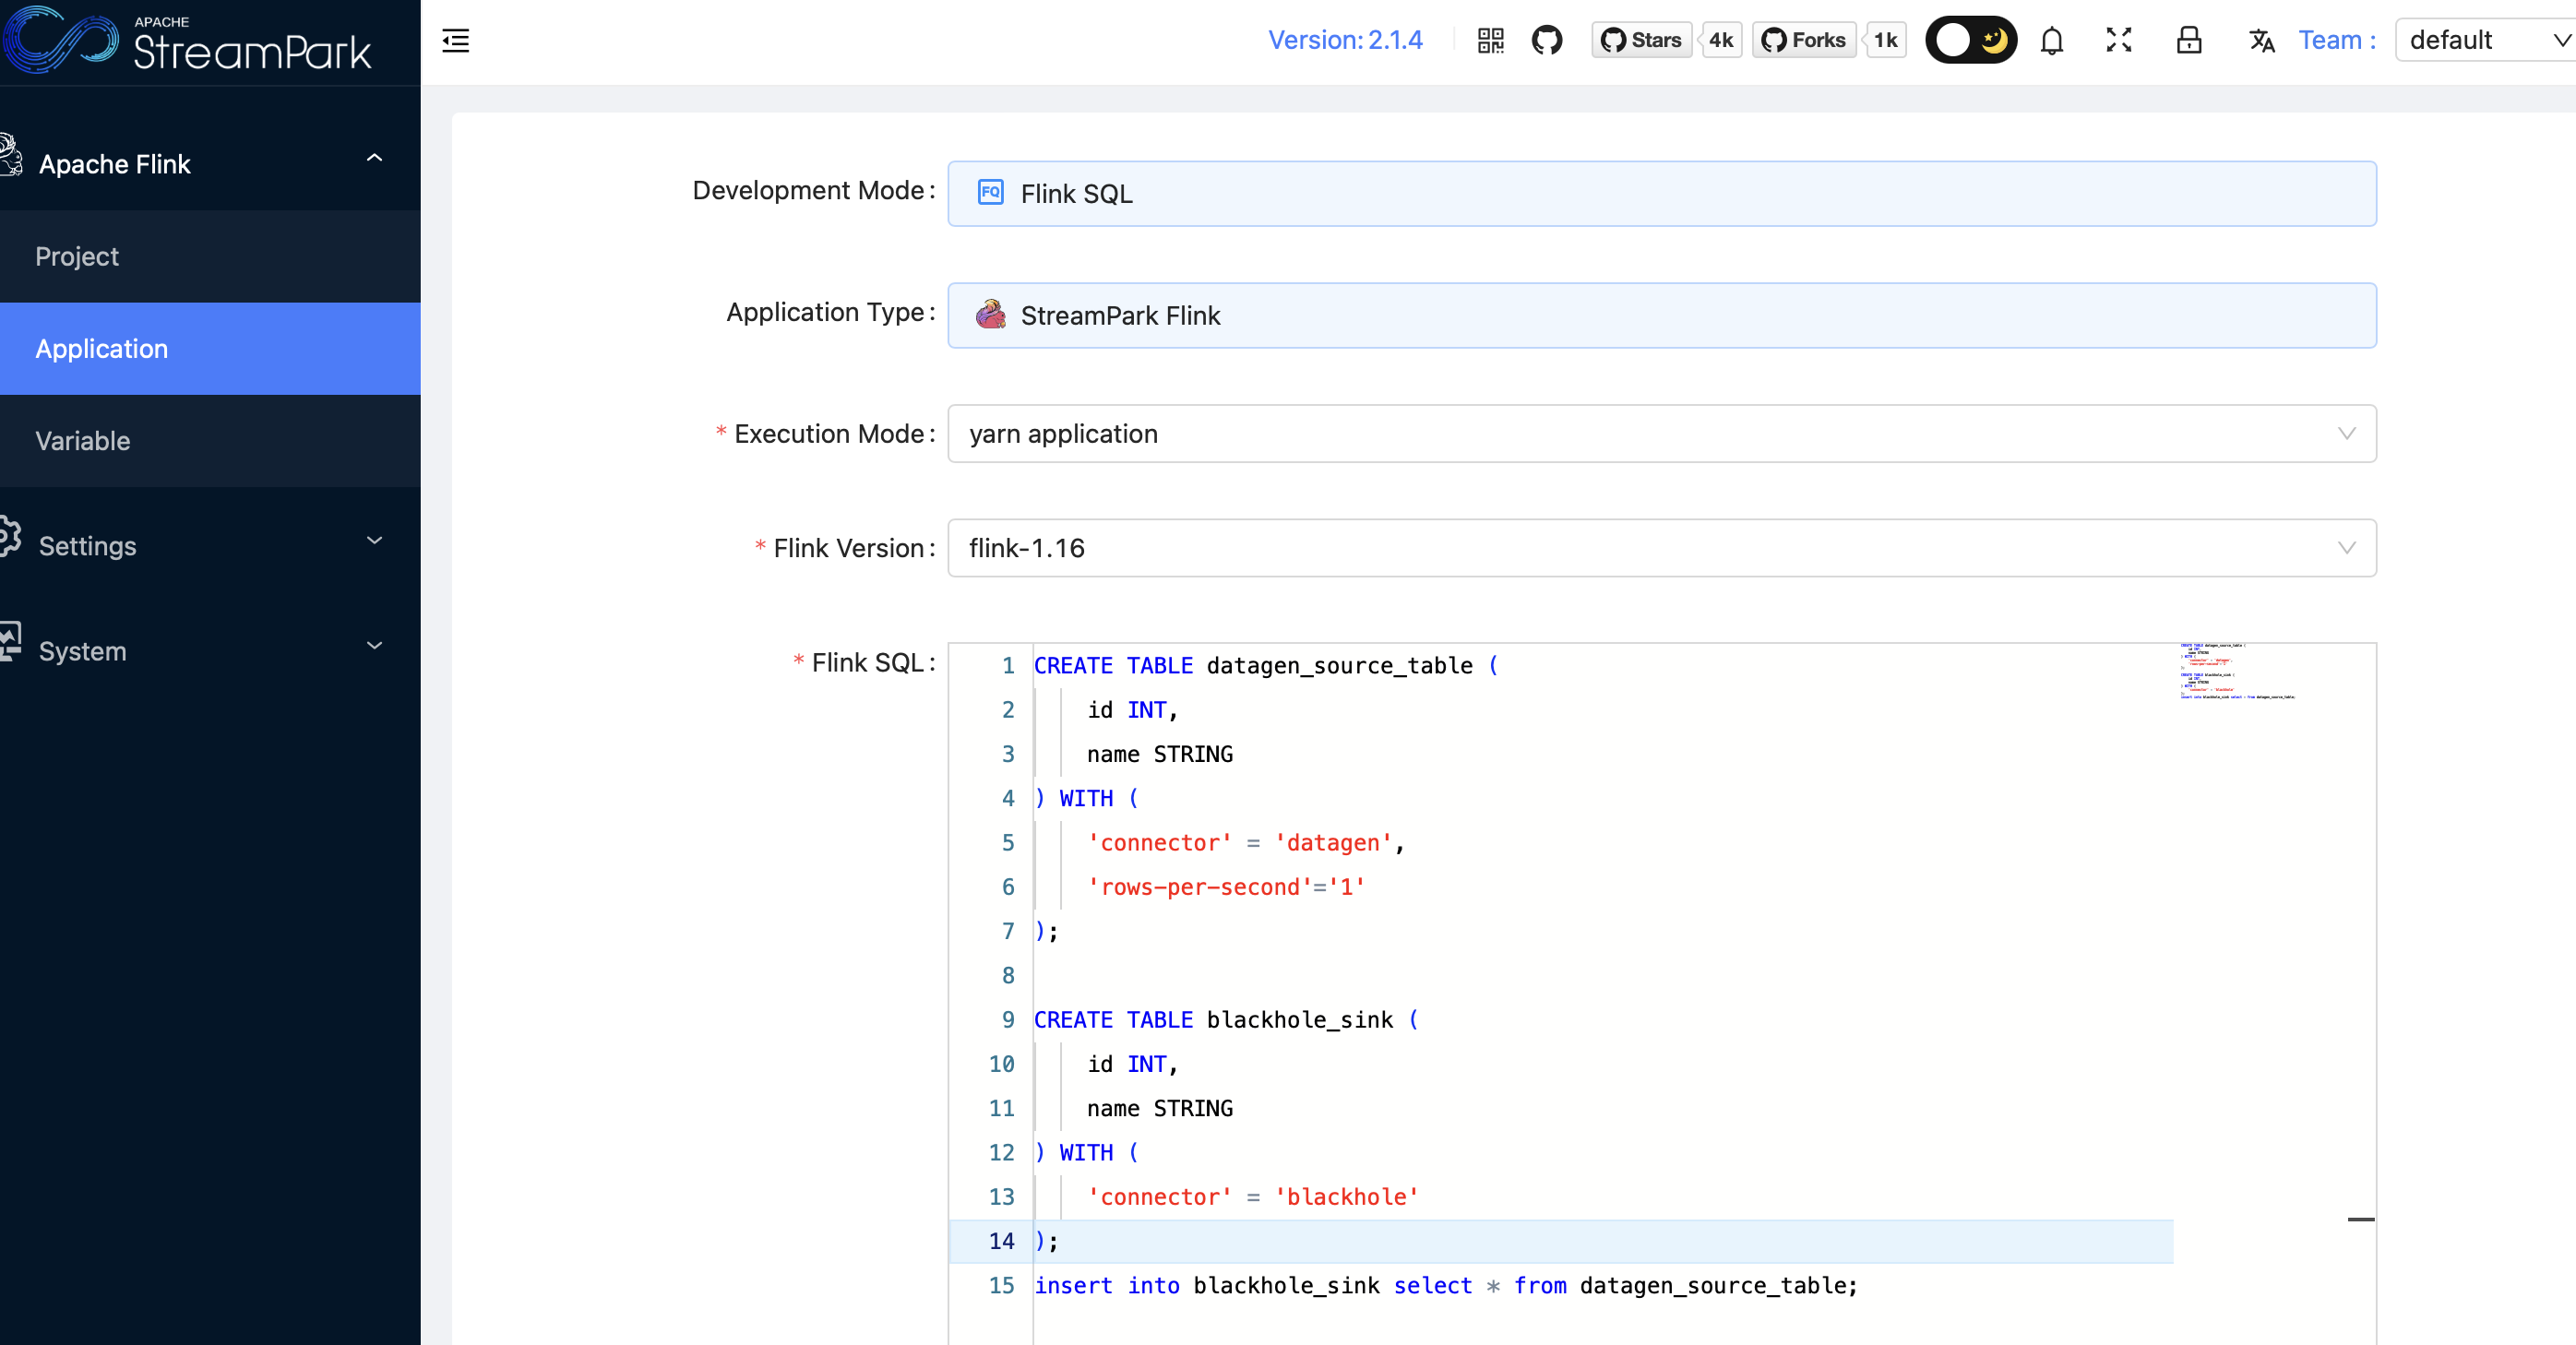
CREATE TABLE datagen_source_table (id INT,name STRING) WITH ('connector' = 'datagen','rows-per-second'='1');CREATE TABLE blackhole_sink (id INT,name STRING) WITH ('connector' = 'blackhole');insert into blackhole_sink select * from datagen_source_table;
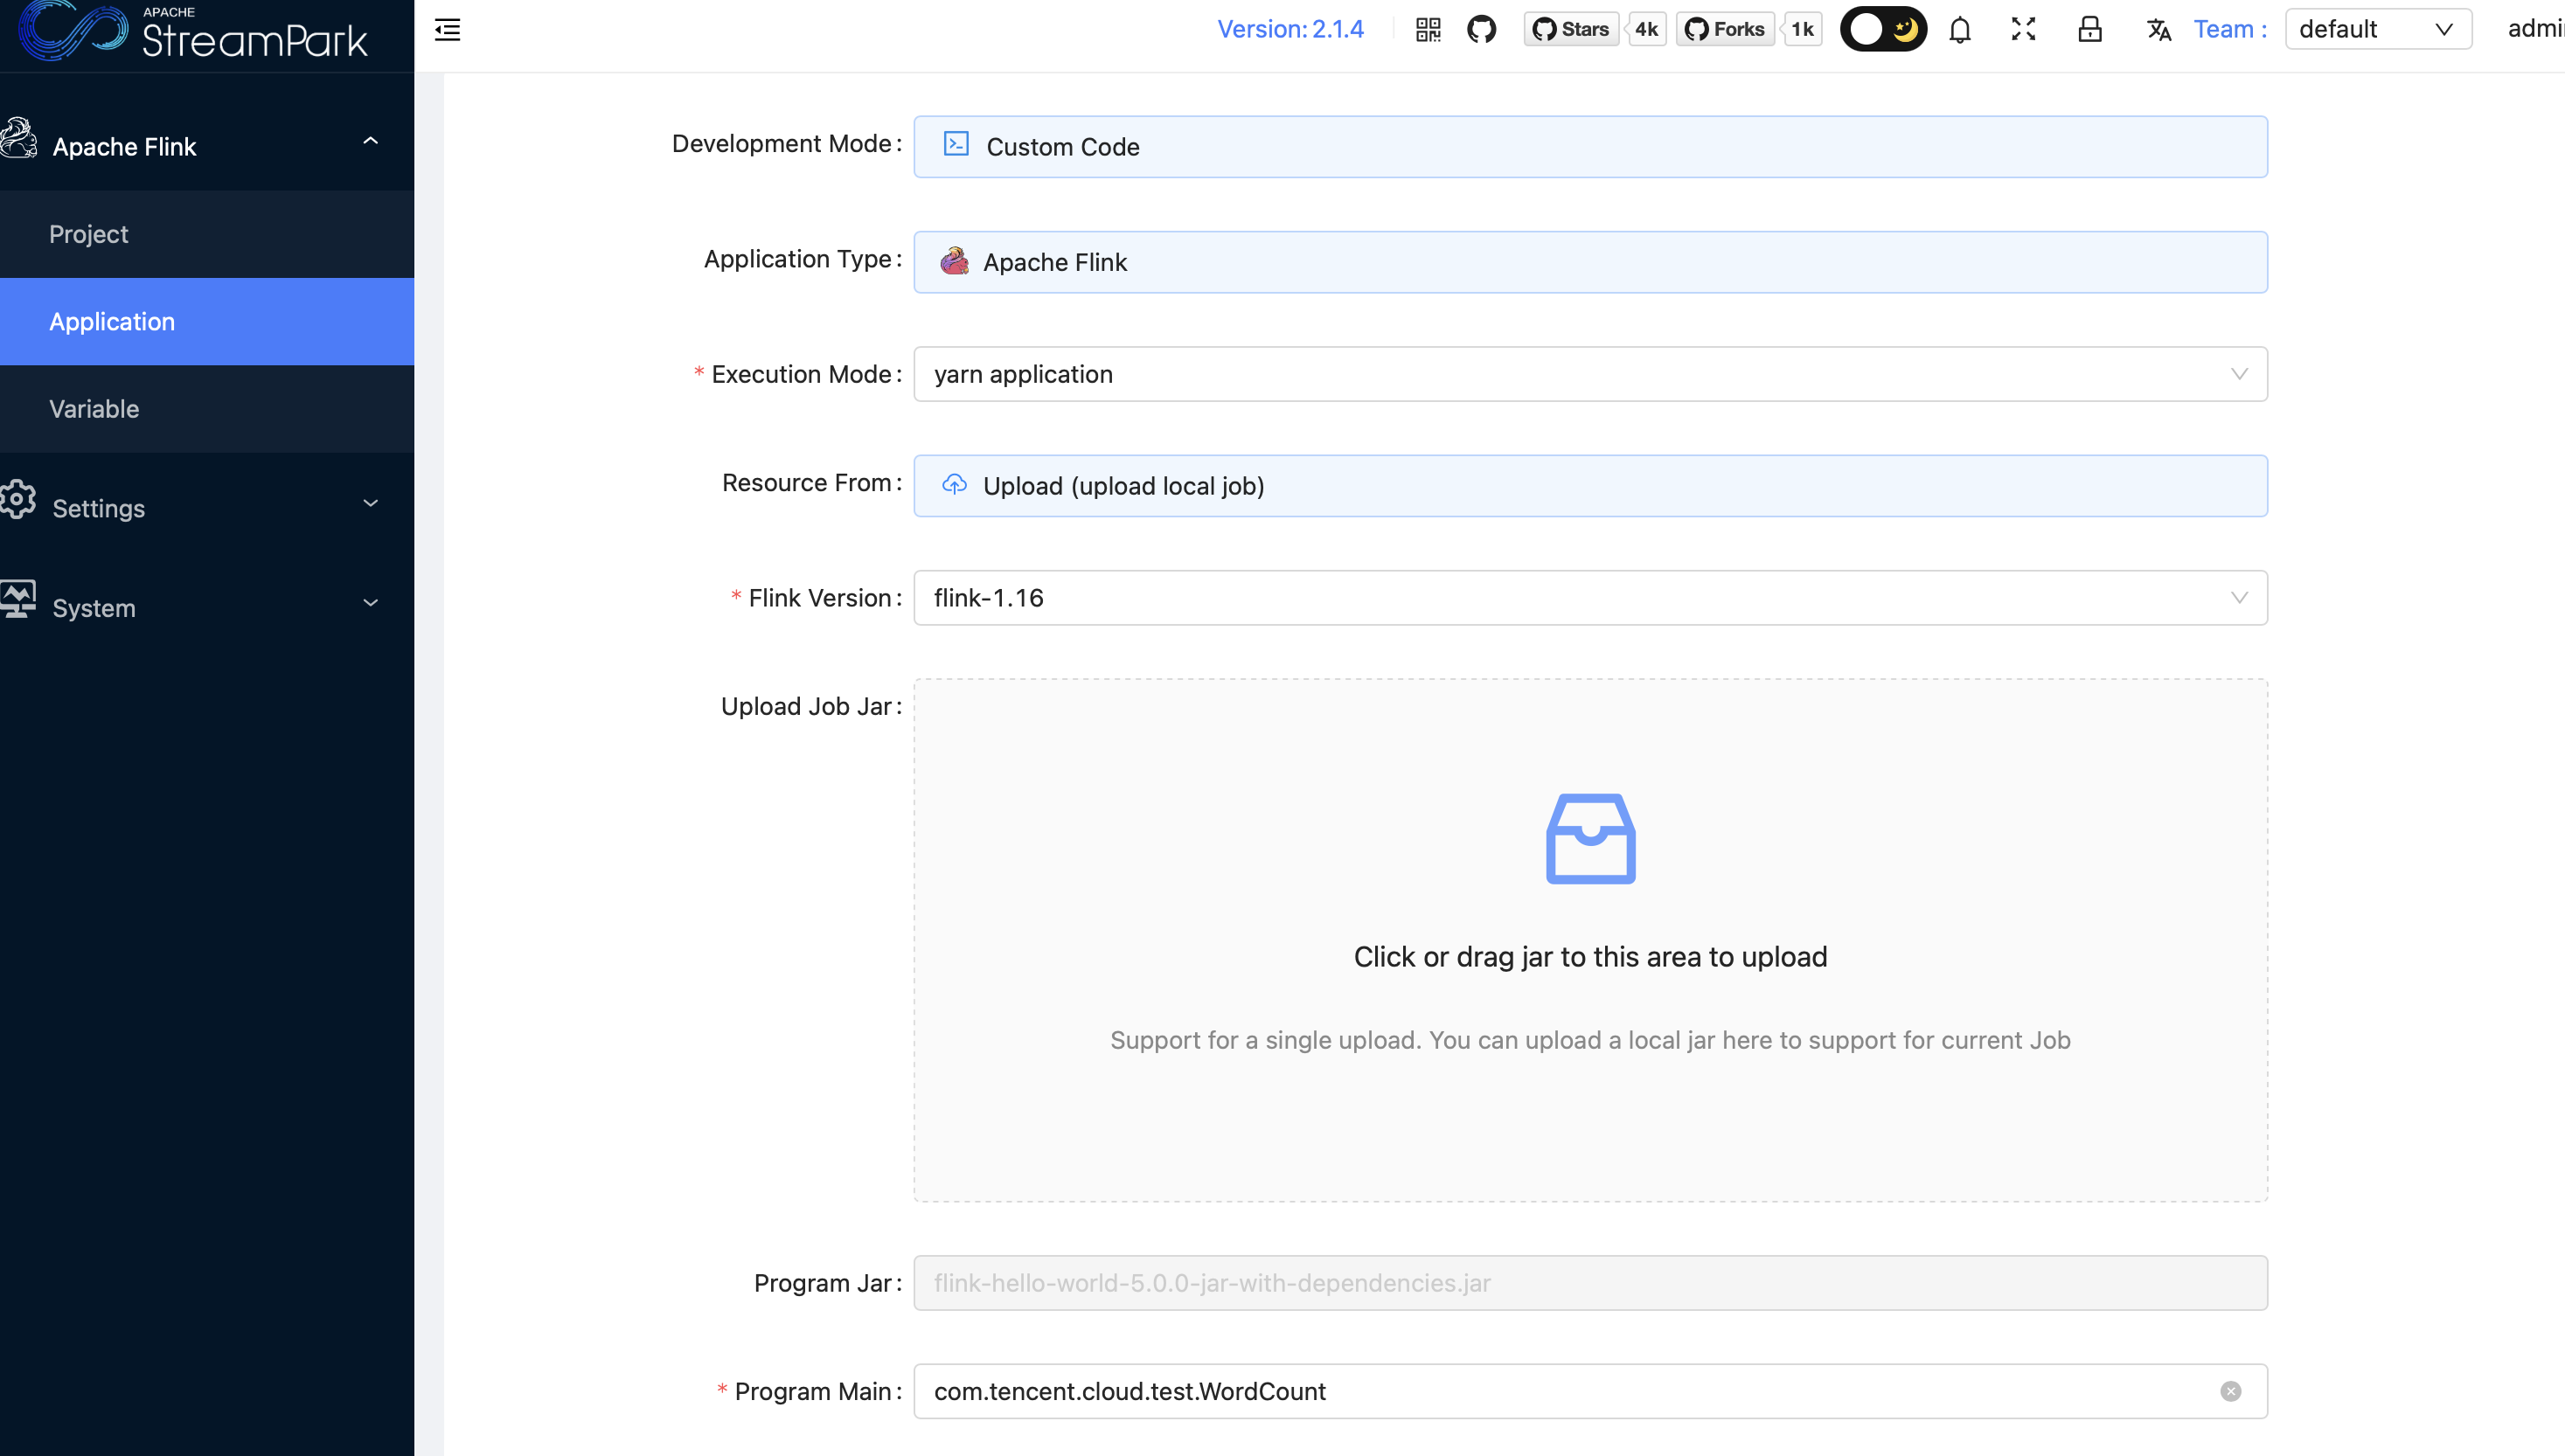
6. Jar 作业示例。
jar 包不需要写 savepoint dir 和 checkpoint dir。
7. 作业参数设置。
在 Dynamic Properties 设置 -DJobManagerCpu=1.0 -DJobManagerMem=4.0 -DTaskManagerCpu=1.0 -DTaskManagerMem=4.0 可参考作业资源配置。
使用内置 connector 例如添加 -DBuiltInConnector=flink-connector-mysql-cdc;如果多个 connector 用“,”连接。


