【提升计算效率】向量化人工智能算法的策略与实现
原创
向量化是提高人工智能算法计算效率的关键技术之一。通过将操作应用于向量或矩阵,而不是逐个元素处理,向量化可以显著加速计算过程。本文将探讨向量化的基本概念、实现方法,并提供Python代码示例,以帮助读者理解如何在人工智能算法中应用这一技术。
向量化的基本概念
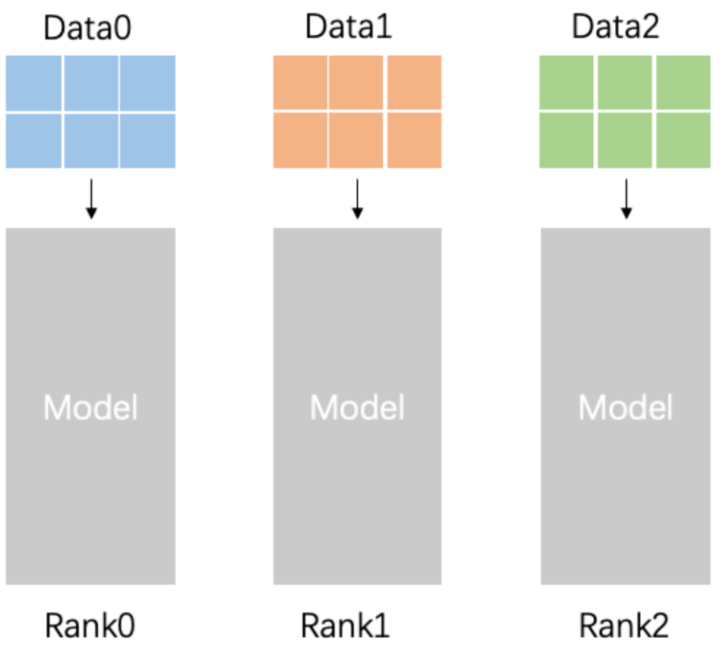
向量化是将标量运算转换为向量运算的过程。传统的标量运算逐个处理数据元素,而向量化则一次处理多个数据元素,从而利用现代处理器的并行计算能力。向量化可以显著减少计算时间,尤其是在处理大规模数据时。
向量化与标量运算的比较
- 标量运算:逐个处理数据元素,计算速度较慢。
- 向量化:批量处理数据元素,计算速度较快,适合现代处理器的并行计算能力。
向量化在人工智能算法中的应用
向量化在许多人工智能算法中都有广泛应用,尤其是在机器学习和深度学习领域。例如,在神经网络训练过程中,向量化操作可以加速矩阵运算,从而缩短训练时间。
1. 向量化操作的实现
在Python中,NumPy库提供了强大的向量化功能。通过使用NumPy,我们可以将标量操作转换为向量操作,实现高效计算。
示例代码:向量化数组运算
import numpy as np

# 创建两个随机数组
a = np.random.rand(1000)
b = np.random.rand(1000)

# 标量运算
result_scalar = np.zeros(1000)
for i in range(1000):
    result_scalar[i] = a[i] + b[i]

# 向量化运算
result_vectorized = a + b

# 输出结果
print("标量运算结果:", result_scalar[:5])
print("向量化运算结果:", result_vectorized[:5])在上述代码中,result_vectorized的计算速度明显快于result_scalar,这就是向量化的优势。
2. 向量化在神经网络中的应用
在深度学习中,神经网络的前向传播和反向传播过程涉及大量的矩阵运算。向量化可以加速这些运算,从而提升训练效率。
示例代码:向量化矩阵乘法
import numpy as np

# 创建两个随机矩阵
A = np.random.rand(100, 100)
B = np.random.rand(100, 100)

# 标量运算
result_scalar = np.zeros((100, 100))
for i in range(100):
    for j in range(100):
        result_scalar[i, j] = np.dot(A[i, :], B[:, j])

# 向量化运算
result_vectorized = np.dot(A, B)

# 输出结果
print("标量运算结果:", result_scalar[:5, :5])
print("向量化运算结果:", result_vectorized[:5, :5])在这个例子中,result_vectorized的计算速度远远快于result_scalar,展示了向量化在矩阵运算中的效率提升。
向量化的实践建议
- 利用高效的数学库:使用
NumPy、TensorFlow、PyTorch等库,这些库内部实现了高度优化的向量化操作。 - 避免显式循环:尽量使用向量化操作代替显式的循环,减少计算时间。
- 优化数据布局:确保数据以适合向量化的方式存储,例如使用连续的内存块。
向量化技术在深度学习中的进阶应用
在深度学习中,向量化不仅限于基础的矩阵运算,还包括更复杂的操作,如卷积、激活函数和损失计算。以下部分将深入探讨这些进阶应用,并提供相应的代码示例。
1. 向量化卷积操作
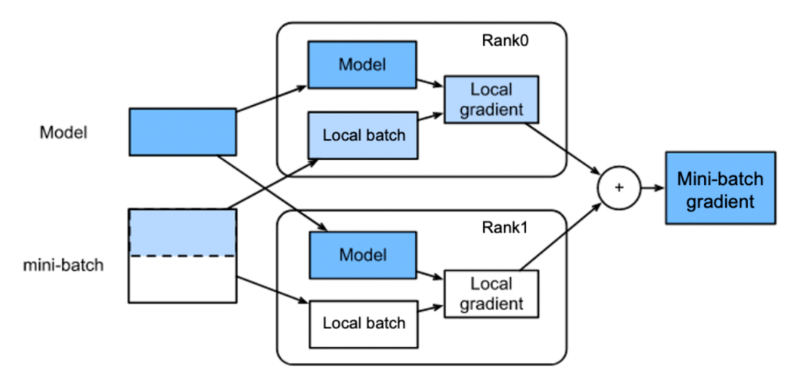
卷积是深度学习中常见的操作,尤其在卷积神经网络(CNN)中。向量化的卷积操作可以显著提升计算效率。
示例代码:向量化二维卷积
import numpy as np
from scipy.signal import convolve2d

# 创建随机图像和卷积核
image = np.random.rand(256, 256)
kernel = np.random.rand(3, 3)

# 标量卷积
result_scalar = np.zeros((256 - 2, 256 - 2))
for i in range(256 - 2):
    for j in range(256 - 2):
        result_scalar[i, j] = np.sum(image[i:i+3, j:j+3] * kernel)

# 向量化卷积
result_vectorized = convolve2d(image, kernel, mode='valid')

# 输出结果
print("标量卷积结果:", result_scalar[:5, :5])
print("向量化卷积结果:", result_vectorized[:5, :5])在这个示例中,convolve2d函数提供了向量化的卷积实现,显著加快了计算速度。
2. 向量化激活函数计算
激活函数是神经网络中的重要组成部分。向量化的激活函数计算可以加速前向传播和反向传播过程。
示例代码:向量化ReLU激活函数
import numpy as np

# 创建随机输入数据
X = np.random.randn(1000, 1000)

# 标量ReLU
def relu_scalar(x):
    return np.maximum(0, x)

result_scalar = np.zeros_like(X)
for i in range(X.shape[0]):
    for j in range(X.shape[1]):
        result_scalar[i, j] = relu_scalar(X[i, j])

# 向量化ReLU
result_vectorized = np.maximum(0, X)

# 输出结果
print("标量ReLU结果:", result_scalar[:5, :5])
print("向量化ReLU结果:", result_vectorized[:5, :5])在这个例子中,使用np.maximum函数可以高效地计算ReLU激活函数,替代了逐个元素处理的标量实现。
3. 向量化损失函数计算
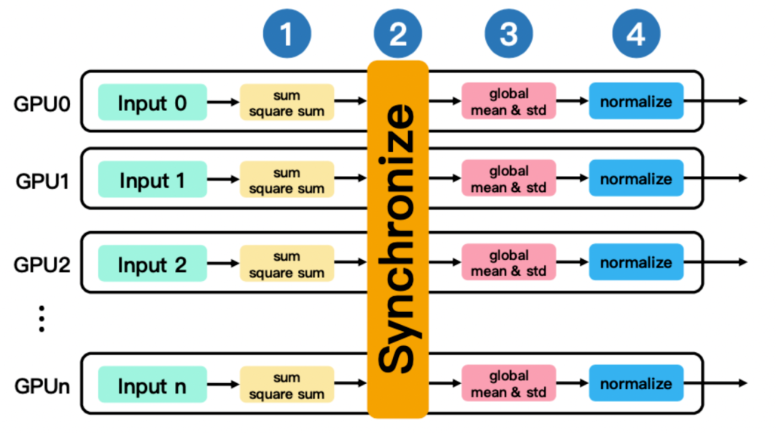
损失函数用于评估模型的预测误差。向量化的损失函数计算可以加速训练过程。
示例代码:向量化均方误差损失函数
import numpy as np

# 创建随机预测值和真实值
y_pred = np.random.randn(1000)
y_true = np.random.randn(1000)

# 标量均方误差
def mse_scalar(y_true, y_pred):
    return np.mean((y_true - y_pred) ** 2)

result_scalar = mse_scalar(y_true, y_pred)

# 向量化均方误差
def mse_vectorized(y_true, y_pred):
    return np.mean((y_true - y_pred) ** 2)

result_vectorized = mse_vectorized(y_true, y_pred)

# 输出结果
print("标量均方误差:", result_scalar)
print("向量化均方误差:", result_vectorized)在这个示例中,mse_vectorized函数利用向量化技术实现了均方误差的计算,相比标量实现更为高效。
向量化技术的挑战与解决方案
虽然向量化技术可以大幅提高计算效率,但也面临一些挑战,如内存占用、数据布局和硬件限制。以下是一些解决方案:
1. 内存占用优化
向量化操作可能会导致内存占用增加,特别是在处理大规模数据时。通过使用内存映射(memory-mapped files)和稀疏矩阵(sparse matrices),可以有效减少内存使用。
2. 数据布局优化
确保数据按顺序存储,以便在向量化操作中提高缓存命中率。这可以通过调整数据的排列方式或使用适当的数据结构来实现。
3. 硬件限制
现代处理器和GPU都支持向量化操作,但在某些硬件上,向量化的效果可能会受到限制。了解硬件的特点,并优化代码以适应硬件的架构,可以进一步提升性能。
结论
向量化是提升人工智能算法计算效率的重要技术,广泛应用于矩阵运算、卷积操作、激活函数计算和损失函数计算等方面。通过有效利用向量化技术,可以显著加速算法的执行,并提高整体计算性能。
希望本文提供的代码示例和技术建议能够帮助读者更好地理解和应用向量化技术,提升人工智能算法的计算效率。如果您有进一步的问题或需要更多的技术支持,请随时与我们联系。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号