MySQL 之索引详解

想象一下,你正在图书馆寻找一本关于 MySQL 索引的书。图书馆里有成千上万本书,但没有目录。你只能一排一排、一本一本地找,直到找到你想要的书。这将会花费大量的时间!数据库索引就像图书馆的目录一样,可以帮助数据库系统快速定位到所需数据,从而大大提高查询速度。
1. 索引基础:概念与类型
1.1 什么是索引?
索引是一种特殊的数据结构,它存储了表中一列或多列的值以及对应行的物理地址。当数据库执行查询时,会首先在索引中查找符合条件的记录地址,然后再根据地址直接访问数据行,从而避免了全表扫描,提高了查询效率。
示例:
假设我们有一个名为 users 的表,包含以下数据:
id | name | |
|---|---|---|
1 | 张三 | zhangsan@example.com |
2 | 李四 | lisi@example.com |
3 | 王五 | wangwu@example.com |
如果我们在 name 列上创建索引,数据库就会创建一个索引结构,其中包含 name 列的值和对应行的 id:
name | id |
|---|---|
张三 | 1 |
李四 | 2 |
王五 | 3 |
当我们执行查询 SELECT * FROM users WHERE name = '李四' 时,数据库会首先在索引中找到 name 为 '李四' 的记录,然后直接访问 id 为 2 的行,而不需要扫描整个 users 表。
1.2 常见的索引类型
MySQL 支持多种类型的索引,常见的包括:
- 主键索引 (PRIMARY KEY): 唯一标识表中每一行的索引,一个表只能有一个主键索引,主键索引的值不能为空。
- 唯一索引 (UNIQUE): 唯一索引保证索引列的值是唯一的,可以有多个唯一索引,允许为空值(但只允许一个空值)。
- 普通索引 (INDEX): 最基本的索引类型,没有任何限制,用于加速查询速度。
- 全文索引 (FULLTEXT): 用于在文本字段中进行全文搜索,主要用于 MyISAM 引擎。
2. 索引的利与弊
优点:
- 大大加快数据的检索速度,这是创建索引的最主要原因。
- 加速表之间的连接,特别是在实现数据的参考完整性方面特别有用。
- 在使用分组和排序子句进行数据检索时,可以显著减少查询中分组和排序的时间。
缺点:
- 创建和维护索引需要耗费时间,而且随着数据量的增加而增加。
- 索引需要占用物理空间,如果要建立索引的列数据量很大,那么需要的存储空间也会很大。
- 当对表中的数据进行修改时,比如添加、删除和修改,索引也需要动态地维护,降低了数据的维护速度。
3. 索引操作:创建与删除
创建索引:
可以使用 CREATE INDEX 或 ALTER TABLE 语句来创建索引:
- CREATE INDEX:
CREATE INDEX index_name ON table_name (column_name);示例:
CREATE INDEX idx_name ON users (name);- ALTER TABLE:
ALTER TABLE table_name ADD INDEX index_name (column_name);示例:
ALTER TABLE users ADD INDEX idx_email (email);删除索引:
可以使用 DROP INDEX 或 ALTER TABLE 语句来删除索引:
- DROP INDEX:
DROP INDEX index_name ON table_name;示例:
DROP INDEX idx_name ON users;- ALTER TABLE:
ALTER TABLE table_name DROP INDEX index_name;示例:
ALTER TABLE users DROP INDEX idx_email;4. 深入底层:数据结构与性能对比
前面我们已经了解了索引的基本概念,现在让我们更深入地探讨 MySQL 索引的底层实现原理,以及使用索引和不使用索引在性能上的巨大差异。
4.1 索引的数据结构
MySQL 索引的底层数据结构主要有两种:B+Tree(多路平衡搜索树) 和 哈希表。我们平常所说的索引,如果没有特别指明,都是指默认的 B+Tree 结构组织的索引。
- B+ 树 是一种多路平衡查找树,它将所有数据存储在叶子节点,非叶子节点只存储索引值和指向子节点的指针。所有叶子节点通过链表连接,方便范围查询,并且每个节点可以存储多个索引值,降低树的高度,减少 I/O 次数, 使其成为 MySQL 索引最常用的数据结构。
- 哈希表 是一种键值对存储结构,它通过哈希函数将索引值映射到哈希表中的一个位置,从而实现快速查找。哈希表适用于等值查询,例如 WHERE name = '张三',但不适用于范围查询。MySQL 中,Memory 存储引擎默认使用哈希索引,而 InnoDB 存储引擎默认使用 B+ 树索引。
B + Tree(多路平衡搜索树)结构介绍,如图所示:
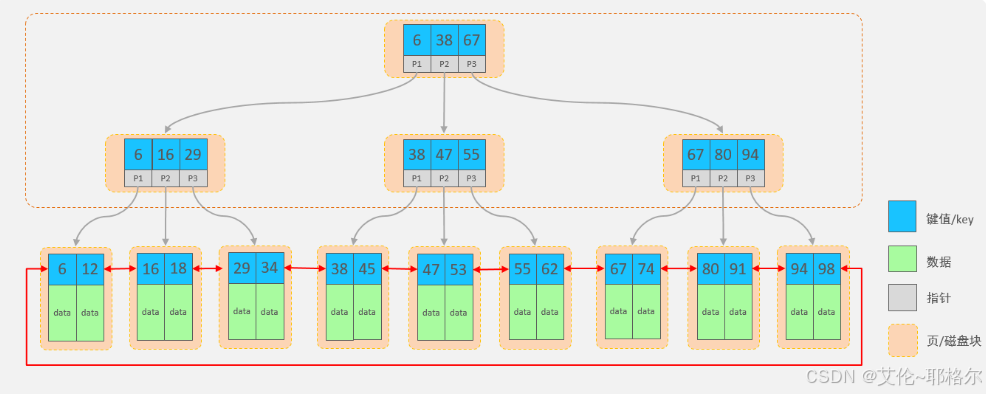
B+Tree结构:
- 每一个节点,可以存储多个key(有n个key,就有n个指针)
- 节点分为:叶子节点、非叶子节点
- 叶子节点,就是最后一层子节点,所有的数据都存储在叶子节点上
- 非叶子节点,不是树结构最下面的节点,用于索引数据,存储的的是:key+指针
- 为了提高范围查询效率,叶子节点形成了一个双向链表,便于数据的排序及区间范围查询
4.2 使用索引和不使用索引的性能差异
为了更好地理解使用索引带来的性能提升,我们来看一个具体的例子。
假设我们有一个包含 100 万条数据的 users 表,其中 name 列没有创建索引。
场景一:不使用索引
SELECT * FROM users WHERE name = '张三';当执行这条 SQL 语句时,MySQL 数据库需要遍历整个 users 表,逐行比较 name 列的值是否等于 '张三',直到找到匹配的行。这种方式被称为全表扫描,效率非常低下,尤其是在数据量非常大的情况下。
场景二:使用索引
CREATE INDEX idx_name ON users (name);

SELECT * FROM users WHERE name = '张三';
当我们在 name 列上创建了索引之后,再次执行相同的查询语句,MySQL 数据库会直接使用索引进行查找。由于 B+ 树的特性,查找速度非常快,只需要很少的 I/O 操作就可以定位到目标数据。
总结:
使用索引可以避免全表扫描,大大提高查询效率,尤其是在数据量非常大的情况下。
5. 索引失效:问题与解决
虽然索引可以提高查询效率,但在某些情况下,索引可能会失效,导致 MySQL 数据库无法使用索引进行查询,从而进行全表扫描。
常见的索引失效的情况包括:
- 未使用索引列进行查询: 比如在 WHERE 子句中使用了非索引列进行过滤。
- 对索引列进行了函数操作: 比如在 WHERE 子句中对索引列使用了函数操作,如 SUBSTR、DATE 等。
- 使用了 LIKE 模糊查询,且通配符 % 位于开头: 比如 WHERE name LIKE '%三'。
- 使用了 OR 连接条件,且其中一个条件没有使用索引: 比如 WHERE name = '张三' OR age = 18,如果 age 列没有创建索引,那么整个查询将无法使用索引。
- 数据分布不均: 如果索引列的数据分布非常不均匀,比如大部分数据的索引列值都相同,那么索引的效率也会降低。
6. 总结
索引是 MySQL 数据库中非常重要的一个概念,合理地使用索引可以大大提高数据库的查询效率。在设计和使用索引时,需要根据实际情况选择合适的索引类型,并尽量避免索引失效的情况。
以上就是关于数据库中索引的相关知识,希望对各位看官有所帮助,下期见,谢谢~
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2024-09-27,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号