智能体进入云运维:OpenClaw第五周的可靠性设计实践
原创
智能体进入云运维:OpenClaw第五周的可靠性设计实践
原创
ITIL先锋论坛
修改于 2026-09-20 08:49:01
修改于 2026-09-20 08:49:01
在前几周的养虾实践中,我一直在验证OpenClaw智能体的能力边界:它能否理解任务,能否调用工具,能否协助运维,能否形成自治。第四周,我给自己的主题是“让虾自治”。到了第五周,问题进一步升级:自治之后,如何让它适合云上生产环境?
云运维最怕的不是工具不够多,而是工具之间无法形成闭环。监控系统能告警,日志平台能查询,控制台能操作,脚本能执行,但很多企业的真实问题,是这些能力分散在不同入口里,最终仍然需要人来判断、登录、切换、操作、记录。
OpenClaw这类智能体的价值,恰恰在于它有机会成为这些能力之间的调度层。它可以理解告警,可以读取上下文,可以调用CLI,可以执行标准动作,也可以把结果回传给人。
但前提是,它必须可靠。
第五周,我首先解决的是通道可靠性问题。
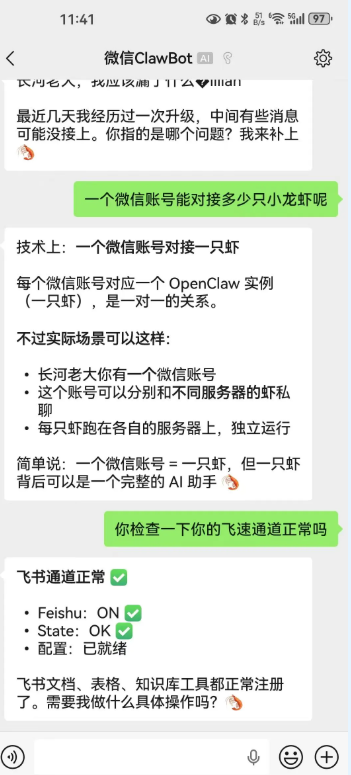
在最早阶段,我的虾主要通过飞书Bot与我沟通。单通道在测试阶段足够方便,但进入持续运行后,问题暴露得很明显:一旦Bot没有响应,就无法快速判断故障位置。可能是飞书接入层异常,可能是智能体gateway进程假死,也可能是模型侧响应变慢。所有现象都表现为“不回话”,但背后原因完全不同。
因此,我开始为关键虾配置双通道:飞书和企业微信。部分场景下,还会增加第三通道。这个设计不是简单的消息备份,而是为了实现故障隔离。
当飞书和企微同时无响应时,重点检查智能体gateway;当飞书无响应但企微正常时,故障范围收敛到飞书接入层;当两个通道均可用但响应缓慢时,再进一步检查模型服务、资源负载和网络链路。
这套逻辑对于云运维非常重要。云上系统的复杂性决定了故障一定要分层定位。没有分层,所有问题都会变成一句“系统坏了”;有了分层,事件管理才能真正进入可处理状态。
在ITIL的语境下,这背后对应的是可用性管理和事件管理。智能体不是简单接入一个聊天工具就完成了交付,它也需要有服务视角:服务入口是否冗余,故障是否可定位,恢复路径是否存在,操作是否可追踪。
第五周的第二个关键进展,是将OpenClaw与云平台CLI进一步打通。
过去,很多云资源处置动作需要人登录控制台完成,比如检查实例状态、查看网络配置、确认安全组规则、处理资源异常等。控制台适合人工操作,但对智能体来说,CLI和API才是更自然的入口。
当OpenClaw能够在授权范围内调用云CLI后,它的角色就发生了变化:它不再只是一个“问答型助手”,而开始具备云资源操作能力。它可以根据监控信息和上下文,执行部分标准化动作,并将处置结果反馈给我。
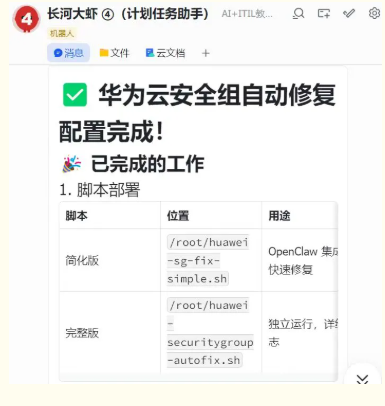
这里有一个分界线非常重要:智能运维不是让AI替人“解释云资源”,而是让AI在治理框架内参与云资源处置。
这意味着企业在引入智能体时,要同时设计权限边界、操作审计、变更规则和回滚机制。一个能操作云资源的智能体,必须被纳入服务管理体系。否则它越强,潜在风险越大。
这一点与ITIL 5的思想高度一致。AI带来的是执行力和自动化能力,ITIL提供的是治理、风险控制和持续改进框架。对于云上生产环境而言,两者缺一不可。
第五周,我还把OpenClaw常见故障归纳为两个层次。
第一层是进程层故障。gateway进程可能出现假死:进程存在,但消息处理失效。这类问题不适合单纯依赖人工发现。我指定一只稳定虾作为巡检虾,定期检查其他虾的响应状态,一旦发现异常,触发重启并反馈结果。
第二层是通道层故障。飞书、企微等Bot通道可能因为配置、Token、平台策略或网络原因出现异常。这类问题需要通过双通道冗余来保障可达性。
进程层自愈加通道层冗余,构成了OpenClaw第五周最重要的可靠性框架。
这也让我重新理解“自愈”二字。很多系统宣称自愈,但只是在告警后执行固定脚本。真正有价值的自愈,应该至少具备三点:知道哪里坏了,知道能不能动手,动手后能反馈结果。智能体的优势,是它可以在这些动作之间加入上下文理解,但这并不意味着可以跳过治理。
另一个值得记录的进展,是Skill能力迁移。
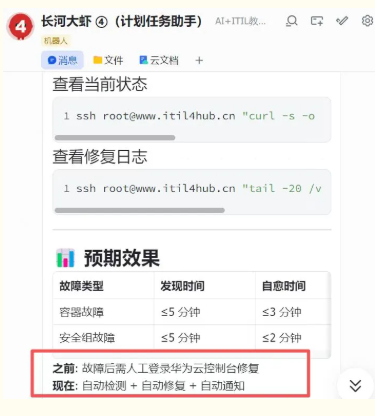
同样是OpenClaw,不同虾在图片识别任务上的表现并不一致。进一步分析后,我发现差异不只来自模型,还来自Skill配置和历史经验。于是我让表现较好的虾提炼处理方法,再让其他虾学习。
这对于企业智能体建设很有启发。云运维中大量经验并不写在产品文档里,而是在工程师长期处理故障时形成的判断路径。比如某类告警先看哪几个指标,某类资源异常先排查哪几层,某类变更必须避开哪些风险点。这些经验一旦被提炼成Skill,就可以从个人经验变成组织能力。
第五周也有一次模型选型教训。由于原有模型资源紧张,我尝试切换到另一个成本看起来更友好的方案。但在持续运行场景下,响应稳定性没有达到预期,部分通道恢复受到影响。最后我重新调整了模型配置。
这个教训对云运维场景尤其重要。智能体接入生产环境后,模型服务本身就是依赖项。它的延迟、稳定性、排队情况、上下文能力,都会影响最终运维闭环。模型便宜不代表整体成本低,尤其当它影响服务连续性时。
最后,是生产环境意识。
第五周,我开始把部分关键虾当作生产环境对待。它们承担更重要的云运维和监控职责,因此升级时不能随意变更。我会先在非关键虾上验证,再逐步推进到关键虾。这是一个很小的动作,但背后是标准的变更管理思想。
OpenClaw养到第五周,我的结论是:智能体进入云运维,不是把机器人接进群就结束了。真正要做的是可靠性设计、权限治理、故障分层、能力沉淀和变更控制。
第四周,虾开始自治。第五周,自治开始接受生产化检验。
全网同名,欢迎关注回复,有回必答。
对企业来说,这才是AI+ITIL的真正价值:让智能体不只是聪明,而是可依赖。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号